Anmerkung des Autors: Dieser Artikel vergleicht Gemini 4 Carbon, Claude Fable 5.2 und GPT-6 Astra anhand zweier Bewertungssysteme: dem AA-Gesamtindex und der MKA-Bewertung für professionelle Aufgaben. Verglichen werden Leistung, Dauer und Kosten. Außerdem erkläre ich, mit welchen Testkonfigurationen gearbeitet wurde und wie weit die statistischen Schlussfolgerungen reichen.
Vorab: 7 Begriffe für den Vergleich der drei Modelle
- MKA (Multimodal Knowledge Agent): Ein Benchmark für multimodale professionelle Arbeitsaufgaben. Er prüft, ob ein Modell komplexe Dokumente wie Konstruktionszeichnungen, Scans oder Bilddaten verstehen und ein vollständiges Arbeitsergebnis liefern kann.
- Climb WSR: Eine gewichtete Erfüllungsquote, die nur über die trennschärferen Bewertungskriterien berechnet wird. Sie macht Unterschiede zwischen Spitzenmodellen sichtbar.
- Regression WSR: Eine gewichtete Kennzahl dafür, ob die Grundanforderungen erfüllt sind. Sie entspricht sozusagen der Bestehensgrenze für professionelle Ergebnisse.
- Reasoning-Stufe: Die Einstellung für die Denkintensität, die einem Modell zur Verfügung steht. Beispiele sind LOW, MEDIUM und HIGH bei Carbon sowie Max und Xhigh bei Fable und Astra in der Rangliste.
- Aufgabenkosten: Die Summe aller Modellaufruf-Gebühren, die für eine bestimmte Aufgabe anfallen. Das ist kein fester Preis pro einzelner API-Anfrage.
- Cache-Lesezugriff: Das erneute Verwenden bereits zwischengespeicherter Eingaben, das zu einem niedrigeren Preis abgerechnet wird.
- Statistische Signifikanz: Eine Kennzahl, die zeigt, ob es genügend statistische Belege für einen Punkteunterschied zwischen zwei Modellen gibt. Erreicht der Abstand kein signifikantes Niveau, lässt er sich nicht als eindeutiger Sieg oder Niederlage werten.
Das Rennen der Spitzenmodelle lässt sich kaum noch mit einer einzigen Gesamtrangliste erklären. Dieser Artikel vergleicht Gemini 4 Carbon, Claude Fable 5.2 und GPT-6 Astra in drei Dimensionen: Gesamtleistung, professionelles Arbeitsergebnis und Aufgabenkosten. Am Ende gibt es Empfehlungen zur Modellwahl je nach Aufgabentyp.
Das ist keine Rangliste, die alle Punktzahlen in einen Topf wirft. Gesamtindex und MKA sind zwei verschiedene Bewertungssysteme, deshalb betrachte ich sie getrennt. Ich zeige auch, welche Abstände statistisch belegt sind und bei welchen die Belege nicht ausreichen.
Der Nutzen für Sie: Nach der Lektüre können Sie anhand Ihrer Anforderungen an Qualität, Geschwindigkeit und Kosten entscheiden, welches Modell Sie zuerst wählen sollten.
一、Gemini 4 Carbon、Claude Fable 5.2 und GPT-6 Astra treten in derselben Arena an
Die Zeitpunkte dieser Wettbewerbsrunde liegen eng beieinander. Google hat Gemini 4 Carbon am 28. Oktober 2026 erstmals vorgestellt, Anthropic hat am 9. November Claude Fable 5.2 veröffentlicht, und Carbon wurde am 10. November offiziell für Entwickler, Unternehmen und Endnutzer freigegeben. Am selben Tag haben Google DeepMind und Artificial Analysis den MKA-Benchmark gestartet. Am 11. November wurde der Artificial Analysis Intelligence Index v5.0.1 aktualisiert und um Fable 5.2 ergänzt.
Die drei Modelle sind in ihrer öffentlichen Ausrichtung deutlich verschieden. Carbon baut auf Gemini 4 Argon auf und zielt auf langlaufende Agenten, komplexes Software-Engineering und wissenschaftliche Forschung. Es verarbeitet Text, Bilder, Audio und Video als Eingabe. Fable 5.2 nutzt Adaptive Thinking, hat ein Kontextfenster von 1M Token und gibt maximal 128K Token aus. GPT-6 Astra erzielt in beiden hier herangezogenen Benchmarks Ergebnisse und dient häufig als Effizienz-Referenz.
| Vergleichsdimension | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | Aktuelle Einschätzung |
|---|---|---|---|---|
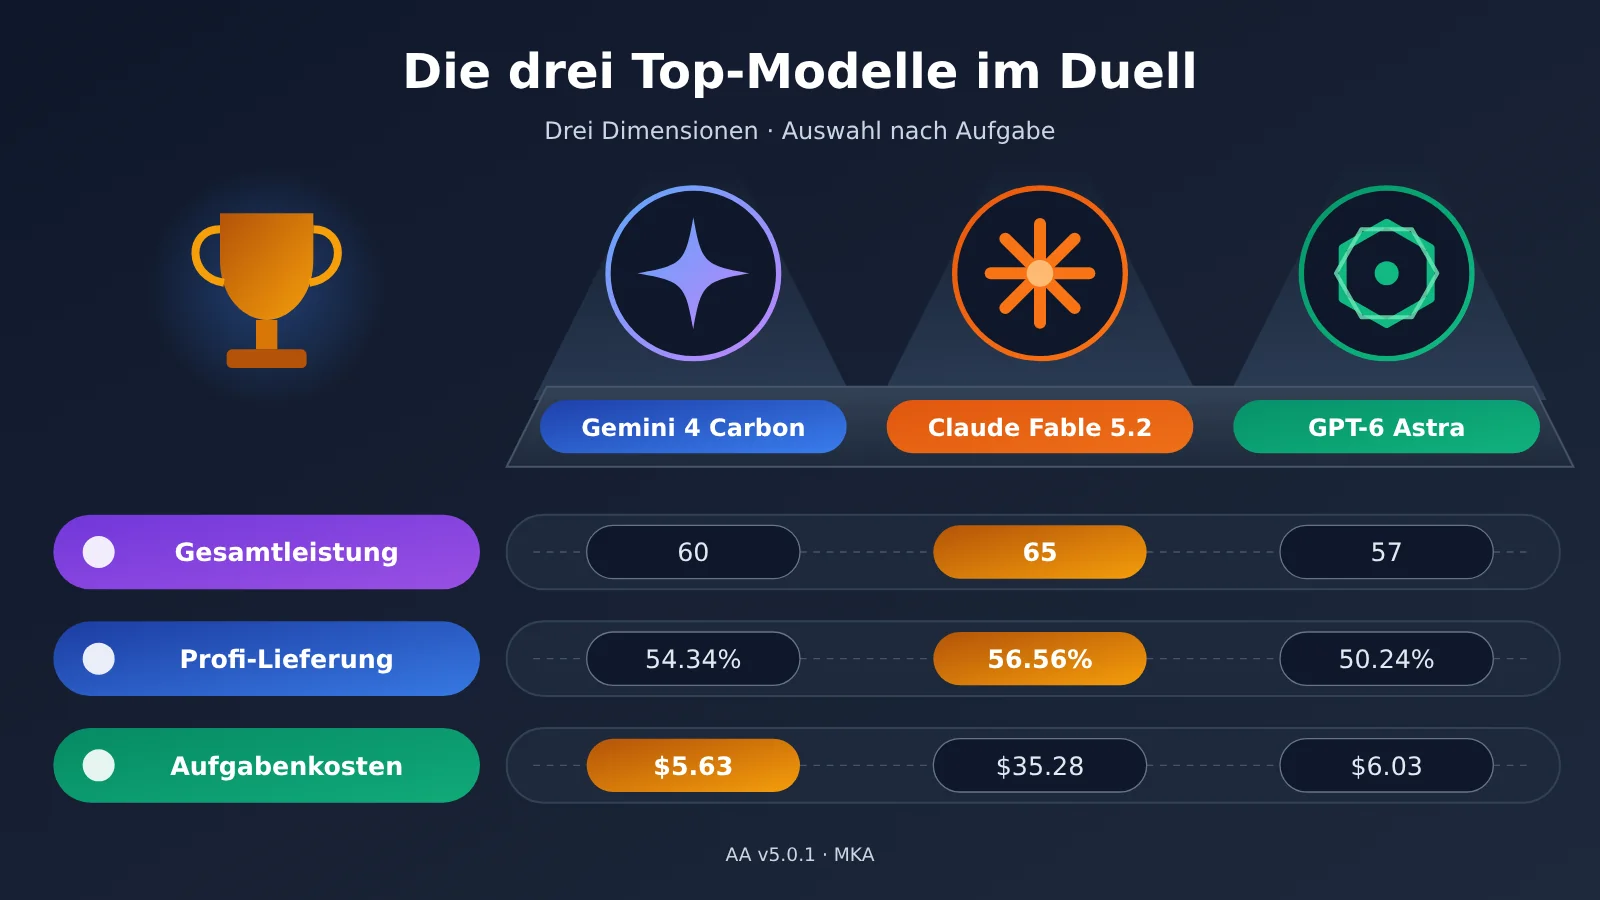
| Gesamtleistung (AA v5.0.1) | 65 (Max) | 60 (High) | 57 (Max) | Fable vorn |
| Professionelle Ergebnisse (MKA Climb-WSR) | 56,56 % | 54,34 % | 50,24 % | Fable und Carbon nah beieinander, beide vor Astra |
| Kosten pro Aufgabe (MKA Tabelle 4) | $35.28 | $5.63 | $6.03 | Carbon am günstigsten |
| Ausführungszeit (MKA Tabelle 4) | 83,2 Minuten | 29,2 Minuten | 18,5 Minuten | Astra am schnellsten |
| Token-Verbrauch (MKA Tabelle 4) | 40.48M | 7.05M | 2.43M | Astra am sparsamsten |
Die „Aktuelle Einschätzung“ in der Tabelle bezieht sich jeweils nur auf die einzelne Kennzahl. Kein Modell liegt in allen Dimensionen auf Platz eins.
📊 Hinweis zu den Daten: Die Zahlen in der Tabelle stammen aus einem Snapshot des AA-Rankings und aus dem technischen MKA-Paper. Beide Messmethoden lassen sich nicht ineinander umrechnen. Wenn Sie Ihren eigenen Anwendungsfall prüfen möchten, können Sie über APIYI (apiyi.com) mit denselben Eingabeaufforderungen einen kleinen Vergleichstest fahren und sehen, wie sich die drei Modelle unter realer Last unterscheiden.
Zwei: AA-Gesamtranking – Claude Fable 5.2 vorerst vorn, Gemini 4 Carbon dicht dahinter
Der Artificial Analysis Intelligence Index v5.0.1 besteht aus 9 Benchmarks: AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2 und Terminal-Bench-Science 0.1. Sie decken Wissensarbeit, Automatisierung, Code, wissenschaftliches Schlussfolgern und Faktentreue ab. Der Index beantwortet die Frage: „Wie leistungsfähig ist das Modell insgesamt?“
| Modellkonfiguration | AA Index v5.0.1 | Kosten pro Benchmark-Aufgabe | Dauer pro Aufgabe |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26.54 | 44,4 Minuten |
| Gemini 4 Carbon High | 60 | $7.76 | 24,9 Minuten |
| GPT-6 Astra Max | 57 | $6.24 | 23,0 Minuten |
Bei dieser Tabelle sollten Sie die unterschiedlichen Konfigurationen im Blick behalten. Die drei Modelle laufen jeweils auf den Stufen Max, High und Max, also mit unterschiedlichen Reasoning-Budgets. Die Ergebnisse sind deshalb kein reiner Vergleich der Modellfähigkeiten unter gleichen Bedingungen. Auch beim selben Modell ändert sich der Wert mit der Stufe: Fable 5.2 erreicht auf Xhigh und High jeweils 62 Punkte, Carbon kommt auf Medium auf 58 Punkte und auf Low auf 54 Punkte.
Die Stufen innerhalb von Carbon lohnen einen eigenen Blick. In der Berechnung von AA liegen die Kosten pro Aufgabe bei Medium mit $6.59 sogar unter denen von Low mit $7.19. High hat zwar die höchste Punktzahl, doch die Latenz bis zum ersten Antwort-Token beträgt 67,54 Sekunden. Eine höhere Reasoning-Stufe bringt also nicht zwangsläufig einen proportionalen Gewinn. Die $7.76 in der Tabelle sind die durchschnittlichen AA-Aufgabenkosten auf Basis von Carbons Standardpreis von $4/$20, nicht der Preis einer gewöhnlichen einzelnen Anfrage.
III. MKA Professional Delivery: Wie gut die drei Modelle echte Fachaufgaben erledigen
Der AA-Index misst die Gesamtleistung, MKA dagegen die Frage, ob ein Modell echte professionelle Arbeit erledigen kann. Laut technischem Paper zu MKA sieht der Aufbau so aus:
- Insgesamt 200 private, reale Aufgaben aus 10 Branchen und 83 Berufen. Jede Aufgabe entspricht etwa 3 bis 8 Stunden Arbeit einer Fachkraft.
- Pro Aufgabe gibt es rund 70 gewichtete Bewertungskriterien. 88 % der Aufgaben verlangen eigenständige Dateien als Ergebnis, etwa Word, Excel, PPT, PDF, HTML oder Bilder.
- Alle Modelle laufen im selben Stirrup Agent Harness, mit identischer Werkzeugumgebung und einem einheitlichen Budget von 250 Runden. Jede Aufgabe wird einmal ausgeführt.
| Modell | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56,56 % | 73,26 % | 95,71 % |
| Gemini 4 Carbon | 54,34 % | 71,89 % | 96,36 % |
| GPT-6 Astra | 50,24 % | 69,34 % | 95,17 % |
Die drei Kennzahlen bedeuten jeweils etwas anderes. Regression-WSR zeigt, wie gut die Grundanforderungen erfüllt werden. Alle drei Modelle liegen hier über 95 %, Carbon knapp vorn. Climb-WSR zählt nur besonders schwierige Kriterien und ist daher das wichtigste Unterscheidungsmerkmal unter den Spitzenmodellen. Overall WSR ist die gewichtete Gesamterfüllungsrate über alle Kriterien. Keine dieser Zahlen ist die Trefferquote bei gewöhnlichen Frage-Antwort-Tests. Man darf sie deshalb auch nicht direkt mit den AA-Index-Werten 65, 60 und 57 vergleichen.
Statistische Signifikanz bei Claude Fable 5.2 und Gemini 4 Carbon
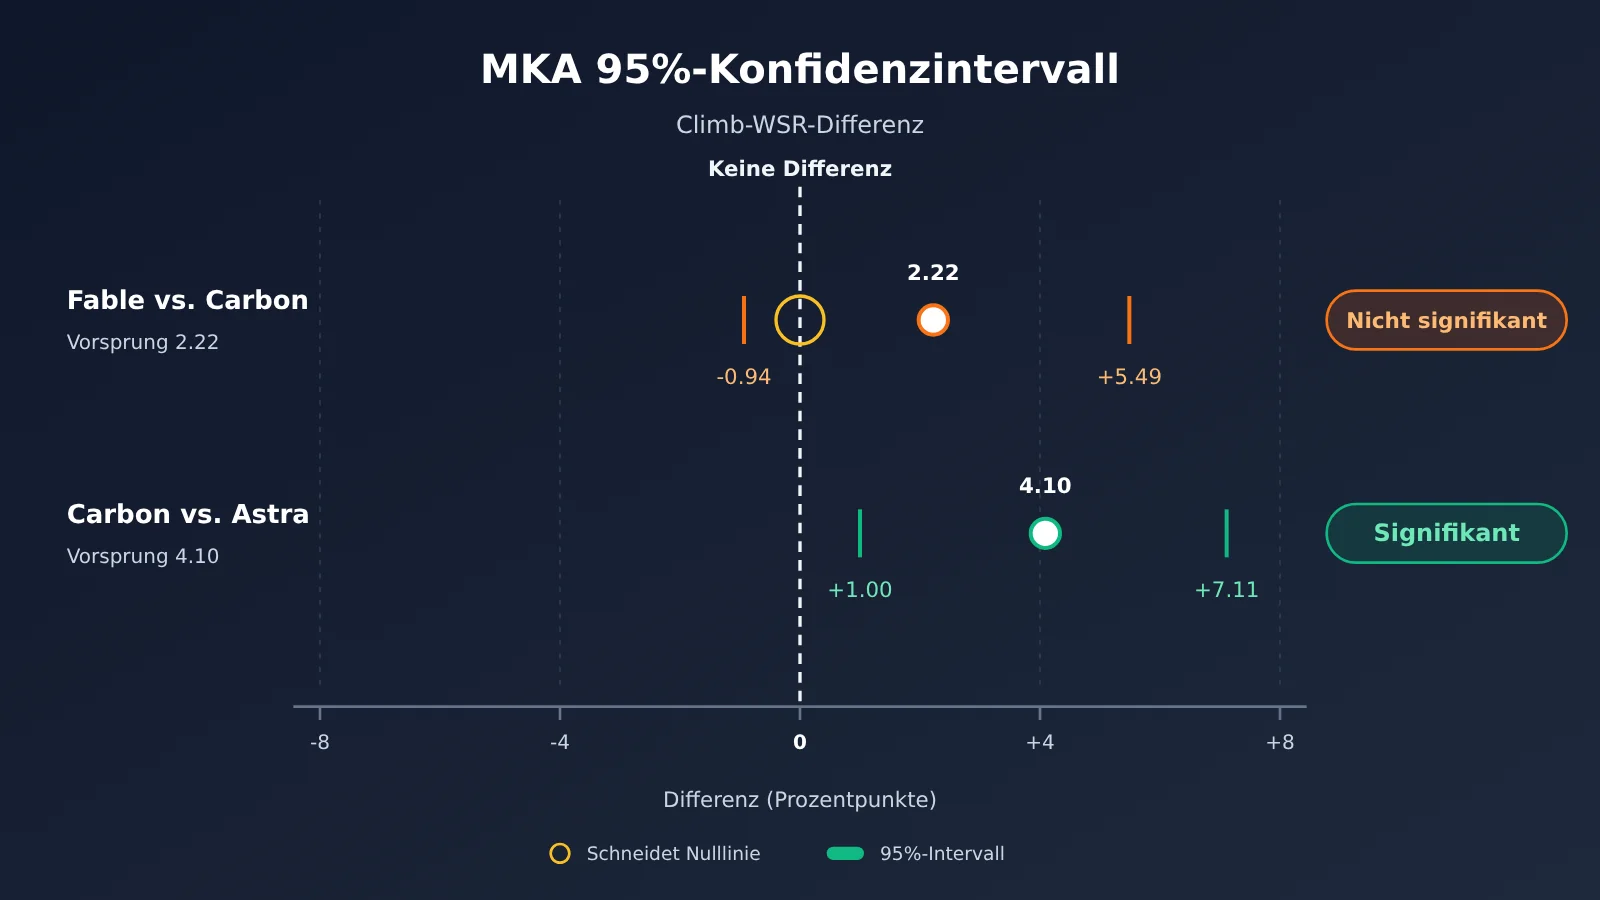
Die statistische Signifikanz ist der Punkt, auf den man bei der Interpretation von MKA am meisten achten sollte. Das Paper liefert folgende Daten:
- Fable gegenüber Carbon: 2,22 Prozentpunkte Vorsprung, 95-%-Konfidenzintervall von -0,94 bis +5,49. Das Intervall schließt die 0 ein, der Unterschied ist also nicht statistisch signifikant.
- Carbon gegenüber Astra: 4,10 Prozentpunkte Vorsprung, 95-%-Konfidenzintervall von +1,00 bis +7,11. Das Intervall liegt komplett über 0, der Unterschied ist also statistisch signifikant.
Korrekt formuliert heißt das: Bei MKA liegen Fable 5.2 und Carbon auf einem ähnlichen Niveau, und die vorliegenden Belege reichen nicht aus, um Fable eindeutig vor Carbon zu sehen. Die Schlussfolgerung des Papers lautet, dass beide Modelle Astra deutlich hinter sich lassen.
Vier: Aufgabenkosten im Vergleich – was die drei Modelle für dieselbe Aufgabe tatsächlich kosten
Tabelle 4 des MKA-Papers nennt den durchschnittlichen Ressourcenverbrauch pro Aufgabe. Die API-Kosten wurden anhand der Listenpreise der jeweiligen Anbieter geschätzt, unter Berücksichtigung der Abrechnung für Prompt-Caching.
| Durchschnittswerte pro Aufgabe | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| Token gesamt | 40,48 Mio. | 7,05 Mio. | 2,43 Mio. |
| Ausgabe-Token | 378,9 Tsd. | 129,5 Tsd. | 42,0 Tsd. |
| Agent-Runden | 128,8 | 46,6 | 29,0 |
| Ausführungszeit | 83,2 Minuten | 29,2 Minuten | 18,5 Minuten |
| Kosten pro Aufgabe | $35,28 | $5,63 | $6,03 |
Aus der Tabelle lassen sich drei Erkenntnisse ableiten:
- Fable setzt die meisten Ressourcen ein: Der Token-Verbrauch ist 5,74-mal so hoch wie bei Carbon, die Ausführungszeit etwa 2,85-mal so lang. Die hochwertigen Ergebnisse beruhen auf vielen Erkundungsrunden und sehr vielen Aufrufen.
- Carbon hat das beste Preis-Leistungs-Verhältnis: Die Kosten pro Aufgabe liegen bei etwa einem Sechstel von Fable. Bei Climb-WSR liegt Carbon nur 2,22 Prozentpunkte zurück, und dieser Abstand ist nicht signifikant.
- Astra ist am schnellsten und spart die meisten Token: Ausführungszeit und Token-Verbrauch sind am niedrigsten. Die Kosten pro Aufgabe liegen aber trotzdem leicht über denen von Carbon, und bei Climb-WSR liegt Astra deutlich hinter Carbon.
Token-Preis, Token-Verbrauch und Aufgabenrechnung: der Unterschied
Diese drei Begriffe werden oft durcheinandergeworfen. Beim Token-Preis kostet Fable 5.2 pro Million Eingabe-Token $8 und pro Million Ausgabe-Token $40. Carbon kostet bis zum 30. November im Einführungsangebot $2/$10, ab dem 1. Dezember dann $4/$20. Ein niedriger Einzelpreis bedeutet aber nicht automatisch eine niedrige Rechnung: Astra verbraucht nur etwa ein Drittel der Token von Carbon, liegt bei den Kosten pro Aufgabe aber leicht darüber. Offenbar beeinflussen sowohl die Preisstruktur als auch die Cache-Trefferquote der einzelnen Modelle den Endbetrag.
Das Lesen aus dem Cache ist in Agent-Szenarien eine Variable, die oft übersehen wird. Ein Agent sendet in jeder Runde erneut große Mengen an Kontext. Bei Carbon beträgt der Preis für gecachte Eingaben zum Beispiel nur etwa 5 % des normalen Eingabepreises. Fables 40,48 Mio. Token bestehen zu einem großen Teil aus wiederholt gelesenem Kontext, deshalb schlägt die Abrechnungsweise direkt auf die Rechnung durch. Außerdem werden die Denk-Token von Carbon als Ausgabe abgerechnet, und bei der Nutzung von Grounding fallen für Suchanfragen zusätzliche Gebühren an.
Bei den Kostendaten gibt es drei Erhebungsweisen, die man getrennt zitieren sollte: Tabelle 4 des MKA-Papers (Carbon $5,63, Fable $35,28), die dynamische MKA-Rangliste (Carbon $6,29, Fable $31,97) und die Aufgabenkosten im AA-Index ($7,76 bzw. $26,54). Sie unterscheiden sich im Erhebungsumfang und dürfen deshalb nicht miteinander vermischt werden.
Fünftens: Wo zeigt sich der multimodale Vorteil von Gemini 4 Carbon?
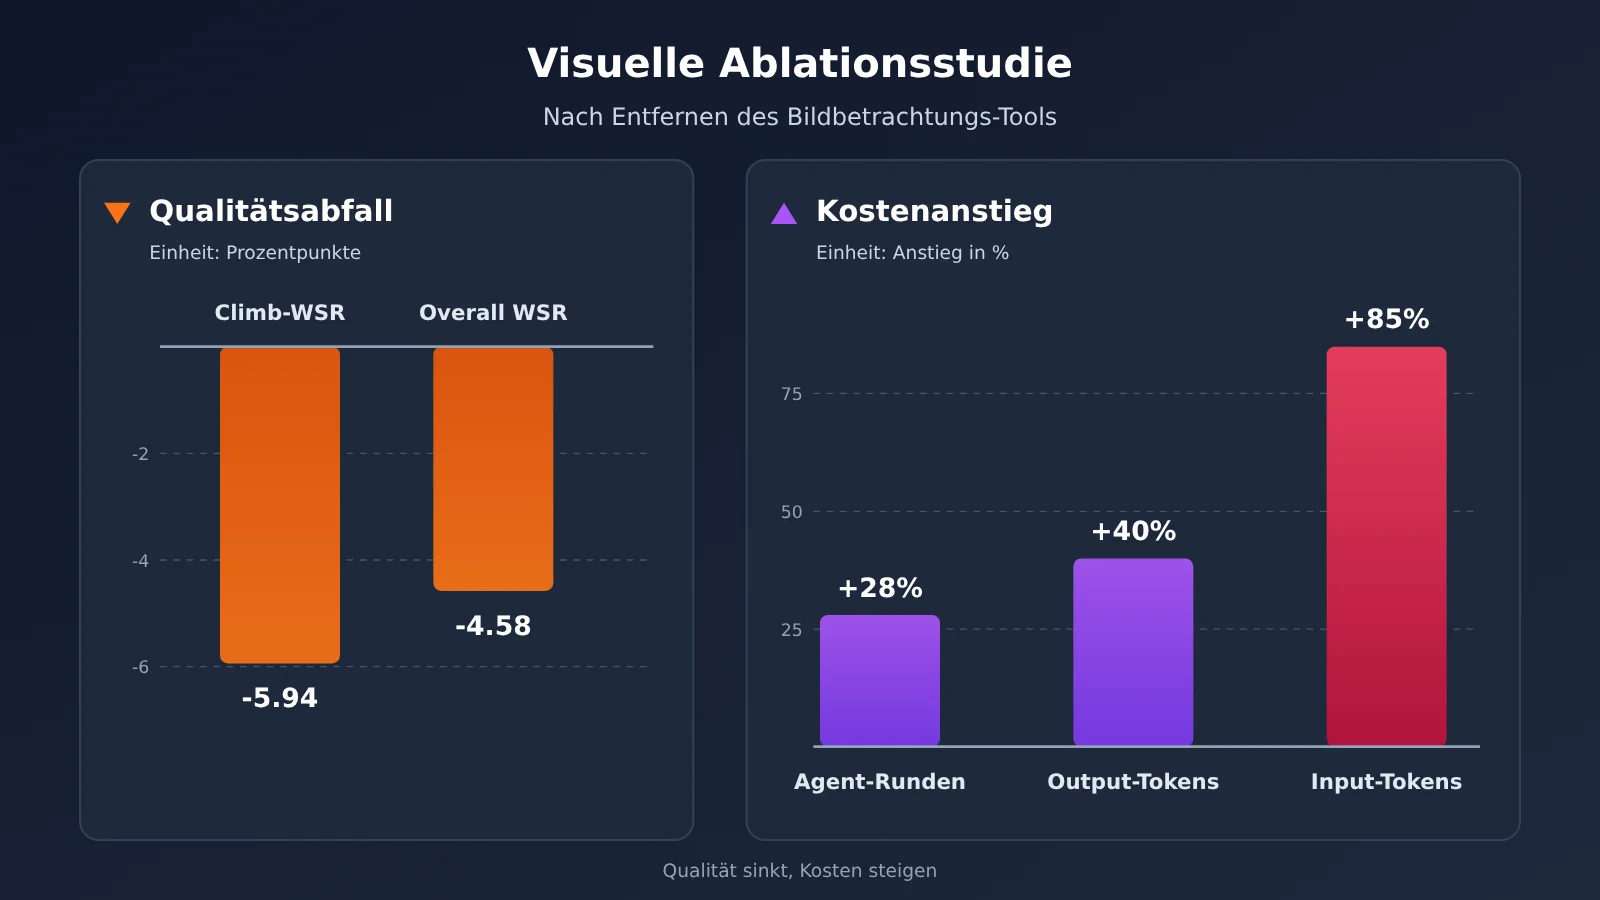
Das MKA-Paper enthält eine Ablationsstudie: Dort wurde Carbons Bildbetrachtungs-Tool view_image entfernt. Das Modell musste die Aufgaben nur mit OCR, Code-Ausführung und klassischen Computer-Vision-Methoden lösen. Die Ergebnisse:
- Die Climb-WSR sinkt um 5,94 Prozentpunkte, die Overall WSR um 4,58 Prozentpunkte.
- Die Zahl der Agent-Runden steigt um 28 %, die Ausgabe-Token steigen um 40 %, die Eingabe-Token um 85 %.
- Das Modell versucht, den Verlust mit ASCII-Bildern, Unicode-Braille und OpenCV auszugleichen. Bei echten Fotos und medizinischen Bildern scheitert es aber weiterhin häufig.
Diese Zahlen zeigen: Visuelles Verständnis lässt sich in professionellen Arbeitsumgebungen kaum durch Textextraktion ersetzen. Räumliche Beziehungen in Bauplänen, die Lage von Läsionen in Bilddaten oder die visuelle Kodierung in Diagrammen gehen nach der OCR größtenteils verloren. Das Modell kann den Bildinhalt dann nur noch erraten und schreibt dafür immer wieder neuen Code. Die Qualität sinkt, die Kosten steigen.
Auch die Branchenergebnisse der MKA-Rangliste passen dazu. Carbon führt im Gesundheitswesen und überzeugt bei bildbasierten Ergebnissen, ebenso wie Argon. Fable 5.2 liegt in den Bereichen Software und Daten, Ingenieurwesen, Logistik und Karten, Wirtschaft sowie Finanzen vorn und hat bei Liefertypen wie PDF, Word und Spreadsheet die Nase vorn. Kein Modell führt in allen 10 Branchen. Word-Dateien und reine Textdateien bleiben die schwierigsten Liefertypen: Bei keinem der beiden Typen kommt ein Modell über 52 %.
Sechs: Einsatzempfehlungen – Wofür sich Gemini 4 Carbon, Claude Fable 5.2 und GPT-6 Astra jeweils eignen
Wann Sie Claude Fable 5.2 wählen sollten
- Komplexe, professionelle Ergebnisse mit höchsten Qualitätsanforderungen: etwa Finanzanalyseberichte, technische Konzepte und Software- oder Datenprojekte. Fehler sind bei solchen Aufgaben teuer, dafür nehmen Sie längere Laufzeiten und höhere Rechnungen in Kauf.
- Lieferungen, die überwiegend aus Office-Dokumenten bestehen: Ausgaben als PDF, Word und Tabellen gehören bei Fable im MKA zu den Stärken.
Wann Sie Gemini 4 Carbon wählen sollten
- Komplexe Agent-Aufgaben, bei denen Qualität und Kosten zusammenpassen müssen: Im MKA erreicht Carbon bei etwa einem Sechstel der Kosten ein Niveau, das sich statistisch kaum von Fable unterscheidet.
- Aufgaben, die auf visuellem Verständnis beruhen: zum Beispiel das Auswerten technischer Zeichnungen, die Unterstützung bei der Analyse medizinischer Bilder und bildbasierte Ergebnisse. Für die Reasoning-Stufe empfiehlt sich der Einstieg mit MEDIUM, denn damit erfindet das Modell im AA-Test zur faktischen Zuverlässigkeit seltener Antworten.
Wann Sie GPT-6 Astra wählen sollten
- Pipelines, bei denen es auf Ausführungsgeschwindigkeit ankommt: Im MKA hat Astra die kürzeste Laufzeit und die wenigsten Agent-Runden. Das passt zu Aufgaben, die schnelles Feedback brauchen.
- Szenarien, in denen Token-Budget oder Kontextdruck eine Rolle spielen: Astra verbraucht insgesamt die wenigsten Token, dafür müssen Sie bei der Qualität professioneller Ergebnisse Abstriche hinnehmen.
| Aufgabentyp | Erste Wahl | Alternative | Hauptgrund | Zugang |
|---|---|---|---|---|
| Hochwertige Fachberichte | Claude Fable 5.2 | Gemini 4 Carbon | Höchste Punktzahl in AA und MKA | Offizielle API, APIYI |
| Komplexe Agent-Aufgaben im Batch | Gemini 4 Carbon | Claude Fable 5.2 | Ähnliche Qualität bei etwa einem Sechstel der Kosten | Offizielle API, APIYI |
| Auswertung von Zeichnungen und Bildern | Gemini 4 Carbon | Claude Fable 5.2 | Belege aus der Vision-Ablation, führend im medizinischen Bereich | Offizielle API, APIYI |
| Schnelle Ausführungs-Pipelines | GPT-6 Astra | Gemini 4 Carbon | Geringste Laufzeit und niedrigster Token-Verbrauch | Offizielle API, APIYI |
7. So testen Sie die drei Modelle über eine einheitliche Schnittstelle
Öffentliche Ranglisten sind nur ein Ausgangspunkt. Entscheidend ist, wie sich ein Modell bei Ihren eigenen Aufgaben schlägt. Das folgende Beispiel nutzt eine OpenAI-kompatible Schnittstelle. Sie müssen nur den Parameter model wechseln, um mit demselben Code verschiedene Modelle aufzurufen:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI: OpenAI-kompatible Schnittstelle
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Token-Verbrauch protokollieren, um später die Kosten abzuschätzen
Vollständigen Code für den Vergleichstest der drei Modelle anzeigen
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Maßgeblich sind die Modellnamen in der Modellliste der Plattform; GPT-6 Astra ist hier nur ein Beispielname
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# Preise (US-Dollar pro Million Token) bitte passend zum tatsächlichen Kanal eintragen
# Beispiel: Fable 5.2 mit offiziellem Listenpreis; Carbon mit Einführungspreis bis zum 30. November
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # Bitte selbst ergänzen
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # Grobe Schätzung: Cache-Lesezugriffe werden nicht gesondert berücksichtigt; Denk-Token zählen in der Regel zur Ausgabe
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
Dieser Code erfasst nur einen einzelnen Aufruf. Bei echten Agent-Aufgaben müssen Sie die Kosten aller Runden addieren, das sind die in diesem Artikel gemeinten Aufgabenkosten. Außerdem unterstützt Carbon thinking_budget nicht: Wird der Parameter übergeben, antwortet die API mit HTTP 400. Auch Sampling-Parameter wie temperature werden ignoriert. Die Reasoning-Stufe stellen Sie so ein, wie es die Plattformdokumentation beschreibt.
🚀 Schnellstart-Empfehlung: Holen Sie sich am besten zuerst das kostenlose Testguthaben für Neukunden bei APIYI (apiyi.com). Lassen Sie dann das obige Vergleichsskript mit 5–10 echten Beispielen aus Ihrem Geschäftsalltag laufen und halten Sie Laufzeit, Token-Verbrauch und Qualitätsbewertung fest. Erst danach entscheiden Sie, welches Modell die Hauptrolle übernimmt. Die Plattform bindet OpenAI, Claude, Gemini und weitere gängige Modelle über denselben API-Schlüssel an und rechnet nutzungsbasiert ab. Zum Wechseln des Modells genügt es, einen einzigen Parameter zu ändern.
Entscheidungshilfe: Wie Sie zwischen den drei Modellen abwägen
Bei der Modellauswahl legen Sie am besten zuerst fest, welche Anforderung für Ihre Aufgabe am wichtigsten ist, und wählen dann die passende Kennzahl:
- Qualität ist die harte Vorgabe: Orientieren Sie sich vor allem an der Climb-WSR aus dem MKA und entscheiden Sie sich zwischen Fable 5.2 und Carbon. Da der Abstand zwischen den beiden nicht signifikant ist, sollten Sie die Modelle am besten mit Ihren eigenen Beispielen überprüfen.
- Das Budget ist die harte Vorgabe: Schauen Sie auf die Kosten pro Aufgabe in Tabelle 4 des MKA statt auf den Token-Preis. Hier hat Carbon einen deutlichen Vorteil.
- Die Zeit ist die harte Vorgabe: Achten Sie auf Ausführungszeit und Anzahl der Agent-Runden – Astra ist am schnellsten. Dafür müssen Sie in Kauf nehmen, dass es bei der Qualität professioneller Ergebnisse deutlich zurückliegt.
💡 Auswahlempfehlung: Sie können sich am Vorgehen von Google /swarm orientieren: Ein starkes Modell übernimmt Planung und Prüfung, ein schnelles Modell die Stapelverarbeitung. Über die einheitliche Schnittstelle von APIYI (apiyi.com) lassen sich in einem Projekt je nach Agent-Rolle unterschiedliche Modelle zuweisen, ohne dass Sie mehrere SDKs pflegen müssen.
Häufig gestellte Fragen (FAQ)
Q1: Wie sind Gemini 4 Carbon, Claude Fable 5.2 und GPT-6 Astra jeweils positioniert?
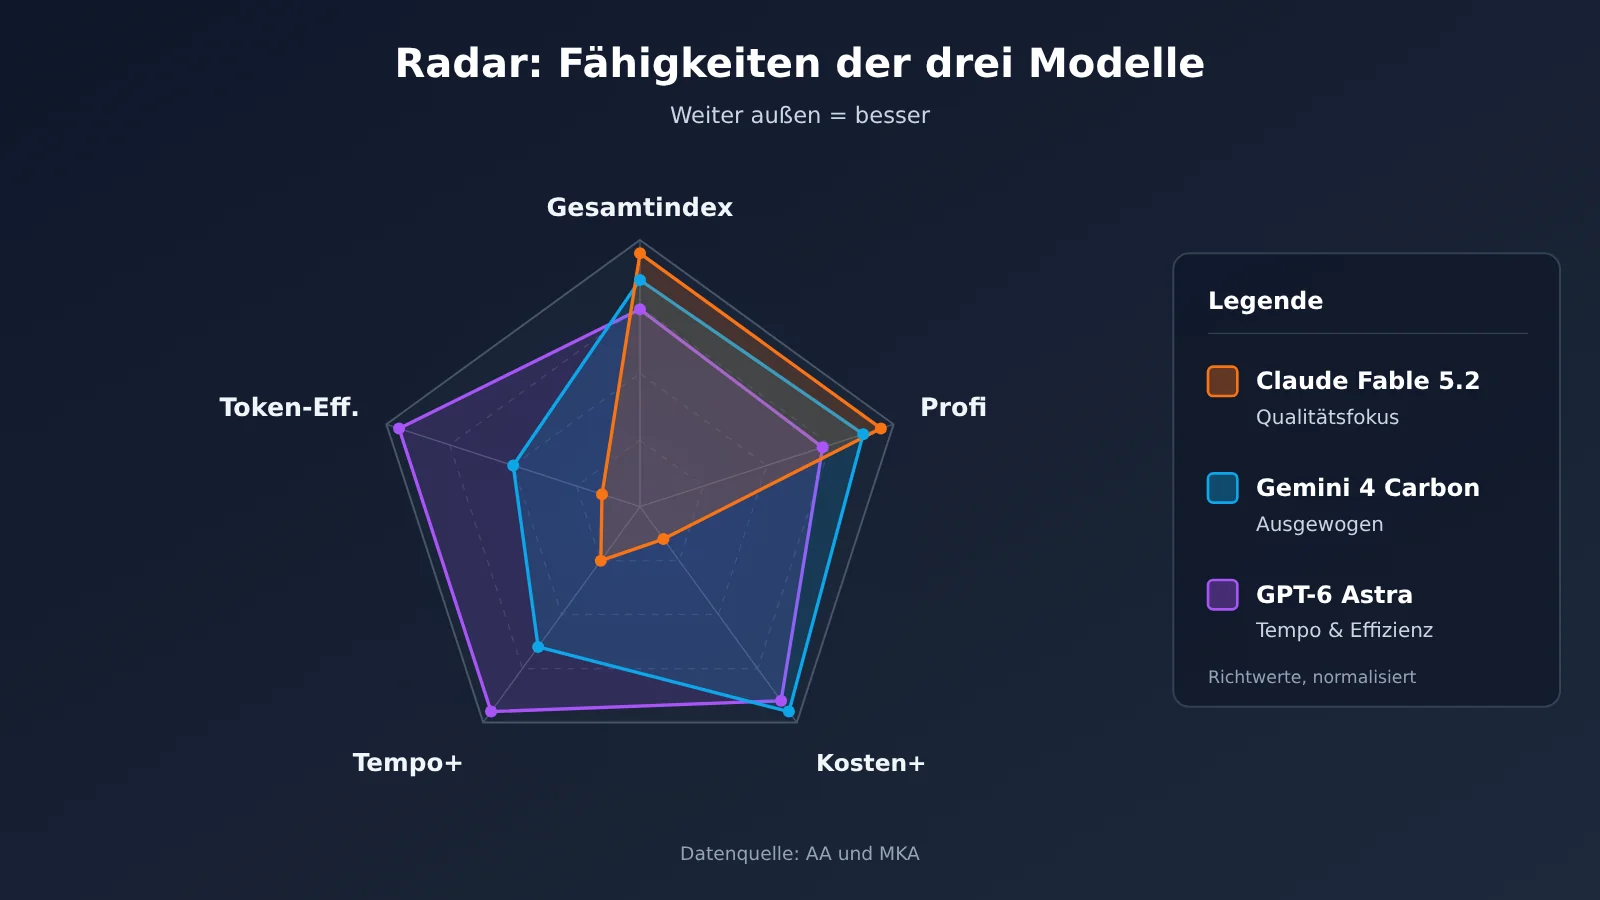
Alle drei sind Top-Reasoning-Modelle aus der zweiten Jahreshälfte 2026. Fable 5.2 liegt bei der Gesamtqualität und bei professionellen Arbeitsergebnissen vorn. Carbon bietet einen ausgewogenen Mix aus Qualität, multimodalen Fähigkeiten und Kosten pro Aufgabe. Astras Stärken sind Ausführungsgeschwindigkeit und Token-Effizienz.
Q2: Fable 5.2 liegt im MKA 2,22 Prozentpunkte vor Carbon. Heißt das, dass Fable stärker ist?
Nein. Das 95-%-Konfidenzintervall dieses Abstands reicht von -0,94 bis +5,49 und schließt damit die 0 ein, der Unterschied ist also nicht statistisch signifikant. Treffender ist: Beide Modelle liegen auf einem ähnlichen Niveau, und beide liegen deutlich vor Astra.
Q3: Kann man die 65 Punkte des AA-Index mit den 56,56 % des MKA vergleichen?
Nein. Der AA-Index ist ein Gesamtwert aus 9 Benchmarks, wobei die Modelle jeweils mit unterschiedlichen Reasoning-Stufen laufen. Der MKA misst dagegen die gewichtete Erfüllungsquote bei professionellen Arbeitsergebnissen unter einem einheitlichen Harness. Gegenstand und Bewertungsmethode unterscheiden sich, deshalb lassen sich die Werte nicht ineinander umrechnen.
Q4: Carbon kostet pro Token nur ein Viertel von Fable. Sind auch die Kosten pro Aufgabe nur ein Viertel?
Nicht unbedingt. In der Startphase liegt der Token-Preis von Carbon tatsächlich bei 25 % von Fable 5.2, ab dem 1. Dezember steigt er auf 50 %. Die tatsächliche Rechnung hängt aber vom Token-Verbrauch, von Thinking-Tokens, Cache-Treffern und Tool-Aufrufen ab. In Tabelle 4 des MKA unterscheiden sich die Kosten pro Aufgabe zwischen den beiden um etwa das Sechsfache, weil Carbon auch deutlich weniger Tokens verbraucht.
Q5: Wie kann ich die drei Modelle günstig selbst testen?
Am besten über eine Aggregator-Schnittstelle, die mehrere Modelle unterstützt:
1. Registrieren Sie sich bei APIYI (apiyi.com) und holen Sie sich Ihren API-Schlüssel samt kostenlosem Testguthaben.
2. Setzen Sie die base_url im Code dieses Artikels auf `https://api.apiyi.com/v1`.
3. Lassen Sie den Vergleich mit echten Dateien und Aufgaben aus Ihrem Alltag laufen und halten Sie Qualität, Laufzeit und Token-Verbrauch fest.
Q6: GPT-6 Astra spart am meisten Tokens. Warum sind die Kosten pro Aufgabe trotzdem nicht am niedrigsten?
Wenige Tokens bedeuten nicht automatisch eine niedrige Rechnung. Die Preisstruktur für Eingabe, Ausgabe und Cache ist bei jedem Modell anders, und die Endkosten ergeben sich aus der Summe von Verbrauch mal jeweiligem Preis. In Tabelle 4 des MKA verbraucht Astra etwa ein Drittel der Tokens von Carbon, ist aber geringfügig teurer.
Q7: Welche Einschränkungen haben diese Bewertungsergebnisse?
Im MKA wird jede Aufgabe nur einmal ausgeführt. Als Judge dient GPT-6 Luna Medium, das zu 96 % mit den Expertenurteilen übereinstimmt. Die AA-Rangliste ist eine dynamische Momentaufnahme, und wenn der Preis von Carbon am 1. Dezember angepasst wird, ändern sich auch die nach Standardpreis berechneten Kosten. Wer die Kosten langfristig verfolgen möchte, kann in der Nutzungsübersicht von APIYI (apiyi.com) die tatsächlichen Ausgaben pro Modell auswerten und als eigene Kostendaten verwenden.
Die wichtigsten Erkenntnisse im Dreier-Vergleich (Key Takeaways)
- Gesamtleistung: Im AA v5.0.1 erreicht Fable 5.2 Max 65 Punkte und liegt damit vor Carbon High (60) und Astra Max (57).
- Professionelle Ergebnisse: Im MKA ist der Abstand zwischen Fable und Carbon nicht signifikant. Beide liegen deutlich vor Astra.
- Kosten pro Aufgabe: Nach der Berechnungsweise aus Tabelle 4 des Papers kostet Carbon 5,63 $ pro Aufgabe, etwa ein Sechstel von Fable.
- Tempo und Effizienz: Astra braucht pro Aufgabe 18,5 Minuten und 2,43 Mio. Token. Bei Geschwindigkeit und Token-Effizienz ist es damit am besten.
- Wert der multimodalen Fähigkeiten: Ohne das Tool zur Bildansicht sinkt bei Carbon die Qualität, und die Eingabe-Token steigen um 85 %.
- Grenzen der Kennzahlen: Token-Preis, Token-Verbrauch und Aufgabenkosten sind drei verschiedene Größen.
- So gelingt der Einstieg: Über APIYI (apiyi.com) lassen sich alle drei Modelle mit einem einzigen Schlüssel an einer kleinen Stichprobe vergleichen.
Fazit: Keine einzelne Kennzahl entscheidet, welches Modell das beste ist
Zurück zur Eingangsfrage: Die drei Spitzenmodelle unterscheiden sich vor allem darin, wie sie Qualität, Geschwindigkeit und Kosten gegeneinander abwägen:
- Claude Fable 5.2: Liegt beim Gesamtindex und bei den professionellen Ergebnissen vorn, braucht dafür aber die längste Ausführungszeit und verursacht die höchsten Kosten pro Aufgabe.
- Gemini 4 Carbon: Die Qualität bei professionellen Ergebnissen liegt statistisch nahe an Fable, die Kosten pro Aufgabe sind am niedrigsten. Das Bildverständnis ist der besondere Vorteil.
- GPT-6 Astra: Läuft am schnellsten und spart die meisten Token, bleibt bei der Qualität professioneller Ergebnisse aber deutlich hinter den beiden anderen zurück.
Gesamtleistung, Aufgabenqualität, Antwortgeschwindigkeit und Kosten pro Aufgabe sollten Sie getrennt bewerten. Statt nur auf die Platzierung im Ranking zu schauen, ist es verlässlicher, einen Vergleichstest mit Ihren eigenen Aufgaben durchzuführen. Mit APIYI (apiyi.com) können Sie schnell prüfen, wie sich die drei Modelle in Ihrem Anwendungsfall schlagen. Die Plattform bietet kostenloses Testguthaben und eine einheitliche Schnittstelle für mehrere Modelle.
📚 Referenzen
- MKA-Technikpapier: MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- Link:
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
Hinweis: Originaldaten zu WSR der drei Modelle, Konfidenzintervallen, den Kosten aus Tabelle 4 und den visuellen Ablationsexperimenten
-
Artificial Analysis Modell-Rangliste: Intelligence Index v5.0.1
- Link:
artificialanalysis.ai/leaderboards/models -
Hinweis: Dynamische Momentaufnahme von Gesamtscore sowie Kosten und Dauer pro Aufgabe
-
MKA-Benchmark-Rangliste: Ranking multimodaler Knowledge-Agents
- Link:
artificialanalysis.ai/zh/evaluations/mka -
Hinweis: Einzelergebnisse nach führenden Modellen der Branche und nach Typ der gelieferten Dateien
-
Gemini 4 Carbon Model Card: Offizielle Unterlagen von Google DeepMind
- Link:
deepmind.google/models/model-cards/gemini-4-carbon -
Hinweis: Modalitäten, Kontext, Reasoning-Stufen und bekannte Einschränkungen
-
Gemini-API-Preisseite: Carbon-Standardpreis, Cache-Preis und Batch-Preis
- Link:
ai.google.dev/gemini-api/docs/pricing -
Hinweis: Einführungspreis und Preisanpassung ab dem 1. Dezember
-
Claude Fable 5.2 API-Dokumentation: Offizielle Modellbeschreibung von Anthropic
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Hinweis: Kontext, maximale Ausgabe, Token-Preise und Fast Mode
Autor: APIYI-Technikteam
Austausch: Melden Sie sich gern über die Startseite von APIYI bei uns. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com