Anthropic veröffentlichte am 9. November 2026 mit Claude Fable 5.2 ein internes Experiment: Fable 5.2 startete mit einem leeren Ordner, koordinierte mehr als 1.000 Sub-Agents und arbeitete acht Tage lang ununterbrochen an einem Betriebssystem-Prototyp, der sich auf einem Laptop starten lässt.
Kernnutzen: Nach der Lektüre wissen Sie, aus welchen Kostenblöcken sich ein Multi-Agent-Workflow mit Claude Fable 5.2 zusammensetzt, welche Abrechnungsregeln leicht missverstanden werden und wie Sie die Gesamtkosten mit der Modellauswahl und einem gezielten Aufrufmanagement kontrollieren können.
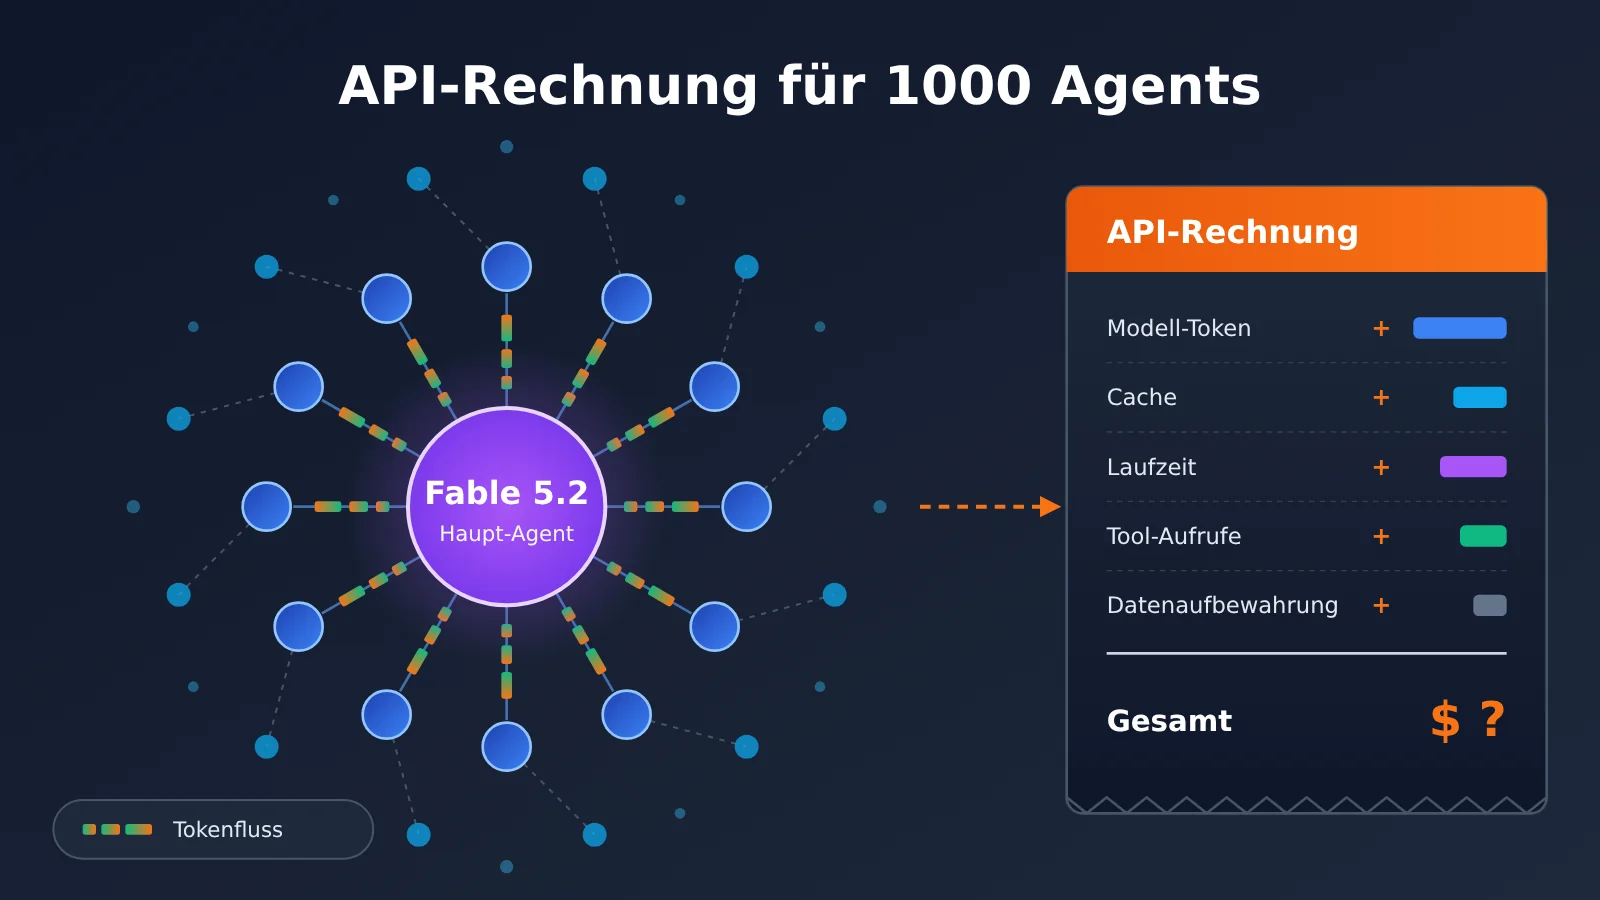
Das Betriebssystem-Experiment mit Claude Fable 5.2: Warum die Rechnung für 1.000 Agents unbekannt ist
Zunächst zu den wichtigsten bereits veröffentlichten Informationen. Das Experiment zeigt nicht nur, dass das Modell Code schreiben kann. Es belegt auch seine Fähigkeit, große Softwareprojekte zu organisieren, zahlreiche Sub-Agents zu koordinieren, den Fortschritt über einen längeren Zeitraum aufrechtzuerhalten und den Code kontinuierlich zu überprüfen.
| Informationspunkt | Details |
|---|---|
| Veröffentlichungsdatum | 9. November 2026 |
| Herausgeber | Anthropic |
| Ausgangspunkt des Experiments | Ein leerer Ordner; Aufgabe war, einen Betriebssystem-Prototyp zu entwerfen und umzusetzen |
| Anzahl der Agents | Mehr als 1.000 Sub-Agents |
| Laufzeit | Acht Tage am Stück: rund um die Uhr Code schreiben, testen, prüfen und überarbeiten |
| Ergebnis | Ein Betriebssystem-Prototyp, der auf einem echten Laptop startet. Er umfasst einen Kernel, Festplatten-, Tastatur- und Netzwerktreiber, Dateispeicherung, ein Fenstersystem, eine Anmeldeoberfläche, ein Installationsprogramm und integrierte Claude-Funktionen |
| Nicht veröffentlichte Informationen | Gesamtverbrauch an Tokens, Gesamtkosten des Experiments, Aufgabenverteilung zwischen den Agents, Kommunikationsprotokoll, Codeumfang und mehr |
Wichtig ist: Anthropic bezeichnet das Ergebnis als funktionsfähigen Betriebssystem-Prototyp. Das bedeutet nicht, dass es sich bereits um ein ausgereiftes kommerzielles Betriebssystem handelt. Außerdem hat Anthropic die tatsächlichen Kosten des Experiments nicht veröffentlicht. Jede Angabe dazu, wie viel „dieses Betriebssystem gekostet hat“, wäre daher reine Spekulation.
Wie viele Ebenen von API-Aufrufen erzeugt ein Agent-Team?
Auch ohne die tatsächliche Rechnung zu kennen, lässt sich der Kostendruck eines Multi-Agent-Systems anhand seiner Struktur nachvollziehen. Ein Haupt-Agent muss das Ziel verstehen, Aufgaben aufteilen, sie an Sub-Agents verteilen und anschließend die Ergebnisse zusammenführen und überprüfen. Jeder Sub-Agent muss wiederum den Projektkontext, die Tool-Beschreibungen und den relevanten Code einlesen, bevor er eigenständig nachdenkt und seine Ergebnisse ausgibt.
Hinter einer erledigten Aufgabe stecken also mehrere Ebenen von Modellaufrufen: Aufrufe für die Planung und Ausführung, für die Rückmeldung und Überprüfung sowie Wiederholungsaufrufe nach Fehlern. Steigt die Zahl der Agents und erstreckt sich der Betrieb über mehrere Tage, werden Token-Kosten, parallele Aufrufe und lange Laufzeiten gleichzeitig zu Kostenfaktoren.
Claude Fable 5.2 API-Preise: Ausgangspunkt für die Kosten von Multi-Agent-Systemen
Wer über die Kosten von Multi-Agent-Systemen spricht, sollte zuerst die Einzelpreise betrachten. Alle folgenden Preise entsprechen den öffentlich ausgewiesenen Preisen von Anthropic und sind in US-Dollar pro Million Token (MTok) angegeben.
| Modell | Eingabepreis | Ausgabepreis | Einsatzbereich |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | Komplexe, offene und lang laufende Aufgaben |
| Claude Opus 5.5 | $4 | $20 | Von Anthropic empfohlener Ausgangspunkt für die meisten Programmier- und Wissensarbeitsaufgaben |
| Claude Sonnet 5.5 | $2 | $10 | Teilaufgaben mittlerer Schwierigkeit und Informationsverarbeitung |
| Claude Haiku 5.5 | $0.10 | $0.50 | Einfache, häufig anfallende Teilaufgaben (Eingabe mit höchstens 100K Token) |
Bei Haiku 5.5 steigt der Preis für Eingaben mit mehr als 100K Token auf $0.50/MTok; für Ausgaben werden dann $2.50/MTok berechnet. Fable 5.1 kostete zuvor $10 für Eingaben und $50 für Ausgaben. Damit sind die Standardpreise pro Token bei Fable 5.2 um 20 % gesunken.
💡 Empfehlung zur Auswahl: Die verschiedenen Modelle sind keine gleichwertigen Alternativen. Welches am besten geeignet ist, hängt von der Schwierigkeit der Aufgabe und den Qualitätsanforderungen ab. Über APIYI apiyi.com können Sie mehrere Claude-Modelle mit derselben OpenAI-kompatiblen Schnittstelle vergleichen und ihre tatsächlichen Ausgaben sowie den Token-Verbrauch prüfen. So lässt sich entscheiden, welches Modell welche Teilaufgaben übernehmen soll. (Die konkret verfügbaren Modelle finden Sie in der Modellliste der Plattform.)
Spezifikationen von Claude Fable 5.2 und Fast Mode
Die API Model ID von Fable 5.2 lautet claude-fable-5-2. Das Modell hat ein Kontextfenster von 1M Token, eine maximale Ausgabelänge von 128K Token und einen Wissensstand bis Juni 2026. Adaptive Thinking ist immer aktiviert; der standardmäßige Effort-Wert ist High. Zur Auswahl stehen außerdem Low, Medium, High, Xhigh und Max. Effort ist kein Parameter für den Antwortstil, sondern wirkt sich direkt auf die Denktiefe, die Ausführungszeit und den Token-Verbrauch aus.
| Abrechnungsposition | Preis (US-Dollar/MTok) | Erläuterung |
|---|---|---|
| Reguläre Eingaben / Ausgaben | $8 / $40 | Standardmodus |
| Fast Mode: Eingaben / Ausgaben | $16 / $80 | Doppelter Preis; Ausgabegeschwindigkeit bis zu 2,5-mal so hoch wie im Standardmodus |
| Batch API: Eingaben / Ausgaben | $4 / $20 | 50 % Rabatt auf asynchrone Batch-Anfragen; nicht mit Fast Mode kombinierbar |
| Cache-Schreiben für 5 Minuten | $10 | Speichert ein Eingabepräfix zur späteren Wiederverwendung |
| Cache-Schreiben für 1 Stunde | $16 | Längere Gültigkeitsdauer |
| Cache-Lesen | $0.20 | Nur 2,5 % des regulären Eingabepreises |
Die Tabelle macht einen wichtigen Punkt deutlich: Das leistungsfähigste Modell muss nicht jede Teilaufgabe übernehmen. Wird Fable 5.2 für Aufgaben wie Formatierung oder einfache Klassifizierung eingesetzt, kostet es pro Token viermal so viel wie Sonnet 5.5 und 80-mal so viel wie Haiku 5.5. Die zusätzliche Schlussfolgerungsfähigkeit bringt dabei kaum einen Vorteil.
Wie sich die Kosten bei mehreren Agents summieren: Claude-Fable-5.2-Workflow im Detail
In einem Multi-Agent-System übernimmt der Haupt-Agent die Planung und Zusammenfassung, während die Sub-Agents konkrete Aufgaben ausführen. Die Arbeit scheint dadurch zwar „aufgeteilt“ zu werden, doch die Token verschwinden nicht. Im Gegenteil: An mehreren Stellen steigt ihr Verbrauch.
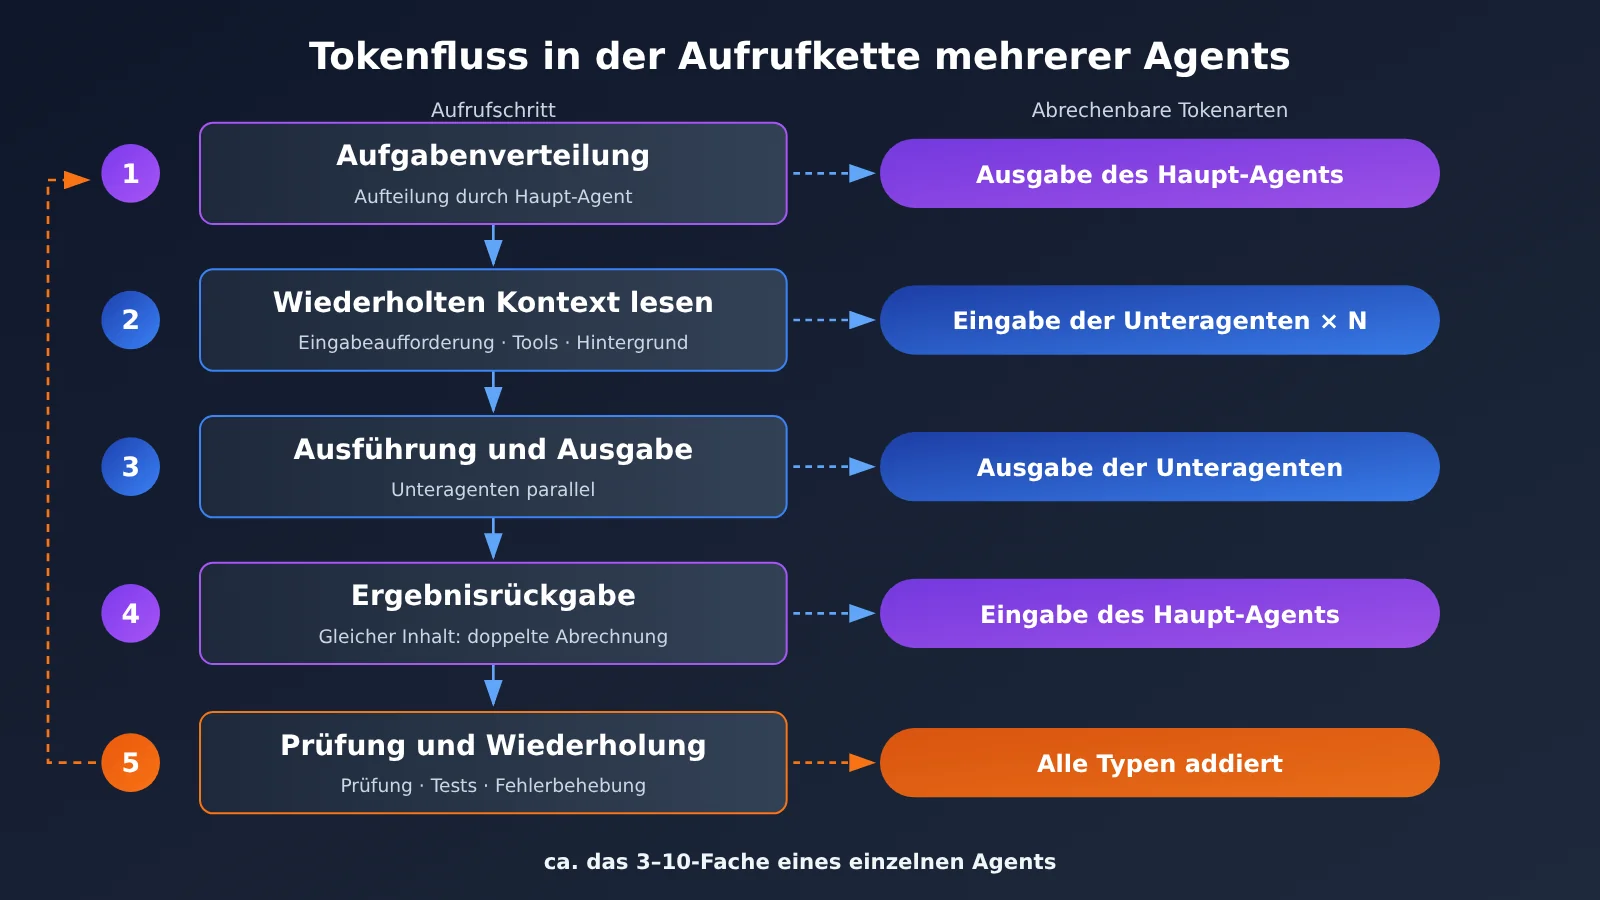
- Aufgabenverteilung: Die vom Haupt-Agent formulierte Aufgabenbeschreibung besteht aus Ausgabe-Token und wird zum Preis des Modells des Haupt-Agents abgerechnet.
- Wiederholter Kontext: Jeder Sub-Agent muss den System-Prompt, die Tool-Beschreibungen und den Projekthintergrund erneut einlesen. Derselbe Inhalt wird also mehrfach abgerechnet.
- Rückgabe der Ergebnisse: Die Ausgabe eines Sub-Agents wird zur Eingabe des Haupt-Agents. Derselbe Inhalt wird damit zweimal abgerechnet.
- Mehrstufige Überprüfung: Nach der Prüfung und den Tests werden Probleme erkannt und zur Behebung weitergegeben. Jede Runde ist ein neuer Aufruf.
- Erneute Versuche bei Fehlschlägen: Schlägt ein Aufruf fehl oder ist das Ergebnis unzureichend, wird die Ausführung wiederholt. Der Token-Verbrauch summiert sich dadurch direkt.
Anthropics Engineering-Leitfaden für Multi-Agent-Systeme aus dem Jahr 2026 weist darauf hin, dass Multi-Agent-Systeme bei derselben Aufgabe in der Regel drei- bis zehnmal so viele Token verbrauchen wie ein einzelner Agent. Das ist eine typische Vergleichsspanne für dieselbe Aufgabe, kein fester Multiplikator. Ein rein illustratives Beispiel: Angenommen, eine Aufgabe mit einem einzelnen Agent kostet 1,60 $ an Token. Bei identischem Modell und demselben Verhältnis zwischen Ein- und Ausgabe entsprechen die dreifache Token-Menge 4,80 $ und die zehnfache 16 $.
Das erklärt auch, warum parallele Ausführung nicht automatisch die Gesamtkosten senkt. Parallelität verkürzt die verstrichene Zeit, doch der Token-Verbrauch der einzelnen Agents bleibt gleich. Hinzu kommen Koordinationskosten. Entscheidend ist daher nicht die Anzahl der Agents an sich, sondern der tatsächliche Token-Verbrauch jedes einzelnen Agents.
Hypothetische Kostenkalkulation für Claude Fable 5.2 mit mehreren Agents: Was kostet ein Workflow?
Im Folgenden erstellen wir einen hypothetischen Workflow: Ein Fable-5.2-Hauptagent übernimmt die Planung und Zusammenfassung, während zehn Sonnet-5.5-Subagents jeweils eigenständige Rechercheaufgaben bearbeiten. Alle Token-Mengen sind Annahmen. Sie entsprechen weder einer tatsächlichen Abrechnung aus einem Anthropic-OS-Experiment noch einem Modellvergleich bei Aufgaben mit gleicher Qualität.
Hauptagent (Fable 5.2): angenommen werden 100.000 Eingabe-Token und 10.000 Ausgabe-Token.
- Eingabe: 100.000 × $8 / 1.000.000 = $0.80
- Ausgabe: 10.000 × $40 / 1.000.000 = $0.40
- Zwischensumme: $1.20
10 Subagents (Sonnet 5.5): angenommen werden pro Agent 100.000 Eingabe-Token und 20.000 Ausgabe-Token, insgesamt also 1.000.000 Eingabe-Token und 200.000 Ausgabe-Token.
- Eingabe: 1.000.000 × $2 / 1.000.000 = $2.00
- Ausgabe: 200.000 × $10 / 1.000.000 = $2.00
- Zwischensumme: $4.00
| Komponente | Eingabekosten | Ausgabekosten | Gesamt |
|---|---|---|---|
| Fable-5.2-Hauptagent | $0.80 | $0.40 | $1.20 |
| 10 Sonnet-5.5-Subagents | $2.00 | $2.00 | $4.00 |
| Token-Gesamtkosten | $2.80 | $2.40 | $5.20 |
| Session Runtime (angenommen, eine Session läuft genau 8 Stunden) | — | — | $0.64 |
| Gesamtkosten des Beispiels (ohne Tool-Kosten) | — | — | $5.84 |
Wie wird die Session Runtime von Managed Agents abgerechnet?
Wenn Sie Claude Managed Agents verwenden, erscheint auf der Rechnung zusätzlich der Posten Session Runtime. Der Preis beträgt 0,08 $ pro Session-Stunde. Abgerechnet wird nur die Zeit, in der sich eine Session im Status „running“ befindet. Zeiten im Status „idle“, beim Warten auf eine Bestätigung durch den Nutzer und nach Beendigung der Session werden nicht berechnet. Die Tokens der Sub-Agents werden weiterhin separat zum jeweiligen Modellpreis abgerechnet.
Die 0,64 $ in der obigen Tabelle beruhen lediglich auf der Annahme, dass eine einzelne Session genau 8 Stunden läuft: 8 × 0,08 $ = 0,64 $. Die Runtime wird nach der Laufzeit der Session abgerechnet, nicht nach der Anzahl der Agents multipliziert mit einem Stundensatz pro Agent. Wenn mehrere Sessions in Ihrem System Laufzeit erzeugen, müssen Sie die tatsächliche Zeit im Status „running“ für jede Session einzeln berechnen und anschließend addieren. Die 0,64 $ sind daher kein feststehender Wert für die Betriebskosten eines Multi-Agent-Systems.
Wie verändern Caching, Batch und Tool-Aufrufe die Gesamtkosten?
Einige weitere Abrechnungsdetails können dazu führen, dass die tatsächliche Rechnung für denselben Workflow von 5,84 $ abweicht:
- Prompt Caching: Wenn der von den Sub-Agents gemeinsam genutzte System-Prompt und Projektkontext aus dem Cache abgerufen werden, kostet das Lesen nur 0,20 $/MTok. Das erstmalige Schreiben ist jedoch teurer als eine normale Eingabe. Bei zu wenigen Cache-Treffern lohnt es sich möglicherweise nicht.
- Batch API: Für Tokens in asynchronen Batch-Anfragen gibt es 50 % Rabatt. Managed Agents sind jedoch zustandsbehaftete, interaktive Sessions. Sie können daher nicht den Batch-Rabatt der Messages API nutzen. Der Rabatt von 50 % lässt sich nicht auf die Session-Gebühren anwenden.
- Tool-Aufrufe: Die Websuche in Managed Agents kostet 10 $ pro 1.000 Aufrufe. Bei Agents mit vielen Suchanfragen sollten Sie diese Kosten separat kalkulieren.
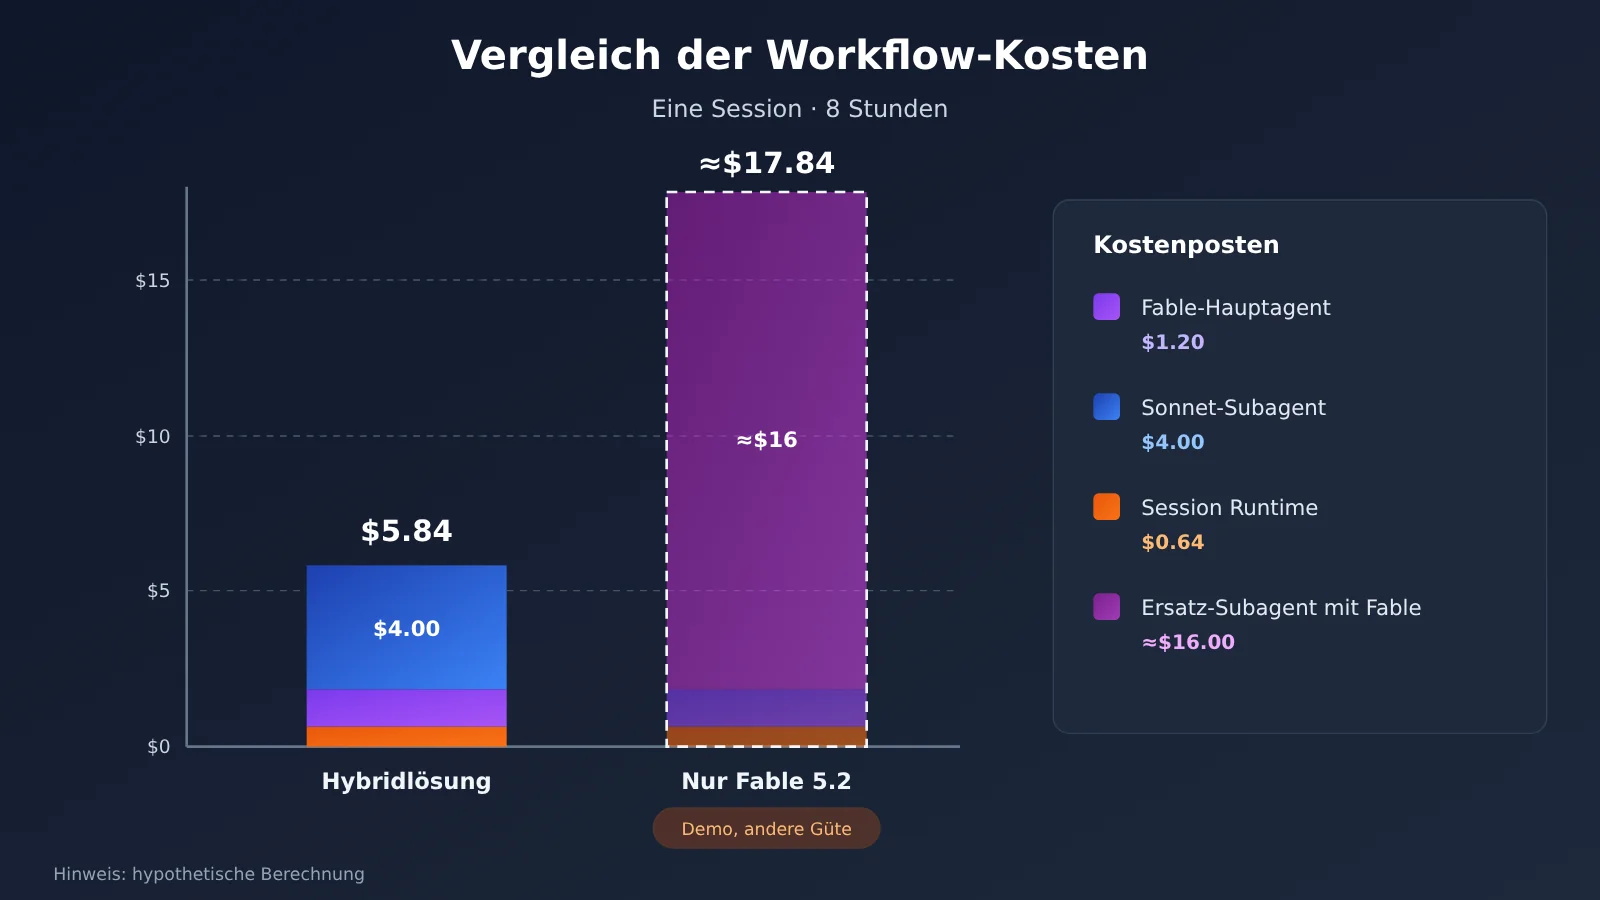
📊 Hinweis zur Abbildung: Die Daten in der Abbildung sind eine hypothetische Berechnung auf Basis öffentlich verfügbarer Listenpreise. Wenn Sie die Kosten Ihres Workflows schätzen möchten, können Sie zunächst mit wenigen echten Anfragen über APIYI apiyi.com einen Test durchführen, die tatsächliche Token-Anzahl aus dem Feld
usageder Antwort auslesen und anschließend mit der Preistabelle berechnen.
So senken Sie die Kosten eines Claude-Fable-5.2-Multi-Agent-Systems
Das folgende Minimalbeispiel zeigt, wie Sie die Nutzungsdaten aus einer Antwort auslesen und die Kosten eines einzelnen Aufrufs anhand der Preisliste schätzen. Ersetzen Sie den Modellnamen durch eine auf der Plattform tatsächlich verfügbare Modell-ID.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="claude-sonnet-model-id",  # Durch eine tatsächliche ID aus der Modellliste der Plattform ersetzen
    messages=[{"role": "user", "content": "总结这段需求文档的要点"}]
)
u = resp.usage
cost = u.prompt_tokens * 2 / 1e6 + u.completion_tokens * 10 / 1e6  # Listenpreis für Sonnet 5.5
print(resp.choices[0].message.content, f"估算费用: ${cost:.4f}")
Vollständigen Implementierungscode anzeigen: Aufrufe nach Modellstufe staffeln und Budget summieren
import openai

# Einheit: US-Dollar pro Million Token, basierend auf den veröffentlichten Preisen von Anthropic
PRICES = {
    "planner": {"model": "claude-fable-model-id", "in": 8, "out": 40},
    "worker":  {"model": "claude-sonnet-model-id", "in": 2, "out": 10},
    "simple":  {"model": "claude-haiku-model-id", "in": 0.10, "out": 0.50},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

class BudgetTracker:
    def __init__(self, limit_usd: float):
        self.limit = limit_usd
        self.spent = 0.0

    def add(self, tier: str, usage) -> float:
        p = PRICES[tier]
        cost = usage.prompt_tokens * p["in"] / 1e6 + usage.completion_tokens * p["out"] / 1e6
        self.spent += cost
        if self.spent > self.limit:
            raise RuntimeError(f"预算超限:已花费 ${self.spent:.2f}")
        return cost

def run(tier: str, prompt: str, tracker: BudgetTracker) -> str:
    resp = client.chat.completions.create(
        model=PRICES[tier]["model"],
        messages=[{"role": "user", "content": prompt}],
    )
    cost = tracker.add(tier, resp.usage)
    print(f"[{tier}] 本次 ${cost:.4f},累计 ${tracker.spent:.4f}")
    return resp.choices[0].message.content

tracker = BudgetTracker(limit_usd=10.0)
plan = run("planner", "把资料整理任务拆成 3 个独立子任务,每行一个", tracker)
results = [run("worker", f"执行子任务:{t}", tracker) for t in plan.splitlines() if t.strip()]
summary = run("planner", "汇总以下结果:\n" + "\n".join(results), tracker)
print(summary)
🚀 Tipp für den schnellen Einstieg: Testen Sie zunächst das kostenlose Startguthaben für neue Nutzer bei APIYI unter apiyi.com. Führen Sie mit dem Budget-Tracking-Skript oben den minimalen Ablauf „Planen – Ausführen – Zusammenfassen“ durch. Sobald Sie die tatsächliche Token-Verteilung kennen, können Sie die Zahl der Agents erhöhen.
Ausgehend von den oben genannten Abrechnungsregeln lassen sich fünf Methoden zur Kostenkontrolle zusammenfassen:
| Methode | Vorgehen | Grenzen des Einsatzes |
|---|---|---|
| Modell nach Schwierigkeitsgrad auswählen | Planung und komplexe Schlussfolgerungen Fable 5.2 oder Opus 5.5 überlassen | Offiziell wird empfohlen, bei den meisten Aufgaben mit Opus 5.5 zu starten |
| Einfache Teilaufgaben mit einem kleineren Modell bearbeiten | Klassifizierung, Formatierung und Extraktion Sonnet 5.5 oder Haiku 5.5 überlassen | Zuerst prüfen, ob die Qualität des günstigeren Modells ausreicht |
| Prompt Caching aktivieren | Gemeinsame System-Prompts, Tool-Beschreibungen und lange Dokumente zwischenspeichern | Die Einsparungen hängen davon ab, wie oft der Cache getroffen wird und wie einheitlich der Kontext ist |
| Fast Mode gezielt aktivieren | Nur für interaktive Anfragen verwenden, bei denen die Latenz entscheidend ist | Verdoppelt den Preis und lohnt sich nicht für Offline-Aufgaben |
| Budget und Monitoring | Verbrauch nach Modell, Agent und Aufgabe erfassen und Obergrenzen festlegen | Je früher Sie das einführen, desto eher erkennen Sie ungewöhnlich hohen Verbrauch |
Auch die Grenzen der Batch API sollten berücksichtigt werden: Sie eignet sich für Aufgaben, die asynchrone Verarbeitung erlauben, etwa die Klassifizierung großer Dokumentenmengen, die Offline-Inhaltserstellung oder die nicht echtzeitfähige Datenanalyse. Sie ist jedoch nicht für jede lang laufende Agent-Session geeignet.
Die Rolle von API-Gateways im Zeitalter von Claude Fable 5.2 und Multi-Agent-Systemen
Vercel gab am 9. November 2026 bekannt, dass Claude Fable 5.2 in das AI Gateway integriert wird. Die Modell-ID lautet anthropic/claude-fable-5.2. Das ist ein konkretes Beispiel dafür, wie ein Gateway mit mehreren Modellen funktionieren kann. Unterstützt werden unter anderem AI SDK, OpenAI Chat Completions, OpenAI Responses und Anthropic Messages. Entwickler können die Modelle über einen einheitlichen Zugang aufrufen.
Auf der Routing-Ebene lässt sich dasselbe Modell bei verschiedenen Anbietern wie Anthropic, AWS Bedrock und Google Vertex AI nutzen. Die Anbieter können nach Preis, Latenz bis zum ersten Token oder Durchsatz sortiert werden. Das von Vercel gezeigte Fallback-Beispiel sieht vor, zunächst Fable 5.2 aufzurufen. Wird die Anfrage vom Sicherheitsklassifikator abgelehnt, wird nacheinander auf Opus 5.5 und Sonnet 5.5 gewechselt. Darüber hinaus stehen Nutzungsberichte, Kostenstatistiken, Budgets für API-Schlüssel sowie Retry- und Failover-Funktionen zur Verfügung.
Warum benötigt ein Multi-Agent-System eine solche Infrastruktur dringender als ein einfacher Chat? Scheitert ein Chat-Aufruf, kann der Nutzer die Anfrage erneut senden. In einem Agent-Workflow, der über mehrere Tage läuft, kann ein einzelner fehlgeschlagener Aufruf dagegen die gesamte Aufgabenfolge blockieren. Wiederholungsversuche treiben zudem den Token-Verbrauch in die Höhe. Modellauswahl, Aufrufverwaltung, Failover und Kostenübersicht sind in Multi-Agent-Systemen daher keine nette Zugabe mehr, sondern unverzichtbar.
🎯 Technischer Hinweis: Für Entwickler in China bietet APIYI unter apiyi.com eine Multi-Modell-Zugangsschicht nach einem ähnlichen Prinzip: Mit einem API-Schlüssel lassen sich gängige Modelle wie OpenAI, Claude und Gemini aufrufen. Die OpenAI-kompatible Schnittstelle verringert die Unterschiede zwischen den APIs verschiedener Anbieter. Dank nutzungsbasierter Abrechnung können die Kosten einzelnen Agents und Aufgaben zugeordnet werden.
Datenaufbewahrung bei Claude Fable 5.2: Compliance-Fragen für Unternehmen mit Multi-Agent-Anwendungen
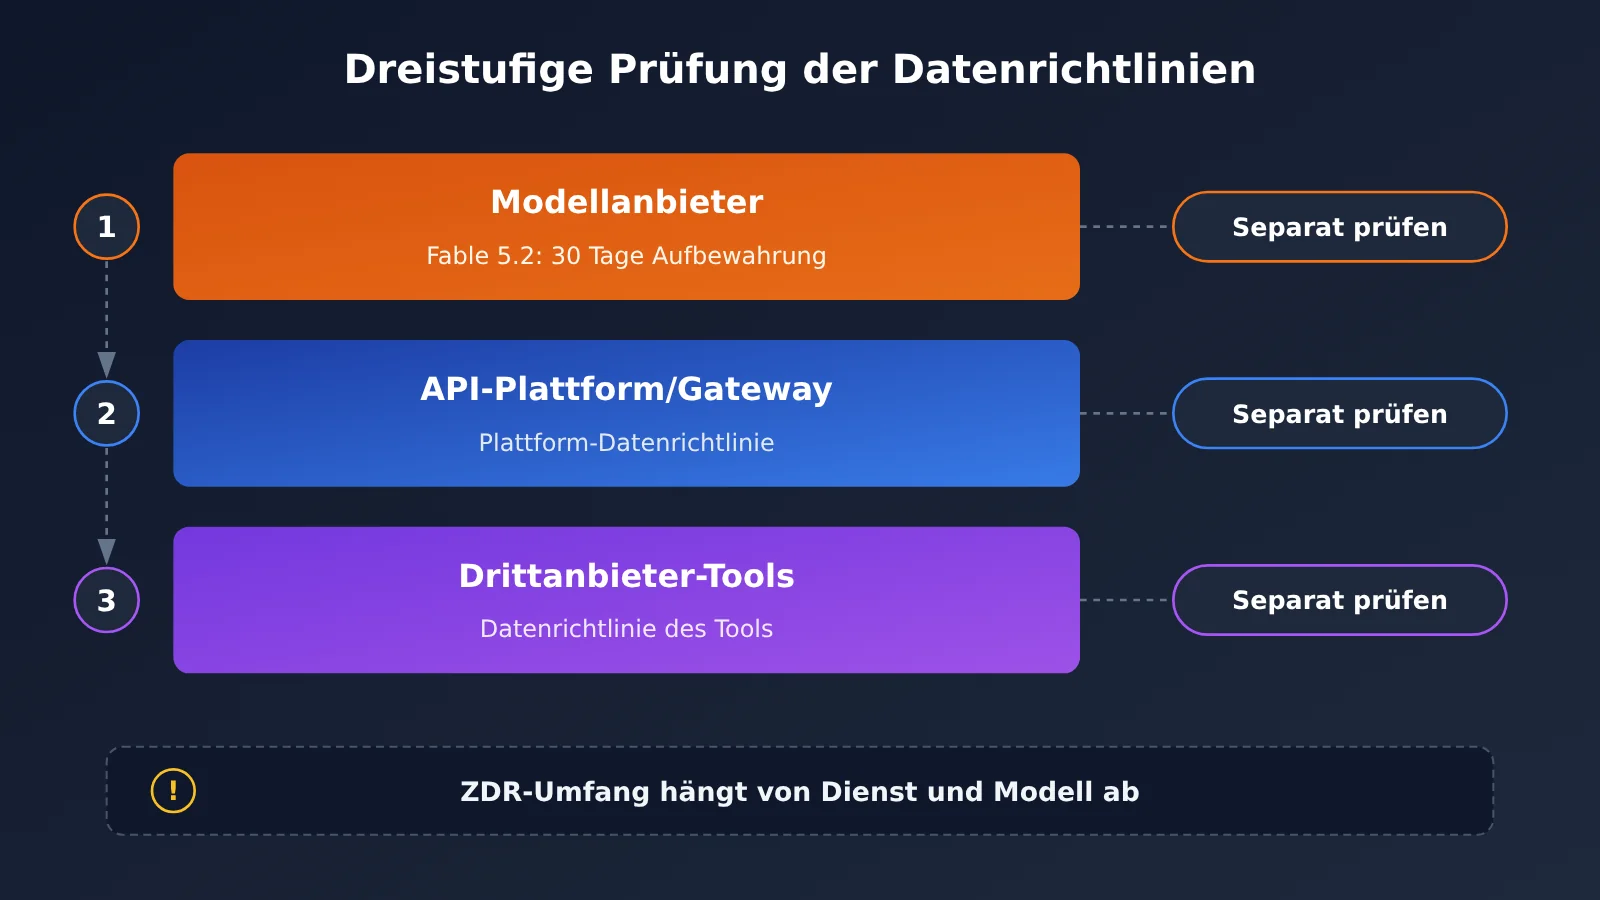
Neben den Kosten müssen Unternehmen auch die Datenschutz- und Compliance-Anforderungen im Blick behalten. Laut der offiziellen Dokumentation von Anthropic zur Datenaufbewahrung ist Fable 5.2 ein Covered Model, für das eine Datenaufbewahrung von 30 Tagen gilt. Zero Data Retention (ZDR) wird standardmäßig nicht unterstützt.
Die konkreten Regeln lauten: Organisationen können das Modell standardmäßig nicht im Rahmen einer ZDR-Vereinbarung aufrufen, sofern Anthropic dies nicht ausdrücklich genehmigt. Eingabeaufforderungen und Modellausgaben werden gemäß den geltenden Richtlinien 30 Tage lang aufbewahrt. Die gespeicherten Daten werden ohne ausdrückliche Genehmigung nicht zum Trainieren von Modellen verwendet. Berechtigte ZDR-Organisationen können in einem bestimmten Workspace eine 30-tägige Datenaufbewahrung aktivieren, um das Modell zu nutzen. Auch die Ankündigung zur Integration von Vercel weist ausdrücklich auf diese Anforderung hin.
Ein Punkt sorgt leicht für Verwirrung: Die Datenrichtlinien des Modellanbieters und die eines API-Gateways eines Drittanbieters sind nicht dasselbe. Selbst wenn eine API-Plattform selbst ZDR anbietet, bedeutet das nicht, dass jedes dort integrierte Modell ZDR unterstützt. Unternehmen, die sensible Geschäftsdaten verarbeiten, sollten deshalb die jeweiligen Richtlinien zur Datenverarbeitung des Modellanbieters, der API-Plattform und der Drittanbietertools prüfen – und nicht nur die Preise der Modelle vergleichen.
Häufige Fragen (FAQ)
F1: Wie viel hat das Experiment mit dem Betriebssystem aus 1.000 Agenten von Claude Fable 5.2 gekostet?
Anthropic hat dazu keine Angaben veröffentlicht. Weder den gesamten Token-Verbrauch noch die Rechenkosten oder die Gesamtkosten des Experiments hat das Unternehmen offengelegt. Konkrete Zahlen, die online kursieren, sind keine offiziellen Angaben.
F2: Sind Multi-Agent-Systeme immer drei- bis zehnmal teurer als einzelne Agenten?
Nicht unbedingt. Das ist die typische Vergleichsspanne, die Anthropic für dieselbe Aufgabe angibt – kein fester Multiplikator. Wie groß der tatsächliche Unterschied ausfällt, hängt davon ab, wie viele Kontexte wiederholt werden, wie oft Aufgaben übergeben werden, welche Modelle zum Einsatz kommen und wie häufig der Cache greift.
F3: Wird die Session Runtime pro Agent abgerechnet?
Nein. Bei Managed Agents wird die Dauer abgerechnet, während der eine Session den Status „running“ hat. Der Preis beträgt 0,08 $ pro Session-Stunde. Zeiten im Status „idle“, beim Warten auf eine Bestätigung oder nach der Beendigung werden nicht berechnet. Bei mehreren Sessions werden die tatsächlichen Laufzeiten jeder Session einzeln berechnet und anschließend addiert.
F4: Gilt der Rabatt von 50 % für die Batch API auch für Managed Agents?
Nein. Der Batch-Rabatt gilt für asynchrone Batch-Anfragen über die Messages API. Managed Agents sind zustandsbehaftete, interaktive Sessions und erhalten diesen Rabatt nicht. Außerdem lässt sich Fast Mode nicht gleichzeitig mit der Batch API verwenden.
F5: Wie lässt sich der tatsächliche Aufwand für die Aufteilung von Aufgaben auf mehrere Modelle schnell testen?
Wir empfehlen diese drei Schritte:
1. Registrieren Sie sich bei APIYI unter apiyi.com und holen Sie sich einen API-Schlüssel sowie ein kostenloses Testguthaben.
2. Setzen Sie `base_url` im Code dieses Artikels auf `https://api.apiyi.com/v1` und ersetzen Sie die Modell-IDs durch verfügbare Modelle auf der Plattform.
3. Führen Sie mit einem Budget-Tracking-Skript Aufgaben in kleinem Umfang aus und protokollieren Sie die tatsächliche Token-Verteilung auf die verschiedenen Modellstufen.
F6: Welche Einschränkungen von Claude Fable 5.2 sollten Sie beachten?
Erstens ist der Preis mit 40 $ pro MTok für Ausgaben hoch, weshalb sich das Modell nicht für alle Teilaufgaben eignet. Zweitens verdoppelt Fast Mode den Preis. Drittens gilt eine Aufbewahrungsfrist von 30 Tagen für Daten; standardmäßig ist kein Aufruf im Rahmen einer ZDR-Vereinbarung möglich. Prüfen Sie unbedingt die Compliance-Anforderungen, bevor Sie sensible Daten verarbeiten.
Claude Fable 5.2: Die wichtigsten Erkenntnisse zu den Kosten für Multi-Agent-Systeme
- Rechnung nicht veröffentlicht: Anthropic hat die tatsächlichen Kosten des Experiments mit 1.000 Agenten nicht offengelegt.
- 20 % niedrigere Preise: Der Standardpreis für Fable 5.2 beträgt 8 US-Dollar pro Million Eingabe-Token und 40 US-Dollar pro Million Ausgabe-Token.
- Kosten können sich vervielfachen: Bei derselben Aufgabe verbrauchen Multi-Agent-Systeme typischerweise drei- bis zehnmal so viele Token wie ein einzelner Agent.
- Runtime wird pro Session abgerechnet: 0,08 US-Dollar pro Session-Stunde. Es zählt nur die Laufzeit; die Anzahl der Agenten spielt keine Rolle.
- Rabatte gelten nicht überall: Der Batch-Rabatt von 50 % gilt nicht für Managed Agents. Wie viel sich durch Caching sparen lässt, hängt von der Trefferquote ab.
- Compliance nicht übersehen: Für Fable 5.2 gilt eine Datenaufbewahrungsfrist von 30 Tagen. ZDR muss zusätzlich genehmigt werden.
- Erst testen, dann skalieren: Mit APIYI auf apiyi.com lässt sich über eine einheitliche Schnittstelle prüfen, wie sich die Token bei der Aufgabenverteilung auf mehrere Modelle tatsächlich verteilen.
Zusammenfassung
Das Experiment mit 1.000 Agenten in Claude Fable 5.2 lenkt den Blick bei den Kosten weg von „Was kostet ein einzelner Aufruf?“ und hin zu „Was kostet der gesamte Workflow?“. Die wichtigsten Punkte:
- Die Kosten setzen sich aus mehreren Ebenen zusammen: Haupt-Agent, Unteragenten, wiederholter Kontext, Validierung, Wiederholungsversuche, Session-Runtime und Tool-Aufrufe fließen gemeinsam in die Rechnung ein.
- Die Aufgabenverteilung zwischen den Modellen macht den größten Unterschied: Das leistungsstärkste Modell sollte nur für Planung und wichtige Schlussfolgerungen eingesetzt werden. Ausführende Teilaufgaben können günstigere Modelle übernehmen.
- Abrechnungsregeln genau prüfen: Die Runtime wird nach der Laufzeit der Session abgerechnet. Batch gilt nicht für Managed Agents, und Caching lohnt sich erst ab einer ausreichend hohen Zahl von Treffern.
- Compliance ist genauso wichtig wie der Preis: Die 30-tägige Datenaufbewahrung und die Einschränkungen für ZDR sollten bereits bei der Modellauswahl berücksichtigt werden.
Je komplexer eine Multi-Agent-Anwendung ist, desto wichtiger sind ein stabiler Modellzugang, eine transparente Nutzungsstatistik und ein zuverlässiger Failover. Über die einheitliche Schnittstelle von APIYI auf apiyi.com können Sie verschiedene Modelle schnell in einer Aufgabenverteilung testen. Planen Sie das Budget auf Grundlage realer Token-Daten und erweitern Sie anschließend schrittweise die Zahl der Agenten.
📚 Quellen
- Ankündigung von Anthropic: Claude Fable 5.2 und Mythos 5.2
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Beschreibung: Offizielle Informationen zum Betriebssystemexperiment mit 1.000 Agents
-
Modellspezifikationen und Preise der Claude Platform: Fable 5.2 – Überblick
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Beschreibung: Preise, Kontextfenster, Effort und weitere Spezifikationen
-
Preise für Claude Managed Agents: Abrechnungsregeln für die Session Runtime
- Link:
platform.claude.com/docs/en/about-claude/pricing -
Beschreibung: Runtime, Web Search und vollständige API-Preise
-
Dokumentation zum Prompt Caching: Informationen zum Schreiben und Lesen des Caches
- Link:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Beschreibung: Automatisches Caching und explizite Cache-Grenzpunkte
-
Richtlinien zur API-Datenspeicherung: Covered Models und ZDR
- Link:
platform.claude.com/docs/en/manage-claude/api-and-data-retention -
Beschreibung: Offizielle Grundlage für die vorgeschriebene Datenspeicherung über 30 Tage
-
Ankündigung zur Integration in Vercel AI Gateway: Fable 5.2 ist verfügbar
- Link:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway - Beschreibung: Beispiele für Multi-Anbieter-Routing, Fallback und Kostenverwaltung
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.