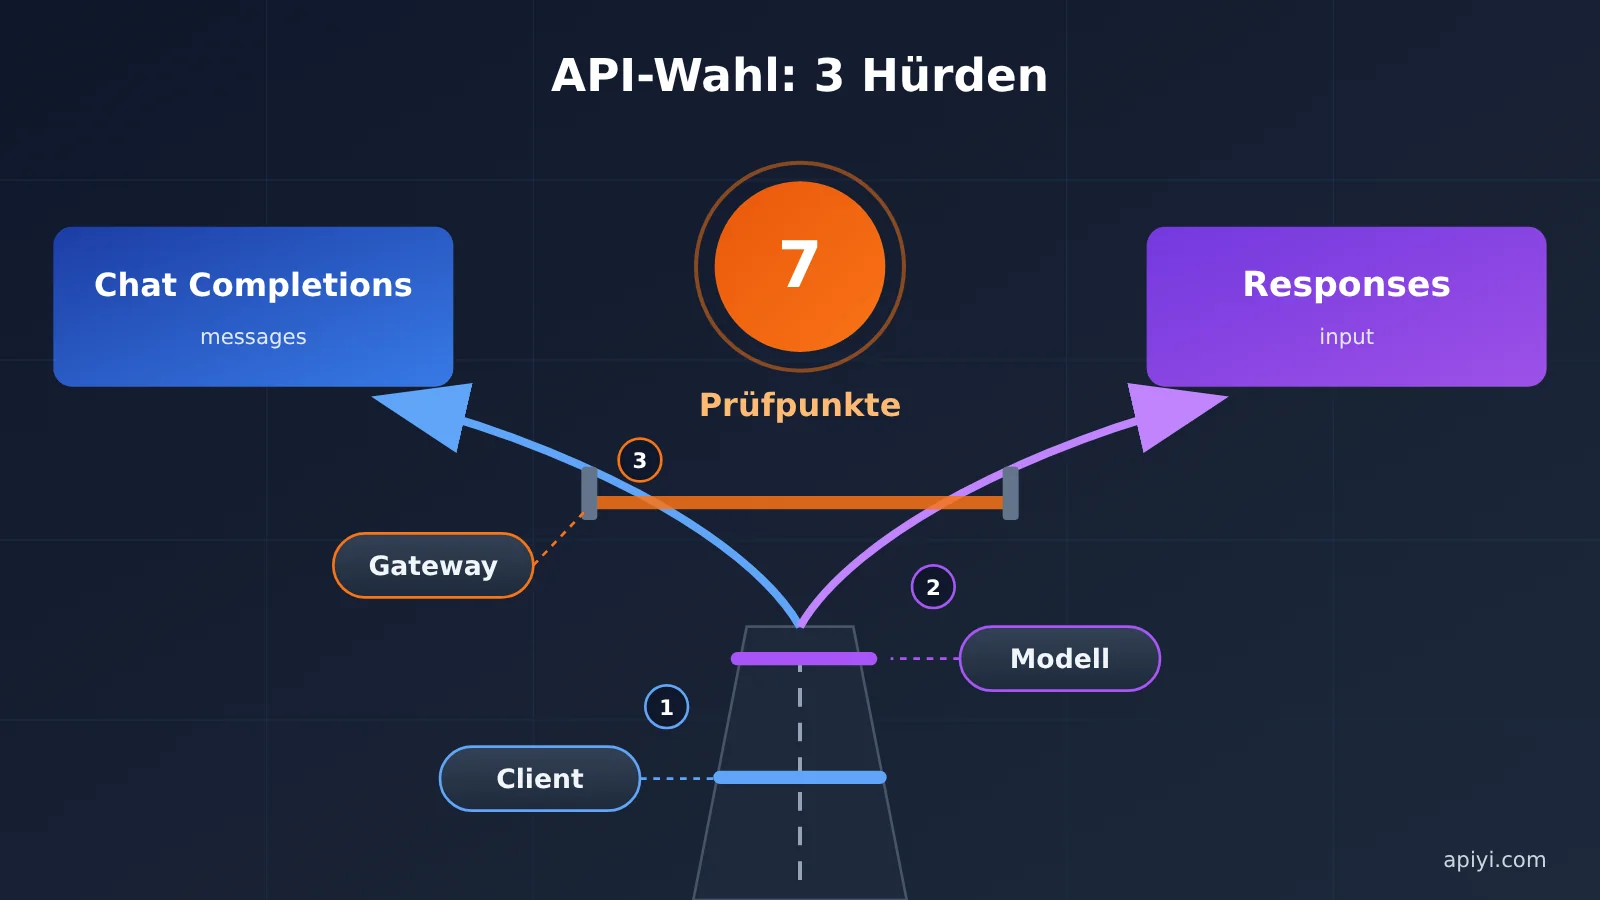
Das Fazit vorweg: Ob Responses oder Chat Completions die richtige Wahl ist, hängt nicht davon ab, welche Schnittstelle neuer ist. Entscheidend ist das Zusammenspiel von Client, Modell und Gateway. Der Client bestimmt, welche Anfragen Sie senden können. Das Modell bestimmt, welcher Endpunkt die benötigten Funktionen bietet. Und das Gateway entscheidet, ob die Anfrage unverändert beim Upstream ankommt.
Stellen Sie also nicht allein deshalb die Schnittstelle um, weil Sie ein neues Modell anbinden möchten. Als Faustregel gilt: Unterstützt der Client eine Schnittstelle nicht, hilft auch deren Aktualität nicht weiter. Unterstützt das Modell nur einen Endpunkt, erzwingen Sie nicht den anderen. Die folgenden 7 Prüfpunkte, die Entscheidungstabelle für verschiedene Szenarien und die Rollback-Checkliste helfen Ihnen, Inkompatibilitäten bei Tool-Aufrufen, Reasoning-Parametern oder Streaming-Ereignissen vor dem Produktivstart zu erkennen.
Was ist der Unterschied zwischen Responses und Chat Completions?
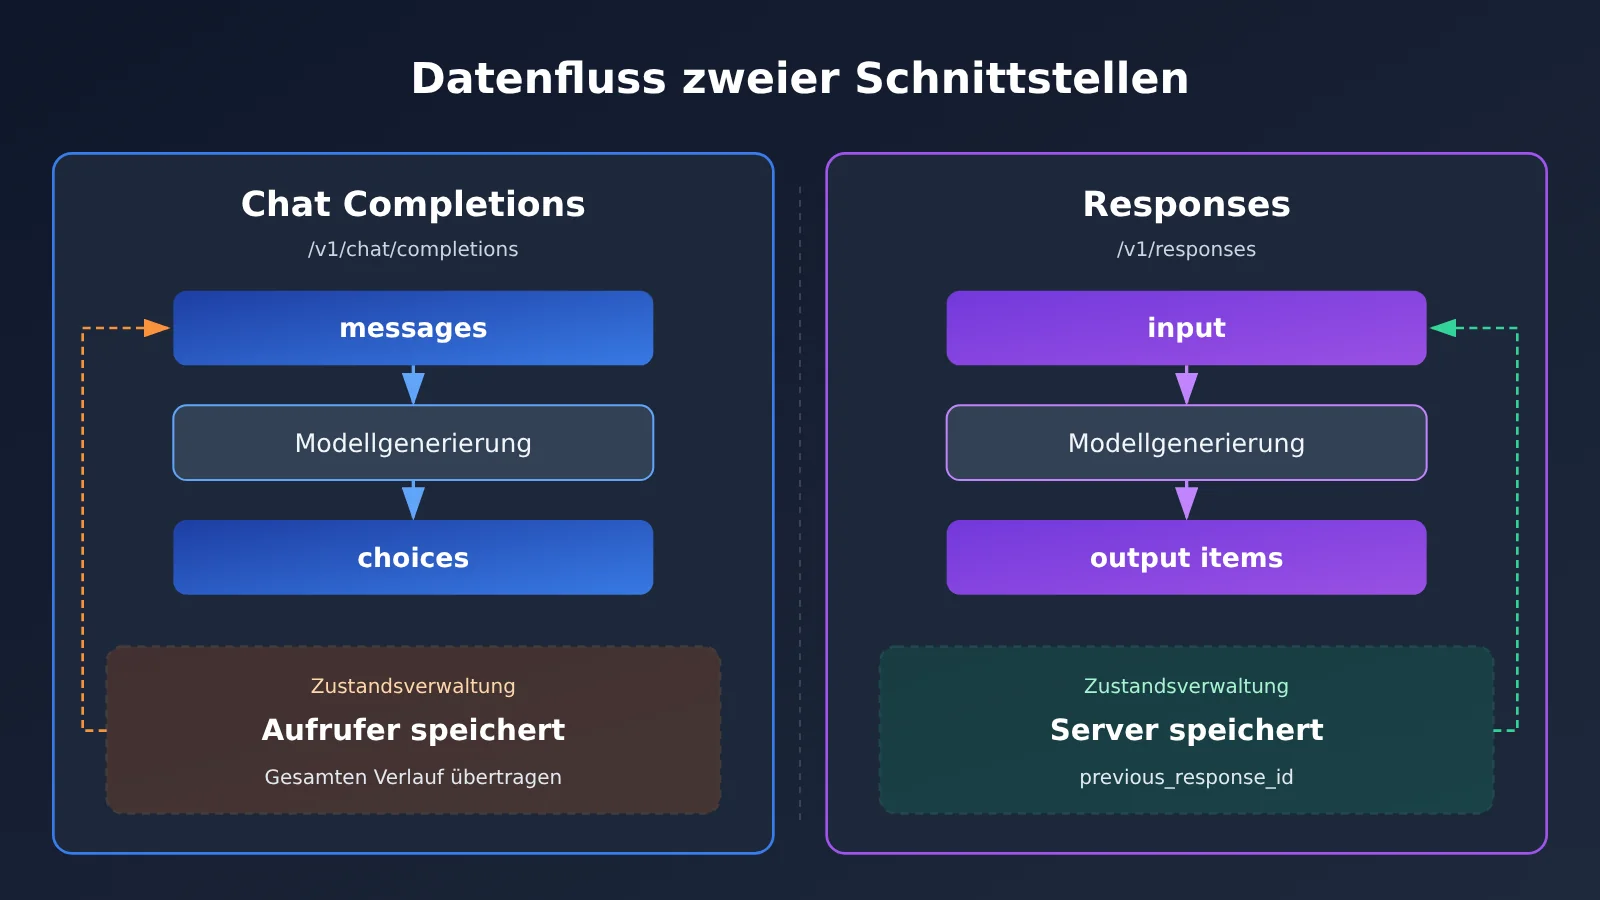
Der wichtigste Unterschied liegt im Datenmodell: Chat Completions arbeitet mit einem Nachrichten-Array, Responses mit einem Antwortobjekt.
Bei Chat Completions steht im Request messages im Mittelpunkt. Jede Nachricht enthält role und content; weitere häufige Felder sind temperature, max_tokens, tools und stream. Die Schnittstelle ist zustandslos: Die aufrufende Anwendung verwaltet den Gesprächsverlauf. Aus der Antwort lassen sich message und finish_reason unter choices auslesen, der Verbrauch steht in usage. Chat Completions wird von den meisten SDKs und Clients unterstützt.
Bei Responses steht im Request input im Mittelpunkt. Hinzu kommen optional tools, reasoning und previous_response_id. Die Antwort enthält das Array output sowie output_text, status, id und usage. Einige neuere Reasoning-Modelle und Tool-Funktionen sind nur über Responses verfügbar. Allerdings unterstützen nicht alle Modelle, SDKs, Clients und Gateways diese Schnittstelle.
| Prüfpunkt | Chat Completions | Responses | Migrationsrisiko |
|---|---|---|---|
| Endpunkt und Request-Struktur | /v1/chat/completions, verwendet messages |
/v1/responses, verwendet input |
Pfad oder Request-Body passen nicht, Parsing-Code funktioniert nicht mehr |
| Zustand bei mehreren Gesprächsrunden | Die aufrufende Anwendung übermittelt den vollständigen Verlauf | previous_response_id kann auf die vorherige Runde verweisen |
Zustand läuft ab, Kontext ist inkonsistent |
| Reasoning- und Token-Parameter | max_tokens oder max_completion_tokens |
Reasoning wird über reasoning konfiguriert |
Parameter werden ignoriert oder lösen einen Fehler aus |
| Tool-Aufrufe | tools und Tool-Ergebnisse innerhalb von Nachrichten |
Tool-Einträge in output und zugehörige Ergebniseinträge |
Aufruf-IDs werden falsch zugeordnet, die Agent-Schleife bricht ab |
| Streaming-Ereignisse | Inkrementelle SSE-Fragmente | Typisierte SSE-Ereignisse | Vorzeitiges Ende, Fehler beim Zusammenfügen von Text |
| Multimodale Eingaben | Häufig image_url-Inhaltsfragmente |
Häufig Eingabeeinträge wie input_image |
Bilder oder Dateien werden abgelehnt |
| Kompatibilität | Breite Unterstützung durch Clients und Gateways | Abhängig von Client, Gateway und Modell | Die Base URL lässt sich eintragen, der Endpunkt aber nicht aufrufen |
Prüfen Sie die folgenden Punkte in dieser Reihenfolge. Wenn Anforderungen miteinander kollidieren, stellen Sie zuerst sicher, dass Client und Modell zusammen funktionieren:
- Zuerst der Client: Unterstützt er Chat Completions, Responses oder das native Format des Anbieters?
- Dann das Modell: Ist das gewünschte Modell nur über einen bestimmten Endpunkt verfügbar? Benötigt es integrierte Tools oder Reasoning-Einträge?
- Danach das Gateway: Leitet es Anfragen an den gewünschten Endpunkt weiter? Unterstützt es Modellzuordnung und Protokollierung?
- Zuletzt die Kosten: Unterscheiden sich bei derselben Aufgabe die Kosten für Token, Caching und Wiederholungsversuche zwischen den beiden Schnittstellen?
Empfehlung für die Anbindung: Die Vergleichstabelle hilft dabei, Risiken zu erkennen. Welchen Endpunkt ein Modell tatsächlich unterstützt, sollten Sie in Ihrer konkreten Umgebung prüfen. Schauen Sie zunächst in der Konsole von APIYI apiyi.com nach dem gewünschten Modell und entscheiden Sie dann, welchen Weg Sie testen möchten.
Anfragen prüfen: Checks 1–3 für die Responses-Anbindung
Für die Anfrage gilt: Wenn Endpunkt, Status und Parameter nicht zusammenpassen, brauchen Sie Tools und Streaming noch nicht zu testen.
Check 1: Endpunkte und Anfrageformate von Responses und Chat Completions
Prüfen Sie, ob die Anfrage an den richtigen Pfad geht und ob Anfragekörper und Antwortverarbeitung auf die jeweilige Struktur abgestimmt sind.
- Der Unterschied: Chat Completions verwendet
/v1/chat/completions, Responses verwendet/v1/responses. Ersteres übermitteltmessagesund liestchoices, Letzteres übermitteltinputund liestoutput. - Typische Falle: Nur den Pfad ändern, aber nicht die Antwortverarbeitung. Die Anfrage kann erfolgreich sein, während der Anwendungscode nicht auf
choices[0].messagezugreifen kann. Es sieht dann so aus, als hätte das Modell keinen Inhalt zurückgegeben. - So prüfen Sie es: Senden Sie jeweils eine minimale Textanfrage an beide Endpunkte und protokollieren Sie den Statuscode, die Felder auf oberster Ebene der Antwort und
usage. Bei der OpenAI-kompatiblen Schnittstelle von APIYI lautet die Base URLhttps://api.apiyi.com/v1. Ob der gewünschte Endpunkt und das Modell verfügbar sind, entnehmen Sie der Konsole und der Dokumentation. - So wählen Sie: Wenn das Modell beide Schnittstellen unterstützt und Ihre Anwendung nur Text benötigt, können Sie die bestehende Schnittstelle weiterverwenden. Ist das Modell nur über einen bestimmten Endpunkt verfügbar, passen Sie die Anbindung entsprechend an.
Prüfung 2: Zustandsverwaltung über mehrere Gesprächsrunden bei Chat Completions und Responses
Wo der Zustand gespeichert wird, bestimmt die Fehlerdiagnose und beeinflusst, wie gut sich der Kontext kontrollieren lässt.
- Unterschied: Bei Chat Completions wird in jeder Runde das vollständige
messages-Array übergeben. Responses kann mitprevious_response_idauf die vorherige Antwort verweisen und einen Teil des Zustands dem Server überlassen. - Typische Stolperfallen: Weniger Inhalte zu übertragen bedeutet nicht automatisch niedrigere Kosten. Ob der bisherige Kontext weiterhin als Eingabe-Token berechnet wird, zeigen die offizielle Dokumentation und die tatsächliche Abrechnung. Eine weitere Falle ist ein abgelaufener Zustand: Wird eine lang laufende Aufgabe fortgesetzt, ist die alte Response-ID möglicherweise nicht mehr verwendbar.
- So lässt es sich prüfen: Drei Gesprächsrunden nacheinander ausführen und sicherstellen, dass die dritte Runde auf Informationen aus der ersten zugreifen kann. Anschließend mit einer älteren ID den Fehlerfall testen und prüfen, ob der Fehler erkennbar ist. Gibt es hinter dem Gateway mehrere Upstream-Verbindungen, außerdem prüfen, ob die ID anfrageübergreifend weiterverwendet werden kann. Entscheidend ist, was das Gateway unterstützt.
- So fällt die Wahl: Wer den Kontext vollständig kontrollieren sowie einfach prüfen und kürzen möchte, überträgt am besten den gesamten Verlauf. Responses lohnt sich, wenn lange Gespräche oder Agent-Schleifen tatsächlich vom serverseitigen Zustand profitieren.
Prüfung 3: Reasoning- und Token-Parameter bei der Migration zu Responses
Das größte Risiko bei Parametern ist oft keine Fehlermeldung, sondern dass sie stillschweigend ignoriert werden: Die Anfrage ist erfolgreich, aber die Reasoning-Konfiguration greift nicht.
- Unterschiede: Bei einigen neueren Modellen wurde
max_tokensdurchmax_completion_tokensersetzt. Das alte Feld kann ignoriert werden oder einen Fehler auslösen. Auch die Bezeichnung für die Reasoning-Intensität unterscheidet sich je nach Anbieter und Schnittstelle. Gebräuchlich sind etwa Reasoning Effort undthinking. - Typische Falle: Dieselbe Parametervorlage für alle Modelle verwenden. Verwerfen Client oder Gateway unbekannte Felder, sieht die Antwort zwar normal aus, Reasoning-Tiefe und Ausgabelimit entsprechen aber möglicherweise nicht den eingestellten Werten.
- So prüfen Sie es: Ändern Sie Ausgabelimit und Reasoning-Intensität einzeln und vergleichen Sie die Länge der Antworten,
usageund Fehlermeldungen. Gibt es keinen Unterschied, prüfen Sie zunächst, ob der Parameter weitergegeben und vom Modell unterstützt wird. Ziehen Sie dann die offizielle Dokumentation und die Gateway-Dokumentation hinzu. - So treffen Sie die Wahl: Pflegen Sie eine Parameterzuordnung pro Kombination aus Modell und Endpunkt, statt grob nach Anbieter zu kategorisieren. Wenn Ihre Anwendung von der
reasoning-Konfiguration abhängt, bevorzugen Sie einen Schnittstellenpfad, der dieses Feld unverändert weitergibt.
Fähigkeiten prüfen: Checks 4–6 für die Migration von Chat Completions
Das Fazit auf der Fähigkeitsebene: Beide Schnittstellen können dieselbe Funktion unterstützen, aber der Parsing-Code lässt sich in der Regel nicht direkt wiederverwenden.
Check 4: Tool-Aufrufe mit Chat Completions und Responses
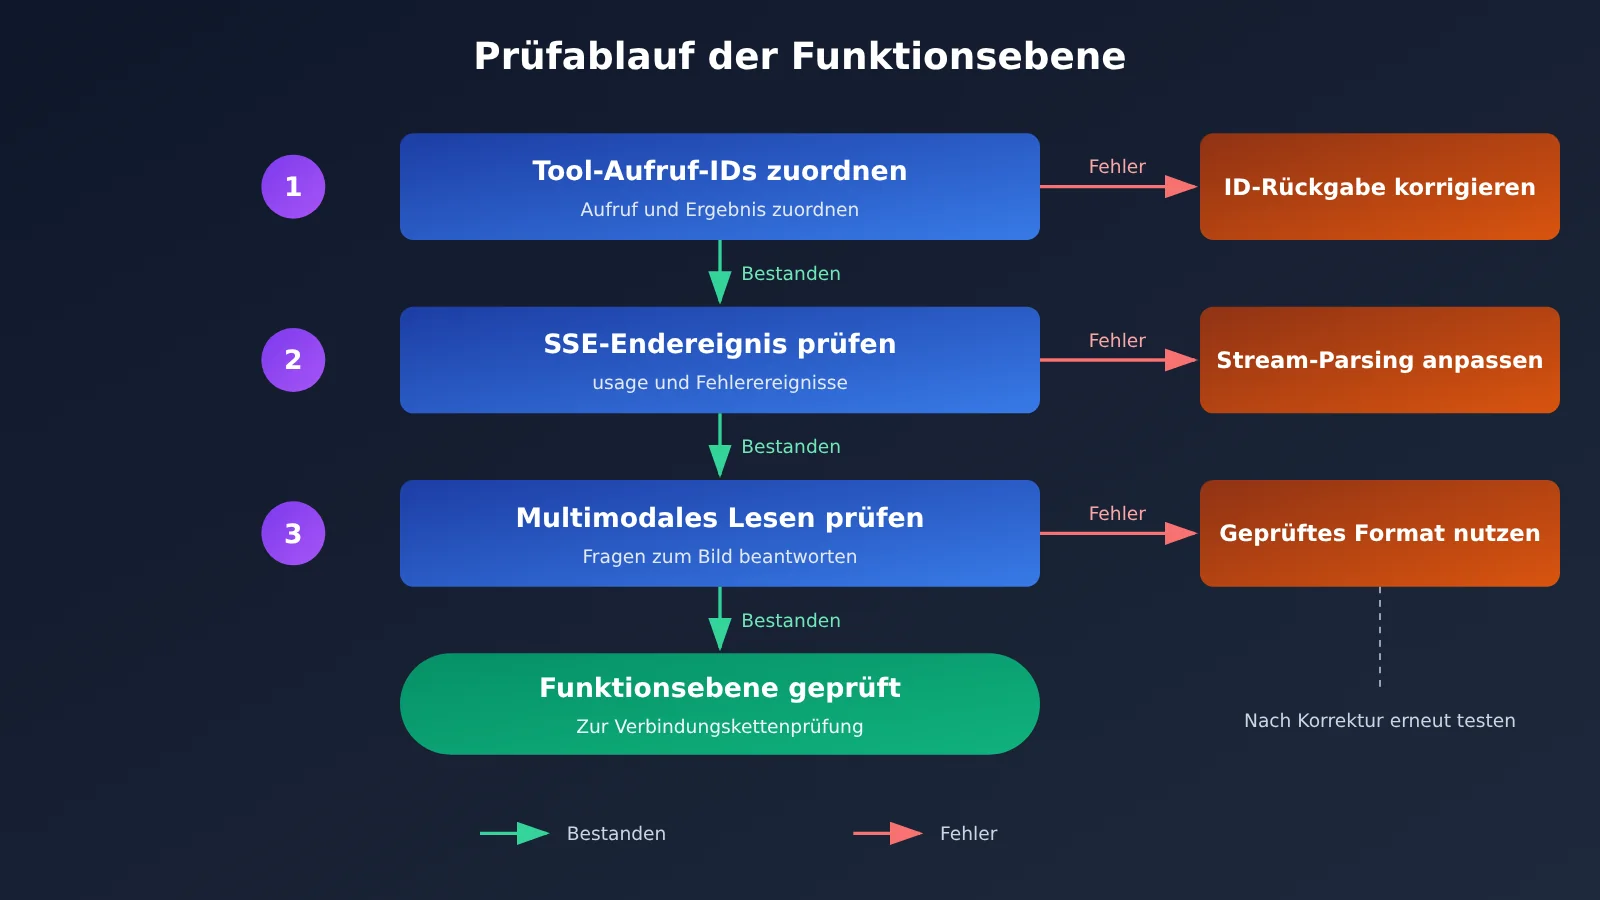
Chat Completions unterstützt Tool-Aufrufe. Migriert werden müssen vor allem das Tool-Schema, die Aufruf-IDs und die Art, wie Ergebnisse zurückgegeben werden.
- Unterschied: Beide Schnittstellen unterstützen Tool-Definitionen, aber ihre Strukturen unterscheiden sich. Bei Chat Completions stehen Aufrufe normalerweise in
tool_callsinnerhalb einer Assistant-Nachricht. Responses gibt Aufrufe alsoutput-Einträge zurück; die Ergebnisse müssen über die entsprechenden Eingabeeinträge zurückgegeben werden. Die konkreten Felder finden Sie in der offiziellen Dokumentation. - Typische Stolperfallen: Bei parallelen Aufrufen nur das erste Tool verarbeiten oder eine Aufruf-ID vor der Rückgabe verändern. In der nächsten Runde kann das Modell einen Fehler melden oder mit dem falschen Ergebnis weiterarbeiten. Letzteres ist schwerer zu erkennen.
- So prüfen Sie es: Bereiten Sie einen Testfall mit einem einzelnen und einen mit parallelen Tool-Aufrufen vor. Prüfen Sie, ob jede Aufruf-ID unverändert zurückgegeben wird und die Ergebnisse korrekt zugeordnet sind. Lassen Sie anschließend ein Tool absichtlich fehlschlagen und prüfen Sie, ob die Agent-Schleife sauber beendet wird.
- So entscheiden Sie: Wenn Ihre bestehende Toolchain stabil läuft und Sie keine integrierten Tools benötigen, bleiben Sie bei Chat Completions. Sind die integrierten Tools des Zielmodells nur über Responses verfügbar, migrieren Sie und schreiben die Parsing-Schicht um.
Check 5: Streaming-Ereignisse bei Responses und Chat Completions
Beim Streaming reicht es nicht zu prüfen, ob Text ausgegeben wird. Auch der Abschluss und die Fehlerbehandlung müssen funktionieren.
- Unterschied: Beide Schnittstellen basieren auf SSE, verwenden aber unterschiedliche Ereignistypen und Abschlussmarkierungen. Chat Completions liefert vor allem inkrementelle Fragmente; Responses unterscheidet durch verschiedene Ereignistypen zwischen Text, Tools und Abschlussstatus.
- Typische Stolperfallen: Den Empfang von
databereits als Abschluss werten oder nur Textfragmente zusammensetzen, ohne inkrementelle Tool-Parameter und Fehlerereignisse zu verarbeiten. Dadurch können Antworten abgeschnitten und Tool-Parameter unvollständig sein. - So prüfen Sie es: Zeichnen Sie einen vollständigen SSE-Rohdatenstrom auf. Prüfen Sie die Reihenfolge der Fragmente, das Abschlussereignis, die Stelle, an der
usageerscheint, und das Verhalten bei Fehlern während der Übertragung. Wenn das Gateway Ereignisse umwandelt oder puffert, zeichnen Sie den Datenstrom auch hinter dem Gateway auf. - So entscheiden Sie: Wenn der Streaming-Parser Ihres Clients nur das Chat-Completions-Format versteht, wechseln Sie nicht direkt zu Responses. Aktualisieren Sie vorher das SDK oder passen Sie die Parsing-Schicht an.
Check 6: Multimodale Eingaben bei der Responses-Anbindung
Welche multimodalen Felder verfügbar sind, hängt sowohl von der Schnittstelle als auch vom Anbieter ab. Ein erfolgreicher Texttest bedeutet nicht, dass auch Bilder und Dateien funktionieren.
- Unterschied: Bildfelder können
image_url,input_imageoder base64 verwenden. Auch die Eingabe von Dateien und Audio hängt von der Schnittstelle und dem Anbieter ab. - Typische Stolperfallen: Die alte Struktur für Inhaltsfragmente übernehmen oder davon ausgehen, dass sowohl URL als auch base64 funktionieren. Bei der Formatumwandlung im Gateway können außerdem Unterschiede bei Größe, Kodierung oder Dateityp auftreten.
- So prüfen Sie es: Senden Sie jeweils eine minimale Anfrage mit einem Bild per URL, einem base64-Bild und dem benötigten Dateityp. Prüfen Sie, ob das Modell den Inhalt tatsächlich gelesen hat. Eine Frage, die sich nur anhand des Bildes beantworten lässt, ist zuverlässiger als die bloße Prüfung des Statuscodes.
- So entscheiden Sie: Wenn Sie nur Bildverständnis benötigen, verwenden Sie bevorzugt das Format, das mit Ihrem aktuellen Client bereits getestet wurde. Sind Datei- oder Audiofunktionen von einem bestimmten Endpunkt abhängig, richten Sie sich nach der offiziellen Dokumentation und der Unterstützung durch das Gateway.
Zugriffskette prüfen: Check 7 zur Responses-Kompatibilität
Das Ergebnis der Prüfung: Nur weil sich eine Base URL eintragen lässt, unterstützen Client, SDK und Gateway noch lange nicht die Responses-API.
Check 7: Responses-Kompatibilität von SDK, Client und Gateway
Eine Anfrage durchläuft vier Ebenen: Client, SDK, Gateway und Modell. Unterstützt eine davon die neue Schnittstelle nicht, lässt sie sich nicht nutzen.
| Ebene | Was ist zu prüfen? | Häufiger Fehlschluss |
|---|---|---|
| Client | Unterstützt er den gewünschten Endpunkt und ist seine Version aktuell genug? | Eine Base-URL-Einstellung bedeutet, dass Responses unterstützt wird |
| SDK | Stellt es die gewünschte Methode und die Ereignistypen bereit? | Wenn sich die Anfrage senden lässt, werden auch Streaming und Tools korrekt verarbeitet |
| Gateway | Leitet es den gewünschten Endpunkt weiter und muss dieser separat freigeschaltet werden? | OpenAI-Kompatibilität bedeutet, dass alle OpenAI-Endpunkte abgedeckt sind |
| Modellzuordnung | Steht die Modell-ID in der Liste und muss sie zugeordnet werden? | Ein offizieller Modellname funktioniert auch unter demselben Namen im Gateway |
- Unterschied: Chat Completions wird am breitesten unterstützt. Die Verfügbarkeit von Responses hängt von der Kombination aus Client, SDK, Gateway und Modell ab.
- Typische Falle: Der Client setzt den Pfad unbemerkt auf
/chat/completions, oder das Gateway leitet nur einen Teil der Felder weiter. Wer bei der Fehlersuche nur auf den Modellnamen schaut, hält das Problem leicht für eine Einschränkung des Modells. - So prüfen Sie es: Senden Sie zunächst ohne den Anwendungscode eine minimale Anfrage mit einem API-Testtool. Senden Sie anschließend dieselbe Anfrage über den Client und vergleichen Sie den tatsächlichen Pfad, den Anfrage-Body und die Antwort.
- So entscheiden Sie: Unterstützt eine Ebene der Zugriffskette den gewünschten Endpunkt nicht, behalten Sie zunächst die bestehende Schnittstelle bei oder wechseln Sie zu einem tatsächlich unterstützten Format.
Beim Einsatz mehrerer Modelle sollte das Gateway möglichst wenig Anpassungen am Client erfordern. APIYI apiyi.com ermöglicht mit einem Schlüssel den Aufruf von Modellen verschiedener Anbieter wie OpenAI, Claude und Gemini. Dabei unterstützt der Dienst sowohl den OpenAI-API-Standard als auch die nativen Formate von Claude und Gemini. Der Client kann sich über das jeweils unterstützte Protokoll anbinden, ohne für jedes Modell eine eigene Konfiguration zu benötigen.
Tragen Sie Modell-IDs nicht aus dem Gedächtnis ein und übernehmen Sie auch nicht einfach die Namen anderer Plattformen. Prüfen Sie vor der Migration die Modell-ID und die verfügbaren Endpunkte in der Modellliste der APIYI-Konsole auf apiyi.com. Auch für Preise und Verfügbarkeit sind die Angaben in der Konsole und der Dokumentation maßgeblich. Das dauert nur kurz und schließt viele Fehler wie „Modell nicht vorhanden“ oder „Endpunkt nicht unterstützt“ aus.
Responses oder Chat Completions: Welche Schnittstelle für welchen Anwendungsfall?
Für die meisten einfachen Aufgaben reicht Chat Completions aus. Zu Responses lohnt sich der Wechsel vor allem dann, wenn Sie dessen neuere Funktionen tatsächlich benötigen.
| Anwendungsfall | Empfohlene Schnittstelle | Grund | Was noch zu prüfen ist |
|---|---|---|---|
| Coding-Agenten (Claude Code, Codex CLI, Cline usw.) | Je nach den vom Client unterstützten Formaten | Die Protokollimplementierung des Clients bestimmt die verfügbaren Wege. Meist stehen weiterhin Chat Completions oder Anthropic Messages im Vordergrund | Protokollkonfiguration der aktuellen Version, Tool-Aufrufe und Streaming-Parsing |
| Neue OpenAI-Reasoning-Modelle mit integrierten Tools | Responses bevorzugen | Einige Reasoning- und Tool-Funktionen sind nur über Responses verfügbar | Ob das Gateway den Endpunkt weiterleitet und die integrierten Tools verfügbar sind |
| Lange Dialoge oder Agent-Schleifen | Responses prüfen | Serverseitiger Zustand kann wiederholte Übertragungen reduzieren | Ablaufzeit und Konsistenz des Zustands sowie tatsächliche Token-Kosten |
| Aufrufe benutzerdefinierter Tools | Bestehende stabile Schnittstelle beibehalten | Auch Chat Completions unterstützt Tool-Aufrufe; der Migrationsaufwand liegt hauptsächlich in der Parsing-Schicht | Parallele Aufrufe, Zuordnung der Aufruf-IDs und Rückgabe von Fehlern |
| Einheitliche Anbindung mehrerer Modelle | Gateway mit Unterstützung für mehrere Formate bevorzugen | So muss der Client nicht für jedes Modell angepasst werden | Modellzuordnung, Logs und Unterschiede bei den Modellparametern |
| Einfache Frage-Antwort-Aufgaben oder Klassifizierung ohne Schreibzugriff | Chat Completions | Funktionsumfang ausreichend, breite Kompatibilität und geringer Anpassungsaufwand | Ob der Parameter für die Ausgabelänge zum Zielmodell passt |
Suchen Sie in der Tabelle zuerst Ihren Anwendungsfall und prüfen Sie dann die letzte Spalte. Wenn etwa das Zielmodell nur Responses anbietet, Ihr Client aber nur Chat Completions unterstützt, sollten Sie nicht einfach die Felder anpassen. Aktualisieren oder wechseln Sie stattdessen den Client oder wählen Sie ein Modell, das über den unterstützten Weg verfügbar ist.
Die Kosten beurteilen Sie am besten zum Schluss. Responses ist nicht zwangsläufig günstiger: Cache-Treffer, Wiederholungsversuche und der tatsächliche Token-Verbrauch beeinflussen das Ergebnis. Aussagekräftig ist daher nur ein Rechnungsvergleich für dieselbe Aufgabe.
Empfehlung: Wenn mehrere Modelle infrage kommen, vergleichen Sie sie mit denselben Eingabeaufforderungen und Tool-Anwendungsfällen. Über APIYI apiyi.com können Sie mit demselben API-Schlüssel zwischen Modellen wechseln und mithilfe des kostenlosen Testguthabens für neue Nutzer eine kleine Testreihe durchführen. Das reduziert den anfänglichen Aufwand für Anbindung und Konfiguration.
Häufige Fragen zu Responses und Chat Completions
Die gemeinsame Antwort auf diese Fragen lautet: Erst den tatsächlichen Ablauf prüfen, dann Schlussfolgerungen ziehen.
Q1: Lassen sich neue Modelle nur mit Responses nutzen?
Nicht unbedingt. Das hängt vom jeweiligen Modell und Gateway ab. Manche neuen Reasoning-Modelle oder Tool-Funktionen sind nur über Responses verfügbar, während andere Modelle weiterhin Chat Completions unterstützen. Prüfen Sie vor der Integration die offizielle Dokumentation und die Modellbeschreibung des Gateways.
Q2: Unterstützt Chat Completions weiterhin Tool-Aufrufe?
Ja. Chat Completions unterstützt Tool-Aufrufe. Die Unterschiede liegen in der Feldstruktur, im Format der zurückgegebenen Ergebnisse und in der Zustandsverwaltung. Bei der Migration zu Responses muss der Code zur Verarbeitung von Tool-Aufrufen meist angepasst werden und lässt sich nicht direkt wiederverwenden.
Q3: Was tun, wenn das Gateway Responses nicht unterstützt?
Prüfen Sie zunächst, ob sich das gewünschte Modell auch über Chat Completions oder das native Format des Anbieters nutzen lässt. Falls ja, können Sie den bestehenden Zugriffsweg beibehalten. Ist das Modell nur über Responses verfügbar, benötigen Sie ein Gateway, das diesen Endpunkt unterstützt, oder eine Direktverbindung. Bei APIYI apiyi.com können Sie in der Konsole und in der Dokumentation prüfen, welche Endpunkte das gewünschte Modell unterstützt.
Q4: Warum haben sich die Kosten nach der Migration verändert?
Häufige Ursachen sind Änderungen bei der Kontextübermittlung oder der Anzahl der Reasoning-Tokens, eine andere Cache-Trefferquote, zusätzliche Runden durch Tool-Aufrufe und erneute Versuche nach Fehlern. Vergleichen Sie zur Fehlersuche zunächst `usage` für dieselbe Aufgabe. Prüfen Sie anschliessend Modell, Anfragevolumen und Token-Verbrauch in den Nutzungsprotokollen von APIYI apiyi.com.
Q5: Wann ist ein Rollback sinnvoll?
Ein Rollback ist angebracht, wenn zentrale Abläufe fehlschlagen, Tool-Ergebnisse falsch zugeordnet werden oder Streams häufig abbrechen. Das gilt auch, wenn Erfolgsquote, Latenz oder Kosten deutlich von den Ausgangswerten abweichen und sich das kurzfristig nicht erklären lässt. Legen Sie die Rollback-Kriterien vor der Migration fest, damit es nach dem Produktivstart keine Diskussionen unter Zeitdruck gibt.
Checkliste für die Migration zu Responses und den Rollback
Für die Migration gilt: in kleinen Schritten testen, den alten Pfad beibehalten und anhand der Baseline entscheiden, ob sich der Wechsel lohnt.
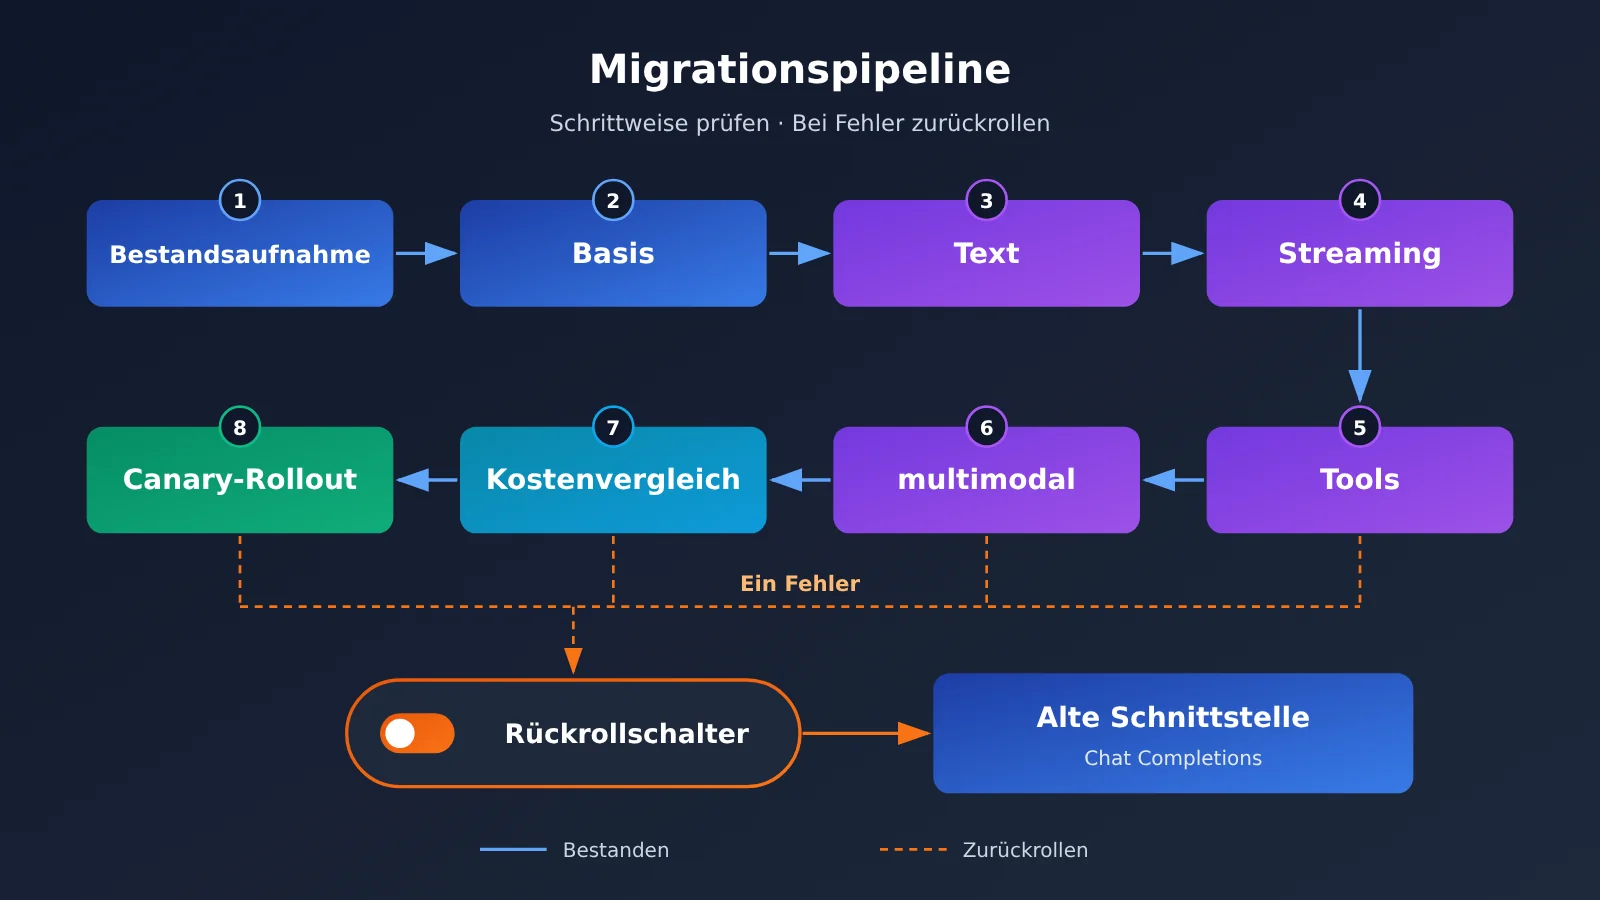
Checkliste für die Validierung der Responses-Migration
- Versionen erfassen: Client-, SDK- und Gateway-Versionen auflisten und prüfen, ob der Zielendpunkt unterstützt wird.
- Zuordnung prüfen: Endpunkt, Modell-ID, Reasoning-Parameter und Token-Parameter abgleichen.
- Baseline dokumentieren: Erfolgsquote, Latenz und Token-Kosten der ursprünglichen Schnittstelle festhalten.
- Alten Pfad beibehalten: Konfiguration und Modell-ID der ursprünglichen Schnittstelle aufbewahren. Die Umschaltung per Schalter oder Umgebungsvariable ermöglichen, statt sie fest im Code zu verankern.
- Zuerst Text testen: Prüfen, ob eine minimale Textanfrage funktioniert und die Antwort korrekt verarbeitet wird.
- Dann Streaming testen: Prüfen, ob die einzelnen Antwortteile vollständig zusammengesetzt und Abschluss- und Fehlerereignisse korrekt behandelt werden.
- Danach Tools testen: Einzelne und parallele Tool-Aufrufe prüfen und sicherstellen, dass Aufruf-IDs und Ergebnisse korrekt zugeordnet werden.
- Zuletzt multimodale Eingaben testen: Prüfen, ob das Modell die tatsächlich verwendeten Eingaben wie Bilder und Dateien korrekt lesen kann.
- Abrechnung nachvollziehen: Token-Abrechnung und Cache-Nutzung vergleichen und Unterschiede erklären.
- Schrittweise mit wenig Traffic ausrollen: Zunächst nur einen kleinen Teil des nicht kritischen Traffics umstellen und dabei Unterschiede und Fehlerfälle protokollieren.
Vergleichen Sie während der Validierung die Ergebnisse der alten und neuen Anfragen direkt miteinander. In der APIYI-Konsole auf apiyi.com lassen sich Nutzung und Abrechnung einsehen. Anhand der Logs können Sie prüfen, ob Modell und Verbrauch der Testanfragen den Erwartungen entsprechen. Bei Auffälligkeiten wechseln Sie zurück zur ursprünglichen Schnittstellenkonfiguration und reproduzieren das Problem anhand der Fehlerfälle.
Kriterien für ein Rollback von Chat Completions
| Beobachtung | Empfohlene Maßnahme | Rollback-Entscheidung |
|---|---|---|
| Textanfragen schlagen fehl | Schrittweise Einführung pausieren, Endpunkt und Parsing prüfen | Zurückrollen, wenn sich das Problem nicht kurzfristig beheben lässt |
| Streaming wird abgeschnitten oder endet nicht | Ursprüngliche SSE-Ereignisse vergleichen | Sofort zurückrollen, wenn die Ausgabe für Nutzer beeinträchtigt ist |
| Fehlerhafte Zuordnung von Tool-Aufrufen | Aufruf-ID und Rückgabeformat prüfen | Sofort zurückrollen, wenn fehlerhafte Aktionen entstehen können |
| Reasoning-Parameter greifen nicht | Weiterleitung der Parameter und Modellunterstützung prüfen | Zurückrollen, wenn die Ausgabequalität leidet und keine alternative Konfiguration verfügbar ist |
| Kosten weichen von der Baseline ab | Token-Verbrauch, Cache und Wiederholungsversuche analysieren | Zurückrollen, wenn der vom Team festgelegte Schwellenwert überschritten wird und sich die Abweichung nicht erklären lässt |
Responses oder Chat Completions: die wichtigsten Punkte
- Reihenfolge bei der Auswahl: Zuerst den Client prüfen, dann das Modell und das Gateway; zuletzt die Kosten vergleichen.
- Funktionsumfang: Responses eignet sich für Modelle, die auf dessen exklusive Funktionen angewiesen sind, wird aber nicht von allen Modellen unterstützt.
- Tool-Aufrufe: Chat Completions unterstützt Tool-Aufrufe. Bei der Migration kommt es vor allem auf die Felder und die korrekte Zuordnung an.
- Reihenfolge bei der Validierung: Zuerst Text, dann Streaming, dann Tools und zuletzt multimodale Funktionen prüfen.
- Voraussetzungen für ein Rollback: Alte Konfiguration nicht löschen, Baseline vorab dokumentieren und die Umstellung über einen Schalter steuern.
Fazit: Responses oder Chat Completions?
Wenn die bestehende Chat-Completions-Integration stabil läuft und alle benötigten Funktionen bietet, muss der Endpunkt nicht allein um des Wechsels willen geändert werden – vorausgesetzt, das neue Modell lässt sich anbinden. Wenn das Zielmodell oder integrierte Tools Responses voraussetzen, arbeiten Sie die sieben Prüfpunkte Schritt für Schritt durch. Entscheidend ist: Unterstützt der Client einen Endpunkt nicht, nutzen Sie ihn nicht – auch wenn er noch so neu ist. Unterstützt das Modell nur einen Endpunkt, erzwingen Sie keinen anderen.
Bevor Sie loslegen, können Sie über APIYI unter apiyi.com die Modell-ID und die unterstützten Endpunkte prüfen. Arbeiten Sie die Checkliste zunächst mit minimalen Anfragen durch und entscheiden Sie danach, ob Sie die Nutzung ausweiten.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.