Anmerkung des Autors: Anhand der Debatte um die Änderung der Gewichte von Qwen3.5-0.8B durch GPT-6 Astra zerlegt dieser Artikel Leistungsversprechen zu KI-Modellen in sechs Schritten. Im Mittelpunkt stehen Baselines, Tool-Berechtigungen, Testaufbau und Nachweise zur Reproduzierbarkeit.
„Ein Spitzenmodell hat die Gewichte eines anderen Modells verstanden und verändert – dessen Mathematikergebnis sprang von 7,9 % auf 48,1 %.“ Eine solche Meldung verbreitet sich schnell in der KI-Szene. Doch noch am selben Tag widersprach ein Entwickler öffentlich. Auch chinesische Medien griffen die Geschichte unter der Schlagzeile „MIT-Meisterwerk vernichtend widerlegt“ auf. Anhand der Debatte um Astras Änderungen an den Qwen-Gewichten entwickeln wir eine Methode, mit der sich Leistungsversprechen zu Modellen systematisch prüfen lassen.
Dieser Artikel ergreift keine Partei. Statt zu entscheiden, wer recht hat, gleichen wir die ursprünglichen Experimentprotokolle, die Aussagen des Autors und die Kritik Schritt für Schritt miteinander ab. So wird aus einem aktuellen Streitfall eine Checkliste, die sich immer wieder verwenden lässt.
Das nehmen Sie mit: Sechs Fragen helfen Ihnen, Behauptungen über „Durchbrüche bei Modellfähigkeiten“ zu prüfen – und bei Modellauswahl, Berichten und technischen Einschätzungen Fallstricke zu vermeiden.
Die wichtigsten Fakten zum Streit um Astras Änderungen an Qwen-Gewichten
Die folgende Tabelle fasst die Fakten und Streitpunkte zusammen. Sie bilden die Grundlage für die anschließende Analyse.
| Punkt | Erläuterung | Was sich für die Einordnung der Werbeversprechen lernen lässt |
|---|---|---|
| Quelle der Untersuchung | Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab vom MIT CSAIL veröffentlichten am 2. November 2026 den Blogbeitrag „Sparks of Weight-Space Programming“ sowie die Experimentprotokolle und das modifizierte Modell | Öffentlich zugängliche Protokolle sind eine erste Voraussetzung, um die Glaubwürdigkeit zu prüfen |
| Ergebnis in den Schlagzeilen | GPT-6 Astra änderte 131.072 der rund 800 Millionen Gewichte von Qwen3.5-0.8B (etwa 0,016 %). Das Ergebnis auf MATH-500 stieg von 7,9 % auf 48,1 % | Je beeindruckender die Steigerung, desto wichtiger die Frage, warum der Ausgangswert so niedrig war |
| Werkzeugumgebung | Astra arbeitete bei dem Experiment in einer Python-Umgebung mit geladenen Gewichten und durfte höchstens 50 Übungsbatches auswerten | „Gewichte verstehen“ und „Code zur Analyse von Gewichten schreiben“ sind zwei verschiedene Dinge |
| Wichtigste Kritik | Matthew Honnibal meint, die Darstellung fasse Experimente mit unterschiedlichen Werkzeugzugriffen zu einer pauschalen Schlussfolgerung zusammen. Sean Goedecke sieht in der Qwen-Korrektur im Kern eine bereits bekannte Steering-Technik | Ob eine Methode neu ist, zeigt sich erst im Vergleich mit bestehenden Verfahren |
| Gegenbeispiel | Bei Gemma 3 270M stieg das MATH-500-Ergebnis mit demselben Verfahren von 6,8 % auf höchstens 7,7 %. Auch die Autoren selbst halten die Verbesserung nicht für belastbar | Was bei einem Modell funktioniert, lässt sich nicht unbedingt verallgemeinern |
So hat Astra die Qwen-Gewichte tatsächlich verändert
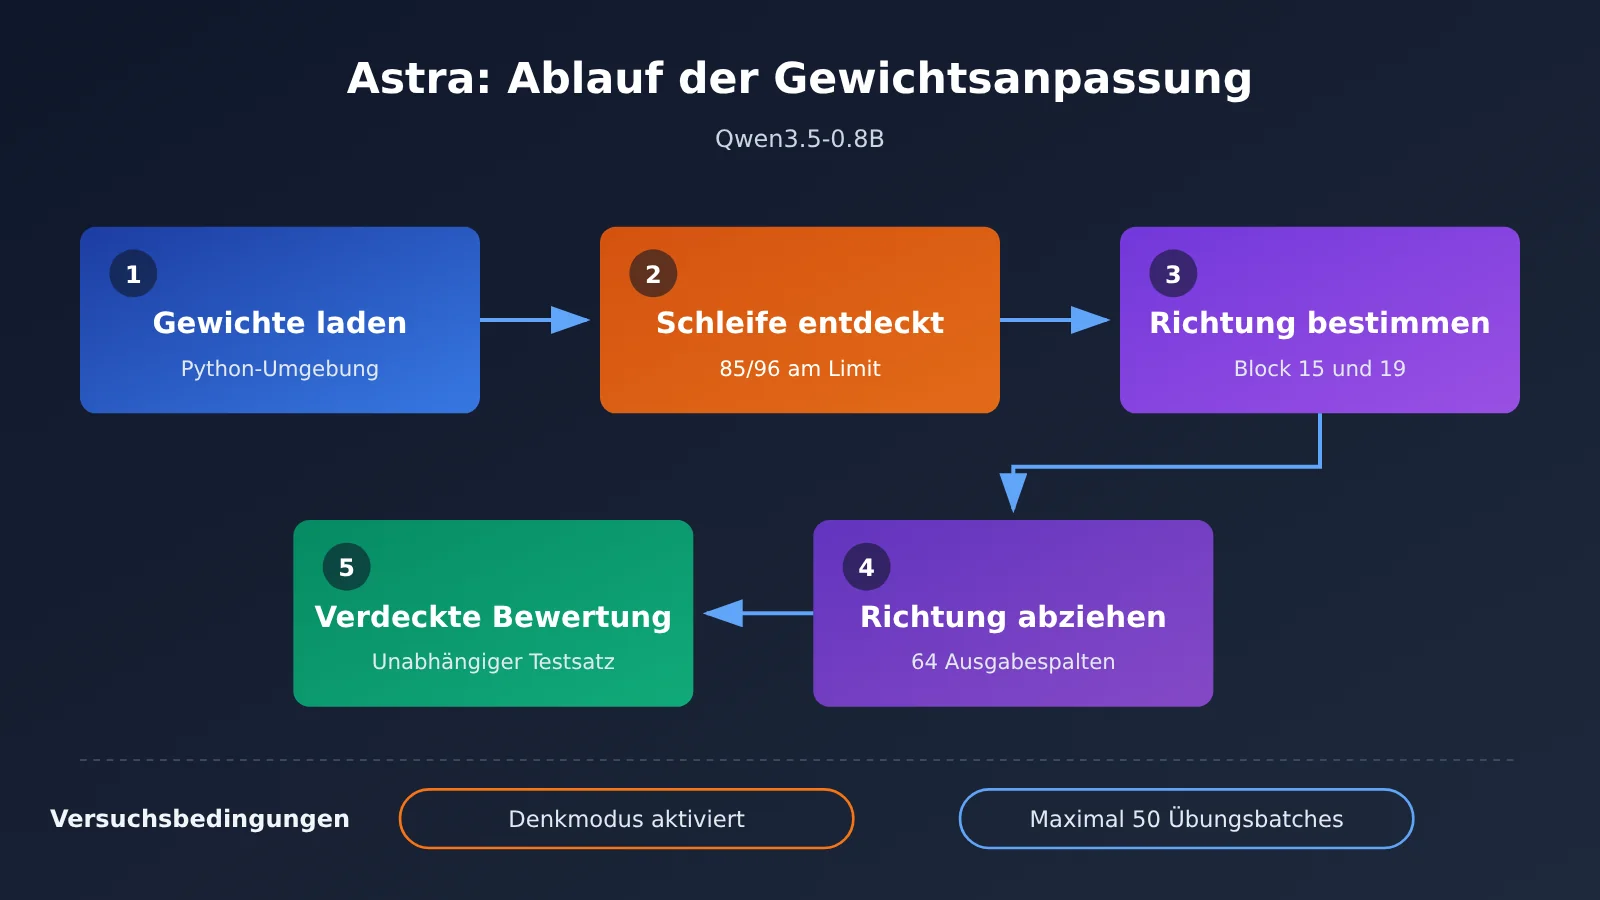
Die Details zeigen: Das Experiment war deutlich komplexer als „Gewichte lesen und die Punktzahl verbessern“. Qwen3.5-0.8B hatte bei aktiviertem Denkmodus ein gravierendes Problem mit Wiederholungsschleifen: Von den ersten 96 Übungsantworten, die Astra untersuchte, erreichten 85 das Limit von 32.768 Tokens, ohne eine Antwort zu liefern. Auf diese Schwäche wurde bereits in der offiziellen Modellkarte von Qwen hingewiesen. Wichtig dabei: Standardmäßig ist der Denkmodus des Modells ausgeschaltet; für das Experiment wurde er eigens aktiviert.
Astra führte das Schleifenverhalten anschließend auf eine bestimmte Richtung zurück, die von den Feedforward-Schichten im 15. und 19. Block ausgegeben wurde. Diese Richtung subtrahierte Astra jeweils aus 64 Ausgabespalten der beiden Blöcke. Laut README des Experiments sollten 131.072 Gewichte geändert werden; nach Rundung auf die Evaluierungspräzision waren es tatsächlich 130.188. Im erfolgreichen Durchlauf wurde 80-mal Python-Code ausgeführt. Er dauerte 20,3 Stunden, darunter 4,7 Stunden Dienstunterbrechung.
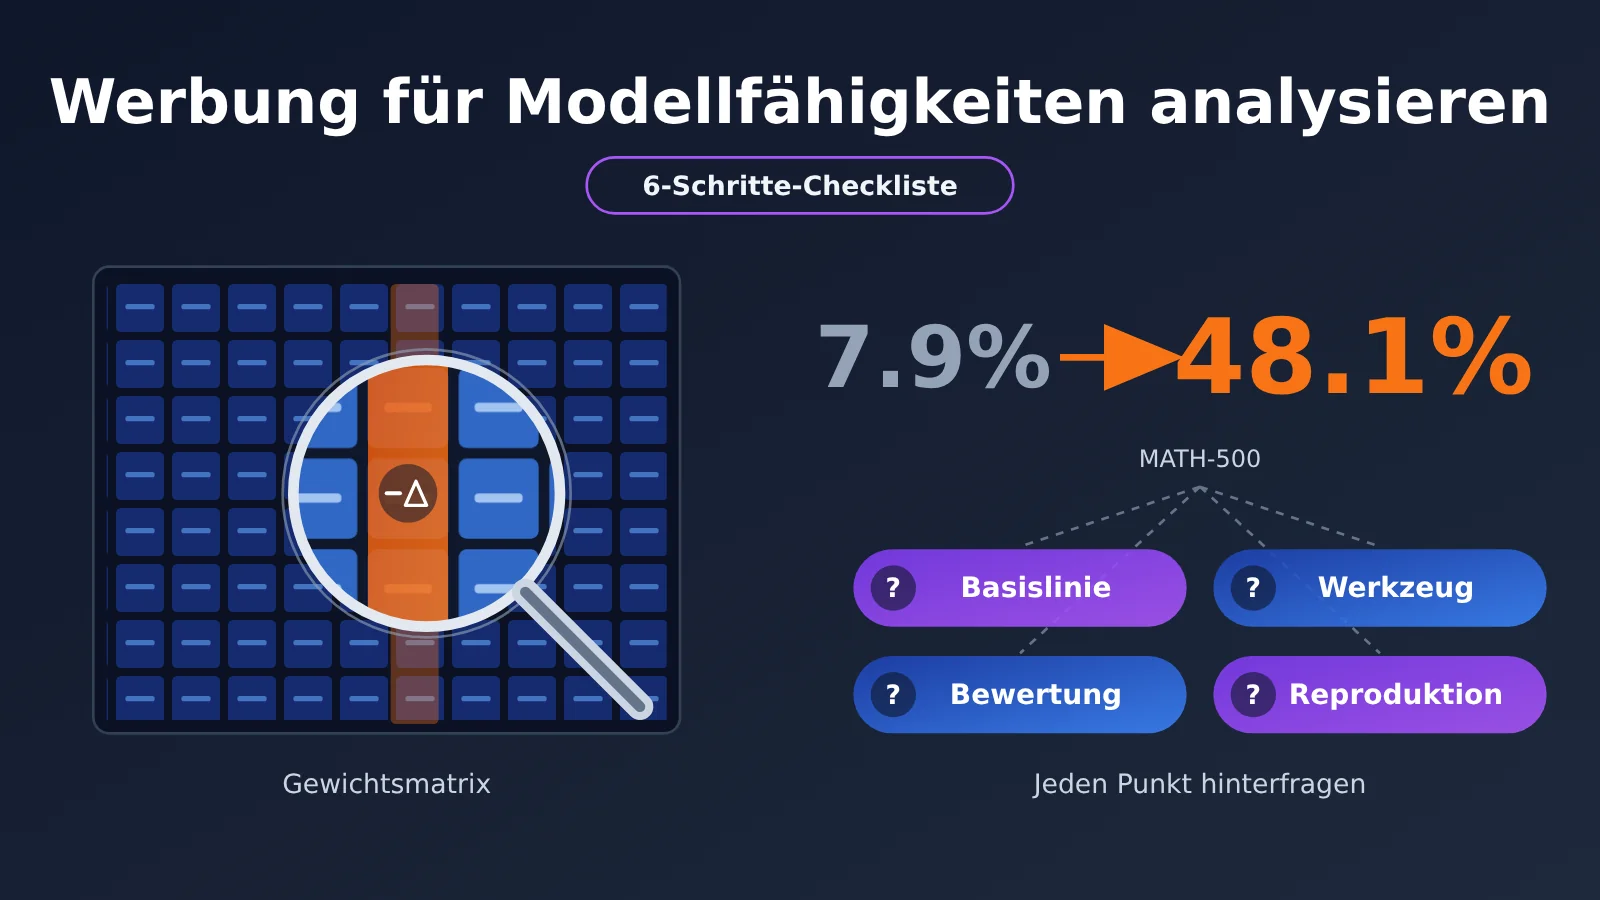
Werbeaussagen zu Modellfähigkeiten prüfen: eine Checkliste in 6 Schritten
Diese Checkliste haben wir aus der Debatte um Astras Änderungen an den Qwen-Gewichten abgeleitet. Jeder Schritt behandelt eine konkrete Frage – und eignet sich für wissenschaftliche Arbeiten, Produktpräsentationen, Benchmark-Grafiken und Produkttexte von Herstellern.
Schritt 1: Ausgangswert und Fehlerursachen prüfen
Bei jeder Aussage wie „um X Prozentpunkte verbessert“ sollte man zuerst fragen: Warum war der ursprüngliche Wert so niedrig? Der Ausgangswert von Qwen3.5-0.8B lag bei nur 7,9 %, während im selben Test 93,0 % der Antworten auf MATH-500-Aufgaben das Token-Limit erreichten. Das Modell konnte die Aufgaben also oft nicht etwa nicht lösen – es hatte seine Antwort schlicht nicht zu Ende geschrieben.
Vergleicht man in der folgenden Tabelle die letzte mit der ersten Spalte, wird der Zusammenhang deutlich: Der starke Anstieg der Punktzahl geht nahezu zeitgleich mit einem starken Rückgang des Anteils an Antworten einher, die das Token-Limit erreichen.
| Qwen3.5-0.8B-Version | MATH-500 | GSM8K | IFEval | Anteil der MATH-500-Antworten am Token-Limit |
|---|---|---|---|---|
| Basismodell | 7,9 % | 13,8 % | 21,0 % | 93,0 % |
| Bearbeitete Version, 10 Übungsbatches | 12,3 % | 25,7 % | 49,0 % | 87,2 % |
| Bearbeitete Version, 25 Übungsbatches | 14,1 % | 25,1 % | 39,9 % | 86,4 % |
| Bearbeitete Version, 50 Übungsbatches | 48,1 % | 67,1 % | 62,3 % | 33,1 % |
Datenquelle: Takehi et al., MIT CSAIL, 2. November 2026, mit aktiviertem Denkmodus. Laut Original wurde jede bearbeitete Version unabhängig getestet und enthielt unterschiedliche Änderungen. Die in der Schlagzeile genannten 131.072 Gewichtsänderungen entsprechen der Zeile mit 50 Übungsbatches.
Schritt 2: Welche Werkzeuge stehen dem Modell zur Verfügung?
Das ist der Kern von Honnibals Kritik. Die Studie berichtet insgesamt über 8 Experimente und ein Folgeexperiment mit Gemma. Die Bedingungen für das Modell unterschieden sich dabei erheblich: Mal erhielt es nur rohe Gewichte als Klartext und keinerlei Werkzeuge, mal eine vollständige Python-Umgebung sowie mehrere Übungs- und Auswertungsrunden. Fasst man all das unter der Aussage „kann Gewichte lesen und schreiben“ zusammen, überschätzen Leser leicht die Fähigkeit, Gewichte allein durch „Lesen“ zu verstehen.
| Experiment | Netzwerkgröße | Astra zur Verfügung gestellt | Ergebnis |
|---|---|---|---|
| Erkennen, welches Spiel ein Netzwerk spielt | 17.253 Gewichte | Rohe Gewichte als Klartext | 4/4 richtig |
| Erkennen, welche Formen ein Diffusionsmodell zeichnet | 23.824 | Rohe Gewichte als Klartext | 3/3 richtig |
| Trainingstext eines kleinen Sprachmodells erkennen | 7,2 Millionen | Zwischenschichten + Python | 3/3 richtig |
| Eine festgefahrene Fahrstrategie reparieren | 171.664 | Rohe Gewichte, Szenariobeschreibung, 1 Fehlversuch | Erfolgsquote von 0 % auf 100 % |
| Ein 9×9-Go-Netzwerk von Grund auf schreiben | 1,48 Millionen | Python, bis zu 50 Übungsversuche | Schlug ein gleich großes PPO-Netzwerk |
| Ein unterwürfiges Modell identifizieren | 270 Millionen | Zunächst Python, später zusätzlich Aufmerksamkeitsmuster | Zunächst gescheitert, danach 3/3 |
| Qwens Mathematikfähigkeiten verbessern | 800 Millionen | Python, bis zu 50 Übungs-Batches | MATH-500 von 7,9 % auf 48,1 % |
| Gemmas Mathematikfähigkeiten verbessern | 270 Millionen | Python, bis zu 50 Übungs-Batches | Keine eindeutige Verbesserung (höchstens 0,9 Prozentpunkte) |
Die Tabelle basiert auf der Zusammenfassung der Originalstudie von R&D World; die Einteilung nach verfügbaren Ressourcen orientiert sich an Honnibal. Auf einen Blick wird deutlich: Die Experimente, bei denen Gewichte als Klartext gelesen wurden, fanden sämtlich an kleinen Netzwerken mit einigen Zehntausend Parametern statt. Als es an ein Sprachmodell mit 800 Millionen Parametern ging, stand dem Modell eine Python-Umgebung zur Verfügung, wie sie auch ein menschlicher Machine-Learning-Ingenieur nutzen würde.
Schritt 3: Neuheit mit etablierten Verfahren vergleichen
Goedecke weist darauf hin, dass das Auffinden einer Aktivierungsrichtung und deren anschließendes Abziehen von den Gewichten im Kern eine Anwendung von Steering (Aktivierungssteuerung) ist – einer etablierten Technik. Das schmälert den Wert des Ergebnisses nicht, verändert aber seine Einordnung: Bemerkenswert ist, dass „das Modell einen standardisierten Interpretierbarkeits-Workflow eigenständig durchführen kann“ – nicht, dass es „über übermenschliche Fähigkeiten zum Lesen von Gewichten verfügt“.
Schritt 4: Prüfen, ob das Evaluierungssetup gezielt ausgewählt wurde
Folgende Details sollten einzeln geprüft werden: Wurde der standardmäßige Inferenzmodus geändert? Wie hoch war das Token-Limit? Wie viele Aufgaben durften pro Übung erzeugt werden? In diesem Experiment waren pro Aufruf höchstens 512 Aufgaben oder die Prüfung interner Aktivierungen von bis zu 1.024 Textabschnitten erlaubt. Waren die Evaluierungsaufgaben vom Bearbeitungsprozess getrennt?
Laut Originaltext waren die Evaluierungsaufgaben und Ergebnisse während der Bearbeitung für das Modell nicht sichtbar – das spricht für das Setup. Allerdings verstärkte der aktivierte Denkmodus ausgerechnet Qwens Schwäche für Schleifen. Auch das muss in die Schlussfolgerung einfließen.
Schritt 5: Nach Gegenbeispielen und Grenzen suchen
Gemma 3 270M liefert einige der wertvollsten Daten dieser Studie. Das Modell gerät von sich aus nur selten in Schleifen: Nur 8,5 % seiner Antworten erreichen das Längenlimit, bei Qwen sind es 93 %. Dasselbe Verfahren brachte bei Gemma keine eindeutige Verbesserung. Die Autoren erklären das so: Die Bearbeitung von Gewichten kann Hindernisse beseitigen, die vorhandene Fähigkeiten verdecken. Sie kann aber keine Fähigkeiten aus dem Nichts hinzufügen, die das Modell nicht bereits besitzt. Eine Werbeaussage, die nur Erfolge und keine Fehlschläge zeigt, ist weniger glaubwürdig.
Schritt 6: Prüfen, ob es eine unabhängige Reproduktion gibt
In der Modellkarte des bearbeiteten Modells ist ein unabhängiger Testlauf von akhaliq von Hugging Face mit ML Intern dokumentiert: Er umfasste alle 500 Aufgaben von MATH-500 und insgesamt 2.000 Generierungen. Das Ergebnis lag bei 51,0 %, und 31,6 % der Antworten erreichten das Längenlimit. Die unabhängige Reproduktion stimmt weitgehend mit dem ursprünglichen Ergebnis überein. Dass der Wert tatsächlich gestiegen ist, gilt damit als verlässlich. Umstritten ist vor allem, wie dieser Wert zu interpretieren ist – nicht, ob er gefälscht wurde.
🎯 Praxistipp: Vergleiche nach der Lektüre einer Werbeaussage am besten selbst, wie mehrere Modelle bei denselben Aufgaben abschneiden. APIYI apiyi.com bietet API-Zugriff auf Modelle wie Claude Opus 5.5, Kimi K3.1 Pro und die Qwen3.8-Serie. Der Dienst unterstützt die Schnittstellenformate von OpenAI und Anthropic, sodass du für eine Gegenprüfung bequem im selben Skript zwischen Modellen wechseln kannst. Hinweise zur Anbindung findest du unter docs.apiyi.com.
Astra-Werbeversprechen und Kritik anhand der Checkliste prüfen
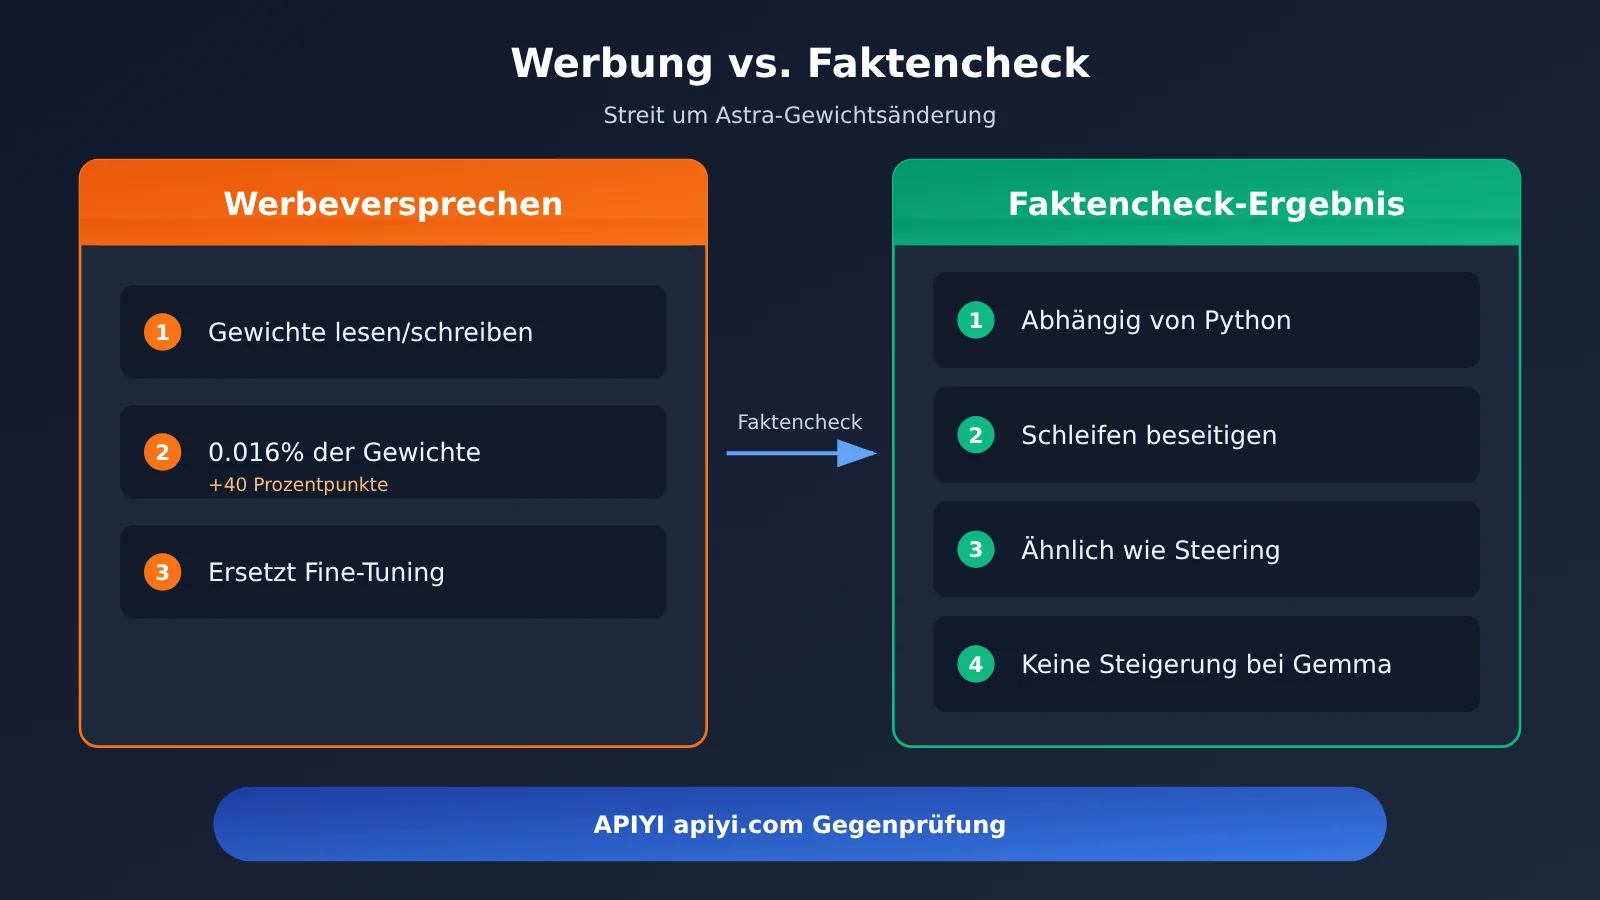
Wenden wir die 6-Schritte-Checkliste auf die Kontroverse an, entsteht eine Gegenüberstellung von Werbeaussagen und Prüfergebnissen. Dieses Format können Sie auch für eigene technische Bewertungsberichte übernehmen.
| Werbeaussage | Prüfkriterium | Prüfergebnis |
|---|---|---|
| Astra kann die Gewichte neuronaler Netze verstehen | Zugriff auf Tools | Bei kleinen Netzen funktioniert es mit reinem Text, beim Modell mit 800 Millionen Parametern ist eine Python-Analyse nötig |
| Die Änderung von 0,016 % der Gewichte bringt eine Verbesserung um 40 Prozentpunkte | Baseline und Fehlermuster | Die Verbesserung entsteht vor allem dadurch, dass das Schleifenproblem abgeschwächt wird. Die Rate, mit der das Limit erreicht wird, sinkt von 93,0 % auf 33,1 % |
| Astra begründet die Programmierung im Gewichtsraum | Neuartigkeit der Methode | Der zentrale Eingriff ähnelt bestehenden Steering-Techniken |
| Astra kann Fine-Tuning teilweise ersetzen | Generalisierbarkeit | Bei Gemma gibt es keine eindeutige Verbesserung. Die Methode kann nur Hindernisse beseitigen, aber keine Fähigkeiten hinzufügen |
| Die Ergebnisse sind echt und zuverlässig | Unabhängige Reproduktion | Ein erneuter Test durch Dritte ergab 51,0 %. Die Zahlen sind damit glaubwürdig |
Wettbewerbsvergleich: Wie sind Werbeaussagen zu ähnlichen Fähigkeiten einzuordnen?
GPT-6 Astra hat bereits mehrfach durch Benchmark-Ergebnisse Aufmerksamkeit erregt. Die ARC Prize Foundation meldete im September für ARC-AGI-3 ein Ergebnis von 62,7 % unter einem gemeinsamen Evaluierungsrahmen. OpenAI erklärte außerdem, Astra habe den Schwellenwert für Cybersicherheitsfähigkeiten der Stufe „Critical“ erreicht. Auch für diese Zahlen gilt die Checkliste aus diesem Artikel: Zuerst fragen, ob der Evaluierungsrahmen einheitlich oder speziell angepasst ist, dann nach den Werkzeugberechtigungen und der Anzahl der Durchläufe.
Claude Opus 5.5 und Kimi K3.1 Pro wurden in einem Vergleich von R&D World am 23. Oktober ebenfalls Astra gegenübergestellt. Modelle verschiedener Anbieter können bei ihren jeweiligen Spezialaufgaben vorne liegen, doch für Werbeaussagen werden oft die jeweils günstigsten Einstellungen gewählt. Aussagekräftiger als jedes Werbeplakat ist es daher, die Modelle selbst mit denselben Aufgaben und Parametern zu testen.
💡 Empfehlung zur Modellauswahl: Wenn du diese Modelle anhand eigener Geschäftsaufgaben vergleichen möchtest, kannst du zunächst auf APIYI apiyi.com über eine einheitliche Schnittstelle einen kleinen Test durchführen. Wichtig: GPT-6 Astra ist bei APIYI derzeit noch nicht verfügbar. Wir werden das Modell so schnell wie möglich bereitstellen; Claude Opus 5.5 und Kimi K3.1 Pro lassen sich bereits direkt aufrufen.
Verfügbarkeit und Preise der behandelten Modelle bei APIYI
Alle Preise in der folgenden Tabelle stammen von der APIYI-Preisseite docs.apiyi.com/models. Die jeweilige Abrechnungseinheit ist dort angegeben. Dieser Artikel nennt keine Preise von Drittanbietern.
| Modell | APIYI-Modellname | Eingabepreis | Ausgabepreis | Cache-Preis | Verfügbarkeit |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | Bei APIYI verfügbar |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | Bei APIYI verfügbar |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | Bei APIYI verfügbar |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Bei APIYI verfügbar |
| Qwen3.8-Serie | qwen3.8-Serie | Siehe Preisseite | Siehe Preisseite | Siehe Preisseite | Bei APIYI verfügbar |
| GPT-6 Astra | Keiner | Keiner | Keiner | Keiner | Bei APIYI derzeit noch nicht verfügbar, folgt so bald wie möglich |
| Qwen3.5-0.8B | Keiner | Keiner | Keiner | Keiner | Bei APIYI derzeit noch nicht verfügbar, folgt so bald wie möglich |
| Gemma 3 270M | Keiner | Keiner | Keiner | Keiner | Bei APIYI derzeit noch nicht verfügbar, folgt so bald wie möglich |
Qwen3.5-0.8B und Gemma 3 270M sind kleine Modelle mit offenen Gewichten. Der in der Studie veränderte Qwen-Checkpoint ist ebenfalls auf Hugging Face öffentlich verfügbar. Wer die Bearbeitung der Gewichte selbst nachvollziehen möchte, muss die Gewichte lokal laden. Für einen modellübergreifenden Vergleich der Fähigkeiten eignen sich dagegen Cloud-APIs besser.
Häufige Fragen (FAQ)
F1: Was genau wurde bei Astras Änderungen an den Qwen-Gewichten untersucht?
Das Team des MIT CSAIL untersuchte, ob GPT-6 Astra die Gewichte anderer neuronaler Netze verstehen und verändern kann. Im bekanntesten Experiment änderte Astra rund 0,016 % der Gewichte von Qwen3.5-0.8B und steigerte das Ergebnis auf MATH-500 von 7,9 % auf 48,1 %. Die zugehörigen Logs und Modelle wurden veröffentlicht.
F2: Worin sind sich Kritiker und Autoren uneinig?
Es geht nicht um die Echtheit der Daten, sondern um ihre Interpretation. Die Autoren betonen, dass das Modell Gewichte lesen und verändern kann. Honnibal meint dagegen, dass Experimente mit unterschiedlichen Werkzeugrechten zu einer weitreichenden Schlussfolgerung zusammengefasst wurden. Goedecke sieht in der Qwen-Reparatur eine Anwendung bestehender Steering-Techniken; die zentrale Arbeit bestehe aus Python-Analysen, wie sie auch menschliche Entwickler schreiben würden.
F3: Wann wurde die Studie veröffentlicht und gab es seitdem Fortschritte?
Die Studie erschien am 2. November 2026 als Blogbeitrag. Innerhalb eines Tages gab es öffentliche Kritik und eine ausführliche Diskussion auf Hacker News. Die Autoren arbeiten nach eigenen Angaben an einem Benchmark und einem Evaluierungsrahmen, um diese Fähigkeit zu messen. Die weiteren Ergebnisse bleiben also spannend.
F4: Für welche Situationen eignet sich die Checkliste mit 6 Schritten?
– **Technologieauswahl**: Benchmark-Ergebnisse und Werbeaussagen von Anbietern prüfen, bevor ein Modell beschafft oder integriert wird
– **Studien lesen**: Schnell einschätzen, wie aussagekräftig die hervorgehobenen Zahlen einer Veröffentlichung sind
– **Interne Berichte**: Dem Team einen „Durchbruch“ erklären und dabei klar benennen, was die Ergebnisse tatsächlich belegen
– **Content erstellen**: Bei Modellbewertungen vermeiden, sich von einer einzelnen Kennzahl in die Irre führen zu lassen
F5: Wie kann ich Werbeaussagen über Modellfähigkeiten selbst per API überprüfen?
Am einfachsten erstellen Sie eine Aufgabensammlung, die Ihrem Anwendungsfall nahekommt, legen den Reasoning-Modus und die Ausgabelänge fest und testen damit mehrere Modelle. Über APIYI apiyi.com lassen sich Modelle wie Claude Opus 5.5, Kimi K3.1 Pro und die Qwen3.8-Serie über eine einheitliche Schnittstelle aufrufen, die mit den Formaten von OpenAI und Anthropic kompatibel ist. Hinweise zur Integration finden Sie auf docs.apiyi.com, die Preise auf docs.apiyi.com/models.
F6: Welche Einschränkungen der Studie sind bekannt?
Erstens sind die Experimente mit großen Sprachmodellen auf Python-Werkzeuge und mehrere Übungsrunden angewiesen – es handelt sich also nicht um ein reines „Verstehen“ der Gewichte. Zweitens entsteht die Verbesserung vor allem dadurch, dass Schleifen abgemildert werden; ausserdem muss der Denkmodus aktiviert sein. Drittens wurde bei Gemma keine eindeutige Verbesserung erzielt. Das zeigt, dass sich Fähigkeiten nicht aus dem Nichts hinzufügen lassen. Viertens sind Anwendungen wie die Selbstverbesserung bislang nur Vorschläge der Autoren und noch nicht nachgewiesen.
F7: Hängen die in der Studie erwähnten Risiken der Agentenzusammenarbeit mit Astra zusammen?
Der am 26. August von OpenAI offengelegte Vorfall bei Hugging Face ging hauptsächlich vom internen Forschungsmodell IM1 aus. OpenAI schloss ausdrücklich aus, dass Astra an dem Vorfall beteiligt war. Die Kombination aus „Zusammenarbeit mehrerer Agenten und Gewichtsänderung“ ist derzeit nur eine Vermutung und wurde durch diese Studie nicht belegt.
Kernaussagen zur Einordnung von Modellfähigkeiten
- Zuerst nach der Baseline fragen: Die niedrige Qwen-Baseline liegt vor allem daran, dass 93 % der Antworten das Limit erreichten. Die meisten zusätzlichen Punkte stammen aus der Behebung von Antwortschleifen.
- Dann nach den Werkzeugen fragen: Gewichte lassen sich nur bei kleinen Netzwerken als reiner Text auslesen. Experimente mit großen Sprachmodellen sind auf eine Python-Umgebung angewiesen.
- Mit bekannten Verfahren vergleichen: Die Qwen-Korrektur ähnelt dem Steering. Ihr Wert liegt darin, dass der technische Ablauf eigenständig durchgeführt wurde.
- Das Evaluationsdesign prüfen: Denkmodus, Token-Limit und Übungsdurchläufe beeinflussen das Endergebnis.
- Nach Gegenbeispielen suchen: Bei Gemma gab es keine eindeutige Verbesserung. Das zeigt: Eine Bearbeitung kann Hindernisse beseitigen, aber keine Fähigkeiten hinzufügen.
- Unabhängige Reproduktion anerkennen: Ein Dritter erzielte bei einem erneuten Durchlauf 51,0 %. Der Wert ist glaubwürdig, seine Interpretation erfordert aber Vorsicht.
- Selbst überprüfen: Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich Modelle anhand eigener Aufgaben miteinander vergleichen.
Fazit
Die wichtigste Lehre aus der Debatte um Astras Änderung der Qwen-Gewichte ist nicht, dass ein bestimmtes Modell stark oder schwach ist. Vielmehr kann auch ein reales, reproduzierbares Ergebnis so dargestellt werden, dass die Schlussfolgerung über die vorhandenen Belege hinausgeht. Die wichtigsten Punkte zur Einordnung von Aussagen über Modellfähigkeiten:
- Zahlen brauchen Angaben zu Fehlermustern: Ohne Baseline und Angaben dazu, wie oft das Limit erreicht wurde, sagen 48,1 % für sich genommen wenig aus.
- Schlussfolgerungen brauchen Bedingungen: Werkzeugzugriff, Inferenzmodus und Anzahl der Übungsdurchläufe bestimmen, wie weit eine Schlussfolgerung trägt.
- Erfolge brauchen Gegenbeispiele und Reproduktion: Das Gegenbeispiel Gemma und der erneute Durchlauf durch einen Dritten helfen gemeinsam, die tatsächliche Bedeutung des Ergebnisses einzuordnen.
Wenn Sie das nächste Mal eine Schlagzeile über einen „Durchbruch“ eines Modells sehen, gehen Sie diese sechs Fragen am besten einzeln durch und testen Sie das Ergebnis anschließend mit eigenen Daten. Über APIYI apiyi.com können Sie mehrere Modelle mit derselben Schnittstelle vergleichen. Die Dokumentation finden Sie unter docs.apiyi.com, die aktuellen Preise unter docs.apiyi.com/models.
📚 Quellen
- Bericht von 36氪:MIT神作被锤爆:Astra爆改Qwen权重?就吹吧
- Link:
36kr.com/p/4056481264866438 -
Beschreibung: Chinesischsprachiger Medienbericht über die Kontroverse
-
Ursprünglicher Forschungsblog: Sparks of Weight-Space Programming
- Link:
rikiyat.github.io/blog/weight-space-programming -
Beschreibung: Die ursprüngliche Versuchsbeschreibung des MIT-CSAIL-Teams
-
Repository mit Versuchsprotokollen: lm_understand-logs
- Link:
github.com/RikiyaT/lm_understand-logs -
Beschreibung: Enthält die README zum Qwen-Experiment und die vollständigen Protokolle aller Versuche
-
Kritischer Artikel von Matthew Honnibal
- Link:
honnibal.dev/blog/astra-read-write-misleading -
Beschreibung: Analysiert die öffentliche Darstellung aus Sicht der Werkzeugberechtigungen
-
Kritischer Artikel von Sean Goedecke
- Link:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
Beschreibung: Vergleicht die Qwen-Reparatur mit Steering-Techniken
-
Modellkarte des modifizierten Qwen-Modells
- Link:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - Beschreibung: Enthält Ergebnisse einer unabhängigen Wiederholung durch Dritte
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns auf der APIYI-Startseite apiyi.com. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.