Anmerkung des Autors: Am 2. November 2026 stellte OpenAI das interne Git-Backend Pando vor. Dieser Artikel geht der Frage nach, wie Pando innerhalb von zehn Wochen in Produktion ging: Er beleuchtet die Aufgabenverteilung zwischen Menschen und Agents, das Testsystem und die Migration. Ausserdem fasst er Methoden für die Agent-Entwicklung zusammen, die auch andere Teams nutzen können.
Am 2. November 2026 veröffentlichte OpenAI den technischen Artikel „Scaling Git at OpenAI“ und stellte darin Pando vor, das neue Git-Backend für sämtliche Entwicklungsaktivitäten im Monorepo des Unternehmens: Vom Projektstart bis zur Verarbeitung von Produktions-Traffic vergingen rund zehn Wochen. Ein einzelner Ingenieur entwarf die Kernarchitektur, mehrere Agent-Teams übernahmen die Implementierung und wenige Ingenieure kümmerten sich um das Deployment. Daraus liesse sich leicht die Geschichte erzählen, wie „ein Mensch KI beim Bau von Infrastruktur dirigiert“. Die von OpenAI veröffentlichten Details zeigen jedoch, dass ein ganzes System aus technischen Vorgaben und Validierungsverfahren den Ausschlag gab.
Dies ist keine Nacherzählung eines KI-Programmiermythos. Der Artikel stützt sich auf die offiziellen Angaben von OpenAI und unterscheidet zwischen bekannten und noch nicht veröffentlichten Informationen. So wurden weder die Grösse des beteiligten Teams noch Token-Kosten, Aufgabenprotokolle oder der Anteil manuell geänderter Codezeilen bekannt gegeben.
Das nehmen Sie mit: Sie erfahren, warum OpenAI Pando gebaut hat, welche Aufgaben die Codex-Agent-Teams übernahmen, welche Prüfverfahren den Einsatz von Agents in der Infrastrukturentwicklung ermöglichten und wie Sie diese Methoden in eigenen Projekten anwenden können.
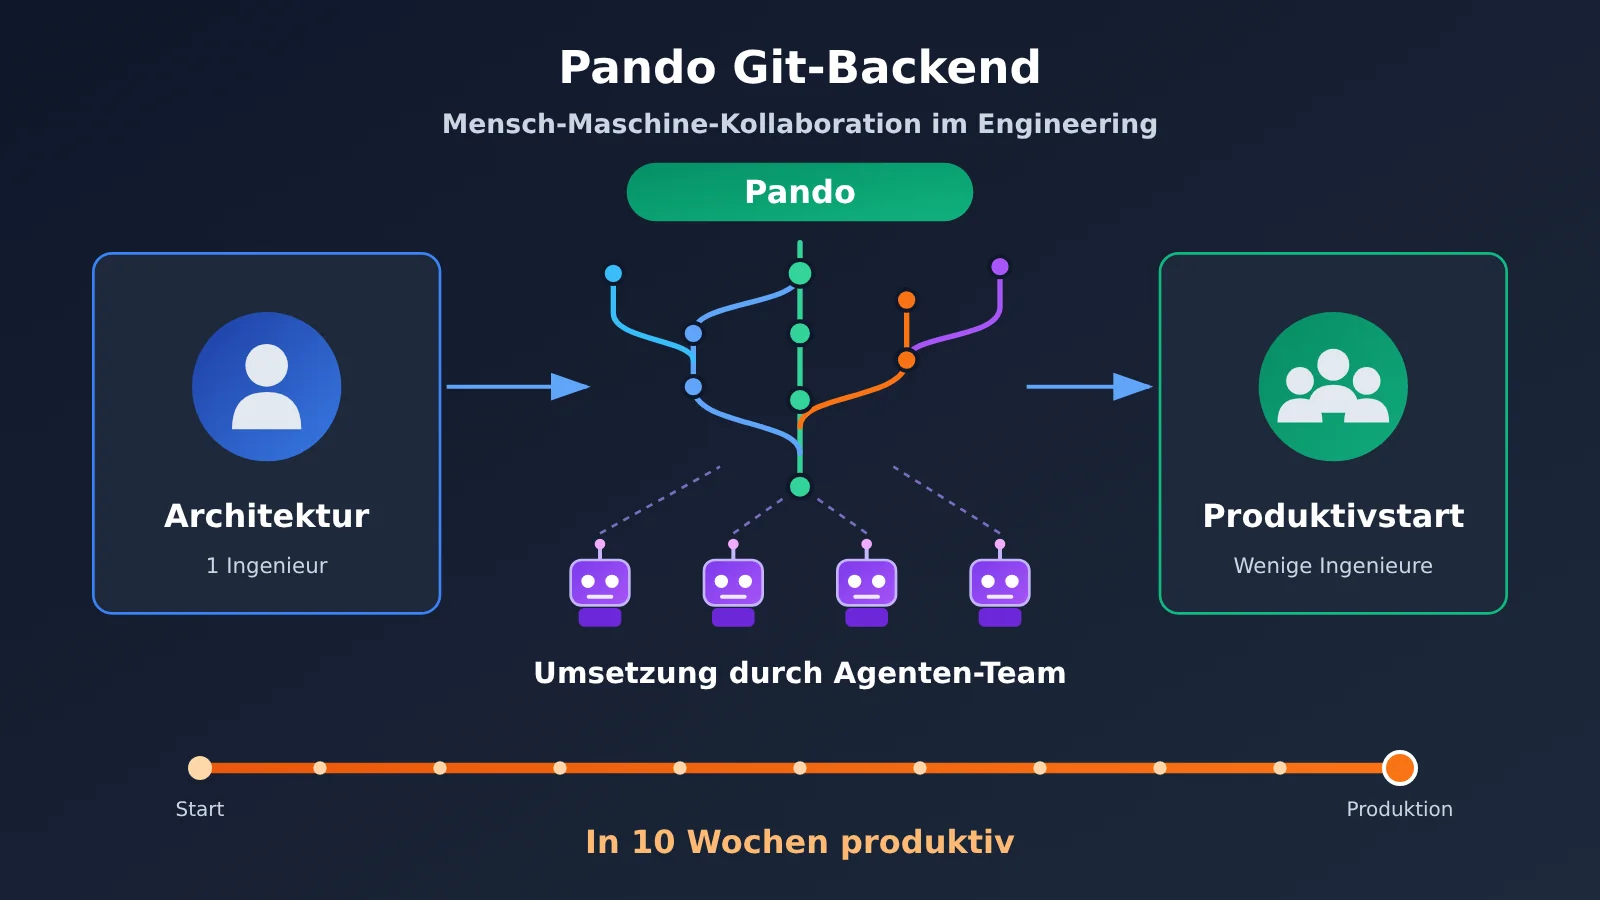
Pando im Überblick: Was die Codex-Agent-Teams geliefert haben
Die folgende Tabelle fasst die offiziell bestätigten Informationen zusammen. Wichtig: Pando ist ein Git-kompatibles Server-Backend – weder ein neues Versionskontrollprotokoll noch ein direkter Ersatz für GitHub.
| Information | Details |
|---|---|
| Veröffentlichung | 2. November 2026, offizieller Artikel „Scaling Git at OpenAI“ |
| Autoren | Aaron Friel, Taylor Blau und Ted Nyman (OpenAI-Techniker) |
| Projektzeitraum | Rund 10 Wochen vom Start bis zum Produktionseinsatz; seit April 2026 verarbeitet Pando Produktionsverkehr |
| Implementierungssprache | Das Server-Backend wurde hauptsächlich in Rust von Grund auf neu entwickelt; Abhängigkeiten vom Altsystem wurden bewusst vermieden |
| Aufgabenteilung zwischen Mensch und KI | Ein Ingenieur entwarf die Kernarchitektur, mehrere Agent-Teams implementierten sie, einige wenige Ingenieure übernahmen das Deployment |
| Ergebnis im Produktionsbetrieb | Die mediane Push-Latenz sank um fast 80 %; täglich werden knapp 1 PB Git-Daten ausgeliefert |
| Verfügbarkeit | Stand 2026-11-03: Kein öffentliches Server-Backend, keine API und keine Preise veröffentlicht |
Warum OpenAI das Git-Backend mit Codex-Agenten neu aufbauen musste
Ausgangspunkt für Pando war der rasante Anstieg der Code-Commits. Eine offizielle Grafik verwendet die Zahl der im ersten Quartal 2024 in den Hauptbranch gemergten Commits als Basis und zeigt das Wachstum in den folgenden Quartalen. Die Tabelle greift einige Zeitpunkte heraus.
| Quartal | Wachstum der Commits gegenüber 2024 Q1 | Einordnung |
|---|---|---|
| 2024 Q4 | +98 % | Fast eine Verdopplung |
| 2025 Q4 | +264 % | Das Altsystem konnte mit den Anforderungen zunehmend nicht mehr Schritt halten |
| 2026 Q1 | +432 % | Pando befand sich in der Entwicklung |
| 2026 Q3 | +1.378 % | Rund das 14,78-Fache des Basiswerts |
| 2026 Q4 | +2.442 % | Offizielle Prognose, kein tatsächliches Ergebnis eines abgeschlossenen Quartals |
Eine wichtige Grenze bei der Interpretation: Die Zahl der Commits ist nicht gleichbedeutend mit der Zahl der Codezeilen, der PRs oder der Entwicklungsproduktivität. Daraus lässt sich also weder ableiten, dass „die Codemenge um das 25-Fache gestiegen ist“, noch, dass „Codex die Effizienz der Ingenieure um das 25-Fache gesteigert hat“. OpenAI erklärt den Anstieg selbst damit, dass Ingenieure dank Codex mehr Aufgaben gleichzeitig bearbeiten können. Das führt zu mehr parallelen Branches, Pushes, Merges, CI-Jobs sowie Fetch- und Clone-Anfragen.
Gegen Ende 2025 wurde das Altsystem bei Push und Fetch langsamer, zudem schlugen Merges fehl. Die Zuverlässigkeit lag zeitweise unter 90 %. OpenAI hat weder die genaue Berechnung dieser Kennzahl noch ihren zeitlichen Verlauf veröffentlicht. Daraus lässt sich deshalb auch nicht schließen, dass „mehr als 10 % aller Commits fehlgeschlagen sind“.
Die 4 wichtigsten Designentscheidungen in Pandos technischer Architektur
Pando ersetzt Git nicht, sondern gestaltet die Speicherung, die Aktualisierung von Referenzen und die Bereitstellung von Daten im Backend neu. Wer diese Entscheidungen versteht, erkennt auch, welche Abwägungen Menschen getroffen haben, die sich nicht ersetzen lassen.
- Unabhängige Branch-Updates: Statt einen konsistenten Snapshot des gesamten Repositorys zu einem einzigen Zeitpunkt zu pflegen, verwaltet jeder Branch seine Version unabhängig. Nur Anfragen, die denselben Ref ändern, müssen koordiniert werden. Dabei kommt ein Modell kausaler Konsistenz zum Einsatz. Der Nachteil: Beim gleichzeitigen Lesen mehrerer Branches können diese aus unterschiedlichen Zeitpunkten stammen.
- Packfiles speichern und wiederverwenden: Jedes bei einem Push empfangene Packfile wird als unveränderliche Daten im Blob Store gespeichert. Beim Fetch werden anhand der have/want-Angaben des Clients vorhandene Packfiles ausgewählt. Über Gits packfile-uri-Mechanismus werden die Download-Adressen bereitgestellt, sodass die Daten nicht für jeden Client erneut gepackt und komprimiert werden müssen.
- Regionaler Cache Express: Cluster und lokale Caches werden in mehreren Regionen betrieben. Konsistentes Hashing verteilt die Anfragen; die Trefferquote des Packfile-Caches liegt bei über 99 %. Dabei handelt es sich um einen Cache für Git-Daten, nicht um Prompt Caching für APIs Großer Sprachmodelle.
- Mehrstufige Compaction im Hintergrund: Ähnlich wie bei einem LSM Tree werden kleine Packfiles schrittweise zu größeren Mengen zusammengeführt, die zusammenhängende Versionsintervalle abdecken. Das aktuelle Monorepo nutzt dabei bis zu Stufe L4.
OpenAI hat außerdem drei Architekturtypen verglichen und eine Simulation mit 1.000 Clients und insgesamt 10.000 Pushes durchgeführt. Es handelt sich um eine von OpenAI erstellte synthetische Lehrsimulation, nicht um einen unabhängigen Benchmark eines Dritten.
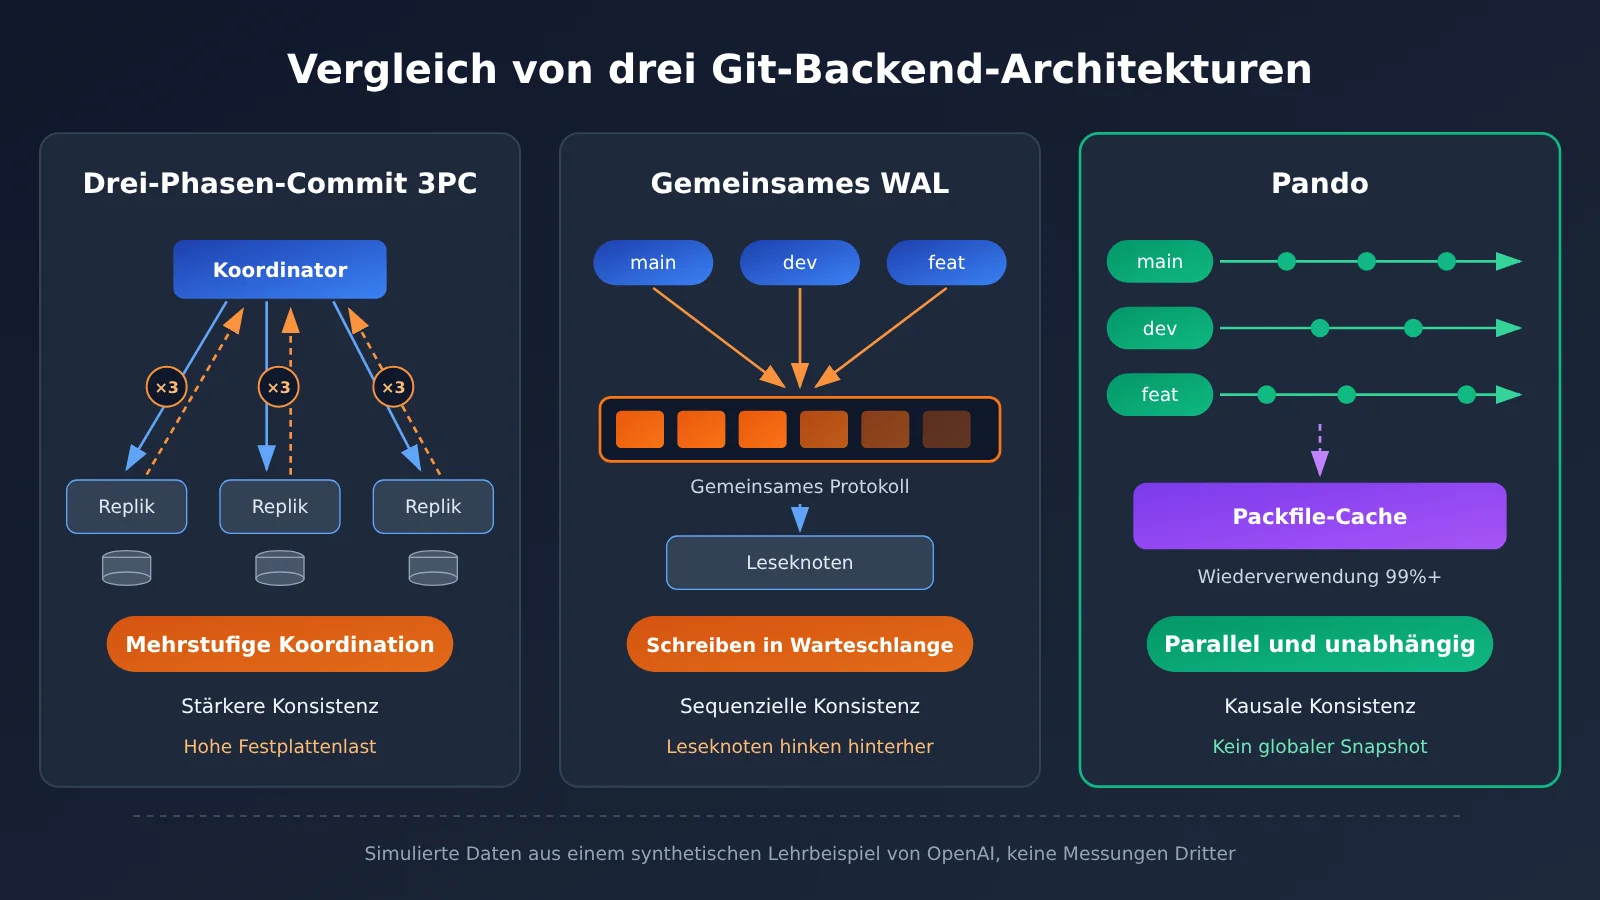
| Architektur | Schreibverfahren | Konsistenz | Hauptengpass |
|---|---|---|---|
| Drei-Phasen-Commit 3PC | Koordiniertes Schreiben über mehrere vollständige Replikate | Relativ stark | Mehrere Koordinationsrunden und Festplattenlast bremsen parallele Schreibvorgänge |
| Gemeinsames WAL | Alle Updates konkurrieren um dasselbe Log | Sequentielle Konsistenz | Leseknoten fallen zurück, wenn schneller geschrieben als angewendet wird |
| Pando | Unabhängige atomare Transaktionen pro Ref | Kausale Konsistenz | Verzicht auf einen Snapshot des gesamten Repositorys zum selben Zeitpunkt |
Zu den offiziell veröffentlichten Produktionsdaten gehören außerdem: In Spitzenzeiten wurden innerhalb einer Stunde mehr als 57 TB an Packfiles ausgeliefert, wobei über 99 % der Bytes aus lokalen Festplatten-Caches stammten. Clone und Fetch können auf Standard-Cloud-VMs eine 10-Gbps-Verbindung voll auslasten. Das Lesen und Schreiben von Metadaten beim Push hat eine Komplexität von O(1), das Lesen von Metadaten für die Fetch-Planung eine von O(log Δ). Diese Komplexitätsangaben beziehen sich auf Metadatenoperationen, nicht auf die gesamte Netzwerkdauer.
Wie das Codex-Agent-Team die Arbeit an Pando aufteilte
„Ein Ingenieur entwarf den Kern“ bedeutet nicht, dass nur eine Person am Projekt beteiligt war. Ebenso wenig heißt „Ein Agent-Team setzte das Projekt um“, dass jede Codezeile von KI geschrieben wurde. Auf Basis der offiziell beschriebenen Aufgaben lässt sich die Arbeitsteilung wie folgt zusammenfassen. OpenAI hat allerdings keine konkreten Aufgabenlisten für die einzelnen Agenten veröffentlicht.
| Rolle | Übernommene Aufgaben | Warum diese Rolle? |
|---|---|---|
| Architekturingenieur (Mensch) | Engpässe des alten Systems analysieren, auf Kompatibilität mit dem Git-Protokoll bestehen, unabhängige Branch-Updates und die Wiederverwendung von Packfiles wählen, auf starke Konsistenz im gesamten Repository verzichten | Diese unumkehrbaren technischen Entscheidungen bestimmen die Grenzen des Systems |
| Codex und andere Agenten | Implementierung des Rust-Backends, Protokollkompatibilität für Push und Fetch, gleichzeitige Schreibzugriffe, Performance-Optimierung, Behebung von Randfallproblemen | Der Implementierungsaufwand ist hoch, und die Ergebnisse lassen sich wiederholt durch Tests prüfen – ideal für parallele Iterationen |
| Validierungsagenten | In lang laufenden Sitzungen nach Randfällen suchen; Modelle mit Daybreak-Fähigkeiten führen rund um die Uhr adversariale Tests durch | Die kontinuierliche Prüfung lässt sich von Menschen kaum mit derselben Häufigkeit leisten |
| Deployment-Ingenieur (Mensch) | Datenverkehr schrittweise umleiten, altes und neues System synchronisieren, Hunderte Integrationen migrieren | Produktionsrisiken und organisatorische Abstimmung erfordern menschliche Verantwortung |
Die Tabelle zeigt das Grundprinzip: Menschen legen Architektur, Rahmenbedingungen und Abnahmeziele fest; Agenten übernehmen einen großen Teil der Implementierung und Iteration. Die Ingenieure verantworten die Migration in die Produktionsumgebung und die Zuverlässigkeit des Systems. Da OpenAI keine Vergleichsgruppe mit rein menschlicher Entwicklung bereitgestellt hat, lässt sich nicht berechnen, um welchen Faktor Codex das Projekt beschleunigt hat.
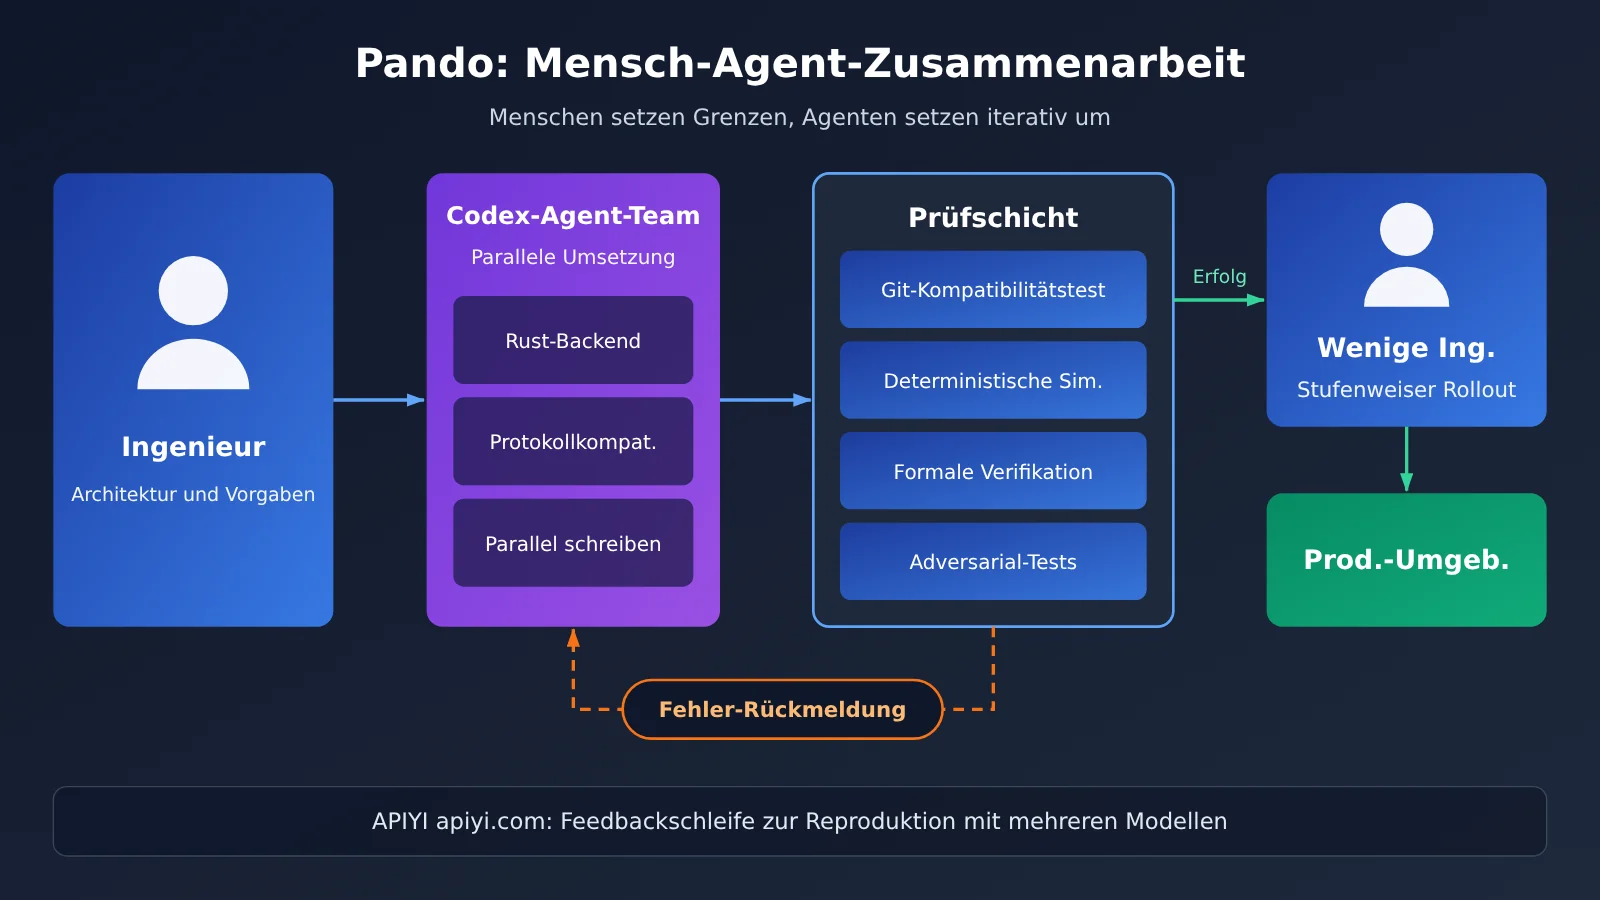
Pandos Testsystem: Warum Codex-Agenten an der Infrastruktur mitentwickeln können
Pando ist Infrastruktursoftware. Fehler wirken sich darauf aus, ob Branches auf den richtigen Commit zeigen, ob beim Push Objekte verloren gehen oder ob ein Fetch die vollständige Historie liefert. Eine fehlerhafte Webseite lässt sich neu laden; ein fehlerhaftes Git-Backend kann dagegen die Entwicklung eines ganzen Unternehmens lahmlegen. Deshalb stattet OpenAI seine Agenten nicht einfach mit längeren Eingabeaufforderungen aus, sondern mit einem ausführbaren Verifikationssystem.
Git-Kompatibilitätstests: Entscheidend ist das Verhalten, nicht die Kompilierung
OpenAI hat die Git Conformance Test Suite entwickelt. Damit können Agenten nach Änderungen an der Serverimplementierung selbst prüfen, ob sich diese wie erwartet mit Standard-Git verhält. Getestet werden Ref-Aktualisierungen, Push, Fetch, Packfile-Übertragungen und Protokollkompatibilität. Entscheidend ist die Übereinstimmung mit dem Verhalten von Git – nicht nur, dass der Code kompiliert und die Unit-Tests bestehen. Die Anzahl der Testfälle hat OpenAI nicht veröffentlicht.
Deterministische Nebenläufigkeitssimulation: Race Conditions reproduzierbar machen
Die schwierigsten Fehler in verteilten Systemen entstehen oft, wenn mehrere Vorgänge ineinandergreifen. OpenAI verwendet Deterministic Simulation Harnesses, um Systemzustände und nebenläufige Ereignisse reproduzierbar zu simulieren. Das hilft, Race Conditions, Probleme bei der Git-Aushandlung, Fehler bei der Packfile-Planung und Regressionen aufzuspüren. Ändern beispielsweise zwei Agenten gleichzeitig denselben Branch, dürfen nicht beide widersprüchlichen Updates als erfolgreich gelten. Außerdem muss ein neues Commit-Objekt bereits lesbar sein, bevor der Branch-Zeiger aktualisiert wird. Diese Beispiele erläutern die Testziele; sie sind keine einzeln von OpenAI veröffentlichten Testfälle.
Formale Verifikation mit Lean und TLA+: Auf den Zeitrahmen achten
OpenAI hat offengelegt, dass GPT-6 Astra Agenten dabei unterstützt, formale Beschreibungen in Lean und TLA+ zu erstellen. Die daraus entstandene sogenannte „Theory of Pando“ dient dazu, Invarianten zu prüfen, Fehler zu finden und zu beheben sowie bestimmte Eigenschaften zu beweisen. Dabei gibt es zwei Einschränkungen: Erstens werden ausgewählte Eigenschaften verifiziert – das bedeutet nicht, dass sämtliche Codepfade des Systems mathematisch bewiesen sind. Zweitens wurden laut OpenAI neu erschienene Modelle fortlaufend eingesetzt, um Leistung und Zuverlässigkeit zu verbessern. Diese Praktiken lassen sich daher nicht vollständig den ersten zehn Wochen zuordnen.
Lange Agentensitzungen und adversariale Sicherheitstests
OpenAI berichtet außerdem, dass mehrere aufeinanderfolgende Agentensitzungen über Hunderte Stunden liefen, um Probleme in Randfällen zu finden und zu beheben. Modelle mit Daybreak-Fähigkeiten testeten Git und Pando fortlaufend adversarial. OpenAI hat weder die Anzahl der Agenten noch die Dauer einzelner Sitzungen, den Token-Verbrauch, die Anzahl behobener Bugs oder die Häufigkeit menschlicher Aufsicht veröffentlicht. Daraus lässt sich also nicht ableiten, dass „Agenten Hunderte Stunden lang unbeaufsichtigt Code geschrieben haben“. Interessant ist vor allem der veränderte Ansatz: Agenten werden nicht nur für die erste Codegenerierung, sondern auch für die kontinuierliche Verifikation eingesetzt.
Auch der von OpenAI veröffentlichte Git-Fork liefert indirekte Hinweise auf diese laufende Verbesserung. Beispiele sind Patches für paralleles Hashing in index-pack im August 2026 sowie für Wiederholungsversuche bei Drosselung und die Wiederverwendung fertiggestellter Packs im Oktober. Diese Commits entstanden jedoch alle nach der ersten Inbetriebnahme im April 2026 und zählen daher ebenfalls nicht zu den Ergebnissen der ersten zehn Wochen.
Schrittweise Migration zu Pando: Code vom Codex Agent ist nicht automatisch produktionsreif
Die zehn Wochen bezeichnen den Zeitraum vom Start bis zum Produktionseinsatz, nicht die gesamte Zeit bis zur vollständigen Reife. Pando wurde schrittweise und ohne Ausfallzeiten eingeführt. Laut offizieller Darstellung lief die Migration ungefähr so ab:
- Pando wurde als vorgeschalteter Proxy für Lese- und Schreibzugriffe vor das alte System gesetzt. Das alte und das neue Backend blieben synchron.
- Bei tatsächlichen Anfragen wurden identische Anfragen gebündelt und Git-Daten zwischengespeichert. Nachdem ein Teil des Datenverkehrs umgeleitet worden war, wurde das alte System dadurch sogar entlastet.
- Über einen internen Wrapper für die Git-CLI wurden die Clients der Entwicklerinnen und Entwickler schrittweise migriert.
- Hunderte Integrationen, die von der alten API, Webhooks und Methoden zum Herunterladen von Repositories abhingen, wurden ebenso migriert wie die Review- und Change-Request-Workflows.
- Für die Migration wurden Codex Skills bereitgestellt. So konnten Entwickler Codex direkt bei der Vorbereitung lokaler Repositories und der Migrationsumgebung einsetzen.
- Der verbesserte Git-Client wurde auf den Geräten der Entwickler und in der ChatGPT-Desktop-App ausgerollt.
Laut offizieller Darstellung wurde die Entwicklungsarbeit während der gesamten Migration nicht unterbrochen. Angaben zur Rollback-Rate, zur Verteilung von Störungen und zu fehlgeschlagenen Fällen wurden jedoch nicht veröffentlicht. Für technische Verantwortliche ist dieser Teil interessanter als die „zehn Wochen“: Alte Workflows kompatibel halten, Integrationen migrieren und Datenverkehr schrittweise umleiten – all das ist häufig mindestens so komplex wie die Entwicklung des neuen Systems selbst.
Pando: Was bedeutet das für Agent-Entwickler und technische Teams?
Auswirkungen auf Agent-Entwickler
- Die Möglichkeiten eines Agents hängen von der Verifizierbarkeit ab: Pando ermöglicht es Agents, an Kernimplementierungen mitzuwirken. Voraussetzung sind Kompatibilitätstests, deterministische Simulationen und formale Beschreibungen, die zuverlässiges Feedback liefern.
- Die Rolle von Agents erweitert sich: Sie schreiben nicht nur Code, sondern suchen auch kontinuierlich nach Randfällen, führen adversariale Tests durch und unterstützen Nutzer bei der Migration.
Auswirkungen auf technische Verantwortliche
- AI Coding erhöht die Last in nachgelagerten Prozessen: Mehr Commits bedeuten auch mehr Arbeit für CI, Code-Reviews und Code-Hosting. OpenAI berichtete in einem weiteren Artikel im Juli 2026, dass sich die interne Zahl wöchentlicher PRs gegenüber dem vorherigen vierten Quartal mehr als verdoppelt hatte. Code-Reviews wurden dabei zu einem neuen Engpass.
- Ein eigenes Pando ist nicht automatisch nötig: Skalierungsprobleme großer Monorepos gab es schon vor dem KI-Zeitalter. Die allermeisten Teams müssen kein Git-Backend neu entwickeln.
Vergleich mit einem Harness-Engineering-Projekt
Im Februar 2026 stellte OpenAI ein weiteres, unabhängiges Projekt vor: Ausgehend von einem leeren Repository schrieb Codex den Produktivcode. In rund fünf Monaten entstanden etwa eine Million Codezeilen und rund 1.500 PRs. Anfangs wurde das Projekt von drei Ingenieuren vorangetrieben. Es handelte sich nicht um dasselbe Team oder denselben Prozess wie bei Pando; die Zahlen dürfen daher nicht vermischt werden. Beide Projekte zeigen aber denselben Trend: Ingenieure übernehmen zunehmend die Gestaltung von Systemen, Testumgebungen und Agent-Workflows. Zu den Erfahrungen aus dem Projekt gehören, Aufgaben in kleine Schritte aufzuteilen, für jeden Branch eine eigene Laufzeitumgebung bereitzustellen, Agents Zugriff auf Logs und Metriken zu geben und ihnen über AGENTS.md Orientierung zu bieten, statt die gesamte Wissensbasis in die Eingabeaufforderung zu packen.
Auf Hacker News gab es auch andere Stimmen: Kritiker argumentierten, dass mehr Commits nicht gleichbedeutend mit höherer Qualität seien. Befürworter hielten dagegen, dass die sinkenden Kosten für das Schreiben von Code mehr kleine Projekte möglich machten. Das sind Meinungen aus der Community, keine statistischen Schlussfolgerungen.
So nutzen Sie den Ansatz des Codex-Agent-Teams: ein testgetriebener Feedback-Loop
Bei Pando lässt sich vor allem eine Idee auf andere Projekte übertragen: Agenten erhalten Feedback, das sich direkt überprüfen lässt. Der folgende minimale testgetriebene Loop zeigt das Prinzip: Das Modell erzeugt einen Patch und erhält die Testergebnisse zurück, um den Code weiter zu korrigieren.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="YOUR_CODING_MODEL",  # Durch das zu testende Coding-Modell ersetzen
    messages=[{"role": "user", "content": "根据以下失败测试修复函数:..."}]
)
print(resp.choices[0].message.content)
Vollständige Implementierung des Test-Feedback-Loops anzeigen
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "你是严格遵守约束的工程 Agent。"
    "只修改指定文件,不得改动测试;输出完整的新文件内容。"
)

def run_tests() -> tuple[bool, str]:
    """Führt die Überprüfung aus, entsprechend den Kompatibilitätstests bei Pando."""
    r = subprocess.run(["pytest", "-q", "tests/"], capture_output=True, text=True)
    return r.returncode == 0, r.stdout[-3000:] + r.stderr[-1000:]

def agent_loop(target: str, spec: str, max_rounds: int = 5) -> bool:
    for i in range(max_rounds):
        ok, log = run_tests()
        if ok:
            print(f"第 {i} 轮:测试全部通过,等待人工审核")
            return True
        source = open(target, encoding="utf-8").read()
        resp = client.chat.completions.create(
            model="YOUR_CODING_MODEL",
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content":
                    f"需求与约束:\n{spec}\n\n当前代码:\n{source}\n\n测试输出:\n{log}"}
            ],
        )
        with open(target, "w", encoding="utf-8") as f:
            f.write(resp.choices[0].message.content)
    print("达到轮次上限,转交人类工程师处理")
    return False

agent_loop("src/ref_store.py", "同一分支的并发更新必须只有一个成功")
🚀 Schnellstart: Für den Aufbau eines solchen Feedback-Loops können Sie zunächst kostenloses Testguthaben bei APIYI auf apiyi.com nutzen. Mit demselben API-Schlüssel wechseln Sie zwischen verschiedenen Coding-Modellen und vergleichen, wie erfolgreich sie Fehler in Ihrer Testsuite beheben.
Die folgende Tabelle überträgt Pandos Vorgehen auf ein Framework, das auch andere Teams nutzen können. Die Empfehlungen basieren auf öffentlich zugänglichen Informationen; es handelt sich nicht um einen von OpenAI veröffentlichten Pando-Workflow.
| Phase | Wichtige Schritte | Vorgehen bei Pando | Geeignete Werkzeuge |
|---|---|---|---|
| Ziele und Grenzen festlegen | Protokolle definieren, die kompatibel sein müssen, sowie nicht verhandelbare Kennzahlen | Git-Protokollkompatibilität beibehalten | Designdokumente, AGENTS.md |
| Testumgebung aufbauen | Kompatibilitätstests, Parallelitätssimulation und Regressionstests | Konformitätstests und deterministische Simulation | pytest, Property-Based Testing, TLA+ |
| Aufgaben an Agenten verteilen | Kleine Aufgaben, separate Branches und automatische Tests | Umsetzung durch mehrere Agententeams | Modellaufrufe mit mehreren Modellen, etwa über APIYI auf apiyi.com |
| Menschliche Prüfung | Wichtige Abwägungen, modulübergreifende Abhängigkeiten und Sicherheitsauswirkungen prüfen | Architektur unter Kontrolle menschlicher Entwickler | Code-Review-Regeln |
| Schrittweise in Betrieb nehmen | Mit wenig Traffic starten und Kompatibilität mit dem alten System bewahren | Durchleitender Proxy für Lese- und Schreibzugriffe, Migration in Etappen | Schrittweise Releases, Monitoring-Kennzahlen |
Häufig gestellte Fragen (FAQ)
F1: Was ist Pando?
Pando ist ein internes, Git-kompatibles Server-Backend von OpenAI, das sämtliche Entwicklungsaktivitäten im monolithischen Code-Repository unterstützt. Es behält das standardmäßige Git-Protokoll und die Git-Clients bei, gestaltet aber Referenzaktualisierungen, die Wiederverwendung von Packfile-Speicher und die Auslieferung über Caches neu. So sollen viele Agents und Entwickler gleichzeitig Änderungen einreichen und Daten lesen können.
F2: Hat eine einzelne Person Pando mit Codex entwickelt?
Nein. Laut OpenAI hat ein Entwickler die Kernarchitektur entworfen, mehrere Agent-Teams haben sie implementiert und einige wenige Entwickler haben Pando bereitgestellt. OpenAI hat weder die Zahl der Beteiligten noch den Anteil manuell geänderter Codezeilen oder die Agent-Konfiguration veröffentlicht. Auch wurde nicht behauptet, dass der gesamte Code von Codex erzeugt oder ohne menschliche Prüfung übernommen wurde.
F3: Wann wurde Pando eingeführt und ist es öffentlich nutzbar?
Pando verarbeitet seit April 2026 Produktionsdatenverkehr. Der technische Artikel wurde am 2. November 2026 veröffentlicht. Stand 3. November 2026 gibt es weder einen öffentlich verfügbaren Server oder eine API noch Angaben zu Preisen oder einem Veröffentlichungstermin. Öffentlich verfügbar sind lediglich OpenAIs Fork des Git-Clients und einige Upstream-Patches. Das bedeutet nicht, dass der Pando-Server quelloffen ist.
F4: Wurden alle Validierungsarbeiten innerhalb von zehn Wochen abgeschlossen?
So lässt sich das nicht sagen. Laut OpenAI wurden neu erschienene Modelle fortlaufend zur Verbesserung von Pando eingesetzt. Es lässt sich nicht bestätigen, dass die von GPT-6 Astra unterstützte formale Arbeit mit Lean/TLA+, die Hunderte Stunden an Agent-Sitzungen und die adversarialen Tests vollständig innerhalb der ersten zehn Wochen stattfanden. Auch die veröffentlichten Git-Patches entstanden überwiegend nach der ersten Inbetriebnahme.
F5: Wie lässt sich mit einer API ein ähnlicher Test- und Feedbackzyklus für Agents aufbauen?
Beginnen Sie am besten mit einem kleinen Modul:
1. Registrieren Sie sich bei APIYI auf apiyi.com und sichern Sie sich einen API-Schlüssel und kostenloses Testguthaben.
2. Schreiben Sie zunächst ausführbare Tests oder Kompatibilitätsprüfungen und lassen Sie erst danach das Modell den Code ändern.
3. Nutzen Sie den Code aus diesem Artikel, setzen Sie base_url auf `https://api.apiyi.com/v1` und wiederholen Sie den Zyklus „Generieren – Testen – Logs zurückführen“.
Da die Schnittstelle mit OpenAI kompatibel ist, müssen Sie zum Wechsel zwischen Modellen nur den Parameter model ändern. So lassen sich die Ergebnisse der Fehlerbehebung leicht vergleichen.
F6: Welche Grenzen gibt es, wenn andere Teams Pandos Vorgehen direkt übernehmen?
Es gibt drei wesentliche Einschränkungen: Erstens sind die Kosten unbekannt, da OpenAI keine Ausgaben für Tokens und Infrastruktur veröffentlicht hat. Zweitens hängt Pando von einem hochwertigen Validierungssystem ab. In Projekten ohne Tests ist es riskanter, Agents große Mengen Code schreiben zu lassen. Drittens lässt sich das Ergebnis von zehn Wochen nicht auf alle Projekte ähnlicher Größe übertragen. Testen Sie den Ansatz zunächst mit einem kleinen Budget bei APIYI auf apiyi.com in einem weniger kritischen Modul. Wenn der Feedbackzyklus funktioniert, können Sie den Einsatz ausweiten.
Pando und Codex Agent: Die wichtigsten Erkenntnisse
- Was ist Pando? Ein interner, Git-kompatibler Backend-Dienst von OpenAI, der nach rund zehn Wochen in Produktion ging und nicht öffentlich verfügbar ist.
- Warum wurde Pando entwickelt? Codex erhöhte die Zahl gleichzeitiger Commits. Das alte System wurde dadurch langsamer und Merges schlugen fehl.
- Aufgabenteilung zwischen Mensch und Agent: Menschen legen Architektur und Rahmenbedingungen fest, der Agent setzt sie iterativ um, Ingenieure übernehmen das Deployment.
- Entscheidend für den Erfolg: Kompatibilitätstests, deterministische Simulationen und formale Verifikation lieferten zuverlässiges Feedback.
- Einordnung des Zeitrahmens: Spätere neue Modelle und Verifikationsmethoden lassen sich nicht vollständig den ursprünglichen zehn Wochen zurechnen.
- Einführung: Ein Proxy für Lese- und Schreibzugriffe und eine schrittweise Umstellung des Datenverkehrs ermöglichten die Migration ohne Unterbrechung der täglichen Entwicklung.
- Erste Schritte: Zunächst Tests erstellen und dann die Feedbackschleife mit mehreren Modellen über APIYI apiyi.com überprüfen.
Fazit
Die wichtigsten Erkenntnisse aus dem Pando-Beispiel:
- Skalierung erzwingt neue Infrastruktur: Mehr Commits durch AI Coding wirken sich auf Git, CI und Code-Reviews aus. Pando ist eine technische Antwort auf diesen Druck.
- Die Ergebnisse von Agenten hängen von der Überprüfung ab: Das Codex-Agent-Team konnte an der Implementierung der Infrastruktur mitwirken, weil ausführbare Kompatibilitätstests, Simulationen gleichzeitiger Zugriffe und formale Beschreibungen vorhanden waren.
- Menschliche Entscheidungen bleiben entscheidend: Für Architekturabwägungen, Konsistenzgrenzen und die Migration in die Produktionsumgebung sind menschliche Ingenieure verantwortlich.
Für die meisten Teams ist nicht die Zahl „zehn Wochen“ übertragbar, sondern das Zusammenspiel von klaren Rahmenbedingungen, ausführbaren Tests, Aufgabenverteilung, kontinuierlichem Feedback und menschlichen Entscheidungen an den entscheidenden Stellen. Vollautomatische Entwicklung muss nicht das Ziel sein: Lassen Sie einen Agenten zunächst die Feedbackschleife in einem kleinen, vollständig getesteten Modul durchlaufen und erweitern Sie den Umfang anschließend schrittweise.
Um die Ergebnisse schnell zu überprüfen, empfiehlt sich APIYI apiyi.com. Die Plattform bietet eine OpenAI-kompatible Schnittstelle und kostenloses Startguthaben für neue Nutzer. So lassen sich verschiedene Programmiermodelle innerhalb derselben Feedbackschleife vergleichen.
📚 Quellen
- Offizieller OpenAI-Technikartikel „Scaling Git at OpenAI“: Hauptquelle für Architektur, Migration und Leistungsdaten von Pando
- Link:
openai.com/index/scaling-git-at-openai -
Hinweis: Veröffentlicht am 2026-11-02; zentrale Grundlage für die Fakten in diesem Artikel
-
OpenAI Harness Engineering: Ein weiteres internes Projekt, dessen Entwicklung von Codex geleitet wurde
- Link:
openai.com/index/harness-engineering -
Hinweis: Hilft beim Verständnis der Agent-Entwicklungsmethodik; die Daten dürfen nicht mit denen von Pando vermischt werden
-
Custom Code Review Rules for Codex: Engpässe bei der Codeprüfung durch KI-gestützte Entwicklung
- Link:
developers.openai.com/blog/custom-code-review-rules-for-codex -
Hinweis: Beschreibt den Anstieg der internen wöchentlichen PR-Zahlen und die Prüfregeln in AGENTS.md
-
Öffentlicher Git-Fork von OpenAI: Repository mit Verbesserungen für den Client
- Link:
github.com/openai/git -
Hinweis: Enthält Verbesserungen wie packfile-uri, aber nicht den Quellcode des Pando-Servers
-
OpenAI Git Patch Tracker: Dokumentation der Beiträge zum Upstream-Projekt
- Link:
oai-git.openai.chatgpt.site - Hinweis: Hier lassen sich die kontinuierlichen technischen Verbesserungen nach der Inbetriebnahme nachvollziehen
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Agent-Entwicklung finden Sie im Dokumentationszentrum unter docs.apiyi.com.