Anmerkung des Autors: Dieser Artikel zeigt, wie Flint-interactive mit „semantischen Ereignissen + Aktualisierungsoperationen“ den Aufwand und die Fehlerquote bei der Erstellung interaktiver Diagramme durch Agents senkt, und stellt drei Integrationswege vor.
Wer einen KI-Agent für Datenanalyse oder Reporting entwickelt, kennt vielleicht dieses Problem: Der Agent erstellt schnell ein statisches Diagramm, doch sobald „Klick zum Filtern“ oder eine „verknüpfte Auswahl per Rahmen“ hinzukommt, sind mehrere Korrekturrunden nötig. Mal ist das Layout verschoben, mal funktioniert die Hervorhebung nicht. Ist ein Problem behoben, taucht an anderer Stelle das nächste auf – Token und Zeit fließen ins Debugging.
Microsoft Research hat Flint-interactive am 22. Oktober 2026 veröffentlicht. Es ist eine auf Flint aufbauende Sprache für interaktive Datenvisualisierung. Dieser Artikel empfiehlt keine neue Diagrammbibliothek. Stattdessen betrachten wir Flint-interactive als Beispiel dafür, wie sich Ausgabevorgaben auf höherer Abstraktionsebene für Agents gestalten lassen, damit sie weniger Rendering-Code auf niedriger Ebene schreiben müssen.
Das nehmen Sie mit: Sie verstehen die Kosten- und Zuverlässigkeitsprobleme bei der Erstellung interaktiver Diagramme durch Agents. Außerdem lernen Sie den Ansatz kennen, die visuelle Logik dem Compiler zu überlassen und die Interaktionslogik mit semantischen Ereignissen zu beschreiben. Und Sie erfahren, für welche Szenarien sich die drei Integrationswege eignen: im Dialog, in einer Anwendung und mit benutzerdefinierten Interaktionen.
Warum es aufwendig ist, einen Agenten Interaktionscode ohne Flint-interactive schreiben zu lassen
Einen Agenten den Code für interaktive Diagramme direkt schreiben zu lassen, scheint die flexibelste Lösung zu sein. Der Forschungsblog nennt jedoch zwei deutliche Engpässe bei der praktischen Umsetzung – selbst mit leistungsstarken aktuellen Modellen.
Der erste Engpass sind hohe Generierungskosten. Ein Agent liefert selten in einem einzigen Durchlauf ein zufriedenstellendes interaktives Diagramm. Meist sind mehrere Runden für Schlussfolgerungen, Programmierung und Debugging nötig – und jede kostet Token und Zeit. Der zweite Engpass ist die mangelnde Zuverlässigkeit. Interaktive Visualisierungen sind komplex: Bei anspruchsvollen Diagrammen gerät leicht das Layout durcheinander oder eine Interaktion funktioniert nicht. Bei der Fehlerbehebung können zudem neue Probleme entstehen.
Wäre es also eine Lösung, einfach die eingebauten Interaktionen einer Diagrammbibliothek zu nutzen? Der Blog kommt zu dem Schluss, dass diese bei manchen Visualisierungsbibliotheken nicht ausdrucksstark genug sind. Individuelle interaktive Diagramme lassen sich damit nur schwer umsetzen. Letztlich fehlt eine Sprache zur Beschreibung von Interaktionen, die sowohl ausdrucksstark als auch ausreichend abstrakt ist.
| Ansatz | Was der Agent ausgeben muss | Hauptproblem | Eignung |
|---|---|---|---|
| Rendering-Code direkt auf niedriger Ebene schreiben | Event-Listener, Treffererkennung, Neuzeichnungslogik | Mehrere Debugging-Runden, hoher Token-Verbrauch, neue Bugs durch Änderungen | Am ausdrucksstärksten, aber wenig stabil |
| Nur eingebaute Interaktionen der Diagrammbibliothek nutzen | Einige Konfigurationsoptionen ein- oder ausschalten | Begrenzte Auswahl an Interaktionen, schwer anzupassen | Stabil, aber nicht ausdrucksstark genug |
| Flint-interactive-Spezifikation | Zuordnung semantischer Ereignisse zu Aktualisierungsaktionen | Eine neue Spezifikation muss erlernt werden | Verbindet Ausdrucksstärke und Zuverlässigkeit |
Wenn Ihr Agent für solche Generierungsaufgaben mit mehreren Durchläufen häufig zwischen Modellen wechseln muss, können Sie über die einheitliche Schnittstelle von APIYI apiyi.com mehrere gängige Modelle anbinden. Mit demselben Aufrufcode lassen sich die Anzahl der Durchläufe und der Verbrauch verschiedener Modelle vergleichen. So finden Sie zunächst heraus, wie teuer das Schreiben von Code auf niedriger Ebene in Ihrem Anwendungsfall tatsächlich ist.
Flint-interactive: Das Wichtigste im Überblick
| Aspekt | Beschreibung | Nutzen für Entwickler |
|---|---|---|
| Semantische Ereignisse | Der Compiler übersetzt rohe Auslöser wie Klicks, Ziehen oder Tastendrücke in Informationen darüber, welche Diagrammelemente und Daten ausgewählt wurden. | Der Agent muss sich nicht um Pixelkoordinaten und Treffererkennung kümmern. |
| Update-Operationen | Übergeordnete Operationen wie set-style, set-annotation und set-viewport beschreiben Änderungen an der Darstellung. | Rendererspezifische Grafikmarkierungen müssen nicht direkt bearbeitet werden. |
| Flint-Canvas-Zustandsmaschine | Sie verfolgt Benutzerinteraktionen auf der Canvas und verwaltet den Rendering-Zustand. | Das Framework übernimmt die Laufzeitverwaltung und reduziert inkonsistente Zustände. |
| Kombinierbarkeit | Ereigniserzeugung und visuelle Updates lassen sich kombinieren und mit Tabellen, Texten und Komponenten verbinden. | So lassen sich Datengeschichten und verknüpfte Dashboards erstellen. |
Semantische Ereignisse: Flint-interactive interessiert nur, welche Daten ausgewählt wurden
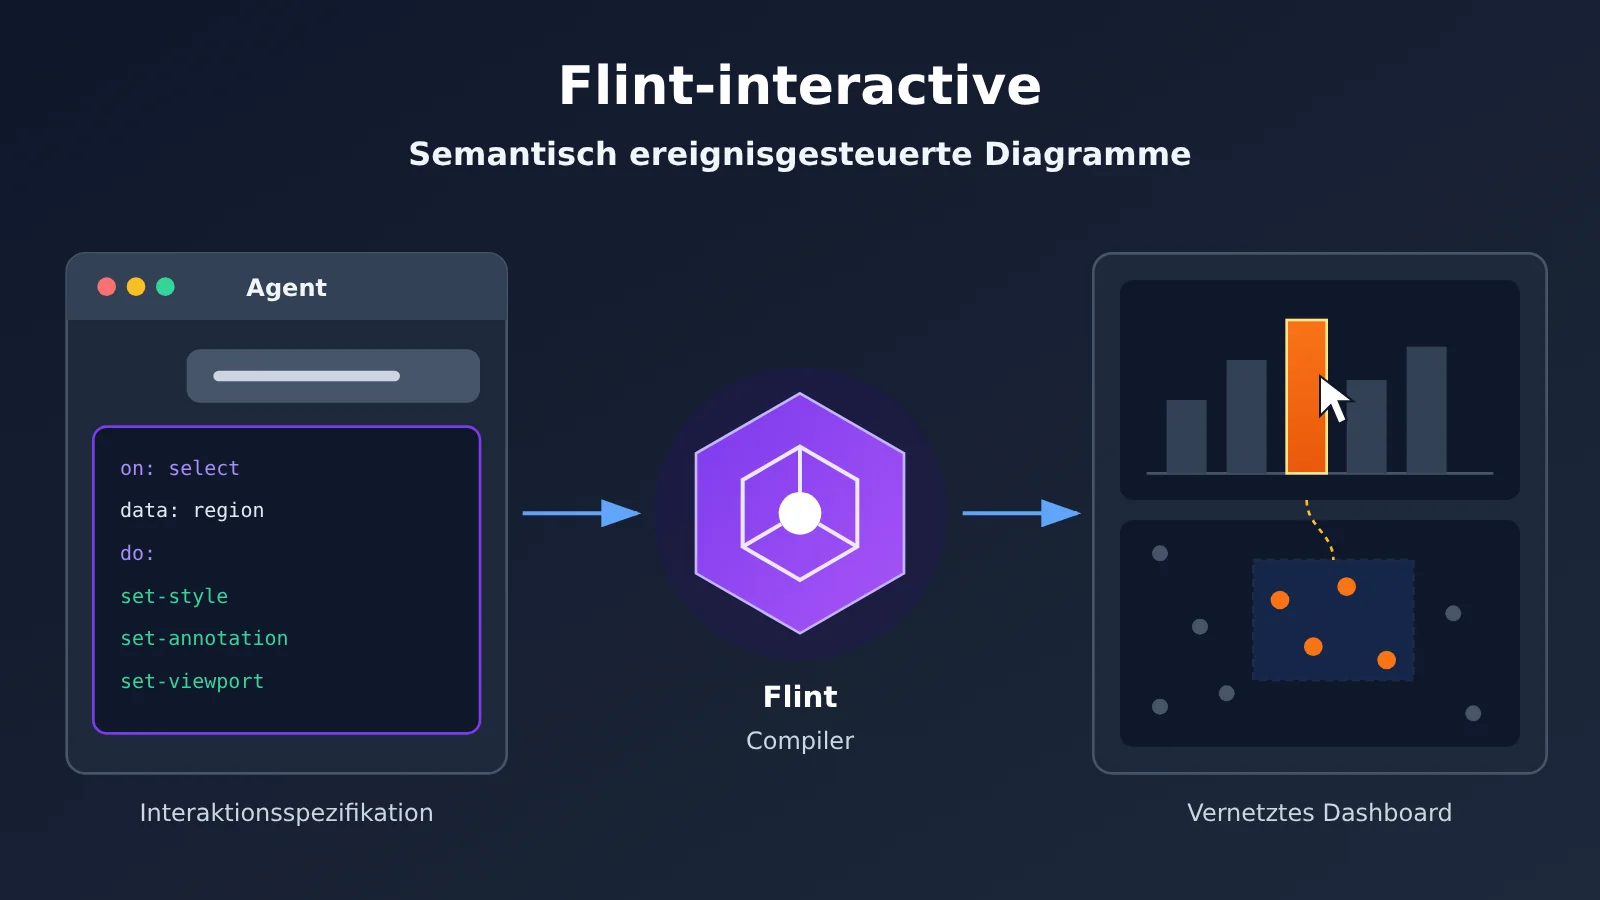
Semantische Ereignisse sind das zentrale Konzept von Flint-interactive. Bei einem herkömmlichen Ansatz muss der Agent verarbeiten, an welchen Koordinaten (x, y) die Maustaste gedrückt und wohin sie anschließend gezogen wurde. Danach muss er selbst berechnen, welche Datenpunkte der Bereich umfasst. In Flint übernimmt der Compiler diesen Schritt und erzeugt direkt ein bedeutungsvolles Ereignis wie „Der Benutzer hat diese Ländergruppen per Auswahlrahmen markiert“.
Das lässt sich mit dem Unterschied zwischen nativen DOM-Ereignissen und Geschäftsereignissen in der Frontend-Entwicklung vergleichen. Bei der Geschäftslogik interessieren nicht die Koordinaten von mousedown, sondern etwa, dass der Benutzer Bestellung A ausgewählt hat. Semantische Ereignisse bieten dieselbe Abstraktion für Visualisierungen – und der Compiler stellt sicher, dass sie korrekt funktioniert.
Update-Operationen: Flint-interactive ersetzt imperatives Neuzeichnen durch deklarative Ergebnisse
Nach einem semantischen Ereignis muss die Interaktionslogik nur eine Frage beantworten: Wie soll die Darstellung anschließend aussehen? Zu den im Blog aufgeführten Update-Operationen gehören set style zum Hervorheben von Daten, set annotation zum Beschriften eines Punkts und set viewport zum Verschieben oder Zoomen der Ansicht.
Das ähnelt dem Unterschied zwischen SQL und einer von Hand geschriebenen Schleife. Bei SQL beschreiben Sie das gewünschte Ergebnis, und die Datenbank entscheidet, wie sie es erreicht. Bei einer Flint-Interaktion beschreiben Sie, welche Daten hervorgehoben werden sollen. Der Compiler übersetzt das in konkrete Änderungen auf der Canvas, einschliesslich Treffererkennung und visueller Updates auf niedriger Ebene.
Zustandsmaschine: Flint Canvas verwaltet die Interaktionslaufzeit
Flint Canvas ist im Kern eine Zustandsmaschine. Sie verfolgt fortlaufend Benutzerinteraktionen auf der Canvas und verwaltet den Rendering-Zustand. Für den Agenten bedeutet das, dass er fehleranfällige Zwischenzustände wie „Was ist gerade ausgewählt?“ oder „Wurde die vorherige Hervorhebung bereits entfernt?“ nicht selbst verwalten muss.
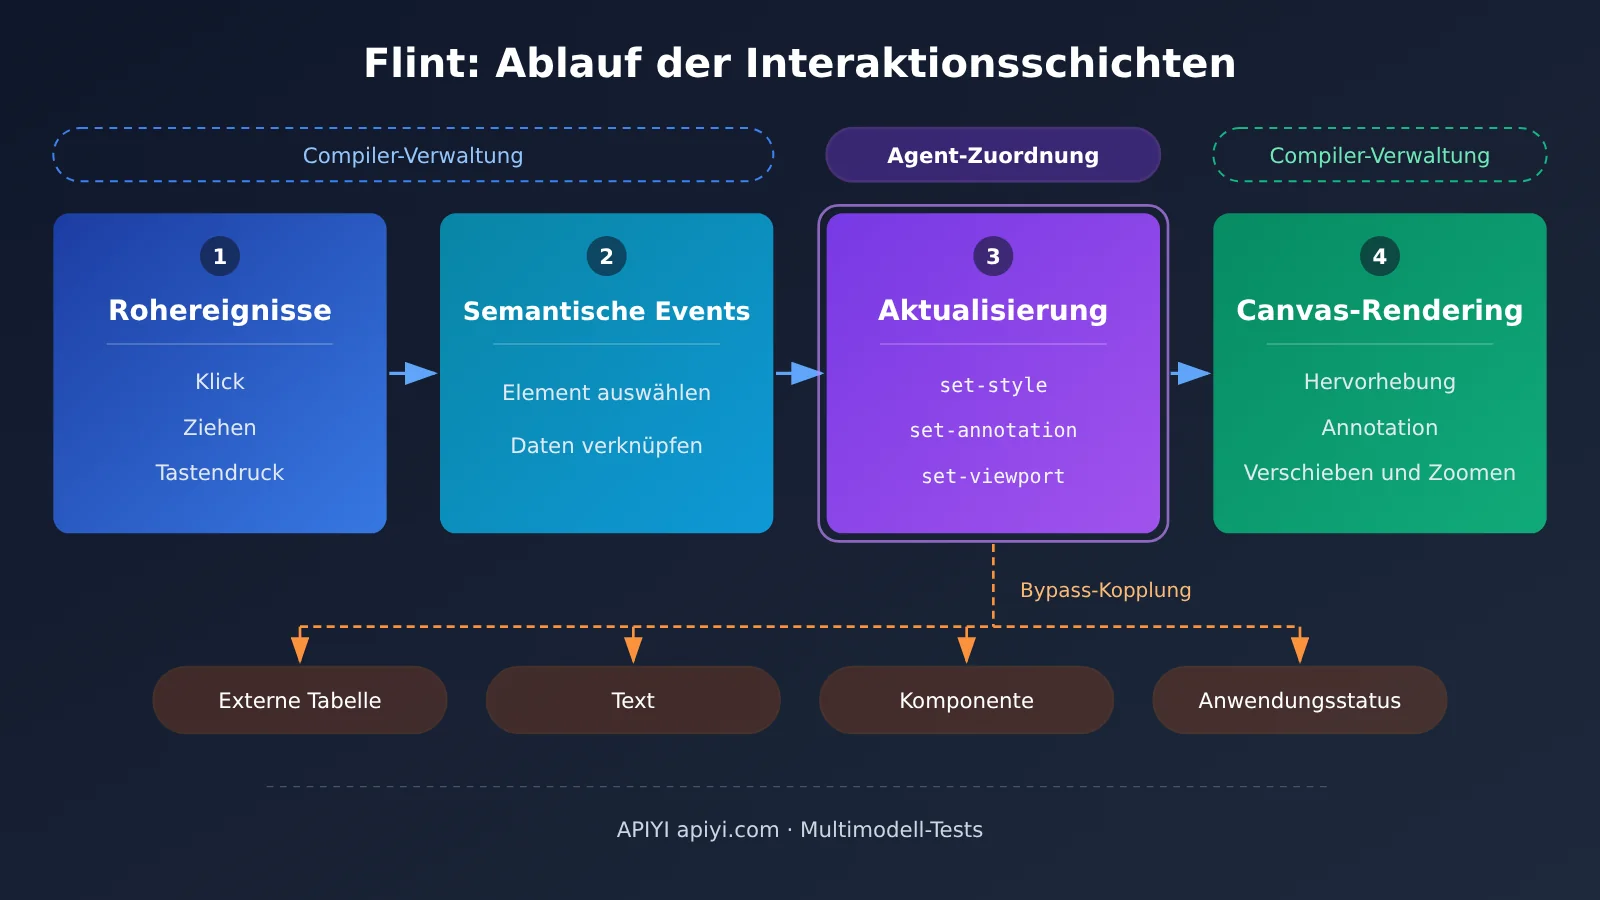
Die Grafik zeigt die zentrale Aufteilung aus dem Blog: Der Compiler verwaltet die visuelle Logik, während der Benutzer die Interaktionslogik auf semantischer Ebene beschreibt. Der Agent ist nur für die Zuordnung in der mittleren Ebene zuständig: Welches Ereignis führt zu welchem Update? Die beiden fehleranfälligen Enden übernimmt das Framework.
Das übertragbare Prinzip hinter Flint-interactive: High-Level-Ausgabespezifikationen für Agents
Über Flint-interactive hinaus ist vor allem die technische Entscheidung hinter diesem Beispiel übertragbar: Lassen Sie den Agent nicht die Ebene ausgeben, auf der er am ehesten Fehler macht. Rendering-Code auf niedriger Ebene hat komplexe Abhängigkeiten und lange Feedbackschleifen. Wenn ein Agent hier wiederholt durch Versuch und Irrtum vorgeht, wird das schnell teuer.
Anders betrachtet macht Flint aus einem offenen Programmierproblem eine Zuordnungsaufgabe mit einem begrenzten Vokabular. Der Ausgaberaum des Agents wird kleiner, seine Ausgaben erhalten eine einheitlichere Struktur und lassen sich leichter prüfen. Dieser Ansatz eignet sich auch für die Workflow-Orchestrierung, die Formularerstellung oder das Berichtslayout.
| Entscheidungskriterium | Geeignet für die Ausgabe durch den Agent | Geeignet für Compiler oder Laufzeitumgebung |
|---|---|---|
| Drückt die Aufgabe eine fachliche Absicht aus? | Ja, etwa „Nach Auswahl eines Landes die zugehörige Gruppe hervorheben“ | Nein, etwa bei der Umrechnung von Pixelkoordinaten |
| Hängt sie von vielen impliziten Zuständen ab? | Wenige Abhängigkeiten, durch eine einmalige Zuordnung beschreibbar | Viele Abhängigkeiten, kontinuierliche Nachverfolgung nötig |
| Lassen sich Fehler leicht eingrenzen? | Klar strukturierte Spezifikation, leicht zu prüfen | Verstreute Rendering-Details, schwer zu untersuchen |
| Ist das Ergebnis wiederverwendbar? | Kann als Voreinstellung hinterlegt werden, etwa linked-brush | Allgemeine Infrastruktur, einmalig implementiert |
Beim Entwurf des Ausgabeformats für den eigenen Agent lässt sich diese Tabelle Punkt für Punkt durchgehen. Eine Ebene eignet sich für den Agent, wenn sie eine Absicht ausdrückt, wenig von Zuständen abhängt und leicht zu prüfen ist. Andernfalls gehört sie in deterministischen Code oder einen Compiler.
Der Forschungsblog nennt allerdings keine quantitativen Daten dazu, ob dieser Ansatz den Token-Verbrauch senkt oder die Erfolgsquote erhöht. Testen Sie den Nutzen des Designprinzips daher am besten an Ihren eigenen Aufgaben, statt die Schlussfolgerung ungeprüft zu übernehmen.
Flint-interactive: Schnellstart mit 3 Integrationswegen
Der Blog stellt drei Wege zur Nutzung vor: für Personen, die Diagramme verwenden, für Anwendungsentwickler und für Interaktionsdesigner. Wir stellen sie in der Reihenfolge ihres Aufwands vor – vom einfachsten bis zum umfangreichsten.
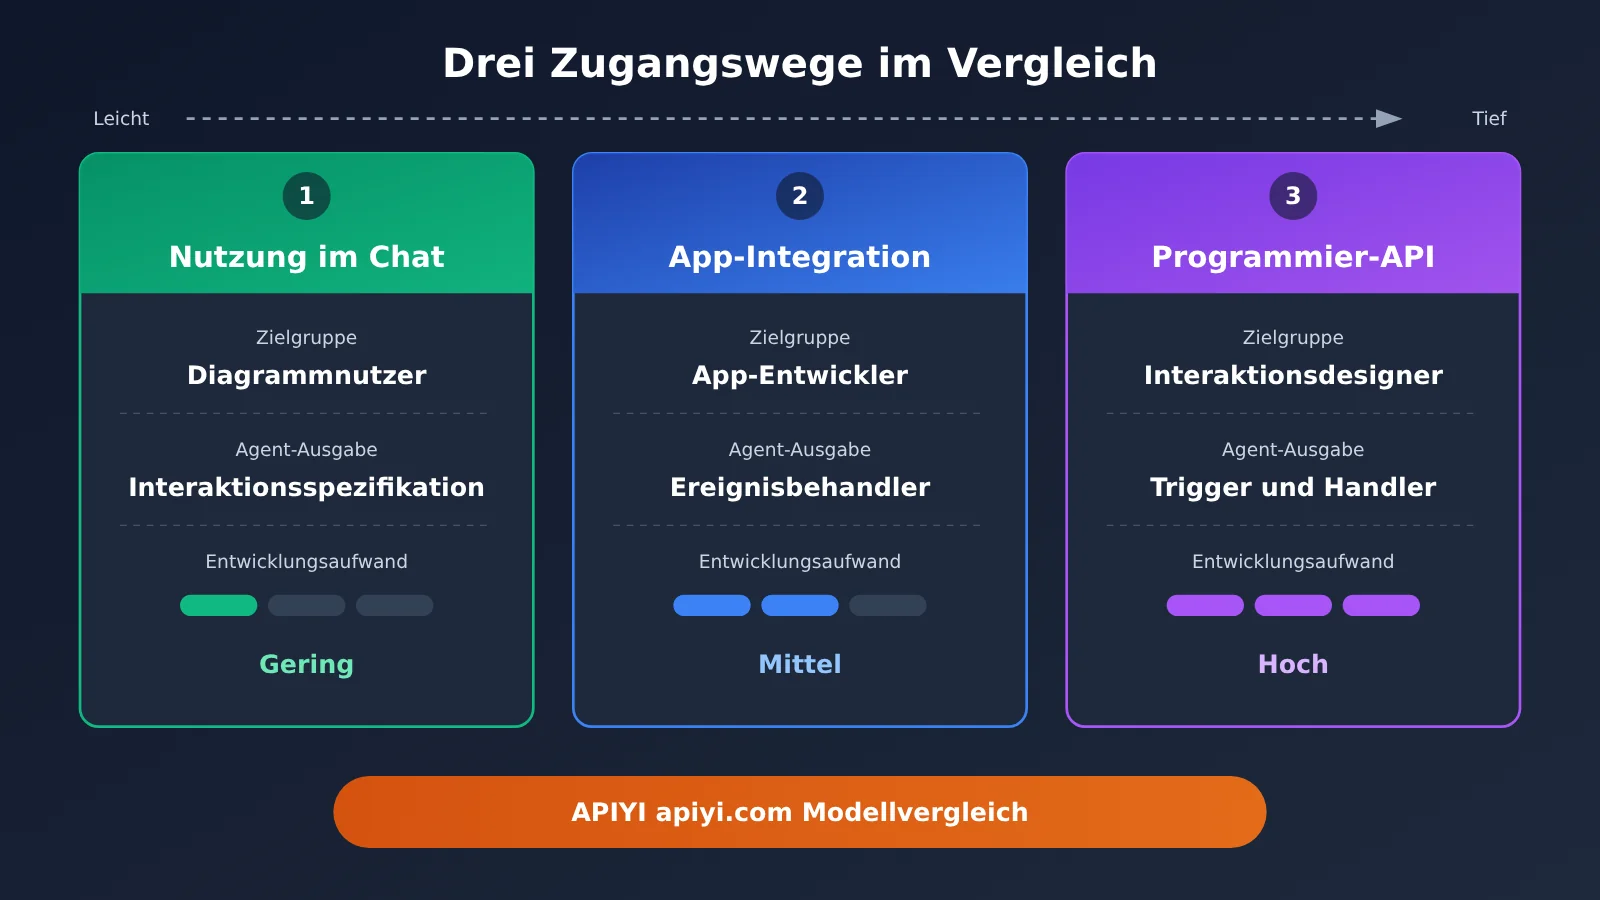
| Integrationsweg | Zielgruppe | Ausgabe des Agenten oder der Anwendung | Typisches Szenario |
|---|---|---|---|
| Nutzung im Chat (Flint-MCP + MCP Apps) | Personen, die Diagramme verwenden | Flint-Diagrammspezifikation + interaction_spec |
Daten im Chat erkunden und ausgewählte Inhalte in Rückfragen übernehmen |
| Integration in eine Anwendung (Flint Interactive Canvas) | Anwendungsentwickler | Handler für semantische Ereignisse + an Canvas gesendete Aktualisierungsoperationen | Dashboards, Datengeschichten, verknüpfte Diagramme und Tabellen |
| Individuelle Interaktionen (Programmier-API) | Interaktionsdesigner | Auslöser (trigger) + eigene handle-Funktion | Individuelle Interaktionen über die Voreinstellungen hinaus, etwa DimpVis |
Weg eins: Flint-interactive im Dialog nutzen (MCP)
Das ist der einfachste Einstieg. Über Flint-MCP und MCP Apps lässt sich Flint Interactive direkt in einer Chat- oder Canvas-Umgebung nutzen. Die Einrichtung erfolgt nach der offiziellen MCP-Anleitung. Danach sieht der Ablauf ungefähr so aus:
- Flint-MCP nach der offiziellen MCP-Anleitung in eine Chat- oder Canvas-Umgebung einbinden, die MCP Apps unterstützt;
- dem Agent mitteilen, welches Diagramm er erstellen und welche Interaktionen es unterstützen soll, zum Beispiel: „Bereichsauswahl mit gemeinsamer Hervorhebung von Ländern derselben Gruppe“;
- der Agent erzeugt zusätzlich zur Flint-Diagrammspezifikation eine
interaction_specund stellt im Dialog ein interaktives Diagramm dar; - Auswahlen im Diagramm können als Kontext an spätere Gesprächsrunden übergeben werden.
Der vierte Schritt ist besonders wertvoll: Markiert jemand einen Bereich mit auffälligen Daten und fragt direkt nach „Warum liegen diese Punkte so hoch?“, erhält der Agent ein strukturiertes Auswahlergebnis statt einer vagen Beschreibung.
Weg zwei: Flint-interactive Canvas in eine Anwendung integrieren
Für eigene Dashboards oder Datengeschichten bietet sich Flint Interactive Canvas an. Der Datenfluss funktioniert in beide Richtungen:
- Diagramm → Anwendung: Flint Canvas sendet semantische Ereignisse, die deine Anwendung über Ereignis-Handler empfängt. Damit kann sie Tabellen filtern, ein anderes Diagramm aktualisieren oder den Anwendungszustand ändern;
- Anwendung → Diagramm: Soll eine Komponente der Anwendung das Diagramm steuern, sendet sie eine Aktualisierungsaktion an Flint Canvas.
Das Beispiel im Blog zeigt, wie Diagramm und Tabelle in beide Richtungen zusammenspielen: Ein Klick auf eine Tabellenzeile hebt den zugehörigen Punkt im Diagramm hervor und umgekehrt. Für Reporting-Produkte ist das die Grundlage für eine verknüpfte Darstellung von Grafiken und Text. Der Blog erwähnt außerdem, dass du den interaction-author-Skill an deinen Coding-Agent weitergeben kannst, damit er dir hilft, Interaktionsvorlagen in deine Anwendung einzubauen.
Weg drei: Eigene Interaktionen mit Flint-interactive über die Programmier-API erstellen
Wenn vordefinierte Interaktionen wie die verknüpfte Bereichsauswahl mit linked-brush nicht ausreichen, lassen sich über die Programmier-API ein Trigger und eine eigene handle-Funktion definieren. So werden semantische Ereignisse auf eine Reihe individueller Diagrammaktualisierungen abgebildet.
Das Beispiel im Blog zeigt, wie ein Land nach einem Klick hervorgehoben und mit seinem Namen beschriftet wird. Der Handler kombiniert die beiden Aktionen set-style und set-annotation, ohne dass rendererspezifische grafische Elemente bearbeitet werden müssen. In einem komplexeren DimpVis-Beispiel können Nutzer einen Punkt entlang eines Zeitpfads ziehen und beobachten, wie sich Temperatur und Niederschlag in allen Städten verändern.
🚀 Tipp für den Einstieg: Prüfe zunächst über Weg eins im Dialog, ob sich deine Daten für Interaktionen eignen. Entscheide danach, ob sich der Aufwand für Weg zwei oder drei lohnt. Die Modelle für den Agenten kannst du über APIYI apiyi.com einheitlich anbinden und im selben Code zwischen mehreren gängigen Modellen wechseln. So siehst du, welches am zuverlässigsten eine gültige
interaction_specerzeugt.
Zuverlässigkeit der vom Agenten erzeugten Flint-interactive-Spezifikationen bewerten
Der Blog erklärt nicht, welche Modelle oder Agenten Flint-Spezifikationen besonders gut erzeugen. Deshalb empfiehlt sich vor dem produktiven Einsatz ein einfacher Bewertungsprozess. Achte dabei auf folgende Kennzahlen:
| Bewertungskennzahl | Messmethode | Bedeutung |
|---|---|---|
| Erfolgsquote beim ersten Versuch | Anteil der Ergebnisse, die sofort korrekt gerendert werden und interaktiv nutzbar sind | Zeigt direkt die Kosten der Erzeugung |
| Durchschnittliche Zahl der Korrekturrunden | Anzahl der Dialogrunden von der ersten Generierung bis zum nutzbaren Ergebnis | Entspricht dem Token- und Zeitaufwand |
| Übereinstimmung mit der Interaktionsabsicht | Manuell prüfen, ob das Verhalten den Anforderungen entspricht | Eine gültige Spezifikation erfüllt nicht automatisch die gewünschte Absicht |
| Regressionsstabilität | Prüfen, ob nach einer Änderung an einer Interaktion die übrigen weiterhin funktionieren | Bezieht sich auf das im Blog erwähnte Zuverlässigkeitsproblem |
Stelle am besten einen festen Satz von Interaktionsanforderungen als Testset zusammen. Vergleiche damit unter Verwendung derselben Eingabeaufforderungen zwei Ansätze: „Rendering-Code direkt schreiben“ und „Flint-Spezifikation ausgeben“. Über eine Schnittstelle wie APIYI, die mehrere Modelle bündelt, kannst du verschiedene Modelle in einem Skript vergleichen und sparst dir die separate Anbindung der jeweiligen SDKs.
Häufig gestellte Fragen (FAQ)
Q1: Was ist Flint-interactive?
Flint-interactive ist eine interaktive Sprache zur Datenvisualisierung, die Microsoft Research auf Basis von Flint entwickelt hat. Ein Compiler übersetzt Nutzerinteraktionen in semantische Ereignisse und ändert Diagramme mithilfe abstrakter Aktualisierungsoperationen. So können Nutzer und Agenten Interaktionen wie Klicken, Filtern, Zoomen, Hervorheben und das Verknüpfen mehrerer Diagramme durch kompakte Spezifikationen beschreiben.
Q2: Wie unterscheidet sich Flint-interactive davon, einen Agenten den Interaktionscode direkt schreiben zu lassen?
Beim direkten Schreiben von Code muss der Agent Ereignisse, Treffertests und das Neuzeichnen gleichzeitig behandeln. Das bietet viele Möglichkeiten, erfordert aber oft mehrere aufwendige Debugging-Runden und ist fehleranfälliger. Flint-interactive überlässt die visuelle Logik dem Compiler. Der Agent beschreibt nur, welches semantische Ereignis welche Aktualisierung auslöst. Dadurch fällt seine Ausgabe kürzer aus und ihre Struktur lässt sich leichter überprüfen.
Q3: Wann wurde Flint-interactive veröffentlicht?
Microsoft Research veröffentlichte die Forschungsarbeit am 22. Oktober 2026 in seinem Blog. Es handelt sich um ein aktuelles Forschungsergebnis. Die Quellen enthalten keine eindeutigen Angaben zur Open-Source-Lizenz, zum Reifegrad oder zur Eignung für den Produktiveinsatz. Vor dem Einsatz in einem Projekt empfiehlt sich daher ein Blick auf die neuesten Informationen im offiziellen Repository.
Q4: Für welche Anwendungsfälle eignet sich Flint-interactive besonders?
– **Dialogbasierte Datenanalyse**: Datenpunkte im Chat per Rahmen auswählen und das Ergebnis in eine Folgefrage übernehmen;
– **Berichte und Dashboards**: mehrere Diagramme verknüpfen und per Klick auf ein Diagramm eine Detailtabelle filtern;
– **Datengeschichten**: Diagramme und Textabschnitte wechselseitig hervorheben – ähnlich wie beim interaktiven Erzählen im Datenjournalismus.
Q5: Wie bereitet man Modellaufrufe für einen Agenten vor, der Flint-interactive nutzt?
Flint klärt die Frage, *was* ausgegeben werden soll. Das Modell selbst muss separat angebunden werden. Eine einfache Möglichkeit ist, über APIYI auf apiyi.com mehrere führende Modelle anzubinden. Über eine einheitliche Schnittstelle lässt sich dieselbe Reihe von Interaktionsanforderungen mit verschiedenen Modellen testen. Anschliessend kann man vergleichen, wie häufig die erzeugten Spezifikationen auf Anhieb funktionieren und wie viele Korrekturrunden nötig sind, bevor man ein Modell für die Produktionsumgebung auswählt.
Q6: Wie können Produktverantwortliche entscheiden, ob ihr Team Flint-interactive einführen sollte?
Zunächst helfen zwei Fragen: Müssen Ihre Nutzer Daten tatsächlich interaktiv in Diagrammen erkunden? Und ist der Nachbesserungsaufwand bei den derzeit vom Agenten erzeugten interaktiven Diagrammen hoch? Falls beides zutrifft, lohnt sich ein Test im kleinen Rahmen mit Ansatz 1. In der Testphase können Sie über die APIYI-Plattform schnell zwischen Modellen wechseln und so die Kosten für die Validierung niedrig halten.
Q7: Welche bekannten Einschränkungen oder offenen Fragen gibt es bei Flint-interactive?
– **Fehlende quantitative Daten**: Der Blog nennt keine konkreten Zahlen zur Token-Einsparung oder zur Verbesserung der Erfolgsquote;
– **Unbekannte Modelleignung**: Es wird nicht angegeben, welche Modelle Flint-Spezifikationen am besten erzeugen;
– **Begrenztes Interaktionsvokabular**: Interaktionen ausserhalb der vordefinierten Optionen müssen über die Programmier-API selbst implementiert werden. Das Team ermutigt dazu, auf GitHub neue Vorlagen einzureichen, um das Vokabular zu erweitern.
Flint-interactive: Das Wichtigste in Kürze
- Ursache der Kosten: Wenn ein Agent Interaktionscode direkt schreibt, sind mehrere Debugging-Runden nötig. Das verbraucht viele Token und kann bei der Fehlerbehebung neue Bugs verursachen;
- Semantische Ereignisse: Der Compiler übersetzt grundlegende Aktionen wie Klicken und Ziehen in Aussagen wie „Welche Daten wurden ausgewählt?“;
- Aktualisierungsoperationen: Mit set-style, set-annotation und set-viewport werden Änderungen an der Darstellung deklariert, ohne das zugrunde liegende Rendering anzufassen;
- Aufgabentrennung: Der Compiler übernimmt die visuelle Logik, die Interaktionslogik wird auf semantischer Ebene beschrieben und eine Canvas-Zustandsmaschine verwaltet die Laufzeit;
- Drei Wege: MCP für die Nutzung im Dialog, Canvas für Anwendungen und eine Programmier-API für individuelle Interaktionen;
- Übertragbares Prinzip: Für Agenten eine Ausgabe-Spezifikation auf hoher Abstraktionsebene entwerfen und die fehleranfälligste Ebene an ein deterministisches System übertragen;
- Praxisprüfung: Über die einheitliche Schnittstelle von APIYI mehrere Modelle vergleichen und die Stabilität der Spezifikationserzeugung testen.
Fazit
Der Ansatz semantischer Ereignisse von Flint-interactive lässt sich auf drei Punkte bringen:
- Das Problem ist richtig erkannt: Interaktive Diagramme sind nicht deshalb schwer zu erzeugen, weil die Modelle nicht leistungsfähig genug sind. Es fehlt vielmehr eine Interaktionssprache, die sowohl ausdrucksstark als auch ausreichend abstrakt ist;
- Die Aufgaben sind klar verteilt: Der Compiler übernimmt die Auswertung von Ereignissen und die Aktualisierung der Darstellung. Der Agent beschreibt nur die Zuordnung „Ereignis → Aktualisierung“;
- Die Integration ist abgestuft: Vom Ausprobieren im Dialog über die Einbindung in Anwendungen bis hin zu individuellen Interaktionen lässt sich der Aufwand schrittweise an den Bedarf anpassen.
Teams, die Agenten für Reporting oder Datenanalyse entwickeln, können sich auch ohne direkten Einsatz von Flint an dessen Designprinzipien orientieren und das Ausgabeformat ihrer eigenen Agenten hinterfragen.
Für die praktische Validierung empfiehlt sich der einheitliche Zugang zu mehreren gängigen Modellen über APIYI auf apiyi.com. Vergleicht anhand derselben Interaktionsanforderungen die erzeugten Ergebnisse, um schnell eine passende Kombination aus Modell und Spezifikation für euren Anwendungsfall zu finden.
📚 Weiterführende Ressourcen
- Microsoft Research Blog – Flint-interactive: Offizieller Forschungsblog zu Flint-interactive
- Link:
microsoft.com/en-us/research/blog/flint-interactive-a-language-for-creating-interactive-data-visualizations - Beschreibung: Stellt semantische Ereignisse, Aktualisierungsoperationen, den Canvas-Zustandsautomaten sowie die drei Nutzungsmöglichkeiten MCP, Canvas und Programmier-API vor. Der Blog enthält außerdem eine MCP-Einrichtungsanleitung, eine Sammlung interaktiver Beispiele und einen Einstieg zur Programmier-API.
Autor: APIYI Technikteam
Technischer Austausch: Besuchen Sie APIYI unter apiyi.com und tauschen Sie sich mit uns über praktische Erfahrungen mit Agents und der Anbindung mehrerer Modelle aus. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.