Anmerkung des Autors: Eine Stanford-Studie zeigt, dass 44 % der verbreiteten Aussagen über LLMs bereits veraltet sind. Bei Aussagen mit geschätztem Ablaufzeitpunkt beträgt die durchschnittliche Gültigkeitsdauer nur 15,7 Monate. Dieser Artikel übersetzt die Ergebnisse in eine Checkliste, mit der Entwicklungsteams ihre Modellauswahl überprüfen können.
„Ein bestimmtes Modell kann nicht zählen, wie viele r in strawberry vorkommen“, „Informationen in der Mitte langer Kontexte gehen verloren“ oder „Modelle erfinden gern Literaturangaben“ – solche Aussagen hast du vielleicht schon oft in Fachartikeln, Technikgruppen und bei der Modellauswahl gehört. Die Stanford-Forscher Owen Queen und James Zou haben 50 häufig zitierte Aussagen über LLMs mit 20 Modellen erneut überprüft. Ihr Ergebnis: 44 % waren bereits veraltet. Aussagen mit geschätztem Ablaufzeitpunkt blieben im Schnitt nur 15,7 Monate gültig.
Das ist nicht einfach ein weiterer allgemeiner Beitrag darüber, dass Modelle immer leistungsfähiger werden. Die Studie liefert konkrete Daten: Welche Arten von Aussagen veralten am schnellsten, welche bleiben länger gültig und wie groß sind die Unterschiede zwischen Modellen derselben Generation? Dieser Artikel überträgt die Empfehlungen der Forscher an die Wissenschaft in einen Ablauf, den Entwicklungsteams bei der Modellauswahl direkt anwenden können.
Das nimmst du mit: Du erfährst, welche Aussagen der Art „Modell X ist nicht gut in Y“ besonders unzuverlässig sind. Außerdem lernst du eine Vorgehensweise für die Modellauswahl kennen: Modellname, Version und Datum dokumentieren, die Eingabeaufforderung aufbewahren und den Test mit dem Zielmodell wiederholen.
Die wichtigsten Ergebnisse der Studie zur Veralterung von LLM-Erkenntnissen
Die folgende Tabelle zeigt die zentralen Zahlen der Studie. Die untersuchten Modelle stammen von acht verschiedenen Entwicklern und wurden zwischen Juli 2024 und September 2026 veröffentlicht. Der entsprechende Bericht erschien am 3. November 2026.
| Aspekt | Studiendaten | Bedeutung für die Modellauswahl |
|---|---|---|
| Anteil veralteter Erkenntnisse | Von 50 Erkenntnissen sind 44 % veraltet, bei 34 % hat sich der Effekt deutlich abgeschwächt | Die meisten im Netz verbreiteten Aussagen über Modellschwächen lassen sich nicht mehr ungeprüft übernehmen |
| Anteil weiterhin gültiger Erkenntnisse | Nur 16 % gelten unverändert, bei 6 % hat sich der Effekt sogar verstärkt | Einige hartnäckige Tendenzen verdienen langfristige Aufmerksamkeit |
| Durchschnittliche Lebensdauer | Bei 22 Erkenntnissen, deren Veralterungszeitpunkt sich schätzen ließ, betrug sie durchschnittlich 15,7 Monate | Bewertungsergebnisse, die über ein Jahr alt sind, sollten grundsätzlich mit Vorsicht betrachtet werden |
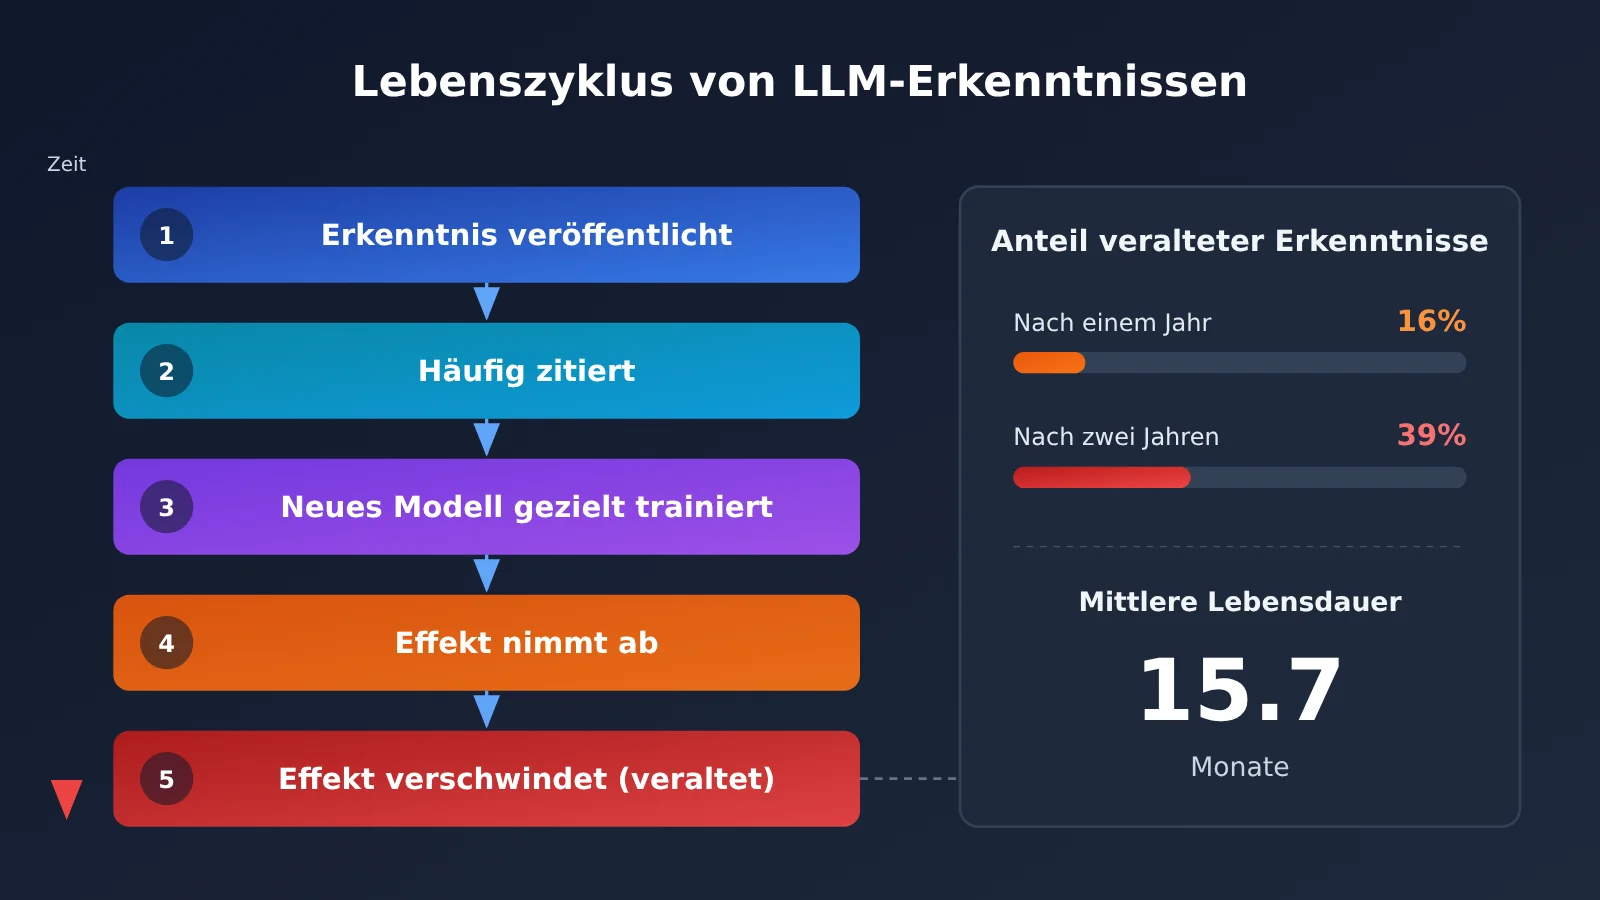
| Veränderung im Zeitverlauf | Nach einem Jahr sind 16 % veraltet, nach zwei Jahren 39 % | Je älter eine Erkenntnis ist, desto wichtiger ist eine erneute Überprüfung |
| Unterschiede innerhalb derselben Modellgeneration | Bei Modellen, die zwischen Juli und September 2026 erschienen, lag die Zahl veralteter Erkenntnisse zwischen 11 und 30 | Aus dem Veröffentlichungsdatum lässt sich nicht auf die Fähigkeiten schließen |
Zwei zentrale Erkenntnisse zur Veralterung von LLM-Erkenntnissen
Der erste wichtige Punkt ist die Bedeutung von „veraltet“: In der Studie gilt eine Erkenntnis als veraltet, wenn der ihr zugrunde liegende Effekt bei neuen Modellen weitgehend verschwunden ist – nicht schon dann, wenn er sich lediglich abgeschwächt hat. Bei weiteren 34 % der Erkenntnisse hat sich der Effekt „deutlich abgeschwächt“. Das Problem besteht also noch, ist aber längst nicht mehr so gravierend wie in der ursprünglichen Veröffentlichung beschrieben. Zusammengenommen lassen sich damit fast acht von zehn verbreiteten Erkenntnissen nicht mehr unverändert auf heutige Modelle anwenden.
Der zweite wichtige Punkt: Die „Lebensdauer“ einer Erkenntnis hängt stark von ihrer Art ab. Aussagen über Fähigkeiten, die einem Modell fehlen, veralten am schnellsten. Aussagen darüber, zu welchem Verhalten ein Modell neigt, sind dagegen beständiger. Die Erklärung der Forschenden: Bei Fehlern, die Fähigkeiten betreffen, gibt es meist eine „richtige Antwort“ und damit ein klares Trainingsziel, auf das Entwickler hinarbeiten können. Für Vorlieben und Verhaltenstendenzen gibt es dagegen keine Standardantwort – deshalb lassen sie sich schwerer „beheben“.
Welche LLM-Erkenntnisse am schnellsten veralten
Um Wiederholungstests zu priorisieren, muss man zunächst die Art der Erkenntnis einordnen. Die folgende Tabelle teilt typische Erkenntnisse anhand des Forschungsberichts in „leicht veraltet“ und „vergleichsweise beständig“ ein.
| Art der Erkenntnis | Typische Beispiele | Stand laut Studie | Priorität für Wiederholungstests |
|---|---|---|---|
| Schwächen beim logischen Denken und bei Fähigkeiten | Buchstaben in „strawberry“ zählen, Arithmetik in ungewohnten Zahlensystemen, Verlust von Informationen aus der Mitte eines langen Kontexts, Aufgabe einer richtigen Antwort nach Widerspruch durch den Nutzer | 5 von 9 Erkenntnissen zum logischen Denken sind veraltet, keine blieb bestehen oder verstärkte sich | Höchste: Vor dem Zitieren unbedingt erneut testen |
| Faktentreue und Halluzinationen | Erfundenen wissenschaftlichen Quellen | Bei einigen Modellen nahezu auf 0 gesunken, bei einzelnen weiterhin sehr hoch | Hoch: Unterschiede sind enorm, jedes Modell einzeln testen |
| Kombiniertes Schlussfolgern | Fragen mit zwei Schlussfolgerungsschritten, „Umkehrfluch“, widersprüchliche Antworten auf zusammengehörige Fragen zu zeitlichen Abläufen | Abgeschwächt, aber weiterhin nachweisbar | Mittelhoch: Das Problem besteht fort, sein Ausmaß hat sich stark verändert |
| Präferenzen bei der Bewertung | Bevorzugung eigener Antworten, ähnliche Bewertungen für angenommene und abgelehnte Fachartikel, Einfluss der Formulierung medizinischer Zusammenfassungen | Bestehen geblieben oder verstärkt | Mittel: Langfristiges Risiko, aber regelmässige Überprüfung nötig |
| Schmeichelei und Zustimmung zum Nutzer | Sich der Meinung des Nutzers anschliessen | Relativ häufig unter den Erkenntnissen, die bestehen blieben oder sich verstärkten | Mittel: Priorität bei Anwendungen im Kundenservice und in der Beratung |
| Tendenzen in der Ausgabeverteilung | Politische Tendenz nach links, stark ähnliche Antworten auf offene Fragen, ungleichmässige Verteilung erzeugter Zufallszahlen | Bestehen geblieben oder verstärkt | Mittel: Bei der Inhaltserstellung und beim Sampling beachten |
Zu den Erkenntnissen über logisches Denken gibt es eine Unstimmigkeit: Im Text des Berichts heisst es, „5 von 9 sind veraltet, und keine blieb bestehen oder verstärkte sich“. Die Bildunterschrift besagt dagegen, „alle 9 sind zurückgegangen“. Zusammen lässt sich das so verstehen: 5 sind veraltet, die übrigen haben sich ebenfalls abgeschwächt, und keine blieb unverändert. Da uns die vollständige Liste der 50 Erkenntnisse und die Methoden der Wiederholungstests aus der Originalstudie nicht vorlagen, ist für die genaue Einordnung die Originalstudie massgeblich.
Warum Erkenntnisse über LLM-Präferenzen länger Bestand haben
Von den 11 bestätigten oder verstärkten Schlussfolgerungen betreffen 3 den Einsatz von „LLMs als Gutachter“ und 3 das übermässig zustimmende Verhalten gegenüber Nutzern. Die übrigen befassen sich mit politischer Ausrichtung, ähnlichen Antworten auf offene Fragen und einer ungleichmässigen Verteilung von Zufallszahlen. Diese Probleme haben eines gemeinsam: Es lässt sich schwer festlegen, welche Ausgabe „richtig“ ist. Entsprechend schwierig ist es, sie durch gezieltes Training zu beseitigen.
Für Entwicklerteams ergibt sich daraus eine eher überraschende Risikoreihenfolge. Das oft zitierte Problem, dass „Modelle keine Buchstaben zählen können“, ist häufig längst keines mehr. Wirklich aufmerksam sollte man dagegen bei weniger auffälligen systematischen Tendenzen sein. Wer LLMs für automatische Bewertungen, Benotungen oder Empfehlungen einsetzt, sollte solche Präferenzen regelmässig in Regressionstests prüfen.
Gemischte Ergebnisse bei sozialen Vorurteilen von LLMs
Die Forschenden betonen, dass sich Erkenntnisse zu sozialen Vorurteilen unterschiedlich entwickeln. Eine politische Tendenz nach links besteht weiterhin, während Geschlechterstereotype und implizite Assoziationsverzerrungen abgenommen haben. Bei Vorurteilen gegenüber Personen, die afroamerikanisches Englisch sprechen, zeigt sich in den Trenddaten sogar eine Umkehr der Richtung. Das verdeutlicht erneut: Pauschale Aussagen wie „Modelle weisen generell ein bestimmtes Vorurteil auf“ sind nur mit Bezug auf ein konkretes Modell und einen konkreten Zeitpunkt aussagekräftig.
Warum sich die Leistung von LLMs nicht aus Hersteller oder Veröffentlichungsdatum ableiten lässt
Bei der Modellauswahl folgen viele Teams einer einfachen Intuition: Neue Modelle sind besser als alte, Modelle desselben Herstellers verhalten sich ähnlich und große Modelle sind zuverlässiger als kleine. Die Forschungsdaten widersprechen diesen Annahmen jedoch deutlich.
Ein besonders anschauliches Beispiel ist der Test auf erfundene Literaturangaben. In der ursprünglichen Studie von Walters und Wilder aus dem Jahr 2023 erfand GPT-3.5 55 % der Literaturangaben. Forschende der Stanford University testeten aktuelle Modelle mit derselben Eingabeaufforderung: Bei GPT-6.1 Sol lag der Anteil bei 0 %, bei Claude Sonnet 5.5 bei 1 %. Qwen3.7-Flash, ebenfalls 2026 veröffentlicht, erfand dagegen noch 69 % der Literaturangaben – mehr als GPT-3.5 drei Jahre zuvor.
Auch zwischen Modellen, die im selben Zeitraum veröffentlicht wurden, sind die Unterschiede erstaunlich. Bei den zwischen Juli und September 2026 veröffentlichten Modellen lag die Zahl der „widerlegten“ Schlussfolgerungen zwischen 11 bei DeepSeek V4 Pro und 30 bei GPT-6.1 Sol. Die Studie hält ausdrücklich fest, dass weder das Veröffentlichungsdatum noch der Hersteller oder die Modellgröße dieses Muster zuverlässig vorhersagen können.
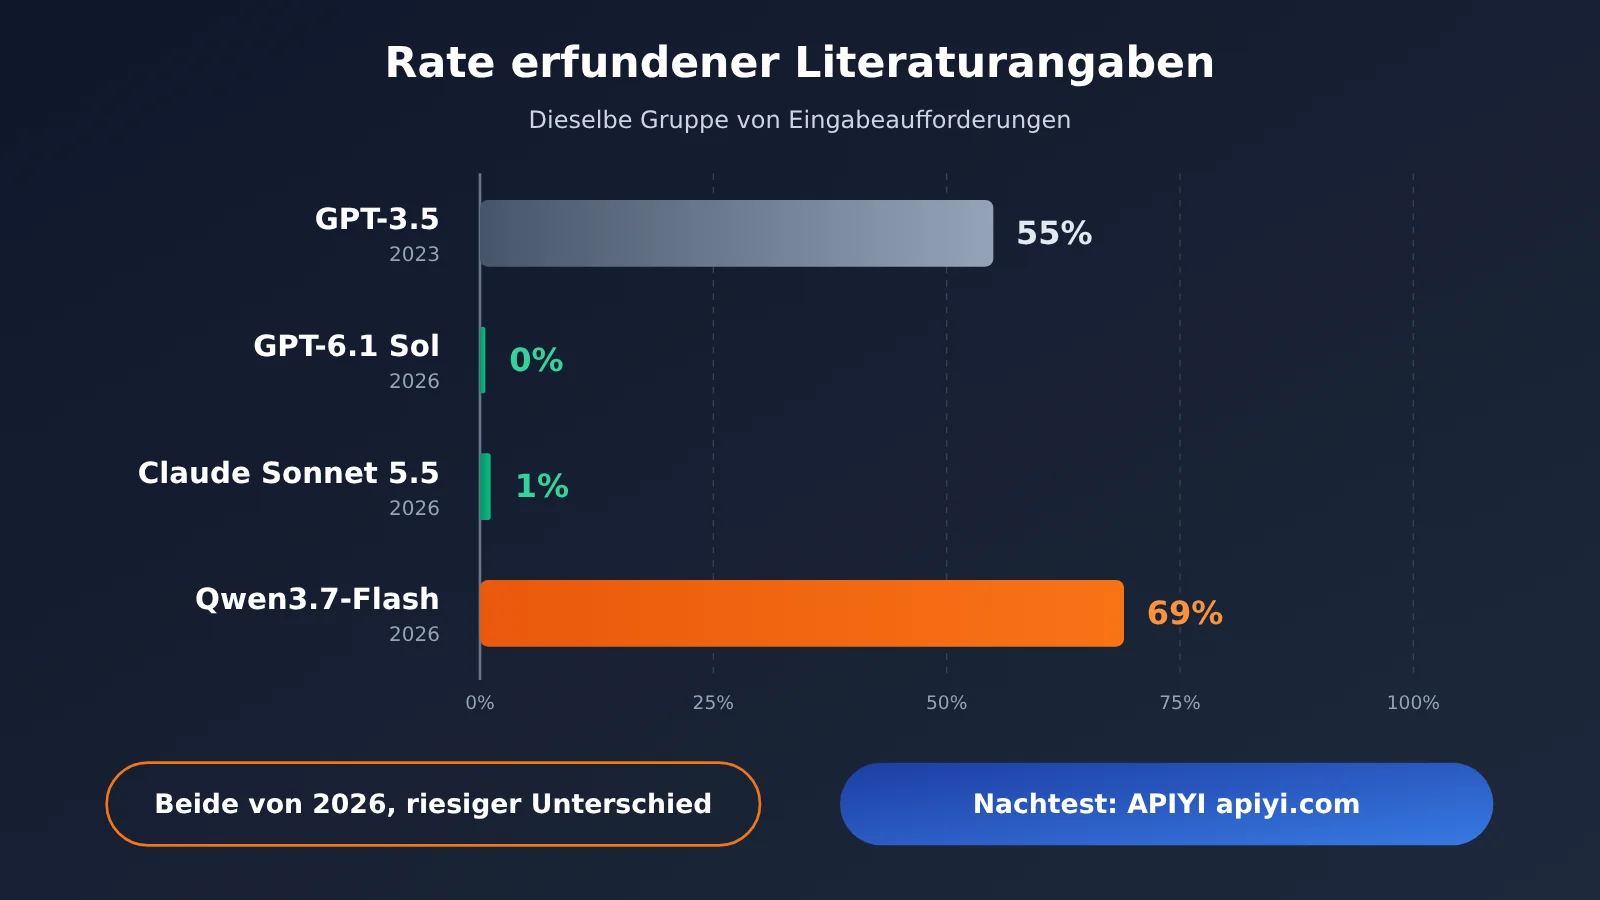
Die Kernaussage der Grafik: Modelle aus demselben Zeitraum können bei ein und demselben Test an entgegengesetzten Enden der Skala liegen. Wenn ihr solche Vergleiche im Team nachvollziehen möchtet, könnt ihr über eine Plattform mit einheitlicher Schnittstelle wie APIYI apiyi.com dieselbe Eingabeaufforderung mit mehreren Kandidatenmodellen testen. Welche Modelle verfügbar sind, steht in der offiziellen Modellliste der Plattform.
Die Forschenden warnen außerdem davor, Verbesserungen mit einer vollständigen Lösung des Problems gleichzusetzen. Bei Zwei-Schritt-Fragen, die zwei bekannte Fakten kombinieren, beantwortete Claude Sonnet 5.5 noch etwa 10 % der kombinierten Fragen falsch – obwohl es die beiden Teilfragen jeweils korrekt beantworten konnte. Für ChatGPT berichtete die ursprüngliche Studie einen Wert von 43 %. Der Anteil ist also deutlich gesunken. Wenn eure Anwendung jedoch auf der Verknüpfung mehrerer Fakten beruht, können auch diese 10 % noch zu Problemen im Produktivbetrieb führen.
LLM-Auswahl erneut prüfen: Checkliste in 5 Schritten
Die Forschenden empfehlen der Wissenschaft, empirische Erkenntnisse über LLMs als „Beobachtungen zu einem bestimmten Modell zu einem bestimmten Zeitpunkt“ zu betrachten – nicht als allgemeingültige Wahrheiten. Studien sollten Modell, Version und Datum dokumentieren sowie Eingabeaufforderungen und Analysecode offenlegen. So lassen sich die Ergebnisse später mit anderen Modellen erneut prüfen. Diese Empfehlungen können Entwicklungsteams fast unverändert in ihren Auswahlprozess übernehmen.
Schritt 1: Jede LLM-Erkenntnis mit Metadaten versehen
Ob eine Erkenntnis aus einer Studie, einem Blog, der Erfahrung von Kollegen oder eigenen Tests stammt: Ergänzen Sie zunächst die Felder in der folgenden Tabelle. Fehlen wichtige Angaben, taugt die Erkenntnis nur als „noch zu prüfender Hinweis“ – nicht als Entscheidungsgrundlage.
| Metadatenfeld | Was dokumentiert wird | Warum die Angabe nötig ist |
|---|---|---|
| Modellname | Vollständiger Modellname statt „Modell eines bestimmten Anbieters“ | Modelle desselben Anbieters können sich stark unterscheiden |
| Konkrete Version | Versionsnummer oder Snapshot-Kennung | Nach einer Aktualisierung kann sich die Leistung eines gleichnamigen Modells ändern |
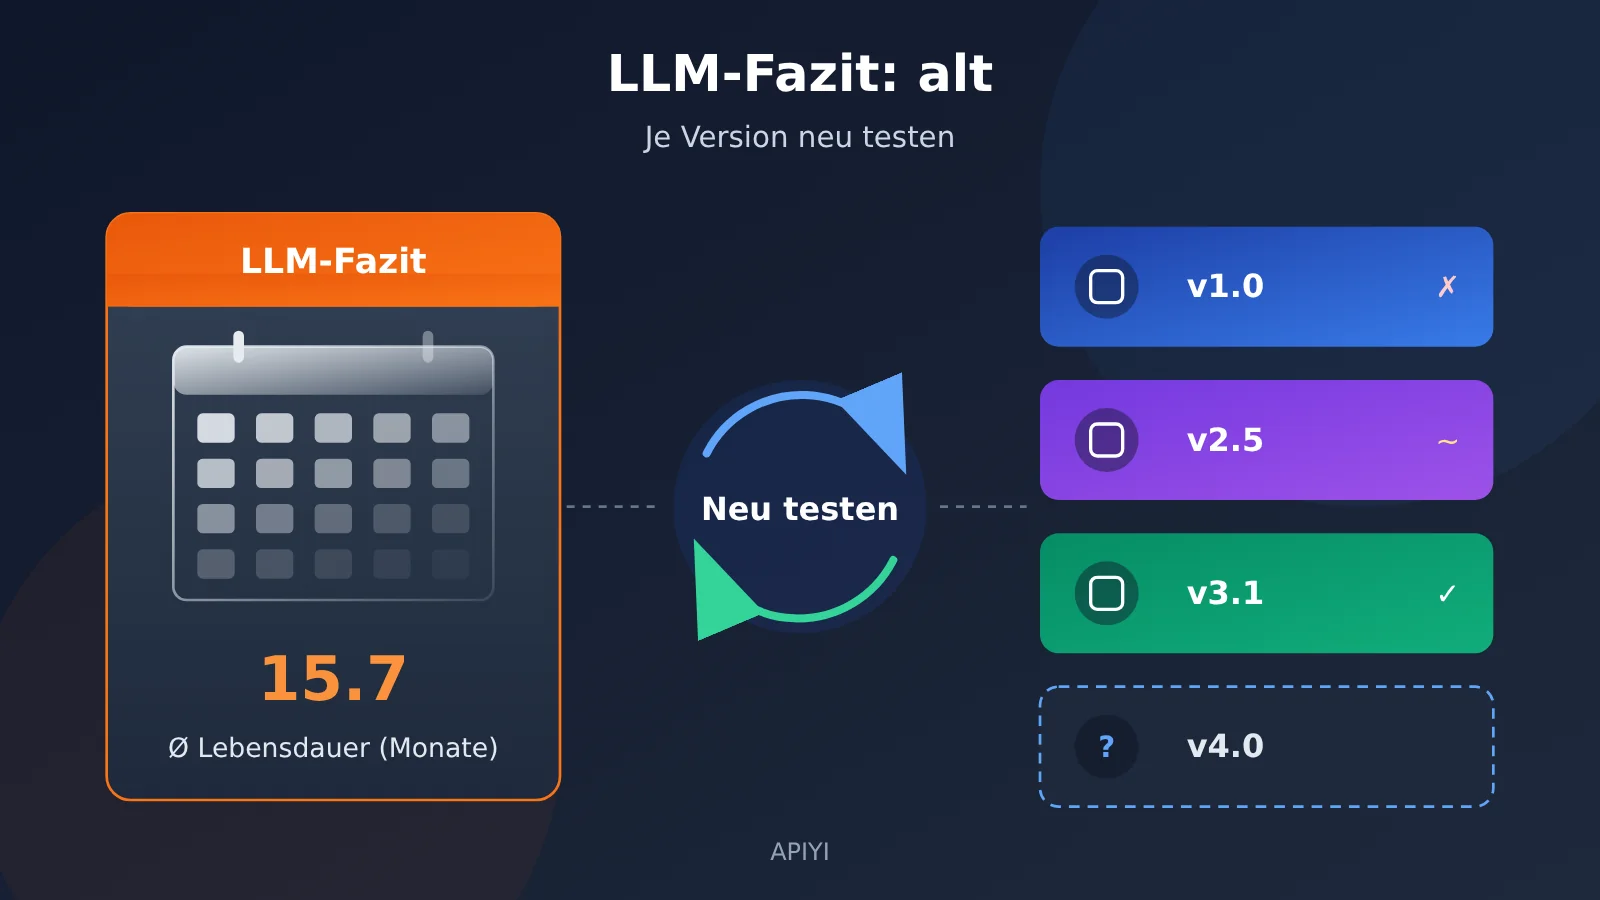
| Testdatum | Auf den Tag genau | Damit lässt sich das „Alter“ der Erkenntnis einschätzen – als Orientierung dient die durchschnittliche Lebensdauer von 15,7 Monaten |
| Vollständige Eingabeaufforderung | System-Eingabeaufforderung, Nutzereingabe und Beispiele | Mit einer anderen Eingabeaufforderung lässt sich das Ergebnis nicht reproduzieren |
| Aufrufparameter | Temperatur, maximale Ausgabelänge usw. | Sampling-Parameter können Erkenntnisse zur Stabilität beeinflussen |
| Bewertungskriterien | Was als bestanden und was als fehlgeschlagen gilt | Sonst sind die Ergebnisse verschiedener Personen nicht vergleichbar |
| Stichprobengröße | Anzahl der getesteten Fälle | Der Screenshot einer einzelnen Unterhaltung lässt keine Rückschlüsse auf Häufigkeiten zu |
Schritt 2: Priorität für LLM-Nachtests nach Art der Schlussfolgerung festlegen
Ordnen Sie eine Schlussfolgerung zunächst einer Kategorie zu. Schlussfolgerungen über Fähigkeitsdefizite – etwa Probleme beim Zählen, Rechnen oder Erinnern oder das Ändern einer Antwort nach Widerspruch – gelten zunächst als „wahrscheinlich veraltet“. Sie müssen vor einer Verwendung erneut getestet werden. Schlussfolgerungen über Präferenzen und Tendenzen – etwa Selbstbevorzugung, übermäßige Zustimmung oder gleichförmige Ausgaben – gelten dagegen zunächst als „wahrscheinlich weiterhin gültig“ und sollten in langfristige Regressionstests aufgenommen werden.
Berücksichtigen Sie anschließend das Alter der Schlussfolgerung: Laut den Forschungsdaten sind Schlussfolgerungen, die älter als ein Jahr sind, mit einer Wahrscheinlichkeit von etwa 16 % veraltet. Nach mehr als zwei Jahren steigt dieser Anteil auf 39 %. Wurde das betreffende Modell inzwischen durch Ihr Kandidatenmodell ersetzt, sollten Sie die Schlussfolgerung unabhängig von ihrer Bekanntheit erneut testen.
Schritt 3: Schlussfolgerungen in ausführbare LLM-Testfälle umwandeln
Eine Aussage wie „Das Modell versteht lange Dokumente schlecht“ lässt sich nicht direkt testen. Formulieren Sie daraus konkrete Testfälle: Platzieren Sie beispielsweise eine wichtige Information jeweils am Anfang, in der Mitte und am Ende eines langen Dokuments. Stellen Sie dazu Fragen und ermitteln Sie die Quote korrekter Antworten. Oder lassen Sie das Modell zunächst eine richtige Antwort geben, simulieren Sie dann einen Widerspruch durch den Nutzer und messen Sie, wie häufig das Modell seine Antwort ändert.
Orientieren Sie sich dabei möglichst an Ihren tatsächlichen Geschäftsdaten, statt nur vereinfachte Beispiele aus Forschungsarbeiten zu übernehmen. Die in der Studie als „veraltet“ eingestuften klassischen Aufgaben wurden möglicherweise von verschiedenen Anbietern gezielt ins Training aufgenommen. Besteht ein Modell diese Aufgaben, heißt das nicht, dass es auch mit Ihren Geschäftsdaten zurechtkommt.
Schritt 4: Alle LLM-Kandidaten mit denselben Eingabeaufforderungen erneut testen
Beim erneuten Testen kommt es darauf an, die Variablen konstant zu halten: dieselben Eingabeaufforderungen, dieselben Parameter und dieselben Bewertungskriterien – nur das Modell wird gewechselt. Wenn für jedes Modell ein eigenes SDK eingebunden und die Authentifizierung separat umgesetzt werden muss, steigt der Aufwand so stark, dass das Team die Tests möglicherweise gar nicht erst durchführt.
🚀 Praxistipp: APIYI apiyi.com nutzt einen einheitlichen OpenAI-API-Standard. Mit einem einzigen Token lassen sich über 200 Modelle aufrufen. Beim Wechsel zwischen Kandidaten muss nur der Parameter
modelgeändert werden; Eingabeaufforderungen und andere Parameter bleiben gleich. Das eignet sich gut für vergleichende Nachtests. Welche Modelle und Versionen konkret unterstützt werden, steht in der offiziellen Modellliste der Plattform.
Schritt 5: Ein Archiv für LLM-Ergebnisse anlegen und regelmäßig überprüfen
Speichern Sie das Ergebnis jedes Nachtests in einem „Ergebnisarchiv“. Es sollte mindestens die ursprüngliche Schlussfolgerung, Metadaten, Testergebnisse und das Datum der nächsten Überprüfung enthalten. Bei einer durchschnittlichen Gültigkeitsdauer von 15,7 Monaten empfiehlt es sich, Schlussfolgerungen, auf die sich zentrale Geschäftsprozesse stützen, viertel- oder halbjährlich zu überprüfen. Wenn ein Upgrade der Modellversion geplant ist, sollte in jedem Fall ein vollständiger Nachtest stattfinden.
| Szenario | Empfohlener Testumfang | Zeitpunkt |
|---|---|---|
| Erstmalige Modellauswahl | Alle entscheidungsrelevanten Schlussfolgerungen + zentrale Geschäftsanwendungsfälle | Vor der Auswahlentscheidung |
| Upgrade der Modellversion | Alle Regressionstestfälle | Vor der Umstellung im Produktivbetrieb |
| Externe Schlussfolgerungen zitieren | Nur die betreffenden Schlussfolgerungen | Vor der Aufnahme in das Konzeptdokument |
| Regulärer Betrieb | Präferenzbezogene Schlussfolgerungen + Anwendungsfälle mit hohem Risiko | Viertel- oder halbjährlich |
| Auffälligkeiten im Produktivbetrieb | Fähigkeiten, die mit der Auffälligkeit zusammenhängen | Sofort |
💡 Auswahltipp: Fragen Sie bei der Auswahl nicht zuerst „Welches Modell ist am stärksten?“. Klären Sie stattdessen, welche Fehler für Ihr Geschäft am schwersten wiegen, und testen Sie die Kandidaten gezielt darauf. Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich mehrere Kandidaten im selben Testablauf vergleichen. So entstehen weniger zusätzliche Variablen durch die technische Anbindung.
Häufig gestellte Fragen (FAQ)
F1: Was bedeutet es, wenn eine LLM-Erkenntnis „veraltet“ ist?
In dieser Stanford-Studie gilt eine empirische Erkenntnis über LLMs als „veraltet“, wenn der zugrunde liegende Effekt bei neueren Modellen weitgehend verschwunden ist. Davon unterscheidet sich „abgeschwächt“: Das Problem besteht weiterhin, tritt aber deutlich seltener oder schwächer auf. Von den 50 Erkenntnissen waren 44 % veraltet und 34 % abgeschwächt.
F2: Was ist der Unterschied zwischen Erkenntnissen über Fähigkeitsdefizite und solchen über Verhaltenstendenzen bei LLMs?
Erkenntnisse über Fähigkeitsdefizite beschreiben, was ein Modell „nicht kann“, etwa Buchstaben zählen, Rechenaufgaben lösen oder Informationen in langen Kontexten behalten. Hier gibt es eindeutig richtige Antworten, und gezieltes Training kann die Defizite leichter beheben. Deshalb veralten diese Erkenntnisse am schnellsten. Erkenntnisse über Verhaltenstendenzen beschreiben dagegen, „wie ein Modell bevorzugt handelt“ – etwa wenn es eigene Antworten bevorzugt oder Nutzern nach dem Mund redet. Hier gibt es keine Standardantwort, weshalb diese Tendenzen länger bestehen bleiben.
F3: Wann wurde die Studie über veraltete LLM-Erkenntnisse veröffentlicht?
Der Bericht dazu erschien am 3. November 2026. Die Studie untersuchte insgesamt 20 Modelle von acht Entwicklern, die zwischen Juli 2024 und September 2026 veröffentlicht wurden. Da sich Modelle schnell weiterentwickeln, sind auch die hier zitierten Zahlen nur begrenzt aktuell. Prüfen Sie deshalb vor ihrer Verwendung die Originalstudie.
F4: Welche Teams sollten LLMs besonders dringend bei jedem Versionswechsel erneut testen?
Das betrifft vor allem folgende Fälle:
– **Teams, die ein Modell auswählen oder wechseln**: So schließen sie Kandidaten nicht aufgrund von zwei Jahre alten Eindrücken über deren Schwächen aus.
– **Teams, die LLMs für Bewertungen und Benotungen einsetzen**: Tendenzen wie die Bevorzugung eigener Antworten oder die Beeinflussung durch Formulierungen bestehen weiterhin.
– **Anwendungen mit hohen Anforderungen an die Faktenrichtigkeit**: Der Anteil erfundener Quellenangaben liegt bei Modellen derselben Generation zwischen 0 % und 69 %.
– **Dialogprodukte für Kundenservice oder Beratung**: Die Tendenz, Nutzern nach dem Mund zu reden, muss langfristig überwacht werden.
F5: Wie lassen sich mehrere LLMs kostengünstig erneut testen?
Entscheidend ist eine einheitliche Schnittstelle, mit der sich das Modell wechseln lässt, ohne andere Variablen zu verändern:
1. Besuchen Sie APIYI unter apiyi.com, registrieren Sie ein Konto und holen Sie sich einen API-Schlüssel.
2. Prüfen Sie in der offiziellen Modellliste, ob die gewünschten Modelle und Versionen verfügbar sind.
3. Verwenden Sie dieselben Eingabeaufforderungen und Parameter, ändern Sie für jeden Modellaufruf nur den Parameter `model` und halten Sie Ergebnisse und Metadaten fest.
So können Sie sich auf die Gestaltung der Testfälle konzentrieren, statt immer wieder Schnittstellen verschiedener Anbieter anzubinden.
F6: Können Ranglistenwerte neuer Modelle erneute Tests ersetzen?
Sie sollten sich nicht vollständig darauf verlassen. Die Studie zeigt, dass weder Veröffentlichungsdatum noch Anbieter oder Modellgröße zuverlässig vorhersagen, wie ein Modell in Bezug auf eine konkrete Erkenntnis abschneidet. Selbst Modelle, die ungefähr zur gleichen Zeit veröffentlicht wurden, unterscheiden sich stark. Ranglisten eignen sich für eine erste Vorauswahl; die endgültige Entscheidung sollte aber auf erneuten Tests mit Ihren eigenen Geschäftsdaten beruhen.
F7: Welche Grenzen hat die LLM-Studie selbst?
Erstens finden sich die vollständige Liste der 50 Schlussfolgerungen und die Methoden für die erneuten Tests nur in der Originalstudie; Sekundärberichte können nicht alle Details abdecken. Zweitens unterscheiden sich in der Berichterstattung die Aussagen im Fließtext und in der Bildunterschrift zu den Schlussfolgerungen über das logische Denken. Hier ist die Originalstudie maßgeblich. Und schließlich sind auch die Studienergebnisse nur Beobachtungen zu „bestimmten Modellen zu einem bestimmten Zeitpunkt“. Nach der Logik der Forschenden werden also auch sie mit der Zeit veralten.
Veraltete LLM-Schlussfolgerungen: Die wichtigsten Erkenntnisse
- Hoher Anteil veralteter Aussagen: Von 50 gängigen Schlussfolgerungen über LLMs sind 44 % bereits veraltet, bei 34 % ist die Aussagekraft deutlich zurückgegangen
- Kurze Gültigkeitsdauer: Schlussfolgerungen, deren Gültigkeitsdauer sich schätzen lässt, gelten im Durchschnitt nur 15,7 Monate; nach zwei Jahren sind fast 40 % veraltet
- Aussagen über Fähigkeitsschwächen veralten am schnellsten: Behauptungen über Probleme beim Buchstabenzählen, bei Rechenaufgaben oder beim Informationsverlust in langen Kontexten sollten vorrangig erneut getestet werden
- Präferenzen und Verhaltensmuster bleiben länger bestehen: Die Bevorzugung eigener Ergebnisse, Schmeichelei und gleichförmige Ausgaben sollten in langfristige Regressionstests aufgenommen werden
- Keine Rückschlüsse allein aus Hersteller oder Zeitpunkt: Selbst bei Modellen aus dem Jahr 2026 liegt der Anteil erfundener Quellenangaben zwischen 0 % und 69 %
- Metadaten sind Voraussetzung: Fehlt Modellname, Version, Datum oder Eingabeaufforderung, lässt sich eine Schlussfolgerung nur schwer reproduzieren
- Eine einheitliche Schnittstelle senkt den Aufwand für erneute Tests: Mit APIYI apiyi.com lassen sich Modelle vergleichen, indem lediglich der Parameter
modelgeändert wird
Fazit
LLM-Erkenntnisse sind im Durchschnitt schon nach 15,7 Monaten überholt. Diese Daten zeigen:
- Erkenntnisse haben ein Verfallsdatum: Jede Aussage über ein LLM sollte als „Beobachtung zu einem bestimmten Modell zu einem bestimmten Zeitpunkt“ gelten.
- Die Art der Erkenntnis bestimmt die Priorität: Aussagen über fehlende Fähigkeiten sollten vorrangig erneut getestet werden, Präferenztendenzen dagegen langfristig beobachtet.
- Die Version ist entscheidend: Hersteller, Veröffentlichungsdatum und Modellgröße ersetzen keinen Test der konkreten Version.
Wenn Sie beim nächsten Meeting zur Modellauswahl hören, „Modell X ist nicht gut in Y“, stellen Sie zunächst drei Fragen: Welche Version? Wann wurde getestet? Ist die Eingabeaufforderung noch vorhanden? Wenn sich das nicht beantworten lässt, gehört die Aussage auf die Liste für erneute Tests.
Über APIYI apiyi.com lassen sich Kandidatenmodelle in denselben Testablauf einbinden und mit denselben Eingabeaufforderungen schnell erneut testen. Welche Modelle verfügbar sind, entnehmen Sie der offiziellen Liste.
📚 Referenzen
- THE DECODER – Rapid LLM development is outrunning the research meant to explain it, study finds: Bericht über die Stanford-Studie zur Gültigkeitsdauer von LLM-Erkenntnissen
- Link:
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
Hinweis: Enthält zentrale Daten zu den 44 % überholten Erkenntnissen, der durchschnittlichen Gültigkeitsdauer von 15,7 Monaten, Beispielen erfundener Literaturangaben und Unterschieden zwischen Modellen derselben Generation.
-
Originalarbeit von Owen Queen und James Zou: Studie von Stanford-Forschenden, die 50 Erkenntnisse über LLMs erneut untersucht haben
- Link: Bitte suchen Sie auf einer wissenschaftlichen Suchplattform nach den Namen der Autoren und dem Titel der Arbeit.
- Hinweis: Für diesen Artikel war der Volltext der Originalarbeit nicht verfügbar. Die Liste der 50 Erkenntnisse und die Testmethoden entnehmen Sie bitte dem Original.
Autor: Technikteam von APIYI
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com. Weitere Informationen zur Modellintegration finden Sie im Dokumentationszentrum unter docs.apiyi.com.