Anmerkung des Autors: Dieser Artikel erklärt anhand der Fehlercodes 429, 401 und 500, warum AI-API-Aufrufe fehlschlagen und wie du darauf reagierst. Du erfährst, wann sich ein Retry lohnt, wann du die Konfiguration korrigieren musst und wofür exponentielles Backoff, Fallback auf andere Modelle und Circuit Breaking geeignet sind.
Beim Aufruf großer Sprachmodelle im Produktivbetrieb taucht mitten in der Nacht eine Reihe von 429-, 401- und 500-Fehlern im Alarmkanal auf – ein Szenario, das viele Entwickler kennen. Häufig werden dann einfach alle fehlgeschlagenen Anfragen erneut gesendet. Doch das verschlimmert die Lage oft. Dieser Artikel erklärt nach Fehlercodes geordnet, wie du 429-, 401- und 500-Fehler bei AI-APIs einordnest und fehlertolerant behandelst. So ersetzt du blindes Wiederholen durch eine gezielte Fehlerbehandlung.
Dies ist keine Einführung in HTTP-Statuscodes, sondern ein Praxisleitfaden für den Produktivbetrieb. Er behandelt die typischen Ursachen der einzelnen Fehler, die Frage nach Wiederholungsversuchen, die Implementierung der Fehlerbehandlung in der Anwendung und die Aufgabenverteilung zwischen Gateway und Anwendung.
Der wichtigste Nutzen: Nach der Lektüre kannst du innerhalb weniger Minuten entscheiden, ob du eine fehlgeschlagene Anfrage wiederholen, auf eine Alternative ausweichen oder sofort die Konfiguration korrigieren solltest. Außerdem weißt du, wann exponentielles Backoff, Fallback auf andere Modelle und Circuit Breaking jeweils sinnvoll sind.
Das Wichtigste zu den AI-API-Fehlern 429, 401 und 500
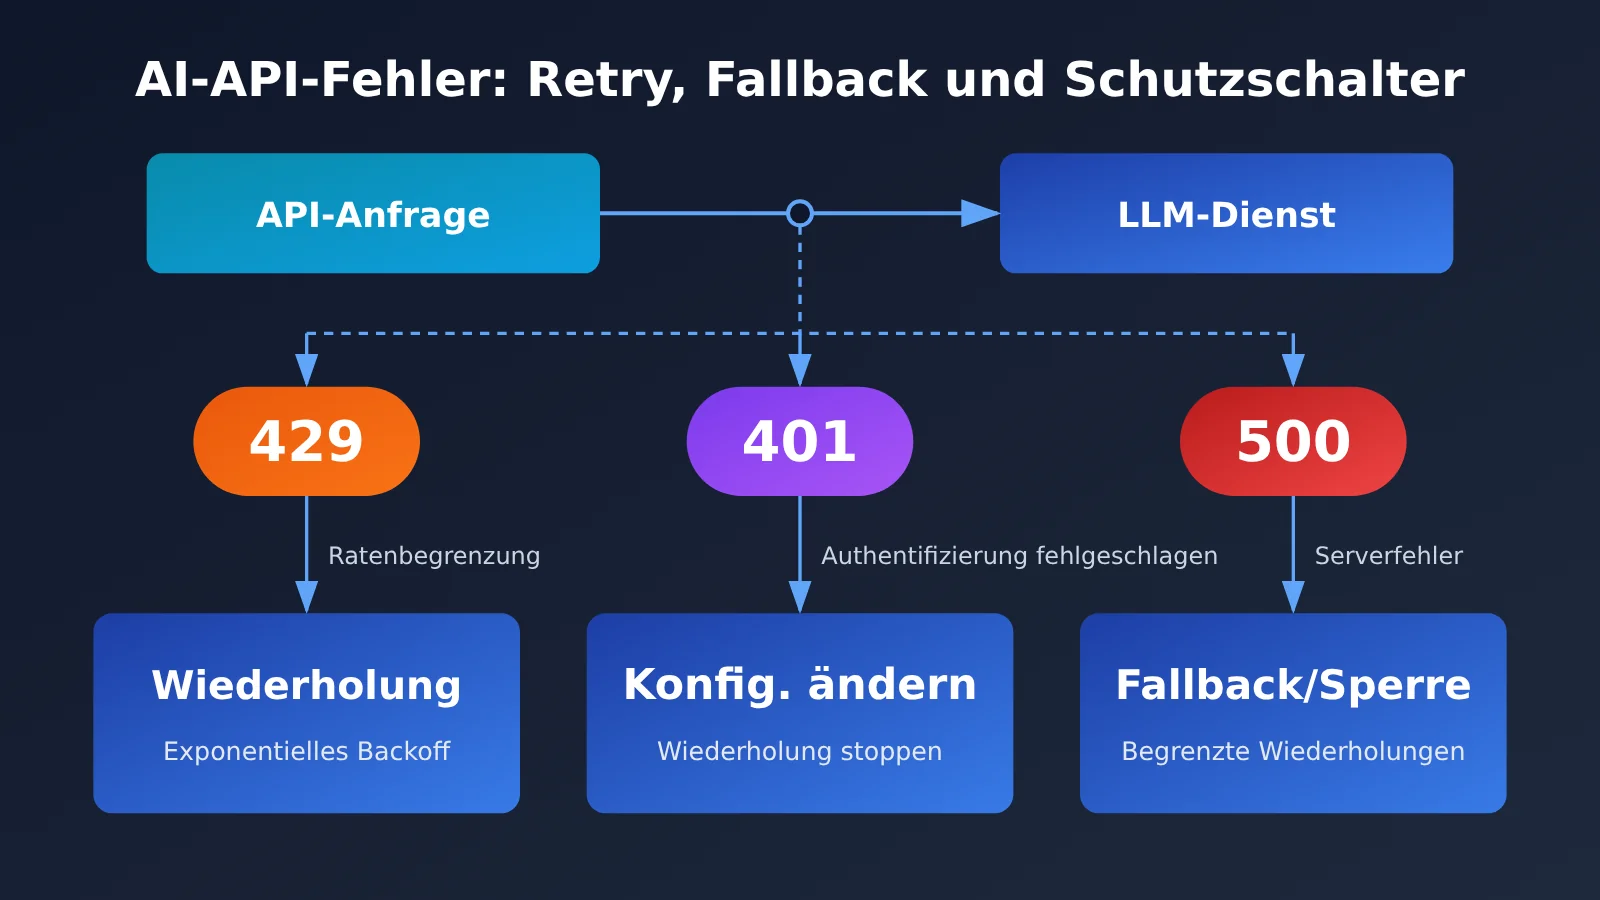
Bei AI-API-Fehlern steht die Einordnung an erster Stelle, nicht der erneute Versuch. Die Fehlercodes weisen auf unterschiedliche Ursachen hin: Manche Probleme lösen sich nach kurzer Zeit von selbst, andere bleiben auch nach beliebig vielen Wiederholungen bestehen. Die folgende Tabelle gibt einen Überblick über die Fehlerkategorien.
| Fehlerkategorie | Typische Statuscodes | Ursache | Erneuter Versuch? | Wichtigste Maßnahmen |
|---|---|---|---|---|
| Ratenbegrenzung | 429 | Zu viele Anfragen oder Kontingent aufgebraucht | Je nach Ursache | Retry-After auslesen, exponentielles Backoff verwenden und zwischen Ratenbegrenzung und ausgeschöpftem Kontingent unterscheiden |
| Authentifizierung | 401、403 | API-Schlüssel ungültig oder Berechtigungen unzureichend | Nein | Wiederholungsversuche sofort stoppen, Alarm auslösen und Konfiguration korrigieren |
| Serverfehler | 500、502、503、504 | Fehler oder Überlastung beim vorgelagerten Dienst | Ja, begrenzt | Begrenzt oft mit Backoff erneut versuchen; bei anhaltenden Fehlern auf eine Ersatzlösung ausweichen oder einen Circuit Breaker auslösen |
| Anfragefehler | 400、404、413、422 | Fehlerhafte Parameter, falscher Modellname oder falsche Länge | Nein | Anfrage-Body protokollieren, Parameter korrigieren und erneut senden |
Ob ein erneuter Versuch sinnvoll ist, hängt davon ab, ob der Fehler vorübergehend oder dauerhaft ist. Bei vorübergehenden Fehlern wie einer Ratenbegrenzung oder kurzzeitigen Störungen des vorgelagerten Dienstes kann sich ein erneuter Versuch lohnen. Bei dauerhaften Fehlern wie einem falschen API-Schlüssel oder fehlerhaften Parametern verschwenden Wiederholungen nur Kontingent, verzögern die Antwort und können sogar strengere Ratenbegrenzungen auslösen.
Entscheidungstabelle für AI-API-Fehlercodes
Bei der Fehlersuche reicht der Statuscode allein nicht aus. Entscheidend sind auch das Fehlerart-Feld im Response-Body und die Response-Header. Die folgende Tabelle lässt sich direkt als Grundlage für die Logik auf Anwendungsebene nutzen.
| Beobachtetes Signal | Mögliche Ursache | Empfohlene Aktion | Für den Circuit Breaker mitzählen? |
|---|---|---|---|
429 mit Retry-After-Header |
Ratenbegrenzung | Nach der im Header angegebenen Zeit erneut versuchen | Nein |
| 429 und Hinweis auf unzureichendes Kontingent oder Guthaben im Fehler-Body | Kontingent des Kontos aufgebraucht | Nicht erneut versuchen; Alarm auslösen und Guthaben aufladen oder Konto wechseln | Nein |
| 401 | API-Schlüssel falsch, abgelaufen oder fehlerhaft formatiert | Nicht erneut versuchen; API-Schlüssel und Umgebungsvariablen prüfen | Nein |
| 403 | API-Schlüssel hat keinen Zugriff auf das Modell oder die Region | Nicht erneut versuchen; Berechtigungen und Modellfreischaltung prüfen | Nein |
| 500 / 502 | Interner Fehler beim Upstream-Anbieter oder fehlgeschlagene Gateway-Weiterleitung | 2–3 Wiederholungsversuche mit Backoff | Ja |
| 503 | Dienst überlastet oder in Wartung | Mit Backoff erneut versuchen, bei Misserfolg auf eine Fallback-Lösung wechseln | Ja |
| 504 oder Client-Timeout | Generierung dauert zu lange oder Upstream antwortet langsam | Je nach Idempotenz erneut versuchen; gegebenenfalls Timeout erhöhen | Ja |
Besonders leicht zu übersehen sind die zwei möglichen Bedeutungen von 429. Manche Anbieter geben 429 auch bei aufgebrauchtem Kontingent zurück. Das Fehlerart-Feld im Response-Body unterscheidet sich dann aber von dem bei einer normalen Ratenbegrenzung. Wertet die Anwendung nur den Statuscode aus, wiederholt sie eine Anfrage bei unzureichendem Guthaben möglicherweise endlos mit Backoff. Die Logs füllen sich mit 429-Fehlern, aber der Dienst erholt sich nicht.
429: Rate-Limit-Fehler im Detail
Ein 429-Fehler tritt auf, wenn die Anzahl der Anfragen oder Token in einem bestimmten Zeitraum das Limit überschreitet. APIs für Große Sprachmodelle begrenzen die Nutzung meist auf mehreren Ebenen: Anfragen pro Minute, Token pro Minute und teilweise auch gleichzeitig laufende Anfragen. Deshalb kann selbst bei wenigen Anfragen ein besonders langer Kontext einen 429-Fehler auslösen.
Für den Umgang mit 429-Fehlern in der Anwendung gelten drei Grundsätze. Erstens: Beachten Sie vorrangig Retry-After oder ähnliche Header, die den Zeitpunkt der Rücksetzung angeben, statt die Wartezeit selbst zu schätzen. Zweitens: Fehlen entsprechende Header, verwenden Sie exponentielles Backoff mit zufälliger Streuung. So verhindern Sie, dass viele Clients gleichzeitig erneut anfragen und das Limit sofort wieder ausschöpfen. Drittens: Begrenzen Sie den Datenverkehr direkt an der Quelle, etwa mit einem Token-Bucket oder einer Warteschlange. Das ist wirksamer als nachträgliche Wiederholungsversuche.
401: Authentifizierungsfehler im Detail
Bei einem 401-Fehler sind Wiederholungsversuche besonders fehl am Platz. Die Ursache liegt fast immer in der Konfiguration. Häufige Gründe sind zusätzliche Leerzeichen oder Zeilenumbrüche beim Kopieren des Schlüssels, eine nicht korrekt in den Container übergebene Umgebungsvariable, ein Schlüssel aus der Testumgebung in der Produktion, ein ausgetauschter oder widerrufener Schlüssel oder ein falsches Format des Authentifizierungs-Headers.
Bei OpenAI-kompatiblen Schnittstellen kommt es außerdem häufig vor, dass base_url und Schlüssel nicht zusammenpassen – etwa wenn mit dem Schlüssel von Plattform A eine Anfrage an die Adresse von Plattform B gesendet wird. Bei einem 401-Fehler sollte die Anwendung daher sofort alle Wiederholungsversuche stoppen, eine Warnung mit hoher Priorität auslösen und die ersten Zeichen des Schlüssels sowie die Anfrageadresse im Log festhalten. Das erleichtert die Fehlersuche. Den vollständigen Schlüssel sollten Sie jedoch nicht protokollieren.
500er-Serverfehler im Detail
Fehler der 500er-Reihe weisen auf ein Problem auf dem Server oder im Übertragungsweg hin. Mögliche Ursachen sind interne Fehler oder eine Überlastung des vorgeschalteten Modelldienstes oder eine fehlgeschlagene Weiterleitung durch ein zwischengeschaltetes Gateway. Solche Fehler sind meist vorübergehend, daher bieten sich Wiederholungsversuche in begrenzter Zahl an. Treten sie jedoch dauerhaft auf, ist der vorgeschaltete Dienst offenbar nicht mehr stabil. Weitere Versuche würden dann nur Anfragen aufstauen und Threads belegen. Stattdessen sollte auf ein Ersatzmodell umgeschaltet oder ein Circuit Breaker aktiviert werden.
Beachten Sie auch 504-Fehler und clientseitige Timeouts. Die Generierung langer Texte durch ein Großes Sprachmodell dauert grundsätzlich länger. Ist das Timeout zu kurz eingestellt, werden normale, langsame Anfragen fälschlich als fehlgeschlagen eingestuft und erneut gesendet. Das kann zu doppelter Abrechnung führen. Wird eine Streaming-Ausgabe unterbrochen, erhält das Frontend zudem nur einen abgeschnittenen Inhalt.
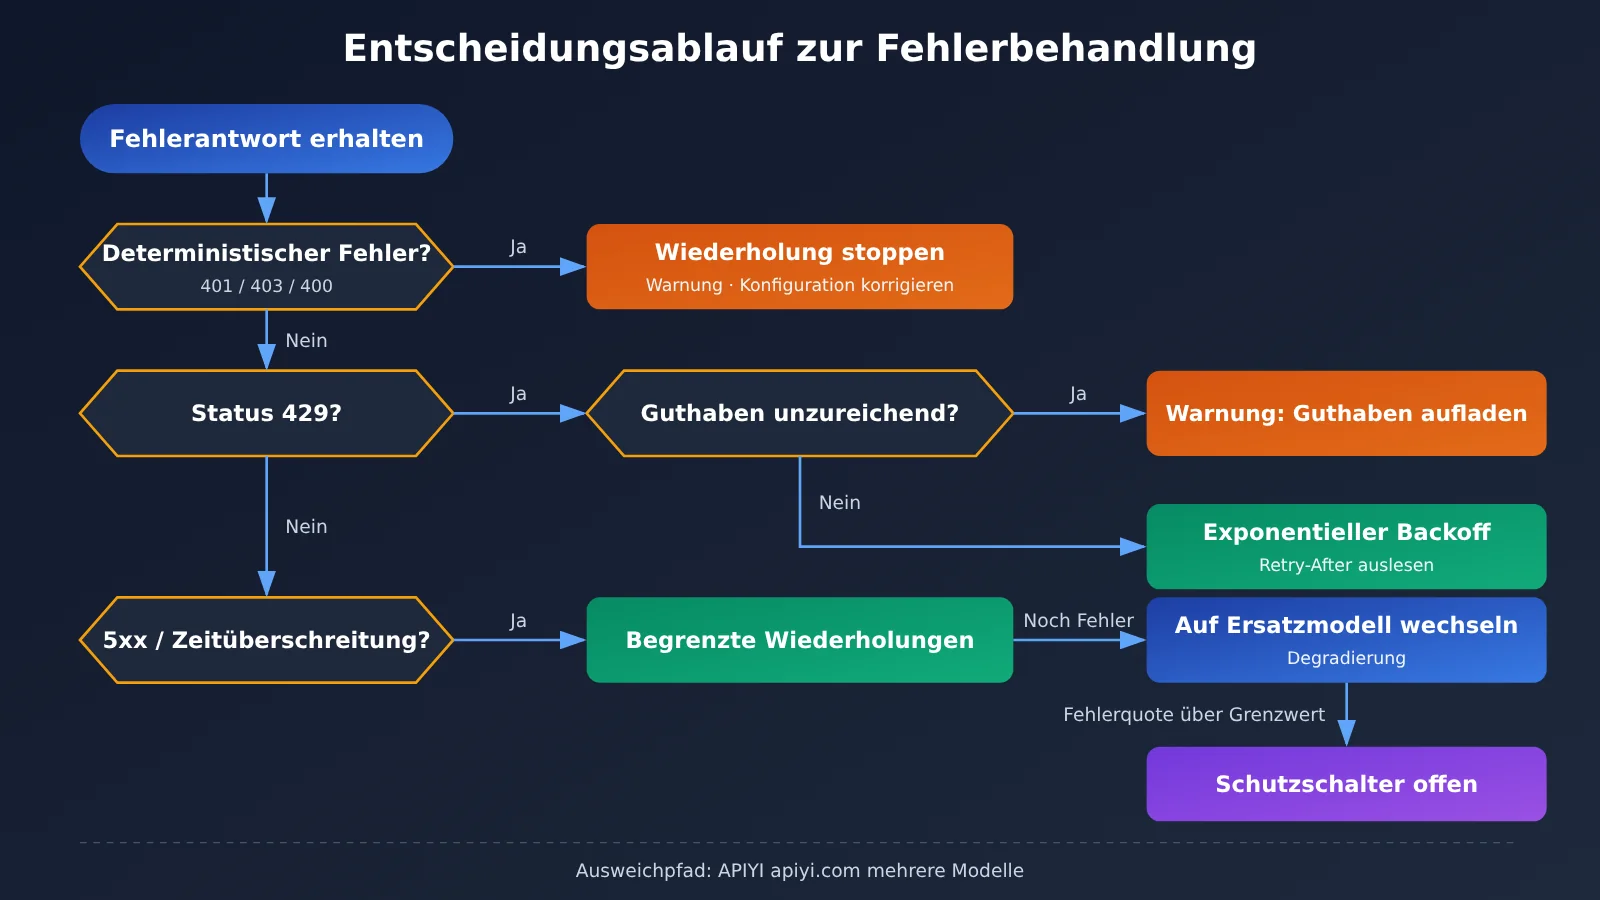
Schnellstart: Wiederholungsversuche, Fallback und Circuit Breaker für AI-APIs
Nachdem die Fehler kategorisiert sind, geht es an die Umsetzung. Dieser Abschnitt verzichtet auf Codeblöcke und erklärt die wichtigsten Punkte anhand von Parameterlisten und Schritten. So lässt sich jede der Mechanismen in einer beliebigen Sprache implementieren.
Exponentielles Backoff für Wiederholungsversuche
Die Idee hinter exponentiellem Backoff: Die Wartezeit wächst mit jedem Wiederholungsversuch um einen Faktor. Zusätzlich kommt eine zufällige Streuung, auch Jitter genannt, hinzu. Die Logik lässt sich so aufbauen:
- Definiere die Fehler, bei denen ein Wiederholungsversuch sinnvoll ist, zum Beispiel
429(sofern das Kontingent nicht aufgebraucht ist),500,502,503,504und Netzwerk-Timeouts. - Prüfe nach jedem Fehler zuerst den Response-Header
Retry-After. Ist er vorhanden, richte die Wartezeit danach; andernfalls berechne sie mit der Backoff-Formel. - Die Formel lautet üblicherweise „Basisintervall × 2 hoch Anzahl der Wiederholungsversuche“, zuzüglich eines zufälligen Jitter-Werts. Lege außerdem eine Obergrenze für die einzelne Wartezeit fest.
- Lege eine maximale Anzahl an Wiederholungsversuchen und ein Zeitbudget für den gesamten Aufruf fest. Sobald eine der Grenzen überschritten wird, brich ab und übergib den Fehler an die Fallback-Logik.
- Protokolliere jeden Wiederholungsversuch mit Fehlercode, Anzahl der Versuche, Wartezeit und Modellnamen, um spätere Analysen zu erleichtern.
Wenn du ein offizielles SDK verwendest, stehen häufig bereits Parameter wie max_retries und timeout zur Verfügung. Achte darauf, nicht zusätzlich dieselbe Wiederholungslogik ausserhalb des SDK zu implementieren: Andernfalls multipliziert sich die Zahl der Versuche und das Anfragevolumen steigt im Fehlerfall stark an.
Die folgende Tabelle enthält typische Erfahrungswerte für den Einstieg. Passe sie an die Latenzanforderungen deiner Anwendung und die Limits des Anbieters an.
| Parameter | Bedeutung | Typischer Startwert | Grundlage für die Anpassung |
|---|---|---|---|
max_retries |
Maximale Anzahl an Wiederholungsversuchen | 2–5 Versuche | Für Echtzeitdialoge niedrig, für Offline-Batchverarbeitung höher |
| Basisintervall | Wartezeit bis zum ersten Wiederholungsversuch | Etwa 1 Sekunde | Bei strengen Rate-Limits gegebenenfalls erhöhen |
| Obergrenze pro Wartezeit | Maximale Backoff-Wartezeit | Einige Dutzend Sekunden | Verhindert, dass einzelne Wartezeiten die Anfrage zu stark verzögern |
| Zufälliger Jitter | Streuung der Wiederholungszeitpunkte | Zufallswert als Anteil der Wartezeit | Besonders wichtig bei vielen gleichzeitigen Clients |
| Gesamtzeitbudget | Maximale Dauer eines Aufrufs | Gemäss SLA der Anwendung | Nach Ablauf direkt auf den Fallback wechseln |
🚀 Schnellstart: Wenn du in der Testphase das Wiederholungsverhalten bei verschiedenen Fehlercodes simulieren möchtest, kannst du über APIYI apiyi.com mehrere Modelle über eine einheitliche OpenAI-kompatible Schnittstelle anbinden. So beobachtest du Antworten und Fehler verschiedener Modelle mit derselben Wiederholungslogik und sparst dir separate Anpassungen für jeden Anbieter.
Fallback-Strategien mit mehreren Modellen
Wiederholungsversuche helfen, wenn „dasselbe Modell vorübergehend nicht verfügbar ist“. Ein Fallback greift dagegen, wenn „sich das Modell kurzfristig nicht erholt“. Dafür wird vorab eine Kette von Ersatzmodellen konfiguriert: Schlägt das primäre Modell wiederholt fehl, wird der Reihe nach auf Ersatzmodelle umgeschaltet. So kann der Dienst weiter antworten – möglicherweise auf Kosten der Qualität oder zu höheren Kosten.
Bei der Planung der Fallback-Kette ist wichtig, dass die Fähigkeiten der Modelle vergleichbar sind. Wenn das primäre Modell Funktionsaufrufe, strukturierte Ausgaben oder lange Kontexte benötigt, müssen auch die Ersatzmodelle diese Funktionen unterstützen. Andernfalls können nach dem Umschalten neue 400-Fehler oder Probleme beim Einlesen des Ausgabeformats auftreten. Die folgende Tabelle zeigt beispielhaft, wie sich Fallback-Ketten für verschiedene Szenarien gestalten lassen.
| Anwendungsszenario | Primäres Modell | Erstes Ersatzmodell | Zweite Auffanglösung | Verfügbare Plattformen |
|---|---|---|---|---|
| Online-Kundensupport | Hochwertiges Allzweckmodell | Modell eines anderen Anbieters auf demselben Niveau | Schnelles, leichtgewichtiges Modell + vereinfachte Antwort | APIYI apiyi.com, offizielle APIs der jeweiligen Anbieter |
| Codegenerierung und -prüfung | Flaggschiffmodell mit starken Programmierfähigkeiten | Flaggschiffmodell eines anderen Anbieters | Hinweis „Später erneut versuchen“ ausgeben | APIYI apiyi.com, offizielle APIs der jeweiligen Anbieter |
| Stapelverarbeitung von Inhalten | Modell mit gutem Preis-Leistungs-Verhältnis | Anderes Modell in derselben Preisklasse | In eine Warteschlange schreiben und später verarbeiten | APIYI apiyi.com, offizielle APIs der jeweiligen Anbieter |
| Extraktion strukturierter Informationen | Modell mit JSON-Ausgabe | Modell, das ebenfalls strukturierte Ausgaben unterstützt | Regel-Engine als Auffanglösung | APIYI apiyi.com, offizielle APIs der jeweiligen Anbieter |
Beim Fallback sollten Sie einige Details beachten:
- Anpassung der Eingabeaufforderung: Modelle reagieren unterschiedlich empfindlich auf System-Eingabeaufforderungen. Für Ersatzmodelle empfiehlt sich jeweils eine eigene, getestete Version.
- Kontextlänge: Prüfen Sie vor dem Wechsel, ob die Nachrichten das Kontextfenster des Ersatzmodells überschreiten. Kürzen Sie bei Bedarf zunächst den Verlauf.
- Kennzeichnung der Ergebnisse: Markieren Sie in Logs und Monitoring, dass eine Antwort vom Ersatzmodell stammt. So lässt sich leichter beurteilen, wie sich der Fallback auf die Qualität auswirkt.
- Kein Fallback bei Authentifizierungsfehlern: Ein 401-Fehler weist auf ein Konfigurationsproblem hin. Ein Modellwechsel würde das Problem nur verdecken; lösen Sie stattdessen direkt einen Alarm aus.
Funktionsweise und Grenzen des Circuit Breakers
Ein Circuit Breaker verhindert, dass eine dauerhaft fehlerhafte Abhängigkeit das gesamte System lahmlegt. Er hat in der Regel drei Zustände: Im Zustand geschlossen werden Anfragen normal weitergeleitet und die Fehlerrate wird erfasst. Überschreitet die Fehlerrate oder die Zahl aufeinanderfolgender Fehler einen Schwellenwert, wechselt der Circuit Breaker in den Zustand offen. Anfragen werden dann direkt abgelehnt oder mit einer Fallback-Lösung beantwortet, ohne den fehlerhaften Upstream-Dienst aufzurufen. Nach einer Abkühlphase wechselt er in den Zustand halboffen und lässt einige Testanfragen durch. Sind sie erfolgreich, schließt er wieder; schlagen sie fehl, öffnet er erneut.
Entscheidend ist, nur Fehler zu zählen, die den Zustand des Upstream-Dienstes widerspiegeln. 5xx-Fehler und Timeouts sollten in die Fehlerrate einfließen, Clientfehler wie 401 und 400 dagegen nicht. Andernfalls könnte ein Konfigurationsfehler den Circuit Breaker öffnen und damit auch alle gültigen Anfragen blockieren. Auch ein 429-Fehler aufgrund eines ausgeschöpften Kontingents sollte nicht mitgezählt werden: Er zeigt den Kontostatus an, nicht den Zustand des Dienstes.
Mehr Circuit Breaker sind nicht automatisch besser. Bei internen Tools mit sehr wenigen Aufrufen ist die Stichprobe für die Fehlerrate zu klein, sodass der Circuit Breaker leicht eine falsche Entscheidung trifft. Hier reichen einfache Wiederholungsversuche und ein Fallback aus. Circuit Breaker eignen sich besser für Produktivdienste mit vielen gleichzeitigen Anfragen: Bei einem großflächigen Ausfall des Upstream-Dienstes begrenzen sie den Schaden schnell und verhindern, dass langsame Anfragen den Thread- und den Verbindungspool belegen.
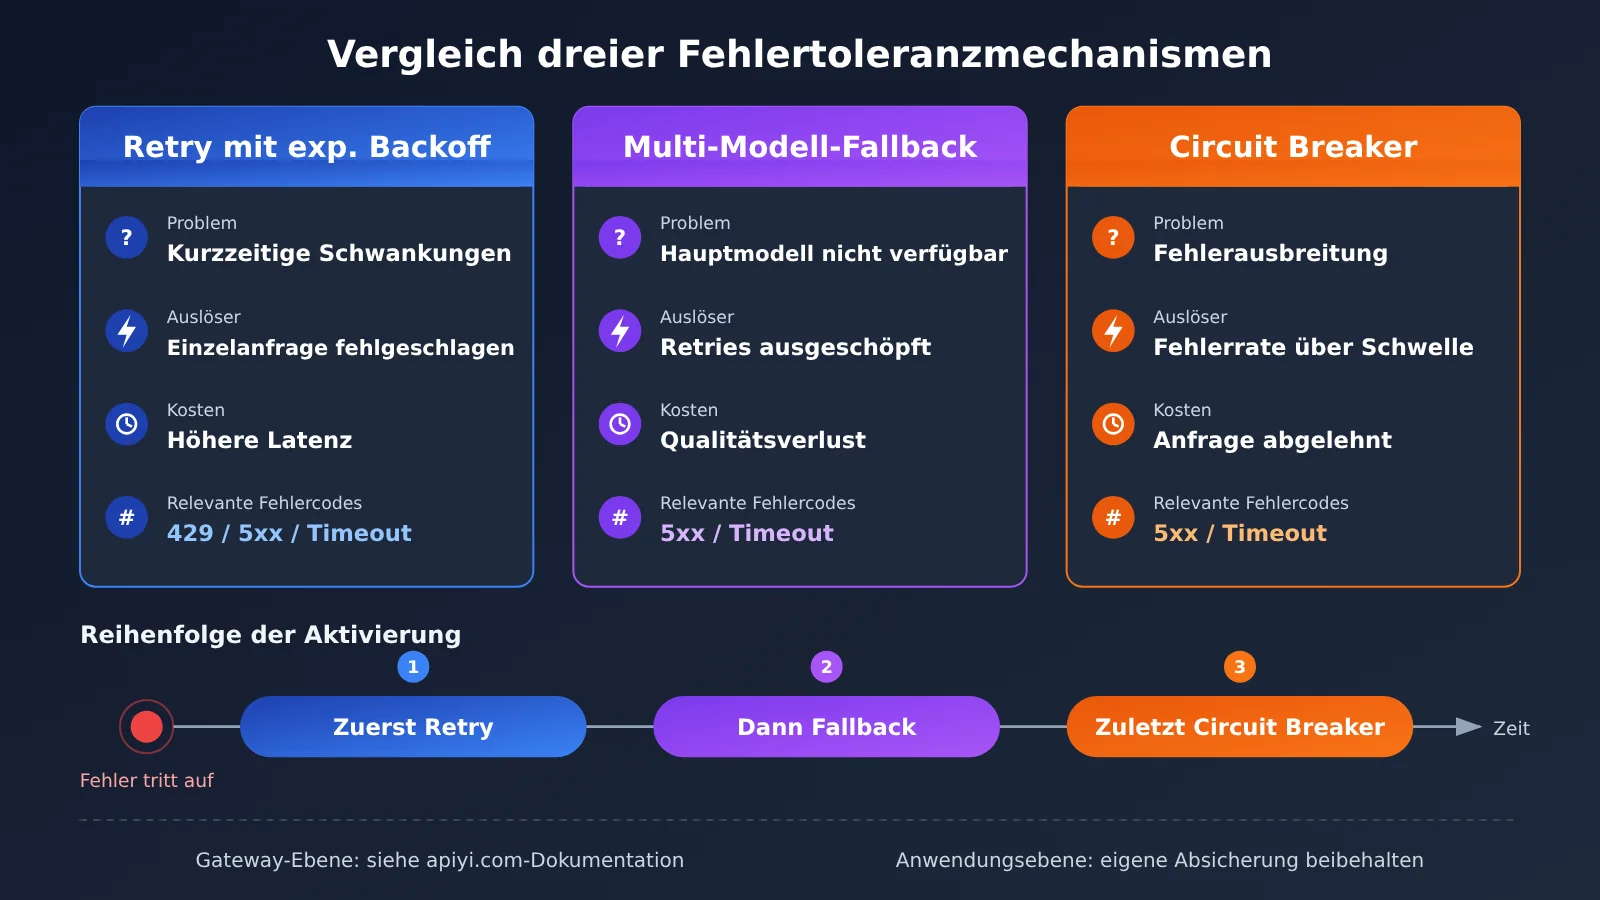
Aufgabenteilung bei der Fehlertoleranz: Gateway und Anwendung
Immer mehr Teams nutzen große Sprachmodelle über API-Gateways oder Aggregationsplattformen. Dabei stellt sich oft die Frage: Wenn das Gateway bereits automatisch auf Alternativen ausweicht, braucht die Anwendung dann noch Wiederholungsversuche und einen Circuit Breaker? Ja – aber mit einer anderen Aufgabenverteilung. Das Gateway kümmert sich um Probleme bei den Upstream-Anbietern, während die Anwendung die fachlichen Anforderungen besser kennt.
| Aufgabe | Gateway-Ebene | Anwendungsebene |
|---|---|---|
| Failover zwischen Anbietern | Zwischen mehreren Anbietern desselben Modells wechseln, Last verteilen | Muss nicht erneut implementiert werden |
| Ausweichen auf andere Modelle | Kann Modell-Routing bereitstellen | Entscheidet, ob die Anwendung eine geringere Qualität akzeptiert und ob die Eingabeaufforderung angepasst werden muss |
| Wiederholungsversuche | Schnelle Wiederholungen auf Anbieterebene | Legt das Wiederholungsbudget fest und stimmt es auf die Wartezeit der Nutzenden ab |
| Circuit Breaker | Überwacht den Zustand der Upstream-Anbieter | Unterbricht Aufrufe und greift auf Alternativen zurück, wenn das gesamte Gateway nicht erreichbar ist |
| Authentifizierungs- und Kontingentfehler | Gibt eindeutige Fehlertypen zurück | Löst Alarme aus, verhindert Wiederholungen und benachrichtigt zuständige Personen |
| Monitoring | Erfolgsrate und Latenz auf Anbieterebene | Erfolgsrate, Anteil der Ausweichlösungen und Auswirkungen auf Nutzende |
APIYI nennt in seiner Leistungsbeschreibung Stabilitätsfunktionen wie automatisches Ausweichen, Lastverteilung und Echtzeit-Monitoring. Solche Funktionen eignen sich für Failover auf Anbieterebene, sodass sich die Anwendung auf fachliche Ausweichlösungen konzentrieren kann. Ob die Bedingungen für das Ausweichen sowie die zurückgegebenen Fehlercodes und das Format der Fehlerantworten vollständig mit denen des offiziellen Anbieters übereinstimmen, sollten Sie anhand der Plattformdokumentation und eigener Tests prüfen. Auch die in der Leistungsbeschreibung erwähnte „unbegrenzte Parallelität“ bedeutet nicht, dass niemals ein 429-Fehler auftritt: Die Beschränkungen der Upstream-Modelle gelten weiterhin. Am sichersten ist es, in der Anwendung stets eine Behandlung für 429- und 5xx-Fehler vorzusehen und eine eigene Ausweichlösung bereitzuhalten, falls das Gateway insgesamt nicht erreichbar ist.
🎯 Technischer Tipp: Lösen Sie nach der Gateway-Integration zunächst in einer Testumgebung gezielt verschiedene Fehler aus – etwa mit einem falschen Schlüssel, einem nicht existierenden Modellnamen oder einem zu langen Kontext. Dokumentieren Sie die Statuscodes und Felder der Fehlerantworten, die APIYI apiyi.com tatsächlich zurückgibt. Passen Sie daraufhin die Regeln zur Fehlerklassifizierung in Ihrer Anwendung an, statt das Fehlerformat aus der offiziellen Dokumentation unverändert zu übernehmen.
Häufig gestellte Fragen (FAQ)
Q1: Was ist der grundlegende Unterschied zwischen einem 429- und einem 500-Fehler bei einer KI-API?
429 bedeutet, dass deine Anfrage ein Limit überschritten hat. Die Ursache liegt also in der Anfragerate oder beim Kontingent deines Kontos. 500 bedeutet, dass auf Serverseite ein Fehler aufgetreten ist – das Problem liegt beim vorgelagerten Dienst. Bei 429 solltest du zunächst die Anfragerate senken und die Wartezeit einhalten. Bei 500 kannst du eine begrenzte Anzahl von Wiederholungsversuchen starten und bei anhaltenden Fehlern auf ein Ersatzmodell ausweichen. In beiden Fällen kann sich das Problem nach kurzer Zeit von selbst lösen, aber der Schwerpunkt bei der Behandlung ist unterschiedlich.
Q2: Warum sollte man einen 401-Fehler niemals automatisch erneut versuchen?
Ein 401-Fehler ist deterministisch: Ist der Schlüssel falsch, bleibt das Ergebnis auch nach zehntausend Versuchen dasselbe. Automatische Wiederholungen verschwenden nicht nur Ressourcen, sondern verdecken auch das Problem und verzögern die Alarmierung. Brich stattdessen sofort ab und prüfe den Schlüssel, die Übergabe der Umgebungsvariablen und ob die Anfrageadresse zum Schlüssel passt.
Q3: Warum verschwindet ein 429-Fehler trotz wiederholter Versuche nicht?
Am häufigsten sind das Kontingent oder das Guthaben aufgebraucht. Manche Anbieter geben auch in diesem Fall 429 zurück, doch das Typfeld im Fehler-Body unterscheidet sich von dem einer gewöhnlichen Ratenbegrenzung. Eine andere Möglichkeit: Deine Wiederholungsversuche nutzen keinen zufälligen Jitter. Dadurch werden viele Anfragen gleichzeitig erneut gesendet und schöpfen das Limit immer wieder aus. Sieh dir zuerst den Fehler-Body an und prüfe anschließend die zeitliche Verteilung der Wiederholungsversuche.
Q4: Kann das Ausweichen auf andere Modelle die Ausgabequalität beeinträchtigen?
Ja, das ist möglich. Beim Ausweichen auf ein Ersatzmodell wird im Grunde Verfügbarkeit gegen Qualität abgewogen. Deshalb solltest du auf Anwendungsebene festlegen, in welchen Szenarien eine solche Ausweichlösung akzeptabel ist. Bereite für Ersatzmodelle separat geprüfte Eingabeaufforderungen vor und erfasse im Monitoring, wie häufig auf sie ausgewichen wird. Bleibt diese Quote über längere Zeit hoch, solltest du Kontingent und Stabilität des Hauptmodells prüfen.
Q5: Wie lassen sich Ausweichketten zwischen verschiedenen Modellen kostengünstig testen?
Du kannst eine Testumgebung mit einer Plattform aufbauen, die eine einheitliche Schnittstelle für mehrere Modelle bietet. Über APIYI apiyi.com kannst du beispielsweise mit derselben OpenAI-kompatiblen Aufrufmethode zwischen Modellen verschiedener Anbieter wechseln. Du musst lediglich den Modellnamen ändern. So lässt sich prüfen, wie sich Haupt- und Ersatzmodelle bei derselben Eingabeaufforderung in ihren Ausgaben und ihrem Fehlerverhalten unterscheiden. Das eignet sich für einen Probelauf der Ausweichkette vor dem Produktivstart.
Q6: Braucht die Anwendung noch einen Circuit Breaker, wenn das Gateway automatisch auf Ersatzmodelle ausweicht?
Ja. Das Ausweichen im Gateway behandelt Probleme bei vorgelagerten Diensten. Das Gateway selbst kann aber ebenfalls nicht erreichbar oder insgesamt nicht verfügbar sein. Für diesen Fall sind der Circuit Breaker und die Fallback-Lösung auf Anwendungsebene da. Bei einem Gateway wie APIYI kannst du für den Circuit Breaker auf Anwendungsebene das Gateway als Ganzes statt einzelner Modellkanäle überwachen. So überschneiden sich die Aufgaben der beiden Ebenen nicht.
Q7: Welche bekannten Nebenwirkungen haben Wiederholungsversuche, Ausweichlösungen und Circuit Breaker?
Wiederholungsversuche können zu mehrfacher Abrechnung führen. Bei nicht idempotenten Vorgängen, etwa Schreiboperationen mit Tool-Aufrufen, können sie außerdem Aktionen mehrfach ausführen. Das Ausweichen auf ein Ersatzmodell kann Qualitätsschwankungen und Unterschiede im Ausgabeformat mit sich bringen. Ist ein Circuit Breaker zu empfindlich eingestellt, weist er unter Umständen reguläre Anfragen ab. Deshalb solltest du alle drei Mechanismen anhand von Monitoring-Kennzahlen laufend nachjustieren, statt sie einmal zu konfigurieren und dann sich selbst zu überlassen.
Die wichtigsten Punkte zur Fehlerbehandlung bei AI-APIs
- Erst einordnen, dann behandeln: Deterministische Fehler sofort beheben; nur bei vorübergehenden Fehlern erneut versuchen.
- Bei 429 den Fehlertext prüfen: Zwischen Ratenbegrenzung und ausgeschöpftem Kontingent unterscheiden – im zweiten Fall sind erneute Versuche sinnlos.
- 401 nie erneut versuchen: Sofort einen Alarm auslösen und insbesondere prüfen, ob Schlüssel, Umgebungsvariablen und API-Endpunkt zusammenpassen.
- Wiederholungsversuche begrenzen: Exponentielles Backoff mit zufälligem Jitter einsetzen und sowohl die Anzahl der Versuche als auch die Gesamtdauer begrenzen.
- Fallbacks auf Fähigkeiten abstimmen: Das Ersatzmodell muss dieselben Funktionen unterstützen und eine eigene Eingabeaufforderung erhalten.
- Für den Circuit Breaker nur serverseitige Fehler zählen: 5xx-Fehler und Timeouts fliessen in die Fehlerrate ein, clientseitige Fehler nicht.
- Gateway und Anwendung klar aufteilen: APIYI apiyi.com kann die Fehlertoleranz auf Kanalebene übernehmen; die Anwendung ist für geschäftslogische Fallbacks zuständig.
Fazit
Wenn eine AI-API 429, 401 oder 500 zurückgibt, ist vor allem eines wichtig: Nicht jeden Fehler pauschal erneut versuchen, sondern je nach Fehlerart unterschiedlich vorgehen.
- Ratenbegrenzung:
Retry-Afterbeachten, mit exponentiellem Backoff und Jitter erneut versuchen und zugleich Parallelität und Token-Verbrauch an der Quelle begrenzen. - Authentifizierungs- und Anfragefehler: Sofort abbrechen, einen Alarm auslösen und die Konfiguration korrigieren. Niemals automatisch erneut versuchen oder den Fehler durch einen Fallback verdecken.
- Serverseitige Fehler: Die Anzahl der Wiederholungsversuche begrenzen und bei anhaltenden Fehlern auf ein Ersatzmodell wechseln. Bei hoher Parallelität hilft ein Circuit Breaker, die Auswirkungen schnell zu begrenzen.
- Gateway und Anwendung trennen: Das Gateway übernimmt Kanalwechsel und Lastverteilung; die Anwendung steuert Geschäftslogik, Wiederholungsbudget und den endgültigen Fallback.
Übernehmen Sie zunächst die Entscheidungstabelle aus diesem Artikel in die internen Standards Ihres Teams zur Fehlerbehandlung. Testen Sie diese anschliessend in einer Störungsübung, um sicherzustellen, dass jede Fehlerart wie vorgesehen behandelt wird.
Wenn Sie eine Fallback-Kette mit mehreren Modellen planen, können Sie über APIYI apiyi.com das Verhalten und die Fehlermeldungen verschiedener Modelle über eine einheitliche Schnittstelle vergleichen. Prüfen Sie Ihre Fehlertoleranzstrategie zuerst in der Testumgebung, bevor Sie sie produktiv einsetzen.
📚 Quellen
- Ofox.ai Blog – Artikel zum Thema AI API Error Handling: Behandelt den Umgang mit 429-Ratenbegrenzungen, 401-Authentifizierungsfehlern und 500-Serverfehlern sowie exponentielles Backoff, Fallbacks auf andere Modelle und Circuit Breaker.
- Link:
ofox.ai/blog/page/41/ -
Hinweis: Eine Quelle für die Themenauswahl dieses Artikels und eine passende englischsprachige Ergänzung.
-
Ofox.ai Blog – Artikel zum Thema LLM API Gateway: Beleuchtet die Auswahl eines LLM-Gateways und Ausfälle bei mehreren Anbietern.
- Link:
ofox.ai/blog/page/40/ -
Hinweis: Hilft dabei, die Rolle der Fehlertoleranz auf Gateway-Ebene in einer Architektur mit mehreren Modellen einzuordnen.
-
APIYI Dokumentationszentrum: Anleitungen zur Anbindung und Nutzung der Plattform.
- Link:
docs.apiyi.com - Hinweis: Für Details wie das Format von Fehlercodes und das Fallback-Verhalten sind die Plattformdokumentation und eigene Tests maßgeblich.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die APIYI-Startseite, um sich über die Stabilität von KI-APIs auszutauschen. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.