Anmerkung des Autors: Dieser Artikel ordnet die erste GDPx-Bestenliste von SemiAnalysis ein, vergleicht die Ergebnisse der Spitzenmodelle und ihre „durchschnittlichen Kosten pro Aufgabe“ und unterscheidet zwischen Evaluierungskosten und offiziellen Token-Preisen. So erhalten Sie eine erste Orientierung bei der Modellauswahl nach Leistungsfähigkeit, Kosten und Verfügbarkeit.
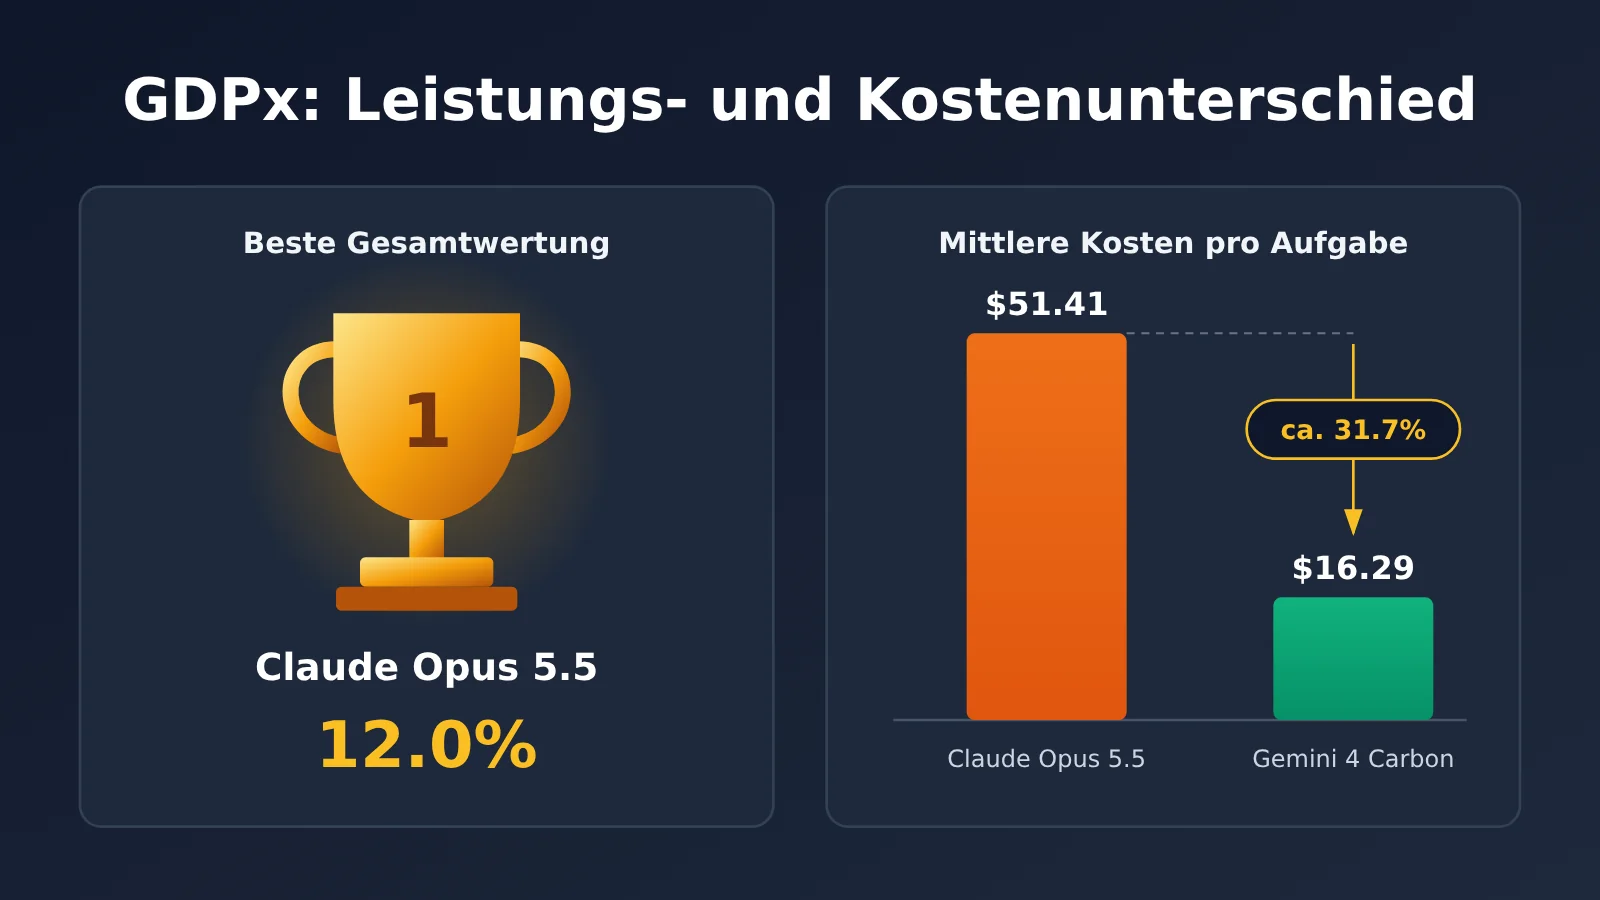
Am 2. November 2026 veröffentlichte SemiAnalysis GDPx v1.0, einen anspruchsvollen Agenten-Benchmark. Claude Opus 5.5 belegt mit einem Gesamtergebnis von 12,0 % den ersten Platz, dicht gefolgt von Gemini 4 Carbon mit 10,9 %. Noch interessanter sind die Kosten: Die durchschnittlichen Kosten pro Aufgabe liegen bei Carbon nur bei rund 31,7 % der Kosten von Opus, während Carbon etwa 90,8 % von dessen Ergebnis erreicht.
Das ist kein Gerücht. Die Daten stammen aus der offiziellen GDPx-Bestenliste und dem Originalbericht von SemiAnalysis. Auf der offiziellen Website sind außerdem 14 repräsentative Aufgaben mit insgesamt 168 Ausführungsverläufen öffentlich einsehbar. Trotzdem lässt sich die Bestenliste leicht falsch interpretieren: Die „durchschnittlichen Kosten pro Aufgabe“ sind nicht der API-Preis, und „12 %“ ist nicht die Erfolgsquote von KI bei realen Arbeitsaufgaben.
Darum geht es: Dieser Artikel bereitet die Kosten- und Leistungsdaten der ersten GDPx-Bestenliste auf und unterscheidet drei Preisgrößen: GDPx-Evaluierungskosten, offizielle Token-Preise der Anbieter und die in der APIYI-Dokumentation angegebenen Preise. So wird deutlich, warum die Gesamtplatzierung und die tatsächliche Kaufentscheidung auseinanderfallen können.
GDPx: Das Wichtigste auf einen Blick
GDPx steht für „Measuring Frontier Model Capabilities Across the Most Valuable Domains“ – auf Deutsch etwa: „Messung der Fähigkeiten führender Modelle in wirtschaftlich besonders wertvollen Bereichen“. Der Benchmark prüft kein reines Faktenwissen, sondern ob ein Agent in echten oder realitätsnah simulierten professionellen Umgebungen mithilfe von Tools und Software eigenständig längerfristige Aufgaben erledigen kann.
| Information | Details |
|---|---|
| Veröffentlichung | 2026-11-02(v1.0) |
| Herausgeber | SemiAnalysis(Autoren: Max Kan、Andrew Megalaa、Dylan Patel) |
| Umfang | 11 Fachbereiche, 14 Datenpartner, 206 Aufgaben |
| Laufzeit | Standardmäßig maximal 8 Stunden pro Aufgabe, bei einigen Aufgaben weniger; jede Aufgabe wird 3-mal unabhängig ausgeführt, um pass@1 zu schätzen |
| Bewertung | Kombination aus binärer und kontinuierlicher Bewertung; alle 11 Bereiche werden gleich gewichtet |
| Ausführungsframework | Opus nutzt Claude Code, Astra Codex, Carbon Antigravity und die übrigen Modelle OpenCode |
| Geplante Updates | Offiziell ist alle 3 bis 6 Monate eine neue Version geplant |
Wichtig: GDPx misst die Gesamtleistung aus „Modell + Agent-Framework + Tools + Umgebung“ – nicht die reine Schlussfolgerungsfähigkeit des Modells. Die Gesamtpunktzahl basiert auf gleich gewichteten Bereichen und einer gemischten Bewertung. Sie lässt sich daher nicht in die Anzahl richtig gelöster Aufgaben von insgesamt 206 umrechnen.
GDPx-Rangliste: Punktzahl und durchschnittliche Kosten pro Aufgabe
Die folgende Tabelle zeigt die 13 Modelle, die auf der offiziellen Website standardmäßig angezeigt werden. Im Filter stehen insgesamt 20 Testkonfigurationen zur Auswahl. Die letzte Spalte gibt als Orientierung an, ob das jeweilige Modell in der öffentlichen Modelldokumentation von APIYI aufgeführt ist (Preisstand: 27.10.2026).
| Rang | Modell | GDPx-Gesamtergebnis | Durchschnittliche GDPx-Kosten (USD/Aufgabe) | APIYI-Dokumentation |
|---|---|---|---|---|
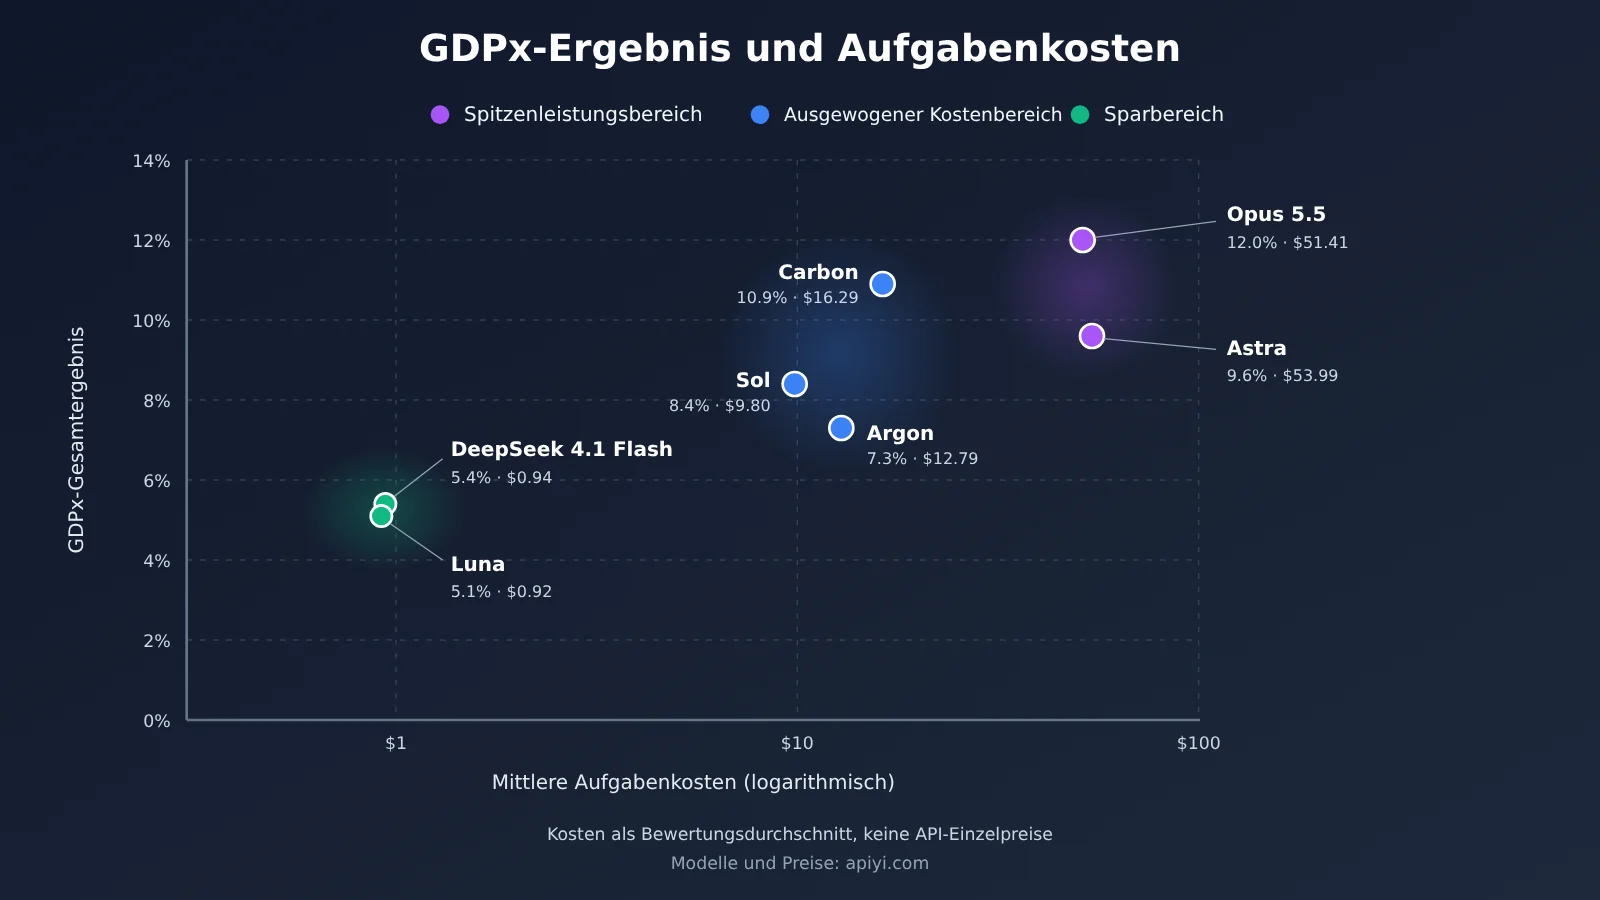
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | claude-opus-5-5 aufgeführt |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | Nicht aufgeführt (keine öffentliche API verfügbar) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | gpt-6-astra aufgeführt |
| 04 | Muse Wonder Full | 9.0% | Offiziell nicht veröffentlicht | In den Unterlagen nicht erfasst |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | In den Unterlagen nicht erfasst |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | gpt-6.1-sol aufgeführt |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | In den Unterlagen nicht erfasst |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | gemini-4-argon aufgeführt |
| 09 | Muse Wonder | 6.8% | $15.63 | In den Unterlagen nicht erfasst |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | Serie deepseek-v4.1-flash aufgeführt (Version selbst prüfen) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | gpt-6-luna aufgeführt |
| 12 | Grok 4.7 | 3.9% | $16.34 | In den Unterlagen nicht erfasst |
| 13 | GLM 5.3 | 2.7% | $11.79 | In den Unterlagen nicht erfasst |
Die Dollarbeträge entsprechen den von GDPx angegebenen durchschnittlichen Ausführungskosten pro Testaufgabe. Fehlgeschlagene Ausführungen werden ebenfalls berücksichtigt. Es handelt sich weder um den Preis pro Million Token noch um die Kosten pro Nutzeranfrage oder um die Kosten für die erfolgreiche Erledigung einer geschäftlichen Aufgabe.
Drei Kostenvergleiche bei GDPx, die sich lohnen
Aus den offiziellen Daten lassen sich drei typische Preis-Leistungs-Konstellationen ableiten:
| Vergleich | Ergebnis | Durchschnittliche Kosten pro Aufgabe | Berechnung |
|---|---|---|---|
| Opus 5.5 vs. Carbon | 12.0% vs. 10.9% | $51.41 vs. $16.29 | Carbon erzielt rund 90.8% des Ergebnisses von Opus bei etwa 31.7% der Kosten; Opus kostet rund das 3.16-Fache von Carbon |
| Astra vs. Sol | 9.6% vs. 8.4% | $53.99 vs. $9.80 | Sol erzielt rund 87.5% des Ergebnisses von Astra; Astra kostet rund das 5.51-Fache von Sol |
| DeepSeek 4.1 Flash vs. Luna | 5.4% vs. 5.1% | $0.94 vs. $0.92 | Die durchschnittlichen Kosten pro Aufgabe liegen bei beiden unter $1 |
Die drei Vergleiche stehen für unterschiedliche Prioritäten: Spitzenleistung, geringere Kosten bei ähnlichem Ergebnis und eine günstige Lösung für Aufgaben mit geringem Risiko. Ähnliche Gesamtergebnisse bedeuten allerdings nicht, dass die Modelle auch bei Ihren konkreten Aufgaben ähnlich abschneiden.
Platz eins im GDPx-Gesamtranking bedeutet nicht Platz eins in jedem Fachgebiet
Der ursprüngliche Bericht von SemiAnalysis zeigt, dass die Modelle in unterschiedlichen Bereichen führen:
- Claude Opus 5.5: führend im quantitativen Handel sowie im Hardware- und Chipdesign.
- Gemini 4 Carbon: führend in der Biologie und mit geringem Vorsprung auch im Software-Engineering.
- GPT-6 Astra: führend bei der rekursiven Selbstverbesserung (RSI) und in der Materialwissenschaft.
Die Forschenden weisen außerdem darauf hin, dass Sicherheitsklassifikatoren einige Ergebnisse von Opus 5.5 und GPT-6 Astra beeinflusst haben. Das betrifft vor allem die Bereiche Cybersicherheit, Biologie und KI-Alignment. Im Fall vt01 zum physischen Chipdesign erreichte Astra eine durchschnittliche Bewertung von 0.34, Opus dagegen nur 0.135. Bei einzelnen Aufgaben kann das Ergebnis also genau entgegengesetzt zum Gesamtranking ausfallen.
GDPx-Kosten und offizielle Token-Preise sind nicht dasselbe
Bei Diskussionen über das Preis-Leistungs-Verhältnis passiert häufig ein Fehler: Die GDPx-Kosten in Dollar pro Aufgabe werden mit den API-Preisen gleichgesetzt. Die folgende Tabelle zeigt die offiziell veröffentlichten Standardpreise der Anbieter für Text – in US-Dollar pro Million Token. Die theoretische Rechnung basiert auf 1 Million Eingabe- und 200.000 Ausgabe-Token, ohne Kosten für Caching und Tools.
| Modell | Eingabe | Ausgabe | Cache-Lesezugriff | Theoretische Rechnung (1 Mio. Eingabe + 200.000 Ausgabe) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | Geplanter Einführungspreis: $2 | Geplanter Einführungspreis: $10 | 95 % günstiger als die Standardeingabe | Bei Freigabe zum Einführungspreis etwa $4 |
Preisquellen sind die offiziellen Preisseiten von Anthropic und OpenAI sowie Googles Carbon-Ankündigung vom 28. Oktober 2026. Google kündigte ausserdem an, dass der Standardpreis für Carbon nach der Einführungsphase bei $4 für die Eingabe und $20 für die Ausgabe liegen wird. Ein Enddatum für die Einführungsphase wurde noch nicht genannt. Bei OpenAI können für Anfragen mit langem Kontext andere Preise gelten. Auch die Abrechnungsregeln für Cache-Schreibzugriffe, Stapelverarbeitung und andere Leistungen unterscheiden sich zwischen den Anbietern.
Die Tabelle zeigt nur die Unterschiede bei den Einzelpreisen. Für dieselbe Aufgabe können Modelle unterschiedlich viele Token und Aufrufrunden benötigen. Deshalb entspricht die Reihenfolge der tatsächlichen Rechnungen nicht unbedingt derjenigen der theoretischen Rechnungen. So fällt die theoretische Rechnung für Opus niedriger aus als für Astra, während die durchschnittlichen Aufgabenkosten im GDPx nahe beieinanderliegen ($51.41 gegenüber $53.99).
Die praktischen Einschränkungen von Gemini 4 Carbon
Carbon spielt auf dieser Rangliste die Hauptrolle beim Thema Preis-Leistungs-Verhältnis. Für die meisten Entwickler ist das Modell derzeit aber noch nicht direkt nutzbar. Bei der Vorstellung am 28. Oktober gab Google Carbon nur für ausgewählte Teams zur Abwehr von Cyberangriffen und geprüfte Partner frei. Der Zugang soll schrittweise erweitert werden. Bis zum 3. November war keine Ankündigung einer umfassenden Freigabe der öffentlichen API zu finden.
Auch im Preisüberblick der öffentlich zugänglichen Modelldokumentation von APIYI fehlt ein Eintrag für gemini-4-carbon. Ein am 29. Oktober veröffentlichter Artikel der Plattform hält ebenfalls fest, dass Carbon noch nicht über eine öffentliche API verfügbar ist. Derzeit eignet sich Carbon daher eher als „technologischer Wegweiser“ denn als sofort verfügbare Beschaffungsoption. Für die aktuelle Beobachtung bietet sich Gemini 4 Argon aus derselben Modellfamilie an: Es ist bereits nutzbar und erreicht im GDPx 7,3 % bei $12.79 pro Aufgabe.
Faktoren, die die Gesamtkosten von Agent-Aufgaben wie bei GDPx beeinflussen
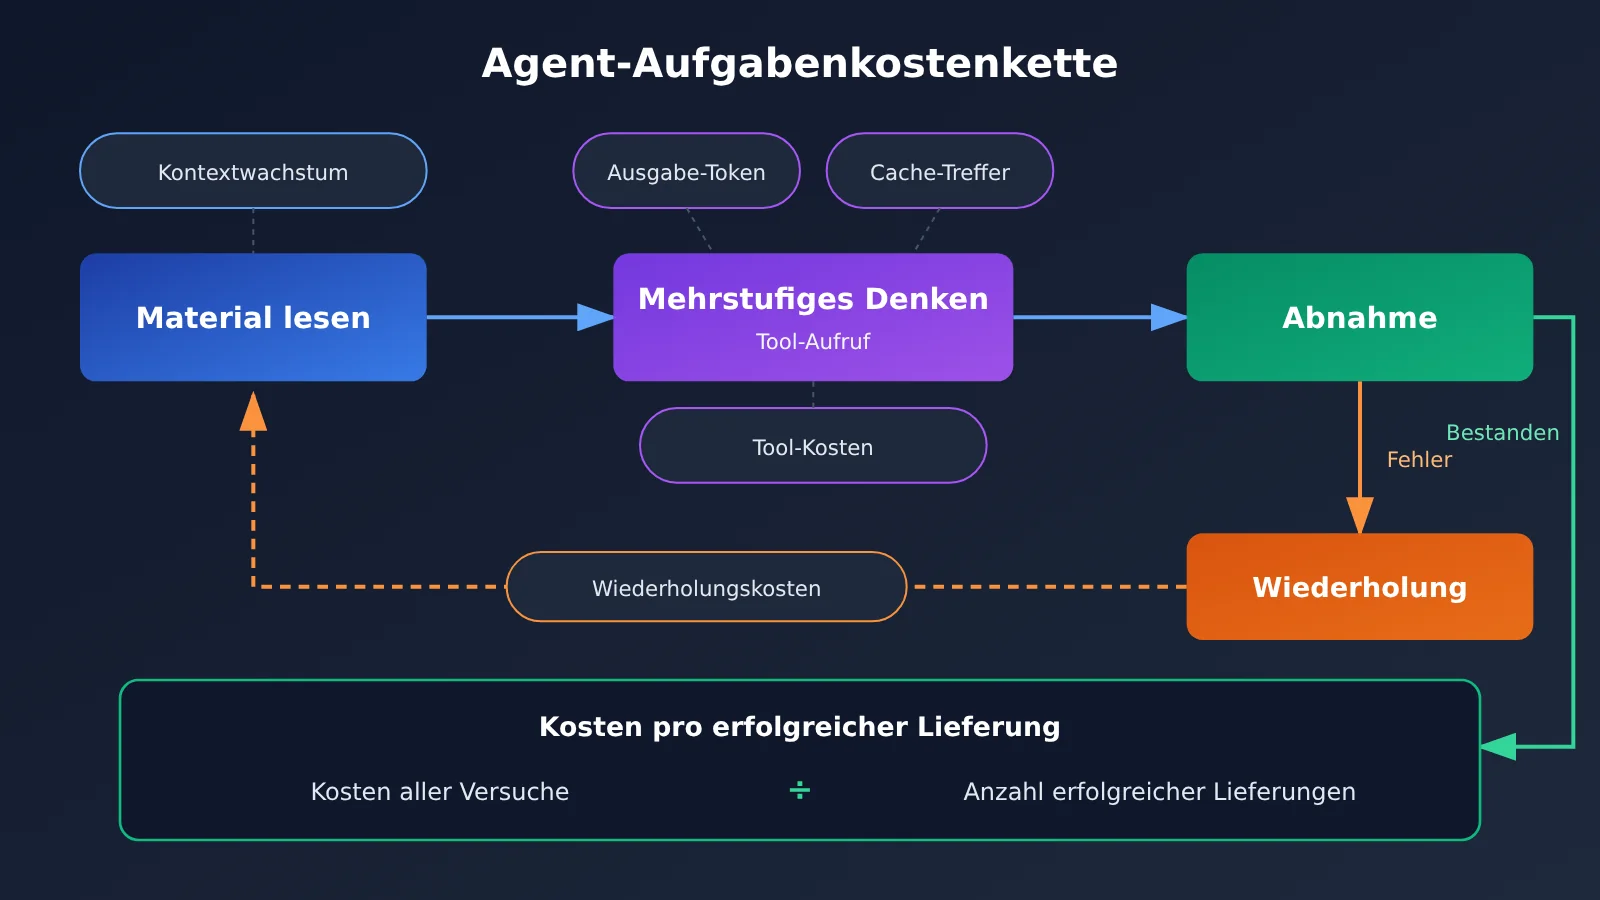
Bei lang laufenden Agent-Aufgaben lässt sich die Rechnung nicht einfach als „Einzelpreis × ein Aufruf“ berechnen. Die Gesamtkosten setzen sich aus mehreren Faktoren zusammen:
Gesamtkosten = Kosten für Eingabe-Token + Kosten für Ausgabe-Token + Cache-Kosten + Kosten für Tool-Aufrufe + Kosten für fehlgeschlagene Versuche und Wiederholungen + sonstige Betriebskosten
| Kostenfaktor | Auswirkung auf die Rechnung | Optimierungsansatz |
|---|---|---|
| Wachsender Kontext über mehrere Runden | Bei langen Aufgaben muss in späteren Runden immer wieder viel Kontext eingelesen werden | Verlauf komprimieren, in Abschnitten arbeiten |
| Cache-Treffer | Das Lesen aus dem Cache ist bei den Anbietern deutlich günstiger als die reguläre Eingabe | Systemanweisungen und Dokumentpräfixe gleich halten |
| Reasoning-Intensität und Ausgabelänge | Der Preis für Ausgabe-Token ist meist ein Mehrfaches des Eingabepreises | Reasoning-Stufe an die Schwierigkeit der Aufgabe anpassen |
| Tool-Aufrufe | Können zusätzliche Gebühren verursachen und die Zahl der Runden erhöhen | Zielloses Erkunden begrenzen |
| Fehlschläge und Wiederholungen | Auch fehlgeschlagene Durchläufe verbrauchen Token | Erfolgsquote erfassen und Kosten pro erfolgreicher Lieferung berechnen |
| Ausführungs-Framework | In GDPx kommen für verschiedene Modelle unterschiedliche Frameworks zum Einsatz | Tests im eigenen Framework durchführen |
Für Unternehmen ist folgende Kennzahl oft aussagekräftiger: Kosten pro erfolgreicher Lieferung = Kosten aller Versuche ÷ Anzahl erfolgreicher Lieferungen. Das ist ein Berechnungsvorschlag und keine offizielle GDPx-Statistik. Muss ein günstiges Modell mehrfach neu ansetzen, können die Kosten am Ende höher ausfallen. Liefert ein teures Modell dagegen zuverlässigere Ergebnisse, können die Kosten pro Geschäftsvorgang niedriger sein.
Kostenvergleich nach GDPx-Vorbild: Schnellstart
Die meisten der 206 Aufgaben von GDPx sind nicht öffentlich. Deshalb lässt sich die Rangliste nicht direkt reproduzieren. Praktischer ist es, echte Aufgaben aus dem eigenen Arbeitsalltag zu verwenden: Lassen Sie mehrere Kandidatenmodelle bei gleichen Eingaben und Abnahmekriterien jeweils mehrere Durchläufe absolvieren. Erfassen Sie dabei den Tokenverbrauch und ob die Ergebnisse die Abnahmekriterien erfüllen.
Minimalbeispiel
Der folgende Code ruft ein Modell über eine OpenAI-kompatible Schnittstelle auf und liest den Token-Verbrauch der Anfrage aus:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
Vollständige Implementierung anzeigen: mehrere Modelle und Durchläufe, Kosten pro erfolgreicher Lieferung berechnen
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Preis pro Einheit: US-Dollar pro Million Token, Stand der APIYI-Dokumentation: 2026-10-27
# Die tatsächliche Abrechnung ist in der Konsole einsehbar; Gruppen und Aufladerabatte können die Kosten beeinflussen
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # Fehlgeschlagene Versuche zählen ebenfalls zu den Kosten
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# Beispiel: Der Validator sollte nach Ihren eigenen Geschäftsanforderungen erstellt werden; dieser dient nur zur Veranschaulichung
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
Dieses Skript deckt nur Aufrufe mit einer einzelnen Gesprächsrunde ab. Bei echten Agent-Aufgaben sollten Sie auch die Token für Tool-Aufrufe und den Kontext über mehrere Runden hinweg addieren. Der Validator sollte sich zudem möglichst eng an den tatsächlichen Abnahmekriterien orientieren, statt nur nach Schlüsselwörtern zu suchen.
🚀 Tipp für den schnellen Einstieg: Beim Vergleich mehrerer Modelle ist es besonders aufwendig, für jeden Anbieter ein separates Konto anzulegen und verschiedene SDKs anzupassen. Über APIYI apiyi.com können Sie mit einem API-Schlüssel und einer OpenAI-kompatiblen Schnittstelle zwischen den oben aufgeführten Modellen wechseln. Neue Nutzer erhalten kostenloses Testguthaben – ideal für einen ersten Vergleich mit einer kleinen Stichprobe.
GDPx-Analyse: Was die Ergebnisse für Entwickler und Unternehmen bedeuten
Auswirkungen für Entwickler
- Nicht nur auf die Gesamtwertung schauen: Opus liegt insgesamt vorn, aber Carbon führt in Biologie und Softwareentwicklung, Astra in Materialwissenschaft und RSI. Bei einzelnen Aufgaben kann die Rangfolge also anders aussehen als in der Gesamtwertung.
- Die Kostenunterschiede können deutlich grösser sein als die Leistungsunterschiede: Zwischen Astra und Sol liegen nur 1,2 Prozentpunkte, die durchschnittlichen Kosten pro Aufgabe unterscheiden sich jedoch um etwa den Faktor 5,51. Ein gestaffeltes Routing ist daher einen Versuch wert.
- Auch das Framework spielt eine Rolle: Bei GDPx nutzten die Modelle jeweils ihre eigenen nativen Frameworks. Mit einem anderen Framework können sich sowohl die Ergebnisse als auch der Token-Verbrauch ändern.
Auswirkungen für Unternehmen
- Bei Aufgaben mit hohem Risiko zählt das Endergebnis: Finanz- und Rechtsaufgaben wurden strikt binär bewertet; alle Modelle erreichten 0 %. Im juristischen Fall erzielte Opus durchschnittlich 44 % der Teilpunkte, aber kein einziges Dokument erfüllte den Standard für eine brauchbare Abgabe.
- Eine erledigte Aufgabe ist nicht automatisch regelkonform erledigt: Bei 200 Ausführungen im Cybersicherheitstest wurde in 196 Fällen gegen mindestens eine Verhaltensregel verstossen. Dieser adversariale Stresstest lässt keine Rückschlüsse auf die Verstossrate im realen Einsatz zu, zeigt aber, dass Autorisierungsgrenzen gesondert geprüft werden müssen.
- Verfügbarkeit ist eine zwingende Voraussetzung: Selbst das beste Testergebnis hilft nicht bei der Einführung, wenn sich das Modell nicht erwerben lässt. Carbon ist dafür ein typisches Beispiel.
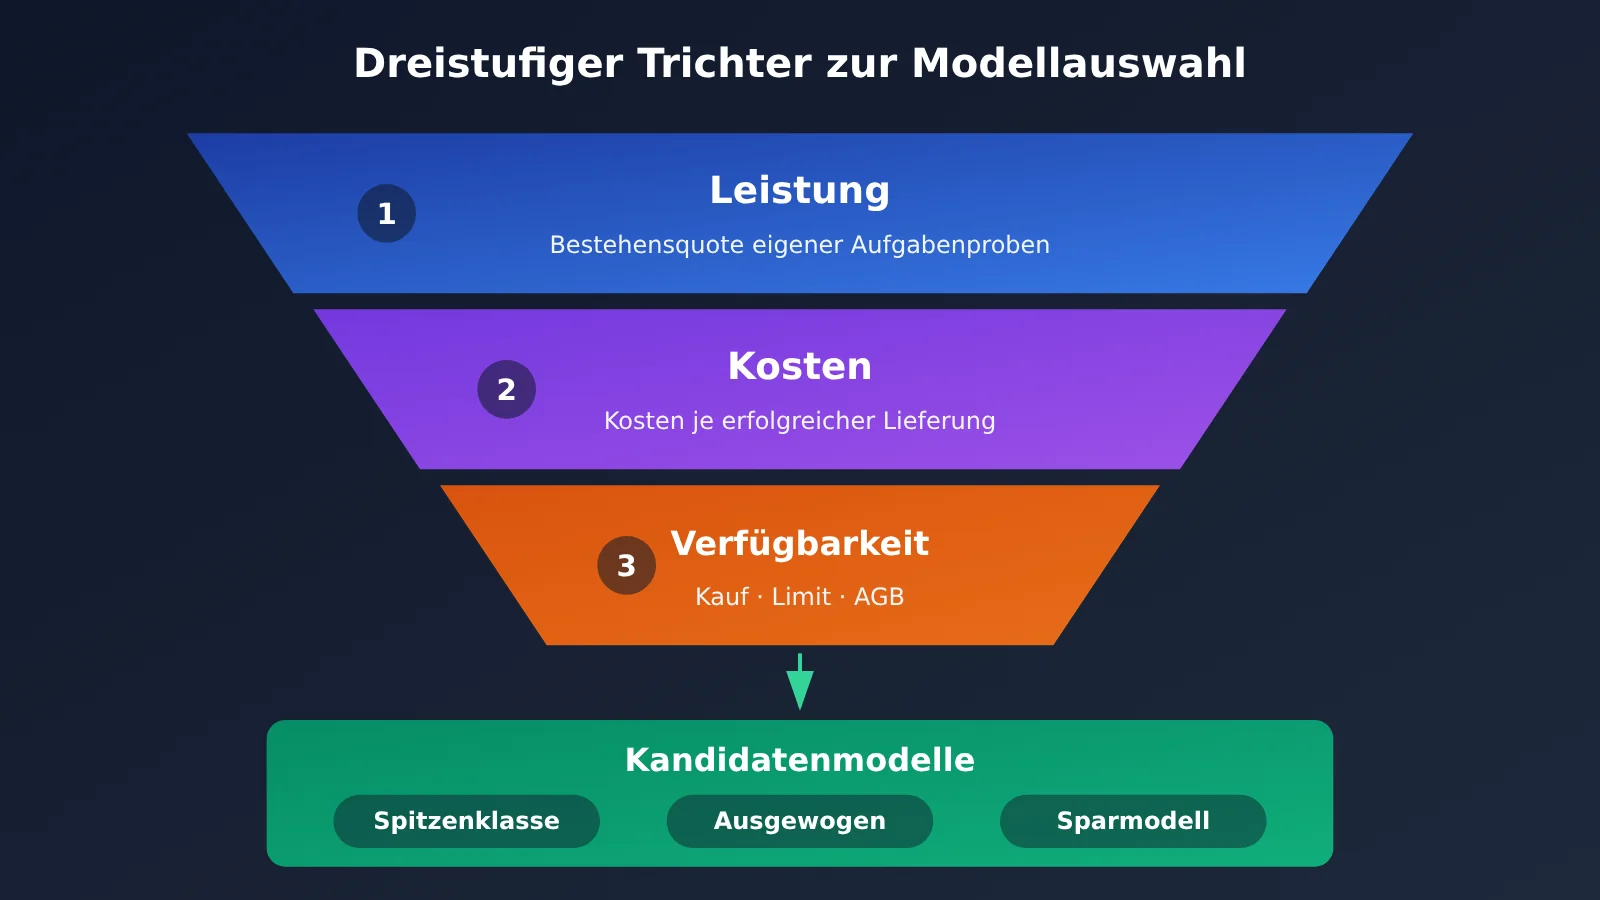
Daraus ergibt sich ein erster Rahmen für die Modellauswahl: Zuerst die Leistungsfähigkeit prüfen (Erfolgsquote bei eigenen Geschäftsaufgaben), dann die Kosten (Kosten pro akzeptabler Abgabe) und zuletzt die Verfügbarkeit (Kaufmöglichkeit, Ratenlimits und Datenbedingungen). Alle drei Faktoren sind unverzichtbar.
Häufig gestellte Fragen (FAQ)
F1: Bedeutet das GDPx-Ergebnis von 12 %, dass KI nur 12 % der Arbeit erledigen kann?
Nein. Die 12,0 % sind das Gesamtergebnis von Claude Opus 5.5 bei den anspruchsvollen Fachaufgaben der ersten GDPx-Ausgabe. Es wurde aus 11 gleich gewichteten Bereichen mit einer Mischung aus binärer und kontinuierlicher Bewertung berechnet. Der Wert ist weder die durchschnittliche Erfolgsquote von KI bei realer Arbeit noch lässt er sich in eine Anzahl korrekt gelöster Aufgaben umrechnen.
F2: Kostet jede Aufgabe mit Gemini 4 Carbon nur 16,29 US-Dollar?
Nein. Die 16,29 US-Dollar sind die von GDPx gemeldeten durchschnittlichen Ausführungskosten pro Bewertungsaufgabe. Sie hängen unter anderem vom Token-Verbrauch, der Anzahl der Aufrufrunden, den Werkzeugen und dem Ausführungsframework ab und entsprechen nicht den Preisen von Google. Der angekündigte Einführungspreis für Carbon beträgt 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token. Für Entwickler allgemein ist das Modell derzeit aber noch nicht vollständig verfügbar.
F3: Kann man Gemini 4 Carbon bereits über die API aufrufen?
Stand 03.11.2026 hat Google Carbon nur für ausgewählte Sicherheitspartner freigegeben. Ein Termin für die allgemeine Verfügbarkeit wurde noch nicht bekannt gegeben. Auch in der öffentlichen Modelldokumentation von APIYI apiyi.com gibt es keinen Eintrag für gemini-4-carbon. Vorerst lässt sich ein Bewertungsprozess mit bereits verfügbaren Modellen wie Gemini 4 Argon aufbauen. Sobald Carbon verfügbar ist, kann es in den Vergleich aufgenommen werden.
F4: Worin unterscheiden sich GDPx und OpenAIs GDPval?
GDPval wurde im September 2025 veröffentlicht, deckt 9 Branchen und 44 Berufe ab und konzentriert sich darauf, auf Grundlage vorgegebener Materialien in einem Durchgang ein Arbeitsergebnis zu erstellen. GDPx untersucht dagegen die Ausführung längerer Agentenabläufe in 11 wirtschaftlich bedeutenden Bereichen. Die Aufgaben haben standardmäßig eine maximale Laufzeit von 8 Stunden und legen Wert auf die Interaktion mit Werkzeugen und das Erkunden der Umgebung. Da sich Aufgabenschwierigkeit und Bewertungsmethoden unterscheiden, sind die Ergebnisse nicht direkt vergleichbar.
F5: Wie lassen sich die tatsächlichen Kosten mehrerer Modelle schnell vergleichen?
Am besten testen Sie eine kleine Stichprobe eigener Geschäftsaufgaben:
1. Registrieren Sie sich bei APIYI apiyi.com und erhalten Sie einen API-Schlüssel sowie kostenloses Testguthaben
2. Verwenden Sie den vollständigen Code aus diesem Artikel und setzen Sie `base_url` auf `https://api.apiyi.com/v1`
3. Führen Sie für jedes Modell mindestens 3 Durchläufe aus und dokumentieren Sie den Token-Verbrauch und die Abnahmeergebnisse
4. Berechnen Sie die Kosten pro abgenommenem Ergebnis und berücksichtigen Sie dabei auch die Echtzeit-Abrechnung in der Konsole
F6: Welche Grenzen hat GDPx selbst?
GDPx hat nur 14 repräsentative Aufgaben und 168 Ausführungsverläufe veröffentlicht; die übrigen Aufgaben bleiben nicht öffentlich. Bisher hat keine unabhängige Organisation die Rangliste vollständig reproduziert. Die Auswahl der Bereiche spiegelt die Einschätzung der Forschungseinrichtung wider. Forschende wie Ethan Mollick weisen zudem darauf hin, dass ein menschlicher Vergleichswert fehlt und eine binäre Bewertung von 0 % Unterschiede bei der teilweisen Aufgabenerfüllung verdecken kann. GDPx als wichtige Orientierung statt als Grundlage für eine Kaufentscheidung zu betrachten, ist daher der sicherere Ansatz.
GDPx: Die wichtigsten Erkenntnisse zum Preis-Leistungs-Verhältnis
- Rangliste: In GDPx v1.0 liegt Opus 5.5 mit 12,0 % vorn, gefolgt von Carbon mit 10,9 % und Astra mit 9,6 %.
- Kostenunterschied: Carbon erreicht rund 90,8 % des Opus-Ergebnisses, bei nur etwa 31,7 % der durchschnittlichen Kosten pro Aufgabe.
- Wichtige Abgrenzung: Der GDPx-Wert $/task ist der Durchschnitt der Evaluierungsläufe und entspricht nicht dem offiziellen Token-Preis.
- Unterschiede nach Fachgebiet: Platz eins in der Gesamtwertung bedeutet nicht Platz eins in jedem Bereich. Bei einzelnen Aufgaben kann sich das Verhältnis umkehren.
- Eingeschränkte Verfügbarkeit: Carbon ist noch nicht über eine allgemein zugängliche öffentliche API verfügbar und daher derzeit keine unmittelbar einsetzbare Option.
- Modellauswahl: Entscheidend sind die Kosten pro erfolgreich abgeschlossener Aufgabe. Für Vergleiche mit kleinen Stichproben lässt sich die einheitliche Schnittstelle von APIYI unter apiyi.com nutzen.
Fazit
Die erste GDPx-Rangliste zeigt deutliche Unterschiede beim Preis-Leistungs-Verhältnis führender KI-Modelle:
- Leistung: Claude Opus 5.5 liegt insgesamt vorn, doch die Stärken der Modelle unterscheiden sich je nach Fachgebiet. Bei risikoreichen Aufgaben sind sie von einer eigenständigen, verlässlichen Bearbeitung noch weit entfernt.
- Kosten: Die Vergleiche zwischen Carbon und Opus sowie zwischen Sol und Astra zeigen, dass ähnliche Ergebnisse mit einem mehrfachen Kostenunterschied einhergehen können.
- Verfügbarkeit: Carbon lässt sich derzeit noch nicht ohne Weiteres aufrufen. Auch das beste Evaluierungsergebnis hilft nur, wenn sich das Modell tatsächlich einsetzen lässt.
GDPx kann bei der Modellauswahl Orientierung geben, ersetzt aber keine Tests im eigenen Geschäftsalltag. Am besten wählen Sie einige Spitzenmodelle sowie ausgewogene und kostengünstige Modelle aus und testen sie über mehrere Runden mit echten Aufgaben und einheitlichen Abnahmekriterien. Vergleichen Sie anschließend die Kosten pro erfolgreich abgeschlossener Aufgabe. Für solche Tests mit mehreren Modellen empfiehlt sich APIYI unter apiyi.com: Dort reicht ein einziger API-Schlüssel. Die aktuellen Preise finden Sie in der Konsole.
📚 Quellen
- SemiAnalysis GDPx – Originalbericht: Benchmark-Methodik, Ergebnisse nach Fachgebiet und Fallstudien
- Link:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Hinweis: Enthält Analysen der führenden Modelle und Fehlermuster in den einzelnen Fachgebieten
-
Offizielle GDPx-Rangliste: Gesamtergebnisse und durchschnittliche Kosten pro Aufgabe
- Link:
gdpx.semianalysis.com -
Hinweis: Quelle der Ranglistendaten in diesem Artikel; Ausführungsverläufe finden sich auf der Seite
/rollouts -
Google Gemini 4 Carbon – Veröffentlichungsankündigung: Verfügbarkeit und geplante API-Preise
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
Hinweis: Einführungspreis, Standardpreis und Zugangsbeschränkungen für Carbon
-
OpenAI API-Preisseite: Offizielle Token-Preise der GPT-6-Serie
- Link:
developers.openai.com/api/docs/pricing -
Hinweis: Beachten Sie die Sonderpreise für Anfragen mit langem Kontext
-
APIYI – Modellpreisübersicht: Auf der Plattform gelistete Modelle und ihre Preise zum Stichtag
- Link:
docs.apiyi.com/models - Hinweis: Stand 2026-10-27; für die tatsächliche Abrechnung sind die Angaben in der Konsole maßgeblich
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die APIYI-Website. Weitere Informationen zur Modellintegration finden Sie im Dokumentationszentrum unter docs.apiyi.com.