Anmerkung des Autors: Dieser Artikel erklärt die zweistufige Router-Worker-Architektur von DeepSeek Super-agent, ihre Trennung von globaler Koordination und eigenständiger Ausführung und ihren Nutzen für eigene Agent-Systeme.
Wer vier oder fünf Coding-Agent-Fenster gleichzeitig offen hat, kennt ein ganz praktisches Problem: In einem Fenster wird ein Login-Bug behoben, in einem anderen eine Datenbankmigration geprüft und ein drittes wartet auf das CI-Ergebnis. Man muss im Kopf behalten, welches Fenster woran arbeitet, wer auf eine Antwort wartet und welche Aufgaben zusammenhängen. Die Modelle können zwar immer selbstständiger arbeiten, doch die Verwaltung dieser Sitzungen bleibt am Menschen hängen.
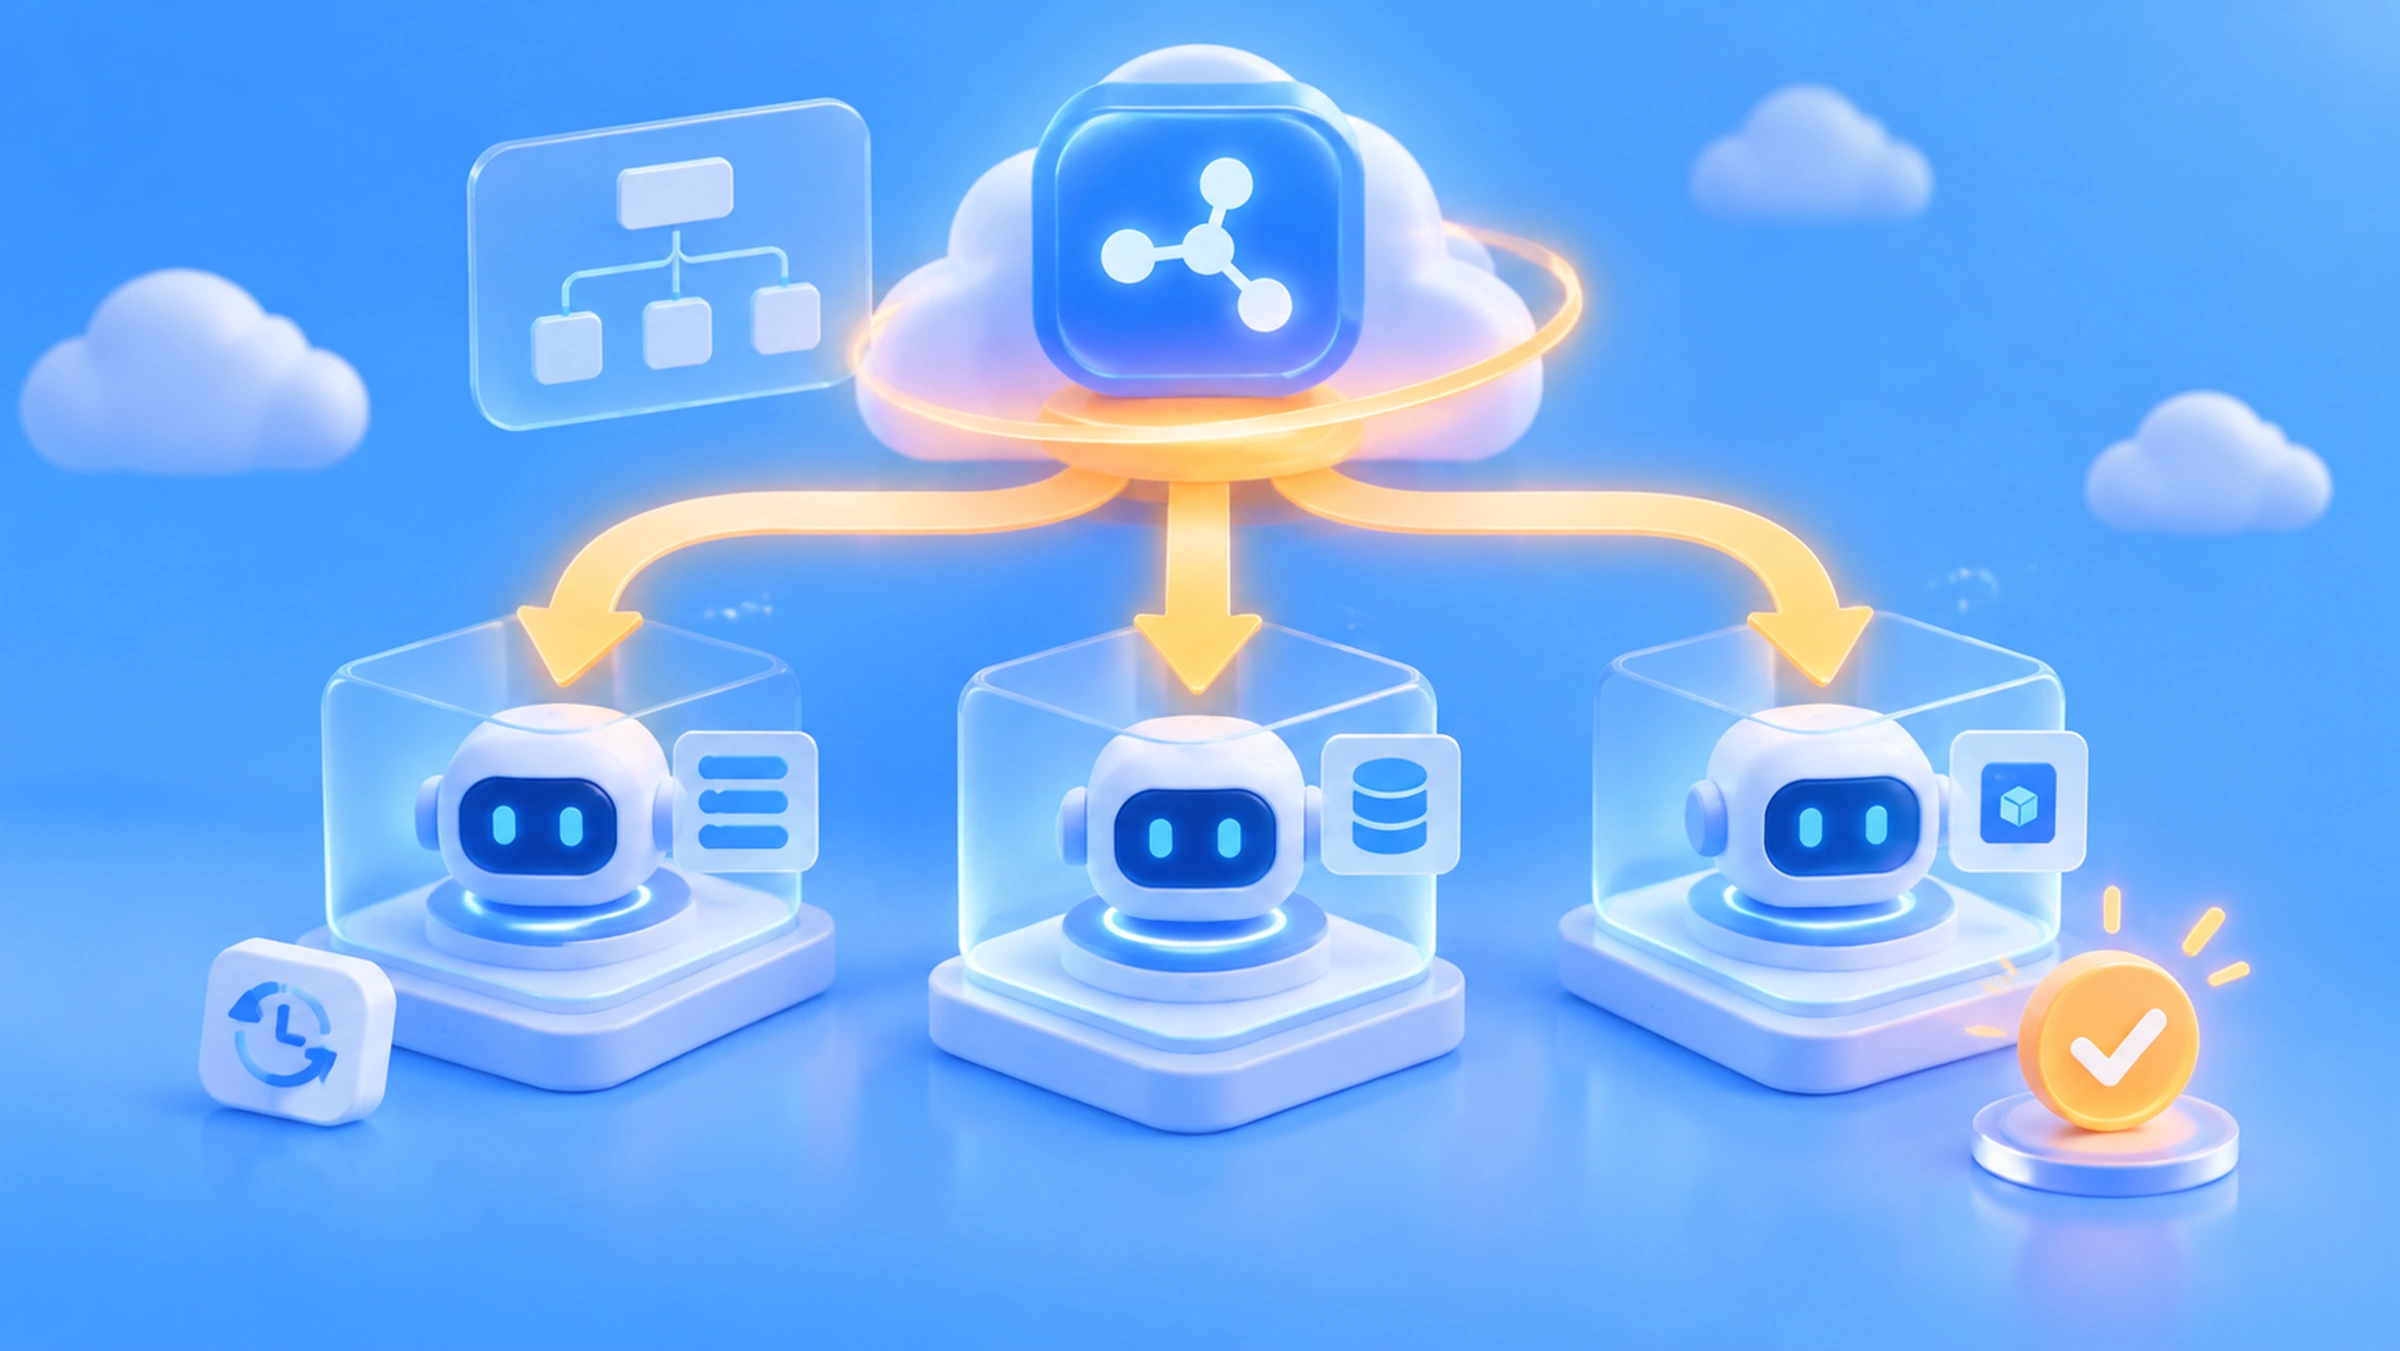
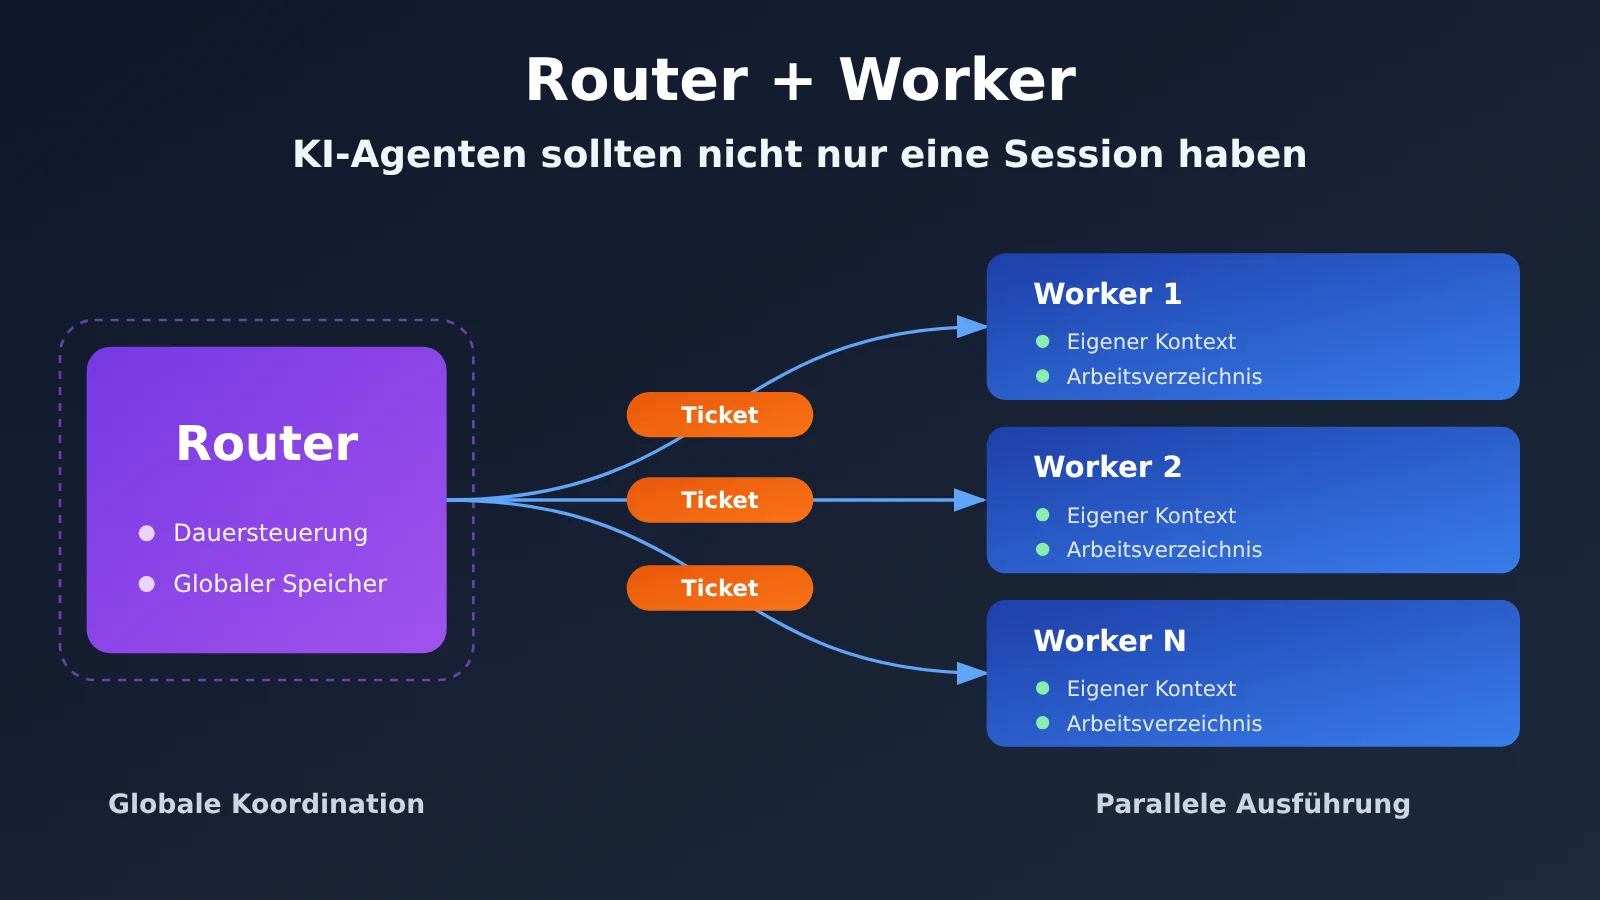
Am 31. Oktober 2026 veröffentlichte das DeepSeek-Harness-Team den Fachartikel „Super-agent-Design im Überblick: Auf dem Weg zu autonomeren Agent-Systemen“ und stellte zugleich den Forschungsprototyp dsh-superagent-prototype unter der MIT-Lizenz als Open Source bereit. Das zentrale Design ist eine zweistufige Router-Worker-Architektur: Ein dauerhaft aktiver Router übernimmt die globale Koordination, mehrere voneinander isolierte Worker führen die konkreten Aufgaben aus.
Dabei geht es nicht um den Trick, „eine KI mehr Dinge gleichzeitig erledigen zu lassen“. Der Super-agent trennt globale Koordination und eigenständige Ausführung auf Architekturebene, um Menschen die Verwaltung mehrerer Sitzungen abzunehmen. Dieser Artikel beleuchtet das Problem, die Mechanismen, die experimentellen Belege und den praktischen Nutzen: von den Designentscheidungen und offiziellen Versuchsdaten bis zu den Erkenntnissen für API-Aufrufe und Kostenmanagement.
Das nehmen Sie mit: Sie verstehen, welches Problem die zweistufige Router-Worker-Architektur tatsächlich löst, und können einschätzen, wann sich ein ähnliches Design für Ihr eigenes Agent-System lohnt.
Router + Worker: Das Wichtigste im Überblick
Bevor wir uns die Architektur ansehen, zunächst die wichtigsten Fakten zur Veröffentlichung. Wichtig ist: DeepSeek hat einen Forschungsprototyp als Open Source veröffentlicht – kein fertiges kommerzielles Produkt und auch kein neues Basismodell.
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 31. Oktober 2026 (technischer Artikel und GitHub-Repository wurden am selben Tag veröffentlicht) |
| Herausgeber | DeepSeek Harness Team |
| Projektname | dsh-superagent-prototype, hauptsächlich in TypeScript entwickelt, MIT-Lizenz |
| Einordnung | Forschungsprototyp, kein fertiges kommerzielles Produkt; benötigt DeepSeek Harness |
| Kernarchitektur | Zweistufige Struktur: Der Router übernimmt die globale Steuerung, Worker führen Aufgaben isoliert aus |
| Aktuell unterstützt | Überwachung eines einzelnen GitHub-Repositories, optionale Feishu-Anbindung, Ticketverwaltung, unabhängige Worker-Sitzungen und PR-Erstellung |
| Interesse aus der Community | Stand 2. November rund 8.900 Stars und 898 Forks (die Zahlen ändern sich laufend) |
DeepSeek nennt vier Eigenschaften als Ziele für den Super-Agent: Continuous (kanalübergreifend zusammenhängender Kontext), Productive (parallele Bearbeitung mehrerer Aufgaben), Proactive (eigenständige Reaktion auf Ereignisse innerhalb der erteilten Berechtigungen) und Persistent (dauerhaft online und nach bestimmten Fehlern wiederherstellbar). Das sind Designziele und bedeutet nicht, dass der Open-Source-Prototyp sie bereits vollständig erfüllt.
Warum ein KI-Agent nicht nur eine Session haben sollte
Das DeepSeek-Team sieht den Engpass bei KI-Programmierwerkzeugen zunehmend nicht mehr in der „Modellfähigkeit“, sondern in der „menschlichen Aufmerksamkeit“. Nach den täglichen Beobachtungen des Teams kann eine Person normalerweise nur etwa drei bis fünf aktive Agent-Sessions effektiv im Blick behalten. Das ist eine Einschätzung aus der Praxis, keine öffentliche Nutzerstatistik im großen Maßstab. Sie trifft aber das, was viele Entwickler erleben.
Das Dilemma: eine Session oder mehrere?
Die beiden üblichen Ansätze haben jeweils deutliche Schwächen. Router + Worker soll deshalb beides vereinen: einen durchgängigen globalen Kontext und die Fähigkeit, Aufgaben parallel im Hintergrund zu bearbeiten.
| Architektur | Vorteile | Kernproblem |
|---|---|---|
| Eine Session für alle Aufgaben | Der globale Kontext bleibt durchgängig erhalten | Aufgabeninformationen beeinflussen sich gegenseitig; lang laufende Tool-Aufrufe blockieren neue Aufgaben; auf einen einzelnen ReAct-Loop beschränkt |
| Eine eigene Session pro Aufgabe | Parallele Ausführung und voneinander isolierte Kontexte | Kein globales Gedächtnis; Menschen müssen sich die Zusammenhänge zwischen Aufgaben merken; Gespräche und Benachrichtigungen verteilen sich auf mehrere Fenster |
| Zweischichtige Router-Worker-Architektur | Zentraler globaler Zustand und isolierte Ausführungskontexte | Höherer Verbrauch an Inferenzressourcen; der Router kann zum Engpass werden |
Bei einer Session staut sich die Arbeit, bei mehreren verteilt sie sich auf viele Stellen. Im ersten Fall muss ein einziges Kontextfenster die Zwischenschritte aller Aufgaben aufnehmen. Im zweiten liegt die gesamte Koordination beim Menschen. DeepSeek führt deshalb auf Systemebene eine eigene Rolle ein, die den Überblick behält, während sich die ausführenden Agenten auf ihre Aufgaben konzentrieren.
So funktioniert die zweistufige Architektur aus Router und Worker
Router: die globale Steuerungsebene für die Koordination
Der Router ist eine dauerhaft laufende logische Ebene. In der aktuellen Architektur untersucht das Projektteam einen Ansatz, bei dem er hauptsächlich durch eine dauerhafte LLM-Session umgesetzt wird. Konzeptionell muss er aber nicht zwingend einer einzelnen Modellsitzung entsprechen. Seine Aufgabe ist vor allem das Koordinieren, nicht das Ausführen:
- Er nimmt Nutzernachrichten und externe Ereignisse etwa von GitHub, IM und CI zentral entgegen.
- Er verwaltet die Zuordnung von Aufgaben und entscheidet, ob eine neue Aufgabe angelegt werden muss.
- Er prüft Berechtigungen, weist Workern Aufgaben zu und koordiniert die Zusammenarbeit über Aufgabengrenzen hinweg.
- Er fasst Informationen für Menschen zusammen und ruft bei Bedarf den Kontext älterer Aufgaben ab.
Ein wichtiges Detail: Laut Projektteam kann der Router sogar ohne Bash-Tool auskommen. Wenn er komplexe Programmieraufgaben nicht selbst ausführt, wird er auch nicht durch lang laufende Tool-Aufrufe blockiert. Zudem brauchen seine Aufgaben häufig nicht das leistungsfähigste Reasoning-Modell. Für Interaktion und Aufgabenverteilung kann manchmal ein leichteres Modell ausreichen. Das liefert eine technische Grundlage dafür, verschiedene Rollen mit unterschiedlichen Modellen auszustatten.
Worker: die Aufgabenebene für die isolierte Ausführung
Worker erledigen die konkrete Arbeit. Im öffentlich verfügbaren Prototyp entspricht jedem Ticket eine Executor-Session; jedes Ticket hat ein eigenes Arbeitsverzeichnis. Im Rahmen seiner Berechtigungen ändert der Worker Code, führt Tests aus und bearbeitet nachträgliches Feedback. Anschliessend erstellt er einen Report. Ist eine menschliche Entscheidung nötig, setzt er den Status auf Attention. Die Ergebnisse werden über den ursprünglichen Kanal bereitgestellt, zum Beispiel über einen GitHub-PR.
Die Modellkontexte der einzelnen Worker sind voneinander getrennt. So geraten die Zwischenschritte mehrerer Aufgaben nicht im selben Kontextfenster durcheinander. Wichtig ist aber: Eine separate Session und ein separates Verzeichnis bedeuten keine starke Sicherheitsisolation. Laut der offiziellen Bereitstellungsdokumentation führen Worker Befehle standardmässig unter dem Betriebssystemkonto des Betreibers aus.
Wie ein GitHub-Issue den Router-Worker-Prozess durchläuft
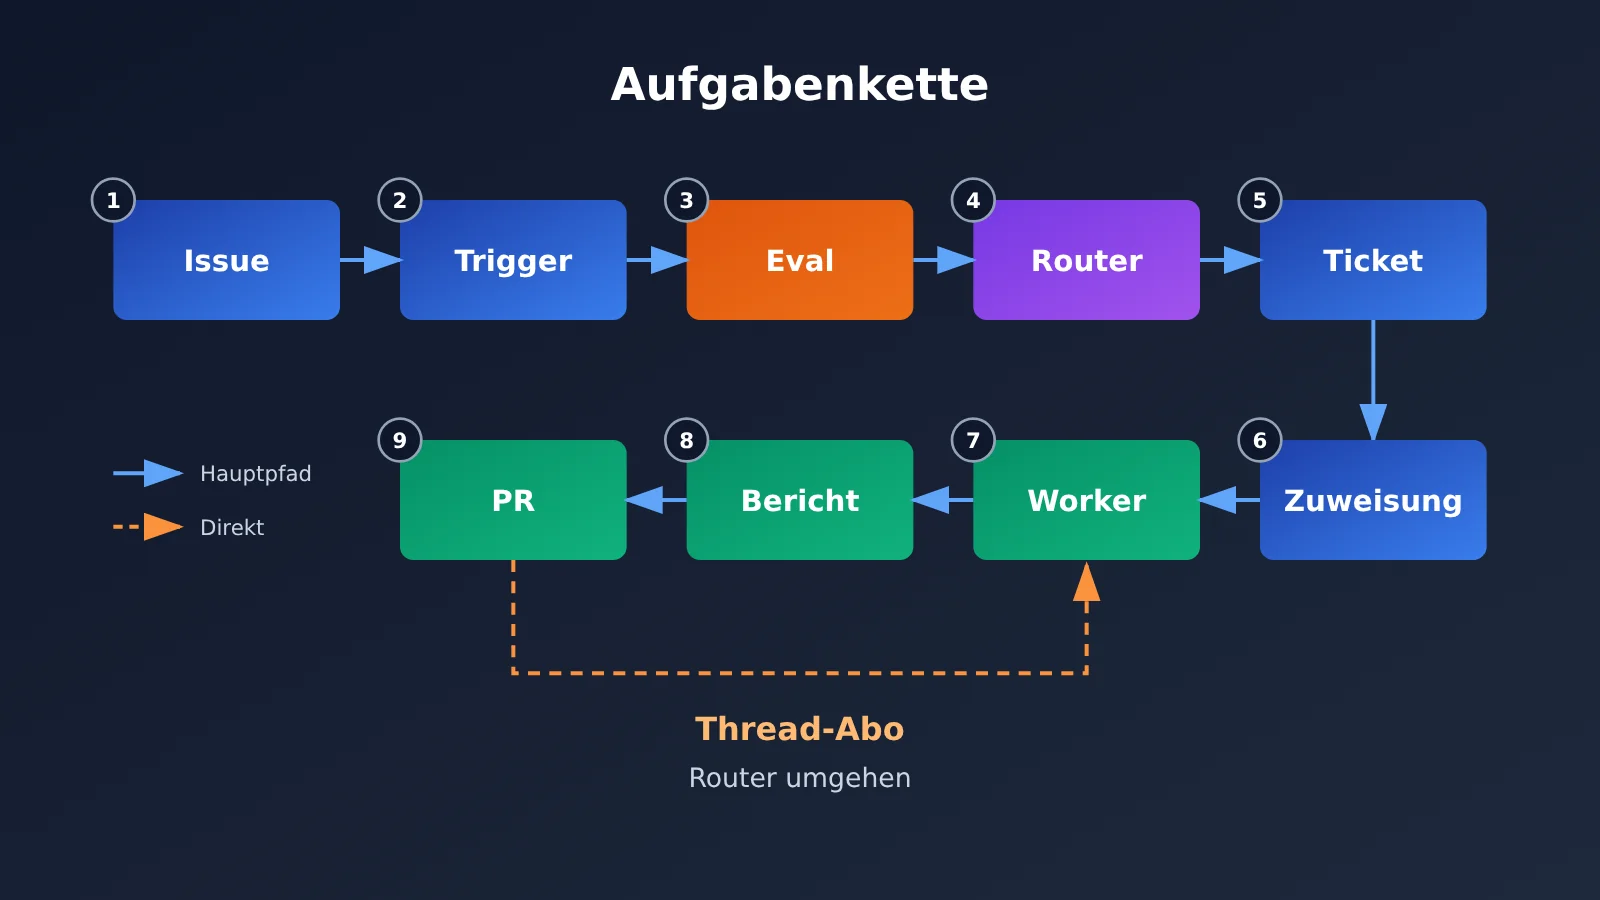
Anhand des Domain Models der Open-Source-Implementierung lässt sich die Aufgabenkette so zusammenfassen: Source → Trigger → Eval → Decision → Ticket → Assignment → Executor → Report. Als Beispiel dient eine berechtigte Person, die in einem GitHub-Issue um die Behebung eines Bugs bittet:
- Die GitHub-Source empfängt einen Issue-Kommentar und erzeugt einen Trigger.
- Das System prüft zunächst anhand deterministischer Regeln die Berechtigung. Danach beurteilt das Modell, ob die Anfrage die Regeln für die Annahme einer Aufgabe erfüllt.
- Der Router nimmt die Aufgabe an und erstellt ein Ticket, in dem Umfang und Berechtigung (Mandate) festgehalten werden.
- Das System erstellt für das Ticket ein Assignment und weist es dem zuständigen Worker zu.
- Der Executor führt die Korrektur in einem separaten Verzeichnis und einer eigenen Session aus.
- Der Worker meldet den Fortschritt oder liefert das Ergebnis und erstellt einen PR.
- Das System stellt dem Nutzer das Ergebnis über den ursprünglichen Issue- oder PR-Thread bereit.
Wenn der Nutzer anschliessend in diesem PR Änderungen anregt, kann die neue Nachricht automatisch der ursprünglichen Aufgabe zugeordnet werden. Er muss nicht mehr danach suchen, welche Agent-Session damals dafür zuständig war. So reduziert die zweistufige Architektur ganz konkret den Verwaltungsaufwand für Menschen.
Vier zentrale Designentscheidungen für Router und Worker
Die zweistufige Architektur bildet zunächst nur das Grundgerüst. Erst einige gezielte technische Entscheidungen machen sie praxistauglich. Jede davon löst ein konkretes Problem:
| Design | Technisches Problem | Funktionsprinzip |
|---|---|---|
| Direkte Thread-Zustellung | Alle Folgemeldungen laufen über den Router und belasten den zentralen Knoten | Worker abonnieren die Threads, für die sie zuständig sind, und erhalten zugehörige Ereignisse direkt |
| Router-Batching | Bei plötzlichen Ereignisspitzen begrenzt die Einzelverarbeitung den Durchsatz | Während der Inferenz aufgelaufene Trigger werden zu einem Batch zusammengefasst und gemeinsam analysiert |
| Inline & Spill | Das Kontextfenster ist begrenzt, und die vollständige Einbindung aller Inhalte ist teuer | Aktuell benötigte Informationen kommen ins Fenster; bei langen Inhalten bleiben nur Zusammenfassung und Leseverweis |
| Chain of Recall | Informationen zu früheren Aufgaben lassen sich schwer wiederfinden | Verknüpfungen zwischen Trigger, Thread, Ticket und Worker werden schrittweise zurückverfolgt |
Direkte Thread-Zustellung: weniger wiederholte Zuweisungen durch den Router
Angenommen, Worker A ist für einen PR zuständig. Dann können spätere Kommentare und CI-Ergebnisse anhand der Thread-Zuordnung direkt an Worker A gehen. Der Router muss nicht für jede zugehörige Nachricht erneut entscheiden. Das ist ein typisches Beispiel dafür, wie sich häufige Entscheidungen mit geringem Mehrwert vom zentralen Knoten auslagern lassen.
Für die direkte Zustellung gelten allerdings klare Berechtigungsgrenzen. Die offizielle Autorisierungsdokumentation hält fest: Abonnierte Nachrichten können Kontext liefern, dürfen aber das Mandat des ursprünglichen Tickets nicht erweitern. Verlangt ein späterer Kommentar neue Arbeit außerhalb des genehmigten Rahmens, sollte der Worker sie zur erneuten Bewertung an das System zurückgeben. Das ist wichtig, um unbefugte Anweisungen in externen Kommentaren abzuwehren.
Router-Batching: auf Ereignisspitzen reagieren
Während der Router eine Inferenzrunde durchführt, werden neu eintreffende Trigger zunächst gesammelt und in der nächsten Runde als Batch analysiert. Aus „einem Modellaufruf pro Nachricht“ wird so „mehrere Nachrichten pro Inferenzrunde“. Bei vielen Ereignissen verteilt sich der Inferenzaufwand dadurch auf mehrere Entscheidungen.
Inline & Spill und Chain of Recall: Kontext als Cache behandeln
DeepSeek betrachtet das Kontextfenster als eine Art Cache. Bei Inline werden Informationen, die voraussichtlich bald gebraucht werden, direkt in das Fenster aufgenommen – etwa die neuesten Kommentare zur aktuellen Aufgabe, relevante Codezeilen und der nötige umgebende Code. Bei Spill bleiben selten benötigte oder sehr lange Inhalte außerhalb des Fensters; erhalten bleiben nur eine Zusammenfassung, zugehörige IDs und ein Leseverweis. Ein Beispiel sind lange historische Diskussionen. Nicht relevante ältere Nachrichten müssen nicht jedes Mal eingebunden werden.
Darauf baut Chain of Recall auf: Das Modell kann den Objektverknüpfungen Trigger → Thread → Ticket → Worker folgen und historische Informationen bei Bedarf schrittweise abrufen. Das spart mehr Kontext, als jedes Mal den vollständigen Verlauf einzufügen, und ähnelt eher einer Datenbankabfrage über einen Index. Allerdings räumt auch DeepSeek ein, dass ein über Monate oder noch länger reichendes Gedächtnis weiterhin ein ungelöstes Problem ist.
Router + Worker: Einordnung der Versuchsdaten
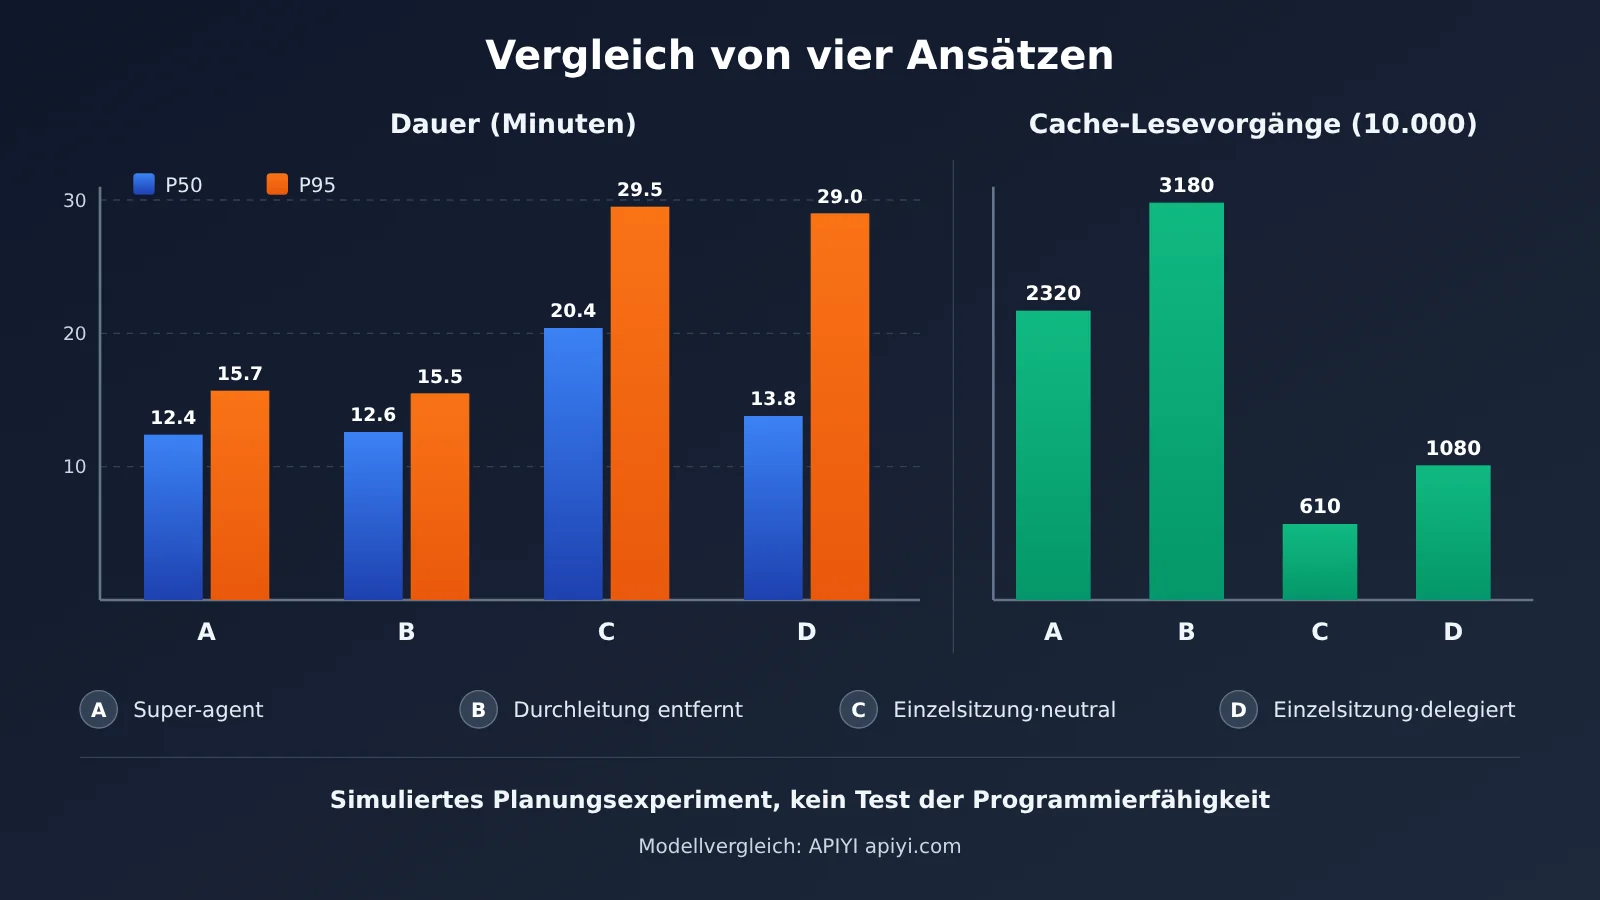
DeepSeek hat eine Reihe vorläufiger Experimente mit synthetischer Last durchgeführt. Jeder simulierte Durchlauf umfasste etwa 300 Nachrichten, davon rund 20 Arbeitsaufträge. Der Rest bestand aus Smalltalk, nachträglichem Feedback, Stornierungsanfragen und CI-Nachrichten. Jede Variante wurde fünfmal getestet. Die Programmierarbeit wurde durch zeitintensive simulierte Tools ersetzt. Die Daten messen daher die Leistung des Scheduling-Systems, nicht die Qualität der Codegenerierung.
End-to-End-Vergleich des Schedulings
| Variante | P50-Fertigstellungszeit | P95-Fertigstellungszeit | Aus dem Cache gelesene Token pro Versuch |
|---|---|---|---|
| Super-agent | 12,4 Minuten | 15,7 Minuten | ca. 23,2 Mio. |
| Super-agent, ohne Abonnement-Direktweiterleitung | 12,6 Minuten | 15,5 Minuten | ca. 31,8 Mio. |
| Einzelne Session + Subagent, neutrale Eingabeaufforderung | 20,4 Minuten | 29,5 Minuten | ca. 6,1 Mio. |
| Einzelne Session + Subagent, bevorzugte Delegation | 13,8 Minuten | 29,0 Minuten | ca. 10,8 Mio. |
Im Vergleich zur Einzelsitzungsvariante mit neutraler Eingabeaufforderung sinkt beim Super-agent die P50-Fertigstellungszeit um etwa 39 %, die P95-Zeit um etwa 47 %. Gegenüber der Einzelsitzungsvariante mit bevorzugter Delegation ist der P50-Vorteil zwar nur gering, die langsamsten Fälle sind beim P95 aber deutlich schneller abgeschlossen. Der grösste Nutzen der zweistufigen Architektur liegt also darin, dass sich die langsamsten Aufgaben nicht mehr so lange hinziehen.
Der Preis dafür ist ebenfalls klar: Der Super-agent liest etwa 3,8-mal so viele Token aus dem Cache wie die Einzelsitzungsvariante mit neutraler Eingabeaufforderung. Er nutzt mehr parallele Sitzungen und Inferenzressourcen, um kürzere und stabilere Fertigstellungszeiten zu erreichen. Das bedeutet aber nicht, dass die Gesamtkosten um das 3,8-Fache steigen. Die tatsächlichen Kosten hängen auch von den Modellpreisen, Cache-Treffern, regulären Eingabe- und Ausgabe-Token, der Modellwahl für Router und Worker sowie den Tool-Aufrufen ab. DeepSeek hat bislang auch keine durchschnittlichen API-Kosten für reale Arbeitsaufträge veröffentlicht.
Auch der Ablationstest zur Abonnement-Direktweiterleitung ist einen genaueren Blick wert. Ohne diese Funktion muss der Router etwa 30 % mehr Entscheidungen treffen, und die Zahl der aus dem Cache gelesenen Token steigt um rund 37 %. Die Fertigstellungszeit bleibt jedoch fast unverändert. Das Fazit: Die Abonnement-Direktweiterleitung spart in diesem Test vor allem Modellaufrufe und Kontextaufwand beim Router, statt die Bearbeitung direkt zu beschleunigen.
Belastungstest der Router-Batchverarbeitung
In dieser Testreihe verwendet der Router ein echtes Modell, der Worker ein simuliertes Modell:
| Kennzahl | Niedrige Ereignisdichte | Hohe Ereignisdichte |
|---|---|---|
| Eingehende Ereignisse | ca. 1 pro Minute | ca. 40 pro Minute |
| Durchschnittliche Batchgröße | 1,0 | 2,8 |
| Dauer einer einzelnen Modellanfrage | 2,5 Sekunden | 3,9 Sekunden |
| Anteilige Inferenzzeit pro Entscheidung | 6,4 Sekunden | 1,6 Sekunden |
Bei höherer Ereignisdichte dauerte eine einzelne Anfrage länger. Gleichzeitig sank aber die anteilige Inferenzzeit pro Entscheidung – die Batchverarbeitung steigerte also den effektiven Durchsatz. Das offizielle Fazit fällt zurückhaltend aus: Bei der aktuellen Teamgröße reicht ein einzelner Router vorerst aus. Daraus lässt sich aber nicht schließen, dass ein Router unbegrenzt Nachrichten verarbeiten kann.
Was Router und Worker für Entwickler bedeuten
Modellabstufung: Ein leichtgewichtiges Modell für den Router, passende Modelle für die Worker
Die wichtigste technische Erkenntnis aus der zweistufigen Architektur: Nicht jede Rolle braucht dasselbe Modell. Der Router übernimmt vor allem Klassifizierung, Zuweisung und Zusammenfassung. Dafür eignet sich ein schnelles, kostengünstiges Modell. Für die Worker lässt sich je nach Komplexität der Aufgabe ein Modell mit stärkerer Reasoning-Fähigkeit wählen. Der Prototyp unterstützt es, für Router und Worker jeweils eigene Modellanbieter und Modelle festzulegen.
Das folgende Minimalbeispiel zeigt, wie der Router über eine OpenAI-kompatible Schnittstelle über die Zuweisung entscheidet:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 切换多家模型
)

ROUTER_MODEL = "your-fast-cheap-model"   # 替换为控制台中可用的轻量模型名

resp = client.chat.completions.create(
    model=ROUTER_MODEL,
    messages=[{"role": "user", "content": "判断这条 Issue 评论是否需要新建 Ticket:修复登录页 500 错误"}]
)
print(resp.choices[0].message.content)
Beispielcode für den abgestuften Aufruf von Router und Workern anzeigen
import json
import openai
from typing import Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 角色与模型分层:模型名请替换为你实际可用的模型
ROLE_MODELS: Dict[str, str] = {
    "router": "your-fast-cheap-model",
    "worker_simple": "your-mid-tier-model",
    "worker_complex": "your-strong-reasoning-model",
}

usage_log = []  # 按 Ticket 记录 Token 消耗

def call(role: str, ticket_id: str, prompt: str) -> str:
    resp = client.chat.completions.create(
        model=ROLE_MODELS[role],
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    usage_log.append({
        "ticket": ticket_id, "role": role,
        "input": u.prompt_tokens, "output": u.completion_tokens,
    })
    return resp.choices[0].message.content

def router_dispatch(ticket_id: str, event: str) -> str:
    prompt = (
        "你是任务调度器,只做分类,不执行任务。"
        "输出 JSON:{\"accept\": bool, \"complexity\": \"simple\"|\"complex\"}\n"
        f"事件:{event}"
    )
    decision = json.loads(call("router", ticket_id, prompt))
    if not decision["accept"]:
        return "ignored"
    role = "worker_complex" if decision["complexity"] == "complex" else "worker_simple"
    return call(role, ticket_id, f"在授权范围内处理任务:{event}")

print(router_dispatch("T-001", "CI 失败:单元测试 test_login 超时"))
print(usage_log)
🎯 Technischer Tipp: Testen Sie beim Aufbau einer abgestuften Agent-Architektur zunächst über APIYI auf apiyi.com mit demselben API-Schlüssel, wie sich leichtgewichtige Modelle und Modelle mit starken Reasoning-Fähigkeiten in den Rollen Router und Worker bewähren. Entscheiden Sie erst danach über die endgültige Konfiguration, statt für alle Rollen das teuerste Modell einzusetzen.
Kostenkontrolle: nach Ticket abrechnen statt nur auf die Gesamtkosten zu schauen
Die offiziellen Experimente zeigen, dass die zweistufige Architektur mehr Rechenressourcen für die Inferenz verbraucht. Deshalb braucht es eine genauere Kostenkontrolle. Praktisch sind unter anderem diese Maßnahmen:
- Token pro Ticket erfassen: Den Aufwand für Router-Entscheidungen und die Ausführung durch Worker getrennt erfassen, um die teuersten Aufgabentypen zu erkennen;
- Kostenarten unterscheiden: Modellkosten, Tool-Kosten, etwa für Suche und Webseitenabrufe, sowie Kosten für die Ausführungsumgebung separat erfassen;
- Cache-Treffer im Blick behalten: Der größte Teil des Token-Verbrauchs beim Super-Agent entfällt auf Cache-Lesezugriffe. Der Preis pro Token kann sich bei einem Cache-Treffer und einem Cache-Miss stark unterscheiden – laut offizieller DeepSeek-Preisliste um ein Vielfaches;
- Unnötige Entscheidungen vermeiden: Nach dem Prinzip der direkten Ereigniszustellung gelangen Folgeereignisse unmittelbar an den zuständigen Worker. So entfallen wiederholte Zuweisungen durch den Router.
💰 Kostenoptimierung: Wenn mehrere Worker parallel arbeiten, kann sich die Zahl der Aufrufe vervielfachen. Über APIYI apiyi.com lassen sich Modelle verschiedener Anbieter nutzungsbasiert aufrufen. Auf einer gemeinsamen Rechnung können Sie die tatsächlichen Kosten verschiedener Rollen und Modelle vergleichen und so gezielter optimieren.
Wann sich Router + Worker lohnt
Eine zweistufige Architektur ist nicht automatisch besser, nur weil sie komplexer ist. Die folgenden Kriterien helfen bei der Entscheidung:
- Geeignet: Es gibt mehrere voneinander unabhängige Aufgaben, etwa Ticket A für einen Bugfix, Ticket B für die Prüfung einer Migration und Ticket C für CI. Gleichzeitig kommen Ereignisse über mehrere Kanäle herein und erfordern eine laufende Reaktion;
- Kann warten: Es gibt nur wenige Aufgaben, sie sind stark voneinander abhängig oder drehen sich hauptsächlich um die Arbeitsteilung bei einer einzelnen komplexen Aufgabe. Dann verbraucht ein einzelner Agent oder ein herkömmliches Agent-Team weniger Ressourcen;
- Zuerst Infrastruktur schaffen: Wenn Berechtigungstrennung, der Umgang mit Konflikten bei Dateiänderungen oder aufgabenbezogene Kostenprotokolle noch fehlen, kann vorschnelle Parallelisierung die Risiken sogar vergrößern.
Außerdem setzen Router + Worker und ein gewöhnliches Agent-Team unterschiedliche Schwerpunkte. Ein gewöhnliches Agent-Team teilt eine komplexe Aufgabe oft auf Rollen wie Recherche, Programmierung und Tests auf. Der Router eines Super-Agents konzentriert sich dagegen auf die Koordination mehrerer unabhängiger Aufgaben, ohne sich in die technischen Details jeder einzelnen zu vertiefen. Laut offizieller Darstellung kann eine ähnliche Struktur auch entstehen, wenn die Hauptsitzung eines gewöhnlichen Agent-Teams ausschließlich die zentrale Kommunikation und die aufgabenübergreifende Zuweisung übernimmt. Die zweistufige Architektur ist also kein Konzept, das ausschließlich DeepSeek vorbehalten ist.
Grenzen der Router-Worker-Architektur und des Prototyps
Bei Architekturanalysen wie dieser passiert leicht ein Fehler: Man hält den vollständigen Entwurf aus einem Designartikel für den aktuellen Funktionsumfang des Open-Source-Prototyps. Die Quellen unterscheiden hier klar:
- Im Prototyp unterstützt: Überwachung eines einzelnen GitHub-Repositories, optionale Feishu-Anbindung, Ticketverwaltung, separate Worker-Sitzungen und -Verzeichnisse, Erstellung von PRs, Anzeige von Aufgaben zur manuellen Bearbeitung im Dashboard sowie Fortsetzung der Arbeit anhand späterer Nachrichten;
- Geplant, aber nicht nachweislich vollständig umgesetzt: automatische Verwaltung mehrerer Repositories, produktionsreifer Dauerbetrieb in der Cloud und geräteübergreifende Umgebungen sowie vollständige autonome Fehlerbehebung durch einen unabhängigen Watchdog; die asynchrone ReAct Loop ist im Harness implementiert, aber noch nicht standardmäßig aktiviert;
- Proaktivität mit Grenzen: Abgeleitete Aufgaben verwenden standardmäßig den Modus
observe: Sie werden nur protokolliert, nicht ausgeführt. Das automatische Zusammenführen von PRs ist standardmäßig deaktiviert.
Auf Architekturebene gibt es weiterhin einige öffentlich eingeräumte Herausforderungen. Die erste ist die Skalierung eines einzelnen Routers: Laut Projektteam reicht er für die aktuelle Teamgröße aus. Wie sich die Last bei größerem Umfang aufteilen lässt, ist noch offen. Die zweite ist das Langzeitgedächtnis: Inline & Spill und der Kettenabruf decken kurzfristigen und mittelfristigen Kontext ab, eine monatsübergreifende Erinnerung ist aber noch nicht gelöst. Die dritte betrifft Berechtigungsgrenzen: Router und Worker laufen standardmäßig im Modus danger-full-access und führen Aktionen unter dem Systemkonto des Betreibers aus. Das Projektteam empfiehlt daher ein separates Systemkonto. Auch Prompt Injection über externe Kommentare und die Verwaltung von Zugangsdaten stehen auf der Liste offener Probleme. In der Community erschien zudem ein Prüfbericht eines Drittanbieters zum Quellcode eines bestimmten Commits. Da der vollständige Angriffsablauf nicht unabhängig reproduziert wurde, lässt sich der Befund nur als potenzielles Risiko einordnen.
Praxistests aus der Community bestätigen ebenfalls den Prototyp-Charakter: Ein Nutzer konnte nach einem frischen Klon anhand der SETUP.md den gesamten Ablauf vom Issue bis zum PR erfolgreich durchlaufen. Gleichzeitig meldete er Probleme bei der Prozesserkennung unter Node.js 24, durch verzögerte GitHub-Benachrichtigungen verpasste Nachrichten und fehlgeschlagene Test-Assertions bei chinesischer Systemsprache.
Häufig gestellte Fragen (FAQ)
Q1: Was ist die zweistufige Router-Worker-Architektur?
Sie bildet die Grundlage des DeepSeek Super-agent: Der Router ist die dauerhaft aktive globale Koordinationsebene. Er nimmt Ereignisse entgegen, verwaltet die Zuordnung zu Aufgaben und verteilt die Arbeit. Die Worker bilden die isolierte Ausführungsebene: Jedes Ticket wird in einer eigenen Session und einem eigenen Verzeichnis bearbeitet. Der Kern ist die Trennung von globaler Koordination und unabhängiger Ausführung.
Q2: Wie unterscheidet sich Router + Worker von einem gewöhnlichen Multi-Agent-Team?
Ein gewöhnliches Agent-Team verteilt eine komplexe Aufgabe meist auf Rollen wie Recherche, Programmierung und Tests. Router + Worker legt dagegen mehr Wert auf die Koordination mehrerer voneinander unabhängiger Aufgaben. Der Router greift dabei nicht in deren Details ein. Wenn die Hauptsitzung eines gewöhnlichen Teams nur die zentrale Interaktion und die Verteilung zwischen Aufgaben übernimmt, kann ebenfalls eine ähnliche zweistufige Struktur entstehen.
Q3: Beweist das offizielle Experiment, dass Super-agent die Programmiereffizienz um 47 % steigert?
Nein. Das Experiment verwendete simulierte Programmierwerkzeuge und führte jede Variante nur fünfmal aus. Gemessen wurde die Zeit bis zum Abschluss der Aufgabenplanung, nicht die Codequalität oder Programmierfähigkeit. Der um etwa 47 % niedrigere P95-Wert zeigt lediglich, dass unter dieser synthetischen Last weniger extreme Verzögerungen bei der Aufgabenplanung auftraten. Daraus lässt sich weder eine Steigerung der tatsächlichen Programmiereffizienz ableiten noch die Programmierfähigkeit mit Claude Code oder Codex vergleichen.
Q4: Ist Router + Worker günstiger?
Nicht unbedingt. Im offiziellen synthetischen Experiment lag das Cache-Lesevolumen von Super-agent etwa 3,8-mal so hoch wie bei der neutralen Einzelsitzungsvariante. Geschwindigkeit und Stabilität wurden also mit einem höheren Ressourcenverbrauch erkauft. Sparpotenzial bietet die Abstufung der Modelle: Der Router nutzt ein leichtgewichtiges Modell, während für die Worker je nach Komplexität ein passendes Modell gewählt wird. Über APIYI apiyi.com lassen sich die tatsächlichen Kosten verschiedener Modellkombinationen mit einer einheitlichen Schnittstelle testen und gegeneinander abwägen.
Q5: Wie lässt sich die Modellabstufung für Router + Worker schnell im eigenen Projekt testen?
Wir empfehlen folgende Schritte:
1. Bei APIYI apiyi.com ein Konto registrieren und einen API-Schlüssel sowie kostenloses Testguthaben erhalten;
2. Den Code aus diesem Artikel verwenden und `base_url` auf `https://api.apiyi.com/v1` setzen;
3. Für Router und Worker unterschiedliche Modelle konfigurieren, den Token-Verbrauch pro Ticket erfassen und die Ergebnisse vergleichen.
Dank der OpenAI-kompatiblen Schnittstelle muss für einen Modellwechsel nur der Parameter `model` geändert werden.
Q6: Kann der Open-Source-Prototyp direkt in einer Unternehmensproduktionsumgebung eingesetzt werden?
Davon ist derzeit abzuraten. Es handelt sich um einen Forschungsprototyp: Worker laufen standardmässig mit den weitreichenden Rechten des ausführenden Nutzers, GitHub Enterprise Server wird nicht unterstützt, und die Community hat unter anderem fehlende Benachrichtigungen sowie potenzielle Sicherheitsprobleme gemeldet. Besser eignet sich der Prototyp, um das Workflow-Design in einer isolierten Umgebung zu testen.
Router + Worker: Das Wichtigste auf einen Blick
- Grundidee: Ein Super-Agent ist eine Systemarchitektur oberhalb der Modelle. Open Source ist ein Forschungsprototyp, kein kommerzielles Produkt;
- Das eigentliche Problem: Der Engpass verlagert sich von den Modellfähigkeiten zur menschlichen Aufmerksamkeit. Eine einzelne Session führt zu Staus, mehrere Sessions erschweren den Überblick;
- Getrennte Aufgaben: Der Router übernimmt nur die globale Koordination und kommt sogar ohne Bash aus. Worker führen Aufgaben unabhängig in isolierten Sessions aus;
- Zentrale Mechanismen: Subscription-Passthrough entlastet den Router bei Entscheidungen, Batch-Verarbeitung verteilt den Inferenzaufwand, und Inline & Spill behandelt den Kontext als Cache;
- Grenzen der Daten: Die Scheduling-Experimente zeigen kürzere Abschlusszeiten im Long Tail, aber einen höheren Token-Verbrauch. Sie sagen nichts über die Programmierfähigkeit aus;
- Einstieg: Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich unterschiedliche Modelle für die einzelnen Rollen konfigurieren und Kosten pro Ticket verwalten.
Fazit
DeepSeek beantwortet mit Router + Worker die Frage, warum ein KI-Agent nicht nur eine einzige Session haben sollte:
- Architekturwert: Globale Koordination und unabhängige Ausführung werden getrennt. So merkt sich das System die Zusammenhänge zwischen Aufgaben – statt sie dem Menschen zu überlassen;
- Technisches Design: Subscription-Passthrough, Batch-Verarbeitung, Inline & Spill und verketteter Abruf adressieren jeweils die zentrale Auslastung, kurzfristige Lastspitzen, die Kontextkapazität und den Abruf früherer Informationen;
- Nüchtern betrachtet: Die Experimente zeigen den Zielkonflikt zwischen Scheduling-Effizienz und Ressourcenverbrauch. Die Skalierung eines einzelnen Routers, Langzeitgedächtnis und Berechtigungsisolierung bleiben offene Fragen.
Wenn dein System bereits mehrere unabhängige Aufgaben gleichzeitig bearbeiten muss, lohnt sich ein Blick auf die zweistufige Architektur. Bei wenigen, eng zusammenhängenden Aufgaben ist ein einzelner Agent weiterhin die wirtschaftlichere Wahl. Unabhängig von der Architektur sind die Abstufung der Modelle und die Kostenerfassung pro Aufgabe entscheidend, um die Kosten im Griff zu behalten.
Über APIYI apiyi.com kannst du schnell testen, wie sich verschiedene Modelle in den Rollen Router und Worker schlagen. Die Plattform bietet eine OpenAI-kompatible Schnittstelle, nutzungsabhängige Abrechnung und kostenloses Testguthaben für neue Nutzer.
📚 Quellen
- Offizieller DeepSeek-Artikel zur Architektur: Super-Agent-Design: Auf dem Weg zu autonomeren Agent-Systemen
- Link:
x.com/DeepSeekHarness/article/2116857257245987236 -
Inhalt: Primärquelle zur zweischichtigen Architektur, den fünf Kernmodulen, Versuchsdaten und offenen Fragen
-
Offizielles GitHub-Repository von DeepSeek: dsh-superagent-prototype
- Link:
github.com/deepseek-ai/dsh-superagent-prototype -
Inhalt: Projektstatus, Quellcode, Lizenz und aktueller Einsatzbereich
-
Open-Source-Dokumentation zum Domain Model: Aufgabenobjekte und ihr Ablaufmodell
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Inhalt: Definitionen zentraler Konzepte wie Source, Trigger, Ticket und Assignment
-
Dokumentation zu Autorisierung und Abonnements: Regeln für Mandate und Thread-Abonnements
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Inhalt: Offizielle Erklärung, warum abonnierte Nachrichten den Autorisierungsumfang nicht erweitern können
-
Deployment-Dokumentation: Abhängigkeiten, Konten und Sicherheitshinweise
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md -
Inhalt: Betriebsmodus mit weitreichenden Berechtigungen und Empfehlung für einen separaten Systembenutzer
-
Offizielle Preise der DeepSeek API: Preise für Modelle und Tools
- Link:
api-docs.deepseek.com/quick_start/pricing - Inhalt: Preisunterschiede bei Cache-Treffern und Cache-Fehlversuchen als Grundlage für Kostenschätzungen
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI auf apiyi.com, um sich über Agent-Architekturen und praktische Modellaufrufe mit mehreren Modellen auszutauschen. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.