Zusammenfassung: Die offiziellen Gewichte von Hy4 sind jetzt öffentlich verfügbar. Dieser Artikel hilft dir einzuschätzen, welches Gewichtspaket du verwenden solltest, welche GPU-Leistung für den eigenen Betrieb nötig ist und wie sich die Kosten fair mit dem direkten API-Aufruf vergleichen lassen.
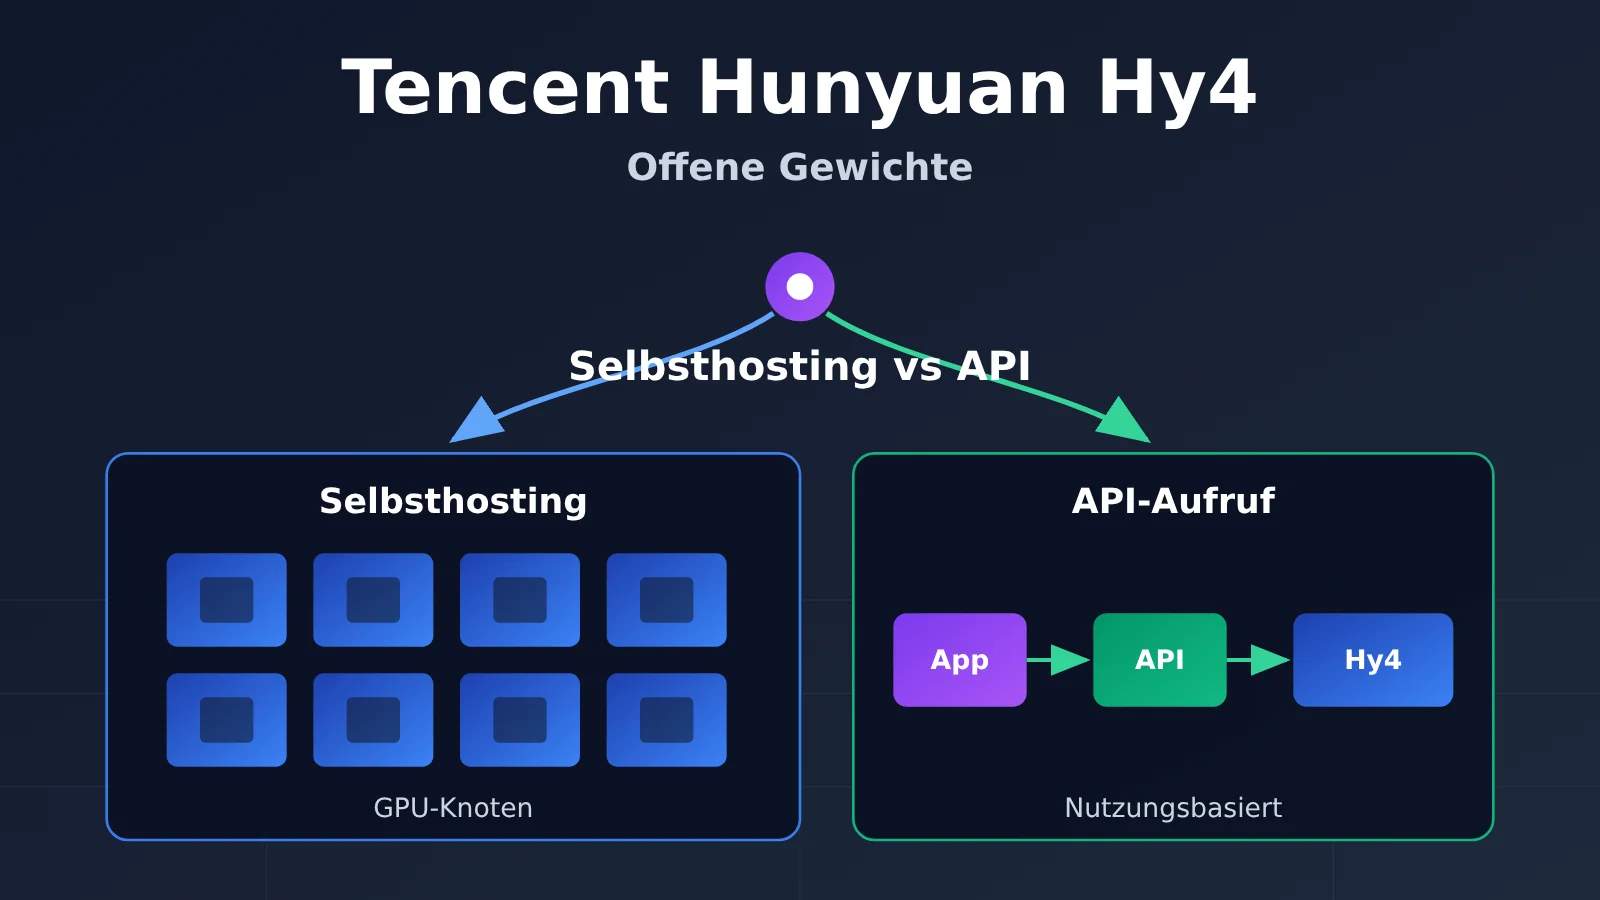
Fazit vorweg: Wenn die Compliance es erlaubt und du zunächst reine Textaufgaben ausprobieren möchtest, ist der direkte API-Aufruf die niedrigschwelligste Option. Ein Selbstbetrieb lohnt sich nur, wenn du eine starke Datentrennung brauchst oder die Inferenzkonfiguration wirklich selbst steuern willst. Der Einstieg in den Selbstbetrieb ist nicht ohne: Die im offiziellen Inferenz-Framework angegebene FP8-Beispielkonfiguration liegt bei 4× B300/GB300 oder 8× H200/B200. Außerdem sind diese Beispiele nicht die Mindestanforderung für alle Konfigurationen und bedeuten nicht, dass sich damit das volle 1M-Kontextfenster ausschöpfen lässt. Wenn die verfügbaren Ressourcen nicht ausreichen, solltest du lieber ein kleineres Modell neu bewerten, statt Hy4 mit Gewalt einzusetzen.
Wissenskarte und Leseleitfaden zu den offenen Hy4-Gewichten
| Nr. | Womit zuerst befassen | Warum zuerst | Was du danach hast |
|---|---|---|---|
| 1 | Version und Gewichtsauswahl | Bei falsch gewählten Gewichten sind alle nachfolgenden Hardware-Schätzungen hinfällig | Du legst fest, ob du Instruct BF16, Instruct FP8 oder Base verwendest |
| 2 | Wie viele GPUs für die Bereitstellung nötig sind | Die Hardware ist die größte Hürde beim Selbstbetrieb | Eine Hardware-Vergleichstabelle und eine Checkliste zur Bestandsaufnahme |
| 3 | Kosten für dieselbe Aufgabenserie | Ein Vergleich ist nur bei gleicher Qualität und gleicher Latenz sinnvoll | Eine Methode zur Berechnung der API-Kosten pro Aufgabe sowie die Kostenbestandteile des Selbstbetriebs |
| 4 | Entscheidung | Die Schlussfolgerungen aus den ersten drei Abschnitten auf dein Szenario anwenden | API nutzen, Selbstbetrieb testen oder auf ein kleineres Modell wechseln |
1→2→3 bauen aufeinander auf: Die Version bestimmt die Gewichtsdateien, die Gewichtsdateien bestimmen die Hardware, und die Hardware bestimmt die Kosten. Abschnitt 4 fasst die Einschätzungen aus den ersten drei Abschnitten zusammen. Wer nur die Kosten betrachtet, kann direkt mit Abschnitt 3 beginnen.
To Know: Die wichtigsten Begriffe für die Hy4-Bereitstellung
| Begriff | Kurze Erklärung |
|---|---|
| Offene Gewichte | Die Modelldateien mit den Parametern können heruntergeladen und selbst bereitgestellt werden; die Nutzungsbedingungen sind durch die Lizenz vorgegeben |
| Instruct / Base | Instruct ist die instruktionsabgestimmte Version, die direkt für Dialoge genutzt werden kann; Base ist das vortrainierte Grundmodell und eignet sich für weiteres Training |
| BF16 / FP8 | Numerische Präzision der Parameter. Bei FP8 belegt jeder Parameter etwa 1 Byte, bei BF16 etwa 2 Byte |
| TP (Tensor-Parallelismus) | Ein Modell wird auf mehrere GPUs aufgeteilt und gemeinsam berechnet; TP8 bedeutet, dass es in 8 Teile aufgeteilt wird |
| KV-Cache | Zwischenzustand, der während der Inferenz für den Kontext gespeichert wird und mit Kontextlänge und Parallelität wächst |
| Cache-Treffer | Eingabe-Tokens, die bei der API-Abrechnung den Prompt-Cache treffen; der Preis pro Einheit liegt unter dem für nicht zwischengespeicherte Eingaben |
1. Hy4-Versionen und offene Gewichte – wie wählen?
1.1 Die drei Zeitpunkte von Hy4
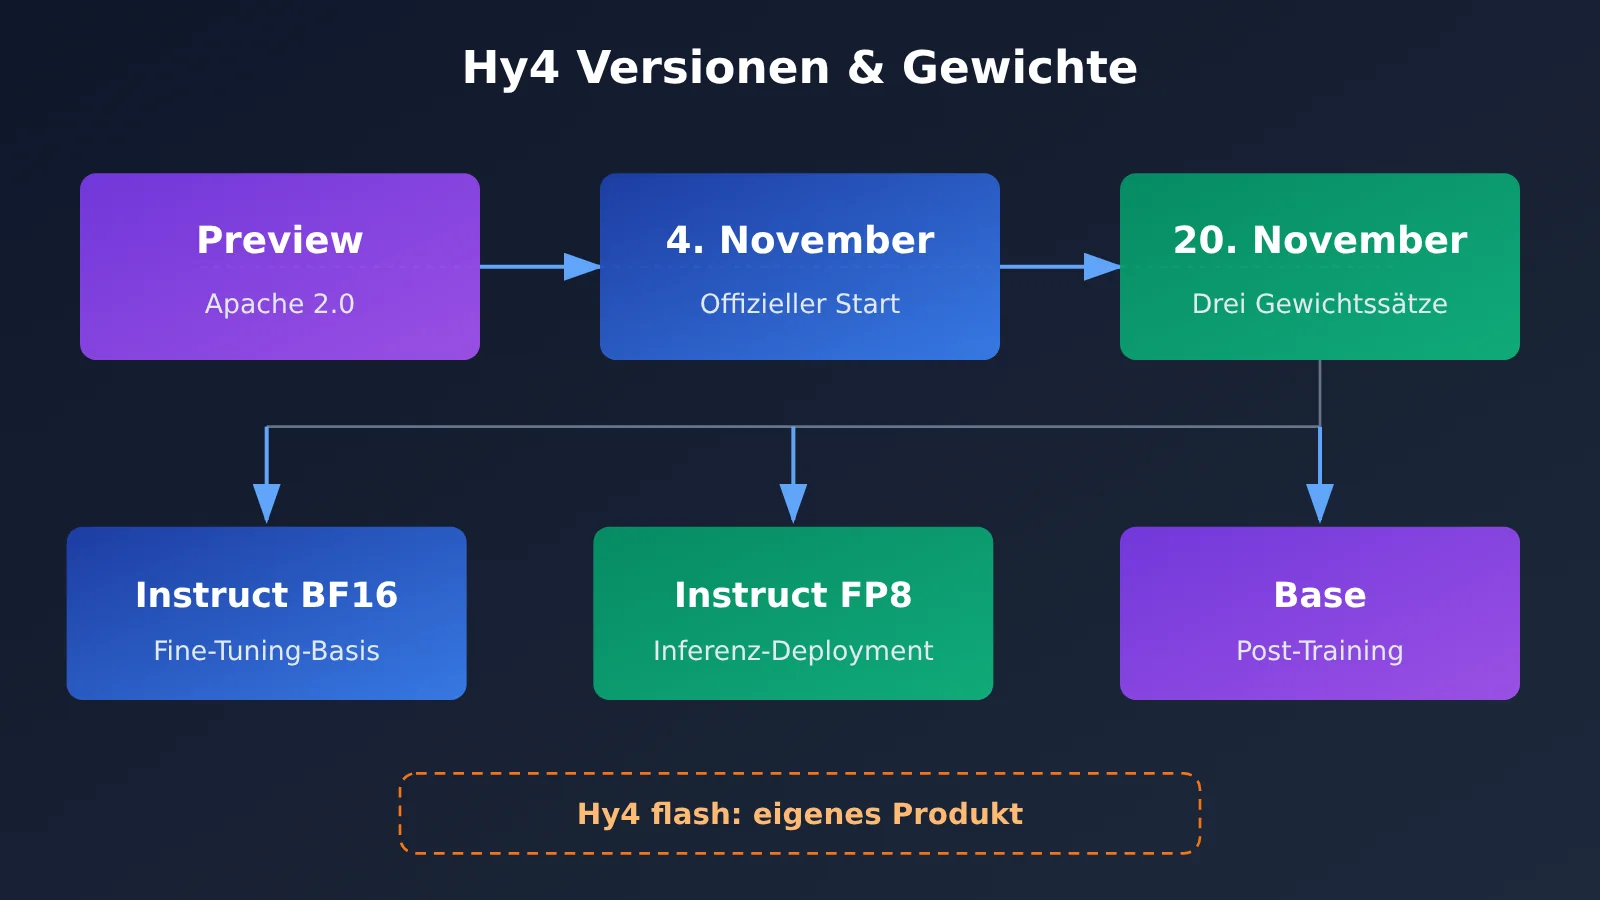
Die Veröffentlichung von Hy4 erfolgte in drei Etappen. Zuerst wurde die Preview-Version freigegeben. Sie erschien auf der Hugging-Face-Seite tencent/Hy4-preview unter der Lizenz Apache 2.0. Am 4. November 2026 gab Tencent bekannt, dass Hy4 offiziell verfügbar ist. Am 20. November wurden die drei Gewichtssätze der offiziellen Version auf Hugging Face veröffentlicht.
Die Unterschiede zwischen diesen drei Zeitpunkten wirken sich direkt auf Ihre Wahl aus. Preview und die offizielle Version haben unterschiedliche Lizenzen: Die offizielle Version verwendet die Tencent Hy License 1.0, deren Abschnitt 10 zusätzliche Bedingungen für bestimmte öffentlich angebotene allgemeine Inferenzdienste festlegt. Wenn Sie Hy4 als öffentlich zugänglichen Dienst bereitstellen möchten, lassen Sie Ihre Rechtsabteilung die Lizenz im Original prüfen und eigenständig entscheiden. Dieser Artikel zieht keine rechtlichen Schlussfolgerungen für die Praxis einzelner Unternehmen.
1.2 Einsatzbedingungen der drei offiziellen Gewichtssätze von Hy4
| Gewichts-Repository | Inhalt | Geeignet für |
|---|---|---|
tencent/Hy4 |
Instruct, BF16 | Maximale numerische Präzision oder als Ausgangspunkt für Fine-Tuning und Quantisierung; höchster VRAM-Bedarf |
tencent/Hy4-FP8 |
Instruct, FP8 | Direkt für die Inferenzbereitstellung; die Beispielkonfigurationen von SGLang und vLLM basieren darauf |
tencent/Hy4-base |
Vortrainiertes Base-Modell | Für eigenes Post-Training und domänenspezifisches Weiter-Training; nicht für den direkten Dialogeinsatz geeignet |
Wichtig ist die Unterscheidung: Die offizielle Hy4-Version ist nicht mit Hy4 flash gleichzusetzen; Letzteres ist eine eigenständige Produktlinie. Die in diesem Artikel besprochene Hardware und die Kosten beziehen sich ausschließlich auf die offizielle Version und lassen sich nicht auf flash übertragen.
2. Wie viele GPUs man für die eigene Bereitstellung von Hy4 braucht
2.1 Beispielkonfigurationen von SGLang und vLLM im Vergleich
Die beiden großen Inferenz-Frameworks stellen jeweils eine Beispielkonfiguration für Hy4 bereit. Hier die Gegenüberstellung:
| Framework | Gewichte | Parallelisierung | Beispiel-GPUs | Anmerkungen zum Beispiel |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 oder 4×GB300 | Die Größe des KV-Pools bestimmt, wie viel Kontext tatsächlich nutzbar ist |
| SGLang | FP8 | TP8 | 8×H200 oder 8×B200 | Wie oben |
| vLLM | FP8 (Standard) | TP8 | 8×B300 | Das Beispiel-Kontextfenster beträgt 131.072; nur ein einzelnes Bild wird unterstützt, Video ist deaktiviert |
Beim Lesen dieser Tabelle sollten Sie drei Punkte beachten:
- Das sind Beispielkonfigurationen, keine Mindestkonfigurationen. Die SGLang-Dokumentation weist darauf hin, dass der KV-Pool die tatsächlich verfügbare Kontextmenge begrenzt; diese Konfigurationen stellen auch keine Untergrenze für irgendeine Parameterkombination dar.
- Ein volles 1M-Kontextfenster ist nicht garantiert. Laut Modellkarte beträgt der maximale Kontext 1.048.576 Token, die tatsächlich nutzbare Länge hängt jedoch von der konkreten Servicekonfiguration ab. Das vLLM-Beispiel öffnet nur 131.072, und keine der beiden Dokumentationen verspricht, dass volle 1M nutzbar sind.
- Die Zahlen der beiden Anbieter lassen sich nicht gegenseitig übertragen. Der in der vLLM-Dokumentation angegebene Referenzspeicher gilt ausschließlich für diese vLLM-Konfiguration.
2.2 770B, 49B und der Zusammenhang mit dem VRAM
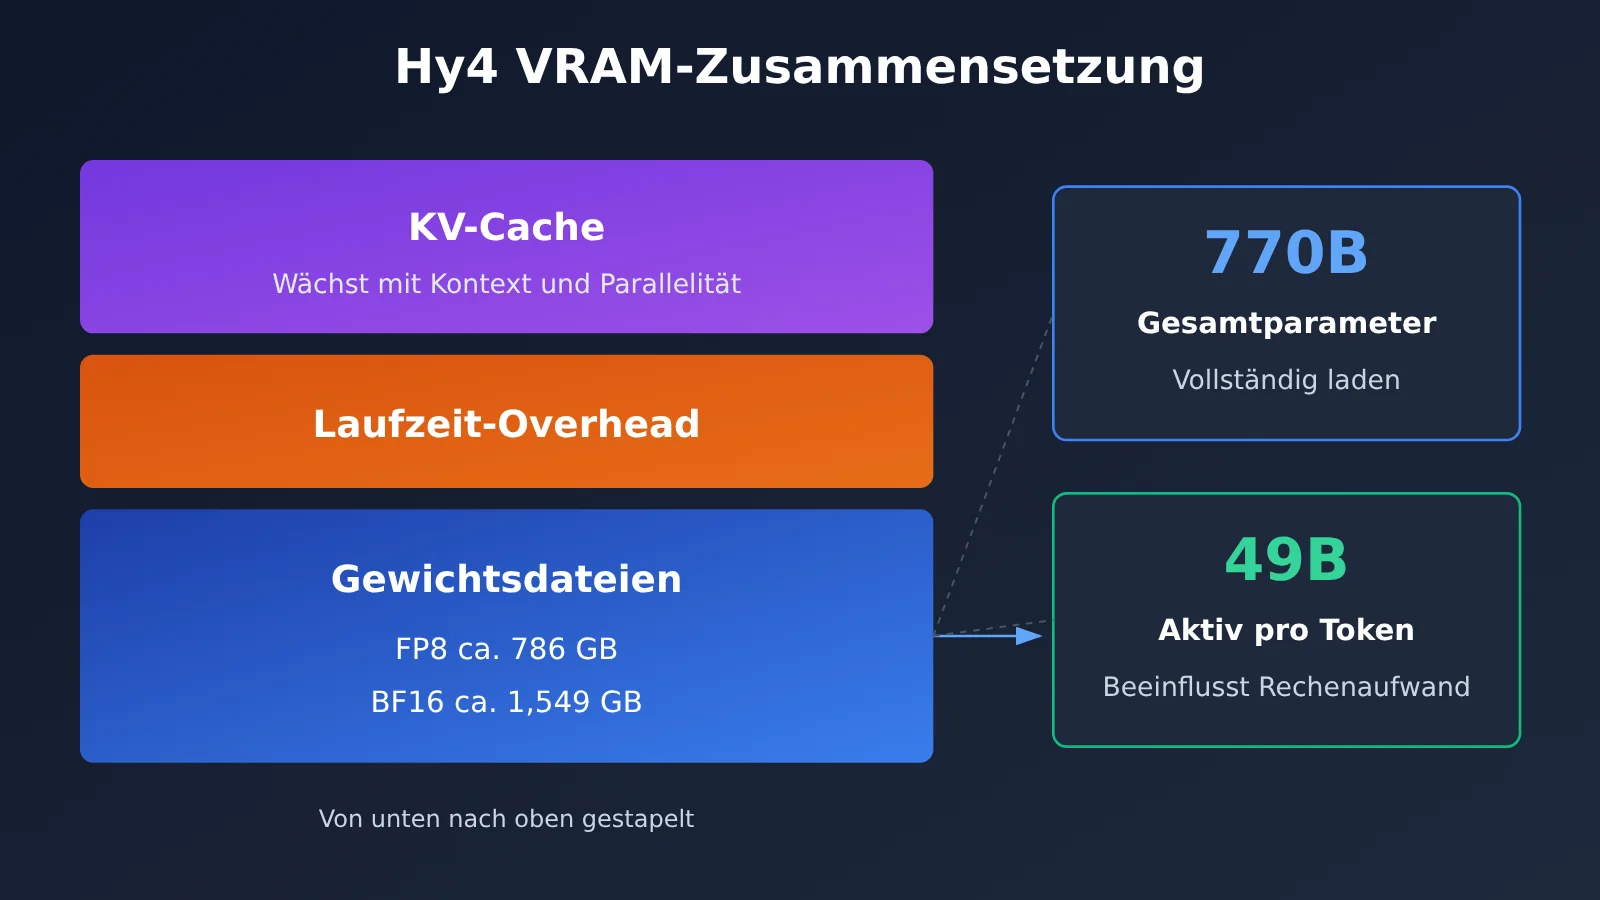
Bei Hy4 werden oft zwei Zahlen genannt: 770B ist die Gesamtanzahl der Parameter im Sprach-Backbone, 49B ist die Anzahl der pro Token aktivierten Textparameter. Viele missverstehen 49B als VRAM-Anforderung – das ist falsch. 49B bestimmt den Rechenaufwand pro Token; um jederzeit beliebige Experten aufrufen zu können, müssen alle 770B Parameter in den VRAM geladen werden.
Der VRAM-Bedarf lässt sich in drei Ebenen unterteilen:
- Größe der Gewichtsdateien: Laut vLLM-Dokumentation sind es bei FP8 etwa 786 GB und bei BF16 etwa 1,549 GB. Das ist in erster Linie eine Frage des Speicherplatzes und der Ladebandbreite.
- VRAM zur Laufzeit: Die Referenz-VRAM-Werte im vLLM-Beispiel liegen bei etwa 944 GB (FP8) und 1,859 GB (BF16). Sie sind größer als die Dateien selbst, weil sie auch Laufzeit-Overhead und reservierten KV-Cache umfassen.
- KV-Cache und Parallelität: Je länger der Kontext und je mehr Anfragen gleichzeitig bedient werden, desto größer ist der KV-Cache-Verbrauch. Dieser Teil entscheidet, wie viel Last dieselbe Hardware noch bewältigen kann, wenn das Modell erst einmal „hineinpasst“.
Vor dem Deployment können Sie anhand der folgenden Checkliste prüfen:
- [ ] Verfügbare GPU-Modelle, Anzahl und VRAM pro Karte – lässt sich damit TP4 oder TP8 bilden?
- [ ] Erfüllt die Verbindung zwischen den GPUs die Kommunikationsanforderungen der Tensor-Parallelität?
- [ ] Kann der lokale Speicher die Gewichte von ca. 786 GB (FP8) bzw. ca. 1,549 GB (BF16) aufnehmen, und wie hoch ist die Ladegeschwindigkeit?
- [ ] Ziel-Kontextlänge: Reichen 131K, oder muss sie länger sein?
- [ ] Spitzenanzahl gleichzeitiger Anfragen und ob der KV-Pool bei dieser Last ausreicht
- [ ] Wird visuelle Eingabe benötigt? (Im vLLM-Beispiel ist nur ein Einzelbild aktiviert.)
- [ ] Stimmt die gewählte Version des Inferenz-Frameworks mit dem offiziellen Cookbook oder Recipe überein?
3. Hy4-Kosten mit demselben Aufgabenpaket berechnen
3.1 Abrechnung nach Verbrauch über die API
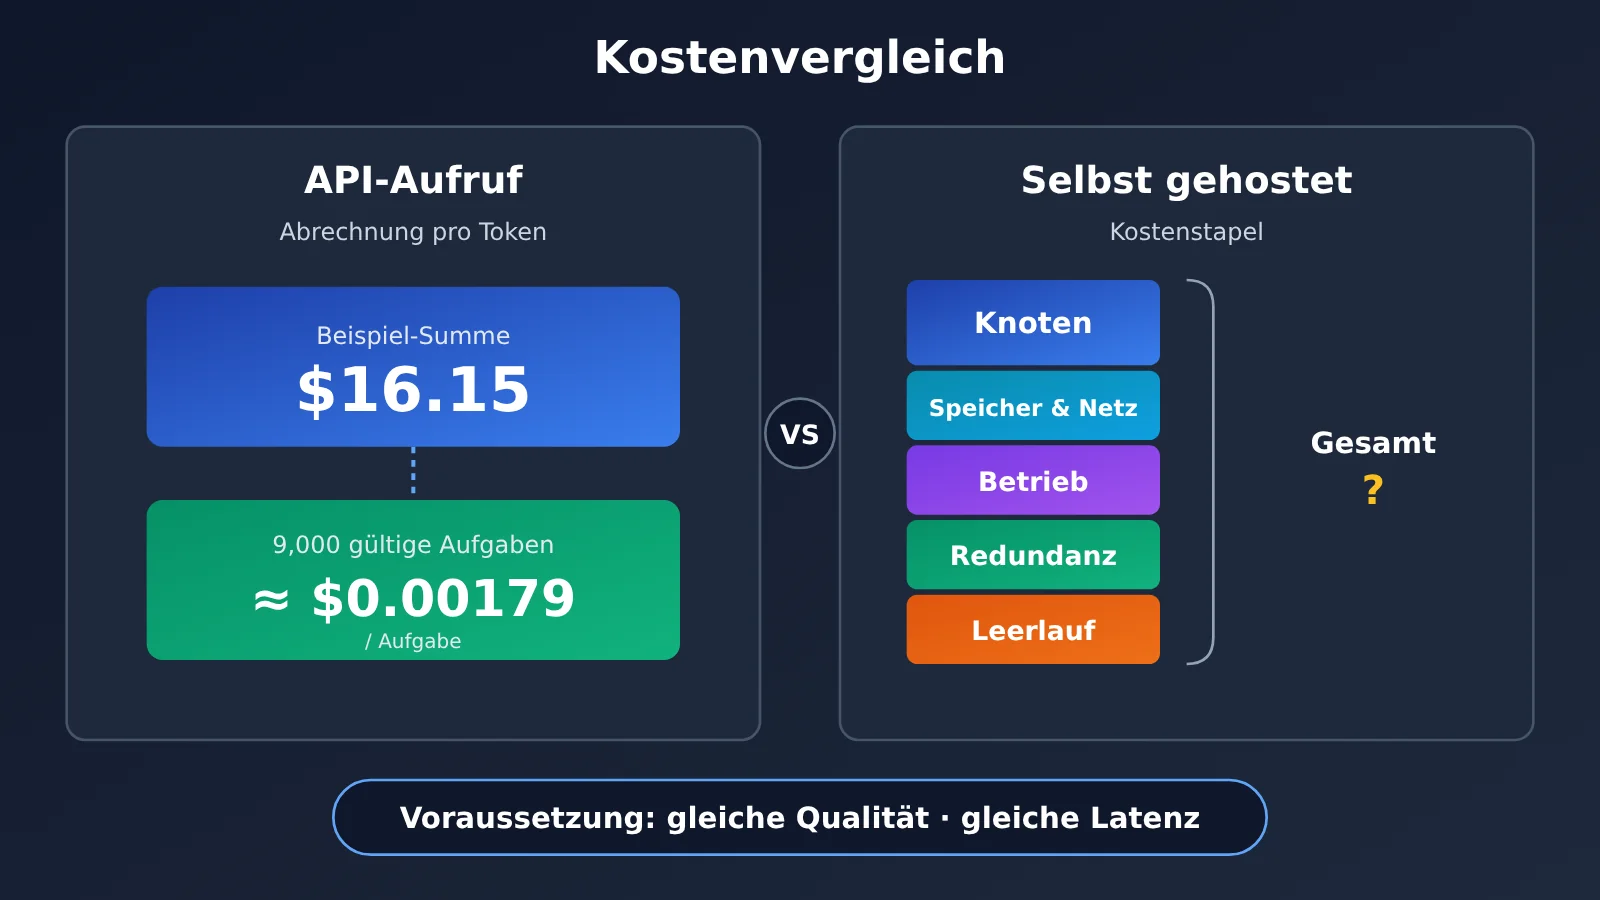
Ein Beispiel anhand der Modellseite von APIYI: Stand 21. November 2026 ist die offizielle Version von Hy4 unter der Modell-ID hy4 verfügbar. Sie ist in die zwei Gruppen Default und SVIP unterteilt und nutzt die Chat-Completions-Schnittstelle. Der Listenpreis wird pro Million Token berechnet: 0,85 $ für ungecachte Eingaben, 2,55 $ für Ausgaben, 0,045 $ für Cache-Reads. Die tatsächliche Abrechnung richtet sich nach der Konsole. Wichtig zu erwähnen: APIYI hat Hy4 schon vor dieser Freigabe der Gewichte gelistet. Die Ankündigung nennt zwar Vision-Unterstützung, das folgende Rechenbeispiel geht aber von reinem Text aus. Die im Model Card genannten 1M-Kontextfenster sowie Video- oder Computer-Use-Fähigkeiten werden nicht mit der real gemessenen Leistung des gehosteten Dienstes gleichgesetzt.
Bei der Abrechnung werden die drei Token-Arten getrennt gezählt und überschneiden sich nicht: Ein einzelnes Eingabe-Token zählt entweder als ungecachte Eingabe oder als Cache-Read, nie doppelt. Das folgende Beispiel ist eine Annahme, keine Messung:
| Position | Angenommene Nutzung | Preis (pro Million) | Kosten |
|---|---|---|---|
| Ungecachte Eingabe | 10 Mio. Token | $0.85 | $8.50 |
| Ausgabe | 3 Mio. Token | $2.55 | $7.65 |
| Cache-Reads | 0 | $0.045 | $0 |
| Summe | — | — | $16.15 |
Angenommen, 9.000 der Ergebnisse aus diesem Aufrufbündel bestehen deine Abnahme, dann kostet jede gültige Aufgabe etwa $16.15 ÷ 9,000 ≈ $0.00179. Gemessen werden sollte man besser die „Kosten pro gültiger Aufgabe“ als die „Kosten pro Aufruf“, denn Kosten für fehlgeschlagene Wiederholungen und Nacharbeit gehören mit hinein. Diese Zahl muss außerdem zusammen mit der tatsächlich beobachteten Latenz und der verkraftbaren Parallelität dokumentiert werden, sonst lässt sie sich nicht mit dem Selbstbetrieb vergleichen.
3.2 Die tatsächliche Kostenstruktur beim Selbstbetrieb
Beim Selbstbetrieb fallen weit mehr Kosten an als nur die GPU. Die folgende Tabelle listet die Posten auf, die eingerechnet werden müssen:
| Kostenposition | Inhalt |
|---|---|
| Rechenknoten | Anschaffungs- oder Mietkosten für Hochleistungs-GPU-Knoten mit 4 oder 8 Karten |
| Speicher und Netzwerk | Gewichtsspeicher im nahezu TB-Bereich, Ladebandbreite, Interconnect zwischen Karten und zwischen Knoten |
| Betrieb | Personalaufwand für Upgrades der Inferenz-Frameworks, Monitoring und Alarmierung sowie Fehlerbehebung |
| Redundanz | Reserveknoten zur Absicherung der Verfügbarkeit, die im Normalbetrieb oft im Leerlauf stehen |
| Auslastung | Leerlaufkosten in verkehrsschwachen Zeiten, die den Preis pro Aufgabe direkt nach oben treiben |
Beim Vergleich der beiden Varianten muss man von gleicher Qualität und gleicher Latenz ausgehen: mit demselben Aufgabenpaket, denselben Abnahmekriterien und ähnlichen Zielen für Latenz und Parallelität jeweils die Kosten pro gültiger Aufgabe berechnen. Weil Hardwarepreise, Auslastung und Personalkosten je nach Team stark schwanken, nennt dieser Artikel keine einheitliche „Break-even-Grenze“. Du musst mit deinen eigenen Angeboten und deiner eigenen Auslastungskurve rechnen.
4. Hy4-Bereitstellungsentscheidung: API, Selbst-Deployment oder kleineres Modell
Fasst man die Ergebnisse der drei vorangegangenen Abschnitte zusammen, lassen sich die Optionen je nach Bedingung in drei Pfade aufteilen:
- Compliance erlaubt + zunächst reine Textaufgaben testen → API nutzen. Keine Hardware-Beschaffung nötig: Berechnen Sie zuerst mit echten Aufgaben die Kosten und Latenz pro bestandener Aufgabe als Basis für spätere Entscheidungen.
- Starke Datenisolierung erforderlich oder eigene Kontrolle über die Inferenzkonfiguration nötig → Hardware inventarisieren und Selbst-Deployment validieren. Prüfen Sie zuerst die Ressourcen anhand der Checkliste aus Abschnitt 2.2, bringen Sie die Beispielkonfiguration von SGLang oder vLLM zum Laufen und vergleichen Sie dann mit demselben Aufgaben-Set wie bei der API Qualität, Latenz und Kosten. Bevor Sie den Dienst extern anbieten, lassen Sie Abschnitt 10 der Lizenz von der Rechtsabteilung prüfen.
- Ressourcen erreichen nicht die Größenordnung des Beispiels → kleineres Modell neu bewerten. Wenn sich 4 oder 8 High-End-GPUs nicht zusammenbringen lassen, wird man durch gewaltsames Verkleinern von Kontext oder Parallelität die Qualitäts- und Latenzziele wahrscheinlich nicht erreichen – ein Wechsel zu einem kleineren Modell ist oft realistischer.
Aktionskarte
- Gewichte auswählen:
Hy4-FP8für Inferenz-Deployment,Hy4-base, wenn weiter trainiert werden soll, und sicherstellen, dass nicht die flash-Variante verwendet wird. - Bereiten Sie 200–500 echte Aufgaben vor und legen Sie die Abnahmekriterien fest.
- Wenn Daten nach außen gegeben werden dürfen, zunächst einen Durchlauf über die API machen; andernfalls zuerst mit öffentlichen oder synthetischen Samples testen und die echten Daten in der internen Umgebung belassen. Token-Verbrauch, Bestehensquote, Latenz und Parallelitätsverhalten protokollieren.
- Falls Selbst-Deployment nötig ist: Hardware anhand der Checkliste inventarisieren und mit derselben Aufgaben-Charge erneut testen.
- Die endgültige Entscheidung an einer einzigen Kennzahl treffen: „Kosten pro bestandener Aufgabe + Latenz“.
Referenzen
- Offizielle Launch-Ankündigung von Tencent Hy4: https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Hy4 Instruct (BF16) Gewichte: https://huggingface.co/tencent/Hy4
- Hy4 Instruct (FP8) Gewichte: https://huggingface.co/tencent/Hy4-FP8
- Hy4 Base Gewichte: https://huggingface.co/tencent/Hy4-base
- Tencent Hy License 1.0: https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- Hy4 Preview (Apache 2.0): https://huggingface.co/tencent/Hy4-preview
- SGLang Hy4 Cookbook: https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- vLLM Hy4 Recipe: https://recipes.vllm.ai/tencent/Hy4
- APIYI Hy4 Launch-Dokumentation: https://docs.apiyi.com/news/hy4-launch
- APIYI Modellliste (Tencent): https://docs.apiyi.com/models#腾讯
- Hy4 Hintergrundübersicht (historischer Snapshot; maßgeblich für Gewichte und Listing-Informationen ist dieser Artikel): https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html