Anmerkung des Autors: Ausgehend von der usage einer Responses-Anfrage werden der normale Input, die Cache-Lese- und Cache-Schreibvorgänge sowie die Reasoning-Ausgabe von GPT-6.2 Sol einzeln nachgerechnet. Danach wird erläutert, wie Cache-Lebensdauer und Anfragestatus die Abrechnung desselben Workflows verändern.
Die Abrechnung von GPT-6.2 Sol lässt sich mit einer festen Methode nachrechnen. Die usage im Anfrageprotokoll teilt den Input in vier Kategorien auf: normaler Input, Cache-Lesen, 30-Minuten-Cache-Schreiben und 12-Stunden-Cache-Schreiben. Diese vier Kategorien schließen sich gegenseitig aus. Die Ausgabe bildet eine eigene Kategorie; die Reasoning-Token sind darin bereits enthalten. Man multipliziert die Tokenanzahl jeder Kategorie mit dem jeweiligen Tarif und addiert die Ergebnisse – das ergibt die Modellkosten dieser Anfrage. Tool-Kosten werden separat berechnet.
Drei Bedingungen verändern das Ergebnis. Erstens: ob die gesamte Input-Menge einer einzelnen Anfrage 272K überschreitet. Ist das der Fall, gilt für die gesamte Anfrage der Langkontext-Tarif. Zweitens: die Cache-Lebensdauer und die tatsächliche Trefferzahl. Je nachdem, ob derselbe Präfix für 30 Minuten oder für 12 Stunden geschrieben wird, liegt der Break-even-Punkt anders. Drittens: der Anfragestatus. incomplete, Wiederholungen und Hintergrundaufgaben beeinflussen die Gesamtabrechnung eines Workflows.
OpenAI hat GPT-6.2 Sol am 17. November 2026 veröffentlicht. Die API-Modell-ID lautet gpt-6.2-sol; das Modell lässt sich über Responses und Chat Completions aufrufen, Function Calling und integrierte Tools laufen über den Responses-Pfad. Dieser Artikel verwendet die offiziellen USD-Listenpreise der direkten OpenAI-Anbindung als Grundlage und erläutert zugleich die Preisnotierung dieses Modells in der öffentlichen Preis-API von APIYI (apiyi.com). Alle Rechenbeispiele in diesem Artikel beruhen auf synthetischen Nutzungsmengen und sind keine gemessenen Abrechnungen.
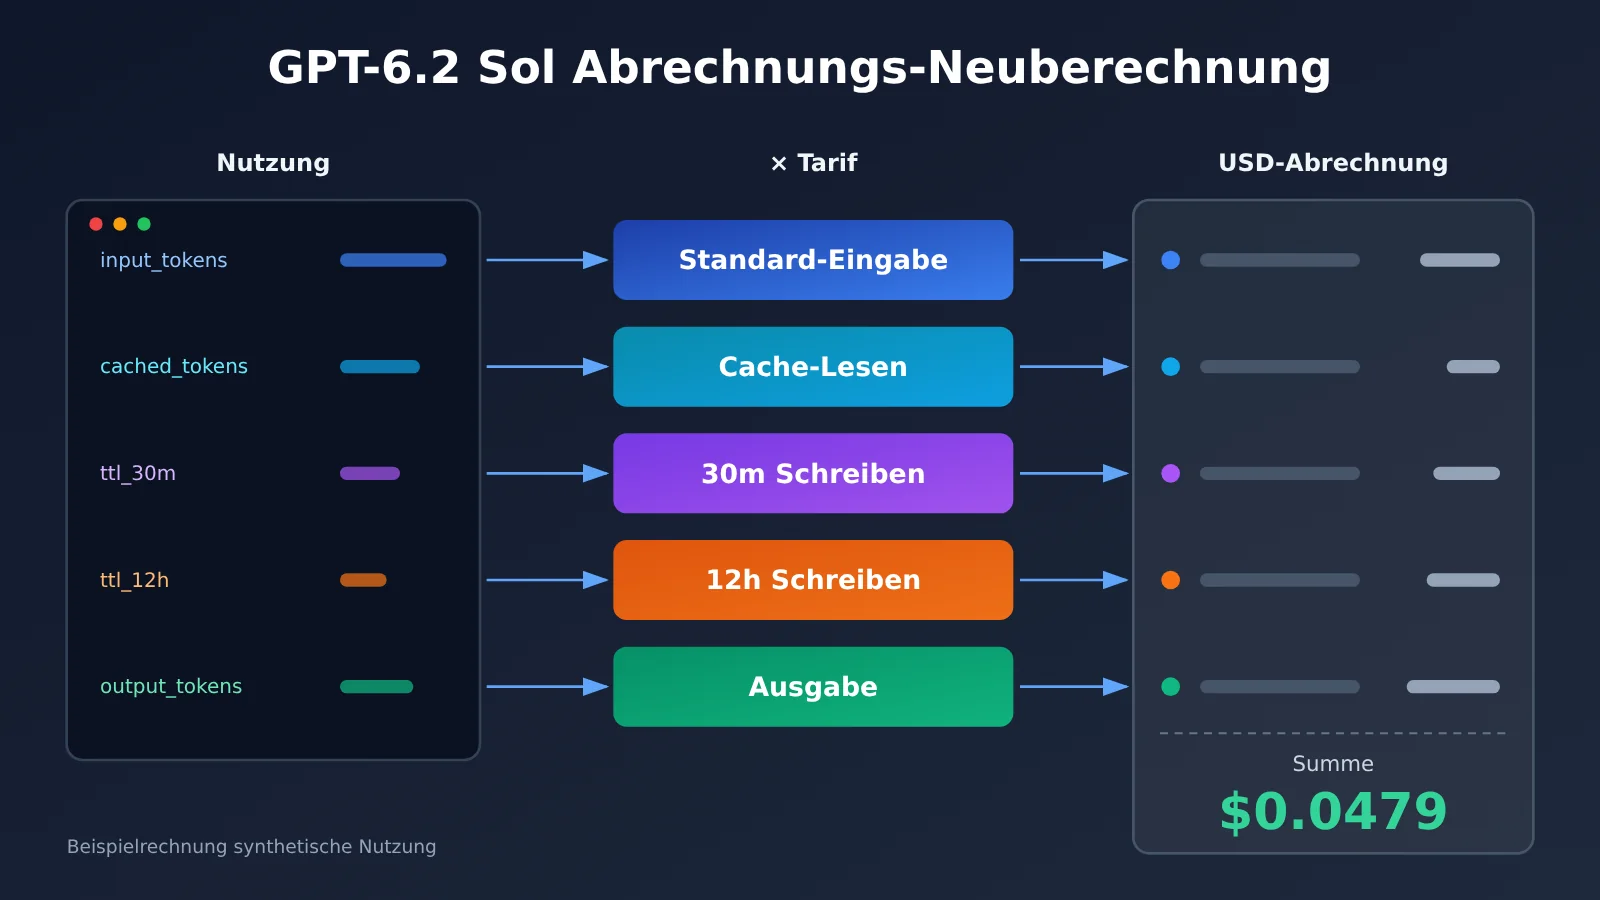
Wissenskarte und Lesereihenfolge zur Abrechnung von GPT-6.2 Sol
Der gesamte Text folgt der Reihenfolge „Felder → Beträge → Cache-Entscheidung → Workflow-Abgleich“. Die Ausgabe jedes Schritts ist die Eingabe des nächsten: Zuerst klären wir, welche Posten in usage enthalten sind, rechnen sie dann in US-Dollar um, vergleichen mit diesem Algorithmus Cache-Varianten und fassen schließlich einzelne Anfragen zu Workflow-Kosten zusammen.
Responses usage
 ├─ Eingabe gesamt input_tokens
 │   ├─ Cache-Lesen cached_tokens ──────────┐
 │   ├─ 30m-Schreiben ttl_30m_tokens ───────┤
 │   ├─ 12h-Schreiben ttl_12h_tokens ───────┼─→ ×entsprechender Tarif → Modellkosten pro Anfrage (Abschnitt 2)
 │   └─ normale Eingabe = Gesamt − Lesen − alle Schreibvorgänge ┤
 └─ Ausgabe output_tokens (inkl. reasoning_tokens) ┘
                                          ↓
         Cache-Lebensdauer wählen (Abschnitt 3) ← Gesamtpreisvergleich bei mehreren Anfragen mit demselben Präfix
                                          ↓
         Workflow-Abgleich (Abschnitt 4) ← Werkzeugkosten + Wiederholungen + incomplete + Kostenexport
| Nr. | Beantwortete Frage | Baut auf dem Inhalt des vorherigen Abschnitts auf | Was Sie danach tun können |
|---|---|---|---|
| 1 | Welche Zahlen in usage in die Abrechnung einfließen | — | Aus einer Antwort fünf abrechnungsrelevante Verbrauchsposten herauslösen |
| 2 | Was diese Verbrauchswerte kosten | die fünf Verbrauchsposten aus Abschnitt 1 | Protokollzahlen in US-Dollar umrechnen und die kurze bzw. lange Tarifstufe bestimmen |
| 3 | Cache für 30 Minuten oder 12 Stunden schreiben | die Preisberechnung pro Einheit aus Abschnitt 2 | Cache-Lebensdauer anhand von Aufrufabstand und Trefferanzahl wählen |
| 4 | Was eine Aufgabe tatsächlich gekostet hat | die Einzelanfrage-Kalkulation aus den Abschnitten 2 und 3 | eine minimale Protokolltabelle aufbauen und Rechnungsdifferenzen nachverfolgen |
Wer nur eine einzelne Kostendifferenz erklären möchte, kann nach dem Lesen der Abschnitte 1 und 2 aufhören. Wer für die Cache-Strategie oder das Kostenjournal verantwortlich ist, sollte alle vier Abschnitte der Reihe nach lesen.
Abrechnungsbegriffe von GPT-6.2 Sol, die man kennen sollte
| Begriff | Erklärung |
|---|---|
| usage | Feld in der API-Antwort, das den Token-Verbrauch der aktuellen Anfrage zusammenfasst |
| Normaler Input | Die Nutzung, die vom Gesamtinput übrig bleibt, nachdem abgerechnete Cache-Lesevorgänge und alle Cache-Schreibvorgänge abgezogen wurden |
| Cache-Lesen | Der Teil des Inputs der aktuellen Anfrage, der zum Wiederverwendungspreis abgerechnet wird |
| Cache-Breakpoint | Die Grenze, an der ein Input-Präfix im Cache gespeichert oder wiederverwendet werden kann |
| TTL | Die Konfiguration der Mindestabdeckungsdauer für die Cache-Abrechnung; Sol unterstützt Schreibvorgänge mit 30 Minuten und 12 Stunden |
| Reasoning-Token | Token, die das Modell in der Denkphase erzeugt und die in die abgerechnete Gesamtausgabe einfließen |
| Response-ID | Die Kennung, die Abrechnungsprotokolle, Hintergrund-Polling und die zugehörige Modellantwort miteinander verknüpft |
| Tool-Gebühr | Separate Kosten, die durch die Nutzung bestimmter gehosteter Tools entstehen |
1 Die fünf Abrechnungsgrößen von GPT-6.2 Sol aus der Responses-Usage ermitteln
1.1 Vier Eingabearten und eine Ausgabeart
Das usage-Objekt von Responses erfasst Eingabe und Ausgabe einer Anfrage getrennt. Auf der Eingabeseite werden die Gesamtmenge und mehrere Detailwerte ausgewiesen, auf der Ausgabeseite die Gesamtmenge sowie der Reasoning-Teilwert. Beim Nachrechnen sind die folgenden Felder relevant:
| Abrechnungskategorie | Ausgelesenes Feld | Erläuterung |
|---|---|---|
| Eingabe gesamt | usage.input_tokens |
Summe der vier Eingabearten; wird selbst nicht direkt mit einem Tarif multipliziert |
| Cache-Lesevorgänge | input_tokens_details.cached_tokens |
Die im Abrechnungssinn gelesene Menge |
| Cache-Schreibvorgänge gesamt | cache_write_tokens |
Summe der Schreibvorgänge beider Lebensdauern |
| 30-Minuten-Schreibvorgänge | cache_write_tokens_details.ttl_30m_tokens |
Wird genutzt, wenn die Lebensdauer-Details zurückgegeben werden |
| 12-Stunden-Schreibvorgänge | cache_write_tokens_details.ttl_12h_tokens |
Wird genutzt, wenn die Lebensdauer-Details zurückgegeben werden |
| Ausgabe | usage.output_tokens |
Enthält die Reasoning-Tokens bereits |
| Reasoning-Teilwert | output_tokens_details.reasoning_tokens |
Dient dem Verständnis der Ausgabezusammensetzung und wird nicht separat berechnet |
1.2 Berechnungsformel für normale Eingaben
Für normale Eingaben gibt es in der usage kein eigenes Feld; sie werden durch Subtraktion ermittelt:
Normale Eingabe = input_tokens − cached_tokens − cache_write_tokens
Hier werden alle Schreibvorgänge abgezogen, also die Summe aus 30-Minuten- und 12-Stunden-Schreibvorgängen. Die vier Kategorien – beide Schreibarten, Lesevorgänge und normale Eingaben – schließen sich gegenseitig aus; jedes Token fällt nur in genau eine Kategorie. Tokens, die in den Cache geschrieben werden, werden mit dem Schreibtarif abgerechnet und nicht noch einmal als normale Eingabe. Genau hier passiert leicht ein Fehler: Lässt man die Schreibmenge in der normalen Eingabe und berechnet zusätzlich die Schreibgebühr, fällt der Gesamtbetrag zu hoch aus.
Auch die Reasoning-Tokens auf der Ausgabeseite werden leicht doppelt gezählt. reasoning_tokens ist eine Teilmenge von output_tokens; für die Nachrechnung genügt es, output_tokens mit dem Ausgabetarif zu multiplizieren. Der Reasoning-Teilwert eignet sich zur Analyse der Frage, warum die Ausgabe diesmal so umfangreich ist, nicht als zusätzliche Abrechnungsposition.
1.3 Abrechnungsfelder für die Nachrechnung, Diagnosefelder nur zur Fehlersuche
In den Diagnoseinformationen von Prompt Caching erscheinen außerdem Zahlen wie „wiederverwendbare Menge“ oder „geschätzte Nicht-Treffer-Menge“. Sie erklären, warum der Cache nicht getroffen hat – etwa weil sich das Präfix geändert hat oder die Länge nicht ausreicht –, geben aber nicht die tatsächliche Abrechnung wieder. Beim Nachrechnen der Abrechnung werden nur die tatsächlichen Abrechnungsfelder aus der usage herangezogen.
Wenn ein Kanal keine Lebensdauer-Details zurückgibt oder cache_write_tokens fehlt, sollte die Abrechnung nicht anhand fehlender Felder geschätzt werden. Maßgeblich sind dann die eigenen Abrechnungsdatensätze des Kanals. Das Rechenbeispiel im nächsten Abschnitt verwendet eine synthetische Usage, in der alle Felder vorhanden sind, damit der vollständige Algorithmus nachvollziehbar ist.
2 GPT-6.2 Sol-Logzahlen in US-Dollar umrechnen
2.1 Offizielle Standard-Preistabelle
Die folgende Tabelle gibt die offiziellen OpenAI-Direktpreise an, Einheit USD pro Million Token. Die Einstufung in kurz oder lang richtet sich nach der gesamten Eingabemenge pro Anfrage; sobald 272K überschritten werden, wird die gesamte Anfrage auf den Langkontext-Tarif umgestellt: Eingabe und alle Cache-Tarife ×2, Ausgabe ×1.5.
| Standard-Abrechnungskategorie | Kurzer Kontext (≤272K) | Langer Kontext (>272K) |
|---|---|---|
| Normale Eingabe | $2.00 | $4.00 |
| Cache-Lesen | $0.10 | $0.20 |
| 30-Minuten-Cache-Schreiben | $2.50 | $5.00 |
| 12-Stunden-Cache-Schreiben | $5.00 | $10.00 |
| Ausgabe (inkl. Reasoning-Token) | $10.00 | $15.00 |
Der Grundpreis für den kurzen Kontext ist identisch mit GPT-6.1 Sol. Außerdem nennt die Modellkarte ein Kontextfenster von 1,050,000 Token, maximal 922,000 Token Eingabe und maximal 128,000 Token Ausgabe. „Wie viel man maximal eingeben kann“ und „ab wann der Langtarif greift“ sind zwei unabhängige Zahlen: Eine Anfrage mit 300K Eingabe ist völlig zulässig, wird aber insgesamt nach dem Langtarif abgerechnet.
2.2 Vollständige Neuberechnung der zusammengesetzten Usage
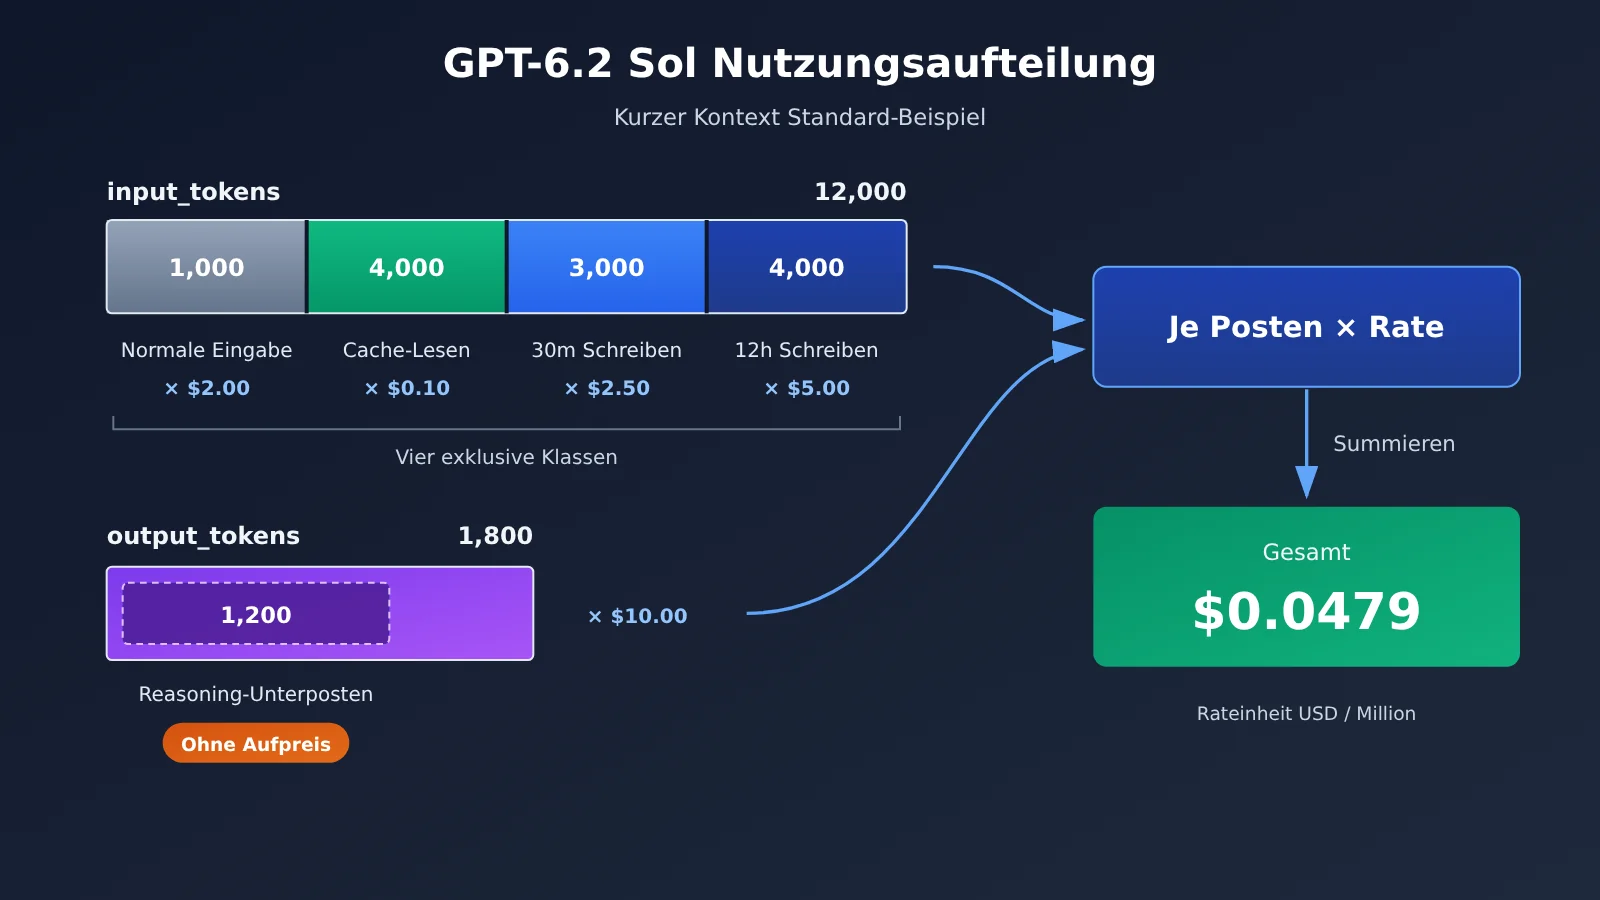
Nehmen wir an, eine Standard-Anfrage mit kurzem Kontext gibt folgende Usage-Werte zurück – ohne Tool-Nutzung und ohne Zusatzgebühren: Eingabe gesamt 12.000, Cache-Lesen 4.000, 30-Minuten-Schreiben 3.000, 12-Stunden-Schreiben 4.000, Ausgabe 1.800 (davon Reasoning 1.200).
Zuerst die normale Eingabe berechnen: 12.000 − 4.000 − 3.000 − 4.000 = 1.000. Dann jeden Posten einzeln mit dem Tarif multiplizieren:
| Abrechnungsposten | Token-Anzahl | Tarif (USD/Million) | Betrag (USD) |
|---|---|---|---|
| Normale Eingabe | 1.000 | 2,00 | 0,0020 |
| Cache-Lesen | 4.000 | 0,10 | 0,0004 |
| 30-Minuten-Schreiben | 3.000 | 2,50 | 0,0075 |
| 12-Stunden-Schreiben | 4.000 | 5,00 | 0,0200 |
| Ausgabe (inkl. Reasoning 1.200) | 1.800 | 10,00 | 0,0180 |
| Summe | — | — | 0,0479 |
In dieser Rechnung macht das 12-Stunden-Schreiben nur 4.000 Token aus, trägt aber über vierzig Prozent des Betrags bei. Der Grund: Sein Stückpreis ist 2,5-mal so hoch wie der einer normalen Eingabe, und beim Schreiben selbst entstehen nur Kosten – der Ertrag kommt erst durch spätere Treffer zustande. Abschnitt 3 geht darauf gesondert ein.
Es empfiehlt sich, im Kostenbuch für jeden Abrechnungsposten sowohl die Token-Anzahl als auch den Tarif getrennt zu erfassen, statt nur einen Gesamtbetrag zu speichern. So kann man bei Abweichungen die tatsächlichen Werte aus dem Log direkt in die obige Tabelle einsetzen und die Quelle der Differenz Zeile für Zeile eingrenzen.
2.3 Lange Kontexte: erst die Tarife wechseln, dann dieselbe Formel anwenden
Wenn die Gesamteingabe 272K überschreitet, bleibt der Algorithmus unverändert; Sie müssen lediglich die gesamte Tarifspalte der obigen Tabelle durch die Werte für lange Kontexte ersetzen. Beachten Sie, dass der Wechsel für die gesamte Anfrage gilt: Cache-Lesen und Cache-Schreiben verdoppeln sich ebenfalls, die Ausgabe wird mit dem 1,5-fachen berechnet. Deshalb muss die Zuordnung zur kurzen oder langen Stufe unbedingt vor der Einzelmultiplikation erfolgen.
Bei Aufrufen über Drittanbieter-Kanäle müssen die Tarife auf die Preisbasis des jeweiligen Kanals umgestellt werden. Am Beispiel von APIYI apiyi.com: Beim erneuten Auslesen der öffentlichen Preis-API am 20.11.2026 verwendet die billing_expr von gpt-6.2-sol ebenfalls eine Stufengrenze bei 272.000 Eingabe-Tokens: kurze Stufe mit normaler Eingabe $2, Cache-Lesen $0,10, Cache-Schreiben $2,50 und Ausgabe $10; lange Stufe mit $3, $0,15, $3,75 und $11,25 (USD / Million Tokens). Man erkennt, dass die Multiplikatoren der langen Stufe von der offiziellen Direktverbindung abweichen und der Interface-Ausdruck nur einen einzigen Cache-Schreibpreis aufführt. Für die tatsächliche Gruppierung, Funktionalität und Abrechnung eines Projekts gelten die aktuelle Konfiguration und Abrechnung der Plattform.
Der folgende Code startet eine Responses-Anfrage über die OpenAI-kompatible Schnittstelle von APIYI und gibt die usage unverändert aus, damit sie später zur Neuberechnung verwendet werden kann:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "固定规则与公共资料(放在前部便于缓存复用)"},
        {"role": "user", "content": "本次请求的具体问题"},
    ],
    max_output_tokens=4000,
)

print(resp.id, resp.status)
print(resp.usage.model_dump())
Nachdem Sie die usage erhalten haben, wandeln Sie mit einer Funktion die fünf Nutzungswerte in Geldbeträge um. Die Tariftabelle wird als Parameter angelegt; beim Wechsel zwischen offizieller Preisbasis und Kanal-Preisbasis ändert sich nur die Konfiguration:
Vollständige Neuberechnungsfunktion anzeigen
LONG_THRESHOLD = 272_000

# Offizielle OpenAI-Standardtarife, USD / Million Token
OFFICIAL_RATES = {
    "short": {"input": 2.00, "cached": 0.10, "w30m": 2.50, "w12h": 5.00, "output": 10.00},
    "long":  {"input": 4.00, "cached": 0.20, "w30m": 5.00, "w12h": 10.00, "output": 15.00},
}

def _get(d, *keys, default=None):
    for k in keys:
        if not isinstance(d, dict) or k not in d:
            return default
        d = d[k]
    return d

def recalc_cost(usage: dict, rates: dict = OFFICIAL_RATES) -> dict:
    total_in = usage["input_tokens"]
    details = usage.get("input_tokens_details") or {}
    cached = details.get("cached_tokens", 0) or 0

    # Wo die Write-Felder liegen, hängt von der tatsächlichen Rückgabestruktur ab – hier werden beide Stellen geprüft
    write_total = details.get("cache_write_tokens", usage.get("cache_write_tokens"))
    ttl = details.get("cache_write_tokens_details") or usage.get("cache_write_tokens_details")
    if write_total is None:
        raise ValueError("缺少 cache_write_tokens,改用渠道出账记录,不要推定")
    w30 = _get(ttl, "ttl_30m_tokens")
    w12 = _get(ttl, "ttl_12h_tokens")
    if write_total and (w30 is None or w12 is None):
        raise ValueError("缺少写入寿命明细,无法区分 30m/12h 费率")
    w30, w12 = w30 or 0, w12 or 0

    plain = total_in - cached - write_total
    output = usage["output_tokens"]
    tier = "long" if total_in > LONG_THRESHOLD else "short"
    r = rates[tier]

    items = {
        "plain_input": plain * r["input"] / 1e6,
        "cache_read": cached * r["cached"] / 1e6,
        "write_30m": w30 * r["w30m"] / 1e6,
        "write_12h": w12 * r["w12h"] / 1e6,
        "output": output * r["output"] / 1e6,
    }
    items["tier"] = tier
    items["model_total"] = round(sum(v for k, v in items.items() if k != "tier"), 6)
    return items

# Mit der synthetischen usage aus Abschnitt 2.2 verifizieren
demo = {
    "input_tokens": 12000,
    "input_tokens_details": {
        "cached_tokens": 4000,
        "cache_write_tokens": 7000,
        "cache_write_tokens_details": {"ttl_30m_tokens": 3000, "ttl_12h_tokens": 4000},
    },
    "output_tokens": 1800,
    "output_tokens_details": {"reasoning_tokens": 1200},
}
print(recalc_cost(demo))  # model_total: 0.0479
Die Funktion bricht bei fehlenden Feldern sofort mit einem Fehler ab, statt den Wert als 0 zu behandeln. Damit wird vermieden, dass eine Anfrage ohne Write-Details fälschlich als „alles normaler Input“ durchgerechnet wird.
🎯 Technischer Tipp: Beim Aufbau eines Kosten-Ledgers solltest du die Nachrechnungsfunktion zuerst mit synthetischen usage-Daten zum Laufen bringen und erst danach echte Logs anbinden. Über APIYI apiyi.com kannst du mit demselben API-Schlüssel kleine Testanfragen mit geringem Volumen starten, die zurückgegebenen usage-Werte Punkt für Punkt mit der Plattformabrechnung abgleichen und erst nach Bestätigung der Felddefinition die Statistik live schalten.
3 Auswahl der Cache-Lebensdauer von GPT-6.2 Sol nach Aufrufrhythmus
3.1 Die Rechnung bei zwei und drei Zugriffen auf denselben Präfix
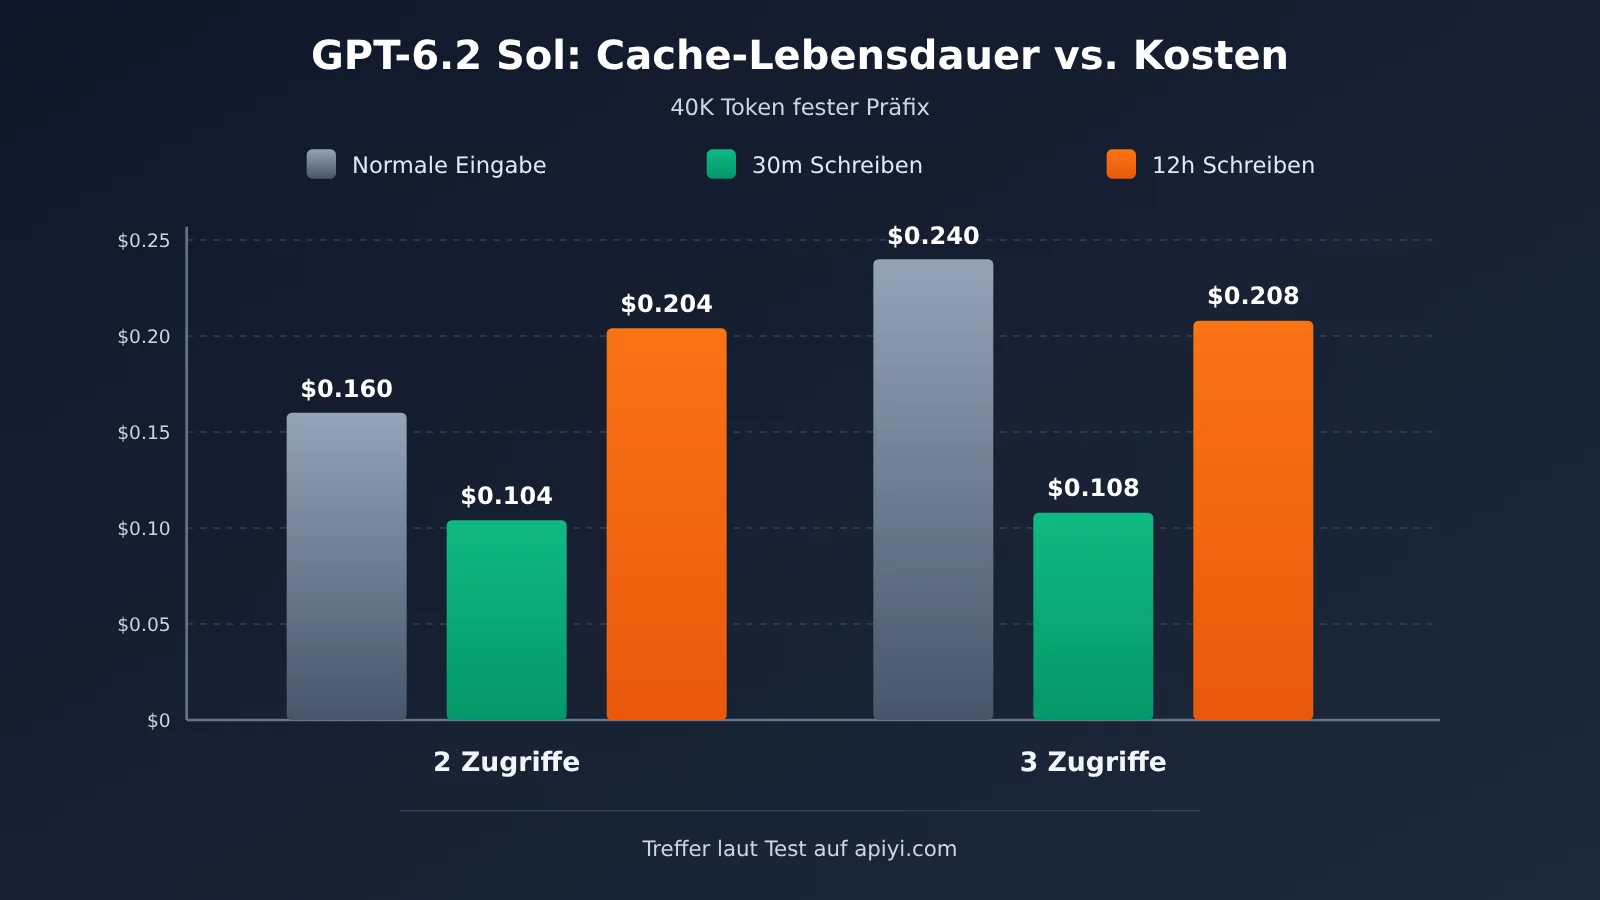
Nehmen wir einen festen Präfix von 40.000 Token an (Systemvorgaben plus öffentliche Unterlagen), abgerechnet nach dem Standardtarif für kurzen Kontext. Die einzelnen Kosten fallen wie folgt an: pro Anfrage als normale Eingabe $0.08, der erste Schreibvorgang mit 30 Minuten Laufzeit $0.10, der erste Schreibvorgang mit 12 Stunden Laufzeit $0.20, ein vollständiger Treffer beim Lesen $0.004. Die folgende Tabelle vergleicht nur den festen Präfixanteil, ohne den variierenden Inhalt und die Ausgabe jeder Anfrage.
| Zugriffsmodus | Normale Eingabe | 30m-Schreibplan | 12h-Schreibplan |
|---|---|---|---|
| 2 Zugriffe (1 Schreiben + 1 Lesen) | $0.160 | $0.104 | $0.204 |
| 3 Zugriffe (1 Schreiben + 2 Lesen, alle im Fenster) | $0.240 | $0.108 | $0.208 |
Bei zwei Zugriffen ist der 12h-Schreibvorgang sogar $0.044 teurer als ohne Caching. Bei drei Zugriffen sind beide Cache-Varianten günstiger als die normale Eingabe, aber der 30m-Plan kostet weiterhin nur etwa die Hälfte des 12h-Plans. Voraussetzung ist, dass diese Zugriffe alle in das 30-Minuten-Fenster fallen.
3.2 Break-even: Wie viele Treffer bis zur Amortisation
Die obigen Zahlen werden intuitiver, wenn man sie aus einem anderen Blickwinkel betrachtet (die folgenden Berechnungen basieren auf den M3-Tarifen). Jeder vollständige Treffer spart im Vergleich zu einer normalen Eingabe $0.076. Ein 30-Minuten-Write kostet $0.02 mehr als eine normale Eingabe und ist mit einem Treffer bereits amortisiert. Ein 12-Stunden-Write kostet $0.12 mehr und erfordert mindestens zwei Treffer innerhalb des Fensters, um sich zu amortisieren.
Der Wert des 12-Stunden-Writes liegt daher nicht darin, „innerhalb desselben Fensters mehr Treffer zu erzielen“, sondern darin, auch dann noch einen Treffer zu erzielen, wenn der Abstand zwischen den Aufrufen mehr als 30 Minuten beträgt. Wenn aufeinanderfolgende Anfragen mit demselben Präfix in der Regel nur wenige Minuten auseinanderliegen, reicht der 30-Minuten-Write aus; die Wahl des 12-Stunden-Writes führt dann nur zu zusätzlichen Write-Kosten. Treffen die Anfragen dagegen nur alle ein bis zwei Stunden ein, ist der 30-Minuten-Cache längst abgelaufen, und jedes Mal muss neu geschrieben werden. In diesem Fall kann der 12-Stunden-Write zusammen mit mehreren Treffern erst dann günstiger sein.
Zwei weitere Punkte können die Einschätzung verändern. Die TTL ist die minimale Abdeckungsdauer für die Abrechnung und bedeutet nicht, dass der Cache unbedingt so lange erhalten bleibt; letztlich kommt es auf die tatsächliche Lesemenge in usage an. Beim 30-Minuten-Write gibt es beim Lesen eine Refresh-Regel; in Szenarien mit hoher Frequenz kann die tatsächliche Abdeckung länger als die nominalen 30 Minuten sein. Deshalb sollte man nach der Auswahl anhand echter Trefferaufzeichnungen nachprüfen, statt nur die Konfiguration zu betrachten.
3.3 Breakpoint-Layout: Stabile Inhalte nach vorne sortieren
Caching wirkt nur auf Präfixe, und das kleinste cachebare Präfix umfasst 1.024 sichtbare Eingabe-Token. In der Praxis lassen sich Breakpoints entsprechend den Wiederverwendungszyklen in mehreren Schichten setzen:
- Langfristig wiederverwendetes öffentliches Material wie Produkthandbücher, Zusammenfassungen der Codebasis: ganz nach vorne, ggf. mit einer Schreibdauer von 12 Stunden.
- Kurzfristig gültige Sitzungsprotokolle wie der Gesprächsverlauf dieser Runde: danach, ggf. mit einer Schreibdauer von 30 Minuten.
- Sofortige Anweisungen, die sich bei jeder Anfrage ändern: ganz ans Ende und nicht in den Cache aufnehmen.
Bei GPT-6.2 gibt es eine leicht zu übersehende Positionsbesonderheit: Das Top-Level-Feld instructions liegt hinter dem cachebaren Breakpoint. Wenn feste Regeln in instructions geschrieben werden, kann dieser Teil nicht wiederverwendet werden. Feste Regeln gehören besser in Developer-Nachrichten am Anfang von input; instructions bleibt für Inhalte reserviert, die sich bei jeder Anfrage ändern können.
💡 Auswahlhinweis: Die Cache-Lebensdauer sollte man anhand des tatsächlichen Traffic festlegen. Empfohlen: Zuerst auf APIYI apiyi.com mit demselben Präfix in realistischem Rhythmus einige Anfragen senden, die Trefferquote von
cached_tokensauswerten und dann entscheiden, welche Schicht 30 Minuten und welche 12 Stunden verwendet. Je nach Kanal kann die Preisgestaltung für Cache-Schreibvorgänge unterschiedlich sein — maßgeblich ist die Abrechnung der Plattform.
4 GPT-6.2 Sol-Kosten pro Workflow aggregieren und Abweichungen nachverfolgen
4.1 Drei Anfragezustände, die die Abrechnung von den Erwartungen abweichen lassen
Auch wenn eine einzelne Anfrage korrekt berechnet wurde, kann die Gesamtrechnung eines Workflows trotzdem nicht aufgehen. Häufige Ursachen hängen mit dem Anfragezustand zusammen:
- incomplete: Wenn die Ausgabe
max_output_tokenserreicht, kann die Antwort mitincompleteenden. Dann liegt möglicherweise noch kein sichtbarer Text vor, aber Eingabe- und Reasoning-Tokens wurden bereits erzeugt und abgerechnet. Werden nur Anfragen mit „erfolgreich zurückgegebenem Inhalt“ gezählt, fehlen diese Kosten. - Hintergrundaufgaben: Bei einer Hintergrundaufgabe mit bereits vorhandener Antwort-ID wird beim Polling dieselbe ID verfolgt. Jedes Polling darf nicht als neue Anfrage erneut verbucht werden.
- Wiederholungen: Eine wegen Timeout oder
incompleteneu ausgelöste eigenständige Anfrage erzeugt eine neue Antwort und muss separat verbucht werden. Je mehr Wiederholungen, desto häufiger werden die Eingabekosten derselben Aufgabe erneut bezahlt.
4.2 Tool-Gebühren und Folge-Tokens durch Tools
Responses unterstützt Tools wie Dateisuche, Websuche, Code-Interpreter und Bilderzeugung. Bei der Bilderzeugung startet Sol im Ablauf einen Tool-Aufruf; das Bild wird von einem separaten Bild-Tool erzeugt, und die Kosten werden ebenfalls nach den Tool-Regeln berechnet. Tool-Gebühren werden nach dem tatsächlichen Typ geprüft, zum Beispiel Websuche mit $10 pro 1.000 Aufrufe; die von der Suche zurückgegebenen Inhalts-Tokens werden zusätzlich nach dem Modelltarif berechnet.
Bei der Nachberechnung muss geprüft werden, welche Tokens die usage-Angaben abdecken. Wenn Tool-Ergebnisse in die nächste Modellanfrage zurückgespielt werden, zeigt sich das als erhöhte Eingabemenge der Folgeanfrage; diese Kosten fallen bei der Folgeanfrage an, nicht beim Tool-Aufruf selbst. Bei einem Workflow mit Suche besteht die Abrechnung normalerweise aus zwei Teilen: „Tool-Nutzungsgebühr + Gebühren für mehrere Modellanfragen“.
4.3 Minimale Logfelder
Damit ein Workflow abgestimmt werden kann, sollte jede Modellantwort mindestens die folgenden Felder protokollieren:
| Logfeld | Zweck |
|---|---|
| Workflow-ID | Ordnet mehrere Anfragen derselben Aufgabe zu |
| Antwort-ID | Verknüpft Hintergrund-Polling und unterscheidet Wiederholungen von derselben Anfrage |
| Modell | Bestimmt die Tariftabelle, z. B. gpt-6.2-sol |
| Service-Stufe | Bestätigt, ob die Standard-Berechnungsgrundlage gilt |
| Endstatus | Identifiziert completed, incomplete usw. |
| Verbrauchsaufschlüsselung | Reguläre Eingabe, Lesevorgänge, 30m-Schreibvorgänge, 12h-Schreibvorgänge, Ausgabe, Reasoning |
| Tool | Tool-Typ und Anzahl der Aufrufe |
| Kosten | Nach Einzelposten nachgerechneter Betrag und Kennzeichnung Kurz-/Langkontext |
Mit dieser Tabelle lässt sich durch Gruppieren und Summieren nach Workflow-ID der Kostenaufwand einer einzelnen Aufgabe ermitteln. Auch die Abweichungsanalyse hat eine Reihenfolge: zuerst prüfen, ob incomplete und Wiederholungen vorliegen, dann, ob die Cache-Lesevorgänge unter den Erwartungen liegen, und schließlich die Tool-Aufrufe kontrollieren.
4.4 Schätzung pro Anfrage und offizieller Export im Abgleich
Eine Schätzung pro Anfrage eignet sich für die Echtzeit-Budgetkontrolle, kann aber bei mehrstufigen Tool-Aufrufen, Wiederholungen oder fehlenden Verbrauchsfeldern leicht abweichen. Es empfiehlt sich, die geschätzten Summen regelmäßig mit dem offiziellen Verbrauchs- oder Kostenexport abzugleichen. Liegt die Abweichung über einem festgelegten Schwellenwert, sollte man anhand der Logs Zeile für Zeile nachprüfen. Bei einer Weiterleitung über Drittanbieter-Kanäle sollten stattdessen die Abrechnungsfelder und Tarifsätze dieses Kanals als Vergleichsbasis dienen.
💰 Kostentipp: Wenn ein Team gleichzeitig mehrere Modelle nutzt, kann es über APIYI unter apiyi.com mit einem einzigen API-Schlüssel zentral aufrufen und die Ergebnisse dann gemäß den minimalen Logfeldern aus diesem Artikel in der Datenbank ablegen. Ein einheitlicher Einstiegspunkt hält Workflow-IDs und Kostenberechnung konsistent; beim Monatsabschluss entfällt eine Ebene der Kanalumrechnung.
So prüfen Sie die Abrechnung für GPT-6.2 Sol
Für jeden Sol-Anforderungsdatensatz lässt sich die Abrechnung in dieser Reihenfolge prüfen: Zuerst stellen Sie fest, ob die Gesamteingabe 272K überschreitet, und wählen die passende Tarifspalte. Dann ziehen Sie von input_tokens die gelesenen sowie alle geschriebenen Token ab und erhalten so die normale Eingabe. Anschließend multiplizieren Sie die fünf Posten jeweils mit dem Tarif, addieren die Ergebnisse und vergleichen sie mit der Abrechnung. Wenn ein einzelner Aufruf übereinstimmt, die Workflow-Summe aber abweicht, suchen Sie in den Logs nach incomplete, Wiederholungen und Tool-Aufrufen.
Ob Caching sich lohnt, zeigt sich letztlich an der tatsächlichen Lesemenge in usage und am Abstand zwischen den Aufrufen. Beim 30-Minuten-Schreibvorgang reicht ein Treffer, um die Kosten wieder hereinzuholen; beim 12-Stunden-Schreibvorgang sind innerhalb des Zeitfensters mindestens zwei Treffer nötig, und der Vorteil zeigt sich nur, wenn die Aufrufe mehr als 30 Minuten auseinanderliegen.
Wenn Sie diese Schlussfolgerungen mit echtem Traffic überprüfen möchten, können Sie bei APIYI apiyi.com ein kostenloses Testkontingent beantragen und mit der Nachrechnungsfunktion aus diesem Artikel die Plattformabrechnung Eintrag für Eintrag abgleichen.
📚 Referenzen
-
OpenAI-Ankündigung zu GPT-6.2 Astra und Sol: Veröffentlichungsdatum und Produktpositionierung
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Erläuterung: Verstehen, wie Sol für alltägliche Arbeit und mehrstufige Agenten positioniert ist
- Link:
-
Modellkarte GPT-6.2 Sol: Kontextspezifikationen, Tarife und Langkontext-Multiplikator
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Erläuterung: Quelle für die Tariftabelle und die 272K-Staffelregel in diesem Artikel
- Link:
-
Prompt-Caching-Leitfaden und Cache-Diagnose: Cache-Felder, TTL und Breakpoint-Regeln
- Link:
developers.openai.com/api/docs/guides/prompt-caching - Erläuterung: Erklärt
cached_tokens, die Lebensdauer von Schreibvorgängen und den kleinsten cachefähigen Präfix
- Link:
-
Reasoning-Leitfaden: Reasoning-Token und
incomplete-Status- Link:
developers.openai.com/api/docs/guides/reasoning - Erläuterung: Verstehen, wie der Reasoning-Verbrauch in die Ausgabe eingerechnet wird
- Link:
-
Leitfaden zur Kostenkontrolle einzelner Workflows: Responses-Kosten pro Workflow summieren
- Link:
developers.openai.com/cookbook/articles/per_run_spending_controller_responses_api - Erläuterung: Referenzimplementierung für Budgetkontrolle auf Workflow-Ebene
- Link:
-
APIYI-Modellübersicht: Kanalangebote und Zugangsinformationen
- Link:
docs.apiyi.com/models.md - Erläuterung: Verfügbare Zugänge und Gruppierungen für gpt-6.2-sol ansehen
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI apiyi.com. Weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com.