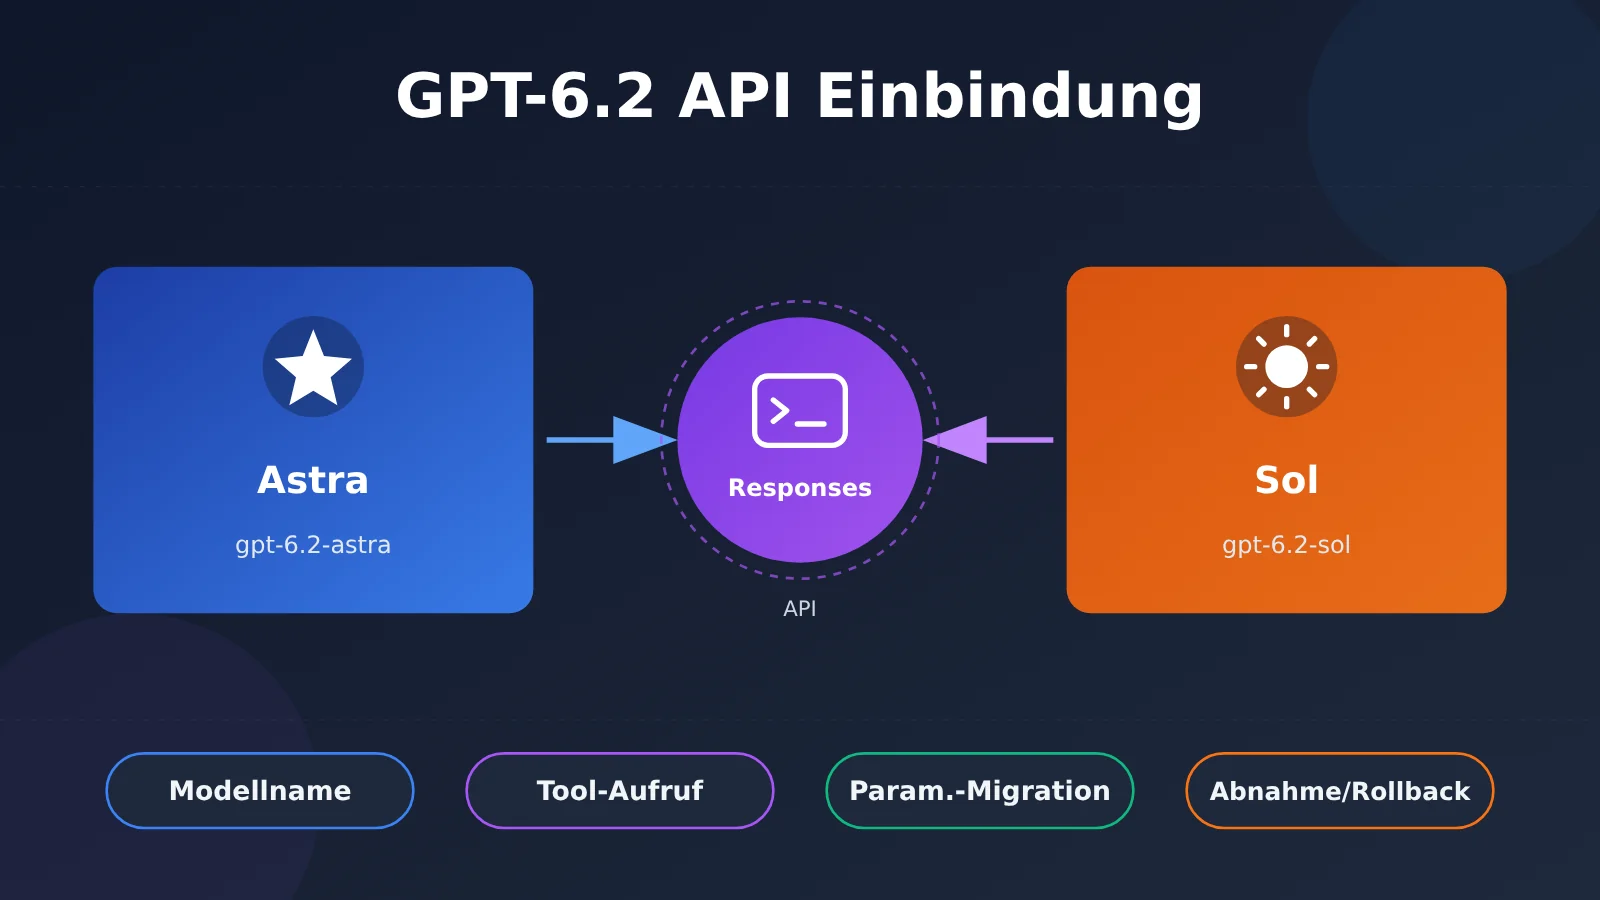
Direkte Antwort: Wenn Sie die GPT-6.2-API anbinden, ändern Sie den Modellnamen auf gpt-6.2-astra oder gpt-6.2-sol. Bei einer Neueinbindung empfehlen wir den Reasoning-Aufwand medium; in älterem Code müssen none oder minimal auf low geändert werden. Reine Textanfragen können weiterhin Chat Completions verwenden, doch sobald Tool-Aufrufe im Spiel sind, ist die Responses API zwingend erforderlich. Außerdem sind Sampling-Parameter wie temperature, top_p usw. zu entfernen. Bei einer Migration von GPT-5.5 oder älteren Versionen müssen Sie zudem die Cache-Parameter auf prompt_cache_options.ttl="30m" umstellen. Am häufigsten wird bei der Migration das historische Präfix übersehen: Neue Anweisungen sollten an die bestehende Historie angehängt und die Historie nicht neu geschrieben werden.
Was Sie nach dem Lesen dieses Artikels wissen:
- Welche gesicherten Informationen es zu den am 17. November 2026 von OpenAI veröffentlichten Modellen GPT-6.2 Astra und Sol gibt und welche Aussagen offizielles Benchmark-Marketing sind.
- Die Standard-API-Preise der beiden Modelle sowie den Abrechnungsfaktor, sobald die Eingabe 272K überschreitet.
- Eine nach Versionen aufgeschlüsselte Parameter-Migrationsliste: Welche Änderungen gelten für alle GPT-6.2-Migrationen, welche nur für GPT-5.5 und ältere Versionen.
- Ein an das offizielle Format angelehntes Beispiel für eine Tool-Aufrufschleife mit der Responses API.
- Diagnoseansätze für häufige Fehler sowie eine Checkliste für Canary-Abnahme und Rollback.
Index: Vereinheitlichen Sie zunächst über „To Know“ und „Kurzüberblick zu den Auswirkungen“ die Begriffe und verschaffen Sie sich einen Überblick darüber, wie die verschiedenen Rollen betroffen sind. Teil eins „Objektive Fakten“ fasst die Veröffentlichungsinformationen, offiziellen Benchmarks, Preise und die Kernpunkte des Migrationsleitfadens im Original zusammen. Teil zwei „Migrationspraxis und analytische Einschätzung“ behandelt der Reihe nach Modellauswahl, Minimalbeispiel, Parameterliste, Tool-Schleife, Fehlerdiagnose sowie Abnahme und Rollback; dieser Teil ist redaktionelle Einschätzung und praktische Empfehlung.
GPT-6.2 API im Überblick: Begriffe verständlich erklärt
| Begriff | Kurze Erläuterung |
|---|---|
| GPT-6.2 Astra / Sol | Die beiden Modelle, die OpenAI in dieser Runde veröffentlicht. Die API-Modellnamen lauten gpt-6.2-astra und gpt-6.2-sol. Astra ist teurer, Sol günstiger. |
| Responses API | Die neuere einheitliche Schnittstelle von OpenAI. Tool-Aufrufe von GPT-6.2 müssen über diese Schnittstelle laufen. |
| Chat Completions | Die klassische Chat-Completion-Schnittstelle. GPT-6.2 unterstützt sie weiterhin für reine Textanfragen. |
| reasoning effort | Die Intensitätsstufe für das Reasoning. Für neue Integrationen empfiehlt OpenAI offiziell medium. |
| Reasoning-Elemente (reasoning items) | Reasoning-bezogene Ausgabeelemente, die das Modell in der Antwort zurückgibt. In mehrstufigen Dialogen und Tool-Schleifen müssen sie unverändert zurückgegeben werden. |
| Verlaufspräfix | Die in einem mehrstufigen Dialog bereits gesendete Eingabesequenz. Sie unverändert zu lassen, hilft bei Cache-Treffern und sorgt für eine konsistente Inferenz. |
| Prompt-Caching | Beim Prompt-Caching können wiederholte Präfixe zum niedrigeren Preis für Cache-Lesevorgänge abgerechnet werden. |
| GDPval v2 / ALE / FrontierCode 2.0 | Namen von Benchmarks, die OpenAI in den Veröffentlichungsmaterialien zitiert. Die Scores der drei lassen sich nicht miteinander vergleichen und dürfen nicht vermischt werden. |
GPT-6.2 API – Auswirkungen auf einen Blick
- Entwickler, die bereits OpenAI-API-Anwendungen betreiben: Der Modellname ist schnell ausgetauscht – die eigentliche Arbeit steckt in der Bereinigung der Parameter und dem Wechsel der Schnittstelle. Anwendungen mit Chat Completions und function calling müssen auf die Responses API umgestellt werden; das macht den größten Teil des Aufwands in dieser Migrationsrunde aus.
- Anwendungen, die auf Sampling-Parametern basieren: Systeme, die den Ausgabestil über
temperatureundtop_psteuern oderlogprobszur Einschätzung der Konfidenz heranziehen, verlieren diese Möglichkeiten in GPT-6.2 und müssen einen anderen Weg finden. - Verantwortliche für die Kosten: Die Stückpreise von Astra und Sol unterscheiden sich um Faktor 4. Bei Anfragen mit langem Kontext über 272K steigt die Abrechnung für die gesamte Anfrage, deshalb muss das Budget anhand der tatsächlichen Verteilung der Anforderungslängen neu kalkuliert werden.
- Normale ChatGPT-Nutzer: In dieser Runde sind ChatGPT Work, Codex und die API freigegeben – der normale Chat gehört nicht zum Umfang dieses Rollouts.
1. GPT-6.2 API – belegte Fakten
Dieser Abschnitt fasst ausschließlich Informationen aus dem offiziellen OpenAI-Material zusammen, Stand der Prüfung: 18. November 2026. Alle Benchmark-Daten in diesem Artikel stammen aus den offiziellen OpenAI-Berichten und nicht aus eigenen Messungen des Teams.
1.1 Veröffentlichungsdatum, Modellnamen und Verfügbarkeitsumfang der GPT-6.2 API
OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Die API-Modellnamen lauten gpt-6.2-astra und gpt-6.2-sol. Beide Modelle akzeptieren Text- und Bildeingaben und geben Text aus; eine native Videogenerierung bieten sie nicht.
Der Rollout erfolgt schrittweise und umfasst ChatGPT Work, Codex und die API – das normale ChatGPT Chat gehört in dieser Runde nicht dazu. Daher können einzelne Konten oder Organisationen diese beiden Modelle kurzfristig möglicherweise noch nicht aufrufen. Vor dem offiziellen Wechsel sollte man die Verfügbarkeit zunächst in der eigenen Organisation prüfen.
1.2 Offizielle Benchmark-Daten zur GPT-6.2 API (offizielle Marketing-Darstellung)
OpenAI nennt in den Veröffentlichungsunterlagen die folgenden Benchmark-Ergebnisse. Jede Angabe gilt nur innerhalb ihres jeweiligen Benchmarks:
- GDPval v2: GPT-6.2 Astra liegt 6,2 Prozentpunkte über GPT-6 Astra und erzeugt 22 % weniger Ausgabe-Token. GPT-6.2 Sol liegt 5,3 Prozentpunkte über GPT-6.1 Sol.
- Agents‘ Last Exam (ALE): GPT-6.2 Astra verbessert sich gegenüber GPT-6 Astra um 5,2 Punkte.
- FrontierCode 2.0: In der max-Reasoning-Stufe unterscheiden sich Sol und Astra um 0,5 Punkte, wobei die Aufgabenkosten etwa 1/5 von Astra betragen. Dies ist lediglich eine Schlussfolgerung aus diesem Test und lässt sich nicht zu einer allgemeinen Kostenaussage verallgemeinern.
Diese drei Zahlengruppen verwenden unterschiedliche Einheiten und Vergleichsbasen. Sie lassen sich weder addieren noch gegeneinander ranken. So liegen etwa die „6,2 Prozentpunkte“ von GDPval v2 und die „5,2 Punkte“ von ALE nicht auf derselben Skala.
1.3 Standardpreise der GPT-6.2-API
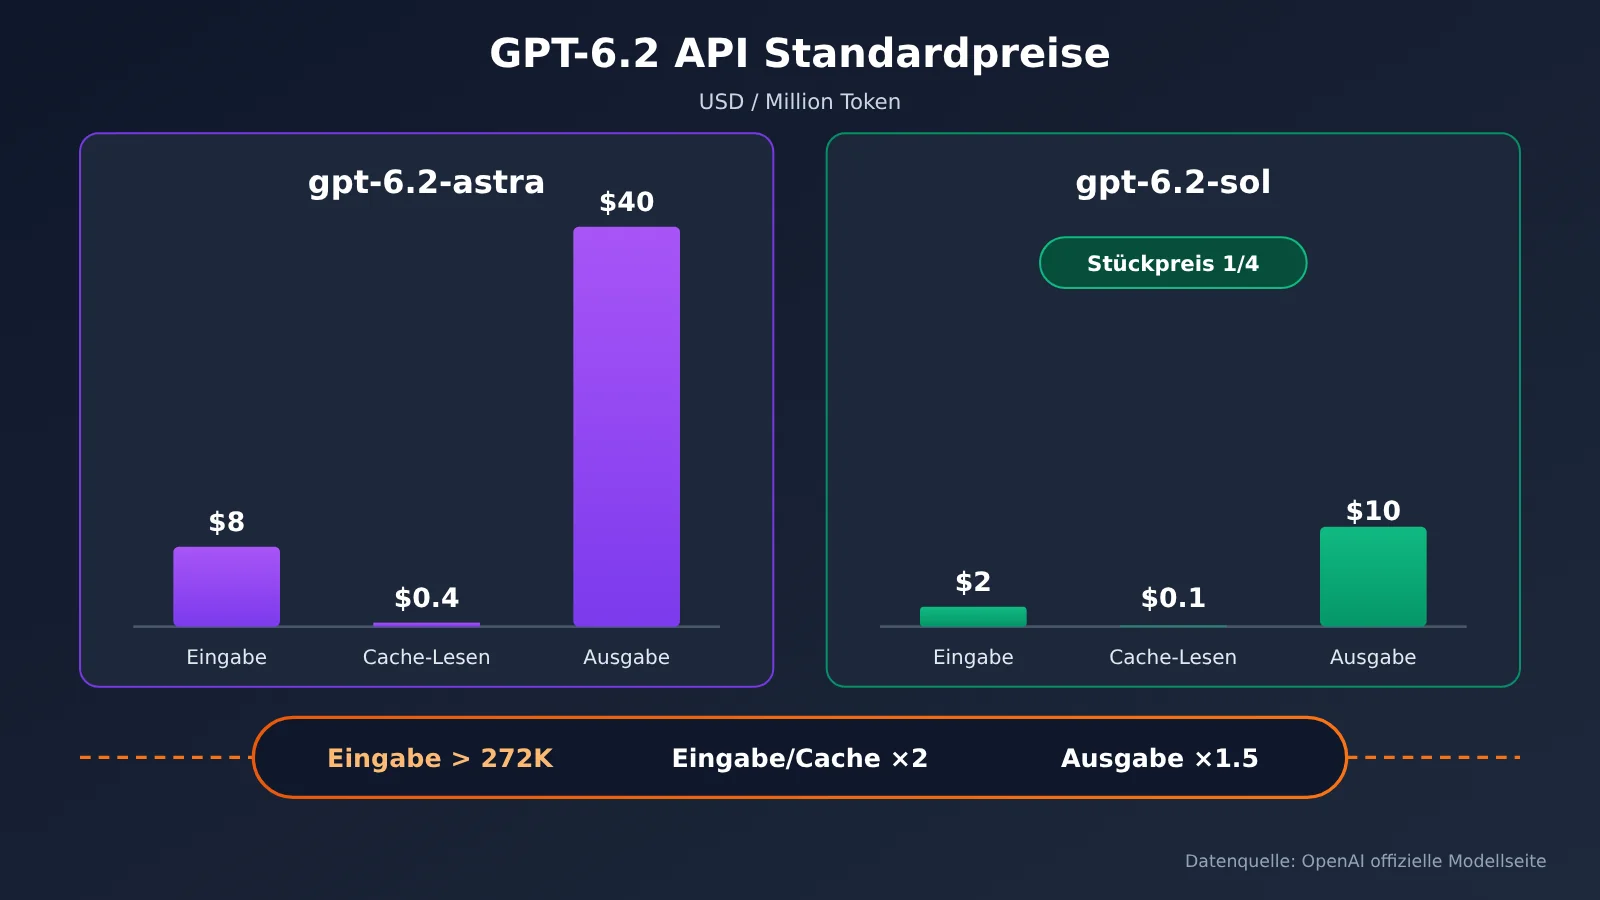
Die folgende Tabelle zeigt die offiziellen Standardpreise der API in US-Dollar pro Million Token:
| Modell | Input ohne Cache | Cache-Lesen | Output | Bei Input über 272K |
|---|---|---|---|---|
gpt-6.2-astra |
$8 | $0.4 | $40 | Input- und Cache-Tarif für die gesamte Anfrage ×2, Output ×1.5 |
gpt-6.2-sol |
$2 | $0.1 | $10 | Input- und Cache-Tarif für die gesamte Anfrage ×2, Output ×1.5 |
Dazu zwei Hinweise. Erstens: Das Schreiben in den Cache wird separat abgerechnet und ist in der Tabelle nicht aufgeführt. Zweitens: Der Aufschlag für langen Kontext gilt für die gesamte Anfrage. Sobald also der Input einer Anfrage 272K übersteigt, wird der komplette Input dieser Anfrage mit dem doppelten Satz berechnet – nicht nur der Teil, der über der Grenze liegt.
1.4 Kernpunkte des offiziellen Migrationsleitfadens für die GPT-6.2 API
Der aktuelle Modell-Migrationsleitfaden von OpenAI (Seite „latest-model“) listet folgende Anpassungen auf:
| Punkt | Chat Completions | Responses API | Geltungsbereich |
|---|---|---|---|
| Tool-Aufrufe | Nicht unterstützt, Sie müssen auf Responses umsteigen | Unterstützt | Alle Anwendungen, die auf GPT-6.2 migrieren |
| Sampling-Parameter | temperature, top_p entfernt |
temperature, top_p entfernt |
Alle Migrationen |
| Wahrscheinlichkeitsausgaben | logprobs, top_logprobs entfernt |
top_logprobs entfernt sowie message.output_text.logprobs aus include gestrichen |
Alle Migrationen |
| Reasoning-Aufwand | Bei neuen Integrationen medium verwenden; none, minimal werden zu low |
Wie links | Alle Migrationen |
| Cache-Beibehaltung | prompt_cache_retention wird zu prompt_cache_options.ttl="30m" |
Wie links | Migration von GPT-5.5 und früheren Versionen |
Zu Multi-Turn-Dialogen weist der Leitfaden außerdem ausdrücklich darauf hin: Der vorhandene Verlaufspräfix sollte beibehalten werden, neue Anweisungen werden hinten angehängt, nicht neu geschrieben. Beim Herabstufen des Modells oder beim Wechsel von Benutzer oder Organisation können Reasoning-Elemente verloren gehen.
2. GPT-6.2-API-Migration in der Praxis: Erfahrungen und Einschätzungen
Dieser Abschnitt enthält die Einschätzung und die praktischen Empfehlungen der Redaktion auf Basis der oben genannten offiziellen Informationen. Der Code wurde an das Format der offiziellen Dokumentation angepasst, aber nicht durch Ausführung verifiziert. Bitte vor der Integration Punkt für Punkt mit der offiziellen Dokumentation abgleichen.
2.1 Modellauswahl bei der GPT-6.2-API: erst Sol, dann Astra
Betrachtet man nur die offiziellen Preise, so kosten Eingabe und Ausgabe bei Sol jeweils nur ein Viertel von Astra. Das Ergebnis in FrontierCode 2.0 – „Sol und Astra unterscheiden sich um 0,5 Punkte, die Kosten liegen bei etwa einem Fünftel“ – deutet darauf hin, dass Sol bei bestimmten Programmieraufgaben ein besonders gutes Preis-Leistungs-Verhältnis bieten könnte. Allerdings stammt diese Schlussfolgerung aus einer einzigen Evaluation. Ob sie für dein Geschäft gilt, lässt sich nur mit eigenen Daten überprüfen.
Die von der Redaktion empfohlene Standardstrategie lautet: Zuerst gpt-6.2-sol über das gesamte Regressionsset laufen lassen, dann die Aufgabentypen herausfiltern, bei denen Sol die Qualitätsanforderungen nicht erfüllt, und für genau diese Aufgaben Astra evaluieren. Außerdem ist zu beachten: Die Angabe „22 % weniger Ausgabe-Token“ für Astra in GDPval v2 bezieht sich auf den Vergleich mit GPT-6 Astra und lässt sich nicht direkt nutzen, um den Preisunterschied zwischen Astra und Sol auszugleichen.
💡 Empfehlung zur Auswahl: Für Vergleichstests zwischen Astra und Sol dieselbe Regressionsmenge und dieselbe Inferenzstufe verwenden und Qualität, Latenz sowie Token-Verbrauch getrennt erfassen. Wenn du mehrere Modelle über eine einzige Schnittstelle vergleichen möchtest, kannst du zuerst in der Modellliste von APIYI apiyi.com prüfen, ob die GPT-6.2-Serie bereits angeboten wird. Falls nicht, nutze bitte direkt die offizielle OpenAI-API.
2.2 Minimales Responses-Beispiel für die GPT-6.2 API
Das Folgende ist ein minimales Beispiel für einen reinen Textaufruf, das die Responses API mit der Reasoning-Stufe medium verwendet. Installieren oder aktualisieren Sie zuerst das offizielle Python SDK: python -m pip install --upgrade openai. Konfigurieren Sie OPENAI_API_KEY in Ihrer Laufzeitumgebung und schreiben Sie niemals einen echten Schlüssel in Code, Artikel oder Versionsverwaltung. Im Folgenden wird standardmäßig die offizielle OpenAI-API aufgerufen.
import os
from openai import OpenAI

# Angelehnt an das Format der offiziellen Dokumentation, nicht durch Ausführung verifiziert
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # Ruft standardmäßig die offizielle OpenAI-API auf

response = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "medium"},
    input="用三句话说明什么是提示词缓存。"
)
print(response.output_text)
Im Beispiel sind temperature und top_p bewusst nicht angegeben, da GPT-6.2 diese beiden Parameter entfernt hat. Falls Ihre Wrapper-Funktion sie standardmäßig mitschickt, müssen Sie sie in der Aufrufebene einheitlich herausfiltern.
🎯 Technischer Hinweis: Wenn Sie einen Drittanbieterdienst wie APIYI apiyi.com anbinden, prüfen Sie zuerst dessen offizielle Dokumentation, Modellliste, Responses-Unterstützung und tatsächliche Preise und konfigurieren Sie dann seine Adresse und den von ihm ausgestellten speziellen Schlüssel. Senden Sie niemals den offiziellen OpenAI-Schlüssel an eine Drittanbieteradresse. In diesem Artikel wurde die Kompatibilität der Drittanbieter-Schnittstelle nicht verifiziert.
2.3 Migrationscheckliste für GPT-6.2-API-Parameter
Die Migrationscheckliste ist nach Ausgangsversion in zwei Gruppen aufgeteilt, damit Änderungen, die nur für ältere Versionen gelten, nicht versehentlich auf alle Projekte angewendet werden.
2.3.1 Was alle Projekte tun müssen, die auf GPT-6.2 migrieren
- Ersetzen Sie den Modellnamen durch
gpt-6.2-astraodergpt-6.2-solund verwalten Sie ihn zentral im Konfigurationscenter, damit später ein Rollback möglich ist. - Entfernen Sie
temperatureundtop_p. Wenn Sie bisher niedrige Temperaturen genutzt haben, um stabilere Ausgaben zu erhalten, können Sie stattdessen auf klarere Anweisungen, strukturierte Ausgabeformate oder Validierungslogik umsteigen. - Bei Projekten, die Chat Completions verwenden, entfernen Sie
logprobsundtop_logprobs. Bei Projekten mit Responses entfernen Sietop_logprobsund nehmenmessage.output_text.logprobsaus deminclude-Array heraus. - Reasoning-Stufe: Verwenden Sie bei neuen Integrationen standardmäßig
medium, und ändern Sie bisherige Einstellungennoneoderminimalinlow. - Alle Anfragen mit
toolssollten grundsätzlich auf die Responses API umgestellt werden.
2.3.2 Was nur bei einer Migration von GPT-5.5 und älteren Versionen zu tun ist
- Ändern Sie
prompt_cache_retentioninprompt_cache_options.ttl="30m". - Prüfen Sie nach der Migration, ob die Cache-Trefferquote normal ist. Der Preis für Cache-Lesevorgänge beträgt nur 1/20 des Preises für nicht gecachte Eingaben – eine sinkende Trefferquote treibt die Kosten direkt in die Höhe.
Wenn Sie von GPT-6 oder GPT-6.1 migrieren, sollten Sie die Punkte aus Checkliste 2.3.1 trotzdem einzeln durchgehen. Auch bei Tool-Calling-Code, der bereits Responses verwendet, sollten Sie prüfen, ob keine entfernten Parameter mehr übrig geblieben sind.
2.4 GPT-6.2-API: Tool-Schleifen und Verlaufs-Präfix
Tool-Aufrufe sind der riskanteste Teil dieser Migration. In der Responses-API umfasst eine vollständige Tool-Schleife vier Schritte: Das Modell gibt ein function_call-Element zurück; dein Code führt die entsprechende Funktion aus; das Ergebnis wird als function_call_output an die Eingabe angehängt; anschließend wird das Modell erneut angefragt. Das Modell kann weitere Tools anfordern – geh also nicht davon aus, dass die zweite Antwort zwangsläufig die finale Antwort ist.
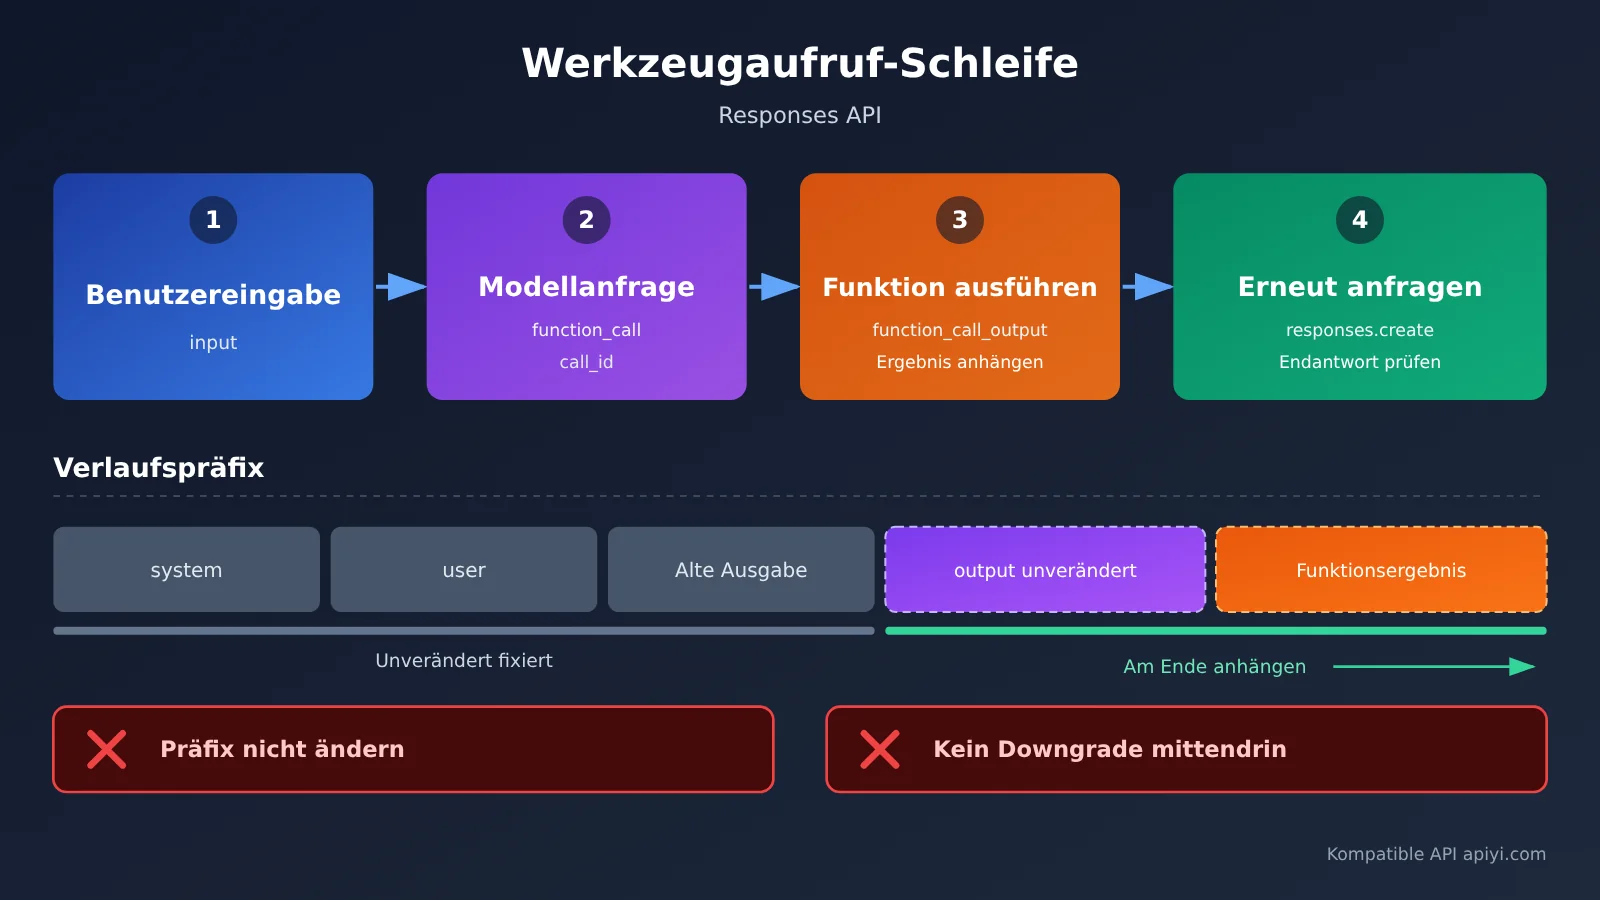
Die entscheidende Regel lautet: Das vom Modell zurückgegebene output wird unverändert an den Verlauf angehängt – ohne Filterung und ohne neu zusammenzusetzen. Die Reasoning-Elemente sind Teil dieser Ausgaben. Wenn du nur die Textteile behältst oder frühere system-Anweisungen mittendrin umschreibst, können spätere Runden die Reasoning-Kontinuität verlieren, und das Cache-Präfix wird ungültig.
Beispiel für einen einzelnen Funktionsaufruf ansehen (vom offiziellen Format abgewandelt, nicht ausgeführt/getestet)
import os
import json
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # Ruft standardmäßig die offizielle OpenAI-API auf

MODEL = "gpt-6.2-sol"

tools = [{
    "type": "function",
    "name": "get_order_status",
    "description": "根据订单号查询订单状态",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False
    },
    "strict": True
}]

def get_order_status(order_id: str) -> dict:
    # Durch deine echte Geschäftslogik ersetzen
    return {"order_id": order_id, "status": "shipped"}

# Vorhandenes Verlaufs-Präfix: unverändert lassen, nur am Ende anhängen
history = [
    {"role": "user", "content": "帮我查一下订单 A1024 的状态"}
]

first = client.responses.create(
    model=MODEL,
    input=history,
    tools=tools,
    reasoning={"effort": "medium"}
)

# Modellausgabe unverändert anhängen (enthält Reasoning- und function_call-Elemente)
history += first.output

for item in first.output:
    if item.type == "function_call" and item.name == "get_order_status":
        args = json.loads(item.arguments)
        result = get_order_status(**args)
        history.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(result, ensure_ascii=False)
        })

final = client.responses.create(
    model=MODEL,
    input=history,
    tools=tools,
    reasoning={"effort": "medium"}
)
if final.status != "completed":
    raise RuntimeError(f"响应未完成:{final.status}")
if any(item.type == "function_call" for item in final.output):
    raise RuntimeError("模型仍请求工具;请按相同流程继续处理,不能当作最终答复")
print(final.output_text)
Die obige Funktion liefert Demodaten, keine echte Bestellabfrage; das Beispiel zeigt nur eine einzige Runde eines Funktionsaufrufs. In der Produktion musst du zusätzlich den Aufrufnamen und die Argumente validieren, die Abfrageberechtigungen prüfen, Tool-Fehler behandeln, für weitere Tool-Anfragen eine Schleife mit Obergrenze einrichten und Timeouts sowie unvollständige Antworten abfangen.
Wenn Sie eine neue Einschränkung ergänzen möchten – zum Beispiel „antworte ab jetzt auf Englisch“ –, sollten Sie sie als neuen Eingabeeintrag an das Ende von history anhängen und nicht zurückgehen und die ursprüngliche Anweisung ändern. Wechseln Sie innerhalb derselben Sitzung nicht auf ein Modell mit niedrigerer Version und migrieren Sie die Sitzung nicht zwischen Benutzern oder Organisationen. Laut offizieller Dokumentation können all diese Änderungen dazu führen, dass Reasoning-Elemente verloren gehen.
2.5 Fehlerdiagnose der GPT-6.2-API
Die folgende Tabelle fasst mögliche Suchrichtungen auf Basis der offiziellen Migrationshinweise zusammen. Die Spalte „Mögliche Ursache“ beruht auf redaktionellen Schlussfolgerungen; die konkreten Fehlertexte richten sich nach der tatsächlichen Antwort:
| Symptom | Mögliche Ursache | Vorgehen |
|---|---|---|
| Anfrage abgelehnt, Meldung: Parameter nicht unterstützt | Noch vorhandene, bereits entfernte Parameter wie temperature, top_p, logprobs |
Einheitlich in der Aufruf-Kapselung herausfiltern |
Chat Completions mit tools schlägt fehl |
Tool-Aufrufe unterstützt GPT-6.2 nur über Responses | Auf responses.create migrieren |
| Fehler bei der Reasoning-Stufe | Es wird noch none oder minimal verwendet |
Auf low umstellen |
| Cache-Konfiguration wirkungslos oder Trefferquote bricht ein | Es wird noch prompt_cache_retention verwendet, oder das Historien-Präfix wurde verändert |
Auf prompt_cache_options.ttl="30m" umstellen und das Präfix stabil halten |
| Qualität in der zweiten Hälfte mehrstufiger Dialoge sinkt deutlich | Reasoning-Elemente wurden nicht zurückgegeben, oder das Modell wurde zwischendurch herabgestuft bzw. die Organisation gewechselt | output unverändert anhängen, in derselben Sitzung dasselbe Modell verwenden |
| Abrechnung liegt weit über der Schätzung | Einige Anfragen überschreiten 272K Eingabe und lösen einen Aufschlag auf die gesamte Rechnung aus | Verteilung der Eingabelängen auswerten, lange Anfragen kürzen oder zusammenfassen |
| Modellname existiert nicht oder keine Berechtigung | Offiziell schrittweise freigegeben, oder die Dritt-Schnittstelle stellt das Modell noch nicht bereit | Organisationsberechtigung prüfen; bei Dritt-Schnittstellen gilt die Modellliste der Plattform |
🛠 Tipp zur Fehlersuche: Wenn das Problem nur bei einer Dritt-Schnittstelle auftritt, senden Sie zunächst dieselbe Anfrage über die offizielle API als Vergleich. So lässt sich erkennen, ob das Problem in Ihrem Code oder in der Kompatibilitätsschicht der Schnittstelle liegt. Wenn Sie bei APIYI apiyi.com auf Kompatibilitätsprobleme stoßen, können Sie sich mit der Anfrage-ID an den technischen Support der Plattform wenden.
2.6 API-Abnahme mit kleinem Traffic-Anteil und Rollback für GPT-6.2
Für die Umstellung empfehlen wir nicht den großen Schalter, sondern ein dreistufiges Vorgehen: „Shadow-Test → Canary-Rollout mit kleinem Anteil → Ausweitung“. Für jede Stufe sollten klare Abnahmekriterien und Rollback-Bedingungen festgelegt werden:
| Phase | Traffic-Empfehlung | Abnahmekriterien | Rollback-Auslöser |
|---|---|---|---|
| Shadow-Test | Onlinerequests kopieren, Ergebnisse nicht an Nutzer zurückgeben | Qualität des Regression-Sets, Erfolgsrate der Tool-Aufrufe, Parsing-Rate strukturierter Ausgaben | Qualität kritischer Aufgaben deutlich unter dem alten Modell |
| Canary-Rollout mit kleinem Anteil | Wenige echte Nutzer | Fehlerrate, P95-Latenz, Tokens pro Anfrage, Cache-Trefferrate | Fehlerrate oder Kosten überschreiten vorgegebene Schwellen |
| Ausweitung | Anteil schrittweise erhöhen | Anteil der Langkontext-Anfragen, Tageskosten, Nutzerfeedback | Viele Anfragen über 272K führen zu unkontrollierten Kosten |
Das Rollback-Design hat zwei Kernpunkte. Erstens: Modellname, Schnittstellentyp und Reasoning-Stufe werden alle über Konfigurations-Schalter gesteuert – beim Rollback wird nur die Konfiguration geändert, kein neues Release veröffentlicht. Zweitens: Der Rollback erfolgt pro neuer Sitzung. Sitzungen, die bereits auf GPT-6.2 laufen, sollten nach Möglichkeit auf dem ursprünglichen Modell zu Ende geführt werden, damit ein Downgrade mitten in der Sitzung nicht zum Verlust von Reasoning-Elementen führt.
🚀 Schnellstart: Beim Canary-Rollout können Sie auf APIYI apiyi.com mit demselben API-Schlüssel gleichzeitig das alte Modell und das Kandidatenmodell für einen Vergleich aufrufen – vorausgesetzt, die Plattform bietet die entsprechenden Modelle an. Maßgeblich ist, was die Plattformkonsole anzeigt; eine Zusicherung kann dieser Artikel dazu nicht geben.
Bei der Migration auf GPT-6.2 liegt der eigentliche Aufwand nicht im Umbenennen des Modells, sondern an drei Stellen: Tool-Aufrufe auf Responses umstellen, die entfernten Parameter bereinigen und historische Präfixe stabil halten. Die offiziellen Benchmarks weisen eine beachtenswerte Richtung, insbesondere das Preis-Leistungs-Verhältnis von Sol bei bestimmten Aufgaben. Ob sich diese Zahlen in Ihrem Geschäft bewahrheiten, lässt sich nur mit eigenen Regression-Sets und Canary-Daten beantworten.
Was man auf Papier erwirbt, bleibt am Ende doch seicht; will man die Sache wirklich begreifen, muss man sie selbst tun. — Lu You, „Beim Lesen an einem Winterabend, für meinen Sohn Ziyu“
Referenzen
Die Code-Struktur orientiert sich zusätzlich am OpenAI Quickstart und am Function-Calling-Leitfaden. Dieser Artikel gleicht ausschließlich die Dokumentation und die Code-Struktur ab; es wurden keine kostenpflichtigen API-Tests durchgeführt.
-
OpenAI-Ankündigung: Introducing GPT-6.2 Astra and Sol
- Link: Offizielle Quelle
- Beschreibung: Veröffentlichungsdatum, Benchmark-Daten und Verfügbarkeitsumfang
-
OpenAI-Modellseite: GPT-6.2 Astra
- Link: Offizielle Quelle
- Beschreibung: Modellname, Modalitäten und Standardpreise
-
OpenAI-Modellseite: GPT-6.2 Sol
- Link: Offizielle Quelle
- Beschreibung: Modellname, Modalitäten und Standardpreise
-
OpenAI-Migrationsleitfaden: Latest model
- Link: Offizielle Quelle
- Beschreibung: Entfernte Parameter, Reasoning-Stufen, Cache-Konfiguration und Anforderungen an historische Präfixe
-
OpenAI-Hilfecenter: ChatGPT Work and Codex
- Link: Offizielle Quelle
- Beschreibung: Hinweise zur Verfügbarkeit auf der Seite von ChatGPT Work und Codex
Autor: APIYI-Technikteam
Technischer Austausch: Wenn bei der Migration Schnittstellenkompatibilitätsprobleme auftreten, kontaktieren Sie uns gerne über die Startseite von APIYI (apiyi.com). Weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com.