Direkte Antwort: Eine neue Eingabeaufforderung ist nicht automatisch besser – und „sieht besser aus“ ist kein Beweis. Um zu beurteilen, welche Artikelvorlage – die alte oder die neue – besser ist, sollten Quellmaterial, Modell und Generierungseinstellungen konstant gehalten, nur die Vorlage geändert und anschließend mit Promptfoo-Assertions stufenweise Struktur, Reihenfolge und inhaltliche Qualität geprüft werden. Ergebnisse sollten außerdem dimensionenweise dargestellt werden; eine Stilbewertung darf keine Faktenfehler ausgleichen. Dieser Artikel stellt ein Versuchsdesign vor; es wurde kein echtes A/B-Experiment durchgeführt, daher werden keine Gewinnraten, Scores oder Einsparungen genannt.
Nach dem Lesen dieses Artikels wissen Sie:
- Was die Assertions
contains, JavaScript undllm-rubricin Promptfoo jeweils prüfen können und was sie nicht belegen können. - Wie Sie Assertion-Dateien separat auf bereits vorhandenen Modellausgaben ausführen und so eine Neugenerierung vermeiden, wenn nur die Bewertungsregeln geändert werden.
- Ein Versuchsdesign zum Vergleich alter und neuer Artikelvorlagen – einschließlich Variablenkontrolle, dreistufiger Prüfung und dimensionenweiser Darstellung.
- Die Grenzen von Modell-Judges und regelbasierten Assertions sowie die Kostenprobleme durch kostenpflichtige Bewertungsmodelle.
Überblick: Zuerst erklärt eine Begriffstabelle einige Schlüsselbegriffe aus der Promptfoo-Evaluierung; danach wird erläutert, was das für Content-Teams, Entwickler und Evaluierungsverantwortliche bedeutet. Der Abschnitt „Objektive Fakten“ im Hauptteil fasst ausschließlich die in der Dokumentation beschriebenen Assertion-Fähigkeiten und den Prüfstatus zusammen. Der Abschnitt „Analyse und Einschätzung“ enthält dagegen Empfehlungen zum Versuchsdesign, Konfigurationsbeispiele und eine Diskussion der Grenzen; dabei wird Punkt für Punkt gekennzeichnet, was Empfehlung und nicht gemessenes Ergebnis ist.
Begriffe, die man kennen sollte, bevor man mit Promptfoo Prompt-Vorlagen vergleicht
Die folgenden Begriffe tauchen im weiteren Verlauf immer wieder auf. Die meisten stammen aus der Konfigurationsdokumentation von Promptfoo, einige wenige sind allgemeine Bezeichnungen aus der Evaluationspraxis.
| Begriff | Kurze Erklärung |
|---|---|
| Promptfoo | Ein Open-Source-Tool zum Evaluieren von Prompts und Ausgaben großer Sprachmodelle; Testfälle und Assertions lassen sich über eine Konfigurationsdatei definieren |
| Assertion (Prüfregel) | Eine automatische Prüfregel für Modellausgaben, die feststellt, ob die Ausgabe eine bestimmte Bedingung erfüllt |
| contains | Prüft, ob ein angegebener Text in der Ausgabe vorkommt – ein deterministischer String-Vergleich |
| JavaScript-Assertion | Eine komplexere Prüfbedingung, umgesetzt über einen JavaScript-Ausdruck oder eine Funktion |
| llm-rubric | Ein Modell bewertet die Ausgabe anhand einer eigenen Skala; gehört zu den Assertions der Kategorie „Modellbewertung“ |
| Grading Provider (Bewertungsanbieter) | Das Modell, das die llm-rubric-Bewertung durchführt; lässt sich separat konfigurieren |
| Rubric (Bewertungsskala) | Die Bewertungskriterien für das bewertende Modell: was als bestanden gilt und wann Punkte abgezogen werden |
| LLM-as-a-Judge (Modell als Richter) | Das Verfahren, große Sprachmodelle statt menschlicher Prüfer die Ausgabequalität bewerten zu lassen |
| Variablenkontrolle | Im Experiment wird nur ein Faktor verändert (hier: die Vorlage), alle anderen bleiben unverändert |
Kurzüberblick: Auswirkungen der Evaluierung alter und neuer Prompt-Vorlagen
Der Wert dieser Evaluierungsmethode liegt weniger darin, wie neu das eingesetzte Tool ist, sondern darin, dass aus „Ich finde die neue Vorlage besser“ eine nachprüfbare Prüfaufzeichnung wird. Die einzelnen Rollen ziehen daraus unterschiedlich viel Gewinn.
| Zielgruppe | Konkrete Auswirkung |
|---|---|
| Content-Teams und Redaktion | Die Überarbeitung der Vorlagen erhält eine nachprüfbare Abnahmegrundlage; Probleme wie „Struktur passt, aber in den Faktenabschnitt ist Spekulation gerutscht“ fallen dabei auf |
| Prompt-Engineer und Entwickler | Die Anforderungen der Vorlage lassen sich in Regel-Assertions und Skalen-Assertions zerlegen; bei Änderungen der Bewertungsregeln müssen nicht alle Ausgaben neu erzeugt werden |
| Evaluierungsverantwortliche | Ergebnisse müssen nach Dimensionen getrennt berichtet werden, und es muss klar unterschieden werden, welche Beweiskraft Modellbewertung, Regel-Treffer und menschliche Prüfung jeweils haben |
| Budgetverantwortliche | Regel-Assertions verursachen praktisch keinen zusätzlichen Aufrufaufwand; bei llm-rubric entstehen Bewertungskosten, sofern ein kostenpflichtiges Modell verwendet wird |
Objektive Fakten zu den Assertion-Fähigkeiten von Promptfoo
Dieser Abschnitt beschreibt ausschließlich die Fähigkeiten, die in der Promptfoo-Dokumentation dargestellt sind. Wir haben die entsprechenden Dokumentationsseiten am 2026-11-17 geprüft, aber das Erstveröffentlichungsdatum dieser Fähigkeiten ist nicht verifiziert, daher nennt dieser Artikel keinen konkreten Veröffentlichungszeitpunkt.
Die contains-Assertion von Promptfoo: Prüfen, ob ein Text auftaucht
contains ist der grundlegendste Assertion-Typ und dient dazu, zu prüfen, ob ein bestimmter Text im Modell-Output vorkommt. Es ist ein deterministischer String-Abgleich: Bei gleichem Output liefert jeder Lauf dasselbe Ergebnis.
Wichtig ist dabei: Ein bestandenes contains sagt ausschließlich, „dass dieser Text getroffen wurde“. Es sagt nichts darüber aus, ob der Absatz, in dem dieser Text steht, gut geschrieben ist, und auch nichts über die inhaltliche Korrektheit.
Die JavaScript-Assertion von Promptfoo: komplexe Bedingungen umsetzen
Wenn die Prüfbedingung über „enthalten oder nicht“ hinausgeht, lässt sich mit einer JavaScript-Assertion eine eigene Logik schreiben. Zum Beispiel die Reihenfolge zweier Überschriften vergleichen, die Anzahl eines bestimmten Abschnitts zählen oder prüfen, ob ein Text innerhalb eines bestimmten Kapitels liegt. Auch diese Assertions bleiben deterministisch, die Ergebnisse sind reproduzierbar.
Bereits erzeugte Promptfoo-Outputs mit einer eigenständigen Assertion-Datei bewerten
Promptfoo unterstützt es, eine eigenständige Assertion-Datei auf bereits erzeugte Modell-Outputs laufen zu lassen, ohne alle Outputs erneut generieren zu müssen. Das ist für die Iteration bei der Evaluierung wichtig: Bewertungsregeln müssen oft wiederholt angepasst werden, während das Generieren selbst sowohl zeitaufwendig als auch mit Aufrufkosten verbunden ist.
llm-rubric von Promptfoo: mit einem Modell nach einer Skala bewerten
llm-rubric gehört zu den modellbasierten Bewertungs-Assertions. Es übergibt den Output und eine eigene Skala (ein Rubric) an ein Bewertungsmodell, das dann entscheidet, ob der Test bestanden ist, und eine Begründung liefert. Laut Dokumentation lässt sich der Bewertungs-Anbieter, der das Scoring durchführt, separat konfigurieren, und auch die beim Scoring verwendete Eingabeaufforderung ist anpassbar.
| Assertion-Typ | Prüfmethode | Deterministisch? | Was lässt sich beweisen | Was lässt sich nicht beweisen |
|---|---|---|---|---|
| contains | String-Abgleich | Ja | Der angegebene Text kommt vor | Absatzqualität, inhaltliche Korrektheit |
| JavaScript | Eigene Code-Logik | Ja | Kodierbare Bedingungen wie Struktur, Reihenfolge, Anzahl | Semantische Qualität |
| llm-rubric | Modell bewertet nach Skala | Beeinflusst durch das Bewertungsmodell | Der Output entspricht aus Sicht des Bewertungsmodells der Rubric | Faktische Korrektheit; ersetzt keine menschliche Prüfung |
Quellen und Prüfstatus
Der Fakten-Teil dieses Artikels stützt sich auf die folgenden Promptfoo-Dokumentationsseiten, Prüfdatum: 2026-11-17:
- Promptfoo-Dokumentation zu Assertions und Metriken: promptfoo.dev/docs/configuration/expected-outputs/
- Promptfoo-Dokumentation zu modellbasierten Bewertungs-Assertions: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Promptfoo-Dokumentation zu llm-rubric: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
Dieser Artikel hat keinen echten A/B-Test zwischen alten und neuen Templates durchgeführt. Die später im Text erwähnten Konfigurationen und Abläufe sind Designvorschläge und stellen keine tatsächlich gemessenen Ergebnisse dar.
Analyse und Bewertung: Alte und neue Artikelvorlagen mit Promptfoo vergleichen
Im Folgenden legen wir unsere Interpretation und Empfehlung auf Basis der oben genannten Fakten dar. Nehmen wir als Beispiel eine „Nachrichtenartikel-Vorlage“ an: Die neue Vorlage soll verlangen, dass der Artikel die beiden Abschnitte „objektive Fakten“ und „Analyse und Bewertung“ enthält, wobei die Fakten zuerst und die Analyse danach kommen; in den Faktenabschnitt dürfen keine Vermutungen einfließen.
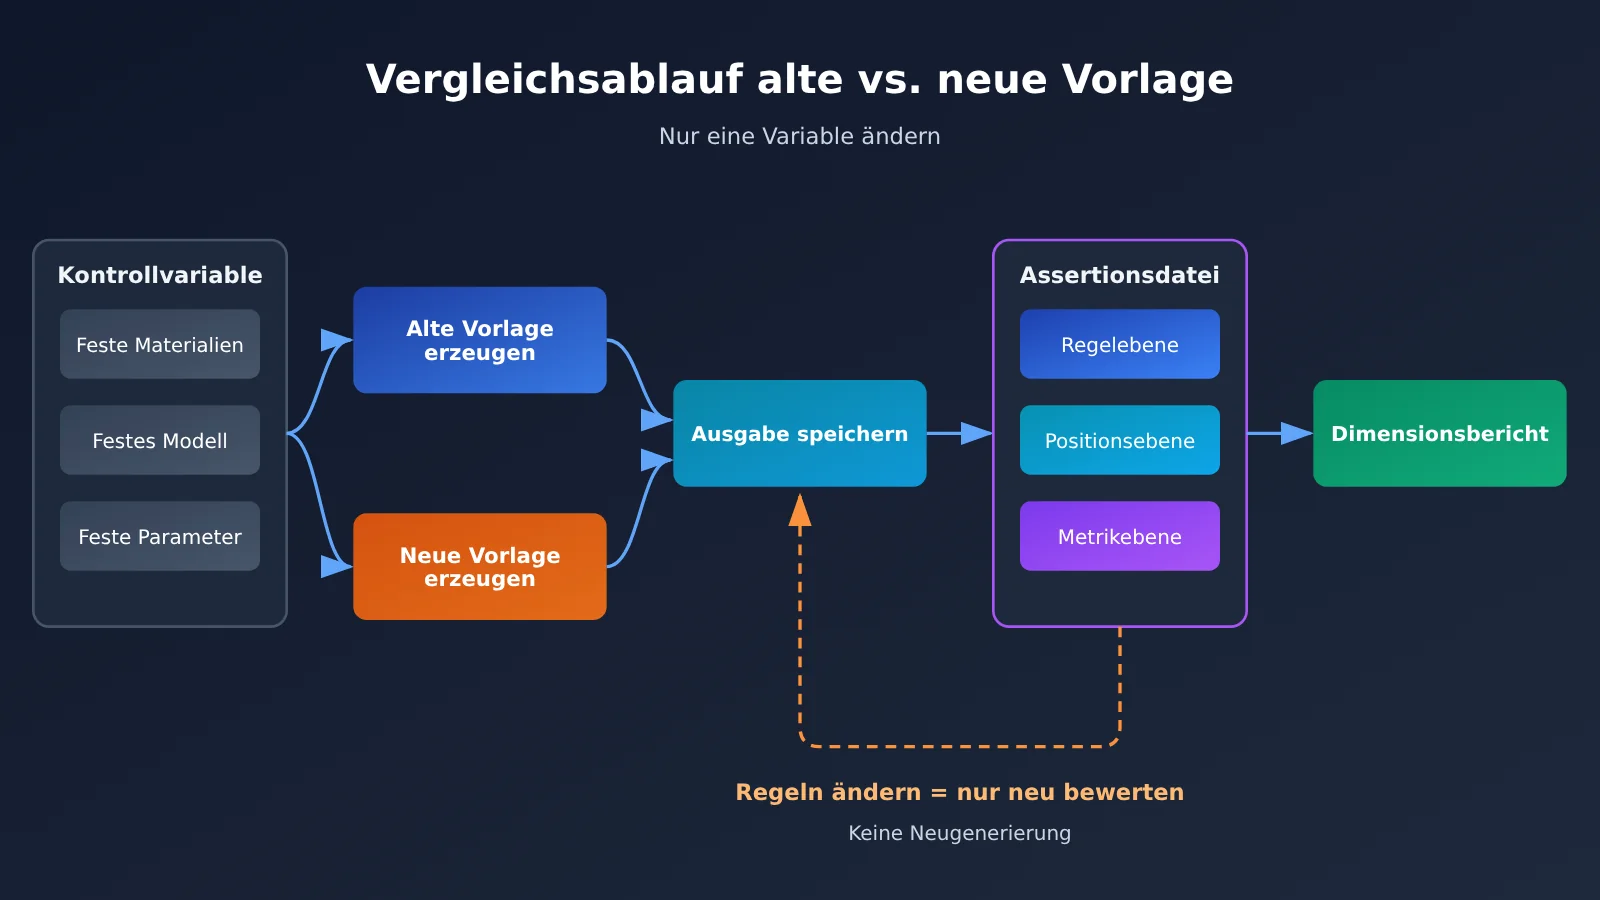
Experimentaufbau: Beim Vergleich von Vorlagen mit Promptfoo nur eine Variable ändern
Der häufigste Fehler beim Vergleich von Vorlagen besteht darin, beim Wechsel der Vorlage zugleich auch Daten, Modell oder Temperaturparameter zu ändern. Selbst wenn die Ergebnisse dadurch besser werden, lässt sich nicht mehr sagen, ob das an der Vorlage oder an anderen Einflussfaktoren liegt. Deshalb besteht der erste Schritt darin, alle Variablen außer der Vorlage festzuschreiben.
| Variable | Vorgehen | Grund |
|---|---|---|
| Eingabedaten | Denselben Datensatz für beide Vorlagen fixieren | Unterschiedliche Daten verändern unmittelbar den Fakteninhalt |
| Generierungsmodell | Dasselbe Modell und dieselbe Version fixieren | Unterschiede im Schreibstil zwischen Modellen können größer sein als Unterschiede zwischen Vorlagen |
| Generierungsparameter | Temperatur, maximale Länge und weitere Einstellungen fixieren | Parameter beeinflussen die Stabilität und Länge der Ausgabe |
| Vorlage für die Eingabeaufforderung | Die einzige geänderte Variable | Sie ist der zu prüfende Gegenstand |
| Bewertungsregeln | Alte und neue Gruppe verwenden denselben Satz an Assertions | Stellt sicher, dass beide Gruppen dieselbe Prüfung durchlaufen |
Promptfoo-Regel- und Positionsebene: erst Struktur, dann Reihenfolge
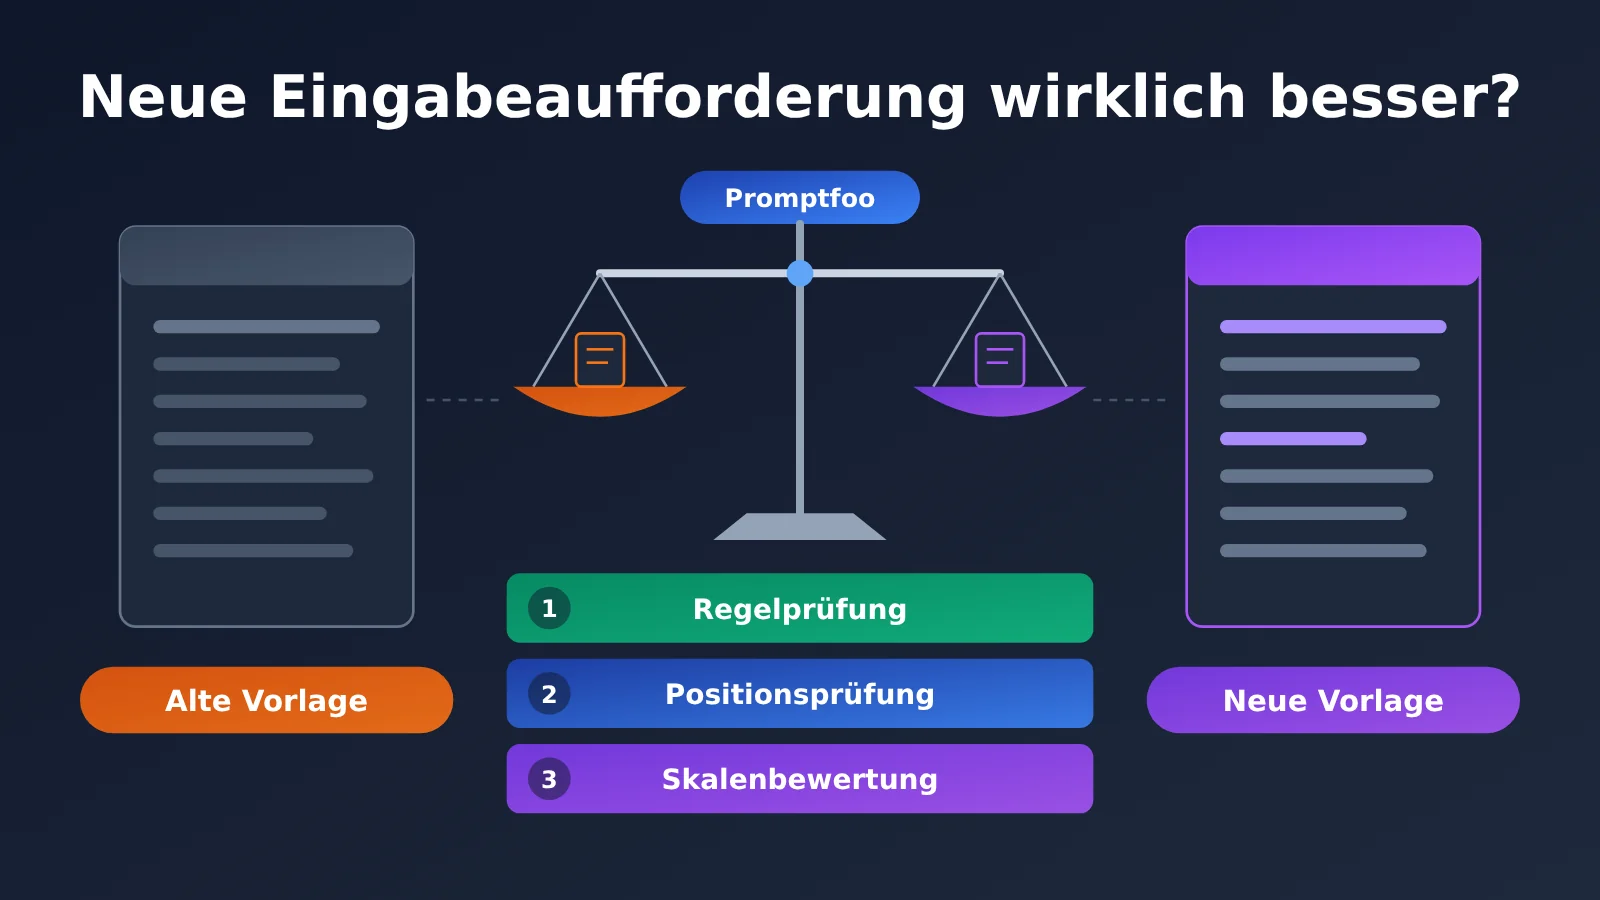
Die erste Ebene ist die Regelprüfung: Mit contains wird bestätigt, ob die von der Vorlage geforderten Überschriften vorkommen. Die zweite Ebene ist der Positionsvergleich: Eine JavaScript-Assertion stellt sicher, dass die Überschrift „客观事实“ vor der Überschrift „分析判断“ erscheint. Beide Ebenen sind deterministische Prüfungen, kostengünstig und stabil im Ergebnis – ideal, um sie ganz vorne einzusetzen und offensichtlich untaugliche Ausgaben herauszufiltern.
Hier ist eine beispielhafte Schreibweise für Assertions; die genauen Feldnamen entnehmen Sie bitte der offiziellen Promptfoo-Dokumentation:
# Beispielkonfiguration: dient zur Veranschaulichung der Idee; Felddetails bitte in der offiziellen Dokumentation prüfen
assert:
  # Regel-Ebene: ob die Überschrift vorhanden ist
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # Positions-Ebene: Der Faktenabschnitt muss vor dem Analyseabschnitt stehen
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
Beachten Sie, dass in der Positions-Ebene zuerst geprüft wird, ob beide Überschriften vorhanden sind. Würde man nur a < b schreiben, gäbe indexOf -1 zurück, wenn die Überschrift „客观事实“ fehlt – und die Bedingung „kleiner als“ wäre trotzdem erfüllt, was zu einer Fehlbewertung führt. Genau deshalb müssen auch deterministische Assertions sorgfältig formuliert werden.
Promptfoo-Rubrik-Ebene: Mit einer klaren Rubrik prüfen, ob Spekulationen in den Faktenabschnitt geraten
Vollständige Überschriften und die richtige Reihenfolge allein bedeuten noch nicht, dass der Faktenabschnitt sauber ist. Die Frage, ob sich Spekulationen in den Faktenabschnitt einschleichen, ist eine semantische Einschätzung, die sich mit Regel-Assertions kaum abdecken lässt – dafür ist llm-rubric die passende Wahl. Die Rubrik sollte konkret formuliert sein und dem Bewertungsmodell sagen, was als Verstoß zählt, statt nur vage zu fragen, ob etwas „gut geschrieben“ ist.
# Beispielkonfiguration: Bewertungsanbieter und Rubrikinhalt sind nur Beispiele
assert:
  - type: llm-rubric
    value: |
      Bewerte ausschließlich den Abschnitt „objektive Fakten“.
      Wenn in diesem Abschnitt Prognosen, subjektive Bewertungen oder nicht durch Quellen belegte Schlussfolgerungen auftauchen, gilt dies als nicht bestanden; zitiere dabei den problematischen Originalsatz.
      Beurteile nicht die sprachliche Qualität und bewerte keine anderen Abschnitte.
    provider: your-grading-model   # Der Bewertungsanbieter lässt sich separat konfigurieren
Die Ergebnisse der Rubrik-Ebene müssen weiterhin manuell stichprobenartig überprüft werden. Das Bewertungsmodell kann Fälle übersehen oder auch eine berechtigte Faktenaussage fälschlich als Spekulation einstufen. Bewährt hat sich, nicht bestandene Proben einzeln nachzuprüfen und zusätzlich einen Teil der bestandenen Proben manuell zu kontrollieren.
Darstellung nach Dimensionen: Promptfoo-Stilpunkte dürfen keine Faktenfehler ausgleichen
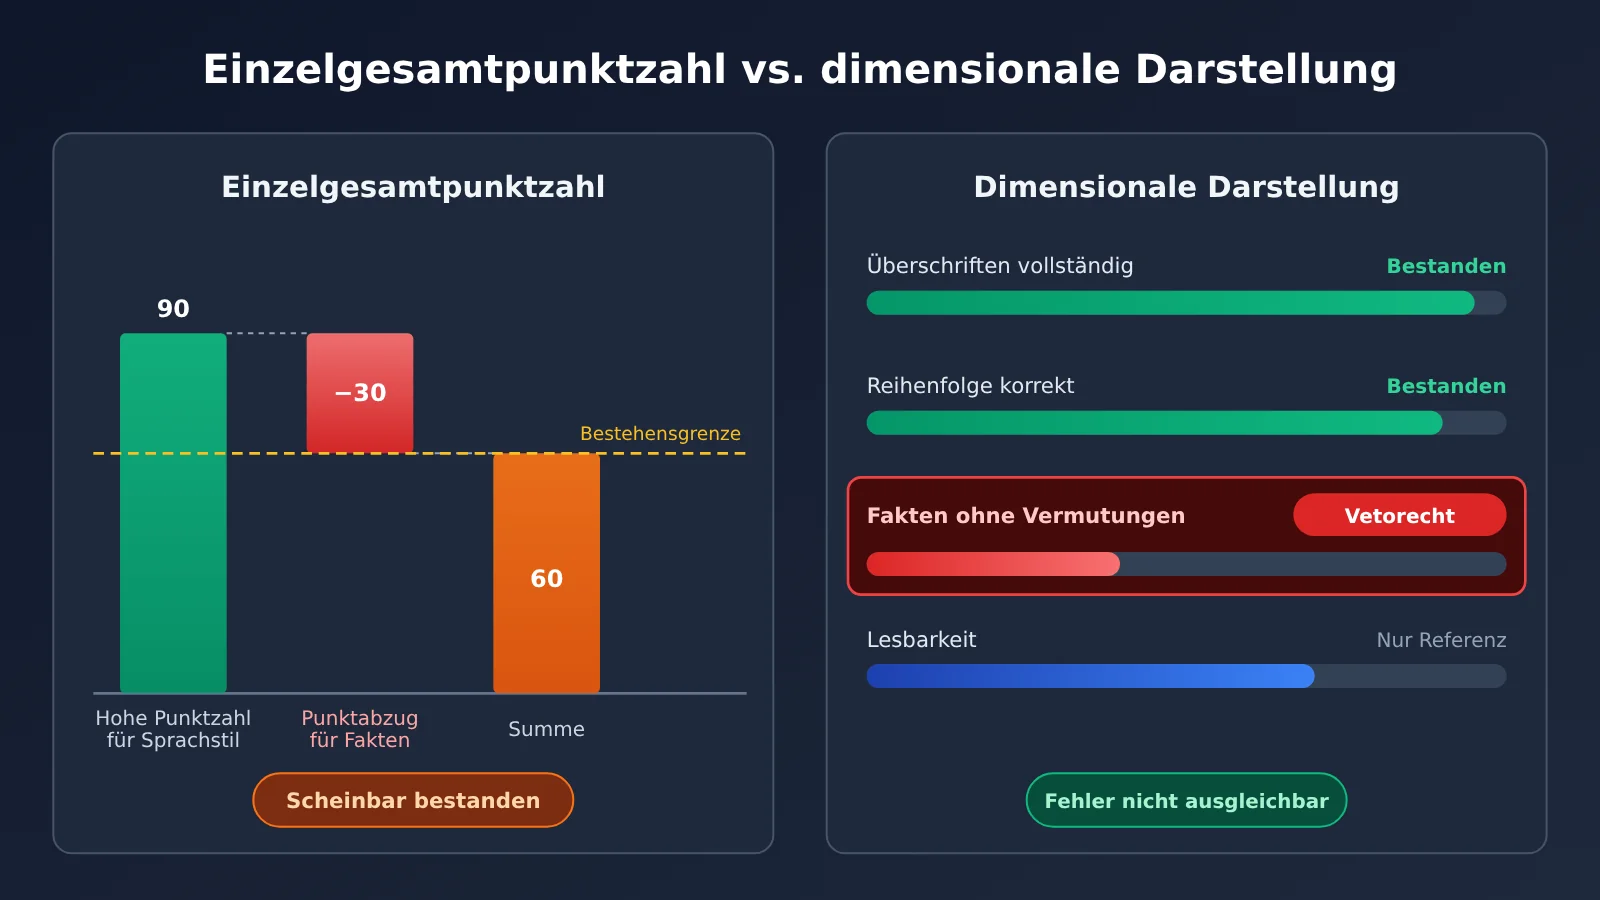
Wenn man alle Assertions zu einer einzigen Gesamtpunktzahl zusammenfasst, kann ein Artikel, der sprachlich flüssig ist, aber im Faktenabschnitt Vermutungen einfließen lässt, eine ähnliche Punktzahl erzielen wie ein Artikel, der strukturell streng, aber etwas farblos ist. Bei Nachrichteninhalten ist diese Art der „gegenseitigen Aufhebung“ gefährlich. Daher empfiehlt es sich, die Ergebnisse nach Dimensionen getrennt auszuweisen und die Fakten-Dimensionen mit Veto-Recht zu versehen.
| Bewertungsdimension | Prüfmethode | Darstellungsform | Kann durch andere Dimensionen ausgeglichen werden? |
|---|---|---|---|
| Alle erforderlichen Überschriften vorhanden | contains | Bestehensrate | Nein, ist eine harte Anforderung |
| Kapitelreihenfolge korrekt | JavaScript | Bestehensrate | Nein, ist eine harte Anforderung |
| Keine Vermutungen im Faktenabschnitt | llm-rubric + manuelle Prüfung | Bestehensrate + Liste der problematischen Original-Sätze | Nein, Veto-Recht |
| Ausdruck und Lesbarkeit | llm-rubric | separat aufgeführt | nur als Referenz, wird nicht verrechnet |
Wenn nur die Promptfoo-Bewertungsregeln geändert werden, alte Ausgaben direkt neu bewerten
Bei der Iteration von Evaluierungen ändert sich am häufigsten die Bewertungsregel und nicht die Vorlage selbst. Etwa wenn sich zeigt, dass die Beschreibung der Skala nicht klar genug ist oder die Positions-Assertion Randfälle auslässt. Da sich weder Vorlage noch Ausgabe geändert haben, ist eine Neugenerierung nicht nötig.
Mit der Fähigkeit von Promptfoo, unabhängige Assertion-Dateien auf bereits vorhandene Ausgaben anzuwenden, lassen sich Generierung und Bewertung vollständig trennen: einmal generieren, Ausgabe speichern, und bei jeder Regelanpassung nur die Assertions erneut laufen lassen. Das spart Zeit und stellt sicher, dass beide Bewertungsrunden exakt denselben Text vor sich haben – nur dann ist ein Vergleich aussagekräftig.
Grenzen und Kosten des Promptfoo-Modell-Richters
Drei Punkte sollten klar sein, damit die Evaluierungsergebnisse nicht überinterpretiert werden:
- Die Punktzahl des Modell-Richters beweist keine faktische Korrektheit. llm-rubric sagt nur aus, dass die Ausgabe aus Sicht des Bewertungsmodells der Skala entspricht. Die Faktenprüfung muss weiterhin anhand der Originalquellen erfolgen.
- Ein bestandenes
containsbedeutet nur, dass der Text getroffen wurde. Es zeigt, dass die Überschrift vorkommt, nicht dass die Qualität des Absatzes darunter stimmt. - Die Bewertung durch ein kostenpflichtiges Modell verursacht Kosten. Regelbasierte Assertions lösen in der Regel keine zusätzlichen Modellaufrufe aus, aber llm-rubric ruft für jede bewertete Ausgabe einmal das Bewertungsmodell auf. Daher lässt sich die gesamte Evaluierung nicht als „komplett kostenlos“ bezeichnen.
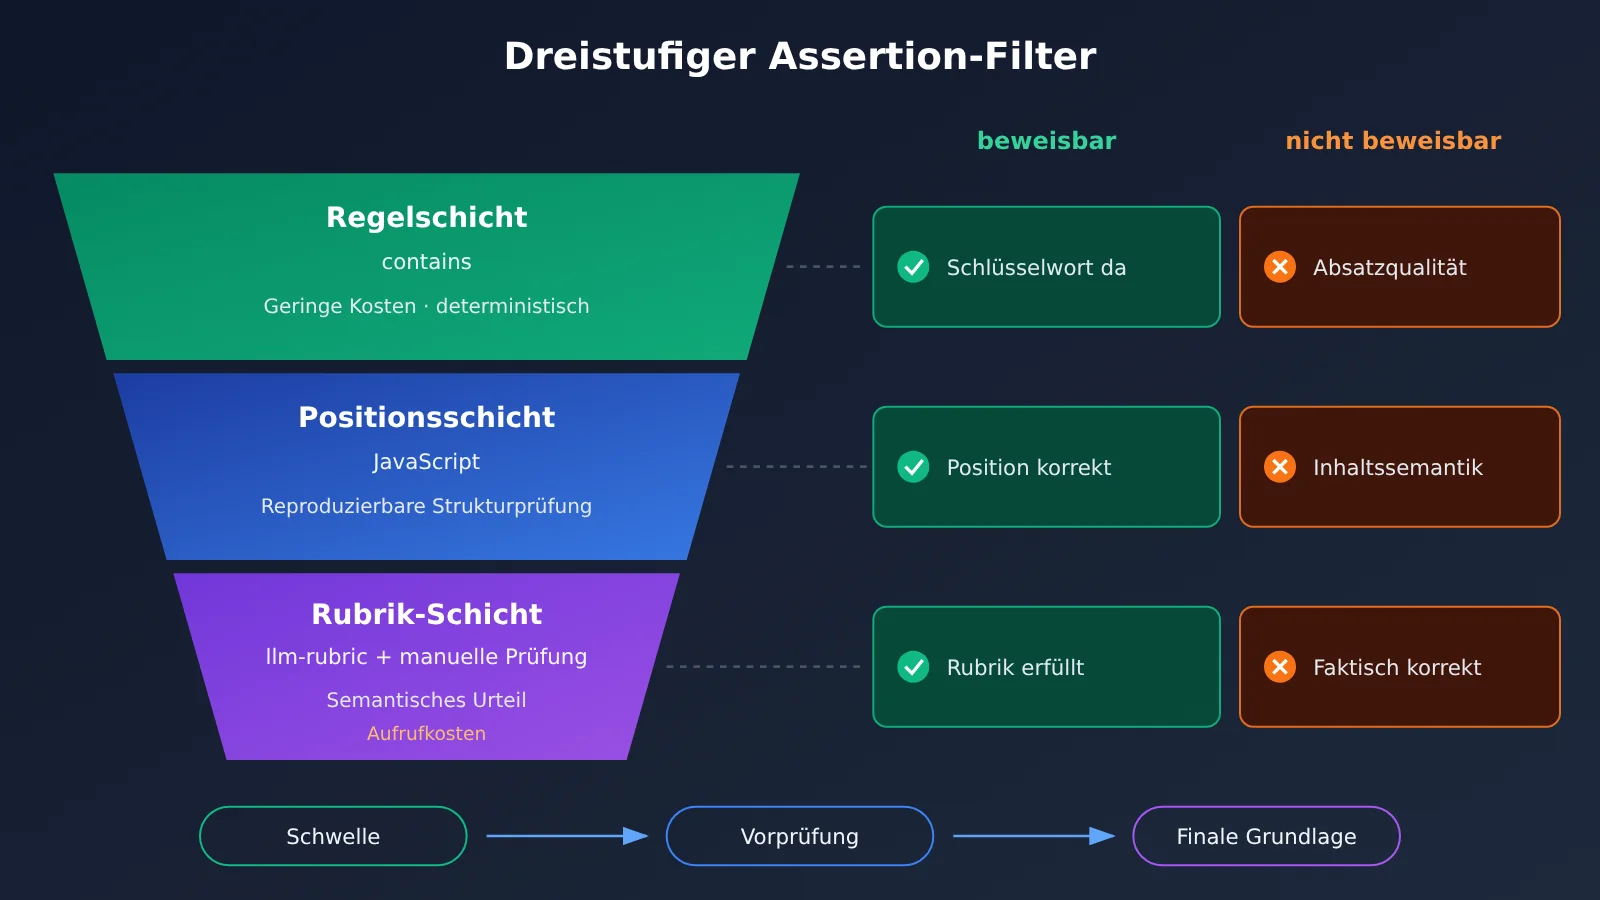
Aufgrund dieser Grenzen lautet unser Urteil: Deterministische Assertions eignen sich als „Schwelle“, Modellbewertungen als „Vorfilter“, und die menschliche Prüfung ist die letzte Instanz für faktenbezogene Schlussfolgerungen. Die drei haben unterschiedliche Aufgaben und können einander nicht ersetzen.
Richtungen, die es sich lohnt, weiter zu verfolgen
Die folgenden Beobachtungsrichtungen sind noch nicht verifiziert und dienen ausschließlich als Vorschläge für weitere Experimente:
- Konsistenz des Bewertungsmodells. Bleibt das Ergebnis stabil, wenn dieselbe Ausgabe mehrfach bewertet wird, und kippt die Schlussfolgerung, wenn man das Bewertungsmodell wechselt? Ist das Ergebnis nicht stabil, muss die Bewertungsskala konkreter formuliert werden.
- Übereinstimmung zwischen manueller Stichprobenprüfung und Modellbewertung. Davon hängt ab, wie weit man sich bei der Vorauswahl auf llm-rubric verlassen kann.
- Ob die Stichprobengröße ausreicht. Vergleicht man nur wenige Artikel, können Zufallseinflüsse die Unterschiede zwischen den Vorlagen überdecken. Man braucht genügend Eingangsmaterial, um zu aussagekräftigen Schlussfolgerungen zu kommen.
Solange es zu diesen Fragen keine Messdaten gibt, sollte man jede Aussage der Art „Wie hoch ist die Gewinnrate der neuen Vorlage?“ oder „Um wie viel hat sich die Bewertung verbessert?“ mit Vorsicht behandeln. Dass dieser Artikel bewusst keine solchen Zahlen nennt, hat genau diesen Grund.
Was man auf dem Papier lernt, bleibt immer oberflächlich; erst wenn man die Sache selbst in die Hand nimmt, versteht man sie wirklich. – Lu You, „Am Winterabend beim Lesen, meinem Sohn Ziyu gewidmet“