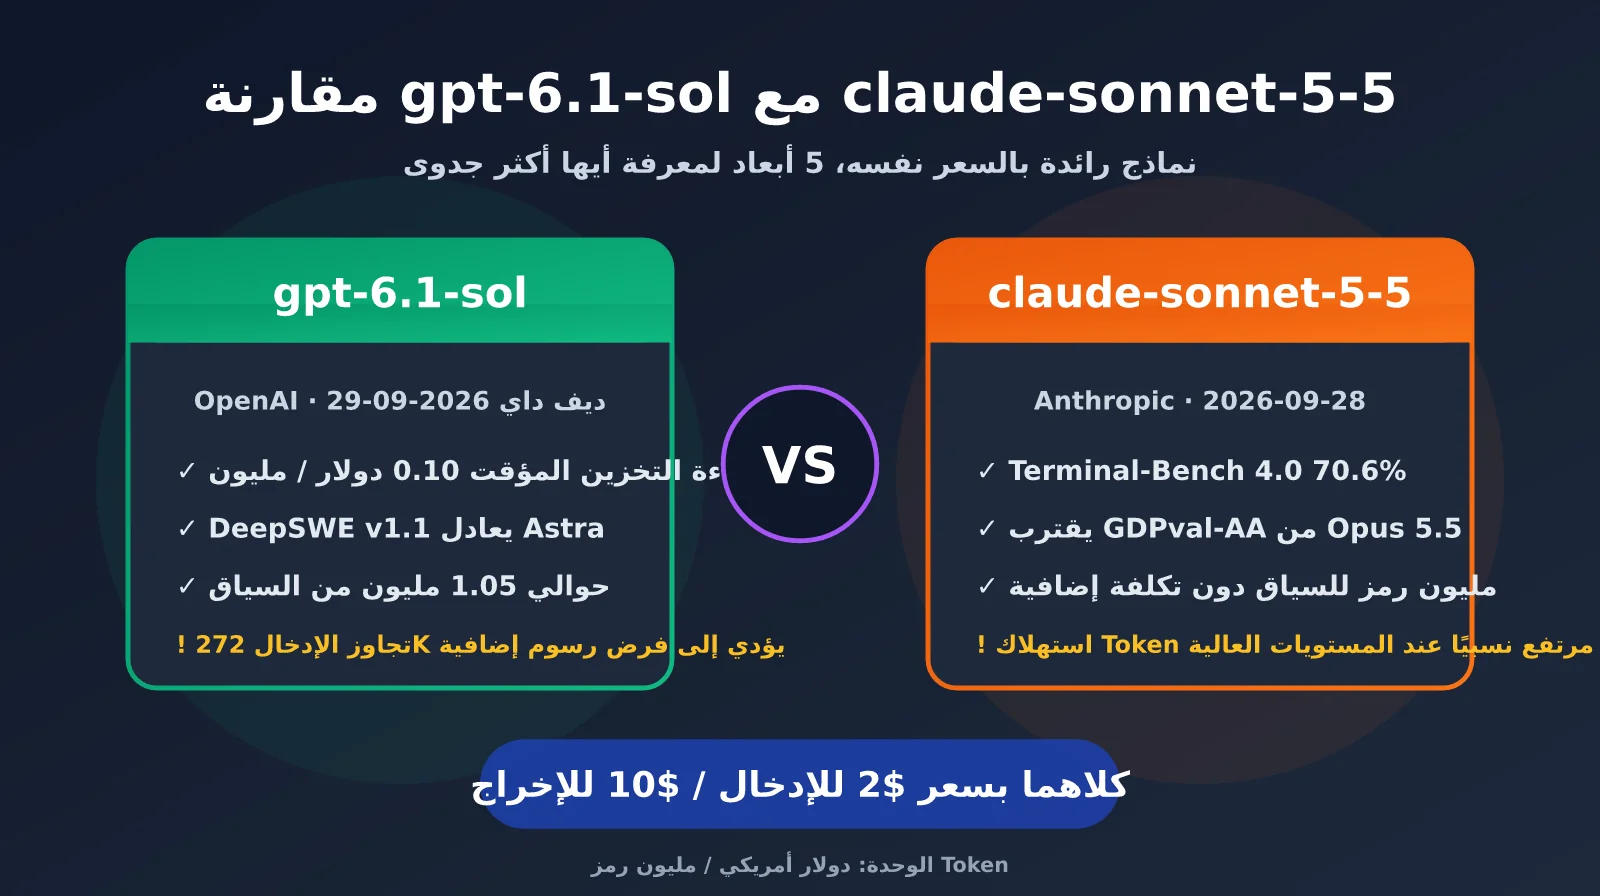
في 28 سبتمبر، أطلقت Anthropic نموذج claude-sonnet-5-5، وفي اليوم التالي كشفت OpenAI خلال DevDay عن gpt-6.1-sol. وصل نموذجا الجيل الجديد الأساسيان من الشركتين تباعًا، وبالسعر نفسه تمامًا: 2 دولار للإدخال و10 دولارات للإخراج لكل مليون Token. كان رد الفعل الأول لدى كثير من المطورين: «كلاهما أرخص، اختر أيًّا منهما». لكن عند الانتقال الفعلي إلى بيئة الإنتاج، يتضح أن الفجوة بينهما في تكلفة المهمة الواحدة، وفوترة السياق الطويل، وأداء الوكلاء أوسع بكثير مما يوحي به جدول الأسعار. تحلل هذه المقالة الفروق الفعلية بين gpt-6.1-sol وclaude-sonnet-5-5 عبر 5 أبعاد، لتساعدك على تجاوز تأثير تفضيل العلامة التجارية أو سهولة الوصول إلى الحساب، واتخاذ قرار عقلاني بحسب السيناريو.
القيمة الأساسية: بعد قراءة هذه المقالة، ستعرف بوضوح كيفية الاختيار والتوزيع بين gpt-6.1-sol وclaude-sonnet-5-5 في سيناريوهات وكلاء البرمجة، ومستندات العمل المكتبية، واسترجاع السياق الطويل، والمعالجة الدفعية عالية التزامن.
نظرة سريعة على المعلمات الأساسية لـ gpt-6.1-sol وclaude-sonnet-5-5
لنوضح أولًا سوء فهم شائعًا: من الناحية الدقيقة، لم ينخفض السعر المعلن لأي من النموذجين. حافظ claude-sonnet-5-5 على تسعير Sonnet 5 البالغ 2/10 دولارات، كما بقي سعر gpt-6.1-sol مماثلًا للجيل السابق gpt-6-sol. أما «انخفاض السعر» المتداول فيظهر على مستويين: الأول هو إتاحة قدرات بمستوى النماذج الرائدة ضمن فئة السعر الأساسية؛ إذ يبلغ سعر gpt-6.1-sol خُمس سعر gpt-6-astra فقط، بينما يبلغ سعر claude-sonnet-5-5 نصف سعر Opus 5.5. والثاني هو انخفاض التكاليف الخفية؛ فقد انخفض سعر إدخال البيانات المخزنة مؤقتًا في gpt-6.1-sol إلى النصف، من 0.20 دولار إلى 0.10 دولار، بينما يمكن لـ claude-sonnet-5-5 خفض تكلفة المهمة الواحدة بما يصل إلى 30% تقريبًا عبر تقليل عدد استدعاءات الأدوات.
| المعلَمة | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|
| تاريخ الإصدار | 2026-09-29 (DevDay) | 2026-09-28 |
| معرّف النموذج | gpt-6.1-sol |
claude-sonnet-5-5 |
| نافذة السياق | نحو 1.05 مليون Token | مليون Token |
| الحد الأقصى للإخراج | 128K | 128K (يصل إلى 300K في النسخة التجريبية من Batch) |
| مستويات الاستدلال | low / medium (افتراضي) / high / xhigh / max | low / medium / high (افتراضي في API) / xhigh / max |
| نمط التفكير | قابل للضبط حسب المستوى | تفكير تكيّفي لا يمكن تعطيله |
| النموذج الرائد من العائلة نفسها | gpt-6-astra ($10/$50) | Claude Opus 5.5 ($4/$20) |
| المنصات المتاحة | APIYI apiyi.com، وواجهة OpenAI API الرسمية | APIYI apiyi.com، وواجهة Anthropic API الرسمية |
يكشف جدول المعلمات عن فرق مهم: مستوى الاستدلال الافتراضي ليس نفسه في النموذجين. يستخدم gpt-6.1-sol مستوى medium افتراضيًا، فيما تضبط واجهة API الخاصة بـ claude-sonnet-5-5 المستوى high افتراضيًا. إذا قارنت النموذجين مباشرةً بالمعلمات الافتراضية، فأنت فعليًا تمنح Sonnet مستوى إضافيًا من «التفكير»، لذلك لن يكون استهلاك Token ووقت الاستجابة على خط البداية نفسه. ولإجراء مقارنة عادلة، يُنصح بتحديد reasoning_effort صراحةً وبالمستوى نفسه لكلا النموذجين.
🎯 اقتراح للاختبار: عند مقارنة النموذجين، احرص على تثبيت مستوى الاستدلال والموجه نفسيهما. نقترح استخدام مفتاح API واحد عبر APIYI apiyi.com لاستدعاء gpt-6.1-sol وclaude-sonnet-5-5 في الوقت نفسه، مع تغيير معلمة
modelفقط لإجراء اختبار A/B؛ وبذلك تتجنب المتغيرات المربكة الناتجة عن اختلاف الحسابات أو الشبكات.
5 فروق جوهرية بين gpt-6.1-sol و claude-sonnet-5-5
الفرق الأول: في وكلاء البرمجة، يتفوق claude-sonnet-5-5 في المهام المعتمدة على الطرفية
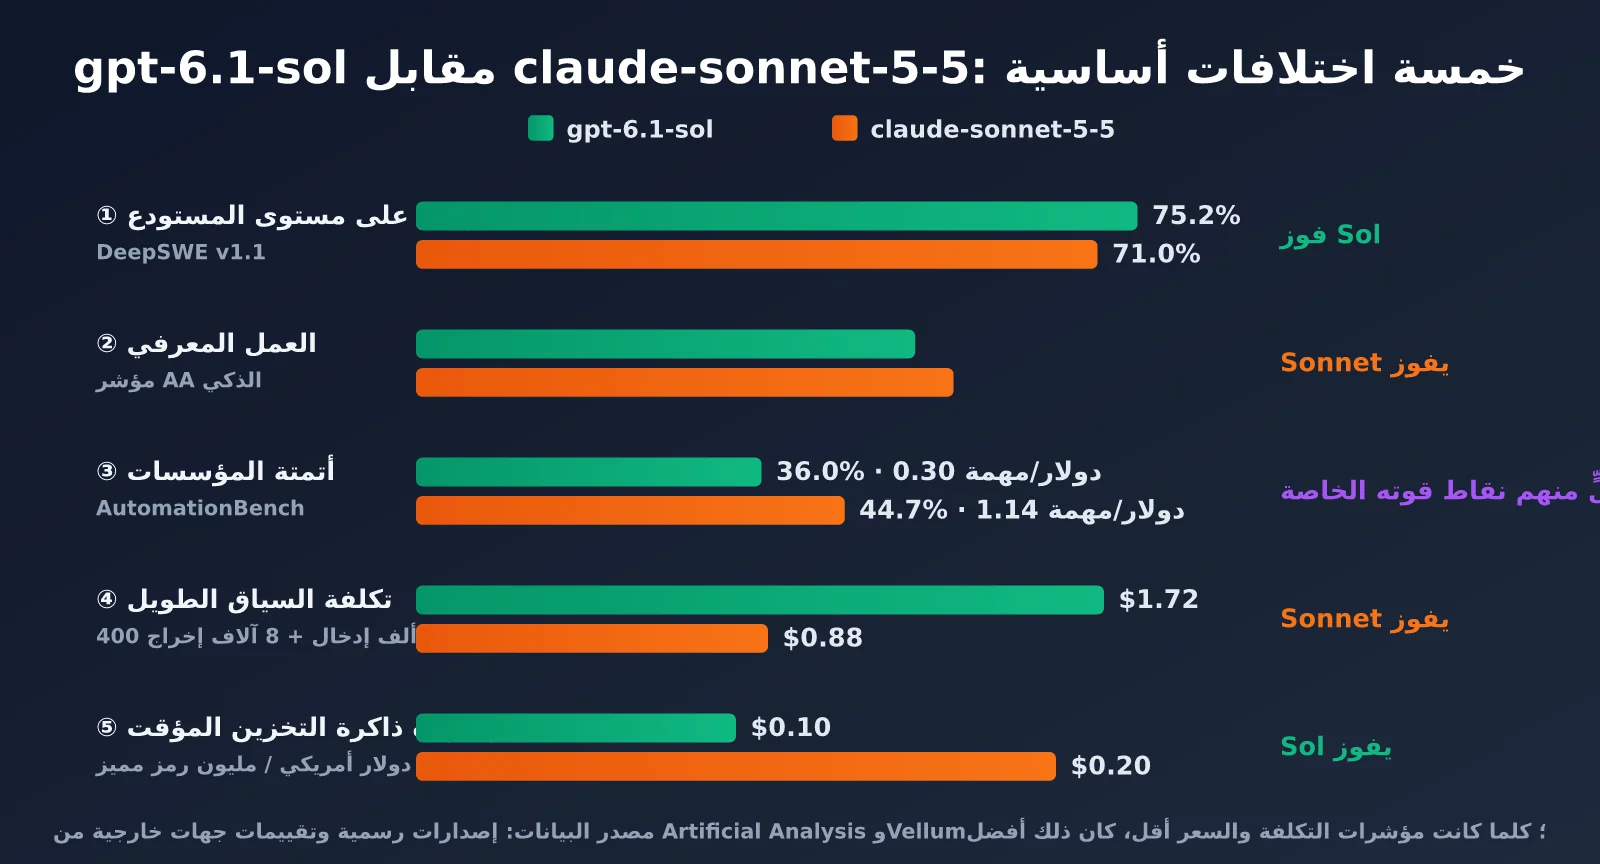
تُعد البرمجة المجال الأكثر احتدامًا للمنافسة بين النموذجين، لكن المعايير التي تعلنها الشركات لا تتطابق تمامًا، لذا يجب النظر إلى كل منها على حدة. حقق claude-sonnet-5-5 رسميًا نسبة 70.6% في Terminal-Bench 4.0، وهي قفزة ضخمة مقارنةً بنسبة 10.3% لـ Sonnet 5، بل وتتجاوز نسبة 66.4% التي حققها Opus 5.5. وفي إعادة اختبار مستقلة أجرتها Artificial Analysis، سجل 64%، متفوقًا كذلك على Opus 5.5 وgpt-6-astra اللذين سجلا 60%. كما حقق 81.3% في SWE-Bench Pro و55.5% في CursorBench 4.0، ليأتي خلف Opus 5.5 فقط.
أما gpt-6.1-sol، فتركز OpenAI على نتيجته في DeepSWE v1.1، حيث حقق 75.2%، متقدمًا قليلًا على نسبة 74.8% لـ gpt-6-astra، مع تكلفة تقارب $1.50 فقط للمهمة الواحدة، أي أقل من خُمس تكلفة Astra. وفي تجميعات الجهات الخارجية، سجل claude-sonnet-5-5 نسبة 71.0% على هذا المعيار. بعبارة أخرى، تبدو الأدلة أقوى لصالح claude-sonnet-5-5 في برمجة الوكلاء المعتمدة على الطرفية، بينما يبرز gpt-6.1-sol من حيث الكفاءة مقابل التكلفة في مهام هندسة البرمجيات على مستوى المستودعات.
الفرق الثاني: في العمل المعرفي، يقترب claude-sonnet-5-5 من Opus
في أعمال المعرفة المكتبية، يقدم claude-sonnet-5-5 أداءً لافتًا جدًا. فقد سجل 1844 في GDPval-AA v2.1، متعادلًا تقريبًا مع Opus 5.5 الذي سجل 1846، كما حقق 1811 في AA-Briefcase، ليبقى قريبًا جدًا من Opus أيضًا. وفي مؤشر الذكاء من Artificial Analysis، احتل claude-sonnet-5-5 المركز الثاني بـ56 نقطة، بفارق نقطتين فقط عن Opus 5.5، بينما سجل gpt-6.1-sol (max) 52 نقطة.
لكن gpt-6.1-sol يمتلك نقاط قوة خاصة في تحليل المستندات. ففي معيار GDP.pdf، حقق 32.0%، مقتربًا جدًا من 32.2% لـ gpt-6-astra، ومتجاوزًا 28.8% لـ Opus 5.5، بتكلفة تقارب $0.38 للمهمة الواحدة. وفي معيار AutomationBench لأتمتة عمليات الشركات، يتقدم claude-sonnet-5-5 بنسبة 44.7% مقابل 36.0% لـ gpt-6.1-sol، لكن تكلفة المهمة لدى الأول تقارب $1.14، في حين لا تتجاوز $0.30 لدى الثاني.
الفرق الثالث: في تشغيل الحاسوب، دخل كلاهما النطاق العملي
في مجال تشغيل الحاسوب (Computer Use)، حقق gpt-6.1-sol نسبة 71.4% على OSWorld 2.0، بفارق 2.1 نقطة فقط عن نسبة 73.5% لـ gpt-6-astra، وبتكلفة تقارب $1.30 للمهمة الواحدة. أما claude-sonnet-5-5 فحقق 80.1% على OSWorld 2.1، مقتربًا من نسبة 81.8% لـ Opus 5.5. من المهم الانتباه إلى أن مجموعتي الاختبار في إصداري OSWorld مختلفتان، لذلك لا يمكن مقارنة الدرجات مباشرةً، لكن من المؤكد أن كليهما بات قادرًا على تشغيل تطبيقات سطح المكتب بصورة مستقرة.
الفرق الرابع: تسعير نافذة السياق الطويلة، لدى gpt-6.1-sol عتبة خفية
هذه النقطة هي الأسهل تجاهلًا، والأكثر تأثيرًا في الفاتورة. فعلى الرغم من أن gpt-6.1-sol يدعم نافذة سياق تقارب 1.05 مليون Token، فإن أي طلب يتجاوز فيه الإدخال 272 ألف Token يُحاسَب كامل إدخاله وذاكرته المؤقتة بسعر مضاعف مرتين، بينما يُحاسَب الإخراج بسعر 1.5 مرة. في المقابل، توفر نافذة السياق البالغة مليون Token في claude-sonnet-5-5 من دون رسوم إضافية للسياق الطويل، إذ يُطبَّق التسعير القياسي طوال الوقت. إذا كان عملك يضع باستمرار دليلًا كاملًا أو مستودع أكواد كاملًا في السياق، فقد يكون هذا الفرق وحده كافيًا لتغيير قرار الاختيار.
الفرق الخامس: كفاءة Token والتخزين المؤقت، gpt-6.1-sol أوفر
يبلغ سعر قراءة التخزين المؤقت في gpt-6.1-sol نحو $0.10، أي نصف سعر claude-sonnet-5-5 البالغ $0.20. وهذا يمنحه أفضلية واضحة في سيناريوهات مثل حلقات الوكلاء، حيث تتكرر البادئة بدرجة كبيرة. من ناحية أخرى، يستهلك claude-sonnet-5-5 عددًا مرتفعًا نسبيًا من Token عند مستوى الاستدلال العالي: إذ وجدت Artificial Analysis أن إعداد max يُنتج نحو 193 ألف Token لكل مهمة، وهو أعلى رقم مرصود حاليًا. كما أظهرت اختبارات مستقلة أن إعداد high الافتراضي في API يستهلك قرابة ضعف Token الإخراج مقارنةً بإعداد medium، من دون تحسن واضح في الجودة.
| المعيار / المؤشر | gpt-6.1-sol | claude-sonnet-5-5 | المتفوق |
|---|---|---|---|
| Terminal-Bench 4.0 (رسمي) | غير معلن | 70.6% | claude-sonnet-5-5 |
| DeepSWE v1.1 | 75.2% | 71.0% | gpt-6.1-sol |
| GDPval-AA v2.1 | غير معلن (سجل الجيل السابق gpt-6-sol نسبة 1487) | 1844 | claude-sonnet-5-5 |
| تحليل مستندات GDP.pdf | 32.0% | غير معلن | gpt-6.1-sol |
| AutomationBench | 36.0% (نحو $0.30/مهمة) | 44.7% (نحو $1.14/مهمة) | للجودة Sonnet، وللتكلفة Sol |
| مؤشر الذكاء AA | 52 | 56 | claude-sonnet-5-5 |
| سعر قراءة التخزين المؤقت | $0.10 / مليون | $0.20 / مليون | gpt-6.1-sol |
💡 ملاحظة حول البيانات: تستند المعايير أعلاه إلى نتائج منشورة رسميًا من OpenAI وAnthropic، وإلى تقييمات جهات خارجية مثل Artificial Analysis وVellum. وتختلف إصدارات الاختبار ومستويات الاستدلال بين الجهات. ننصح بإجراء اختبار مقارن باستخدام عينات من أعمالك الفعلية، فهو أكثر فائدة من أي ترتيب على لوحة نتائج.
مقارنة التكلفة الفعلية بين gpt-6.1-sol و claude-sonnet-5-5
تساوي الأسعار المعلنة لا يعني تساوي الفاتورة النهائية. يقدّر الجدول التالي تكلفة الطلب الواحد في ثلاثة سيناريوهات تحميل شائعة (من دون احتساب كتابة التخزين المؤقت، وبالاعتماد على الأسعار الرسمية)، ويوضح بوضوح مصدر الفروقات.
| سيناريو الحمل | مكوّنات الطلب | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|---|
| حلقة وكيل ذكي (تخزين مؤقت مرتفع) | 100K إدخال (90% إصابة للتخزين المؤقت) + 5K إخراج | نحو $0.079 | نحو $0.088 |
| محادثة اعتيادية | 5K إدخال + 1K إخراج | نحو $0.020 | نحو $0.020 |
| استرجاع بسياق فائق الطول | 400K إدخال (من دون تخزين مؤقت) + 8K إخراج | نحو $1.72 (تفعيل السعر الإضافي) | نحو $0.88 |
| معالجة دفعية (Batch) | نصف السعر المعلن | $1 / $5 | $1 / $5 |
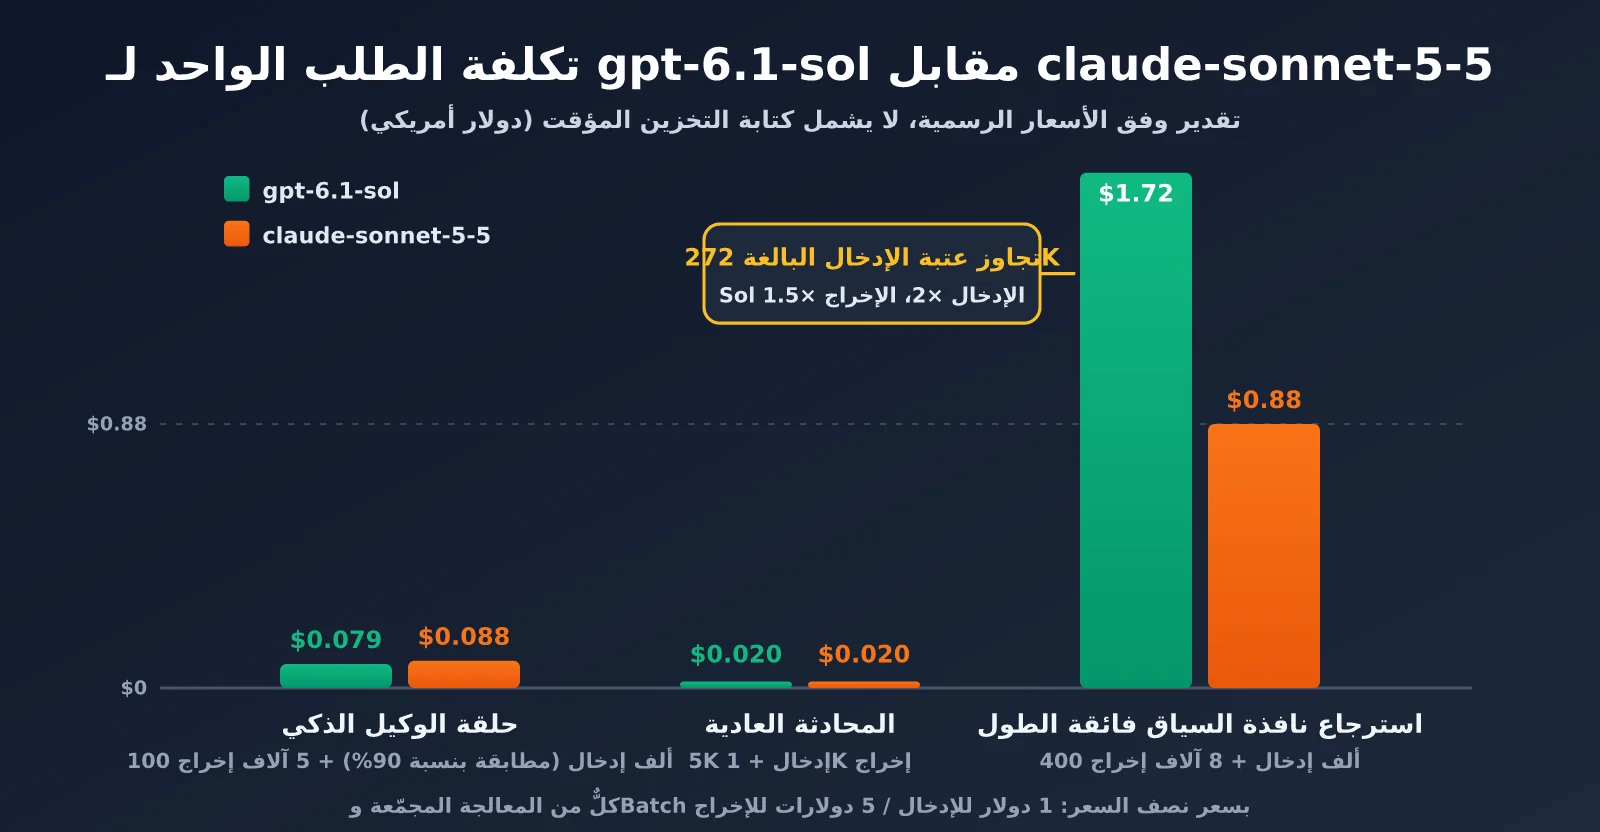
الخلاصة واضحة: في حلقات الوكلاء الذكية التي تتكرر فيها البادئة بدرجة كبيرة، يتفوق gpt-6.1-sol بنحو 10% بفضل انخفاض تكلفة قراءة التخزين المؤقت. أما في المحادثات الاعتيادية، فتكلفة النموذجين متقاربة جدًا. لكن عند تجاوز الإدخال الواحد 272K، تصبح تكلفة claude-sonnet-5-5 نحو نصف تكلفة gpt-6.1-sol.
هناك أيضًا عامل كفاءة الـ Token. فإذا شُغّل claude-sonnet-5-5 على مستوى high أو max، فقد يتضاعف عدد رموز الإخراج الفعلية، ما قد يلغي أفضلية السياق الطويل. لذلك، يُعد التحكم في مستوى الاستدلال مفتاحًا للاستفادة الجيدة من Sonnet.
مقارنة النموذجين بسرعة باستخدام مجموعة الشفرة نفسها
عبر واجهة متوافقة مع OpenAI، تحتاج فقط إلى تبديل معامل model لإجراء اختبار أفقي بين النموذجين. إليك مثالًا مبسطًا:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، والنموذجان يستخدمان مفتاحًا واحدًا
)

for model in ["gpt-6.1-sol", "claude-sonnet-5-5"]:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="medium",  # ثبّت المستوى نفسه لضمان مقارنة عادلة
        messages=[{"role": "user", "content": "أضف اختبارات وحدات لهذه الدالة:def add(a, b): return a + b"}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content[:200])
عرض التفاصيل: سكربت المقارنة الكامل مع إحصاءات الوقت والتكلفة
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة
)

# أسعار كل مليون Token: الإدخال، قراءة التخزين المؤقت، الإخراج
PRICES = {
    "gpt-6.1-sol": (2.0, 0.10, 10.0),
    "claude-sonnet-5-5": (2.0, 0.20, 10.0),
}

def run(model: str, prompt: str, effort: str = "medium"):
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}],
    )
    elapsed = time.time() - start
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p_in, p_cache, p_out = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p_in + cached * p_cache
            + u.completion_tokens * p_out) / 1_000_000
    return elapsed, u.prompt_tokens, u.completion_tokens, cost

tasks = [
    "نفّذ ذاكرة تخزين مؤقت LRU بمدة انتهاء باستخدام Python، واكتب الاختبارات",
    "اقرأ المتطلبات التالية، ثم اقترح تصميم جداول قاعدة البيانات والفهارس: الطلبات، المستخدمون، القسائم",
]

for task in tasks:
    for model in PRICES:
        t, i, o, c = run(model, task)
        print(f"{model:<20} {t:>6.1f}s  in={i:<6} out={o:<6} ${c:.4f}")
🚀 ابدأ بسرعة: إذا لم يكن لديك حساب Anthropic، أو كنت تواجه عوائق مثل الدفع الدولي أو التحقق برقم الهاتف، يمكنك التسجيل مباشرة في APIYI عبر apiyi.com للحصول على رصيد تجريبي. يتيح لك مفتاح واحد استدعاء gpt-6.1-sol وclaude-sonnet-5-5، دون الحاجة إلى إنشاء حسابين رسميين منفصلين.
توصيات سيناريوهات استخدام gpt-6.1-sol و claude-sonnet-5-5
تختلف أوزان الجودة والتكلفة وزمن الاستجابة من نشاط إلى آخر، وفيما يلي توصيات بحسب السيناريوهات الشائعة.
| سيناريو العمل | النموذج الموصى به | السبب الرئيسي |
|---|---|---|
| وكلاء برمجة يعملون عبر الطرفية، على غرار Claude Code | claude-sonnet-5-5 | يتفوق في Terminal-Bench 4.0، ويحتاج إلى عدد أقل من استدعاءات الأدوات |
| إصلاح الشيفرات على مستوى المستودع وسير عمل Codex | gpt-6.1-sol | يعادل Astra في DeepSWE، وتبلغ تكلفة المهمة الواحدة نحو $1.50 |
تحليل مستندات طويلة جدًا / شيفرة مستودع كامل (>272K) |
claude-sonnet-5-5 | لا توجد رسوم إضافية للسياق الطويل، وتكلفته تقارب نصف تكلفة Sol |
| خدمة عملاء عالية التزامن وأسئلة RAG مع تخزين مؤقت مرتفع | gpt-6.1-sol | تكلفة قراءة التخزين المؤقت $0.10؛ وكلما زاد تكرار استخدام البادئة انخفضت التكلفة |
| كتابة التقارير والجداول وأعمال المعرفة المكتبية | claude-sonnet-5-5 | يكاد يتعادل مع Opus 5.5 في GDPval-AA |
| تحليل مستندات PDF واستخراج المعلومات | gpt-6.1-sol | يعادل Astra في GDP.pdf، وتكلفة المهمة الواحدة نحو $0.38 |
| أبحاث الأمن والمساعدة في اختبارات الاختراق | gpt-6.1-sol | يتضمن Sonnet 5.5 حماية مدمجة للأمن السيبراني، ما يرفع معدل الرفض |
سيناريوهات نموذجية لاختيار gpt-6.1-sol
يُعد gpt-6.1-sol الأنسب للأنشطة الحساسة للتكلفة، وذات حجم الطلبات الكبير، والتكرار المرتفع للبادئات. ومن أمثلتها خدمة العملاء الذكية، وأسئلة قاعدة المعرفة، وتنظيف البيانات دفعات كبيرة. ففي هذه الحالات يُعاد استخدام موجه النظام وسياق الاسترجاع بدرجة كبيرة، وتستمر ميزة سعر قراءة التخزين المؤقت البالغ $0.10 في التضاعف.
كما تحسن معدل الهلوسة فيه بوضوح؛ إذ انخفض معدل الأخطاء الواقعية عند مستوى الاستدلال المنخفض من 11.4% في الجيل السابق إلى 7.7%. لذلك يناسب تشغيل المهام الخفيفة بأعداد كبيرة باستخدام مستوى low أو medium. إضافة إلى ذلك، ستطلق OpenAI قريبًا مستوى Ultrafast لـ gpt-6.1-sol، بسرعة توليد تصل إلى نحو 300 Token/ثانية وبسعر يعادل 6 أضعاف المستوى القياسي، وهو خيار متاح لمنتجات التفاعل الفوري.
سيناريوهات نموذجية لاختيار claude-sonnet-5-5
يلائم claude-sonnet-5-5 أكثر الأنشطة التي تتطلب مهام معقدة، وسياقًا طويلًا جدًا، ومعدل نجاح مرتفعًا من المحاولة الأولى. ففي مهام الوكلاء الذكية، يحتاج عادةً إلى نحو 3 استدعاءات للأدوات فقط لإتمام عمل يتطلب من Sonnet 5 ما بين 12 و13 استدعاءً. كما أن سرعة الإخراج فيه تتجاوز الجيل السابق بأكثر من 30%.
وبالنسبة إلى مراجعة المستندات القانونية، أو ترحيل مستودعات الشيفرات، أو كتابة التقارير الطويلة التي تتطلب وضع كمية كبيرة من المواد في السياق دفعة واحدة، فإن نافذة السياق التي تبلغ مليون رمز دون رسوم إضافية تمنحه ميزة واضحة.
يجدر التنبيه إلى أن claude-sonnet-5-5 يتضمن عدة تغييرات غير متوافقة مع الواجهة مقارنةً بـ Sonnet 5: لا يمكن تعطيل وضع التفكير، كما أُزيل خيار فرض استخدام أداة محددة tool_choice: "tool". إذا كانت شيفرتك القديمة تعتمد على هذه السلوكيات، فاحرص على إجراء اختبارات انحدار قبل الترحيل.
🎯 اقتراح معماري: ليس من الضروري الاختيار بين النموذجين فقط. نوصي ببناء توجيه بسيط للنماذج عبر APIYI apiyi.com: وجّه الطلبات القصيرة وحركة المرور ذات التخزين المؤقت المرتفع إلى gpt-6.1-sol، ووجّه السياقات الطويلة جدًا ومهام البرمجة المعقدة إلى claude-sonnet-5-5. ويمكنك التبديل حسب الحاجة عبر واجهة واحدة متوافقة مع OpenAI.
توصيات لاتخاذ القرار بين gpt-6.1-sol و claude-sonnet-5-5
يمكن تلخيص التحليل السابق في مجموعة خطوات عملية قابلة للتنفيذ:
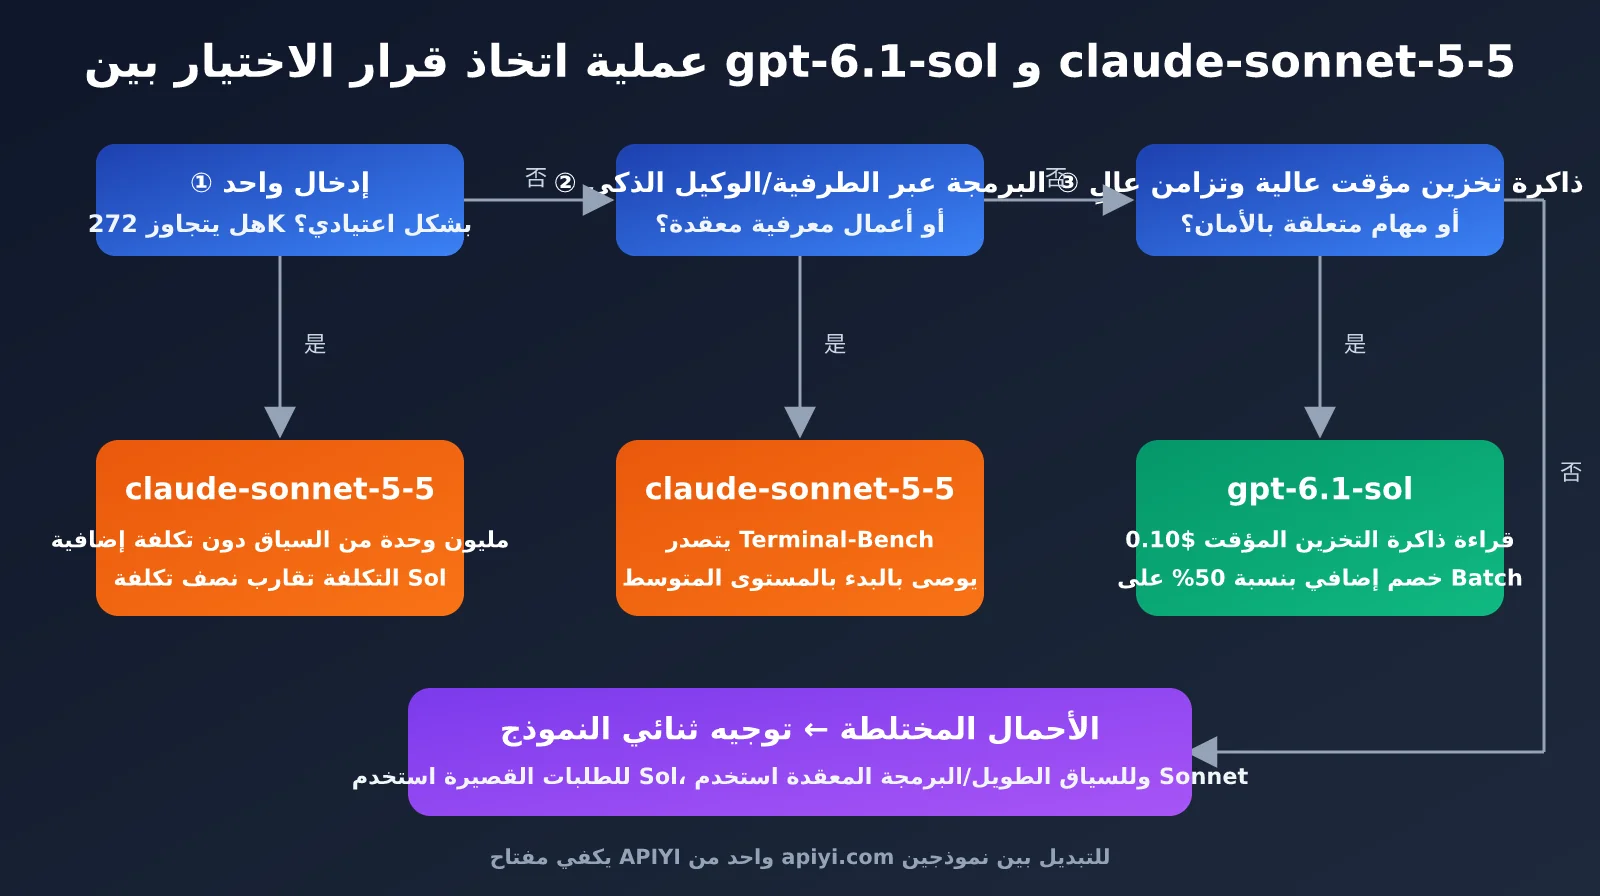
- ابدأ بطول الإدخال: إذا كانت الطلبات المعتادة تتجاوز 272K Token، فامنح الأولوية لـ claude-sonnet-5-5؛ وإلا انتقل إلى الخطوة التالية.
- ثم نوع المهمة: البرمجة عبر الطرفية/الوكلاء الذكيين والعمل المعرفي المعقد يميلان إلى claude-sonnet-5-5؛ أما إصلاح الشيفرة على مستوى المستودع وتحليل PDF فيميلان إلى gpt-6.1-sol.
- بعد ذلك، هيكل حركة المرور: في الأعمال ذات معدلات إصابة التخزين المؤقت العالية والتزامن الكبير، تتضاعف ميزة التكلفة لدى gpt-6.1-sol كلما زاد الحجم.
- وأخيرًا، اضبط مستوى الاستدلال: بغض النظر عن النموذج المختار، ابدأ الاختبار بمستوى medium. وبالنسبة إلى claude-sonnet-5-5 تحديدًا، تجنب استخدام إعداد API الافتراضي high مباشرةً، إذ قد يتضاعف استهلاك Token.
| أولويتك | الخيار الأول | استراتيجية بديلة |
|---|---|---|
| الجودة أولًا، والميزانية كافية | claude-sonnet-5-5(medium/high) | رقِّ المهام الصعبة فقط إلى Opus 5.5 |
| التكلفة أولًا، وحجم الطلبات ضخم | gpt-6.1-sol(low/medium) | نفِّذ المهام غير الفورية عبر Batch بخصم 50% |
| السرعة أولًا، والتفاعل لحظي | gpt-6.1-sol(بعد إطلاق Ultrafast) | مستوى low من claude-sonnet-5-5 |
| الاستقرار أولًا، وتجنب نقطة فشل واحدة | توجيه مزدوج بين النموذجين | التحويل تلقائيًا إلى النموذج الآخر عند تقييد أحدهما |
أما تفضيل العلامة التجارية وإمكانية الوصول، فلا ينبغي أن يكونا عاملين حاسمين في الاختيار التقني. فالحسابات الرسمية لـ Claude تفرض متطلبات أكثر صرامة على المنطقة ووسيلة الدفع، ما يرفع بالفعل عتبة الاستخدام؛ لكن هذه مشكلة في طبقة الوصول وليست مشكلة في قدرات النموذج. وعند إسناد طبقة الوصول إلى منصة API موحدة، يمكنك اختيار النموذج بالكامل وفق أداء المهمة وتكلفتها.
الأسئلة الشائعة
Q1: هل انخفض سعر gpt-6.1-sol و claude-sonnet-5-5 فعلًا؟
لم تتغير الأسعار المعلنة؛ فكلاهما لا يزال عند $2/$10. أما «الانخفاض» الفعلي فيتمثل في أن gpt-6.1-sol يقدم قدرات قريبة من gpt-6-astra بسعر يعادل الخُمس، كما انخفضت تكلفة قراءة التخزين المؤقت من $0.20 إلى $0.10. وفي المقابل، يقدم claude-sonnet-5-5 قدرات قريبة من Opus 5.5 بنصف سعر Opus، ويمكنه خفض تكلفة المهمة الواحدة بنحو 30% كحد أقصى عبر تقليل استدعاءات الأدوات. لذلك، عند المقارنة بينهما، ينبغي النظر إلى التكلفة الإجمالية للمهمة الواحدة بدلًا من سعر الوحدة.
Q2: كيف أستدعي claude-sonnet-5-5 من دون حساب Anthropic؟
تفرض حسابات Anthropic الرسمية متطلبات على منطقة التسجيل ورقم الهاتف ووسيلة الدفع، وغالبًا ما يواجه المطورون الأفراد والفرق داخل الصين عوائق في هذه الخطوة. ومن الحلول البسيطة استدعاؤه عبر APIYI على apiyi.com؛ إذ توفر المنصة واجهة متوافقة مع OpenAI. يكفي تغيير base_url إلى https://api.apiyi.com/v1 وتعيين model إلى claude-sonnet-5-5، دون الحاجة إلى تعديل بقية شيفرة العمل.
Q3: هل يمكن استخدام نافذة السياق البالغة 1.05 مليون في gpt-6.1-sol بالكامل دون قلق؟
يمكن ذلك، لكن انتبه إلى الفوترة. عندما يتجاوز الإدخال في الطلب الواحد 272K Token، تتضاعف أسعار الإدخال والتخزين المؤقت للطلب كاملًا، بينما يرتفع سعر الإخراج إلى 1.5 ضعف. إذا كان عملك يحتاج فعلًا إلى سياق طويل جدًا، فمن الأفضل أولًا ضغطه عبر الاسترجاع، أو توجيه هذه الطلبات إلى claude-sonnet-5-5 الذي لا يفرض تكلفة إضافية على السياق الطويل.
Q4: لماذا يكون claude-sonnet-5-5 أحيانًا أغلى من المتوقع؟
السبب الأساسي هو مستوى الاستدلال. فمستوى API الافتراضي لديه هو high، كما أن وضع التفكير لا يمكن إيقافه، ما قد يولد كمية كبيرة من رموز التفكير غير الضرورية في المهام البسيطة. وتُظهر اختبارات مستقلة أن استهلاك Token في مستوى medium مماثل لـ Sonnet 5، لكنه يقدم نتائج أفضل؛ لذا يُنصح بضبطه صراحةً على medium للمهام اليومية.
Q5: أيهما أختار لسيناريوهات البرمجة؟
إذا كنت تعتمد أساسًا على وكلاء ذكيين عبر الطرفية، مثل Claude Code، لتنفيذ تطوير متعدد الخطوات، فإن نتائج claude-sonnet-5-5 في Terminal-Bench أكثر إقناعًا. أما إذا كان تركيزك على إصلاح العيوب على مستوى المستودع والعمل ضمن سير عمل Codex، فإن gpt-6.1-sol يضاهي gpt-6-astra بتكلفة أقل للمهمة الواحدة. وإذا سمحت ظروف الفريق، فإن دمج النموذجين وتوزيع الطلبات بينهما حسب نوع المهمة هو الحل الأكثر أمانًا.
الخلاصة
لا توجد أفضلية مطلقة عند مقارنة gpt-6.1-sol مع claude-sonnet-5-5. يتفوق claude-sonnet-5-5 في برمجة الوكلاء، والعمل المعرفي، ومؤشر الذكاء، كما يوفّر نافذة سياق بحجم مليون رمز دون تكلفة إضافية. في المقابل، يتميز gpt-6.1-sol بأسعار التخزين المؤقت، وإصلاح الشيفرة على مستوى المستودعات، وتحليل المستندات، وتكلفة المهام الفردية، ما يجعله مناسبًا لحركة الإنتاج واسعة النطاق ومرتفعة إعادة الاستخدام. أسعار النموذجين المعلنة متطابقة، لكن الفارق الحقيقي في الفاتورة تحدده ثلاثة عوامل: طول الإدخال، ومعدل إصابة التخزين المؤقت، ومستوى الاستدلال.
عمليًا، يمكن اتباع ثلاث خطوات: ابدأ باستخدام مسار اتخاذ القرار الوارد في هذا المقال لتحديد النموذج الأساسي؛ ثم شغّل اختبار A/B باستخدام سكربت المقارنة على مهامك الفعلية، مع تثبيت مستوى الاستدلال نفسه؛ وأخيرًا، أنشئ توجيهًا ثنائي النماذج حسب نوع المهمة، بحيث يصل كل طلب إلى النموذج الأفضل من حيث التكلفة مقابل الأداء.
إذا كنت ترغب في تجاوز إجراءات إنشاء حسابين رسميين منفصلين لدى Anthropic وOpenAI، فيُنصح باستخدام APIYI عبر apiyi.com لاستدعاء gpt-6.1-sol وclaude-sonnet-5-5 من واجهة موحّدة. تتوافق واجهة المنصة مع صيغة OpenAI الرسمية، ويكفي مفتاح واحد للتبديل بحرية بين النموذجين، ما يجعلها مناسبة جدًا لاختبارات اختيار النموذج وتوجيه النماذج المتعددة في بيئات الإنتاج.
المراجع:
– إصدار OpenAI الرسمي: تقديم GPT-6.1 Sol على openai.com/index/introducing-gpt-6-1-sol
– إصدار Anthropic الرسمي: تقديم Claude Sonnet 5.5 على anthropic.com/claude-sonnet-5-5
– تقييم مؤشر الذكاء من Artificial Analysis: artificialanalysis.ai
– تحليل Vellum لمعايير GPT-6.1 Sol: vellum.ai/blog
– تقرير The Decoder حول Claude Sonnet 5.5: the-decoder.com
نبذة عن المؤلف: فريق APIYI التقني، متخصص في تكامل واجهات API لنماذج اللغة الكبيرة والممارسات الهندسية. نرحب بتواصلك عبر APIYI على apiyi.com لتبادل الخبرات حول اختيار gpt-6.1-sol وclaude-sonnet-5-5 وتحسين التكاليف.