ملاحظة المؤلف: انطلاقًا من مهمة تطوير برمجيات ينفذها وكيل ذكاء اصطناعي خلال 30 دقيقة، نفصّل مكونات تكلفة جولات الاستدعاء المتعددة للوكيل: الإدخال العادي، والكتابة إلى ذاكرة التخزين المؤقت، والقراءة منها، والمخرجات، والتبادل مع الأدوات. ونقارن طريقة احتساب رسوم التخزين المؤقت لدى ثلاثة مزوّدين، ثم نستخدم مثالًا من 12 استدعاءً لتوضيح الشروط التي تجعل التخزين المؤقت موفّرًا للتكلفة فعلًا.
في 9 نوفمبر 2026، أصدرت Google Cloud نظامَي TPU من الجيل الثامن: TPU 8tx وTPU 8i Max، كما أصدرت TPU Sync مفتوح المصدر لنقل KV Cache. وعاد موضوع «جدار الذاكرة في عصر الوكلاء» إلى الواجهة. ومن الطبيعي أن يتساءل كثير من المطورين: مع تزايد سرعة ذاكرة KV Cache في الطبقة الأساسية، هل ستنخفض فاتورة واجهة API الخاصة بالوكيل؟
القيمة الأساسية: بعد قراءة هذا المقال، ستحصل على معادلة متكاملة لحساب تكلفة الوكيل، ومقارنة بين رسوم التخزين المؤقت لدى ثلاثة مزوّدين، وقائمة بإجراءات تحسين التكلفة يمكنك تطبيقها فورًا.
تكلفة استدعاءات API متعددة الجولات للوكيل: لمحة سريعة عن المعلومات الأساسية
| البند | التفاصيل |
|---|---|
| الحدث | في 2026-11-09، أطلقت Google TPU 8tx وTPU 8i Max وTPU Sync، مع التركيز على اختناقات الذاكرة وذاكرة التخزين المؤقت KV لدى الوكلاء |
| ما يشغل بال المطورين | هل يمكن أن تؤدي التحسينات على مستوى البنية التحتية إلى خفض فاتورة API الخاصة بالوكيل؟ |
| الخلاصة الأساسية | تتحدد الفاتورة وفقًا لمجموع رموز الإدخال العادية، وكتابة الذاكرة المؤقتة، وقراءتها، ورموز الإخراج، وعدد الاستدعاءات، وتكاليف الأدوات |
| المتغيرات الأساسية | مدى ثبات البادئة، وما إذا كانت مدة الاحتفاظ بالذاكرة المؤقتة تغطي وقت انتظار الأدوات، وما إذا كان سجل السياق قد خرج عن السيطرة |
| نطاق التأثير | سيناريوهات الاستدعاء متعدد الجولات، مثل وكلاء البرمجة ووكلاء المستندات الطويلة وتعاون الوكلاء المتعددين |
كيف تبدو مهمة تستغرق 30 دقيقة لوكيل متعدد الجولات؟
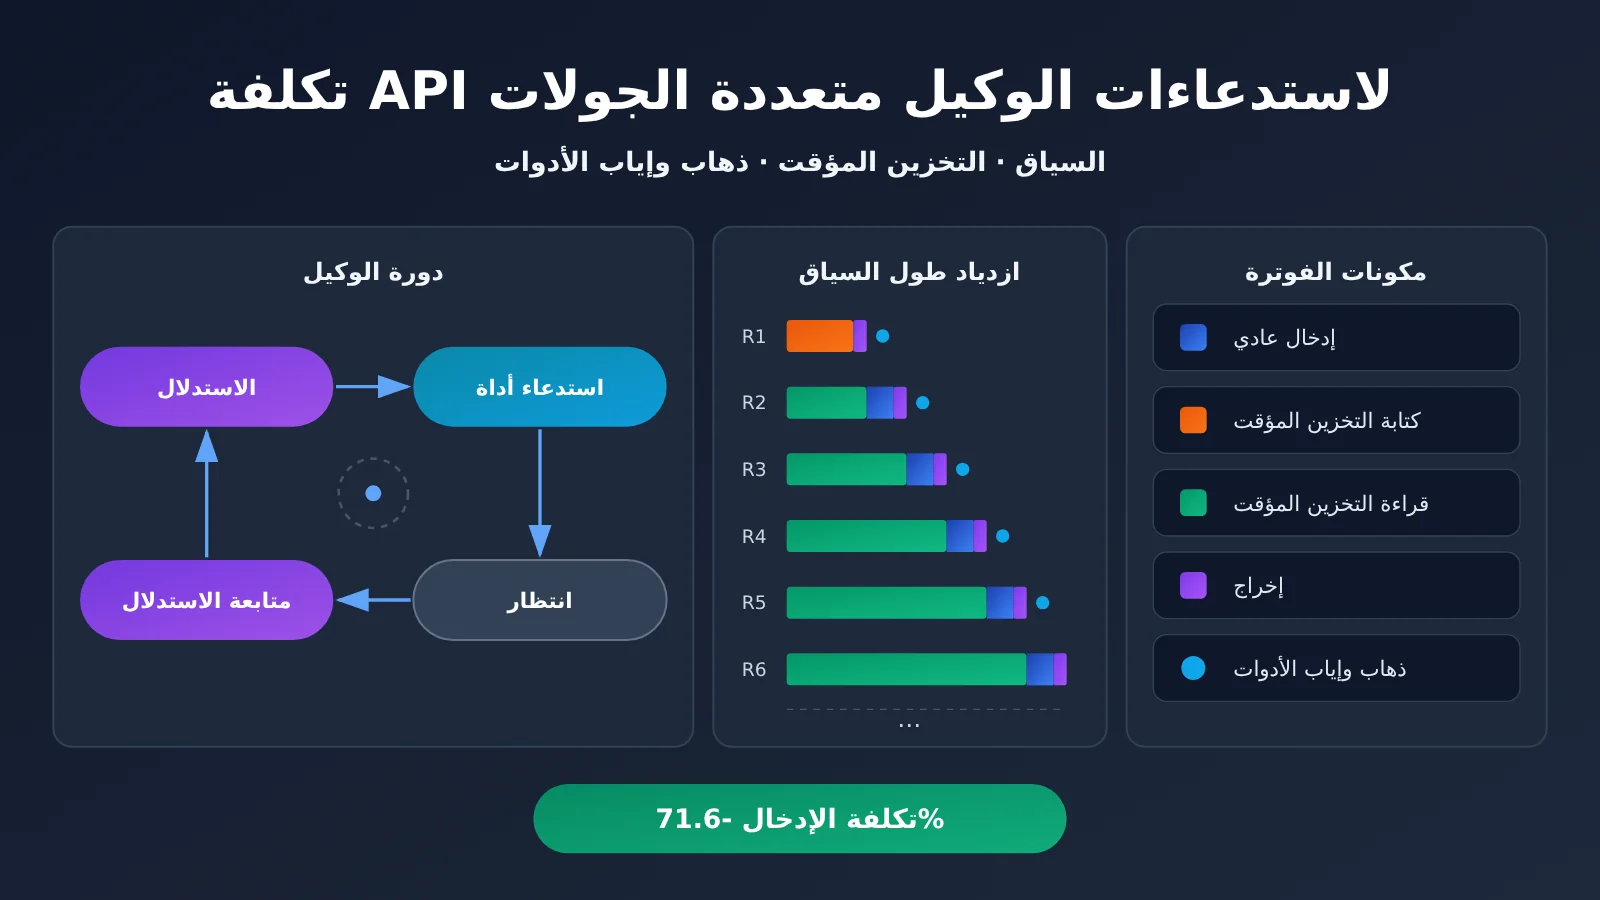
لنتصور أن وكيلًا لتطوير البرمجيات تلقى طلبًا لإصلاح إخفاق في اختبارات إحدى الوحدات. يبدأ بقراءة بنية المشروع والشفرة المصدرية ذات الصلة، ثم يضع خطة للتعديل، ويستخدم الأدوات لكتابة الملفات وتشغيل الاختبارات، وينتظر نتائجها، ثم يواصل الاستدلال بناءً على رسائل الخطأ. قد تتكرر دورة «استدلال—استخدام أداة—انتظار—استدلال» عشرات المرات خلال 30 دقيقة.
تكمن المشكلة في أن واجهات API للنماذج اللغوية الكبيرة عديمة الحالة بطبيعتها. في كل طلب، على الوكيل أن يرسل إلى النموذج من جديد موجه النظام وتعريفات الأدوات وخلفية المشروع، إلى جانب المحادثة السابقة ومخرجات الأدوات. وغالبًا ما يتضمن الطلب الثاني عشر معظم سجل الجولات الإحدى عشرة السابقة، وهذا هو مصدر «إعادة حساب السياق».
ممّ تتكوّن تكلفة استدعاءات API متعددة الجولات في Agent؟
عند تقسيم مهمة Agent إلى خطوات، نجد أن تكلفتها تتكوّن من خمسة أنواع على الأقل. الأنواع الأربعة الأولى هي تكاليف الرموز للنموذج، أما النوع الخامس فينشأ خارج النموذج، لكنه غالبًا ما يُغفل.
| بند التكلفة | المعنى | طريقة الاحتساب |
|---|---|---|
| الإدخال العادي | رموز الإدخال التي لم تُطابق ذاكرة تخزين مؤقت، وتُحتسب بالسعر القياسي | سعر الإدخال القياسي |
| الكتابة في الذاكرة المؤقتة | جزء الإدخال الذي يُستخدم لإنشاء ذاكرة مؤقتة قابلة لإعادة الاستخدام | يحتسب بعض مزوّدي الخدمة والنماذج تكلفته بمعدل أعلى من سعر الإدخال القياسي |
| القراءة من الذاكرة المؤقتة | الإدخال الذي يطابق ذاكرة مؤقتة موجودة | عادةً ما يكون سعره أقل بكثير من سعر الإدخال القياسي |
| رموز الإخراج | المحتوى الذي ينشئه النموذج، بما في ذلك مَعلمات استدعاء الأدوات | يكون سعره عادةً الأعلى، ولا تخفّضه الذاكرة المؤقتة |
| الأدوات والتنفيذ الخارجي | خدمات خارجية مثل البحث وتنفيذ التعليمات البرمجية وقواعد البيانات | تُحتسب تكلفتها وفق أسعار كل خدمة، كما تزيد عدد جولات استدعاء النموذج |
بناءً على ذلك، يمكن كتابة معادلة تكلفة المهمة الواحدة كما يلي:
التكلفة الإجمالية للمهمة = Σ (الإدخال العادي × سعر الإدخال + الكتابة في الذاكرة المؤقتة × سعر الكتابة + القراءة من الذاكرة المؤقتة × سعر القراءة + الإخراج × سعر الإخراج) + تكاليف الأدوات والتنفيذ الخارجي
تشير Σ في المعادلة إلى جمع تكلفة كل استدعاء للنموذج ضمن المهمة. وهذا يعني أن عدد الاستدعاءات عامل مضاعِف بحد ذاته: فكلما زادت جولات التفاعل مع الأدوات، زاد عدد استدعاءات النموذج، وتكرّر احتساب تكلفة البادئة الثابتة. ولا تقتصر تكلفة استدعاء الأدوات على رسوم الأدوات نفسها، بل إنها تقسّم عملية الاستدلال إلى عدة استدعاءات، يتطلب كل منها إعادة إرسال السياق.
الفرق بين KV Cache وPrompt Cache وضغط السياق في استدعاءات Agent متعددة الجولات
عند مناقشة تكاليف Agent، يسهل الخلط بين ثلاثة مفاهيم. فكل منها ينتمي إلى طبقة مختلفة، ويؤثر في الفاتورة بطريقة مغايرة.
| التقنية | الطبقة | المقصود بها | أثرها على مستخدمي API |
|---|---|---|---|
| KV Cache | الطبقة الأساسية لاستدلال النموذج | حفظ حالات Key/Value المستخدمة في حساب الانتباه لتجنب إعادة حساب الرموز السابقة | لا يتحكم بها المستخدم مباشرة؛ لكنها تؤثر في تكاليف مزوّد الخدمة وزمن الاستجابة |
| Prompt Cache | طبقة خدمة API | إعادة استخدام مزوّد الخدمة للبادئات المتكررة في الموجهات، مع احتساب رسوم منفصلة لكتابة البيانات في ذاكرة التخزين المؤقت وقراءتها منها | يظهر أثرها مباشرة في حقول ذاكرة التخزين المؤقت في الفاتورة |
| ضغط السياق | طبقة التطبيق | تلخيص المحتوى السابق أو تصفيته أو اقتطاعه قبل إرساله | يقلل عدد الرموز المُرسلة فعليًا، لكنه قد يؤدي إلى فقدان بعض التفاصيل |
من الجدير بالانتباه أن وثائق OpenAI الرسمية توضح أن Prompt Cache يخزّن فعليًا موترات KV، لا نص الرموز الأصلي. لذلك يمكن فهم Prompt Caching على أنه تحويل إمكانية إعادة استخدام حالات KV في الطبقة الأساسية إلى خدمة لها آلية فوترة. فهو ليس منفصلًا تمامًا عن KV Cache، لكن ما يلاحظه المستخدم هو قواعد الفوترة فقط.
أما ضغط السياق فهو أمر مختلف؛ إذ يغيّر ما «تحمله» الطلبات اللاحقة، لا طريقة إعادة استخدامه. وكلما زاد الضغط، قلّ عدد الرموز، لكن ارتفع أيضًا خطر أن ينسى Agent تفاصيل مهمة.
لماذا لا تعني التحسينات الأساسية لاستدعاءات Agent متعددة الجولات انخفاض الفاتورة؟
ضاعفت Google عرض نطاق HBM وسعة SRAM المدمجة على الشريحة في TPU 8i Max. كما خفّض TPU Sync زمن نقل KV Cache بأكثر من 90% في الاختبارات الداخلية على منصة Ironwood، بينما يوقف Agent Compute Engine الجلسات مؤقتًا عندما يكون Agent خاملاً، وينقل ذاكرة العمل خارج الشريحة. وتؤثر هذه التحسينات في كفاءة استخدام موارد مزوّد الخدمة وزمن الاستدلال، مثل TTFT، وقد تظهر للمستخدم في صورة استجابة أسرع.
لكن أسعار API تحددها سياسة مزوّد الخدمة التجارية، وتظل فاتورة المستخدم محسوبة بحسب عدد الرموز. وقد تؤثر كفاءة الأجهزة المحسّنة في الأسعار على المدى البعيد، لكن ذلك لا يحدث تلقائيًا ولا بنسبة متساوية. كذلك، ظل TPU 8tx وTPU 8i Max مصنّفين على أنهما «قريبًا» حتى 2026-11-10، ولم تُعلن أسعارهما بعد. ما يستطيع المطوّر التحكم فيه فورًا هو بنية الرموز التي يرسلها، لا الأجهزة لدى المزوّد.
تكلفة استدعاءات الوكلاء متعددة الجولات عبر API: مقارنة احتساب رسوم التخزين المؤقت لدى ثلاثة مزوّدين
يوفّر المزوّدون الثلاثة الرئيسيون آليات للتخزين المؤقت، لكنهم يختلفون بوضوح في طريقة تفعيلها ومدة صلاحيتها (TTL) وأسلوب احتساب الرسوم. أُعدّ الجدول أدناه استنادًا إلى الوثائق الرسمية لكل مزوّد، لذا يُرجى الرجوع إلى تفاصيل النموذج والواجهة المعنيين.
| المزوّد | آلية التخزين المؤقت | خيارات TTL | رسوم الكتابة | رسوم القراءة | المنصات المتاحة |
|---|---|---|---|---|---|
| OpenAI | التخزين المؤقت للموجّه (Prompt Caching)، مع دعم التخزين التلقائي للبادئات في النماذج | 30 دقيقة افتراضيًا لبعض النماذج الجديدة، وتدعم بعض النماذج 12 ساعة | في النماذج والواجهات التي تدعم الإعدادات المناسبة: تبلغ الرسوم 1.25 ضعف سعر الإدخال العادي لمدة 30 دقيقة، و2.5 ضعفًا لمدة 12 ساعة؛ وقد لا تُفرض رسوم كتابة إضافية في أنماط التخزين المؤقت الأخرى | عادةً 0.1 ضعف سعر الإدخال العادي، وأقل من ذلك في بعض النماذج | API الرسمية، وAPIYI apiyi.com |
| Anthropic | التخزين المؤقت للموجّه (Prompt Caching) | 5 دقائق افتراضيًا، ويمكن تمديدها إلى ساعة واحدة | تبلغ الرسوم 1.25 ضعف سعر الإدخال العادي لمدة 5 دقائق، وضعفين لمدة ساعة واحدة | تختلف حسب النموذج | API الرسمية، وAPIYI apiyi.com |
| Google Gemini | التخزين المؤقت للسياق (Context Caching)، ويشمل التخزين الضمني والصريح | يمكن ضبط TTL للتخزين المؤقت الصريح | تُحتسب رسوم إضافية للتخزين المؤقت الصريح وفقًا لعدد الرموز المخزّنة ومدة التخزين | يقلّل التطابق من تكلفة الإدخال المتكرر | API الرسمية، وAPIYI apiyi.com |
لنأخذ السعر الرسمي لـ Claude Sonnet 5.5 مثالًا: يبلغ سعر الإدخال العادي 2.00 دولار لكل مليون رمز، وتبلغ تكلفة كتابة التخزين المؤقت لمدة 5 دقائق 2.50 دولار، ولمدة ساعة واحدة 4.00 دولارات، بينما تبلغ تكلفة قراءة المحتوى المخزّن مؤقتًا 0.10 دولار. أي إن قراءة المحتوى المخزّن تكلف 5% فقط من سعر الإدخال العادي، وهذا ما يفسر الانخفاض الكبير في التكلفة عند تكرار البادئة.
تجدر الإشارة إلى أن OpenAI توضح رسميًا أن إصابة التخزين المؤقت ليست مضمونة في كل مرة، كما أن التخزين المؤقت الصريح في Gemini ليس «تخزينًا مجانيًا»، إذ تُفرض رسوم على مدة التخزين نفسها. التخزين المؤقت خصم مشروط، وليس تخفيضًا تلقائيًا للأسعار.
🎯 نصيحة تقنية: تختلف إمكانات التخزين المؤقت وقواعد احتساب الرسوم وحقول الاستجابة بين النماذج المختلفة لدى المزوّدين، ولا تضمن البوابة الموحدة حصول جميع النماذج على الخصومات نفسها. ننصح باستخدام APIYI apiyi.com لاختبار النماذج المرشحة، كلٌّ على حدة، بالاعتماد على مجموعة واحدة من الشفرة المتوافقة مع OpenAI، ثم الاستناد إلى حقول
usageوالفاتورة الفعلية.
الحساب الفعلي لتكلفة التخزين المؤقت لاستدعاءات الوكيل متعددة الجولات: مثال من 12 استدعاءً
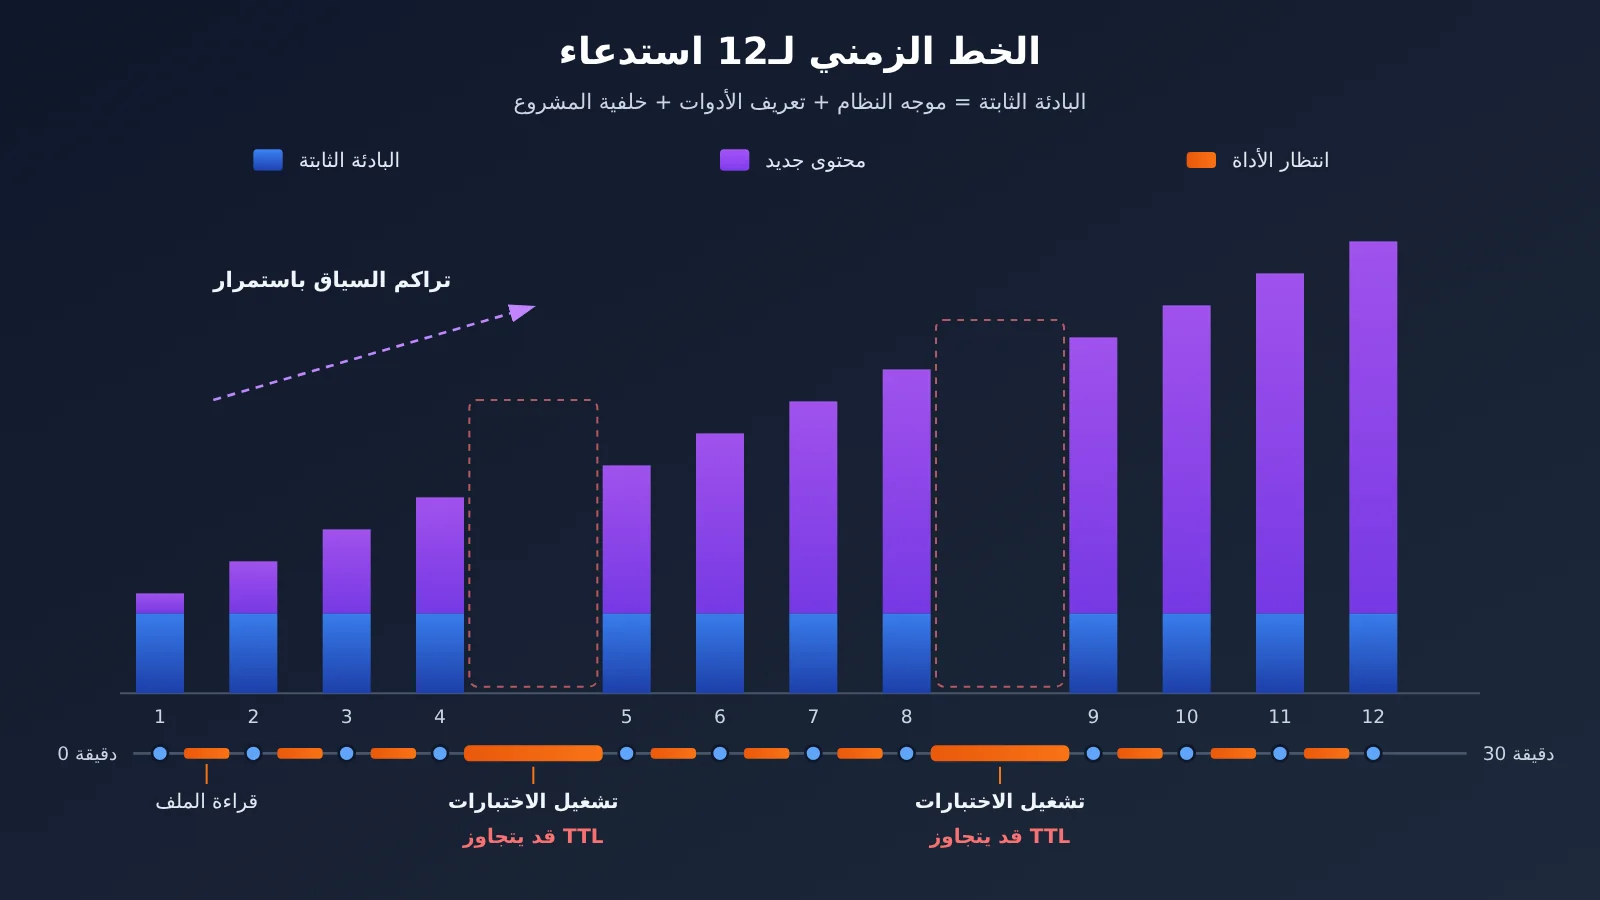
لنستخدم مهمة التطوير التي تستغرق 30 دقيقة، المذكورة في القسم السابق، ونبني مثالًا بالاستناد إلى الأسعار الرسمية لـ Claude Sonnet 5.5. نفترض ما يلي:
- يستدعي النموذج 12 مرة خلال المهمة، ويحتوي كل استدعاء على 22,000 Token كمدخلات؛
- 20,000 Token منها عبارة عن موجه النظام المتكرر وتعريفات الأدوات وخلفية المشروع؛
- يُضاف 2,000 Token جديد في كل مرة؛
- تُستخدم ذاكرة تخزين مؤقت مدتها ساعة واحدة، وتنجح الطلبات اللاحقة كلها في إعادة استخدام محتواها.
من دون التخزين المؤقت: 12 × 22,000 × $2 / 1,000,000 = $0.528.
باستخدام ذاكرة تخزين مؤقت مدتها ساعة واحدة: تبلغ تكلفة كتابة 20,000 Token في المرة الأولى $0.080، وتكلفة الإدخال العادي البالغ 2,000 Token في المرة الأولى $0.004، وتكلفة قراءة المحتوى المخزّن مؤقتًا في الاستدعاءات الـ11 اللاحقة $0.022، وتكلفة المدخلات الجديدة في هذه الاستدعاءات $0.044. ويبلغ المجموع $0.150، أي توفير نحو 71.6% من تكلفة الإدخال.
يحسب هذا المثال تكلفة Token الإدخال فقط، ولا يشمل Token الإخراج أو استدعاءات الأدوات أو تكاليف الخدمات الخارجية. يزداد السجل التاريخي للوكيل مع كل جولة فعلية، لكن الخلاصة لا تتغير: السياق المتكرر هو أكثر ما يضخّم التكلفة في استدعاءات الوكيل متعددة الجولات.
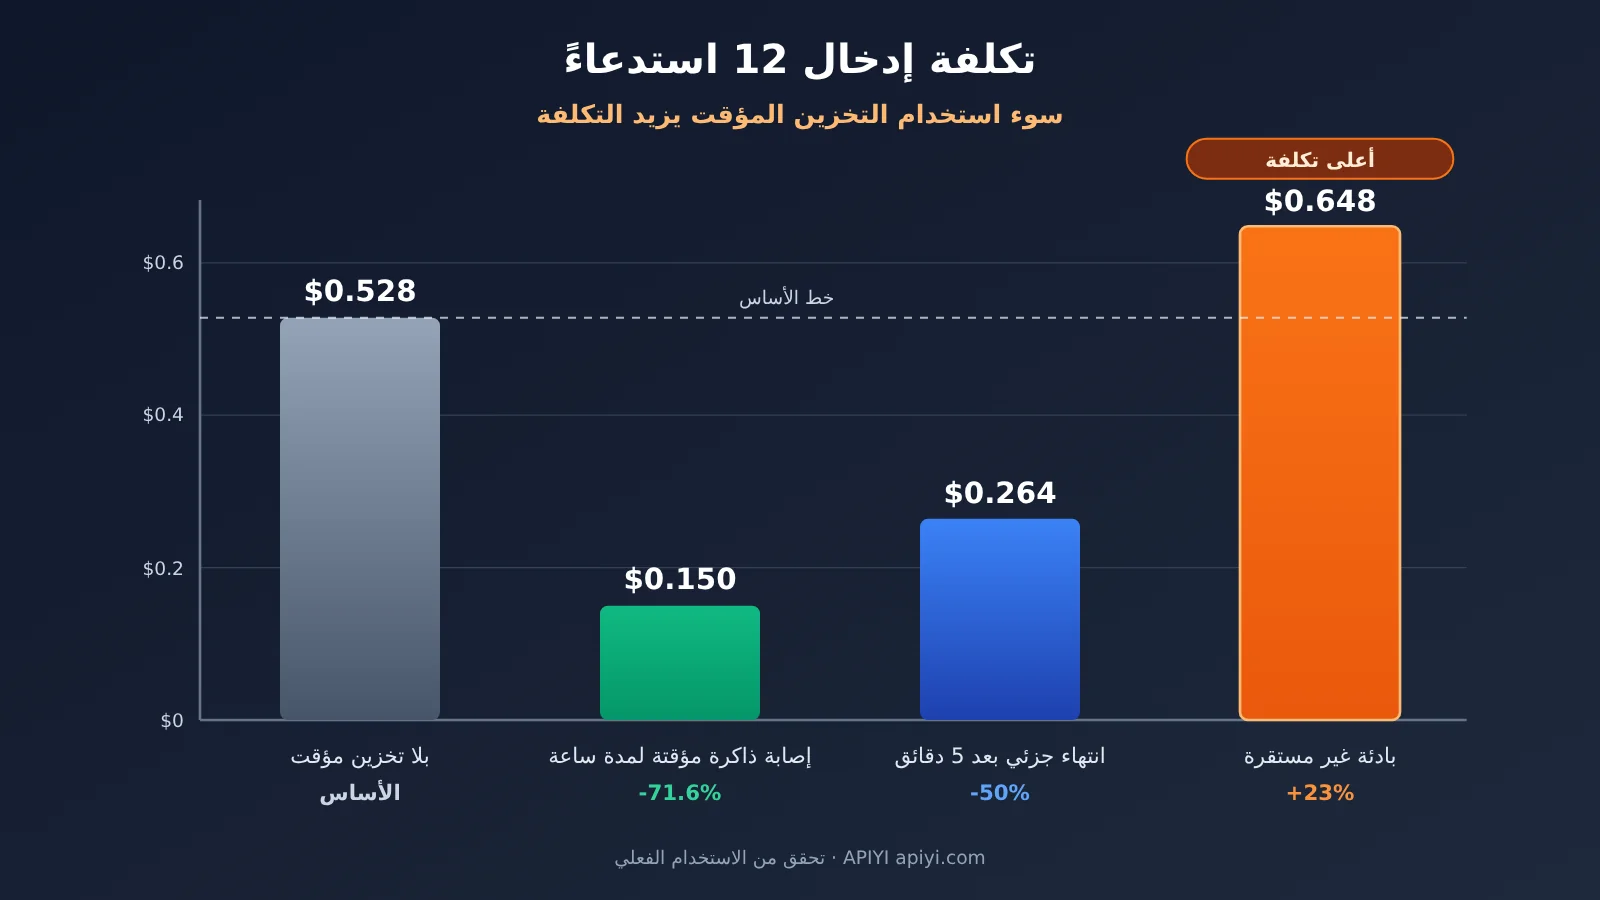
أثر انتهاء صلاحية الذاكرة المؤقتة وتغيّر البادئة ومدة TTL في تكلفة الوكيل
ما سبق هو السيناريو المثالي. فيما يلي مقارنة إضافية لثلاثة انحرافات شائعة، باستخدام الأسعار نفسها. (هذه سيناريوهات توضيحية حسبناها في هذه المقالة استنادًا إلى الأسعار الرسمية.)
| السيناريو | الافتراضات | تكلفة الإدخال | مقارنةً بعدم استخدام الذاكرة المؤقتة |
|---|---|---|---|
| من دون ذاكرة مؤقتة | تُحتسب الطلبات الـ12 كلها بسعر الإدخال العادي | $0.528 | الأساس |
| إصابة كاملة بذاكرة مؤقتة لمدة ساعة واحدة | عملية كتابة واحدة و11 عملية قراءة | $0.150 | توفير نحو 71.6% |
| إصابة كاملة بذاكرة مؤقتة لمدة 5 دقائق | سعر الكتابة $2.50 و11 عملية قراءة | $0.120 | توفير نحو 77.3% |
| انتهاء جزئي لصلاحية ذاكرة مؤقتة لمدة 5 دقائق | يؤدي انتظار الأداة حتى انتهاء المهلة إلى 4 عمليات كتابة و8 عمليات قراءة إجمالًا | $0.264 | توفير نحو 50% |
| بادئة غير مستقرة | تتغير البادئة في كل مرة، فتُحتسب الطلبات الـ12 كلها بسعر الكتابة لمدة 5 دقائق | $0.648 | تكلفة أعلى بنحو 23% |
يمكن الاستفادة من النقاط التالية مباشرةً عند اتخاذ القرار:
- ينبغي أن تغطي مدة TTL وقت انتظار الأداة: الكتابة في ذاكرة مؤقتة لمدة 5 دقائق أقل تكلفة، لكن إذا استغرق تشغيل الاختبار أو التأكيد البشري أكثر من 5 دقائق، فستنتهي صلاحية الذاكرة ويُعاد تخزين المحتوى، ما يقلل التوفير بوضوح.
- استقرار البادئة أهم من مدة TTL: وضع الطوابع الزمنية أو المعرّفات العشوائية في بداية الموجه يمنع كل طلب من إصابة الذاكرة المؤقتة. وفي الأنماط التي تُفرض فيها تكلفة إضافية على الكتابة، قد تزيد الذاكرة المؤقتة الفاتورة بدلًا من خفضها.
- مدة TTL الأطول ليست الأفضل دائمًا: سعر الكتابة لمدة ساعة أعلى بـ1.6 مرة من سعرها لمدة 5 دقائق؛ ولا يكون ذلك مجديًا إلا إذا كان من المحتمل أن يتجاوز الفاصل بين الاستدعاءات 5 دقائق بالفعل.
كيفية خفض تكلفة API عند استدعاء الوكيل عدة مرات
مثال مبسّط جدًا: تسجيل مرات إصابة ذاكرة التخزين المؤقت لكل استدعاء
الخطوة الأولى للتحسين هي «رؤية» التكلفة. يرسل الكود أدناه طلبًا عبر واجهة متوافقة مع OpenAI، ثم يطبع الحقول المتعلقة بذاكرة التخزين المؤقت ضمن usage:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة OpenAI المتوافقة من APIYI
)

resp = client.chat.completions.create(
    model="your-model-name",  # استبدل هذا باسم النموذج الذي تريد اختباره
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
عرض التنفيذ الكامل: بادئة ثابتة + تتبّع تكلفة المهمة الواحدة
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# بادئة ثابتة: ضع تعليمات النظام وتعريفات الأدوات والخلفية العامة للمشروع في البداية، وحافظ على ثباتها حرفيًا
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # الأسعار: دولار لكل مليون Token؛ أدخل السعر الرسمي للنموذج المستخدم
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # أضف الرسالة الجديدة فقط، ولا تعِد ترتيب سجل المحادثة؛ وضع المعلومات المتغيرة، مثل الطوابع الزمنية، في النهاية
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
يُرجى ملاحظة أن التقدير أعلاه يشمل خصم قراءة البيانات المخزنة مؤقتًا فقط. إذا كان النموذج المستخدم يفرض رسومًا منفصلة على الكتابة إلى ذاكرة التخزين المؤقت، فأضف تكلفة الكتابة وفقًا للحقول التي يعيدها النموذج. قد تختلف أسماء حقول usage ومعانيها من نموذج إلى آخر، لذا اعتمد على القيم التي يعيدها النموذج فعليًا.
🚀 البدء السريع: يُنصح بتجربة سكربت التتبّع أعلاه أولًا باستخدام رصيد الاختبار المجاني على APIYI apiyi.com، لمعرفة معدل إصابة الذاكرة المؤقتة وتكلفة المهمة نفسها مع نماذج مختلفة، ثم اختيار النموذج ومدة TTL المناسبين لبيئة الإنتاج.
خمس خطوات لتحسين تكلفة استدعاءات Agent المتعددة
- ثبّت بادئة الموجه: ضع تعليمات النظام وتعريفات الأدوات والمواد المرجعية المشتركة في البداية، ومعلومات المستخدم المتغيرة والطوابع الزمنية في النهاية. ولا تغيّر ترتيب تعريفات الأدوات أو حقولها من دون حاجة.
- اختر TTL مناسبًا: استخدم مدة TTL قصيرة للمهام ذات الاستدعاءات المتكررة والفواصل الزمنية القصيرة. أما Agent الذي يتضمن فترات طويلة للاختبار أو البناء أو الموافقة البشرية، فقيّم ما إذا كانت وفورات إعادة الكتابة التي يتيحها TTL الأطول تعوّض تكلفة الكتابة الإضافية.
- اضبط سجل السياق: أضف إلى السجل دون إعادة ترتيب محتواه، لتجنّب الإخلال ببادئة الذاكرة المؤقتة. لخّص مخرجات الأدوات المطوّلة، مع الاحتفاظ بالاستنتاجات المهمة وحالة المهمة والأدلة الضرورية.
- قلّل استدعاءات النموذج غير الضرورية: ادمج الأدوات التي يمكن تنفيذها على دفعات في استدعاء واحد، وأسند الخطوات الحتمية إلى الشيفرة بدلًا من طلب تقييم النموذج، لتقليل عدد جولات التفاعل من الأساس.
- راقب المؤشرات الفعلية: سجّل لكل مهمة عدد رموز الإدخال العادي، وعمليات الكتابة إلى الذاكرة المؤقتة والقراءة منها، ورموز الإخراج، ومعدل إصابة الذاكرة المؤقتة، وTTFT، والتكلفة الإجمالية. قيّم التكلفة على مستوى المهمة، لا على مستوى الطلب الواحد.
تحليل تأثير استدعاءات API المتعددة في الوكلاء على التكلفة
التأثير في المطوّرين
- يجب أن ينتقل نموذج التكلفة من «الطلب الواحد» إلى «المهمة الواحدة»: تتحدد تكلفة الوكيل وفق سلسلة الاستدعاءات كاملة، لذا فإن النظر إلى سعر الاستدعاء الواحد فقط يؤدي إلى تقدير أقل بكثير من الفاتورة الفعلية.
- بدأت هندسة الموجهات تراعي بنية الفوترة أيضًا: يؤثر استقرار البادئة مباشرةً في إمكانية الاستفادة من التخزين المؤقت، لذا أصبح تصميم بنية الموجهات جزءًا من هندسة التكلفة.
- يتطلب اختيار النماذج المختلفة اختبارات عملية: تختلف نسب الخصم على التخزين المؤقت ومدة صلاحيته (TTL والزيادة في تكلفة الكتابة) باختلاف النموذج، وقد تتفاوت تكلفة المهمة نفسها كثيرًا عند استخدام نموذج آخر.
التأثير في القطاع
- تتركز المنافسة في البنية التحتية على أحمال الوكلاء: يشير تركيز Google على عرض نطاق الذاكرة ونقل KV Cache وإيقاف الوكلاء مؤقتًا واستئنافهم إلى أن تعدد الجولات والسياقات الطويلة أصبحا من أشكال الأحمال الشائعة.
- تظهر فائدة التحسينات للمستخدمين أولًا في زمن الاستجابة: تحسّن التحسينات على مستوى البنية الأساسية زمن الوصول إلى أول رمز (TTFT) ومعدل الإنتاجية أولًا. أما خفض سعر الرمز فيعتمد على سياسة التسعير لدى مزوّد الخدمة، لذا يُستحسن ألا يُدرجه المطوّرون في الميزانية مسبقًا.
الأسئلة الشائعة
س1: لماذا تتجاوز تكلفة API لاستدعاءات الوكيل الذكي متعددة الجولات التوقعات؟
لأن API عديم الحالة، يجب إرفاق موجه النظام وتعريفات الأدوات وسياق المحادثة السابق من جديد مع كل استدعاء. وكلما زاد عدد الاستدعاءات، تكررت محاسبتك على هذه المحتويات الثابتة مرات أكثر، كما تزيد جولات التفاعل مع الأدوات عدد الاستدعاءات.
س2: هل KV Cache وPrompt Cache شيء واحد؟
ليس تمامًا. يعيد KV Cache استخدام الحالة على مستوى الاستدلال في النموذج، أما Prompt Cache فهو تخزين مؤقت للبادئات القابلة لإعادة الاستخدام على مستوى API لدى مزوّد الخدمة، مع احتساب تكلفته. وتوضح وثائق OpenAI أن ما يُخزَّن هو KV Tensor. يمكن للمستخدم ملاحظة Prompt Cache من خلال قواعد الفوترة فقط، ولا يمكنه التحكم مباشرةً في KV Cache.
س3: هل ستنخفض أسعار API فور إصدار Google وحدات TPU الجديدة؟
لا توجد معلومات تبرر هذا الاستنتاج. فحتى 2026-11-10، لا تزال TPU 8tx وTPU 8i Max بحالة Coming soon، ولم تُعلن أسعارهما. تحسّن التحسينات على مستوى العتاد كفاءة استخدام الموارد وزمن الاستجابة لدى مزوّدي الخدمة، لكن انتقال أثرها إلى أسعار الرموز يعتمد على سياسة التسعير لدى كل مزوّد.
س4: هل يوفّر التخزين المؤقت المال دائمًا؟
ليس بالضرورة. فإذا تغيّرت البادئة في كل مرة، فلن يتحقق تطابق مع الذاكرة المؤقتة، وإذا كان الوضع المستخدم يفرض تكلفة إضافية على الكتابة إليها، فقد تكون التكلفة أعلى من عدم استخدامها. كما أن انتظار الأدوات لمدة تتجاوز TTL يؤدي إلى تكرار الكتابة، ما يقلل من التوفير.
س5: كيف أقارن بسرعة بين أداء التخزين المؤقت في النماذج المختلفة؟
يُفضّل تشغيل سير العمل نفسه لمهمة واحدة للوكيل الذكي على عدة نماذج، وتسجيل معدل إصابة الذاكرة المؤقتة والتكلفة الإجمالية لكل مهمة. ويمكنك عبر APIYI apiyi.com استخدام مفتاح API واحد لاستدعاء نماذج OpenAI وClaude وGemini وغيرها، ثم مقارنة النتائج بمجرد تغيير المعامل model.
س6: ما مخاطر ضغط السياق؟
يغيّر الضغط المحتوى المرفق بالطلبات اللاحقة، وقد يؤدي إلى فقدان تفاصيل مهمة، ما يجعل الوكيل الذكي يكرر أخطاءه ويزيد عدد جولات الاستدعاء بدلًا من تقليله. كذلك، إذا أُعيد إنشاء المحتوى المضغوط في كل جولة، فقد يؤدي ذلك إلى تغيير بادئة التخزين المؤقت؛ لذا ينبغي تصميم الضغط بالتوازي مع استراتيجية التخزين المؤقت.
س7: عند الاستدعاء عبر بوابة موحّدة، هل تسري مزايا التخزين المؤقت نفسها على كل النماذج؟
لا. تعتمد إمكانات التخزين المؤقت وقواعد الفوترة والحقول المعادة على النموذج المستخدَم لدى المزوّد الأصلي. عند الاختبار على APIYI apiyi.com، تحقّق من حقول التخزين المؤقت والخصم الفعلي لكل نموذج على حدة قبل إدراجها في ميزانية التكلفة.
النقاط الأساسية حول تكلفة استدعاءات API متعددة المراحل للوكيل
- وحدة التكلفة هي المهمة: تُحتسب فاتورة الوكيل بجمع تكاليف سلسلة الاستدعاءات كاملة، لا تكلفة طلب واحد.
- السياق المتكرر هو مصدر التكلفة الأكبر: في مثال يتضمن 12 استدعاءً، يمكن لذاكرة تخزين مؤقت صالحة لمدة ساعة أن تخفض تكلفة الإدخال بنحو 71.6%.
- خصم التخزين المؤقت مشروط: إذا لم تكن البادئة مستقرة، أو كانت مدة الصلاحية قصيرة جدًا، يقل التوفير وقد ترتفع التكلفة بدلًا من أن تنخفض.
- تختلف طرق الفوترة بين الشركات الثلاث: لذا يجب التحقق من مضاعف الكتابة، وخصم القراءة، ورسوم التخزين لكل نموذج على حدة.
- تحسين الأجهزة لا يعني بالضرورة انخفاض الفاتورة: تحسّن تحسينات KV على مستوى البنية الأساسية زمن الاستجابة أولًا، أما السعر فيعتمد على تسعير مزوّد الخدمة.
- قِس أولًا، ثم حسِّن: استخدم APIYI apiyi.com، بواجهة موحّدة، لقياس معدل إصابة ذاكرة التخزين المؤقت وتكلفة المهمة لكل نموذج على بيانات فعلية.
الخلاصة
تتحدد تكلفة API لاستدعاءات الوكيل متعددة المراحل بثلاثة عوامل مترابطة: إعادة احتساب السياق، ونجاح التخزين المؤقت، والذهاب والإياب إلى الأدوات:
- إعادة احتساب السياق تحدد أساس التكلفة؛ فكلما زاد عدد الاستدعاءات، زاد المحتوى الذي يُعاد احتسابه.
- نجاح التخزين المؤقت يحدد مقدار الخصم على المحتوى المتكرر؛ واستقرار البادئة ومدة صلاحية التخزين عاملان أساسيان.
- الذهاب والإياب إلى الأدوات يضيف تكاليف خارجية، ويزيد أيضًا عدد استدعاءات النموذج.
تسهم استثمارات Google في البنية التحتية، مثل ذاكرة KV المؤقتة وجدار الذاكرة، في تسريع تشغيل الوكلاء. لكن ما يستطيع المطوّر التحكم فيه مباشرة هو بنية الرموز المميّزة لديه. لذا يُنصح بالتركيز على خمسة جوانب: تثبيت البادئة، واختيار مدة صلاحية مناسبة، وتقليص السجل، وتقليل عدد الاستدعاءات، ومراقبة التكلفة على مستوى المهمة. ويمكنك استخدام APIYI apiyi.com للتحقق من أثر كل تحسين ببيانات فعلية.
📚 مراجع
- مدونة Google Cloud – تقديم TPU 8tx وTPU 8i Max: إعلان إطلاق أنظمة الجيل الثامن من TPU
- الرابط:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
ملاحظة: للتعرّف على خلفية جدار الذاكرة لدى الوكلاء وذاكرة KV المؤقتة
-
مدونة Google Cloud – تقديم TPU Sync: مكتبة مفتوحة المصدر لنقل ذاكرة KV المؤقتة والأوزان
- الرابط:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
ملاحظة: تحسينات نقل ذاكرة KV المؤقتة على المستوى المنخفض ومنهجية الاختبار
-
وثائق OpenAI API – التخزين المؤقت للموجهات: آلية التخزين المؤقت وأفضل الممارسات
- الرابط:
platform.openai.com/docs/guides/prompt-caching -
ملاحظة: قواعد تخزين البادئات مؤقتًا، ومدة الاحتفاظ، وتوصيات المراقبة
-
وثائق Anthropic – التخزين المؤقت للموجهات: مدة صلاحية ذاكرة التخزين المؤقت والتسعير
- الرابط:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
ملاحظة: أسعار الكتابة والقراءة لذاكرة التخزين المؤقت لمدة 5 دقائق وساعة واحدة
-
Google AI للمطورين – التخزين المؤقت للسياق: التخزين المؤقت الضمني والصريح في Gemini
- الرابط:
ai.google.dev/gemini-api/docs/caching - ملاحظة: مدة صلاحية التخزين المؤقت الصريح وتكاليف التخزين
الكاتب: فريق APIYI التقني
للتواصل التقني: تفضلوا بزيارة الصفحة الرئيسية لـ APIYI على apiyi.com للتواصل معنا، ويمكنكم الاطلاع على مزيد من مواد التكامل في مركز الوثائق docs.apiyi.com