ملاحظة المؤلف: بعد إصدار نموذج جديد، كيف تتحقق مما إذا كان يستحق التبديل إليه باستخدام مهامك طويلة المدى؟ تُقسِّم هذه المقالة السؤال إلى عملية من 5 خطوات قابلة للتنفيذ.
تكاد تصدر نماذج جديدة كل شهر، وقوائم التقييم بالدرجات تتجدد باستمرار. خُذ نموذج Tencent Hunyuan Hy4 الذي صدر رسميًا في نوفمبر 2026 مثالًا؛ فقد ذكرت الشركة أنه أجرى تحسينات موجّهة مقارنةً بالنسخة التجريبية في قدرات الوكيل (Agent) والمهام طويلة المدى، وظهر في مقدمة النماذج مفتوحة المصدر في عدة معايير تقييم (Benchmark). لكن بالنسبة للمطوّر، هناك سؤال واحد يهم حقًا: هل هو أفضل من النموذج الذي أستخدمه حاليًا في مهامي؟ تقدّم هذه المقالة منهجية للتحقق المقارن من النماذج الجديدة اعتمادًا على مهامك طويلة المدى الخاصة، تساعدك على الوصول في يوم أو يومين إلى استنتاج مدعوم بالبيانات.
هذه ليست مقالة أخرى لقراءة الدرجات. فقوائم التقييم تقيس القدرات العامة، أما عملك فيقيس: هل يستطيع إنجاز مهمة متعددة الخطوات من أولها إلى آخرها؟ وهل يستطيع إصلاح نفسه بعد الخطأ؟ وكم يكلّف إتمام كل طلب؟
القيمة الأساسية: بعد قراءة هذه المقالة، ستتعلم بناء مجموعة تحقق صغيرة ودقيقة للمهام طويلة المدى، ومقارنة النموذج القديم بالجديد عبر 6 مؤشرات، وحساب «تكلفة كل تسليم ناجح» بناءً على الفوترة الفعلية، ثم اتخاذ قرار التبديل أو الإبقاء على النموذج الحالي.
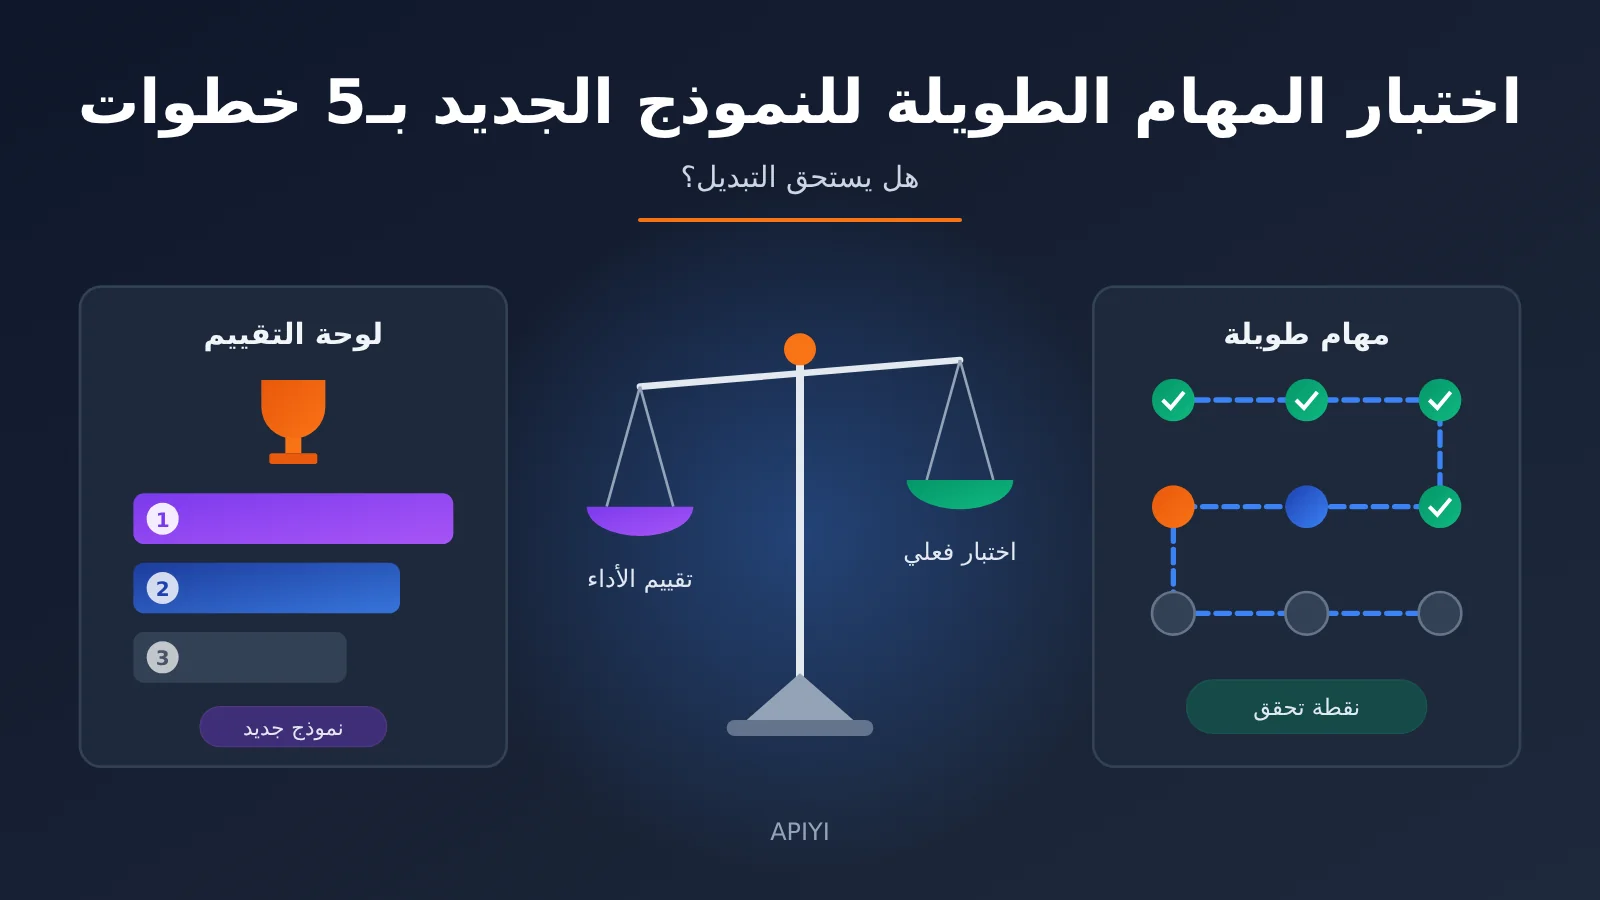
النقاط الأساسية في التحقق من المهام طويلة المدى للنماذج الجديدة
قبل البدء، من المهم توضيح الفرق بين التحقق من المهام طويلة المدى والاختبار العادي أحادي الجولة. الاختبار أحادي الجولة ينظر إلى «مدى جودة إجابة واحدة»، أما التحقق من المهام طويلة المدى فينظر إلى «هل يبقى الهدف قائماً بعد عشرات الخطوات المتتالية».
| النقطة | الشرح | القيمة |
|---|---|---|
| استخدم مهامك الخاصة | استخرج 3-5 مهام متعددة الخطوات من عملك الحقيقي بدلاً من استخدام أسئلة منشورة | النتائج ترتبط مباشرة بعائد العمل |
| مجموعة تحكم ثابتة | شغّل النموذج الحالي والنموذج الجديد على المهمة نفسها وسلسلة الأدوات نفسها | لاستبعاد اختلافات الموجه والبيئة |
| إعطاء الأولوية لمؤشرات العملية | سجّل الحفاظ على الهدف، والتصحيح الذاتي، وعدد التدخلات البشرية | لاكتشاف مشكلات الاستقرار التي لا تكشفها الدرجات |
| احسب التكلفة بحسب التسليم | احسب تكلفة الـ tokens بوحدة «كل تسليم ناجح» | لتجنب الأحكام الخاطئة الناتجة عن النظر إلى سعر الوحدة فقط |
| حدد عتبة تغيير النموذج | اكتب مسبقاً معيار «ما مقدار التحسن الذي يبرر تغيير النموذج» | لمنع الانحياز بسبب حالة واحدة مبهرة |
لماذا يُعد التحقق من المهام طويلة المدى أكثر موثوقية من درجات الاختبارات المعيارية
غالباً ما تكون أسئلة لوحات الصدارة العامة مغلقة وقصيرة المسار، بينما واقع عمل وكلاء الذكاء الاصطناعي (Agents) هو العكس تماماً. في التقييم المرجعي، طُلب من Hy4 تنفيذ مهمة طويلة المدى تبدأ من البحث والتطوير والمراجعة والإصلاح وصولاً إلى لعبة ثلاثية الأبعاد قابلة للعب، وأُضيفت في المنتصف فيديوهات مرجعية ومتطلبات جديدة. تختبر هذه المهام ما إذا كان النموذج، مع تزايد الخطوات، قادراً على تذكر الخطة الأصلية، والتمييز بين ما أُنجز وما لم يُنجز، وتعديل الخطة عندما لا تتوافق النتائج الوسيطة مع التوقعات.
من الظواهر الجديرة بالانتباه أيضاً تأثير التكامل بين «النموذج + سلسلة الأدوات». في التقييم نفسه، أنتج Hy4 خلال نصف ساعة في WorkBuddy 14 عرض PPT وملف Excel ومستند Word من 19 صفحة. وأوضح المُقيّمون أيضاً أن النموذج مسؤول عن الفهم والتخطيط والحكم، بينما تتولى سلسلة الأدوات القراءة والحساب والعرض والكتابة. وهذا يعني أنه عند التحقق من نموذج جديد يجب تشغيله داخل سلسلة أدواتك الخاصة، لأن الاستنتاجات المنفصلة عن البيئة محدودة القيمة.
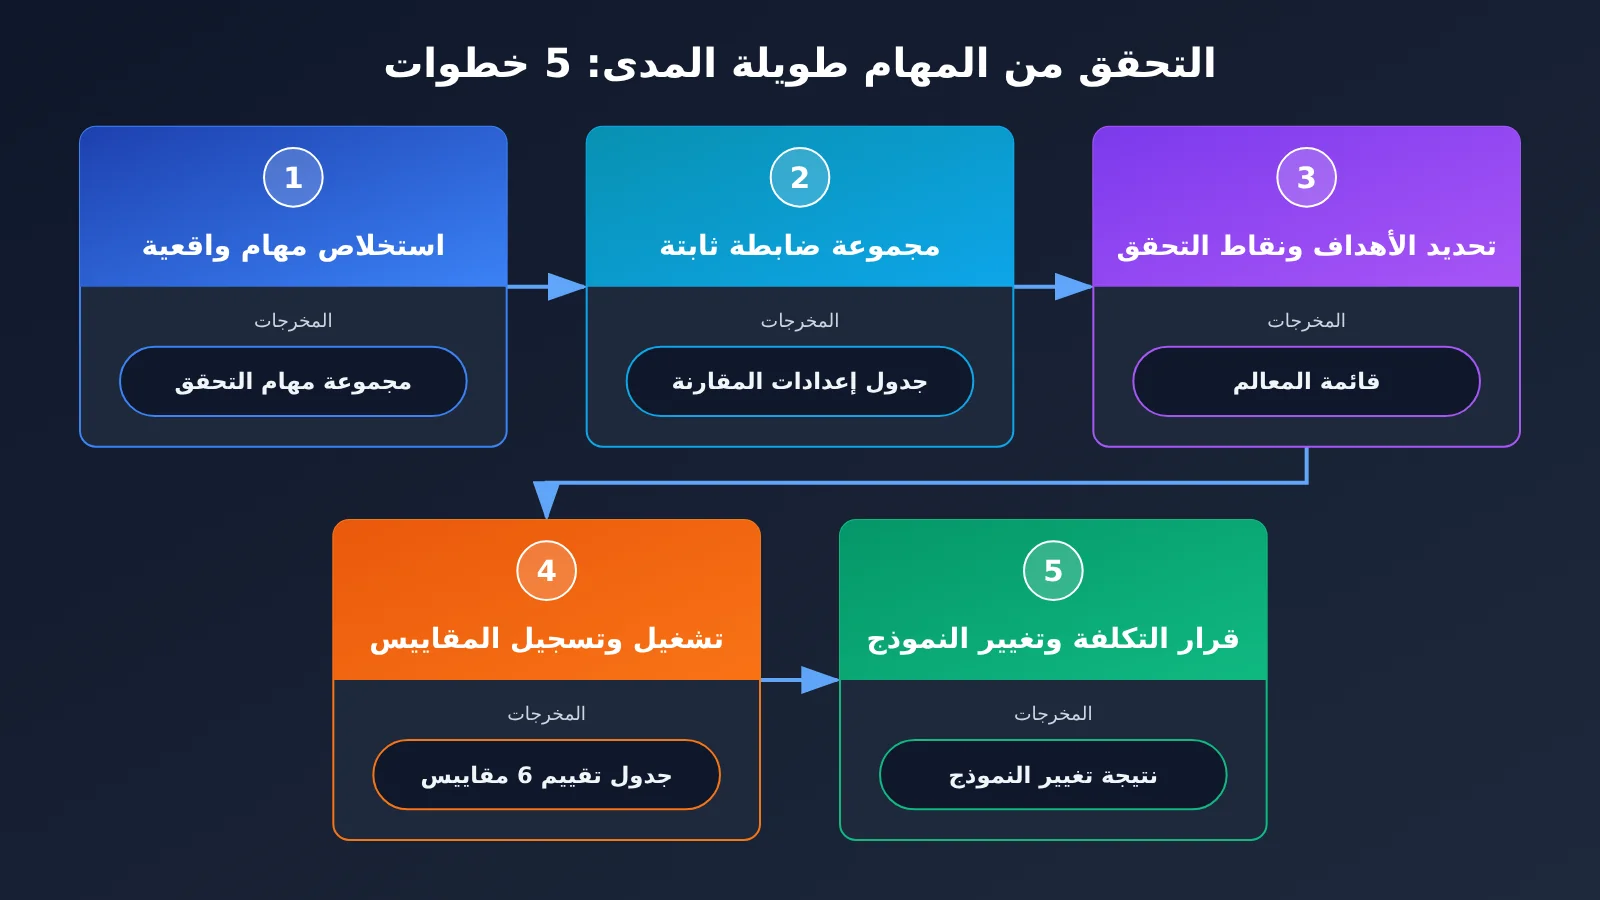
البدء السريع للتحقق من المهام طويلة المدى للنماذج الجديدة: مسار من 5 خطوات
لا يعتمد هذا المسار على أي إطار عمل بعينه. يكفي أن يمرّ استدعاء النموذج لديك عبر واجهة موحّدة، لتتمكن من تبديل النماذج وإجراء المقارنة بتكلفة منخفضة.
الخطوة 1: استخرج مهام طويلة المدى من أعمالك الحقيقية
المهم في مجموعة التحقق ليس عددها الكبير، بل أن تكون قريبة من الواقع. يُفضّل اختيار 3 إلى 5 مهام تغطي أكثر ثلاث فئات شيوعًا في عملك، وأكثرها استهلاكًا للجهد البشري، والأكثر عرضة للأخطاء. ومن الأفضل أن تستوفي كل مهمة ثلاثة شروط: ألا تقل عن 10 خطوات، وأن تتطلب استدعاء أدوات، وأن يكون لها مخرج نهائي واضح.
يمكنك الاستعانة بالفئات التالية من المهام طويلة المدى لتصميم نسختك الخاصة:
- معالجة الدفعات من المستندات: يُعطى النموذج مجلدًا يضم أكثر من عشرة مستندات، ويُطلب منه تلخيص كل مستند على حدة، وإنشاء مواد عرض، ثم تجميع النتائج في جدول وتقرير.
- تطوير التطبيقات: انطلاقًا من وصف المتطلبات، يُنجز النموذج التطوير والاختبار الذاتي والإصلاحات، ثم يسلّم في النهاية منتجًا قابلًا للتشغيل.
- إعادة إنتاج المحتوى متعدد الوسائط: تُرفع لقطات شاشة أو تسجيلات شاشة، ويُطلب من النموذج فهم المحتوى ثم إعادة إنتاج الواجهة أو التفاعل المقابل.
- تشغيل الكمبيوتر: يُطلب من النموذج مشاهدة الشاشة والعثور على الأزرار والنقر والكتابة، لإنجاز سير عمل يمتد عبر أكثر من تطبيق.
الخطوة 2: تثبيت مجموعة التحكم وبيئة التشغيل
مفتاح التجربة المقارنة هو «تغيير متغير واحد فقط». يجب أن تستخدم النماذج القديمة والجديدة نفس موجه النظام، ونفس تعريفات الأدوات، ونفس مواد الإدخال. يُنصح بتشغيل كل مهمة 3 مرات على الأقل، ثم أخذ المتوسط وأسوأ نتيجة، لأن المهام طويلة المدى أعلى عشوائية بكثير من الأسئلة والأجوبة ذات الجولة الواحدة.
| بند الإعداد | الإعداد المقترح | ملاحظات |
|---|---|---|
model |
النموذج الحالي مقابل النموذج الجديد | المعامل الوحيد المسموح بتغييره |
temperature |
متطابق في المجموعتين، ويُفضّل أن يكون منخفضًا | تقليل تداخل العشوائية في النتائج |
max_tokens |
اترك هامشًا وفق أطول مخرجات متوقعة للمهمة | تجنّب الحكم الخاطئ على قدرة النموذج بسبب الاقتطاع |
تعريف الأدوات tools |
قائمة دوال وأوصاف متطابقة تمامًا | اختلاف أوصاف الأدوات يؤثر بوضوح في سلوك الاستدعاء |
| موجه النظام | الإصدار نفسه، دون ضبطه خصيصًا للنموذج الجديد | اختبر أولاً الأداء الجاهز للاستخدام، ثم الأداء بعد الضبط |
| عدد التكرارات | 3 مرات على الأقل لكل مهمة | لرصد الاستقرار وليس أفضل نتيجة |
إذا كان مشروعك يستخدم في الوقت نفسه واجهات بأسلوب OpenAI وأسلوب Anthropic، فإن تبديل النموذج غالبًا يعني تغيير SDK، وتغيير طريقة المصادقة، وتغيير صيغة الطلب، وهو ما يجعل التجربة المقارنة مرهقة. من خلال الاستدعاء عبر منصة تجميع API موحدة، يمكنك إجراء التبديل بتعديل حقل model فقط.
🚀 اقتراح للبدء السريع: يوفر APIYI apiyi.com إمكانية استدعاء واجهات API للنماذج الشائعة المذكورة في هذا المقال، وهو متوافق مع صيغ واجهات OpenAI وAnthropic معًا. عند إجراء تجارب التحكم، ما عليك سوى استبدال معامل
modelللتبديل بين النموذجين القديم والجديد. للحصول على طريقة الوصول وإعداداتbase_urlوالمصادقة، راجع مركز توثيق APIYI على docs.apiyi.com.
الخطوة 3: وضع نقاط ارتكاز للهدف ونقاط تحقق للمهمة
النمط الأكثر شيوعًا لفشل المهام طويلة المدى ليس “عدم القدرة على التنفيذ”، بل “نسيان الهدف أثناء التنفيذ”. استخدم التقييم المرجعي الأمر /goal لإلزام النموذج بالحفاظ على هدف محدد طوال الوقت، ويمكن نقل هذه الفكرة إلى أي بيئة تحقق. اكتب الهدف النهائي بوضوح في بداية المهمة، وقسّم المخرجات التسليمية إلى عدة محطات إنجاز قابلة للفحص.
خذ مهمة “لعبة ثلاثية الأبعاد واقعية وصغيرة” مثالًا: قسّم المقيّمون الهدف إلى 5 عناصر: مشهد اللعبة، والمرئيات والإحساس، والصوت وأسلوب اللعب، وسير العمل، والتسليم النهائي. ينبغي تقسيم مهامك أنت أيضًا بهذه الطريقة، بحيث تقابل كل محطة إنجاز نقطة تحقق يمكن الحكم عليها بموضوعية بأنها “مكتملة/غير مكتملة”، وعندها يصبح التقييم اللاحق أبسط بكثير.
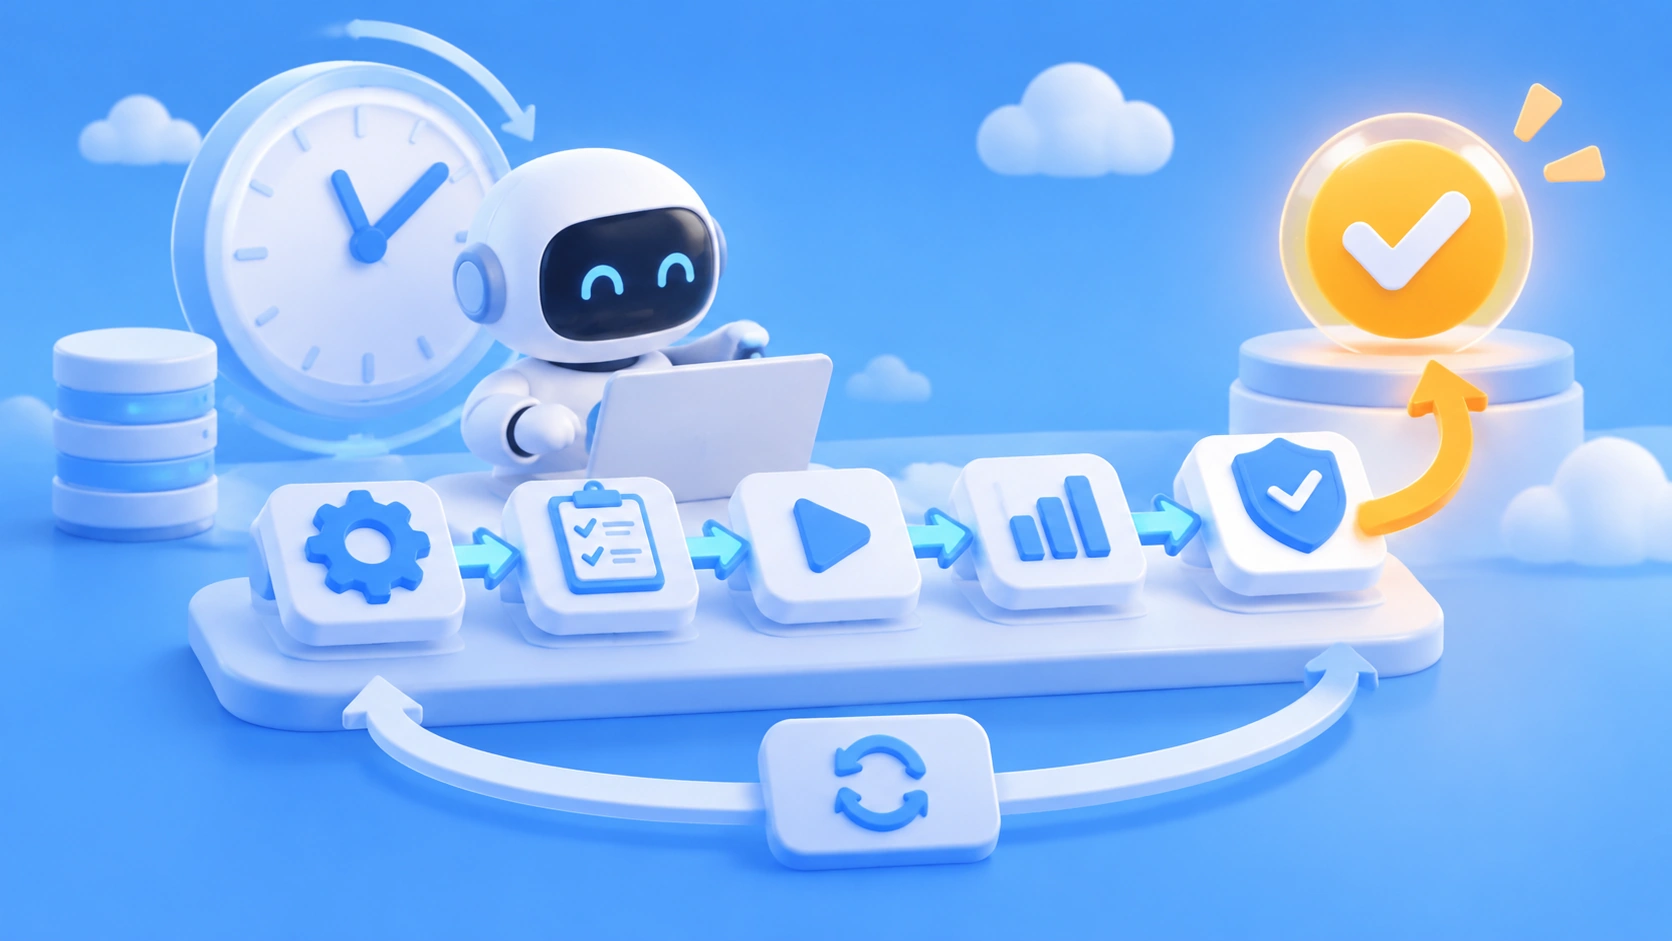
الخطوة 4: التشغيل وتسجيل 6 مؤشرات
احتفظ في كل تشغيل بسجل كامل للمحادثة واستدعاءات الأدوات، ثم قيّم وفق الجدول التالي. تقيس المؤشرات الأربعة الأولى “هل يمكن إنجاز المهمة؟”، بينما يقيس المؤشران الأخيران “هل الأمر مجدٍ من حيث التكلفة؟”.
| المؤشر | كيفية القياس | طريقة التقييم |
|---|---|---|
| معدل إنجاز المهمة | عدد نقاط التحقق المكتملة / إجمالي نقاط التحقق | نسبة مئوية، بمتوسط 3 مرات |
| درجة الالتزام بالهدف | هل لا يزال التقدم في النصف الثاني من المهمة يدور حول الهدف الأولي، وهل هناك إغفال أو خروج عن الموضوع | تقييم بشري من 1 إلى 5 |
| القدرة على تصحيح الأخطاء ذاتيًا | هل يستطيع إصلاح الخطأ بنفسه بعد حدوثه في المنتصف (رسالة خطأ، فشل اختبار) | تسجيل “عدد الأخطاء / عدد مرات الاستشفاء الذاتي” |
| عدد التدخلات البشرية | عدد الجولات التي تحتاج إلى توضيح أو تصحيح بشري | كلما قلّ العدد كان أفضل |
| الوقت المستغرق | الوقت الفعلي المنقضي من الإطلاق إلى التسليم | بالدقائق، بما في ذلك وقت تنفيذ الأدوات |
| تكلفة التسليم الواحد | إجمالي تكلفة التوكنات / عدد مرات التسليم الناجح | وفق أساس الفوترة الفعلي |
يستحق مؤشر “عدد التدخلات البشرية” اهتمامًا خاصًا. وخلص التقييم المرجعي إلى أن Hy4 قادر في الغالب على التسليم دفعة واحدة في معظم مهام العمل المكتبي والمهام الإبداعية اليومية، لكنه لا يزال يحتاج في الأعمال التي تتضمن كثيرًا من عمليات الحاسوب وسير العمل المعقد إلى تفاعلات متعددة الجولات لمساعدته على فهم النية. وهذا بالضبط هو الفرق الذي تحتاج إلى قياسه كميًا في مهامك: كل تدخل واحد يعني تكلفة بشرية إضافية.
الخطوة 5: حساب التكلفة واتخاذ قرار تبديل النموذج
يجب أن يعتمد حساب التكلفة على أساس «كل عملية تسليم ناجحة»، لا على مقارنة سعر وحدة الإدخال والإخراج فقط. فالنموذج الذي يكون سعره للوحدة منخفضًا لكنه يحتاج إلى إعادة التشغيل مرتين قد تكون تكلفته الفعلية أعلى. وتتميز المهام الطويلة بأمر آخر: إذ يحمل السياق المحتوى التاريخي مرارًا، ما يجعل معدل إصابة ذاكرة التخزين المؤقت مؤثرًا جدًا في التكلفة الإجمالية.
طريقة الحساب هي: تكلفة المهمة الواحدة = توكنات الإدخال غير المصيبة لذاكرة التخزين المؤقت × سعر وحدة الإدخال + توكنات الإدخال المصيبة لذاكرة التخزين المؤقت × سعر ذاكرة التخزين المؤقت + توكنات الإخراج × سعر وحدة الإخراج؛ ثم نقسم إجمالي تكلفة عدة عمليات تشغيل على عدد عمليات التسليم الناجحة. أما أسعار الإدخال والإخراج، وأسعار ذاكرة التخزين المؤقت، وأساس الفوترة لكل نموذج، فيرجى الاعتماد على البيانات الفعلية في صفحة أسعار APIYI: docs.apiyi.com/models؛ ولا تدرج هذه المقالة أرقامًا محددة تجنبًا للتضليل الناتج عن تغير الأسعار.
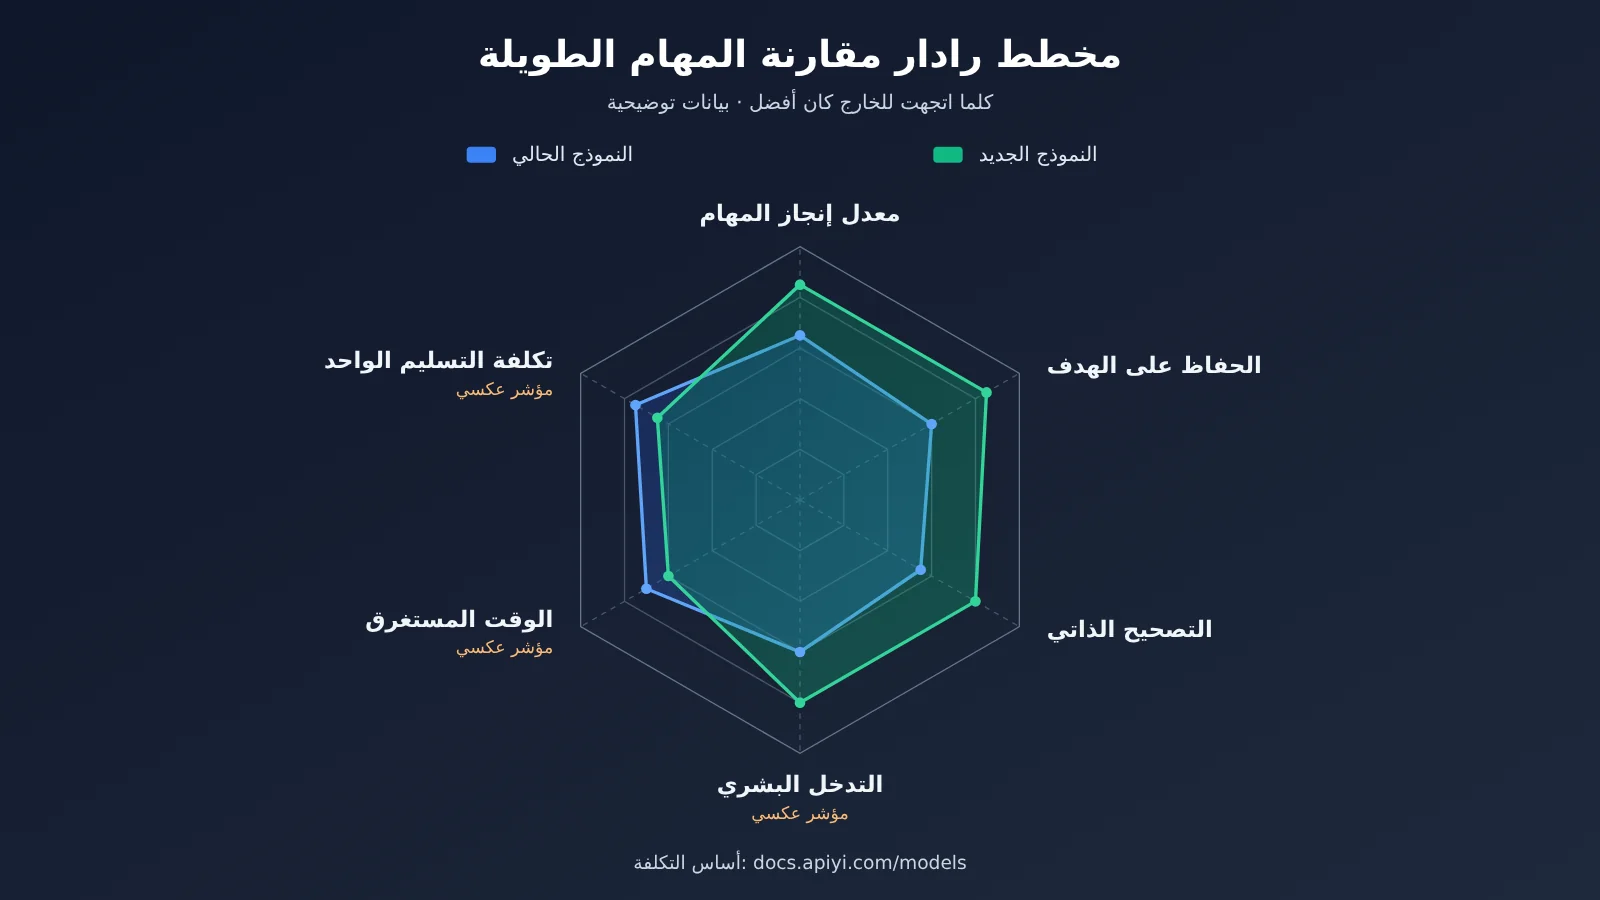
💰 ملاحظة حول حساب التكلفة: عند إجراء المقارنة، يُنصح باستدعاء النموذجين القديم والجديد على المنصة نفسها، بحيث تتوحد إحصاءات الاستخدام وأساس الفوترة، وعندها فقط تصبح «تكلفة التسليم الواحد» المحسوبة قابلة للمقارنة. تعرض صفحة أسعار APIYI: docs.apiyi.com/models أسعار الإدخال والإخراج وذاكرة التخزين المؤقت لكل نموذج، ويمكن استخدامها مباشرة كأساس للحساب.
معايير قرار التحقق من النموذج الجديد في المهام طويلة المدى
بعد الانتهاء من تشغيل البيانات، أكبر ما نخشاه هو أن تكون النتائج “لكلٍّ مزاياه ولا يمكن الحسم”. من الأفضل كتابة قواعد القرار قبل بدء التجربة، ويمكن استخدام الجدول التالي كنقطة انطلاق، ثم تعديل الحدود وفقًا لحساسية العمل.
| نتيجة المقارنة | القرار المقترح | السبب |
|---|---|---|
| ارتفاع واضح في معدل الإنجاز، مع ثبات أو انخفاض تكلفة التسليم الواحد | التبديل المباشر | تحسّن الجودة والتكلفة في آنٍ واحد |
| ارتفاع واضح في معدل الإنجاز مع ارتفاع التكلفة | التبديل حسب السيناريو | استخدام النموذج الجديد فقط في المهام عالية القيمة وعالية الصعوبة |
| ثبات معدل الإنجاز مع انخفاض واضح في التكلفة | التبديل التدريجي | الاستبدال أولاً في المهام منخفضة المخاطر، ثم المراقبة لفترة |
| ثبات معدل الإنجاز مع انخفاض عدد التدخلات | تفضيل التبديل | الجهد البشري الموفور غالبًا أعلى قيمة من تكلفة token |
| انخفاض معدل الإنجاز أو تراجع الاستقرار | عدم التبديل مؤقتًا | انتظار الإصدار التالي أو تعديل الموجّه ثم إعادة الاختبار |
وهناك بُعد آخر يسهل إغفاله هو إعادة هيكلة المهام بفعل القدرات الجديدة. فمثلاً أضاف Hy4 هذه المرة قدرة الفهم البصري، بحيث يمكنه قراءة تسجيل الشاشة مباشرة وتحليله إطارًا بإطار، كما يمكنه التقاط لقطات شاشة متكررة لمخرجاته وتحسينها عبر التغذية الراجعة الذاتية. إذا كانت عمليتك القديمة تتطلب من شخص تحويل لقطات الشاشة إلى وصف نصي، فما يقدمه النموذج الجديد قد لا يكون “أداءً أفضل للمهمة نفسها”، بل “خطوة أقل في العملية بأكملها”. يجب تسجيل هذا النوع من المكاسب بشكل منفصل، لا أن يُقاس فقط بدرجات المهام القديمة.
مرجع لاختيار النماذج عند مقارنة النماذج السائدة
عند إجراء المقارنة، نضع عادةً النموذج الجديد إلى جانب النموذج العامل حاليًا ومرشحين آخرين من المستوى نفسه. يوضح الجدول التالي منطق الاختيار، أما القدرات الفعلية فاعتمد فيها على اختبارك العملي للمهام طويلة المدى.
| نوع المرشح | المهام طويلة المدى المناسبة له | نقاط التحقق الأساسية | المنصة المتاحة |
|---|---|---|---|
| نموذج مفتوح المصدر/محلي جديد الإصدار | معالجة دفعية للمستندات المكتبية، وكيل للسيناريوهات الصينية | الالتزام بالهدف، القيمة مقابل التكلفة | APIYI apiyi.com وغيرها |
| نموذج مغلق المصدر رئيسي عامل حاليًا | برمجة معقدة، استدلال عالي الصعوبة | كخط أساس للجودة | APIYI apiyi.com وغيرها |
| نموذج متعدد الوسائط | إعادة إنتاج لقطات الشاشة/تسجيلات الشاشة، فهم الواجهات | دقة الفهم البصري، التصحيح الذاتي | APIYI apiyi.com وغيرها |
| نموذج خفيف وسريع | توزيع المهام الفرعية، تنسيق المخرجات | الوقت المستغرق والتكلفة | APIYI apiyi.com وغيرها |
💡 نصيحة للاختيار: لا تكتفِ بمقارنة مرشح واحد بالنموذج العامل حاليًا. فعند وضع مرشحين أو ثلاثة في مجموعة التحقق نفسها ضمن واجهة موحدة، غالبًا ما تكتشف حلًا أفضل هو “الاستخدام المدمج حسب السيناريو”. يدعم APIYI استدعاء عدة نماذج سائدة عبر واجهة موحدة، مما يسهّل تطبيق هذا النوع من الحلول المدمجة بسرعة.
الأسئلة الشائعة FAQ
س1: ما المقصود بالتحقق من المهام طويلة المدى للنموذج الجديد؟
التحقق من المهام طويلة المدى يعني اختبار النموذج بمهام واقعية تتكون من عدة خطوات، وتتطلب استدعاء أدوات، ولها مُخرجات محددة بوضوح. والتركيز هنا ليس على جودة الإجابة في دور واحد، بل على قدرة النموذج على التمسك بالهدف عبر الخطوات المتتالية، وعلى تصحيح أخطائه بنفسه عند حدوثها، وعلى التكلفة النهائية للتسليم.
س2: ما الفرق بين التحقق من المهام طويلة المدى والاعتماد على اختبارات Benchmark العامة؟
اختبارات Benchmark قيّمة للمقارنة الأفقية للقدرات العامة، لكن أسئلتها تبتعد كثيرًا عن طبيعة عملك، وغالبها مهام قصيرة السلسلة. أما التحقق من المهام طويلة المدى فيجري مباشرة على سلسلة أدواتك وبياناتك، ويكشف مشكلات مثل نسيان الهدف، وإساءة استخدام الأدوات، والحاجة إلى تدخل بشري متكرر للتصحيح. والجمع بين الاثنين هو الأسلم: استخدم التصنيفات لفرز المرشحين، ثم اتخذ القرار بمهامك الخاصة.
س3: متى يكون مناسبًا البدء بالتحقق بعد إطلاق نموذج جديد؟
يُستحسن تشغيل جولة اختبار “جاهز للاستخدام فورًا” في أقرب وقت بعد الإطلاق، لأن كثيرًا من النماذج الجديدة تتيح فترات مجانية محدودة أو فترات تجريبية. ففي المواد المرجعية، أتيحت لـ Hy4 في WorkBuddy فترة مجانية محدودة من 4 إلى 15 نوفمبر. وإذا كانت نتائج الجولة الأولى جيدة، خصّص وقتًا بعدها لضبط الموجهات خصيصًا للنموذج الجديد وتشغيل جولة ثانية.
س4: كم عدد المهام الكافي في مجموعة التحقق؟
عادةً تكفي من 3 إلى 5 مهام قريبة جدًا من واقع عملك للوصول إلى استنتاجات تحدد الاتجاه، مع تكرار كل مهمة 3 مرات لملاحظة الاستقرار. وبدلًا من تكثير العدد، احرص على أن تغطي المهام أكثر السيناريوهات شيوعًا لديك، وأكثرها استهلاكًا للجهد البشري، وأكثرها عرضة للأخطاء، وصمّم لكل مهمة نقاط فحص واضحة.
س5: كيف أقارن بين عدة نماذج بأقل تكلفة وأقل جهد ممكن؟
أسهل طريقة هي الاستدعاء عبر منصة بواجهة موحدة. فمنصة APIYI على apiyi.com متوافقة مع صيغتي واجهة OpenAI وAnthropic، ويكفي لتغيير النموذج تعديل معامل `model` دون أي تغيير في تعريفات الأدوات أو الموجهات. ويمكنك الاطلاع على خطوات الربط التفصيلية في مركز التوثيق docs.apiyi.com.
س6: كيف تُحسب تكلفة المهام طويلة المدى حسابًا دقيقًا؟
احسبها على أساس “تكلفة التسليم الناجح الواحد”، أي إجمالي تكلفة الـ tokens لكل عمليات التشغيل مقسومًا على عدد مرات التسليم الناجح، مع التمييز بين جزء الإدخال الذي أصاب الذاكرة المؤقتة وجزء الإدخال الذي لم يصبها. أما أسعار الوحدة وأسعار الذاكرة المؤقتة لكل نموذج، فاعتمد فيها على البيانات الفعلية في صفحة الأسعار على APIYI docs.apiyi.com/models، فتوحيد معايير الفوترة على منصة واحدة يجعل المقارنة أكثر إنصافًا.
س7: ما هي حدود التحقق من المهام طويلة المدى؟
أولًا، العينة صغيرة، والنتيجة المبهرة أو الفشل في تشغيل واحد قد يكون مصادفة، لذا يجب تكرار التشغيل؛ ثانيًا، التقييم البشري ينطوي على ذاتية، ويُفضّل أن يقيّم شخصان بشكل مستقل ثم يُؤخذ المتوسط؛ ثالثًا، النتائج تعتمد بشدة على سلسلة الأدوات، وبعد تغيير إطار عمل الوكيل (Agent) يجب إعادة الاختبار. بالإضافة إلى ذلك، غالبًا ما يتحدد السقف الأقصى لقدرة النموذج بصعوبة مهمة الاختبار، لذا ينبغي إضافة مهام أصعب إلى مجموعة التحقق بشكل دوري.
خلاصات رئيسية حول التحقق من المهام طويلة المدى للنماذج الجديدة
- اجعل مهامك الخاصة هي الحكم: من 3 إلى 5 مهام حقيقية متعددة الخطوات أقرب إلى العائد الفعلي من تغيير النموذج من أي لوحة تصنيف.
- غيّر متغيرًا واحدًا فقط: يستخدم النموذجان القديم والجديد الموجهات والأدوات والمدخلات نفسها، مع تشغيل كل مهمة 3 مرات على الأقل.
- مرساة الهدف لا غنى عنها: استعِن بفكرة
/goalلتقسيم المعالم، وكلما كانت نقاط التحقق أكثر موضوعية كان التقييم أدق. - ستة مؤشرات ترسم الصورة كاملة: معدل الإنجاز، الحفاظ على الهدف، التصحيح الذاتي، عدد التدخلات، الوقت المستغرق، تكلفة التسليم.
- احسب التكلفة على أساس التسليم: ميّز بين إصابة الذاكرة المؤقتة وعدمها، واعتمد صفحة أسعار APIYI على docs.apiyi.com/models كأساس للفوترة.
- راقب إعادة هيكلة سير العمل: قد تُغني القدرات الجديدة مثل فهم الصور عن خطوات بشرية في سير العمل القديم بشكل مباشر.
الملخص
النقاط الأساسية للتحقق من النماذج الجديدة في المهام الطويلة:
- المهام حقيقية: مجموعة التحقق مستمدة من الأعمال الفعلية، وتغطي السيناريوهات الشائعة والمستهلكة للوقت والمعرضة للأخطاء.
- المراقبة صارمة: تثبيت البيئة، وتكرار التشغيل، وكتابة شروط تبديل النموذج مسبقًا.
- الحساب دقيق: استخدام تكلفة التسليم الناجح مرة واحدة وعدد التدخلات اليدوية لقياس العائد الحقيقي.
كل إصدار لنموذج جديد هو فرصة لإعادة النظر في سير العمل. بدلاً من الانجراف وراء لوحات التصنيف ومقاطع الفيديو التوضيحية، خصص يومًا أو يومين للحصول على إجابة قاطعة باستخدام مهامك الطويلة الخاصة. نوصي باستخدام APIYI عبر apiyi.com لوضع النماذج القديمة والجديدة تحت نفس مجموعة الواجهات للمقارنة السريعة، راجع تعليمات الوصول في docs.apiyi.com، وبيانات الفوترة وفقًا لـ docs.apiyi.com/models.
📚 المراجع
- 爱范儿 – اختبار Tencent Hy4 الفعلي: حالات اختبار للمهام الطويلة والوسائط المتعددة وعمليات الكمبيوتر في Hy4
- الرابط:
ifanr.com/1687613 -
الوصف: يقدم تصاميم اختبار قابلة للاستفادة مثل قيد الهدف
/goal، وتطوير الألعاب الطويلة، ومعالجة الدفعات من المستندات -
مركز توثيق APIYI: تعليمات الوصول إلى النماذج وتنسيقات الواجهات
- الرابط:
docs.apiyi.com -
الوصف: الاطلاع على طريقة إعداد الواجهات المتوافقة مع OpenAI وAnthropic
-
صفحة أسعار نماذج APIYI: أسعار الإدخال والإخراج والتخزين المؤقت لكل نموذج
- الرابط:
docs.apiyi.com/models - الوصف: المرجع الوحيد للأسعار عند حساب التكاليف
المؤلف: فريق APIYI التقني
التواصل التقني: مرحبًا بكم للتواصل معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، والمزيد من مواد الوصول إلى النماذج متاحة في مركز التوثيق docs.apiyi.com