إجابة مباشرة: الموجه الجديد ليس بالضرورة أفضل، و«يبدو أفضل» ليس دليلًا. لتحديد أي قالب مقال أفضل، القديم أم الجديد، ينبغي تثبيت المصدر نفسه والنموذج نفسه وإعدادات التوليد نفسها، وتغيير القالب فقط، ثم فحص البنية والترتيب وجودة المحتوى عبر طبقات من تأكيدات Promptfoo. وينبغي أيضًا عرض النتائج حسب الأبعاد، حتى لا تلغي درجة الأسلوب أخطاءً واقعية. تقترح هذه المقالة خطة تجربة، ولا تشغّل تجربة A/B حقيقية، ولذلك لا تقدم أي نسب فوز أو درجات أو حجم توفير.
بعد قراءة هذه المقالة، ستعرف:
- ما الذي يمكن أن تفحصه تأكيدات
containsوJavaScript وllm-rubricفي Promptfoo، وما الذي لا تستطيع إثباته. - كيف تشغّل ملف التأكيدات بشكل منفصل على مخرجات نموذج موجودة مسبقًا، وتتجنب إعادة التوليد عند تعديل قواعد التقييم فقط.
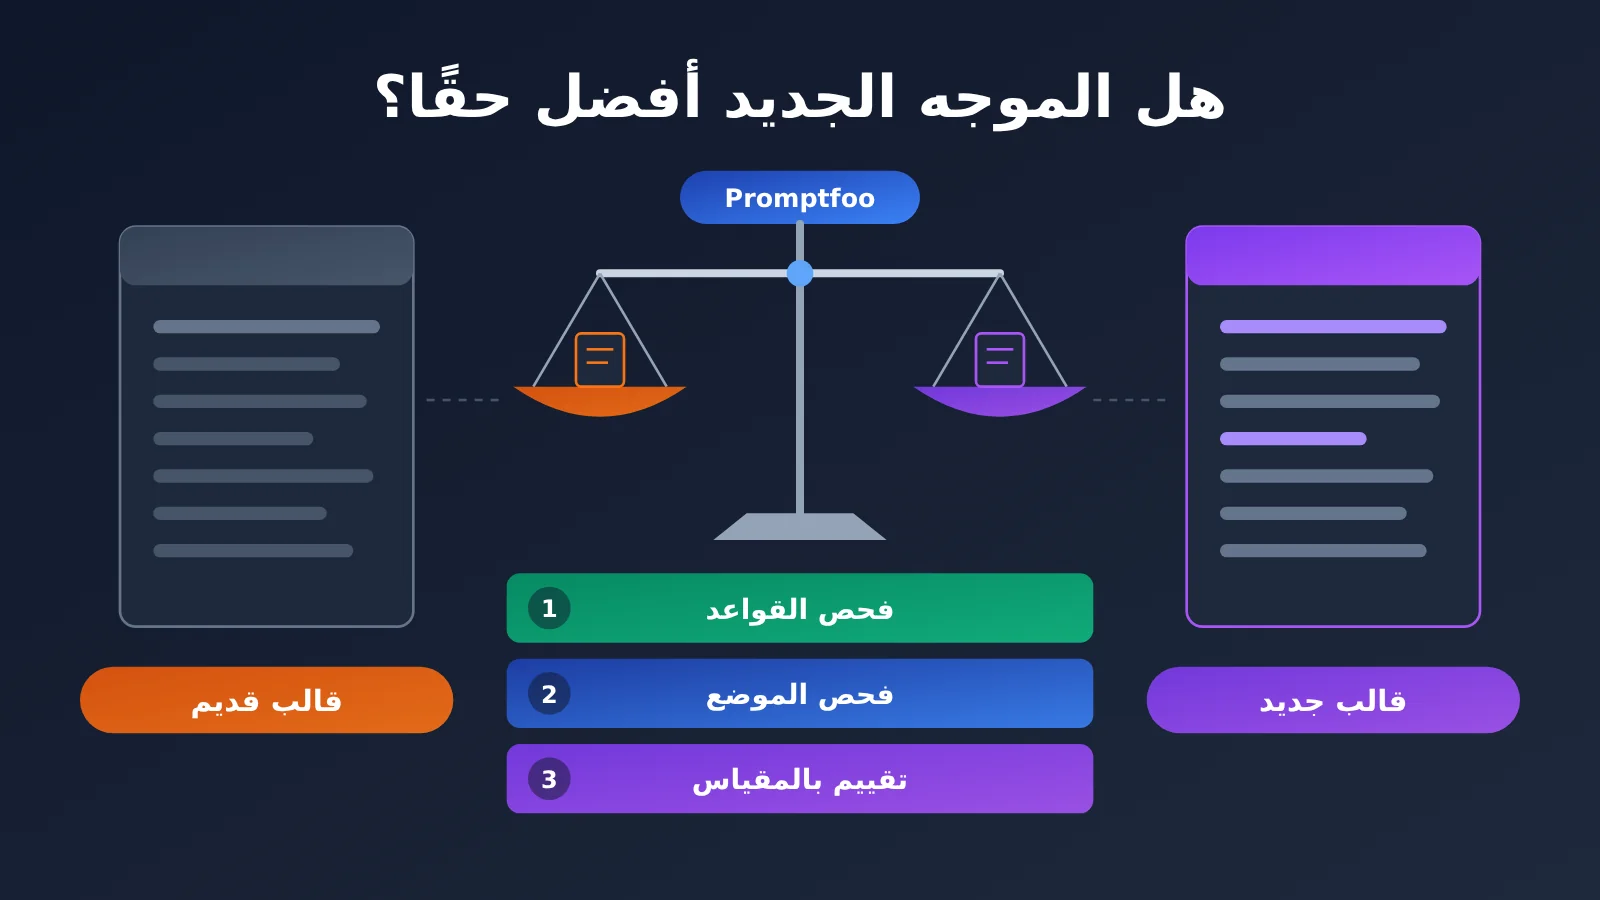
- تصميم تجربة لمقارنة قالب المقال القديم بالجديد، يشمل ضبط المتغيرات والفحص بثلاث طبقات والعرض حسب الأبعاد.
- حدود النموذج المحكّم وتأكيدات القواعد، ومشكلة التكلفة التي تفرضها نماذج التقييم المدفوعة.
فهرس المحتوى: يبدأ بجدول مفاهيمي يشرح بعض المصطلحات الأساسية في تقييم Promptfoo، ثم يوضح أثر ذلك على فرق المحتوى والمطورين والمسؤولين عن التقييم. يعرض قسم «الحقائق الموضوعية» في المتن فقط قدرات التأكيدات وحالة التحقق كما وردت في الوثائق. أما قسم «التحليل والحكم» فيقدم توصيات لتصميم التجربة وأمثلة إعدادات ومناقشة للقيود، ويحدد بندًا بندًا ما هو توصية وما هو نتيجة قياس فعلية.
المفاهيم التي يجب معرفتها قبل مقارنة قوالب الموجهات في Promptfoo
ستتكرر هذه المصطلحات في الأجزاء التالية. معظمها مأخوذ من وثائق إعداد Promptfoo، والقليل منها عبارة عن مصطلحات شائعة في تجارب التقييم.
| المفهوم | شرح موجز |
|---|---|
| Promptfoo | أداة مفتوحة المصدر لتقييم موجهات نماذج اللغة الكبيرة ومخرجاتها، ويمكن استخدام ملفات إعداد لتعريف حالات الاختبار والتأكيدات |
| التأكيد (Assertion) | قاعدة فحص تلقائي لمخرجات النموذج، تحدد ما إذا كانت المخرجات تستوفي شرطًا معينًا |
| contains | يتحقق من وجود نص محدد في المخرجات، وهو مطابقة نصية حتمية |
| تأكيد JavaScript | استخدام تعبير أو دالة JavaScript لتنفيذ شروط تقييم أكثر تعقيدًا |
| llm-rubric | يجعل أحد النماذج يقيّم المخرجات وفق مقياس تقييم مخصص، وينتمي إلى تأكيدات «تقييم النموذج» |
| مزود التقييم (Grading Provider) | النموذج الذي ينفذ تقييم llm-rubric، ويمكن إعداده بشكل منفصل |
| مقياس التقييم (Rubric) | معايير التقييم المكتوبة لنموذج التقييم، وتوضح ما يُعد ناجحًا وما يستوجب خصم النقاط |
| النموذج كحكم (LLM-as-a-Judge) | استخدام نموذج لغة كبير بدلًا من المراجعة البشرية لتقييم جودة المخرجات |
| ضبط المتغيرات | تغيير عامل واحد فقط في التجربة (وهو القالب هنا) مع إبقاء العوامل الأخرى ثابتة |
نظرة سريعة على تأثير تقييم قوالب الموجهات القديمة والجديدة
لا تكمن قيمة هذا النوع من أساليب التقييم في حداثة الأداة نفسها، بل في تحويل عبارة “أرى أن القالب الجديد أفضل” إلى سجل فحص قابل للمراجعة. وما يحصل عليه كل دور من هذه العملية يختلف عن الآخر.
| الفئة | الأثر الفعلي |
|---|---|
| فرق المحتوى والمحررون | أصبح لتعديل القوالب أساس قبول قابل للمراجعة، ويمكن اكتشاف مشكلات من نوع “البنية صحيحة لكن فقرة الحقائق اختلطت فيها التخمينات” |
| مهندسو الموجهات والمطورون | يمكن تقسيم متطلبات القالب إلى تأكيدات قواعدية وتأكيدات مقياسية، وعند تعديل قواعد التقييم لا حاجة لإعادة توليد جميع المخرجات |
| مسؤولو التقييم | يحتاجون إلى عرض النتائج حسب الأبعاد، والتمييز بوضوح بين الحجية التي يقدمها كل من تقييم النموذج ومطابقة القواعد والمراجعة البشرية |
| مسؤولو الميزانية | لا تكاد تأكيدات القواعد تضيف تكلفة استدعاء إضافية، أما llm-rubric فإذا استخدم نموذجًا مدفوعًا فسيولد تكاليف مراجعة |
حقائق موضوعية حول قدرات الادعاءات في Promptfoo
يقتصر هذا الجزء على عرض القدرات التي تصفها وثائق Promptfoo. راجعنا صفحات الوثائق ذات الصلة في 2026-11-17، لكن تواريخ الإصدار الأول لهذه القدرات غير مُتحقَّق منها، لذلك لا نذكر في هذا المقال أي توقيت محدد للإطلاق.
ادعاء contains في Promptfoo: التحقق من ظهور نص معيّن
يُعدّ contains أبسط أنواع الادعاءات، ويُستخدم للتحقق مما إذا كان نص محدد يظهر في مخرجات النموذج. وهو مطابقة نصية حتمية، فالمخرجات نفسها ستُعطي النتيجة نفسها في كل تشغيل.
يجدر التأكيد على أن نجاح contains لا يعني سوى “أن هذا النص قد ظهر”. فهو لا يبيّن ما إذا كانت الفقرة التي يرد فيها هذا النص مكتوبة بشكل جيد، ولا ما إذا كان المحتوى صحيحًا.
ادعاء JavaScript في Promptfoo: تنفيذ شروط معقّدة
عندما تتجاوز شروط التقييم حدود “هل يحتوي أم لا”، يمكن كتابة منطق مخصص عبر ادعاء JavaScript. مثلًا: مقارنة موضع ظهور عنوانين أحدهما بالنسبة للآخر، أو إحصاء عدد قسم معيّن، أو التحقق مما إذا كانت فقرة ما تقع داخل قسم محدد. ويظل هذا النوع من الادعاءات حتميًا، ونتائجه قابلة للتكرار.
تقييم مخرجات Promptfoo الموجودة عبر ملف ادعاءات مستقل
يدعم Promptfoo تشغيل ملف ادعاءات مستقل على مخرجات نموذج تم توليدها مسبقًا، دون الحاجة إلى إعادة توليد جميع المخرجات من جديد. وهذا مهم لدورات التقييم التكرارية: فقواعد التقييم غالبًا ما تحتاج إلى تعديل متكرر، بينما التوليد نفسه يستهلك وقتًا وله تكلفة استدعاء.
llm-rubric في Promptfoo: تقييم النموذج وفق مقياس
ينتمي llm-rubric إلى ادعاءات التقييم بواسطة النموذج. فهو يمرّر المخرجات ومقياسًا مخصصًا إلى نموذج التقييم، الذي يحدد بدوره ما إذا كانت المخرجات تستوفي المقياس ويعطي الأسباب. توضح الوثائق أن مزوّد التقييم الذي ينفّذ عملية التقييم يمكن إعداده بشكل مستقل، وأن الموجه المستخدم في التقييم يمكن تخصيصه أيضًا.
| نوع الادعاء | طريقة الحكم | هل النتيجة حتمية | ما يمكن إثباته | ما لا يمكن إثباته |
|---|---|---|---|---|
| contains | مطابقة نصية | حتمية | ظهور النص المحدد | جودة الفقرة، صحة المحتوى |
| JavaScript | منطق برمجي مخصص | حتمية | شروط قابلة للترميز مثل البنية والترتيب والعدد | الجودة على المستوى الدلالي |
| llm-rubric | تقييم النموذج وفق مقياس | تتأثر بنموذج التقييم | أن المخرجات تستوفي المقياس من وجهة نظر نموذج التقييم | الصحة الواقعية، ولا يغني عن المراجعة البشرية |
المصادر وحالة التحقق
تستند الحقائق في هذا المقال إلى صفحات وثائق Promptfoo التالية، بتاريخ مراجعة 2026-11-17:
- وثائق ادعاءات ومؤشرات Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/
- وثائق ادعاءات التقييم بواسطة النموذج في Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- وثائق llm-rubric في Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
لم نُجرِ في هذا المقال تجربة A/B حقيقية بين قالب قديم وقالب جديد. والإعدادات وسير العمل الواردة لاحقًا هي اقتراحات تصميمية فحسب، ولا تمثل أي نتائج قياس فعلية.
استخدام Promptfoo لمقارنة التحليل والاستنتاج في قالبَي المقالات القديم والجديد
ما يلي هو قراءتنا وتوصياتنا بناءً على الوقائع المذكورة أعلاه. لنأخذ «قالب المقال الإخباري» مثالاً، ولنفترض أن القالب الجديد يشترط أن يتضمّن المقال قسمين: «الوقائع الموضوعية» و«التحليل والاستنتاج»، وأن تأتي الوقائع أولاً ثم يأتي التحليل بعدها، وألا تُخلط أي تخمينات داخل قسم الوقائع.
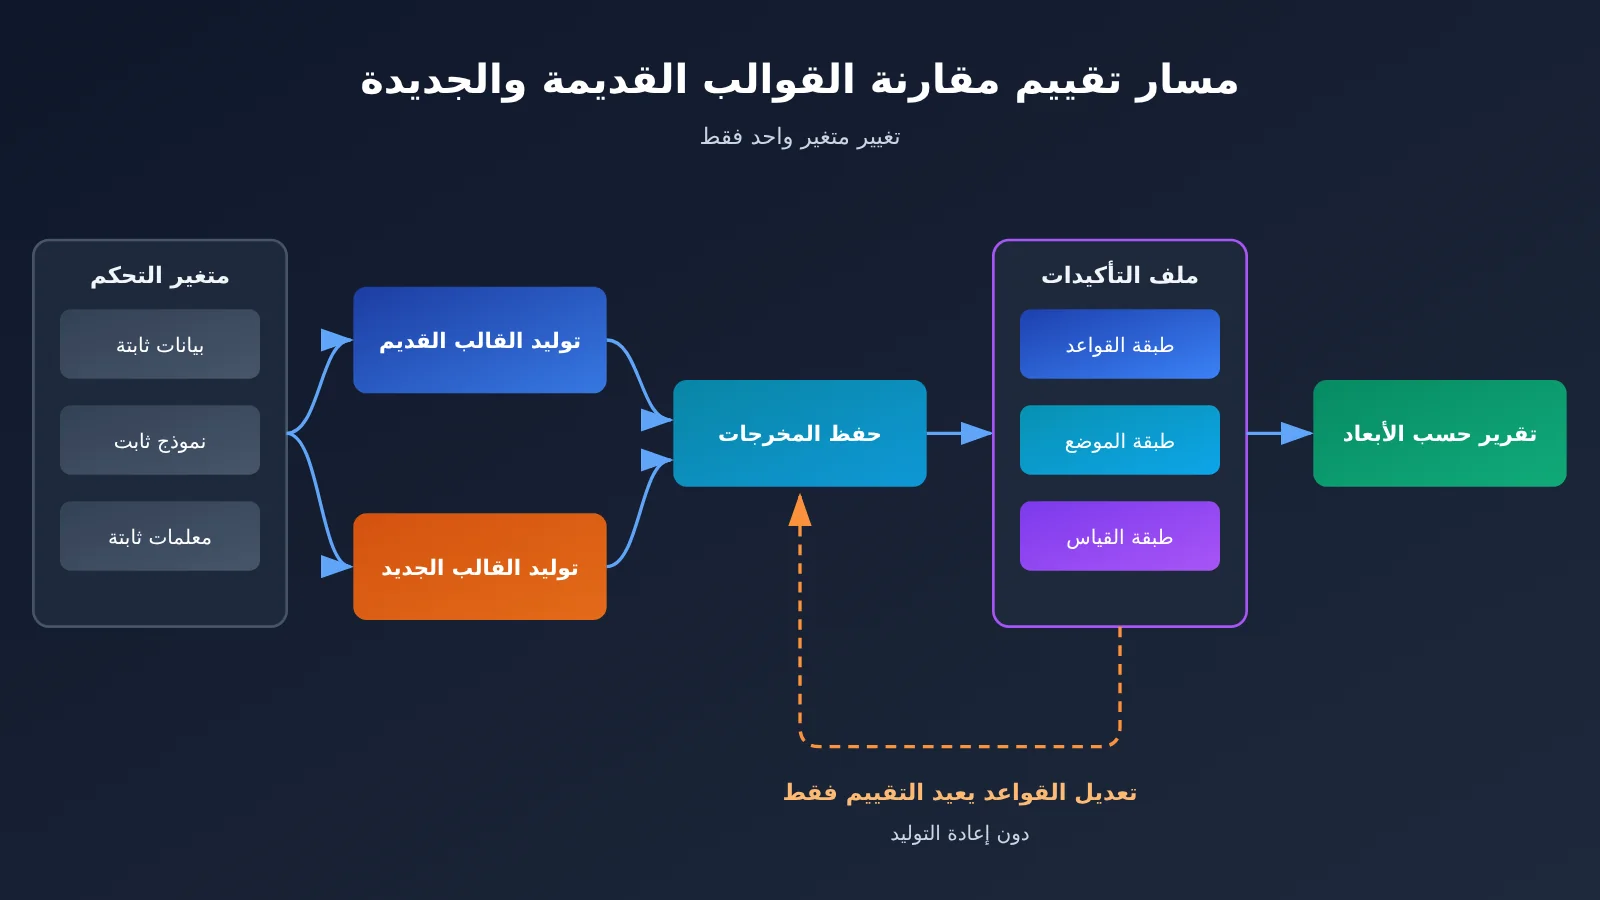
تصميم التجربة: تغيير متغير واحد فقط عند مقارنة القوالب باستخدام Promptfoo
أكثر خطأ شائع في مقارنة القوالب هو تغيير القالب مع تغيير البيانات أو النموذج أو معامل درجة الحرارة في الوقت نفسه. وهكذا، حتى لو تحسّنت النتيجة، لن تستطيع أن تحدد بوضوح هل الفضل يعود إلى القالب أم إلى عوامل أخرى. لذلك فإن الخطوة الأولى هي تثبيت جميع المتغيرات ما عدا القالب.
| المتغير | طريقة المعالجة | السبب |
|---|---|---|
| بيانات الإدخال | تثبيت الدفعة نفسها، ويتشاركها القالبان القديم والجديد | اختلاف البيانات يغيّر محتوى الوقائع مباشرةً |
| نموذج التوليد | تثبيت النموذج نفسه والإصدار نفسه | اختلاف أسلوب الكتابة بين النماذج قد يكون أكبر من اختلاف القوالب |
| معاملات التوليد | تثبيت درجة الحرارة والحد الأقصى للطول وغيرها من الإعدادات | تؤثر المعاملات في استقرار الإخراج وطوله |
| قالب الموجه | المتغير الوحيد الذي يتغيّر | هذا هو الموضوع الذي نريد التحقق منه |
| قواعد التقييم | تستخدم المجموعتان القديمة والجديدة مجموعة التأكيدات نفسها | لضمان خضوع المجموعتين للفحوص نفسها |
طبقة القواعد وطبقة الموضع في Promptfoo: افحص البنية أولاً، ثم افحص الترتيب
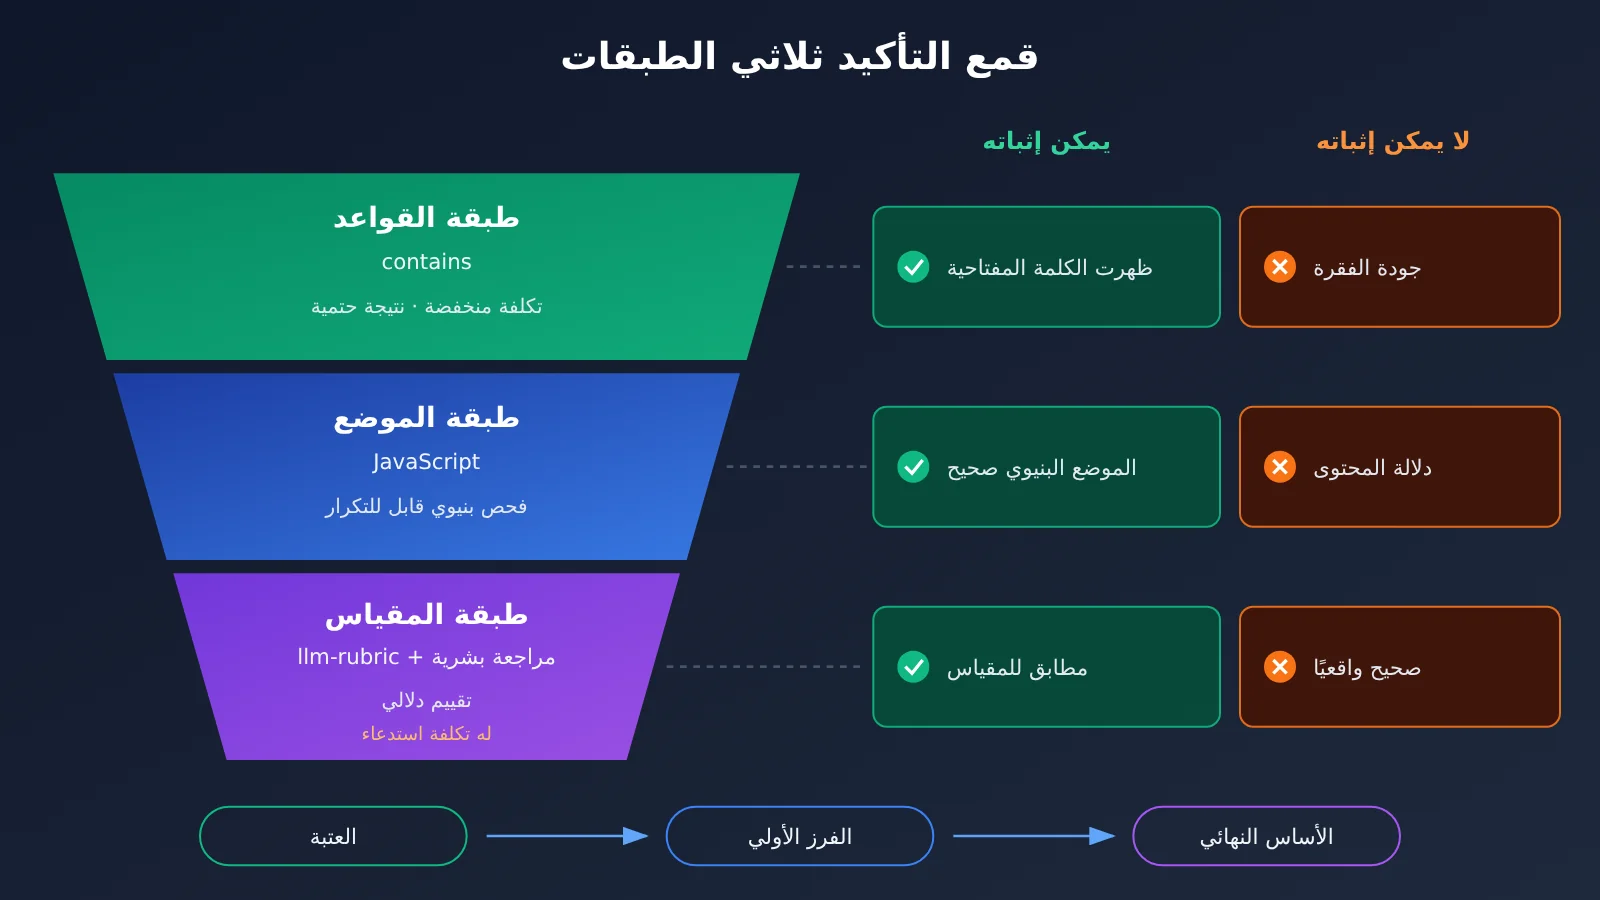
الطبقة الأولى هي فحص القواعد، حيث نستخدم contains للتأكد من ظهور العناوين التي يطلبها القالب. والطبقة الثانية هي مقارنة الموضع، حيث نستخدم تأكيد JavaScript للتأكد من أن عنوان “客观事实” يظهر قبل عنوان “分析判断”. هاتان الطبقتان فحصان حتميان، تكلفتهما منخفضة ونتائجهما مستقرة، ولهذا من المناسب وضعهما في المقدمة لتصفية المخرجات غير المؤهلة بوضوح.
فيما يلي صياغة توضيحية للتأكيد؛ أما أسماء الحقول الدقيقة فيجب الرجوع فيها إلى وثائق Promptfoo الرسمية:
# إعداد توضيحي: يهدف إلى شرح الفكرة؛ تحقق من تفاصيل الحقول مقابل الوثائق الرسمية
assert:
  # طبقة القواعد: هل ظهر العنوان؟
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # طبقة الموضع: يجب أن يسبق قسم الحقائق قسم التحليل
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
انتبه إلى أن صياغة طبقة الموضع تتحقق أولاً من وجود العنوانين معًا. فإذا كتبت a < b فقط، فسيُرجع indexOf القيمة -1 عند غياب عنوان “客观事实”، وهذا يلبي شرط “أصغر من” أيضًا، ما يسبب حكمًا خاطئًا. ولهذا تحديدًا تحتاج التأكيدات الحتمية إلى كتابة دقيقة أيضًا.
طبقة مقياس Promptfoo: فحص فقرة الحقائق بمقياس واضح للتأكد من عدم تسرّب التخمين إليها
اكتمال العناوين وصحة ترتيبها لا يعني أن فقرة الحقائق مكتوبة بشكل نظيف. فسؤال «هل تسرّب التخمين إلى فقرة الحقائق؟» هو حكم دلالي يصعب على الادعاءات القائمة على القواعد تغطيته، وهنا يكون llm-rubric مناسبًا. يجب كتابة المقياس بشكل محدد، يوضّح لنموذج التقييم ما يُعدّ مخالفة، بدلًا من سؤال عام مثل «هل كُتب بشكل جيد؟».
# إعداد توضيحي: مزود التقييم ومحتوى المقياس كلاهما مجرد أمثلة
assert:
  - type: llm-rubric
    value: |
      قيّم فصل «الحقائق الموضوعية» فقط.
      إذا ظهر في هذا الفصل تنبؤ أو تقييم ذاتي أو استنتاج غير موثّق المصدر، فاعتبره غير ناجح، واقتبس الجملة الأصلية التي وقعت فيها المشكلة.
      لا تقيّم الأسلوب الأدبي، ولا تقيّم الفصول الأخرى.
    provider: your-grading-model   # يمكن إعداد مزود التقييم بشكل منفصل
لا تزال نتائج طبقة المقياس تحتاج إلى مراجعة يدوية بعينات. فقد يفوت نموذج التقييم بعض الحالات، وقد يخطئ فيعدّ عبارة واقعية معقولة تخمينًا. الطريقة الأكثر أمانًا هي مراجعة العينات غير الناجحة واحدة تلو الأخرى، ثم سحب جزء عشوائي من العينات الناجحة لمراجعته يدويًا.
العرض حسب الأبعاد: ألا تُلغي درجة الأسلوب في Promptfoo الأخطاء الواقعية
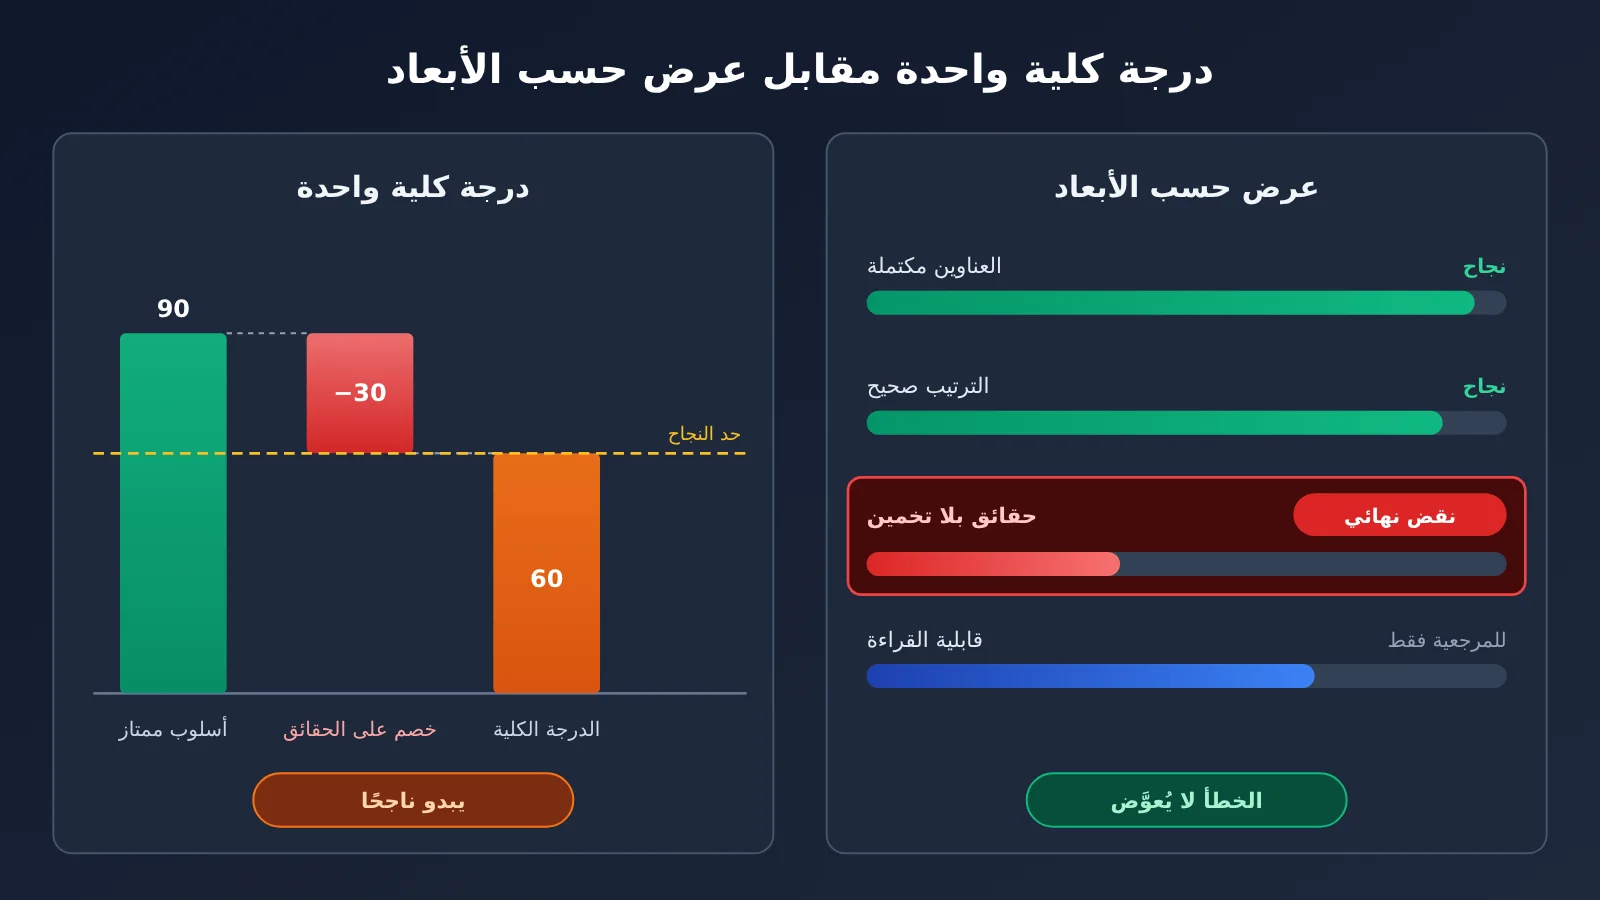
إذا جمعنا كل التأكيدات في درجة إجمالية واحدة، فقد تحصل مقالة سلسة الأسلوب لكنها تخلط التخمين في فقراتها الواقعية على درجة قريبة من مقالة محكمة البنية لكنها مسطحة نسبيًا. وبالنسبة للمحتوى الإخباري، فإن هذا “الإلغاء المتبادل” أمر خطير. لذلك يُنصح بالعرض حسب كل بُعد على حدة، واعتبار الأبعاد الواقعية حقًا ناقضًا (فيتو).
| بُعد التقييم | طريقة الفحص | طريقة العرض | هل يمكن أن تُلغيه أبعاد أخرى |
|---|---|---|---|
| اكتمال العناوين المطلوبة | contains | معدل النجاح | لا، متطلب إلزامي |
| صحة ترتيب الفصول | JavaScript | معدل النجاح | لا، متطلب إلزامي |
| خلو الفقرات الواقعية من التخمين | llm-rubric + مراجعة بشرية | معدل النجاح + قائمة بالجمل المشكلة | لا، حق ناقض (فيتو) |
| التعبير وقابلية القراءة | llm-rubric | يُذكر منفصلًا | للمرجعية فقط، لا يشارك في الإلغاء |
عندما لا تغيّر سوى قواعد تقييم Promptfoo: أعد تقييم المخرجات القديمة مباشرة
خلال تكرار التقييم، يكون التغيير الأكثر شيوعًا في قواعد التقييم لا في القالب نفسه. مثلًا، تكتشف أن وصف مقياس التقييم غير واضح بما يكفي، أو أن توكيدات الموضع أغفلت بعض الحالات الحدّية. في هذه الحالة لم يتغيّر القالب ولا المخرجات، فلا حاجة إلى إعادة التوليد.
بالاستفادة من قدرة Promptfoo على تشغيل ملف توكيدات مستقل على المخرجات الموجودة، يمكن فصل التوليد عن التقييم تمامًا: ولّد مرة واحدة، واحفظ المخرجات، ثم في كل مرة تعدّل فيها القواعد أعد تشغيل التوكيدات فقط. بهذه الطريقة توفّر الوقت، وتضمن أن جولتي التقييم المتتاليتين تنظران إلى النص نفسه تمامًا، وهو ما يجعل المقارنة ذات معنى.
حدود محكّم النموذج في Promptfoo وتكلفته
هناك ثلاث نقاط يجب توضيحها بوضوح، لتجنّب المبالغة في تفسير نتائج التقييم:
- درجات محكّم النموذج لا تثبت صحة الوقائع. يشير llm-rubric فقط إلى أن المخرَج يوافق مقياس التقييم من وجهة نظر نموذج التقييم، أما التحقق من الحقائق فيجب أن يعود إلى المصادر الأصلية.
- اجتياز contains يعني فقط مطابقة نصية. فهو يبيّن أن العنوان ظهر، ولا يبيّن أن جودة الفقرة أسفله مقبولة.
- مراجعة النماذج المدفوعة لها تكلفة. التوكيدات القائمة على القواعد لا تولّد عمليًا استدعاءات إضافية للنموذج، لكن llm-rubric يستدعي نموذج التقييم مرة واحدة لكل مخرَج يقيّمه، لذا لا يمكن وصف مجموعة التقييم بأكملها بأنها «مجانية بالكامل».
بناءً على هذه الحدود، حكمنا هو: التوكيدات الحتمية تصلح كـ«بوابة»، وتقييم النموذج يصلح كـ«فرز أولي»، والمراجعة البشرية هي المرجع النهائي للاستنتاجات الواقعية. الأدوار مختلفة، ولا يمكن أن يحلّ أحدها محل الآخر.
اتجاهات جديرة بالمتابعة لاحقًا
فيما يلي اتجاهات ملاحظة لم يتم التحقق منها بعد، وهي مجرد اقتراحات لتجارب لاحقة:
- اتساق نموذج التقييم. هل تكون النتيجة مستقرة عند تقييم المخرجات نفسها عدة مرات، وهل تنقلب النتيجة إذا استُخدم نموذج تقييم مختلف. وإذا لم تكن النتيجة مستقرة، فسيحتاج مقياس التقييم إلى صياغة أكثر تحديدًا.
- درجة تطابق الفحص اليدوي بالعينة مع تقييم النموذج. هذا هو ما يحدد إلى أي مدى يمكن الاعتماد على llm-rubric في الفرز الأولي.
- هل حجم العينة كافٍ. عند مقارنة عدد قليل من المقالات فقط، قد تحجب العوامل العشوائية الفروق بين القوالب، لذا يلزم وجود مواد إدخال كافية للوصول إلى استنتاجات ذات معنى.
وقبل أن تتوفر بيانات فعلية حول هذه الأسئلة، ينبغي التعامل بحذر مع أي عبارة من قبيل «ما نسبة فوز القالب الجديد» أو «كم ارتفع التقييم». وهذا هو السبب وراء امتناع هذا المقال عمدًا عن تقديم أرقام من هذا النوع.
ما يُنال من الكتب يبدو سطحيًا، ولا تُدرك حقيقة الأمر إلا بالممارسة. — لو يو، قصيدة «قراءة الكتب في ليلة شتاء لإرشاد ابني زيُو»