ملاحظة المؤلف: يقتصر هذا المقال على قراءة لوحة الترتيب النهائية بعد انتهاء جميع عمليات التشغيل البالغ عددها 26,040 في FrontierHarness v1.1، حيث يقارن 21 harness مصنّفة حسب النموذج، مع مقارنة البروتوكولات والأسعار المفتوحة فعليًا لمعرّفات النماذج المعنية على APIYI.
إذا كنت تستخدم بالفعل وكلاء برمجة مثل Codex CLI وClaude Code وOpenCode وPi، وتغيّر النموذج الأساسي كثيرًا، فمن المرجح أن سؤال «أي harness هو الأفضل؟» لا توجد له إجابة موحدة. في 2026-11-10 أطلق Guanlan Dai من Runta نسخة FrontierHarness v1.1، وكان السؤال الذي طرحه مباشرة: عند تبديل النماذج، هل ينبغي أن تبدّل الـ harness أيضًا؟ حتى 2026-11-15، أظهرت لوحة البث المباشر running 0 وscored 26,040، وقد اكتملت جميع عمليات 21 harness × 5 نماذج × 62 مهمة × 4 محاولات.
هذا ليس تحليلًا لترتيب يُظهر أن «harness واحد يتصدّر في كل شيء». في لوحة الترتيب النهائية، ليس نفس الـ harness هو صاحب أعلى معدل نجاح وأرخص تكلفة لكل نجاح، كما أن أرخص harness لكل نموذج من النماذج الخمسة ليس هو نفسه. سيفصل هذا المقال هذه الاستنتاجات حسب النموذج، ويشرحها خانة بخانة.
القيمة الأساسية: بعد قراءة هذا المقال، ستحصل على مقارنة للوحة الترتيب النهائية لـ FrontierHarness مفصولة حسب النموذج، وستعرف أي عمود يجب أن تنظر إليه عند تبديل النماذج، وأي الأرقام القديمة لم تعد صالحة، وأي بروتوكول يجب التحقق منه قبل الاتصال.
معايير الترتيب النهائي في FrontierHarness: قبل تحديد أفضل harness، اقرأ القواعد أولاً
تُنفَّذ جميع عمليات التشغيل في FrontierHarness داخل Runta runtime، وباستخدام المجموعة نفسها من حدود الموارد. ولا يُحتسب أي مزيج من harness × model نتيجةً نهائية إلا بعد إكمال 248 تشغيلاً، لذا تتغير المراتب أثناء البث المباشر باستمرار مع ظهور نتائج جديدة. يلخّص الجدول التالي معايير الاحتساب في الترتيب النهائي v1.1، وهي المرجع الذي ستُبنى عليه كل المقارنات التالية.
| المعيار | إعداد الترتيب النهائي v1.1 | ما يعنيه عند المقارنة |
|---|---|---|
| مجموعة البيانات | [email protected]، 62 مهمة |
جميع الـ harnesses تحل المجموعة نفسها من المهام |
| نطاق التشغيل | 21 harness، و4 محاولات لكل مهمة، و248 محاولة لكل مزيج، و5,208 محاولات لكل نموذج، ليبلغ الإجمالي 26,040 محاولة | المقام متساوٍ في كل خلية، ما يتيح مقارنة عادلة |
| بيئة التشغيل | 1–4 vCPU، و2–8 GB من الذاكرة، و32 GB من مساحة القرص، ومهلة لكل مهمة تتراوح من 15 دقيقة إلى 8 ساعات | لاستبعاد فروق الأجهزة |
| إعدادات الاستدلال | مزوّد الاستدلال Baseten، وقيمة effort مضبوطة على max في النماذج الخمسة | توحيد المتغيرات على جانب النموذج |
| معدل النجاح | عدد النجاحات ÷ المحاولات المحتسبة في النتيجة؛ تُعدّ المهلات وreward hacking إخفاقات، ولا تُحتسب أخطاء البنية التحتية | لا تُمنح نقاط مقابل النظر إلى الإجابة |
| التكلفة | السعر المعلن × عدد الـ tokens المبلّغ عنها | هذه طريقة حساب لوحة الترتيب، وليست فاتورة أي منصة |
| درجة الثقة | إجراء bootstrap بنسبة 95% على مستوى كل مهمة | المراتب المتقاربة جداً ينبغي تفسيرها بحذر |
هناك عدة مجموعات من الأرقام يُعاد تداولها كثيراً، لكنها ليست الترتيب النهائي v1.1. فـ v1.0 اختُبرت على نموذج واحد فقط هو Kimi K3، وشملت 9 harness و12 إعداداً و360 تشغيلاً؛ ومعدل نجاح Codex البالغ 66.7% والتكلفة الوسيطة للمهمة البالغة $3.47 يعودان إلى v1.0. وفي لقطة منتصف الطريق بتاريخ 2026-11-11، تراوحت تكلفة كل نجاح بين $0.57 و$1.32، وتراوح معدل النجاح بين 56.2% و77.6%، وهذا أيضاً مجرد وضع منتصف الطريق. وفي اليوم نفسه كتب أحدهم: «أفضل harness لـ GLM-5.3 هو KimiCode، وأفضل harness لـ Kimi-K3 هو Codex»؛ لكن بعد إعادة الترتيب وفق تكلفة كل نجاح في الترتيب النهائي، لم تبقَ هذه الادعاءات صحيحة.
أي harness هو الأفضل: مقارنة شاملة لجميع المتصدرين في القائمة النهائية لـ FrontierHarness
يجمع الجدول التالي نتائج 21 harness على خمسة نماذج، مرتبة حسب «تكلفة كل عملية نجاح» من الأدنى إلى الأعلى. جميع الأرقام بالدولار مستخرجة من القائمة النهائية لـ FrontierHarness، ومحسوبة بضرب سعر القائمة في عدد الـ tokens المبلّغ عنها.
| الترتيب | harness | تكلفة كل عملية نجاح | متوسط تكلفة كل مهمة | معدل النجاح |
|---|---|---|---|---|
| 1 | Codex CLI | $0.937 | $0.573 | 61.1% |
| 2 | Pi | $0.976 | $0.563 | 57.7% |
| 3 | Oh My Pi | $0.983 | $0.564 | 57.3% |
| 4 | ZCode | $1.06 | $0.659 | 61.9% |
| 5 | KimiCode | $1.09 | $0.653 | 60.2% |
| 6 | OpenCode | $1.12 | $0.646 | 57.4% |
| 7 | Maka | $1.13 | $0.654 | 57.7% |
| 8 | MiniMax Code | $1.14 | $0.647 | 56.8% |
| 9 | DeepSeek Harness: Minimal | $1.15 | $0.661 | 57.4% |
| 10 | Hermes Agent | $1.16 | $0.692 | 59.9% |
| 11 | Cline CLI | $1.19 | $0.689 | 57.7% |
| 12 | Grok Build | $1.20 | $0.723 | 60.0% |
| 13 | Alma | $1.22 | $0.731 | 59.7% |
| 14 | DeepSeek Harness: Standard | $1.27 | $0.697 | 55.0% |
| 15 | DeepSeek Harness: Creator | $1.27 | $0.713 | 56.1% |
| 16 | mini-SWE-agent | $1.29 | $0.757 | 58.6% |
| 17 | DeepSeek Harness: Code | $1.32 | $0.732 | 55.2% |
| 18 | Exo | $1.36 | $0.691 | 50.6% |
| 19 | GitHub Copilot CLI | $1.38 | $0.787 | 56.9% |
| 20 | Claude Code | $1.55 | $0.915 | 58.9% |
| 21 | Antigravity CLI | $1.63 | $0.897 | 55.0% |
المركزان الأولان في الترتيب النهائي الشامل
على مستوى جميع المشاركين، أعلى نسبة نجاح كانت من نصيب ZCode (61.9%)، والأرخص من حيث تكلفة كل اجتياز هو Codex CLI (0.937 دولار)، ويجب قراءة هذين الرقمين معًا. فقد بلغت نسبة نجاح Codex CLI 61.1%، أي أقل من ZCode بـ 0.8 نقطة مئوية فقط، لكن تكلفة كل اجتياز لديه أرخص بنحو 0.12 دولار؛ أما ZCode فهو الخيار الأكثر ثباتًا عندما يكون الهدف هو «اجتياز أكبر عدد ممكن من المسائل». أما Antigravity CLI، وهو الأغلى، فتبلغ تكلفة كل اجتياز لديه 1.63 دولار، أي نحو 1.74 ضعف تكلفة Codex CLI. وتراوحت نسب النجاح في الترتيب بين 50.6% لدى Exo و61.9% لدى ZCode، بفارق 11.3 نقطة مئوية.
هناك موضعان يسهل إساءة قراءتهما. أولًا، إن إصدارات DeepSeek Harness الأربعة ليست أربعة منتجات مستقلة، بل أربعة إعدادات (Minimal وStandard وCreator وCode) للإصدار نفسه 0.2.1-rc.3. ثانيًا، تحتل Alma المرتبة 13 من حيث تكلفة كل اجتياز، والمرتبة 6 من حيث نسبة النجاح، أي بعد ZCode وCodex CLI وKimiCode وGrok Build وHermes Agent. أما ما ورد في لقطة 11 نوفمبر من أن Alma كانت في المرتبة 3 بنسبة 72.7% فهو بيانات مرحلية، والمعتمد هو 59.7% في الترتيب النهائي.
أي harness هو الأفضل بعد تغيير النموذج: خمسة نماذج على حدة في FrontierHarness
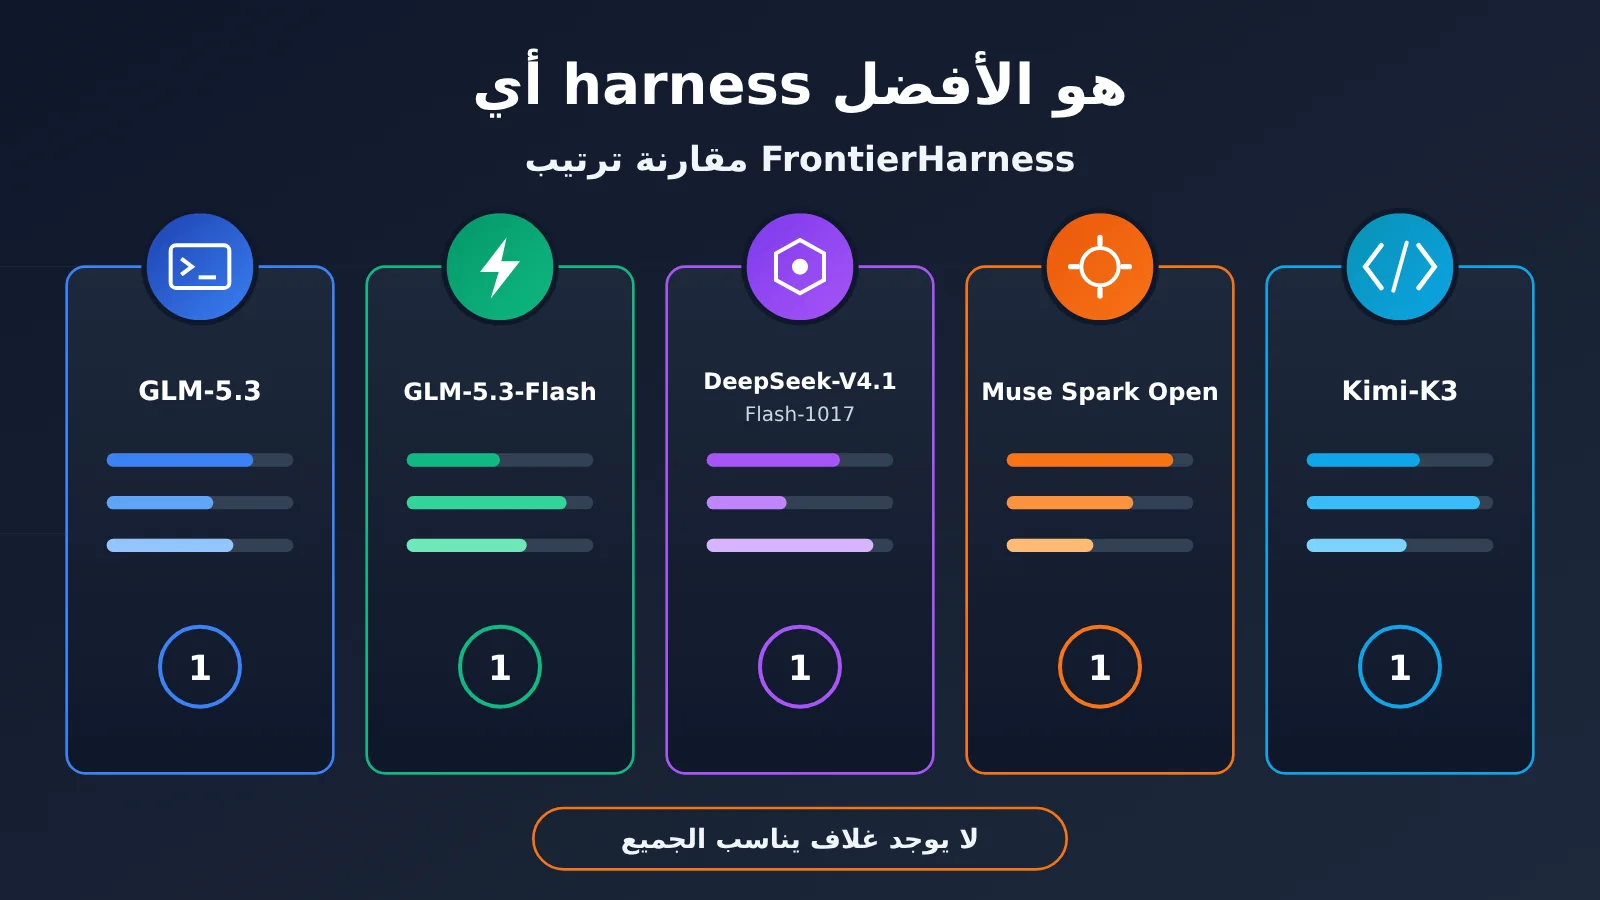
الملخص الشامل لا يخبرك إلا بالمتوسط، أما ما يحدد الفاتورة حقًا فهو العمود الخاص بالنموذج الذي تستخدمه. وكلمة «الأرخص» في الجدول أدناه تعني دائمًا الـ harness الأقل تكلفة لكل نجاح على صفحة ذلك النموذج، ومقام عدد النجاحات هو 248 في جميع الحالات.
| النموذج | متوسط تكلفة المهمة الواحدة (بمتوسط على الـ harness) | الأرخص لكل نجاح | أعلى معدل نجاح | الأغلى للنموذج نفسه |
|---|---|---|---|---|
| GLM-5.3 | $0.968 | Codex CLI $0.803، 57.7% | ZCode 58.9%، $1.48 | Exo $2.72، 50.0% |
| GLM-5.3-Flash | $0.193 | Pi $0.223، 58.1% | Hermes Agent 60.9%، $0.328 | DeepSeek Harness: Minimal $0.484، 55.2% |
| DeepSeek-V4.1-Flash-1017 | $0.185 | OpenCode $0.177، 61.3% | ZCode 69.0%، $0.222 | Cline CLI $0.860، 63.3% |
| Muse Spark Open | $1.01 | Oh My Pi $1.21، 58.9% | Grok Build 59.7%، $1.77 | Claude Code $3.75، 52.8% |
| Kimi-K3 | $1.12 | Oh My Pi $1.45، 57.7% | mini-SWE-agent 64.9%، $2.02 | Antigravity CLI $2.73، 56.9% |
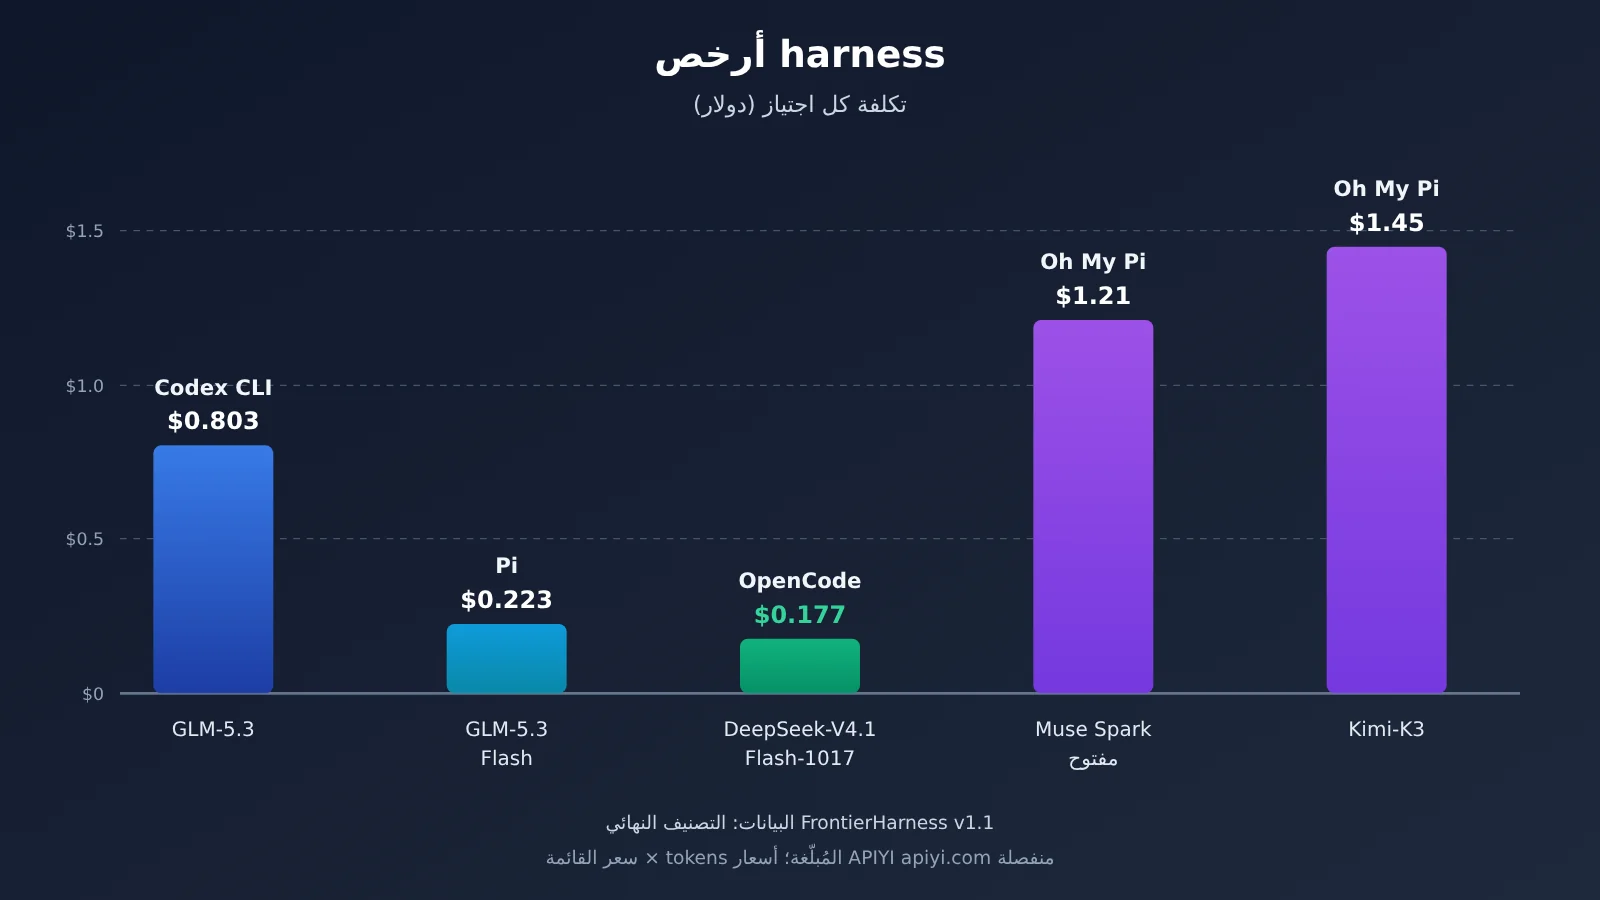
الاستنتاج الأول: أرخص إطار تشغيل ليس واحدًا عبر النماذج الخمسة
أرخص إطار تشغيل في الأعمدة الخمسة هو، على الترتيب: Codex CLI وPi وOpenCode وOh My Pi وOh My Pi؛ أي أربعة إطارات تشغيل مختلفة. وقد جاء Codex CLI، متصدر القائمة الإجمالية، الأرخصَ في عمود GLM-5.3 فقط، بينما في GLM-5.3-Flash سجل $0.226، وهو أغلى من Pi بقليل فقط. لذلك عند تغيير النموذج يجب إعادة النظر في إطار التشغيل، ولا يجوز الاعتماد مباشرة على التوليفة القديمة.
الاستنتاج الثاني: فارق التكلفة عند تغيير النموذج أكبر من فارق تغيير إطار التشغيل
إذا نظرنا إلى متوسط تكلفة المهمة الواحدة حسب النموذج، نجدها تتراوح من $0.185 مع DeepSeek-V4.1-Flash-1017 إلى $1.12 مع Kimi-K3، أي نحو 6.1 أضعاف. وإذا نظرنا إلى المتوسط العام لتكلفة المهمة الواحدة حسب إطار التشغيل، فالأدنى هو $0.563 مع Pi والأعلى هو $0.915 مع Claude Code، أي بفارق أقل من الضعف. بمعنى آخر، في التصنيف النهائي لـ FrontierHarness، يكون تأثير اختيار النموذج أولًا على تكلفة المهمة أكبر من تأثير اختيار إطار التشغيل أولًا.
الاستنتاج الثالث: أداة التشغيل الخاصة بـ DeepSeek لم تكن الأرخص على نموذجها الخاص
في عمود DeepSeek-V4.1-Flash-1017، وبحسب التكلفة لكل نجاح، جاءت الفئات الأربع لـ DeepSeek Harness كالتالي: Code بتكلفة $0.243 ومعدل نجاح 64.1%، وMinimal بتكلفة $0.256 ومعدل نجاح 63.7%، وCreator بتكلفة $0.273 ومعدل نجاح 64.9%، وStandard بتكلفة $0.292 ومعدل نجاح 62.1%. وهكذا لم تحقق أرخص تكلفة (OpenCode عند $0.177)، ولم تحقق أعلى معدل نجاح (ZCode عند 69.0%، أي 171/248، وهي أيضًا أعلى خانة في معدل النجاح بين كل التركيبات). وسجل Claude Code في هذه الخانة 68.1%، بينما جاء Codex CLI بتكلفة $0.237 ومعدل نجاح 67.3%. أما Cline CLI، الأغلى في العمود نفسه، فتستهلك 6.77M tokens في كل محاولة، وتبلغ تكلفتها لكل نجاح $0.860، أي نحو 4.9 أضعاف OpenCode، وهذا المضاعف يخص هذا الثنائي فقط.
وفي عمود Kimi-K3 الأمر نفسه: فمن حيث التكلفة لكل نجاح، جاءت أداة التشغيل الخاصة KimiCode بتكلفة $1.84 ومعدل نجاح 60.1%، وهو أقل من $1.45 لـ Oh My Pi، كما أن معدل نجاحها أقل من 64.9% لـ mini-SWE-agent، ومن 64.1% لـ Alma وZCode. وأدنى خانة في معدل النجاح على مستوى كل التركيبات توجد هنا أيضًا: Exo + Kimi-K3، بمعدل 43.5%، أي 108/248.
توصيات حسب السيناريو: أي harness هو الأفضل لكل نموذج
لتحويل الاستنتاجات السابقة حسب الأعمدة إلى اختيار عملي، يمكن تقسيمها وفق «أي نموذج تستخدم + وما الذي يهمك أكثر: التكلفة أم معدل النجاح».
عند استخدام GLM-5.3
- إذا كانت تهمك تكلفة كل نجاح: Codex CLI، $0.803، 57.7%، وحوالي 1.86M tokens لكل محاولة.
- إذا كان يهمك معدل النجاح: ZCode، 58.9%، لكن تكلفة كل نجاح $1.48، أي قرابة ضعف Codex CLI.
- ملاحظة: KimiCode في هذا العمود عند $1.55 / 58.1%، والادعاء المرحلي السابق لم يعد صحيحًا.
عند استخدام GLM-5.3-Flash
- إذا كانت التكلفة هي الأهم: Pi ($0.223) وCodex CLI ($0.226) متعادلان تقريبًا، كما أن معدل نجاح الأخير أعلى قليلًا عند 59.3%.
- إذا كان معدل النجاح هو الأهم: Hermes Agent عند 60.9%، وتكلفة كل نجاح $0.328؛ أما ZCode عند 60.1% و$0.264 فهو خيار وسط.
عند استخدام DeepSeek-V4.1-Flash-1017
- إذا كانت التكلفة هي الأهم: OpenCode، $0.177، 61.3%.
- إذا كان معدل النجاح هو الأهم: ZCode، 69.0%، وتكلفة كل نجاح $0.222، أي أغلى بنحو $0.045 فقط من الخيار الأرخص. في هذا العمود، تكلفة السعي إلى معدل نجاح مرتفع منخفضة جدًا.
عند استخدام Muse Spark Open أو Kimi-K3
- Muse Spark Open: Oh My Pi هو الأرخص ($1.21)؛ وGrok Build لديه أعلى معدل نجاح (59.7%)؛ أما Claude Code فيستهلك 9.79M tokens لكل محاولة، وتكلفة كل نجاح $3.75، وهي أغلى خلية في هذا العمود.
- Kimi-K3: Oh My Pi هو الأرخص ($1.45، و942k tokens لكل محاولة)؛ وmini-SWE-agent لديه أعلى معدل نجاح (64.9%)؛ أما Codex CLI فعند $1.78 / 63.7%، أي خيار متوازن لا يخسر في أي من الجانبين.
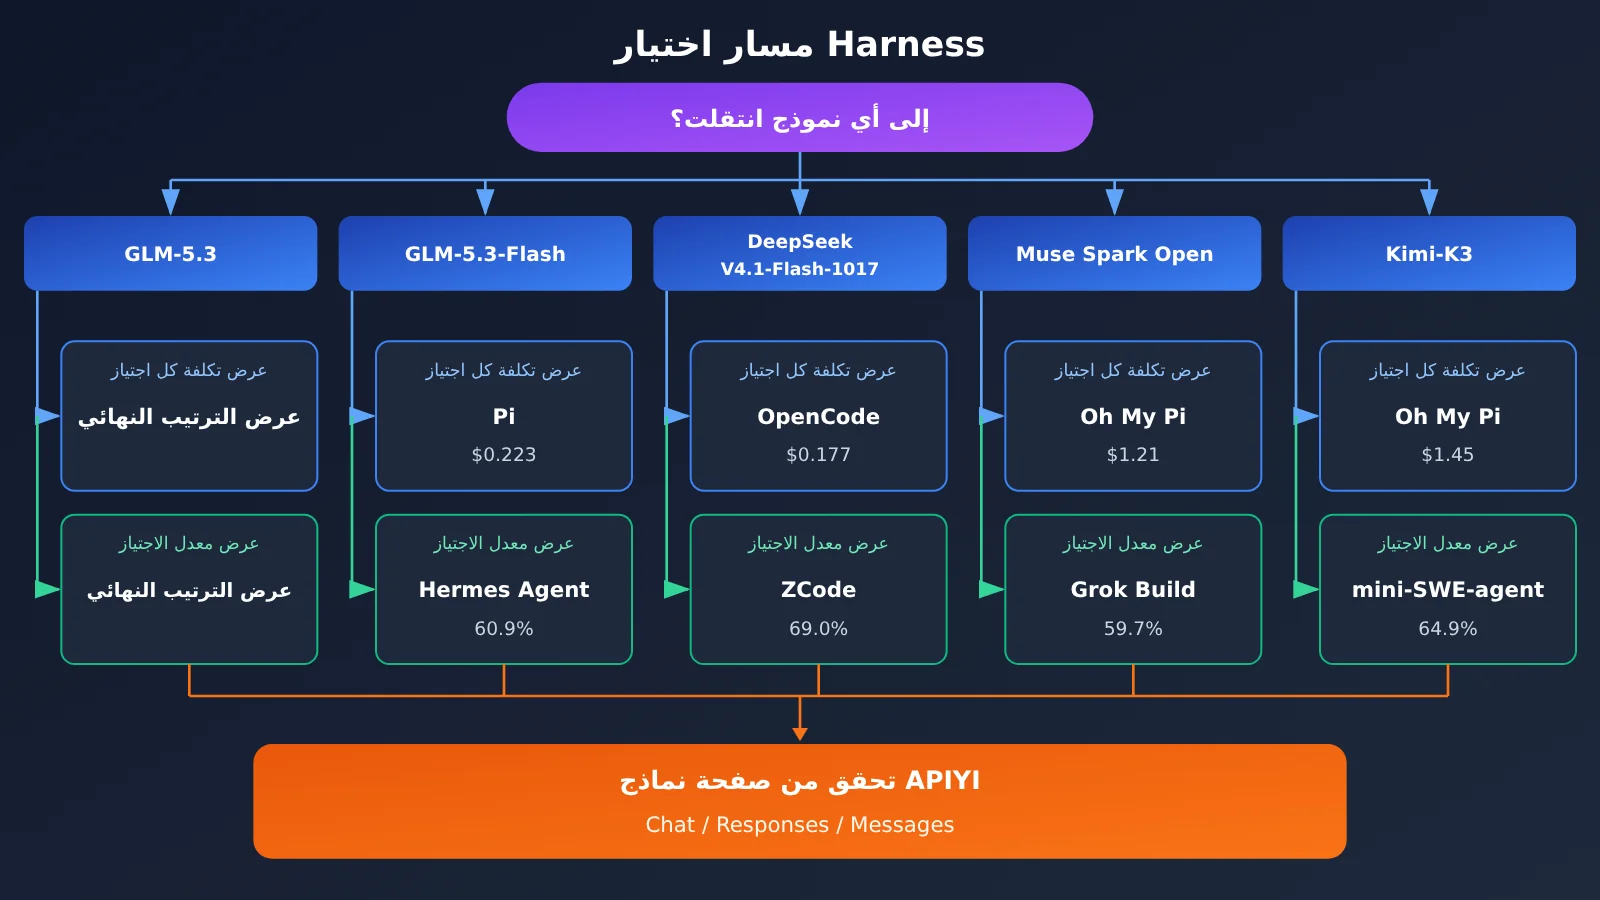
توصية للقرار: مقارنة بين بروتوكولات harness ومعرّفات النماذج في APIYI
العاقة بين harness على لوحة الترتيب ونقاط النهاية (endpoints) في المنصة ليست علاقة تقابل واحد لواحد. فتفوّق Codex CLI لا يعني أن معرّف النموذج الذي بين يديك يفتح Responses؛ والأمر نفسه ينطبق على Claude Code، إذ عليك أولاً النظر إلى عمود Messages. وكل harness يستهلك token عند تنفيذ المهام، وتغيير الواجهة أو تغيير النموذج يغيّر الفاتورة مباشرة؛ لذا قبل تجربة أي خانة، من المستحسن أن تتحقق أولاً في صفحة النموذج على APIYI (apiyi.com) مما إذا كان هذا المعرّف يفتح Chat أو Responses أو Messages، ثم توجّه base_url الخاص بـ harness إلى https://api.apiyi.com/v1.
الجدول التالي هو الأسعار الافتراضية في وثائق APIYI بتاريخ 2026-11-15 (دولار / 1M tokens)، وهي أرقام مختلفة عن أسعار الكتالوج في لوحة الترتيب أعلاه، ولا يجوز خلط الحسابين.
| معرّف النموذج | الإدخال | قراءة الذاكرة المؤقتة | الإخراج | Chat | Responses | Messages | المجموعة |
|---|---|---|---|---|---|---|---|
glm-5.3 |
$1.4 | $0.259 | $4.396 | مدعوم | غير مدعوم | مدعوم | ClaudeCode 0.95×، Default، SVIP |
glm-5.3-flash |
$0.15 | $0.03 | $0.5 | مدعوم | صفحة النموذج: غير مدعوم | صفحة النموذج: غير مدعوم | CodexResponses، Default، SVIP |
deepseek-v4.1-flash-1017 |
$0.3 | $0.006 | $1.2 | مدعوم | غير موجود في الجدول العام | مدعوم | ClaudeCode، Default، SVIP |
deepseek-v4.1-flash |
$0.3 | $0.006 | $1.2 | مدعوم | انظر المجموعة | مدعوم | مع إضافة CodexResponses |
kimi-k3 |
$3 | $0.3 | $15 | مدعوم | غير مدعوم | غير مدعوم | Default، SVIP |
| Muse Spark Open | لم يُطرح بعد | — | — | — | — | — | — |
هناك عدة نقاط تحتاج إلى توضيح واحدة واحدة:
- يمكن لـ
glm-5.3المرور عبر Messages، ولديه مجموعة ClaudeCode بمعامل 0.95×، ما يجعله مناسبًا للاستخدام مع واجهات من نوع Claude Code؛ وهذا المعامل 0.95× يخصglm-5.3وحده. ولا يمكنه المرور عبر Responses. - يوجد تعارض بين الجدول العام وصفحة النموذج في
glm-5.3-flash، ونحتفظ بالروايتين معًا: المجموعة تذكر CodexResponses، لكن صفحة النموذج تكتب أن Responses وMessages غير مدعومين؛ وعمود النوع في الجدول العام مكتوب فيه «نص»، بينما تقول صفحة النموذج إن المدخلات تشمل النص والصورة والفيديو. - يستطيع
deepseek-v4.1-flash-1017المرور عبر Messages، لكن الجدول العام لا يُظهر CodexResponses؛ فإن كنت بحاجة إلى Responses فعليك النظر إلى المعرّف الآخرdeepseek-v4.1-flash. kimi-k3لا يوفر سوى Chat Completions، وقبل استخدام Codex CLI أو Claude Code عليك التأكد أولاً من قدرة harness على الاتصال ببروتوكول Chat.- النسخة الاقتصادية
deepseek-v4-1-flash-economy-261017سعرها: الإدخال $0.24، والإخراج $0.96، وقراءة الذاكرة المؤقتة $0.006، وهي تفتح chat فقط. ووفقًا للتحديثات اللحظية في APIYI، فإنها تحمّل نفس أوزان V4.1-Flash-1017 المستخدمة في النسخة القياسية، لكن التوليد أبطأ. ومن المهم التأكيد: لم يختبر FrontierHarness هذا المعرّف، لذا لا يمكن تطبيق نسب النجاح في لوحة الترتيب عليه. - لم يُطرح Muse Spark Open بعد، وسنطرح هذا النموذج في أقرب وقت؛ وتُعتمد الطُرز والأسعار على قائمة النماذج في المنصة.
💡 توصية للاختيار: ابدأ بتحديد الغلاف المرشح من العمود المقابل في التصنيف النهائي وفق النموذج، ثم استبعد بالبروتوكول التركيبات غير المتوافقة، وأخيرًا نفّذ تجربة صغيرة على نفس الدفعة من المهام. وعبر APIYI على apiyi.com يمكنك التبديل بين معرّفات مثل
glm-5.3وkimi-k3بمفتاح API واحد، ما يتيح فصل متغيّرَي «تغيير النموذج» و«تغيير الغلاف» واختبار كل منهما على حدة.
| هدفك | العمود الذي تبدأ به | مرشحات التصنيف النهائي |
|---|---|---|
| لم تحدد النموذج بعد وتريد غلافًا موثوقًا | الملخص الشامل | Codex CLI (الأرخص لكل نجاح)، ZCode (أعلى نسبة نجاح) |
| حددت النموذج وتريد خفض التكلفة | تكلفة كل نجاح للنموذج المعني | انظر عمود «الأرخص» في جدول النماذج الخمسة |
| حددت النموذج وتريد أعلى نسبة نجاح | نسبة نجاح النموذج المعني | انظر عمود «الأعلى» في جدول النماذج الخمسة |
| تريد ضغط الميزانية الإجمالية | متوسط تكلفة المهمة للنموذج | غيّر النموذج أولًا، ثم غيّر الغلاف |
الأسئلة الشائعة (FAQ)
س1: ما هو FrontierHarness، وكيف يجيب عن سؤال «أي harness هو الأفضل»؟
FrontierHarness هو تقييم لأدوات harness الخاصة بوكلاء البرمجة، أطلقته Runta. في الإصدار v1.1، خضع 21 harness للاختبار على 5 نماذج، بواقع 62 مهمة لكل منها و4 محاولات لكل مهمة، مع احتساب معدل النجاح والتكلفة في البيئة نفسها. والنتيجة ليست متصدرًا واحدًا، بل ترتيب منفصل لكل نموذج.
س2: من الأفضل فعلاً: Codex CLI أم ZCode؟
كلاهما في المركز الأول، لكن بمعيارين مختلفين. فبحسب التكلفة لكل محاولة ناجحة، يتصدر Codex CLI بقيمة $0.937؛ وبحسب معدل النجاح، يتصدر ZCode بنسبة 61.9%. ويعود القرار إليك: هل تعطي الأولوية للميزانية أم لمعدل النجاح؟
س3: هل يمكن الاعتماد على نسبة 66.7% في v1.0 وترتيب 11 نوفمبر؟
لا ينبغي اعتبارهما الترتيب النهائي. فـ v1.0 اختبر Kimi K3 و9 أدوات harness فقط، بما مجموعه 360 محاولة؛ أما ترتيب 11 نوفمبر فهو لقطة من منتصف تشغيل v1.1. وقد أظهر ترتيب البث المباشر بتاريخ 2026-11-15 أن 26,040 محاولة قد اكتملت، لذا ينبغي الاعتماد على الترتيب النهائي في ذلك الوقت.
س4: ما الذي يجب الانتباه إليه عند تشغيل GLM-5.3 باستخدام Claude Code؟
لا يسرد الترتيب النهائي خانة مستقلة لـ Claude Code مع GLM-5.3، لذا لا يمكن استنتاج نتيجته مباشرة. على مستوى البروتوكول، يدعم `glm-5.3` رسائل Messages، كما تتوفر على APIYI apiyi.com فئة ClaudeCode بمعامل 0.95×، أي أن شروط الوصول متوفرة.
س5: كيف أعيد إنتاج خانة معينة في بيئتي؟
يوفر FrontierHarness نقطة دخول للاختبار الذاتي، إذ يمكنك تشغيلها باستخدام مفتاح النموذج الخاص بك في البيئة نفسها. وعلى جانب المنصة، الخطوات هي: تأكد أولاً من أن معرّف النموذج يدعم البروتوكول الذي يحتاجه harness، ثم اضبط `base_url` الخاص بـ harness على `https://api.apiyi.com/v1`؛ ويمكن للمستخدمين الجدد استخدام حصة اختبار مجانية لتشغيل بعض المهام أولاً.
س6: ما قيود هذا الترتيب النهائي؟
تُحتسب المبالغ بالدولار في الترتيب بضرب السعر المعلن في عدد tokens المُبلّغ عنها، وهي تختلف عن فاتورة المنصة الفعلية؛ كما أن effort لجميع النماذج مضبوط على max، وقد تتغير النتائج عند استخدام مستوى آخر. إضافة إلى ذلك، تقع فروق بعض المراكز ضمن فاصل ثقة 95%، لذا لا ينبغي المبالغة في تفسير المراكز المتجاورة.
أيّ harness هو الأفضل: النقاط الرئيسية
- لا يوجد harness واحد يناسب الجميع: أرخص harness لكل نموذج من النماذج الخمسة يقع في أربعة harnessات مختلفة.
- صدارتان في القمة معًا: ZCode يحقق أعلى معدل نجاح بنسبة 61.9%، بينما Codex CLI هو الأرخص بتكلفة 0.937 دولار لكل نجاح.
- النموذج يؤثر في التكلفة أكثر من الـharness: متوسط تكلفة المهمة يختلف بين النماذج بنحو 6.1 مرة، أما بين الـharnessات فالفارق أقل من مرتين.
- الـharness الخاص لا يتفوق: من حيث تكلفة كل نجاح، لم تحقق أي من الفئات الأربع لـDeepSeek وKimiCode الأرخص على نماذجها الخاصة.
- أعلى خلية: ZCode + DeepSeek-V4.1-Flash-1017، بنسبة 69.0%، 171/248.
- قبل الربط، تحقق من البروتوكول: تأكد من أعمدة Chat وResponses وMessages الثلاثة في صفحة النماذج على APIYI قبل اختيار الـharness.
الخلاصة
الإجابة التي يقدمها التصنيف النهائي لـFrontierHarness v1.1 عن سؤال «أي harness هو الأفضل؟» هي: يعتمد على النموذج.
- الصدارة في مجالين: أعلى معدل نجاح لدى ZCode، وأقل تكلفة لكل نجاح لدى Codex CLI.
- عند تغيير النموذج، أعد النظر في الـharness: أرخص harness في الأعمدة الخمسة هو على التوالي: Codex CLI وPi وOpenCode وOh My Pi وOh My Pi.
- الميزانية تبدأ من النموذج: الفارق في متوسط تكلفة المهمة الناتج عن النموذج أكبر من الفارق الناتج عن تغيير الـharness.
عند الاختيار الفعلي، ابدأ بتحديد العمود الخاص بنموذجك في التصنيف النهائي، ثم تحقق من توافق البروتوكول. نوصي باستخدام APIYI عبر apiyi.com لتبديل معرّفات النماذج من خلال واجهة موحدة، وإجراء تجارب صغيرة على التوليفات المرشحة.
📚 المراجع
- لوحة FrontierHarness المباشرة: لوحة v1.1 النهائية وبيانات كل نموذج على حدة
- الرابط:
frontierharness.org/live/ -
الوصف: بتاريخ 2026-11-15 تعرض 26,040 scored، وهي مصدر جميع أرقام اللوحات في هذا المقال
-
مدخل الاختبار الذاتي في FrontierHarness: شغّله بمفتاحك الخاص في البيئة نفسها
- الرابط:
frontierharness.org/evaluate-your-own-harness/ -
الوصف: مناسب لإعادة إنتاج أي توليفة من harness × model
-
منشور الإطلاق من Guanlan Dai: إعداد الأسئلة وحجمها في v1.1
- الرابط:
x.com/guanlan/status/2120192585235046712 -
الوصف: يتضمن معلومات خلفية، مثل أن احتساب النتيجة النهائية يتطلب 248 محاولة، وكذلك الجهة الراعية للاستدلال
-
جدول نماذج APIYI الشامل: أسعار كل معرّف نموذج ونقاط النهاية والمجموعات
- الرابط:
docs.apiyi.com/models - الوصف: تاريخ بيانات الأسعار في هذا المقال هو 2026-11-15 09:36 (UTC+8)
المؤلف: فريق تقنية APIYI
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI لمناقشة اختيار توليفات harness والنماذج