作者注:本文只解读 FrontierHarness v1.1 全部 26,040 次运行结束后的终榜,按模型分列对比 21 个 harness,并对照 API易 上相关模型 ID 实际开放的协议与价格。
如果你已经在用 Codex CLI、Claude Code、OpenCode、Pi 这类编程 Agent,并且经常换底层模型,那么「哪个harness最好」这个问题,大概率没有一个统一答案。2026-11-10,Runta 的 Guanlan Dai 发起 FrontierHarness v1.1,直接抛出的问题就是:when you switch models, should you switch harnesses too? 截至 2026-11-15,直播榜显示 running 0、scored 26,040,21 个 harness × 5 个模型 × 62 个任务 × 4 次尝试已全部跑完。
这不是一份「某只壳全面第一」的榜单解读。终榜上通过率第一和每次通过最便宜不是同一只,五个模型各自最便宜的壳也不是同一只,本文会把这些结论按模型拆开,一格一格讲清楚。
核心价值:读完本文,你会拿到一张按模型分开的 FrontierHarness 终榜对比,知道换模型时该看哪一列、哪些旧数字不能再用,以及在接入前要核对哪条协议。
FrontierHarness 终榜口径:判断哪个harness最好之前先看规则
FrontierHarness 的所有运行都在 Runta runtime 里执行,并且使用同一套资源限制。每个 harness × model 组合要跑满 248 次才算最终结果,所以直播过程中的名次会随着新结果不断变化。下面这张表整理了 v1.1 终榜的计分口径,后面所有对比都以它为准。
| 口径项 | v1.1 终榜设定 | 对比时的意义 |
|---|---|---|
| 数据集 | [email protected],62 个任务 |
所有壳做同一套题 |
| 规模 | 21 个 harness,每题 4 次,每组合 248 次,每个模型 5,208 次,总计 26,040 次 | 每一格分母一致,可以横向比较 |
| 运行环境 | 1–4 vCPU、2–8 GB 内存、32 GB 磁盘,单题超时 15 分钟到 8 小时 | 排除机器差异 |
| 推理设置 | 推理提供方 Baseten,五个模型 effort 都是 max | 模型侧变量统一 |
| 通过率 | 通过数 ÷ 计入成绩的尝试;超时和 reward hacking 算失败,基础设施错误不计入 | 偷看答案不得分 |
| 花费 | 目录价 × 上报 token | 是榜单算法,不是任何平台的账单 |
| 置信度 | 按任务做 95% bootstrap | 相差很小的名次要谨慎解读 |
有几组数字经常被转发,但它们都不是 v1.1 终榜。v1.0 只在 Kimi K3 一个模型上测了 9 个 harness、12 种配置、360 次,其中 Codex 的 66.7% 通过率和 $3.47 的任务中位花费都属于 v1.0。2026-11-11 的中途快照里,每次通过花费在 $0.57 到 $1.32 之间、通过率在 56.2% 到 77.6% 之间,这同样只是过半时的状态。同一天有人写「GLM-5.3 最好是 KimiCode、Kimi-K3 最好是 Codex」,按终榜的每次通过花费重排之后,这些说法都不再成立。
哪个harness最好:FrontierHarness 全场终榜对比
下表把 21 个 harness 在五个模型上的成绩汇总在一起,按「每次通过花费」从低到高排列。所有美元数字都是 FrontierHarness 终榜按目录价乘以上报 token 算出来的。
| 排名 | harness | 每次通过花费 | 平均每次任务花费 | 通过率 |
|---|---|---|---|---|
| 1 | Codex CLI | $0.937 | $0.573 | 61.1% |
| 2 | Pi | $0.976 | $0.563 | 57.7% |
| 3 | Oh My Pi | $0.983 | $0.564 | 57.3% |
| 4 | ZCode | $1.06 | $0.659 | 61.9% |
| 5 | KimiCode | $1.09 | $0.653 | 60.2% |
| 6 | OpenCode | $1.12 | $0.646 | 57.4% |
| 7 | Maka | $1.13 | $0.654 | 57.7% |
| 8 | MiniMax Code | $1.14 | $0.647 | 56.8% |
| 9 | DeepSeek Harness: Minimal | $1.15 | $0.661 | 57.4% |
| 10 | Hermes Agent | $1.16 | $0.692 | 59.9% |
| 11 | Cline CLI | $1.19 | $0.689 | 57.7% |
| 12 | Grok Build | $1.20 | $0.723 | 60.0% |
| 13 | Alma | $1.22 | $0.731 | 59.7% |
| 14 | DeepSeek Harness: Standard | $1.27 | $0.697 | 55.0% |
| 15 | DeepSeek Harness: Creator | $1.27 | $0.713 | 56.1% |
| 16 | mini-SWE-agent | $1.29 | $0.757 | 58.6% |
| 17 | DeepSeek Harness: Code | $1.32 | $0.732 | 55.2% |
| 18 | Exo | $1.36 | $0.691 | 50.6% |
| 19 | GitHub Copilot CLI | $1.38 | $0.787 | 56.9% |
| 20 | Claude Code | $1.55 | $0.915 | 58.9% |
| 21 | Antigravity CLI | $1.63 | $0.897 | 55.0% |
全场终榜的两个第一
全场通过率第一是 ZCode(61.9%),每次通过最便宜的是 Codex CLI($0.937),这两句必须同时看。Codex CLI 的通过率 61.1%,只比 ZCode 低 0.8 个百分点,但每次通过便宜约 $0.12;ZCode 则是在「更想多过题」时更稳的选择。最贵的 Antigravity CLI 每次通过 $1.63,约为 Codex CLI 的 1.74 倍。全场通过率落在 Exo 的 50.6% 到 ZCode 的 61.9% 之间,相差 11.3 个百分点。
有两处容易误读。第一,四个 DeepSeek Harness 是同一版本 0.2.1-rc.3 的四种配置(Minimal、Standard、Creator、Code),而不是四个独立产品。第二,Alma 按每次通过花费排第 13,按通过率排第 6,排在 ZCode、Codex CLI、KimiCode、Grok Build、Hermes Agent 之后。11 月 11 日快照里 Alma 排第 3、72.7% 的说法属于中途数据,以终榜的 59.7% 为准。
换模型后哪个harness最好:FrontierHarness 五模型分列
全场汇总只能告诉你平均水平,真正决定账单的是你手上那个模型那一列。下表中的「最便宜」一律指该模型页上每次通过花费最低的 harness,通过数的分母都是 248。
| 模型 | 平均每次任务花费(对壳取平均) | 每次通过最便宜 | 通过率最高 | 同模型最贵 |
|---|---|---|---|---|
| GLM-5.3 | $0.968 | Codex CLI $0.803,57.7% | ZCode 58.9%,$1.48 | Exo $2.72,50.0% |
| GLM-5.3-Flash | $0.193 | Pi $0.223,58.1% | Hermes Agent 60.9%,$0.328 | DeepSeek Harness: Minimal $0.484,55.2% |
| DeepSeek-V4.1-Flash-1017 | $0.185 | OpenCode $0.177,61.3% | ZCode 69.0%,$0.222 | Cline CLI $0.860,63.3% |
| Muse Spark Open | $1.01 | Oh My Pi $1.21,58.9% | Grok Build 59.7%,$1.77 | Claude Code $3.75,52.8% |
| Kimi-K3 | $1.12 | Oh My Pi $1.45,57.7% | mini-SWE-agent 64.9%,$2.02 | Antigravity CLI $2.73,56.9% |
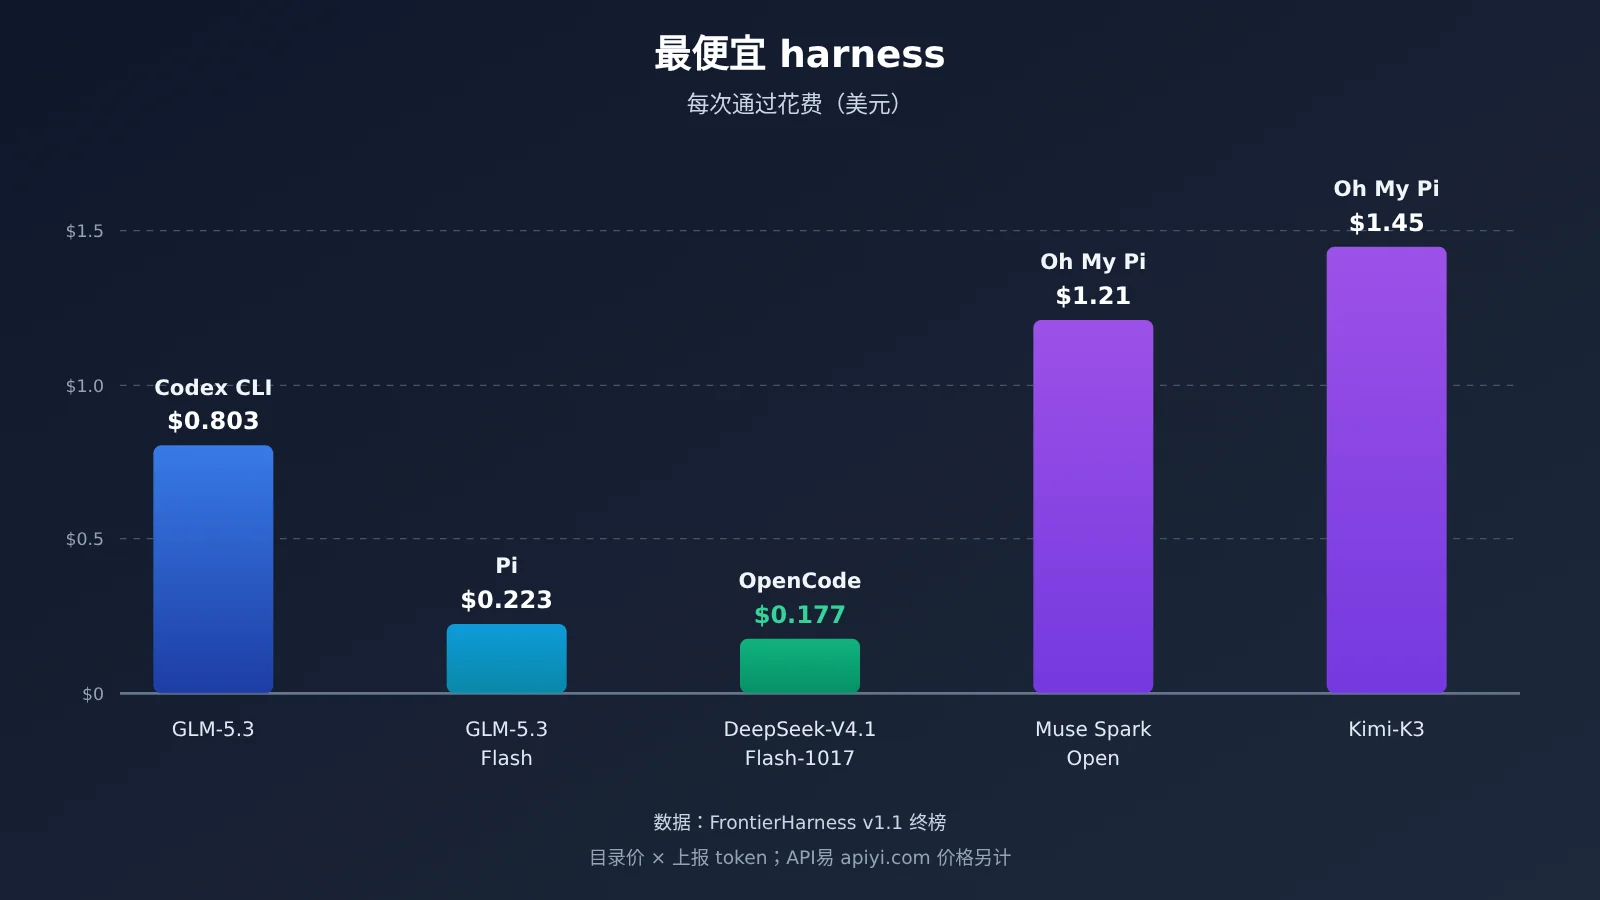
结论一:五个模型的最便宜 harness 不是同一只
五列的最便宜壳分别是 Codex CLI、Pi、OpenCode、Oh My Pi、Oh My Pi,四只不同的壳。全场第一的 Codex CLI 只在 GLM-5.3 这一列拿到最便宜,在 GLM-5.3-Flash 上以 $0.226 仅比 Pi 贵一点。所以换模型时要重新看 harness,不能直接沿用旧组合。
结论二:换模型的花费差距大于换壳
按模型看平均每次任务花费,从 DeepSeek-V4.1-Flash-1017 的 $0.185 到 Kimi-K3 的 $1.12,约为 6.1 倍。按 harness 看全场平均每次任务花费,最低是 Pi 的 $0.563,最高是 Claude Code 的 $0.915,差距不到 2 倍。也就是说,在 FrontierHarness 终榜上,先选模型对任务花费的影响,比先选壳更大。
结论三:自家壳没有在自家模型上拿下最便宜
在 DeepSeek-V4.1-Flash-1017 这一列,按每次通过花费,DeepSeek Harness 四档分别是 Code $0.243 / 64.1%、Minimal $0.256 / 63.7%、Creator $0.273 / 64.9%、Standard $0.292 / 62.1%,既没拿到最便宜(OpenCode $0.177),也没拿到最高通过率(ZCode 69.0%,171/248,这也是全场所有组合里通过率最高的一格)。Claude Code 在这一格 68.1%,Codex CLI 是 $0.237 / 67.3%。同列最贵的 Cline CLI 每试用掉 6.77M tokens,每次通过 $0.860,约为 OpenCode 的 4.9 倍,这个倍数只针对这一对。
Kimi-K3 这一列也一样:按每次通过花费,自家壳 KimiCode 是 $1.84 / 60.1%,不如 Oh My Pi 的 $1.45,通过率也低于 mini-SWE-agent 的 64.9%、Alma 和 ZCode 的 64.1%。全场通过率最低的一格同样出在这里:Exo + Kimi-K3,43.5%,108/248。
场景推荐:按模型选哪个harness最好
把上面的分列结论落到实际选择上,可以按「你用哪个模型 + 你更在意花费还是通过率」来拆。
用 GLM-5.3 时
- 在意每次通过花费:Codex CLI,$0.803,57.7%,每试约 1.86M tokens。
- 在意通过率:ZCode,58.9%,但每次通过 $1.48,接近 Codex CLI 的两倍。
- 需要注意:KimiCode 在这一列是 $1.55 / 58.1%,此前的中途说法已经不成立。
用 GLM-5.3-Flash 时
- 在意花费:Pi($0.223)和 Codex CLI($0.226)几乎打平,后者通过率 59.3% 还略高。
- 在意通过率:Hermes Agent 60.9%,每次通过 $0.328;ZCode 60.1%、$0.264 是折中选项。
用 DeepSeek-V4.1-Flash-1017 时
- 在意花费:OpenCode,$0.177,61.3%。
- 在意通过率:ZCode,69.0%,每次通过 $0.222,只比最便宜的贵约 $0.045。这一列里,追求通过率的成本很低。
用 Muse Spark Open 或 Kimi-K3 时
- Muse Spark Open:Oh My Pi 最便宜($1.21);Grok Build 通过率最高(59.7%);Claude Code 每试 9.79M tokens,每次通过 $3.75,是这一列最贵的一格。
- Kimi-K3:Oh My Pi 最便宜($1.45,每试 942k tokens);mini-SWE-agent 通过率最高(64.9%);Codex CLI $1.78 / 63.7%,两头都不吃亏。
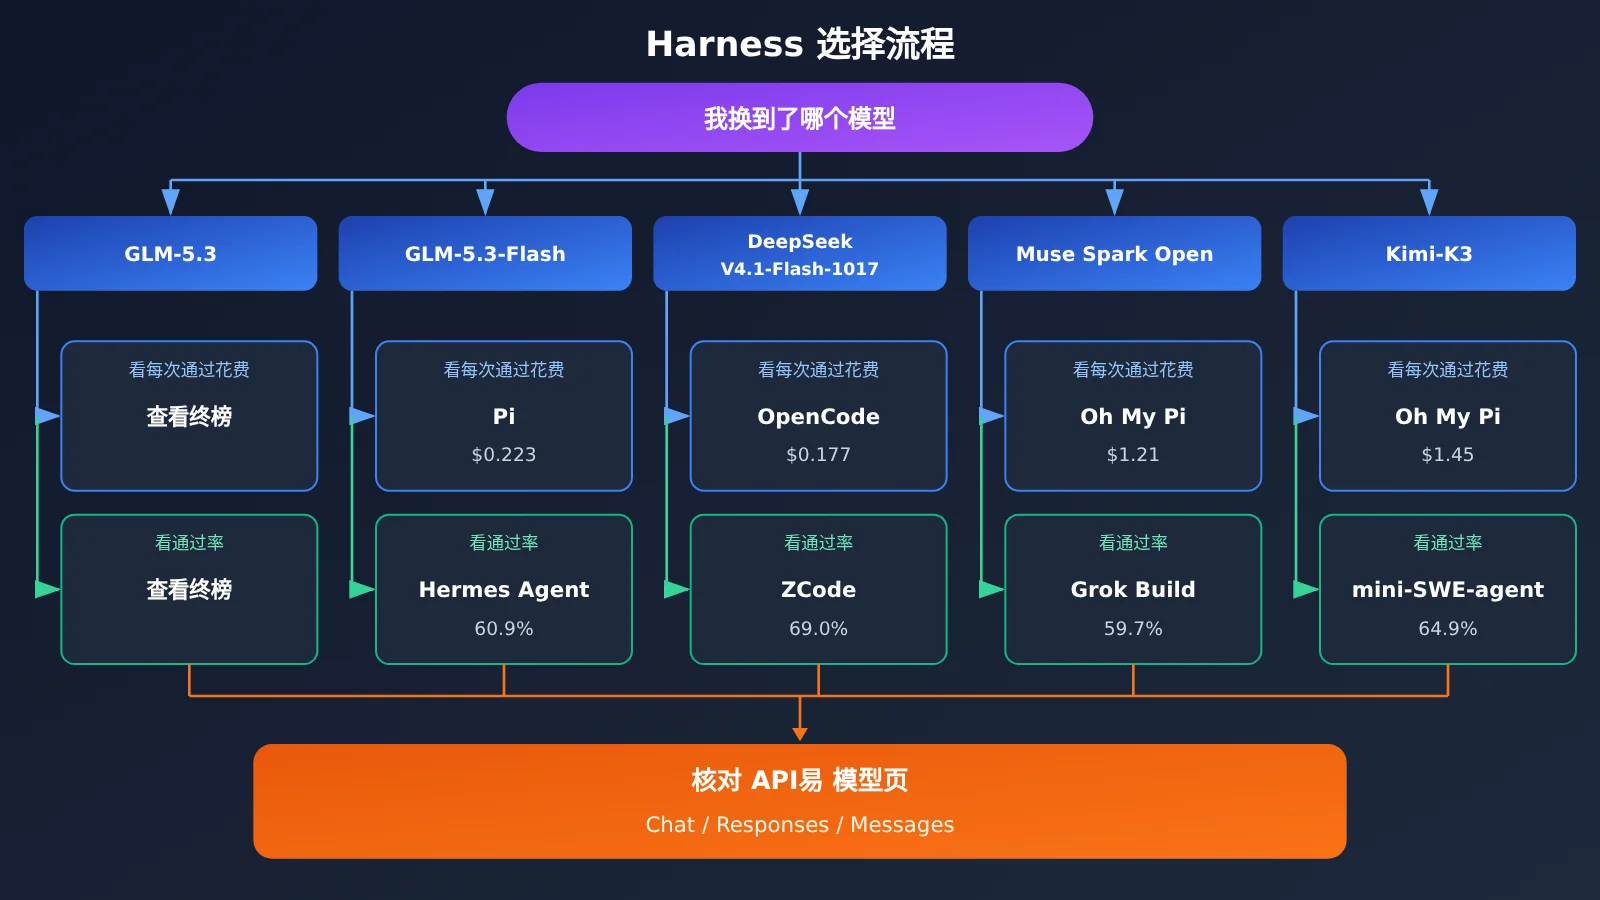
决策建议:harness 协议与 API易 模型 ID 对照
榜单上的 harness 和平台端点并不是一一对应的。Codex CLI 成绩好,不代表你手上的模型 ID 开放了 Responses;Claude Code 同理,要先看 Messages 那一列。每个 harness 跑任务都要消耗 token,换壳或换模型都会直接改变账单,所以在试某一格之前,建议先到 API易 apiyi.com 的模型页核对这个 ID 开放的是 Chat、Responses 还是 Messages,再把 harness 的 base_url 指到 https://api.apiyi.com/v1。
下表是 API易 文档在 2026-11-15 的默认标价(美元 / 1M tokens),与上面的榜单目录价是两套数字,不能混算。
| 模型 ID | 输入 | 缓存读 | 输出 | Chat | Responses | Messages | 分组 |
|---|---|---|---|---|---|---|---|
glm-5.3 |
$1.4 | $0.259 | $4.396 | 支持 | 不支持 | 支持 | ClaudeCode 0.95×、Default、SVIP |
glm-5.3-flash |
$0.15 | $0.03 | $0.5 | 支持 | 模型页:不支持 | 模型页:不支持 | CodexResponses、Default、SVIP |
deepseek-v4.1-flash-1017 |
$0.3 | $0.006 | $1.2 | 支持 | 总表无 | 支持 | ClaudeCode、Default、SVIP |
deepseek-v4.1-flash |
$0.3 | $0.006 | $1.2 | 支持 | 见分组 | 支持 | 多一个 CodexResponses |
kimi-k3 |
$3 | $0.3 | $15 | 支持 | 不支持 | 不支持 | Default、SVIP |
| Muse Spark Open | 暂未上架 | — | — | — | — | — | — |
几处需要逐条说明的地方:
glm-5.3可以走 Messages,并且有 ClaudeCode 分组 0.95×,适合配合 Claude Code 一类壳使用;这个 0.95× 只属于glm-5.3。它不能走 Responses。glm-5.3-flash的总表和模型页有两处不一致,两种说法都保留:分组里列了 CodexResponses,但模型页写 Responses 和 Messages 都不支持;总表类型列写的是「文本」,模型页写输入包含文本、图像、视频。deepseek-v4.1-flash-1017能走 Messages,但总表看不出 CodexResponses;需要 Responses 要看另一条deepseek-v4.1-flash。kimi-k3只有 Chat Completions,用 Codex CLI 或 Claude Code 前需要先确认 harness 能否接 Chat 协议。- 经济版
deepseek-v4-1-flash-economy-261017的价格是输入 $0.24、输出 $0.96、缓存读 $0.006,只开放 chat。按 API易 实时动态,它与标准版加载同一份 V4.1-Flash-1017 权重,生成更慢。需要强调:FrontierHarness 没有测过这个 ID,榜上的通过率不能套用到它身上。 - Muse Spark Open 暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。
💡 选择建议:先按模型挑出终榜上那一列的候选壳,再按协议筛掉接不上的组合,最后用同一批任务做小规模试跑。通过 API易 apiyi.com 用一个 Key 切换
glm-5.3、kimi-k3等 ID,可以把「换模型」和「换壳」两个变量分开测试。
| 你的目标 | 先看哪一列 | 终榜候选 |
|---|---|---|
| 不确定模型,只想要稳妥的壳 | 全场汇总 | Codex CLI(每次通过最便宜)、ZCode(通过率最高) |
| 已定模型,压低花费 | 对应模型的每次通过花费 | 见五模型分列表的「最便宜」列 |
| 已定模型,追求通过率 | 对应模型的通过率 | 见五模型分列表的「最高」列 |
| 想压缩总预算 | 模型平均每次任务花费 | 先换模型,再换壳 |
常见问题 FAQ
Q1:FrontierHarness 是什么,它怎么回答“哪个harness最好”?
FrontierHarness 是由 Runta 发起的编程 Agent harness 评测。v1.1 让 21 个 harness 在 5 个模型上各跑 62 个任务、每题 4 次,并在同一环境下统计通过率和花费。它给出的不是单一冠军,而是每个模型各自的一列名次。
Q2:Codex CLI 和 ZCode 到底谁是第一?
两者都是第一,但口径不同。按每次通过花费,Codex CLI 以 $0.937 排第一;按通过率,ZCode 以 61.9% 排第一。看你优先考虑预算还是成功率。
Q3:v1.0 的 66.7% 和 11 月 11 日的排名还能参考吗?
不能当作终榜。v1.0 只测了 Kimi K3 和 9 个 harness,共 360 次;11 月 11 日是 v1.1 跑到一半时的快照。2026-11-15 直播榜显示已打完 26,040 次,应以这时的终榜为准。
Q4:用 Claude Code 跑 GLM-5.3 时要注意什么?
终榜没有单独列出 Claude Code 在 GLM-5.3 上的这一格,因此不能直接推断它的成绩。在协议层面,`glm-5.3` 支持 Messages,在 API易 apiyi.com 上还有 ClaudeCode 分组 0.95×,接入条件是具备的。
Q5:怎么在自己的环境里复现某一格?
FrontierHarness 提供自测入口,可以用自己的模型 Key 在同一环境中运行。平台侧的做法是:先确认模型 ID 开放了 harness 需要的协议,再把 harness 的 base_url 设为 `https://api.apiyi.com/v1`,新用户可以用免费测试额度先跑几题。
Q6:这份终榜有哪些局限?
榜上的美元按目录价乘以上报 token 计算,与实际平台账单不同;所有模型的 effort 都设为 max,换成其他档位后结果可能变化。另外,部分名次之间的差距落在 95% 置信区间内,相邻名次不宜过度解读。
哪个harness最好 Key Takeaways
- 没有通吃的壳:五个模型的最便宜 harness 分属四只不同的壳。
- 两个第一并存:ZCode 通过率 61.9% 最高,Codex CLI 每次通过 $0.937 最便宜。
- 模型比壳更影响花费:模型间平均任务花费差约 6.1 倍,壳之间不到 2 倍。
- 自家壳不占优:按每次通过花费,DeepSeek 四档和 KimiCode 都没在自家模型上拿下最便宜。
- 最高一格:ZCode + DeepSeek-V4.1-Flash-1017,69.0%,171/248。
- 接入先看协议:在 API易 模型页确认 Chat、Responses、Messages 三列后再选壳。
总结
FrontierHarness v1.1 终榜对「哪个harness最好」的回答是:要按模型来看。
- 全场两个第一:通过率看 ZCode,每次通过花费看 Codex CLI。
- 换模型就要重看壳:五列的最便宜壳分别是 Codex CLI、Pi、OpenCode、Oh My Pi、Oh My Pi。
- 预算先看模型:模型带来的平均任务花费差距,大于换壳带来的差距。
实际选择时,可以先在终榜上找到你所用模型那一列,再核对协议是否接得上。推荐通过 API易 apiyi.com 用统一接口切换模型 ID,对候选组合做小规模试跑。
📚 参考资料
- FrontierHarness 直播榜:v1.1 终榜与各模型分列数据
- 链接:
frontierharness.org/live/ -
说明: 2026-11-15 显示 scored 26,040,是本文所有榜单数字的来源
-
FrontierHarness 自测入口:用自己的 Key 在同一环境运行
- 链接:
frontierharness.org/evaluate-your-own-harness/ -
说明: 适合复现某个 harness × model 组合
-
Guanlan Dai 发布帖:v1.1 的问题设定与规模说明
- 链接:
x.com/guanlan/status/2120192585235046712 -
说明: 包含 248 次才算最终、推理赞助方等背景信息
-
API易 模型总表:各模型 ID 的价格、端点与分组
- 链接:
docs.apiyi.com/models - 说明: 本文价格的数据时间为 2026-11-15 09:36(UTC+8)
作者:APIYI 技术团队
技术交流:欢迎通过 API易 官网首页联系我们,讨论 harness 与模型的组合选型