Hinweis des Autors: Dieser Beitrag interpretiert ausschließlich die finale Rangliste nach Abschluss aller 26,040 Läufe von FrontierHarness v1.1, vergleicht 21 Harnesses nach Modellen getrennt und gleicht sie mit den auf APIYI tatsächlich angebotenen Protokollen und Preisen der relevanten Modell-IDs ab.
Wenn du bereits Coding-Agenten wie Codex CLI, Claude Code, OpenCode oder Pi verwendest und häufig das zugrunde liegende Modell wechselst, dann gibt es auf die Frage „Welches Harness ist das beste?“ wahrscheinlich keine einheitliche Antwort. Am 2026-11-10 startete Guanlan Dai von Runta FrontierHarness v1.1 und warf direkt die Frage auf: Wenn du Modelle wechselst, solltest du dann auch das Harness wechseln? Stand 2026-11-15 zeigt die Live-Rangliste running 0, scored 26,040; 21 Harnesses × 5 Modelle × 62 Aufgaben × 4 Versuche sind vollständig durchgelaufen.
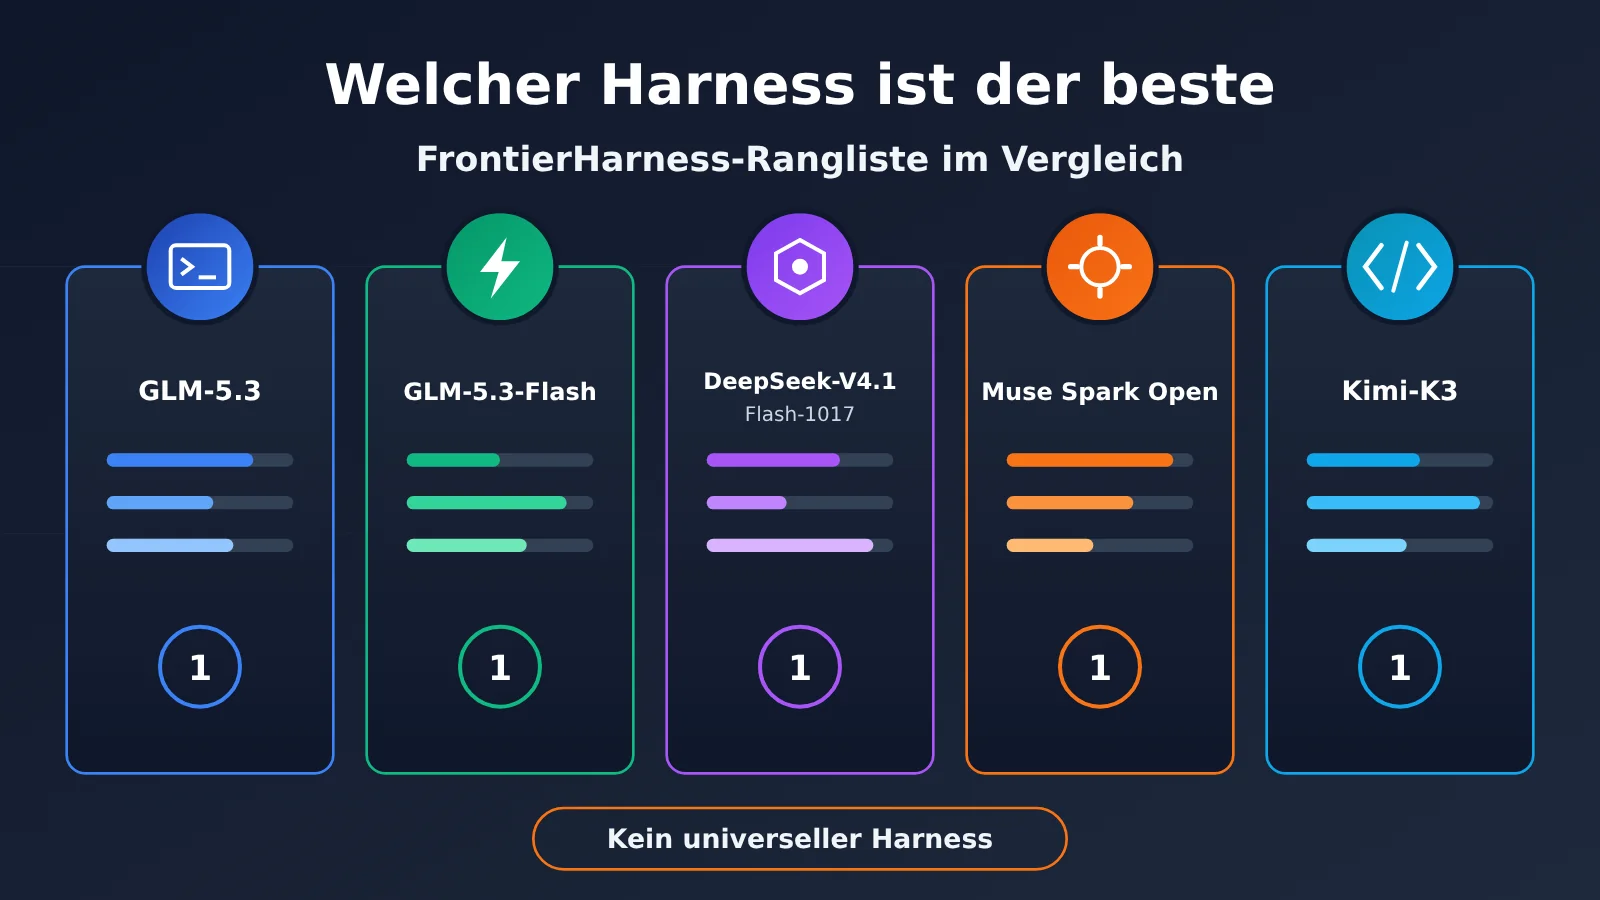
Dies ist keine Auswertung einer Rangliste, bei der ein bestimmtes Harness überall auf Platz eins liegt. Auf der finalen Rangliste sind das Harness mit der höchsten Bestehensquote und das mit den niedrigsten Kosten pro bestandenem Versuch nicht dasselbe, und auch das jeweils günstigste Harness der fünf Modelle ist nicht bei allen Modellen dasselbe. Dieser Artikel zerlegt diese Ergebnisse nach Modellen und erklärt sie Zelle für Zelle.
Das Wichtigste: Nach dem Lesen dieses Artikels hast du einen nach Modellen aufgeteilten Vergleich der finalen FrontierHarness-Rangliste, weißt, welche Spalte du beim Modellwechsel beachten musst, welche alten Zahlen nicht mehr gelten und welches Protokoll du vor der Anbindung prüfen musst.
Die Endstand-Kriterien von FrontierHarness: Bevor man entscheidet, welcher Harness der beste ist, sollte man zuerst die Regeln lesen
Alle Läufe von FrontierHarness werden in der Runta-Runtime ausgeführt und unterliegen denselben Ressourcenlimits. Jede Harness-Modell-Kombination muss volle 248 Läufe absolvieren, bevor sie als endgültiges Ergebnis zählt – deshalb ändern sich die Platzierungen während der Live-Übertragung laufend, sobald neue Ergebnisse eintreffen. Die folgende Tabelle fasst die Bewertungskriterien des v1.1-Endstands zusammen; alle späteren Vergleiche richten sich danach.
| Kriterium | Einstellung im v1.1-Endstand | Bedeutung für den Vergleich |
|---|---|---|
| Datensatz | [email protected], 62 Aufgaben |
Alle Shells bearbeiten denselben Aufgabensatz |
| Umfang | 21 Harnesses, 4 Läufe pro Aufgabe, 248 pro Kombination, 5.208 pro Modell, insgesamt 26.040 | Gleicher Nenner pro Zelle, horizontal vergleichbar |
| Laufzeitumgebung | 1–4 vCPU, 2–8 GB Arbeitsspeicher, 32 GB Festplatte, Timeout pro Aufgabe 15 Minuten bis 8 Stunden | Maschinenunterschiede ausgeschlossen |
| Inferenz-Einstellungen | Inferenzanbieter Baseten, bei allen fünf Modellen ist der Effort auf max gesetzt | Modellseitige Variablen vereinheitlicht |
| Bestehensquote | bestandene Läufe ÷ gewertete Versuche; Timeouts und Reward Hacking zählen als Fehlschlag, Infrastrukturfehler werden nicht gewertet | Wer spickt, bekommt keine Punkte |
| Kosten | Katalogpreis × gemeldete Tokens | Das ist der Leaderboard-Algorithmus, nicht die Rechnung irgendeiner Plattform |
| Konfidenz | 95 % Bootstrap pro Aufgabe | Bei sehr kleinen Abständen vorsichtig interpretieren |
Einige Zahlen werden häufig weitergeteilt, aber sie stammen nicht aus dem v1.1-Endstand. v1.0 wurde nur mit einem einzigen Modell getestet – Kimi K3 –, und zwar mit 9 Harnesses, 12 Konfigurationen und 360 Läufen. Die 66,7 % Bestehensquote von Codex und die medianen Kosten von 3,47 $ pro Aufgabe gehören zu v1.0. Der Zwischenstand vom 11.11.2026 zeigt Kosten zwischen 0,57 $ und 1,32 $ pro bestandener Aufgabe und eine Bestehensquote zwischen 56,2 % und 77,6 % – auch das war nur der Stand zur Halbzeit. Am selben Tag schrieb jemand „Bei GLM-5.3 ist KimiCode am besten, bei Kimi-K3 ist Codex am besten“ – ordnet man nach den Kosten pro bestandener Aufgabe im Endstand neu, gilt keine dieser Aussagen mehr.
Welches Harness ist das beste: FrontierHarness im Vergleich der finalen Gesamtrangliste
Die folgende Tabelle fasst die Ergebnisse von 21 Harnesses auf fünf Modellen zusammen und sortiert sie nach den Kosten pro bestandener Aufgabe – von niedrig zu hoch. Alle Dollarbeträge stammen aus der finalen FrontierHarness-Rangliste und wurden auf Basis der Listenpreise und der gemeldeten Tokenmengen berechnet.
| Platz | Harness | Kosten pro bestandener Aufgabe | Durchschnittliche Kosten pro Aufgabe | Erfolgsquote |
|---|---|---|---|---|
| 1 | Codex CLI | $0,937 | $0,573 | 61,1 % |
| 2 | Pi | $0,976 | $0,563 | 57,7 % |
| 3 | Oh My Pi | $0,983 | $0,564 | 57,3 % |
| 4 | ZCode | $1,06 | $0,659 | 61,9 % |
| 5 | KimiCode | $1,09 | $0,653 | 60,2 % |
| 6 | OpenCode | $1,12 | $0,646 | 57,4 % |
| 7 | Maka | $1,13 | $0,654 | 57,7 % |
| 8 | MiniMax Code | $1,14 | $0,647 | 56,8 % |
| 9 | DeepSeek Harness: Minimal | $1,15 | $0,661 | 57,4 % |
| 10 | Hermes Agent | $1,16 | $0,692 | 59,9 % |
| 11 | Cline CLI | $1,19 | $0,689 | 57,7 % |
| 12 | Grok Build | $1,20 | $0,723 | 60,0 % |
| 13 | Alma | $1,22 | $0,731 | 59,7 % |
| 14 | DeepSeek Harness: Standard | $1,27 | $0,697 | 55,0 % |
| 15 | DeepSeek Harness: Creator | $1,27 | $0,713 | 56,1 % |
| 16 | mini-SWE-agent | $1,29 | $0,757 | 58,6 % |
| 17 | DeepSeek Harness: Code | $1,32 | $0,732 | 55,2 % |
| 18 | Exo | $1,36 | $0,691 | 50,6 % |
| 19 | GitHub Copilot CLI | $1,38 | $0,787 | 56,9 % |
| 20 | Claude Code | $1,55 | $0,915 | 58,9 % |
| 21 | Antigravity CLI | $1,63 | $0,897 | 55,0 % |
Die beiden Bestwerte der finalen Gesamtrangliste
In der finalen Gesamtrangliste gilt: Bei der Erfolgsquote liegt ZCode mit 61,9 % auf Platz 1, und bei den Kosten pro bestandener Aufgabe ist Codex CLI mit $0,937 am günstigsten. Diese beiden Aussagen muss man zusammen betrachten. Codex CLI kommt auf eine Erfolgsquote von 61,1 % und liegt damit nur 0,8 Prozentpunkte unter ZCode, ist aber pro bestandener Aufgabe rund $0,12 günstiger; ZCode ist dagegen die verlässlichere Wahl, wenn möglichst viele Aufgaben bestanden werden sollen. Das teuerste Harness, Antigravity CLI, kostet $1,63 pro bestandener Aufgabe und damit etwa das 1,74-Fache von Codex CLI. Die Erfolgsquoten in der finalen Gesamtrangliste reichen von 50,6 % bei Exo bis 61,9 % bei ZCode – eine Spanne von 11,3 Prozentpunkten.
Zwei Punkte werden leicht missverstanden. Zum einen sind die vier DeepSeek Harness keine vier eigenständigen Produkte, sondern vier Konfigurationen derselben Version 0.2.1-rc.3 (Minimal, Standard, Creator und Code). Zum anderen liegt Alma bei den Kosten pro bestandener Aufgabe auf Platz 13, bei der Erfolgsquote auf Platz 6 – hinter ZCode, Codex CLI, KimiCode, Grok Build und Hermes Agent. Die Angabe, Alma habe im Snapshot vom 11. November mit 72,7 % auf Platz 3 gelegen, stammt aus Zwischenstandsdaten. Maßgeblich ist der Wert der finalen Rangliste von 59,7 %.
Welcher Harness nach dem Modellwechsel am besten ist: FrontierHarness mit fünf Modellen in separaten Spalten
Eine Gesamtübersicht zeigt nur den Durchschnitt. Was am Ende wirklich die Rechnung bestimmt, ist die Spalte des Modells, das du tatsächlich einsetzt. Wenn in der folgenden Tabelle von „günstigstem“ die Rede ist, ist immer der Harness gemeint, der auf der Seite dieses Modells die niedrigsten Kosten pro bestandenem Durchlauf hat; der Nenner für die Anzahl der bestandenen Durchläufe ist stets 248.
| Modell | Durchschnittliche Kosten pro Aufgabe (über Harnesses gemittelt) | Günstigster pro bestandenem Durchlauf | Höchste Bestehensrate | Teuerster Harness beim selben Modell |
|---|---|---|---|---|
| GLM-5.3 | $0.968 | Codex CLI $0.803, 57.7% | ZCode 58.9%, $1.48 | Exo $2.72, 50.0% |
| GLM-5.3-Flash | $0.193 | Pi $0.223, 58.1% | Hermes Agent 60.9%, $0.328 | DeepSeek Harness: Minimal $0.484, 55.2% |
| DeepSeek-V4.1-Flash-1017 | $0.185 | OpenCode $0.177, 61.3% | ZCode 69.0%, $0.222 | Cline CLI $0.860, 63.3% |
| Muse Spark Open | $1.01 | Oh My Pi $1.21, 58.9% | Grok Build 59.7%, $1.77 | Claude Code $3.75, 52.8% |
| Kimi-K3 | $1.12 | Oh My Pi $1.45, 57.7% | mini-SWE-agent 64.9%, $2.02 | Antigravity CLI $2.73, 56.9% |
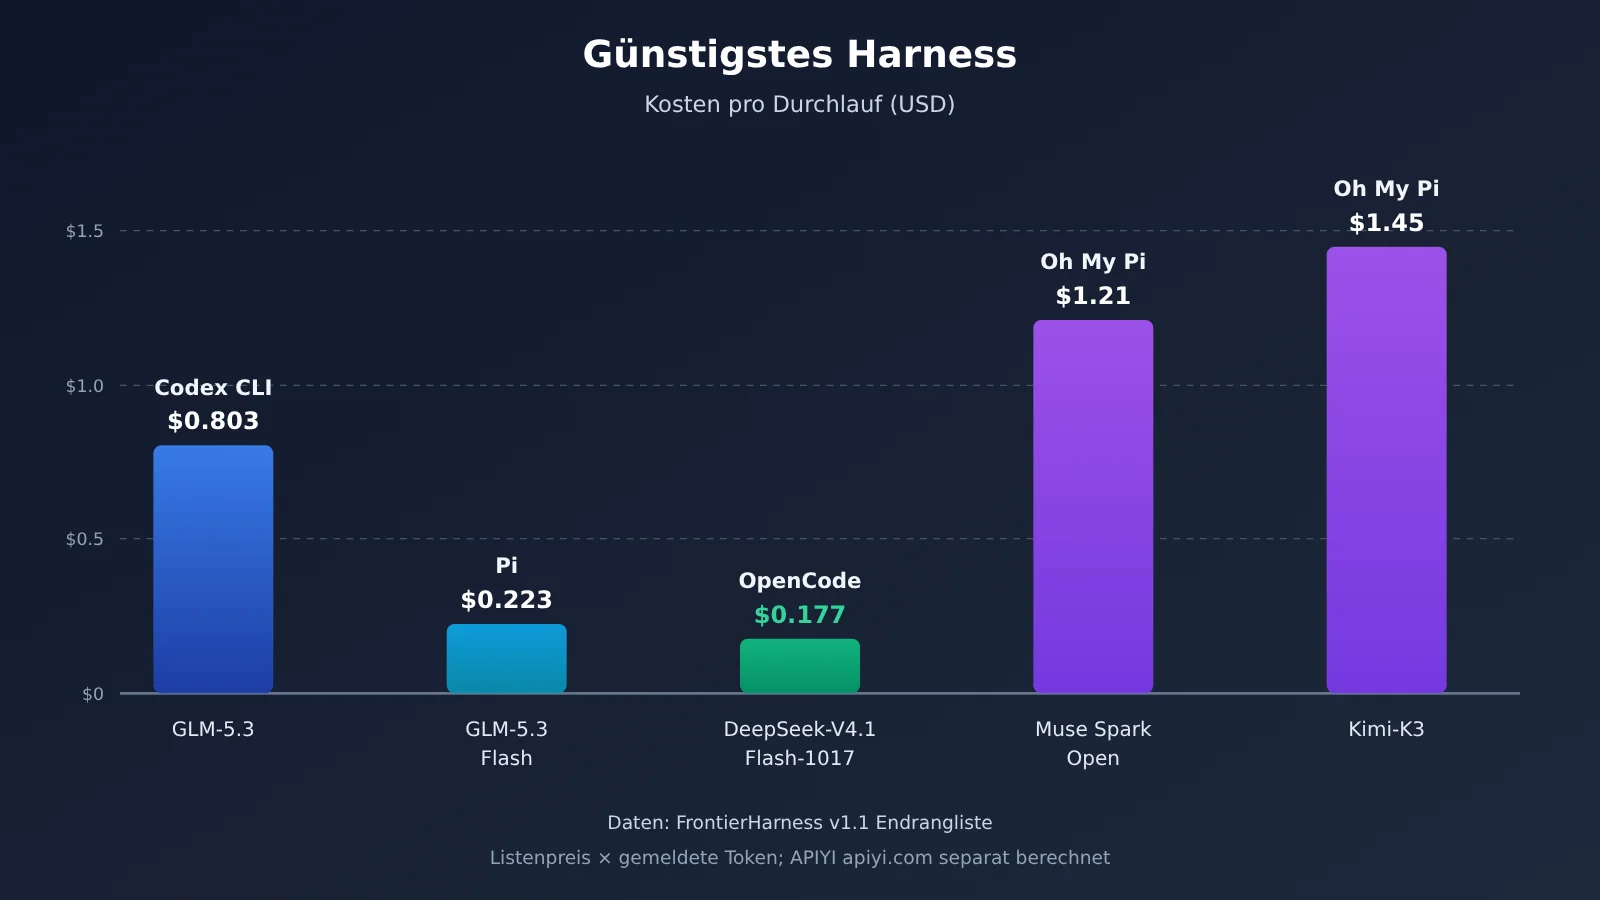
Erkenntnis 1: Bei den fünf Modellen ist das günstigste Harness nicht dasselbe
Die günstigsten Wrapper in den fünf Spalten sind Codex CLI, Pi, OpenCode, Oh My Pi und Oh My Pi – also vier verschiedene Wrapper. Der Gesamtsieger Codex CLI liegt nur in der Spalte GLM-5.3 vorne; bei GLM-5.3-Flash ist er mit $0.226 nur unwesentlich teurer als Pi. Wer das Modell wechselt, muss sich das Harness also neu ansehen und kann nicht einfach die alte Kombination weiterverwenden.
Erkenntnis 2: Der Kostenunterschied zwischen Modellen ist größer als der zwischen den Wrappern
Betrachtet man die durchschnittlichen Kosten pro Aufgabe nach Modell, reichen sie von $0.185 bei DeepSeek-V4.1-Flash-1017 bis zu $1.12 bei Kimi-K3 – rund das 6,1-Fache. Nach Harness betrachtet liegt der Gesamtdurchschnitt pro Aufgabe bei Pi mit $0.563 am niedrigsten und bei Claude Code mit $0.915 am höchsten – weniger als das Zweifache. Auf der finalen FrontierHarness-Rangliste hat also die Wahl des Modells einen größeren Einfluss auf die Kosten pro Aufgabe als die Wahl des Wrappers.
Schlussfolgerung 3: Der eigene Harness war beim eigenen Modell nicht der günstigste
In der Spalte DeepSeek-V4.1-Flash-1017 liegen die vier Stufen des DeepSeek Harness bei den Kosten pro bestandenem Versuch bei Code $0.243 / 64,1 %, Minimal $0.256 / 63,7 %, Creator $0.273 / 64,9 %, Standard $0.292 / 62,1 % – weder der günstigste Platz (OpenCode $0.177) noch die höchste Bestehensquote (ZCode 69,0 %, 171/248, zugleich die höchste Quote aller Kombinationen im gesamten Feld). Claude Code liegt in dieser Zelle bei 68,1 %, Codex CLI bei $0.237 / 67,3 %. Der teuerste Vertreter dieser Spalte, Cline CLI, verbraucht pro Versuch 6,77 M Tokens und kostet $0.860 pro bestandenem Versuch – rund das 4,9-Fache von OpenCode; dieser Faktor gilt nur für dieses Paar.
In der Spalte Kimi-K3 sieht es genauso aus: Bei den Kosten pro bestandenem Versuch liegt der eigene Harness KimiCode bei $1.84 / 60,1 % und damit schlechter als Oh My Pi mit $1.45; auch die Bestehensquote bleibt unter der von mini-SWE-agent (64,9 %) sowie von Alma und ZCode (64,1 %). Die niedrigste Bestehensquote im gesamten Feld stammt ebenfalls von hier: Exo + Kimi-K3, 43,5 %, 108/248.
Szenario-Empfehlungen: Welcher Harness passt zu welchem Modell
Übersetzt man die obigen spaltenweisen Schlussfolgerungen in die Praxis, lässt sich die Auswahl danach aufteilen: „Welches Modell nutzt du + was ist dir wichtiger – Kosten oder Bestehensquote?“
Mit GLM-5.3
- Kosten pro bestandenem Versuch im Blick: Codex CLI, $0.803, 57,7 %, pro Versuch ca. 1,86 M Tokens.
- Bestehensquote im Blick: ZCode, 58,9 %, aber $1.48 pro bestandenem Versuch – fast das Doppelte von Codex CLI.
- Zu beachten: KimiCode liegt in dieser Spalte bei $1.55 / 58,1 %; die frühere Zwischenaussage ist damit hinfällig.
Mit GLM-5.3-Flash
- Kosten im Blick: Pi ($0.223) und Codex CLI ($0.226) liegen fast gleichauf, wobei Letzteres mit 59,3 % eine etwas höhere Bestehensquote erzielt.
- Bestehensquote im Blick: Hermes Agent 60,9 %, $0.328 pro bestandenem Versuch; ZCode mit 60,1 % und $0.264 ist die Kompromissoption.
Mit DeepSeek-V4.1-Flash-1017
- Kosten im Blick: OpenCode, $0.177, 61,3 %.
- Bestehensquote im Blick: ZCode, 69,0 %, $0.222 pro bestandenem Versuch – nur rund $0.045 teurer als der günstigste. In dieser Spalte kostet die Jagd nach der Bestehensquote wenig.
Mit Muse Spark Open oder Kimi-K3
- Muse Spark Open: Oh My Pi ist am günstigsten ($1.21); Grok Build hat die höchste Bestehensquote (59,7 %); Claude Code verbraucht 9,79 M Tokens pro Versuch und kostet $3.75 pro bestandenem Versuch – die teuerste Zelle dieser Spalte.
- Kimi-K3: Oh My Pi ist am günstigsten ($1.45, 942k Tokens pro Versuch); mini-SWE-agent hat die höchste Bestehensquote (64,9 %); Codex CLI $1.78 / 63,7 % – bei beiden Kriterien solide.
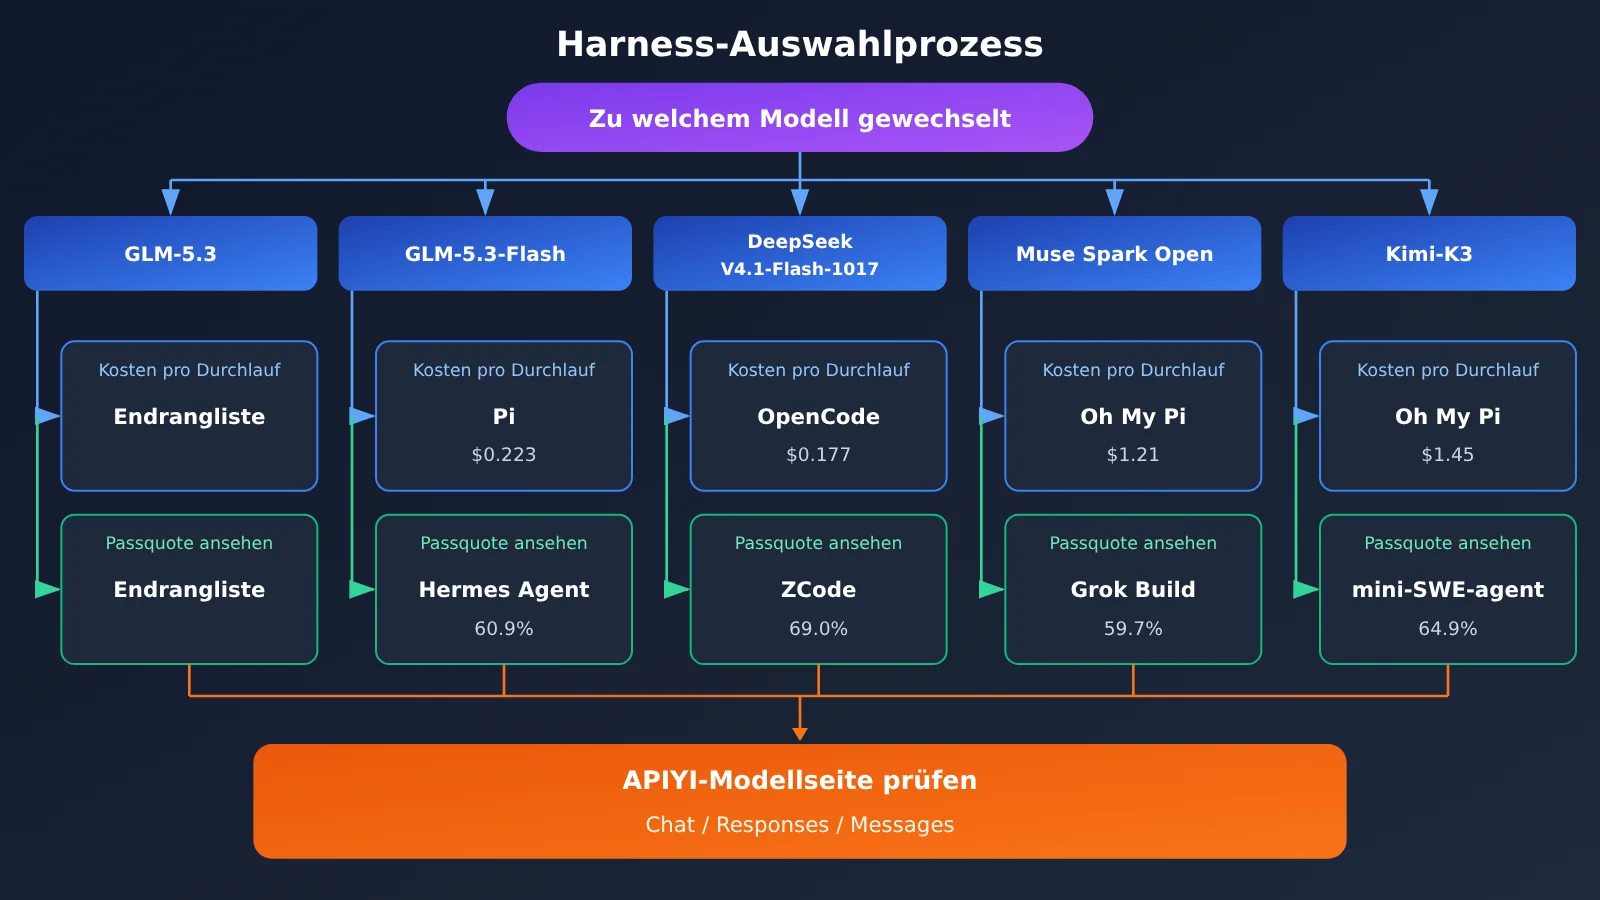
Entscheidungsempfehlung: Harness-Protokolle und APIYI-Modell-IDs im Vergleich
Die Harness-Tools in der Rangliste und die Plattform-Endpunkte sind keine Eins-zu-eins-Entsprechung. Ein gutes Codex-CLI-Ergebnis heißt nicht, dass die Modell-ID in deinen Händen Responses freigeschaltet hat; bei Claude Code gilt dasselbe – schau zuerst in die Messages-Spalte. Jedes Harness verbraucht Token, wenn es Aufgaben ausführt, und ein Wechsel des Harness oder des Modells verändert direkt die Abrechnung. Bevor du also ein Feld testest, solltest du auf der Modellseite von APIYI apiyi.com prüfen, ob diese ID Chat, Responses oder Messages freigibt, und dann die base_url des Harness auf https://api.apiyi.com/v1 zeigen lassen.
Die folgende Tabelle zeigt die Standardpreise aus der APIYI-Dokumentation vom 2026-11-15 (US-Dollar / 1M Tokens). Das sind zwei verschiedene Zahlensätze gegenüber den oben genannten Ranglistenpreisen – sie dürfen nicht vermischt werden.
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe | Chat | Responses | Messages | Gruppe |
|---|---|---|---|---|---|---|---|
glm-5.3 |
$1.4 | $0.259 | $4.396 | unterstützt | nicht unterstützt | unterstützt | ClaudeCode 0.95×, Default, SVIP |
glm-5.3-flash |
$0.15 | $0.03 | $0.5 | unterstützt | Modellseite: nicht unterstützt | Modellseite: nicht unterstützt | CodexResponses, Default, SVIP |
deepseek-v4.1-flash-1017 |
$0.3 | $0.006 | $1.2 | unterstützt | Gesamttabelle: nicht aufgeführt | unterstützt | ClaudeCode, Default, SVIP |
deepseek-v4.1-flash |
$0.3 | $0.006 | $1.2 | unterstützt | siehe Gruppe | unterstützt | zusätzlich CodexResponses |
kimi-k3 |
$3 | $0.3 | $15 | unterstützt | nicht unterstützt | nicht unterstützt | Default, SVIP |
| Muse Spark Open | noch nicht gelistet | — | — | — | — | — | — |
Einige Punkte, die einzeln erläutert werden müssen:
glm-5.3kann über Messages laufen und hat eine ClaudeCode-Gruppe mit 0.95×, was sich gut für Harness wie Claude Code eignet; dieser 0.95×-Faktor gilt nur fürglm-5.3. Über Responses läuft es nicht.- Bei
glm-5.3-flashgibt es zwei Unstimmigkeiten zwischen Gesamttabelle und Modellseite, beide Angaben werden beibehalten: In der Gruppe ist CodexResponses aufgeführt, die Modellseite schreibt jedoch, dass weder Responses noch Messages unterstützt werden; die Typ-Spalte der Gesamttabelle nennt „Text“, die Modellseite sagt, die Eingabe umfasse Text, Bilder und Videos. deepseek-v4.1-flash-1017kann über Messages laufen, aber aus der Gesamttabelle geht CodexResponses nicht hervor; wenn du Responses brauchst, schau auf den anderen Eintragdeepseek-v4.1-flash.kimi-k3bietet nur Chat Completions; bevor du Codex CLI oder Claude Code verwendest, muss zuerst geklärt werden, ob das Harness das Chat-Protokoll unterstützt.- Die Economy-Version
deepseek-v4-1-flash-economy-261017kostet $0.24 für die Eingabe, $0.96 für die Ausgabe und $0.006 für das Cache-Lesen; sie gibt nur chat frei. Laut der Echtzeit-Aktualisierung von APIYI lädt sie dieselben V4.1-Flash-1017-Gewichte wie die Standardversion und generiert langsamer. Wichtig: FrontierHarness hat diese ID nicht getestet, die Pass-Rate aus der Rangliste lässt sich nicht auf sie übertragen. - Muse Spark Open ist noch nicht gelistet, wir werden dieses Modell so bald wie möglich anbieten; Modellvariante und Preis richten sich nach der Modellliste der Plattform.
💡 Auswahl-Tipp: Wähle zuerst anhand des Modells die in dieser Spalte der Endrangliste aufgeführten Kandidaten-Harness aus, filtere dann anhand des Protokolls die Kombinationen heraus, die nicht zusammenpassen, und starte schließlich einen kleinen Probelauf mit demselben Aufgabenpaket. Über APIYI apiyi.com kannst du mit einem einzigen Key zwischen IDs wie
glm-5.3undkimi-k3wechseln und so die beiden Variablen „Modellwechsel“ und „Harness-Wechsel“ getrennt testen.
| Dein Ziel | Welche Spalte zuerst ansehen | Kandidaten fürs Finalranking |
|---|---|---|
| Modell noch unklar, nur ein solider Harness gesucht | Gesamtübersicht | Codex CLI (pro bestandenem Durchlauf am günstigsten), ZCode (höchste Bestehensrate) |
| Modell steht fest, Kosten senken | Kosten pro bestandenem Durchlauf des jeweiligen Modells | siehe Spalte „Am günstigsten“ in der Tabelle der fünf Modelle |
| Modell steht fest, Bestehensrate im Fokus | Bestehensrate des jeweiligen Modells | siehe Spalte „Höchste“ in der Tabelle der fünf Modelle |
| Gesamtbudget drücken | durchschnittliche Kosten pro Aufgabe des Modells | zuerst das Modell wechseln, dann den Harness |
Häufig gestellte Fragen (FAQ)
F1: Was ist FrontierHarness, und wie beantwortet es die Frage „Welcher Harness ist der beste?“
FrontierHarness ist ein von Runta initiierter Benchmark für Coding-Agent-Harnesses. In v1.1 laufen 21 Harnesses auf 5 Modellen jeweils durch 62 Aufgaben, jede Aufgabe viermal, und in derselben Umgebung werden Bestehensrate und Kosten erfasst. Das Ergebnis ist kein einzelner Sieger, sondern pro Modell eine eigene Rangliste.
F2: Wer ist denn nun Erster – Codex CLI oder ZCode?
Beide sind Erste, aber nach unterschiedlichem Maßstab. Bei den Kosten pro bestandenem Durchlauf liegt Codex CLI mit $0,937 vorn; bei der Bestehensrate liegt ZCode mit 61,9 % vorn. Es kommt darauf an, ob dir Budget oder Erfolgsquote wichtiger ist.
F3: Kann man die 66,7 % aus v1.0 und das Ranking vom 11. November noch heranziehen?
Nicht als finales Ranking. v1.0 testete nur Kimi K3 und 9 Harnesses, insgesamt 360 Durchläufe; der 11. November war ein Schnappschuss, als v1.1 erst zur Hälfte lief. Die Live-Rangliste vom 2026-11-15 zeigt bereits 26.040 absolvierte Durchläufe – maßgeblich ist das finale Ranking zu diesem Zeitpunkt.
F4: Worauf sollte man achten, wenn man GLM-5.3 mit Claude Code fährt?
Das finale Ranking führt keine eigene Zelle für Claude Code auf GLM-5.3 auf, daraus lässt sich sein Ergebnis also nicht direkt ableiten. Auf Protokollebene unterstützt `glm-5.3` Messages, und bei APIYI apiyi.com gibt es zusätzlich die ClaudeCode-Gruppe mit 0,95× – die Voraussetzungen für den Anschluss sind also gegeben.
F5: Wie kann man eine bestimmte Zelle in der eigenen Umgebung reproduzieren?
FrontierHarness bietet einen Selbsttest-Einstieg, mit dem du mit deinem eigenen Modellschlüssel in derselben Umgebung laufen kannst. Auf der Plattformseite geht man so vor: zuerst prüfen, ob die Modell-ID das vom Harness benötigte Protokoll freigibt, dann die `base_url` des Harness auf `https://api.apiyi.com/v1` setzen; neue Nutzer können mit einem kostenlosen Testkontingent erst einmal ein paar Aufgaben laufen lassen.
F6: Welche Grenzen hat dieses finale Ranking?
Die Dollar-Beträge auf der Liste ergeben sich aus Listenpreis mal gemeldeten Tokens und weichen von der tatsächlichen Plattform-Rechnung ab; außerdem ist das Effort bei allen Modellen auf max gesetzt, andere Stufen könnten die Ergebnisse verändern. Zudem liegen die Abstände zwischen manchen Rängen innerhalb des 95-%-Konfidenzintervalls – benachbarte Ränge sollte man nicht überinterpretieren.
Welches Harness ist das beste – die wichtigsten Erkenntnisse
- Keine Shell passt zu allem: Die günstigsten Harnesses der fünf Modelle verteilen sich auf vier verschiedene Shells.
- Zwei Spitzenplätze nebeneinander: ZCode hat mit 61,9 % die höchste Erfolgsquote, Codex CLI ist mit 0,937 $ pro bestandenem Durchlauf am günstigsten.
- Das Modell beeinflusst die Kosten stärker als die Shell: Zwischen den Modellen unterscheiden sich die durchschnittlichen Aufgabenkosten um etwa das 6,1-Fache, zwischen den Shells um weniger als das 2-Fache.
- Die hauseigene Shell ist kein Vorteil: Gemessen an den Kosten pro bestandenem Fall lagen weder die vier DeepSeek-Stufen noch KimiCode bei den eigenen Modellen auf dem günstigsten Platz.
- Das beste Feld: ZCode + DeepSeek-V4.1-Flash-1017, 69,0 %, 171/248.
- Anbindung zuerst über das Protokoll klären: Auf der Modellseite von APIYI die drei Spalten Chat, Responses und Messages prüfen, bevor man die Shell wählt.
Fazit
Die finale Rangliste von FrontierHarness v1.1 beantwortet die Frage „Welches Harness ist das beste?“ so: Es kommt auf das Modell an.
- Zwei Sieger im Gesamtfeld: Bei der Erfolgsquote führt ZCode, bei den Kosten pro bestandenem Fall Codex CLI.
- Neues Modell, neue Shell-Prüfung: Die günstigsten Shells der fünf Spalten sind Codex CLI, Pi, OpenCode, Oh My Pi und Oh My Pi.
- Beim Budget zuerst das Modell ansehen: Die Unterschiede bei den durchschnittlichen Aufgabenkosten, die vom Modell kommen, sind größer als die, die ein Shellwechsel ausmacht.
Für die praktische Auswahl sucht man in der finalen Rangliste zuerst die Spalte des eigenen Modells und prüft dann, ob das Protokoll zusammenpasst. Empfehlung: Über APIYI apiyi.com mit einer einheitlichen Schnittstelle die Modell-IDs wechseln und die Kandidatenkombinationen in einem kleinen Probelauf testen.
📚 Quellen
- FrontierHarness-Live-Rangliste: finale Rangliste v1.1 und aufgeschlüsselte Daten je Modell
- Link:
frontierharness.org/live/ -
Beschreibung: Am 2026-11-15 wird scored 26,040 angezeigt; dies ist die Quelle aller Ranglistenzahlen in diesem Artikel.
-
FrontierHarness-Selbsttest: mit eigenem API-Schlüssel in derselben Umgebung ausführen
- Link:
frontierharness.org/evaluate-your-own-harness/ -
Beschreibung: Geeignet, um eine bestimmte Kombination aus Harness und Modell zu reproduzieren.
-
Guanlan Dai Ankündigungspost: Problemstellung und Umfang von v1.1
- Link:
x.com/guanlan/status/2120192585235046712 -
Beschreibung: Enthält Hintergründe wie „erst 248 Durchläufe zählen als final“ sowie Angaben zu den Inferenz-Sponsoren.
-
APIYI Modellübersicht: Preise, Endpunkte und Gruppierungen für jede Modell-ID
- Link:
docs.apiyi.com/models - Beschreibung: Der Preisstand in diesem Artikel ist 2026-11-15 09:36 (UTC+8).
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der offiziellen APIYI-Website, um die passende Kombination aus Harness und Modell zu besprechen.