Note de l’auteur : cet article ne décrypte que le classement final de FrontierHarness v1.1, une fois les 26,040 exécutions terminées. Il compare les 21 harness modèle par modèle, et vérifie en parallèle les protocoles et les tarifs réellement proposés sur APIYI pour les ID de modèles concernés.
Si vous utilisez déjà Codex CLI, Claude Code, OpenCode, Pi ou un autre agent de programmation, et que vous changez souvent de modèle sous-jacent, alors la question « quel harness est le meilleur » n’a probablement pas de réponse unique. Le 2026-11-10, Guanlan Dai de Runta a lancé FrontierHarness v1.1, avec une question posée sans détour : when you switch models, should you switch harnesses too? Au 2026-11-15, le tableau en direct affichait running 0, scored 26,040, et les 21 harness × 5 modèles × 62 tâches × 4 tentatives avaient toutes été exécutées.
Ce n’est pas une lecture de classement du genre « un seul harness écrase tout le monde ». Dans le classement final, le meilleur taux de réussite et le meilleur coût par réussite ne sont pas le même harness, et pour chacun des cinq modèles, le harness le moins cher n’est pas non plus le même. Cet article décompose ces conclusions modèle par modèle, case par case.
L’essentiel : après lecture, vous repartez avec un comparatif du classement final FrontierHarness, séparé par modèle. Vous saurez quelle colonne regarder quand vous changez de modèle, quels anciens chiffres ne sont plus exploitables, et quel protocole vérifier avant de brancher quoi que ce soit.
Les critères du classement final FrontierHarness : avant de décider quel harness est le meilleur, regardez d’abord les règles
Toutes les exécutions de FrontierHarness tournent dans le runtime Runta, avec le même ensemble de limites de ressources. Chaque combinaison harness × model doit atteindre 248 exécutions pour compter comme résultat final — c’est pourquoi le classement évolue sans cesse au fil des nouveaux résultats pendant la diffusion. Le tableau ci-dessous récapitule les critères de notation du classement final v1.1 ; toutes les comparaisons qui suivent s’y réfèrent.
| Critère | Réglage du classement final v1.1 | Ce que cela implique pour la comparaison |
|---|---|---|
| Jeu de données | [email protected], 62 tâches |
Tous les harness passent le même jeu d’épreuves |
| Échelle | 21 harness, 4 exécutions par tâche, 248 par combinaison, 5 208 par modèle, 26 040 au total | Le dénominateur est identique pour chaque case, la comparaison d’une colonne à l’autre est donc possible |
| Environnement d’exécution | 1–4 vCPU, 2–8 GB de RAM, 32 GB de disque, délai d’expiration de 15 minutes à 8 heures par tâche | Élimine les différences entre machines |
| Paramètres d’inférence | Fournisseur d’inférence Baseten, effort réglé sur max pour les cinq modèles | Variables côté modèle uniformisées |
| Taux de réussite | Nombre de réussites ÷ tentatives comptabilisées ; les dépassements de délai et le reward hacking comptent comme des échecs, les erreurs d’infrastructure ne sont pas comptées | Regarder les réponses ne rapporte pas de points |
| Coût | Prix catalogue × tokens déclarés | C’est l’algorithme du classement, pas la facture d’une plateforme quelconque |
| Confiance | Bootstrap à 95 % par tâche | Les écarts de rang très faibles doivent être interprétés avec prudence |
Quelques séries de chiffres circulent souvent, mais aucune ne correspond au classement final v1.1. La v1.0 n’a testé que 9 harness, 12 configurations et 360 exécutions sur un seul modèle, Kimi K3 ; le taux de réussite de 66,7 % de Codex et le coût médian par tâche de 3,47 $ relèvent tous deux de la v1.0. Dans l’instantané intermédiaire du 2026-11-11, le coût par réussite se situait entre 0,57 $ et 1,32 $, et le taux de réussite entre 56,2 % et 77,6 % — c’était là encore un état à mi-parcours. Le même jour, quelqu’un écrivait que « pour GLM-5.3, le meilleur est KimiCode, et pour Kimi-K3, le meilleur est Codex » ; après un nouveau classement fondé sur le coût par réussite du classement final, ces affirmations ne tiennent plus.
Quel harness est le meilleur : comparatif du classement final global de FrontierHarness
Le tableau ci-dessous regroupe les scores de 21 harness sur cinq modèles, classés par « coût par réussite », du plus bas au plus élevé. Tous les montants en dollars sont calculés dans le classement final de FrontierHarness en multipliant les prix catalogue par les tokens déclarés.
| Rang | harness | Coût par réussite | Coût moyen par tâche | Taux de réussite |
|---|---|---|---|---|
| 1 | Codex CLI | $0.937 | $0.573 | 61.1% |
| 2 | Pi | $0.976 | $0.563 | 57.7% |
| 3 | Oh My Pi | $0.983 | $0.564 | 57.3% |
| 4 | ZCode | $1.06 | $0.659 | 61.9% |
| 5 | KimiCode | $1.09 | $0.653 | 60.2% |
| 6 | OpenCode | $1.12 | $0.646 | 57.4% |
| 7 | Maka | $1.13 | $0.654 | 57.7% |
| 8 | MiniMax Code | $1.14 | $0.647 | 56.8% |
| 9 | DeepSeek Harness: Minimal | $1.15 | $0.661 | 57.4% |
| 10 | Hermes Agent | $1.16 | $0.692 | 59.9% |
| 11 | Cline CLI | $1.19 | $0.689 | 57.7% |
| 12 | Grok Build | $1.20 | $0.723 | 60.0% |
| 13 | Alma | $1.22 | $0.731 | 59.7% |
| 14 | DeepSeek Harness: Standard | $1.27 | $0.697 | 55.0% |
| 15 | DeepSeek Harness: Creator | $1.27 | $0.713 | 56.1% |
| 16 | mini-SWE-agent | $1.29 | $0.757 | 58.6% |
| 17 | DeepSeek Harness: Code | $1.32 | $0.732 | 55.2% |
| 18 | Exo | $1.36 | $0.691 | 50.6% |
| 19 | GitHub Copilot CLI | $1.38 | $0.787 | 56.9% |
| 20 | Claude Code | $1.55 | $0.915 | 58.9% |
| 21 | Antigravity CLI | $1.63 | $0.897 | 55.0% |
Les deux premières places du classement final global
Le meilleur taux de réussite global revient à ZCode (61.9%), tandis que Codex CLI affiche le coût par réussite le plus bas ($0.937) ; ces deux constats doivent se lire ensemble. Codex CLI affiche un taux de réussite de 61.1%, soit seulement 0.8 point de pourcentage de moins que ZCode, mais coûte environ $0.12 de moins par réussite ; ZCode est le choix le plus sûr lorsqu’on veut surtout valider davantage de tâches. L’Antigravity CLI, le plus cher, coûte $1.63 par réussite, soit environ 1.74 fois celui de Codex CLI. Les taux de réussite globaux s’échelonnent de 50.6% pour Exo à 61.9% pour ZCode, soit 11.3 points de pourcentage d’écart.
Deux points prêtent à confusion. Premièrement, les quatre DeepSeek Harness sont quatre configurations de la même version 0.2.1-rc.3 (Minimal, Standard, Creator, Code), et non quatre produits distincts. Deuxièmement, Alma se classe 13e sur le coût par réussite et 6e sur le taux de réussite, derrière ZCode, Codex CLI, KimiCode, Grok Build et Hermes Agent. Les chiffres du snapshot du 11 novembre qui plaçaient Alma 3e avec 72.7% relèvent de données intermédiaires ; c’est le 59.7% du classement final qui fait référence.
Changer de modèle : quel harness s’en sort le mieux ? Les cinq modèles de FrontierHarness, colonne par colonne
Un récapitulatif global ne vous donne jamais que la moyenne. Ce qui décide vraiment de la facture, c’est la colonne du modèle que vous utilisez réellement. Dans le tableau ci-dessous, « le moins cher » désigne toujours, sur la page du modèle concerné, le harness dont le coût par passage réussi est le plus bas — le dénominateur des passages réussis étant dans tous les cas 248.
| Modèle | Coût moyen par tâche (moyenne sur les harness) | Le moins cher par passage réussi | Taux de réussite le plus élevé | Le plus cher pour ce même modèle |
|---|---|---|---|---|
| GLM-5.3 | $0.968 | Codex CLI $0.803, 57,7 % | ZCode 58,9 %, $1.48 | Exo $2.72, 50,0 % |
| GLM-5.3-Flash | $0.193 | Pi $0.223, 58,1 % | Hermes Agent 60,9 %, $0.328 | DeepSeek Harness: Minimal $0.484, 55,2 % |
| DeepSeek-V4.1-Flash-1017 | $0.185 | OpenCode $0.177, 61,3 % | ZCode 69,0 %, $0.222 | Cline CLI $0.860, 63,3 % |
| Muse Spark Open | $1.01 | Oh My Pi $1.21, 58,9 % | Grok Build 59,7 %, $1.77 | Claude Code $3.75, 52,8 % |
| Kimi-K3 | $1.12 | Oh My Pi $1.45, 57,7 % | mini-SWE-agent 64,9 %, $2.02 | Antigravity CLI $2.73, 56,9 % |
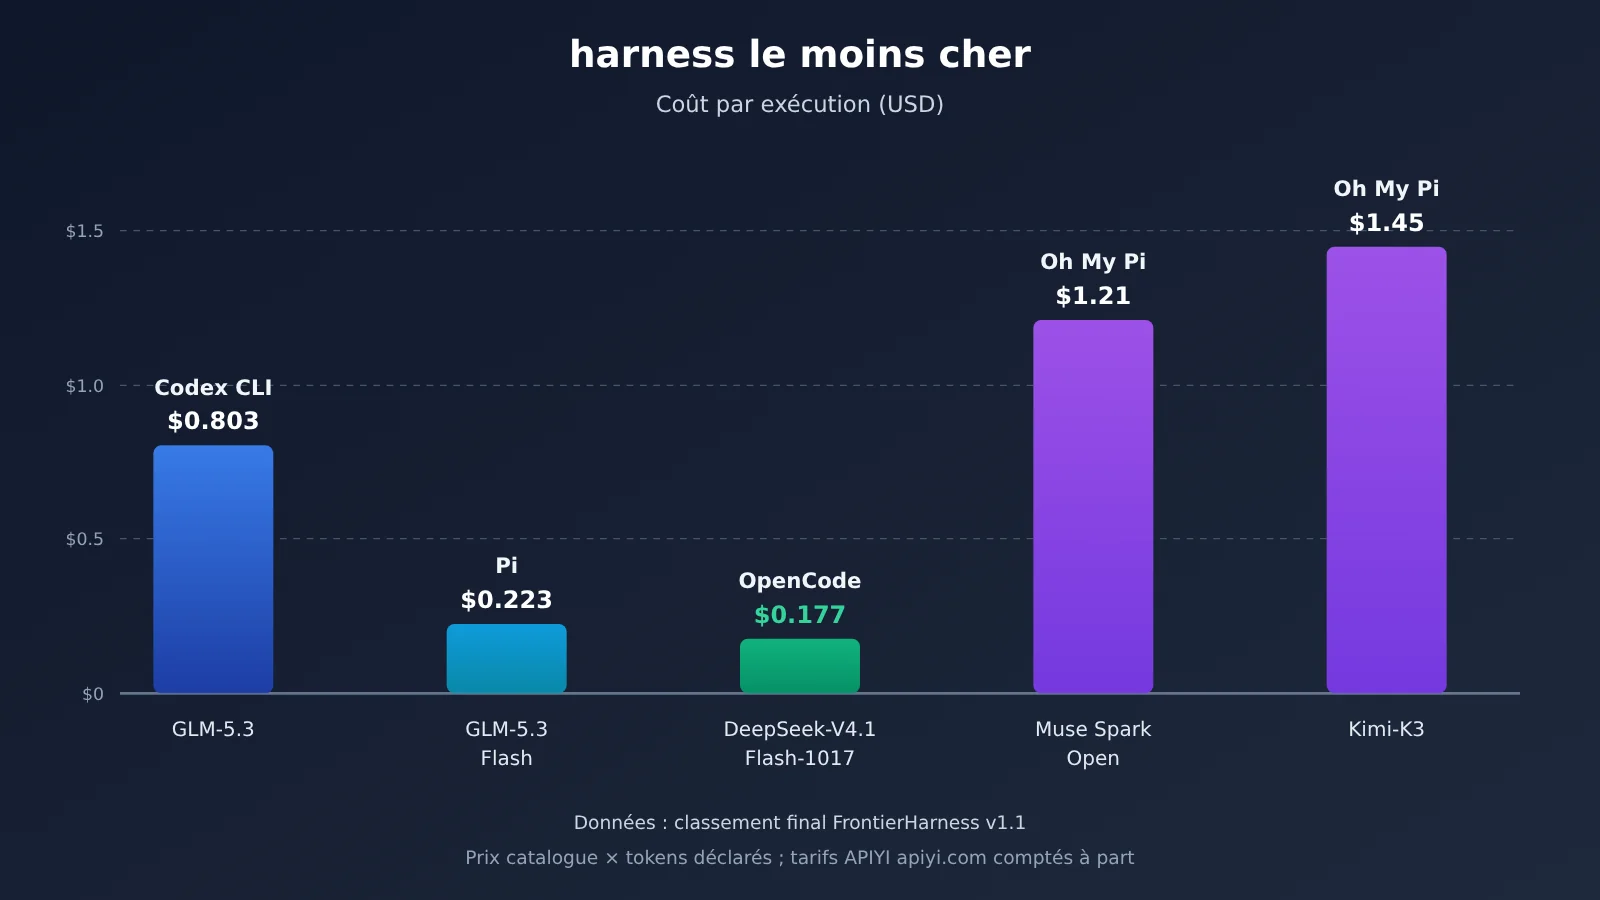
Conclusion 1 : le harness le moins cher n’est pas le même pour les cinq modèles
Les harness les moins chers des cinq colonnes sont respectivement Codex CLI, Pi, OpenCode, Oh My Pi et Oh My Pi — soit quatre harness différents. Codex CLI, leader du classement général, ne décroche la première place en coût que sur la colonne GLM-5.3 ; sur GLM-5.3-Flash, il affiche 0,226 $, à peine plus que Pi. Autrement dit, quand on change de modèle, il faut réexaminer le harness : impossible de reconduire telle quelle l’ancienne combinaison.
Conclusion 2 : l’écart de coût entre modèles dépasse celui entre harness
Si l’on regarde le coût moyen par tâche en fonction du modèle, on passe de 0,185 $ avec DeepSeek-V4.1-Flash-1017 à 1,12 $ avec Kimi-K3, soit environ 6,1 fois plus. Si l’on regarde maintenant le coût moyen par tâche tous modèles confondus, selon le harness, le plus bas est celui de Pi à 0,563 $ et le plus élevé celui de Claude Code à 0,915 $ : même pas un facteur 2. Autrement dit, dans le classement final FrontierHarness, le choix du modèle pèse davantage sur le coût par tâche que le choix du harness.
Conclusion 3 : le harness maison de DeepSeek n’a pas été le moins cher sur son propre modèle
Dans la colonne DeepSeek-V4.1-Flash-1017, en coût par réussite, les quatre déclinaisons de DeepSeek Harness sont Code $0.243 / 64.1%, Minimal $0.256 / 63.7%, Creator $0.273 / 64.9%, Standard $0.292 / 62.1% : il n’a décroché ni le moins cher (OpenCode $0.177), ni le meilleur taux de réussite (ZCode 69.0%, 171/248, qui est aussi la cellule au meilleur taux de réussite de toutes les combinaisons). Dans cette cellule, Claude Code est à 68.1%, et Codex CLI à $0.237 / 67.3%. Le plus cher de la même colonne, Cline CLI, consomme 6.77M tokens par tentative, pour $0.860 par réussite, soit environ 4.9 fois OpenCode ; ce ratio ne vaut que pour cette paire.
Il en va de même pour la colonne Kimi-K3 : en coût par réussite, le harness maison KimiCode affiche $1.84 / 60.1%, moins bien que Oh My Pi à $1.45, et son taux de réussite est aussi inférieur à celui de mini-SWE-agent (64.9%), d’Alma et de ZCode (64.1%). La cellule au taux de réussite le plus bas de tout le benchmark se trouve elle aussi ici : Exo + Kimi-K3, 43.5%, 108/248.
Recommandations par scénario : quel harness choisir selon le modèle
Pour traduire les conclusions colonne par colonne en choix concret, on peut raisonner selon deux axes : « quel modèle utilisez-vous ? » et « privilégiez-vous le coût ou le taux de réussite ? ».
Avec GLM-5.3
- Si le coût par réussite compte : Codex CLI, $0.803, 57.7%, environ 1.86M tokens par tentative.
- Si le taux de réussite compte : ZCode, 58.9%, mais à $1.48 par réussite, soit près du double de Codex CLI.
- À noter : dans cette colonne, KimiCode est à $1.55 / 58.1%, et le propos intermédiaire avancé plus haut ne tient plus.
Avec GLM-5.3-Flash
- Si le coût compte : Pi ($0.223) et Codex CLI ($0.226) sont quasiment à égalité, ce dernier ayant en plus un taux de réussite légèrement supérieur, à 59.3%.
- Si le taux de réussite compte : Hermes Agent 60.9%, à $0.328 par réussite ; ZCode, 60.1% pour $0.264, est une option de compromis.
Avec DeepSeek-V4.1-Flash-1017
- Si le coût compte : OpenCode, $0.177, 61.3%.
- Si le taux de réussite compte : ZCode, 69.0%, à $0.222 par réussite, soit seulement environ $0.045 de plus que le moins cher. Dans cette colonne, chercher le taux de réussite coûte très peu.
Avec Muse Spark Open ou Kimi-K3
- Muse Spark Open : Oh My Pi est le moins cher ($1.21) ; Grok Build a le meilleur taux de réussite (59.7%) ; Claude Code consomme 9.79M tokens par tentative, pour $3.75 par réussite, soit la cellule la plus chère de cette colonne.
- Kimi-K3 : Oh My Pi est le moins cher ($1.45, 942k tokens par tentative) ; mini-SWE-agent a le meilleur taux de réussite (64.9%) ; Codex CLI $1.78 / 63.7%, sans être désavantagé sur aucun des deux critères.
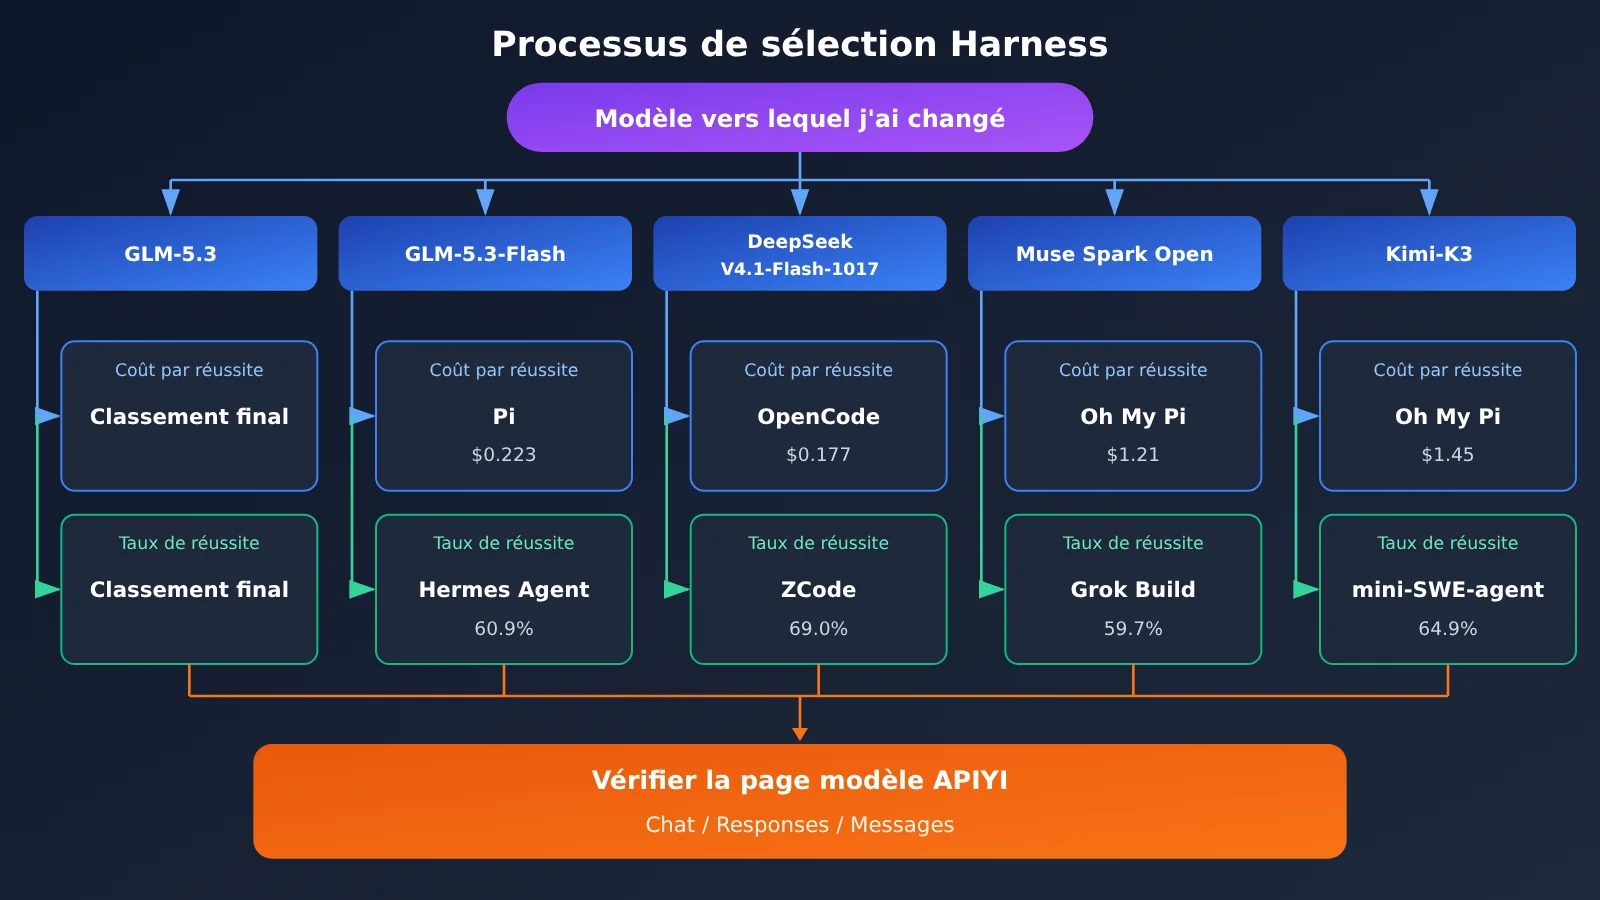
Recommandation de choix : correspondance entre protocoles des harness et ID de modèles APIYI
Les harness du classement et les endpoints des plateformes ne correspondent pas un pour un. De bons résultats avec Codex CLI ne signifient pas que le modèle que vous avez en main expose Responses ; c’est pareil pour Claude Code, il faut d’abord regarder la colonne Messages. Chaque harness consomme des tokens pour exécuter une tâche, et changer de harness ou de modèle modifie directement la facture. Donc avant de tester une case, je vous conseille d’aller vérifier sur la page du modèle d’APIYI apiyi.com si cet ID ouvre Chat, Responses ou Messages, puis de pointer le base_url du harness vers https://api.apiyi.com/v1.
Le tableau ci-dessous reprend les tarifs par défaut de la documentation APIYI au 2026-11-15 (USD / 1M tokens). Ce sont deux séries de chiffres distinctes de ceux du catalogue du classement : on ne peut pas les mélanger.
| ID de modèle | Entrée | Lecture cache | Sortie | Chat | Responses | Messages | Groupe |
|---|---|---|---|---|---|---|---|
glm-5.3 |
$1.4 | $0.259 | $4.396 | Pris en charge | Non pris en charge | Pris en charge | ClaudeCode 0.95×, Default, SVIP |
glm-5.3-flash |
$0.15 | $0.03 | $0.5 | Pris en charge | Page du modèle : non pris en charge | Page du modèle : non pris en charge | CodexResponses, Default, SVIP |
deepseek-v4.1-flash-1017 |
$0.3 | $0.006 | $1.2 | Pris en charge | Absent du tableau récapitulatif | Pris en charge | ClaudeCode, Default, SVIP |
deepseek-v4.1-flash |
$0.3 | $0.006 | $1.2 | Pris en charge | Voir le groupe | Pris en charge | Un CodexResponses en plus |
kimi-k3 |
$3 | $0.3 | $15 | Pris en charge | Non pris en charge | Non pris en charge | Default, SVIP |
| Muse Spark Open | Pas encore disponible | — | — | — | — | — | — |
Quelques points méritent d’être détaillés un par un :
glm-5.3peut passer par Messages et bénéficie d’un groupe ClaudeCode à 0.95×, ce qui en fait un bon choix pour un harness du type Claude Code ; ce 0.95× est réservé àglm-5.3. En revanche, il ne peut pas passer par Responses.glm-5.3-flashprésente deux incohérences entre le tableau récapitulatif et la page du modèle, et je conserve les deux versions : le groupe mentionne CodexResponses, mais la page du modèle indique que ni Responses ni Messages ne sont pris en charge ; la colonne Type du tableau récapitulatif indique « texte », tandis que la page du modèle indique que l’entrée inclut texte, image et vidéo.deepseek-v4.1-flash-1017peut passer par Messages, mais le tableau récapitulatif ne permet pas de voir CodexResponses ; si vous avez besoin de Responses, il faut regarder l’autre ID,deepseek-v4.1-flash.kimi-k3ne propose que Chat Completions : avant d’utiliser Codex CLI ou Claude Code, vérifiez que le harness sait se connecter au protocole Chat.- La version économique
deepseek-v4-1-flash-economy-261017est facturée entrée $0.24, sortie $0.96 et lecture cache $0.006, et n’ouvre que chat. D’après les informations dynamiques en temps réel d’APIYI, elle charge les mêmes poids V4.1-Flash-1017 que la version standard, mais génère plus lentement. À souligner : FrontierHarness n’a pas testé cet ID, et les taux de réussite du classement ne s’appliquent pas à lui. - Muse Spark Open n’est pas encore disponible ; nous le mettrons en ligne dès que possible. Le modèle et le prix de référence sont ceux de la liste des modèles de la plateforme.
💡 Conseil de choix : commencez par sélectionner, selon le modèle, les harness candidats de la colonne correspondante dans le classement final, éliminez ensuite les combinaisons incompatibles selon le protocole, et terminez par un petit essai sur un même lot de tâches. Avec une seule clé APIYI apiyi.com, vous pouvez basculer entre des ID comme
glm-5.3oukimi-k3, ce qui permet de tester séparément les deux variables « changer de modèle » et « changer de harness ».
| Votre objectif | Quelle colonne regarder en premier | Candidats au classement final |
|---|---|---|
| Modèle pas encore choisi, vous voulez juste un harness fiable | Synthèse globale | Codex CLI (le moins cher par réussite), ZCode (meilleur taux de réussite) |
| Modèle déjà choisi, réduire les dépenses | Coût par réussite du modèle concerné | Voir la colonne « le moins cher » du tableau détaillé des cinq modèles |
| Modèle déjà choisi, viser le taux de réussite | Taux de réussite du modèle concerné | Voir la colonne « le plus élevé » du tableau détaillé des cinq modèles |
| Compresser le budget total | Coût moyen par tâche, tous modèles confondus | Changer d’abord de modèle, puis de harness |
FAQ : questions fréquentes
Q1 : Qu’est-ce que FrontierHarness, et comment répond-il à la question « quel harness est le meilleur ? »
FrontierHarness est une évaluation de harness d’agents de programmation lancée par Runta. La v1.1 fait tourner 21 harness sur 5 modèles, chacun sur 62 tâches, 4 fois par tâche, et relève le taux de réussite ainsi que le coût dans un environnement identique. Le résultat n’est pas un champion unique, mais un classement propre à chaque modèle, colonne par colonne.
Q2 : Alors, entre Codex CLI et ZCode, qui est premier ?
Les deux, mais pas selon le même critère. Sur le coût par réussite, Codex CLI arrive en tête avec 0,937 $ ; sur le taux de réussite, c’est ZCode qui mène avec 61,9 %. Tout dépend de ce que vous privilégiez : le budget ou le taux de succès.
Q3 : Peut-on encore se fier aux 66,7 % de la v1.0 et au classement du 11 novembre ?
Non, pas comme classement final. La v1.0 ne portait que sur Kimi K3 et 9 harness, soit 360 exécutions au total ; le 11 novembre correspond à un instantané pris alors que la v1.1 était à mi-parcours. Le classement diffusé en direct le 2026-11-15 affiche 26 040 exécutions terminées : c’est ce classement final-là qu’il faut retenir.
Q4 : À quoi faut-il faire attention quand on utilise GLM-5.3 avec Claude Code ?
Le classement final ne détaille pas la case Claude Code sur GLM-5.3, on ne peut donc pas en déduire directement le score. Sur le plan protocolaire, `glm-5.3` prend en charge Messages, et sur APIYI apiyi.com il existe en plus un groupe ClaudeCode à 0,95× : les conditions d’intégration sont bien réunies.
Q5 : Comment reproduire une case précise dans son propre environnement ?
FrontierHarness met à disposition un point d’entrée d’auto-évaluation, qui permet de faire tourner ses propres clés de modèle dans le même environnement. Côté plateforme, la marche à suivre est la suivante : vérifier d’abord que l’ID du modèle expose bien le protocole dont le harness a besoin, puis régler le `base_url` du harness sur `https://api.apiyi.com/v1`. Les nouveaux utilisateurs peuvent profiter d’un quota d’essai gratuit pour lancer quelques tâches.
Q6 : Quelles sont les limites de ce classement final ?
Les montants en dollars affichés sont calculés en multipliant le prix catalogue par les tokens déclarés, ce qui diffère de la facture réelle de la plateforme ; l’effort de tous les modèles est réglé sur max, et les résultats peuvent bouger avec un autre réglage. Par ailleurs, l’écart entre certaines positions tombe dans l’intervalle de confiance à 95 % : mieux vaut ne pas surinterpréter deux places voisines.
Quel harness est le meilleur
À retenir
- Aucun harness ne passe partout : les harness les moins chers des cinq modèles se répartissent sur quatre harness différents.
- Deux premiers prix coexistent : ZCode affiche le meilleur taux de réussite à 61,9 %, Codex CLI est le moins cher à 0,937 $ par réussite.
- Le modèle pèse plus que le harness dans la facture : d’un modèle à l’autre, le coût moyen par tâche varie d’environ 6,1 fois, contre moins de 2 fois d’un harness à l’autre.
- Les harness maison ne tirent pas leur épingle du jeu : en coût par réussite, les quatre versions de DeepSeek et KimiCode n’ont pas obtenu le meilleur tarif sur leurs propres modèles.
- La meilleure cellule : ZCode + DeepSeek-V4.1-Flash-1017, 69,0 %, 171/248.
- Avant de brancher, vérifiez le protocole : sur la page modèle d’APIYI, contrôlez les trois colonnes Chat, Responses et Messages avant de choisir un harness.
Bilan
Le classement final de FrontierHarness v1.1 répond à la question « quel harness est le meilleur » ainsi : cela dépend du modèle.
- Deux premiers prix sur l’ensemble : le taux de réussite revient à ZCode, le coût par réussite à Codex CLI.
- Changer de modèle, c’est revoir le harness : les harness les moins chers des cinq colonnes sont Codex CLI, Pi, OpenCode, Oh My Pi et Oh My Pi.
- Pour le budget, le modèle d’abord : l’écart de coût moyen par tâche vient plus du modèle que du changement de harness.
En pratique, commencez par repérer la colonne de votre modèle dans le classement final, puis vérifiez que le protocole est bien compatible. Je vous conseille de passer par APIYI apiyi.com pour changer d’identifiant de modèle via une interface unifiée, et de lancer un petit test sur les combinaisons candidates.
📚 Références
- Classement en direct FrontierHarness : classement final v1.1 et données ventilées par modèle
- Lien :
frontierharness.org/live/ -
Description : affiche scored 26,040 au 2026-11-15 ; c’est la source de tous les chiffres de classement cités dans cet article
-
Portail d’auto-évaluation FrontierHarness : exécutez vos propres tests dans le même environnement avec votre propre clé
- Lien :
frontierharness.org/evaluate-your-own-harness/ -
Description : pratique pour reproduire une combinaison harness × model donnée
-
Publication de Guanlan Dai : contexte et échelle du problème traité par la v1.1
- Lien :
x.com/guanlan/status/2120192585235046712 -
Description : contient des informations de contexte, notamment le fait qu’il faut 248 exécutions pour obtenir le résultat final, ainsi que les sponsors de l’inférence
-
Tableau récapitulatif des modèles APIYI : prix, endpoints et groupes de chaque ID de modèle
- Lien :
docs.apiyi.com/models - Description : les prix cités dans cet article datent du 2026-11-15 09:36 (UTC+8)
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site officiel APIYI pour discuter du choix des combinaisons harness × model