作者注:从一个 30 分钟的软件开发 Agent 任务出发,拆解 Agent 多轮调用中普通输入、缓存写入、缓存读取、输出与工具往返的费用构成,对比三家服务商的缓存计费,并用 12 次调用的示例说明缓存在什么条件下才真正省钱。
2026 年 11 月 9 日,Google Cloud 发布 TPU 8tx 与 TPU 8i Max 两套第八代 TPU 系统,同时开源了用于 KV Cache 传输的 TPU Sync。“Agent 时代的内存墙”再次成为话题,很多开发者自然会问:底层 KV Cache 越来越快,我的 Agent API 账单会不会随之变便宜?
核心价值:读完本文,你将拿到一个完整的 Agent 成本公式、三家服务商的缓存计费对照,以及一套可以马上落地的成本优化清单。
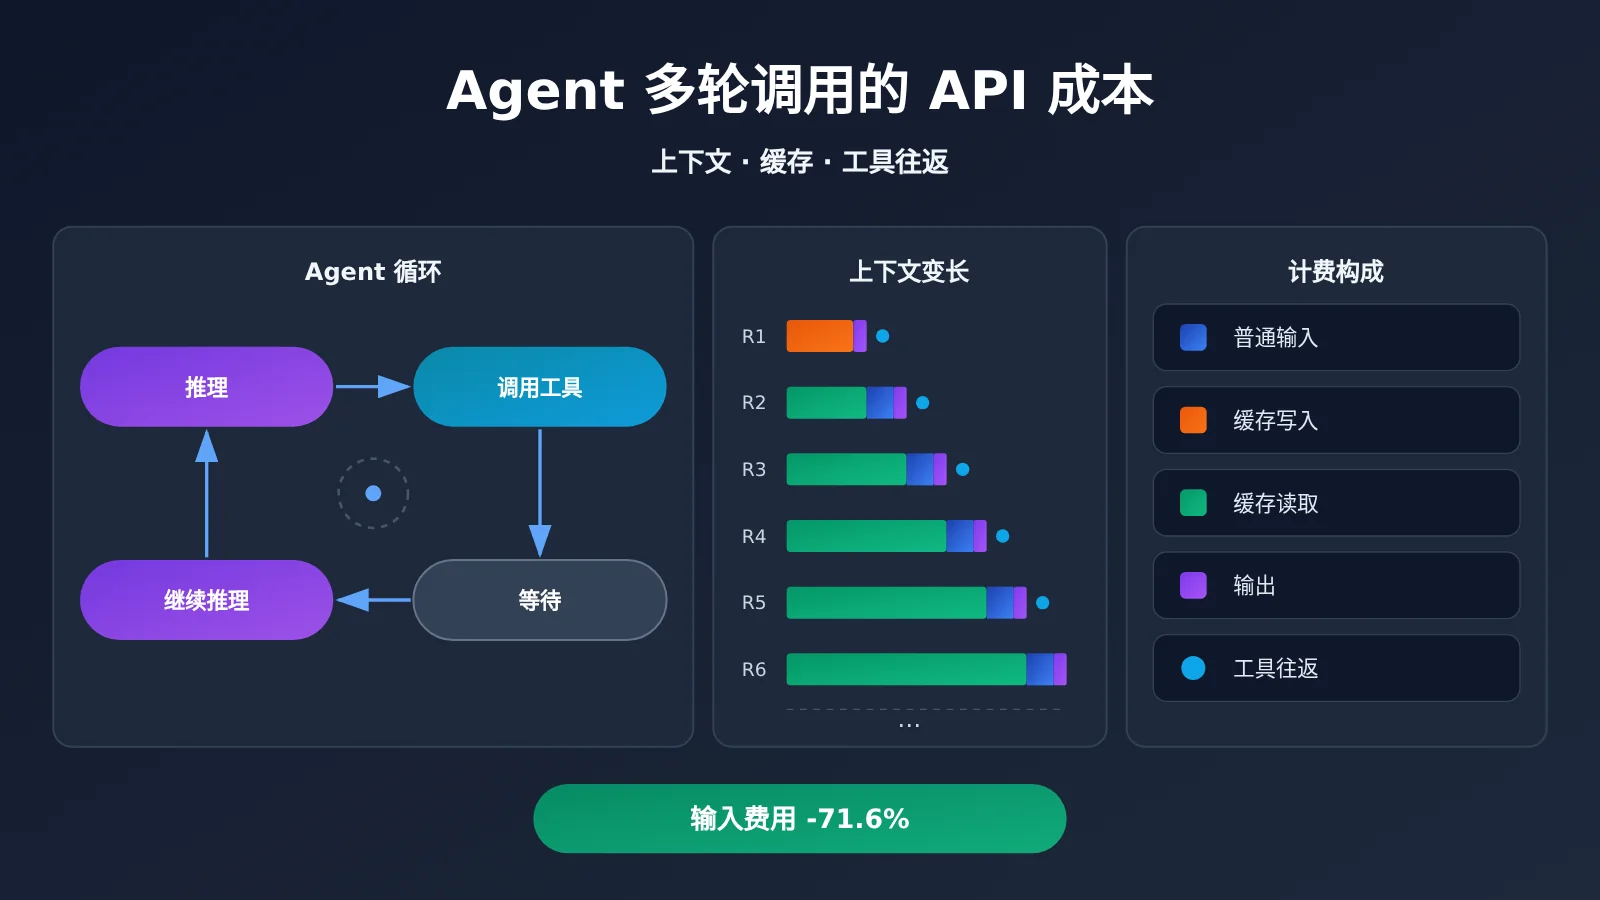
Agent 多轮调用 API 成本:核心信息速览
| 信息项 | 详情 |
|---|---|
| 背景事件 | 2026-11-09 Google 发布 TPU 8tx、TPU 8i Max 及 TPU Sync,聚焦 Agent 的内存与 KV Cache 瓶颈 |
| 开发者关心的问题 | 底层优化能否转化为 Agent API 账单下降 |
| 核心结论 | 账单由普通输入、缓存写入、缓存读取、输出 Token、调用次数与工具费用共同决定 |
| 关键变量 | 前缀是否稳定、缓存 TTL 是否覆盖工具等待时间、历史上下文是否失控 |
| 影响范围 | 编码 Agent、长文档 Agent、多 Agent 协作等多轮调用场景 |
Agent 多轮调用的 30 分钟任务长什么样
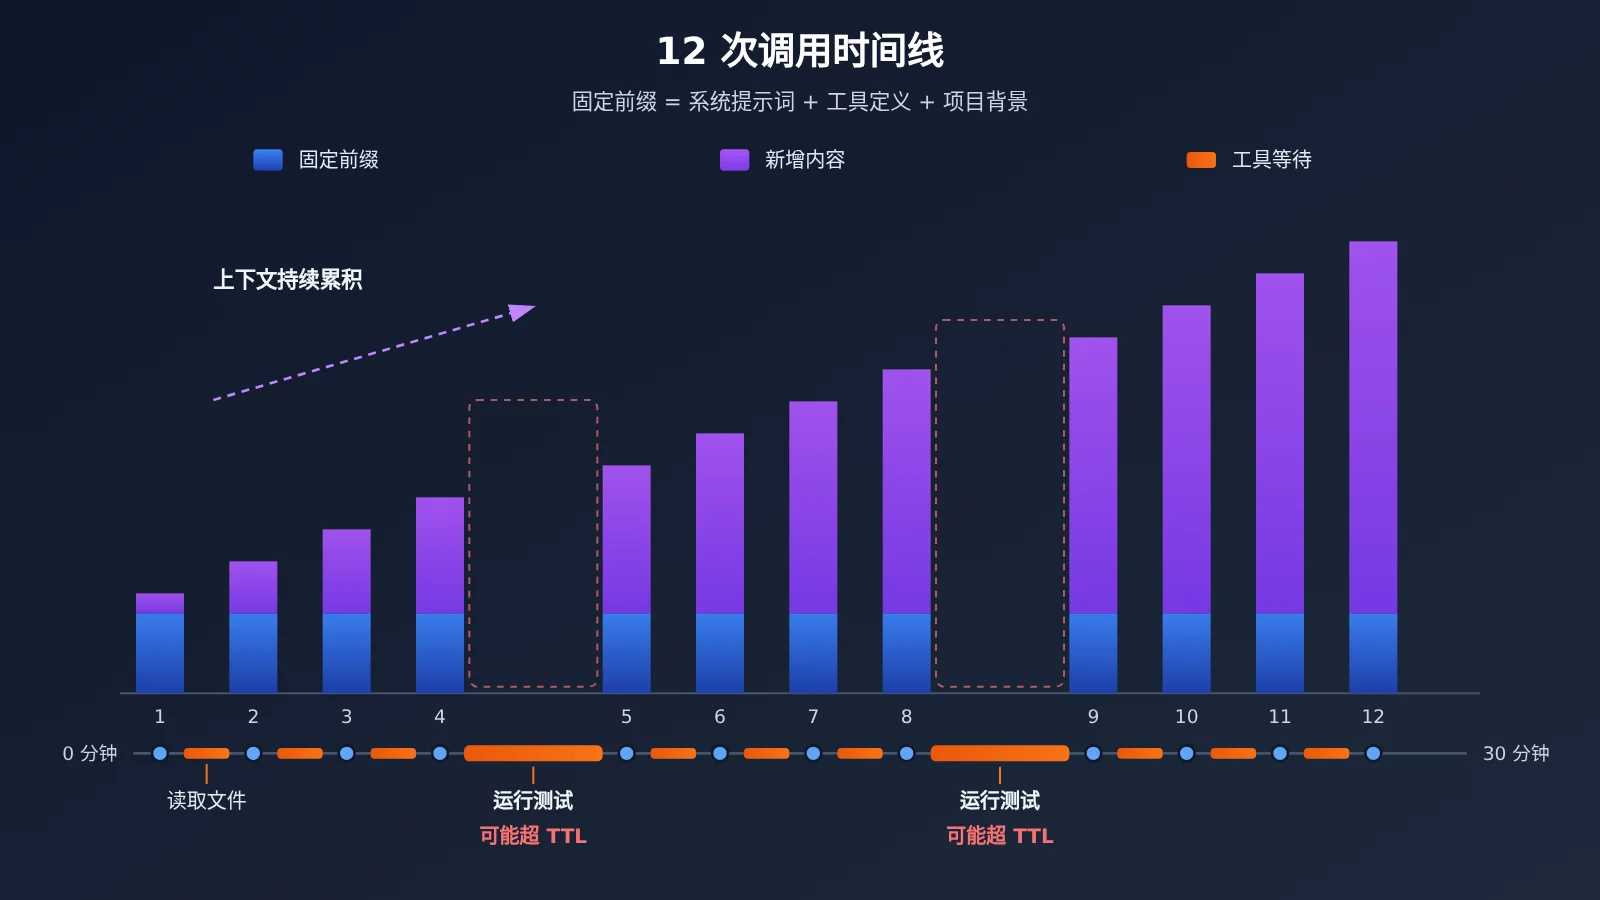
设想一个软件开发 Agent 接到需求:修复某个模块的测试失败。它先读取项目结构和相关源码,生成修改方案,调用工具写文件、跑测试,等待测试结果,再根据报错继续推理。30 分钟里,这样的“推理—工具—等待—推理”循环可能发生十几次。
问题在于,大模型 API 本质上是无状态的。每一次请求,Agent 都要把系统提示词、工具定义、项目背景以及之前的对话和工具输出重新发给模型。第 12 次请求携带的内容,往往包含了前 11 轮几乎全部的历史,这就是“上下文重复计算”的来源。
Agent 多轮调用 API 成本由哪些部分组成
把一次 Agent 任务拆开看,费用至少包含五类。前四类是模型 Token 费用,第五类则发生在模型之外,却常常被忽略。
| 成本项 | 含义 | 计费特点 |
|---|---|---|
| 普通输入 | 未命中缓存、按标准价处理的输入 Token | 标准输入单价 |
| 缓存写入 | 创建可复用缓存的那部分输入 | 部分服务商与模型按高于标准输入的倍率计费 |
| 缓存读取 | 命中已有缓存的输入 | 通常远低于标准输入单价 |
| 输出 Token | 模型生成的内容,含工具调用参数 | 一般是单价最高的部分,缓存无法降低 |
| 工具与外部执行 | 搜索、代码执行、数据库等外部服务 | 按各自服务计费,且会增加模型调用轮数 |
据此可以写出一个单任务成本公式:
任务总成本 = Σ(普通输入 × 输入单价 + 缓存写入 × 写入单价 + 缓存读取 × 读取单价 + 输出 × 输出单价)+ 工具与外部执行费用
公式中的 Σ 是对任务内每一次模型调用求和。这意味着调用次数本身就是乘数:工具往返越多,模型调用越多,固定前缀被重复计费的次数也越多。工具调用并不只花工具自己的钱,它还会把一次推理拆成多次,每次都要重新携带上下文。
Agent 多轮调用中 KV Cache、Prompt Cache 与上下文压缩的区别
讨论 Agent 成本时,三个概念最容易混用。它们分属不同层面,对账单的影响也完全不同。
| 技术 | 所在层面 | 具体含义 | 对 API 用户的影响 |
|---|---|---|---|
| KV Cache | 模型推理底层 | 保存注意力计算中的 Key/Value 状态,避免重复计算历史 Token | 用户不直接控制,影响服务商的成本与延迟 |
| Prompt Cache | API 服务层 | 服务商复用重复提示词前缀,单独计费缓存写入与读取 | 直接体现在账单的缓存字段上 |
| 上下文压缩 | 应用层 | 对历史内容做摘要、筛选或裁剪后再传入 | 减少实际传入的 Token,但可能损失细节 |
值得注意的是,OpenAI 官方文档说明 Prompt Cache 实际保存的是 KV Tensor,而不是原始 Token 文本。因此 Prompt Caching 可以理解为底层 KV 状态复用能力的服务化与计费化,它与 KV Cache 并非毫无关系,但用户能感知到的只有计费规则。
上下文压缩则是另一回事。它改变的是后续请求“携带什么”,而不是“如何复用”。压缩得越激进,Token 越少,但 Agent 遗忘关键细节的风险也越高。
Agent 多轮调用的底层优化为什么不等于账单下降
Google 这次发布的 TPU 8i Max 将 HBM 带宽和片上 SRAM 翻倍,TPU Sync 在 Ironwood 平台的内部测试中将 KV Cache 传输延迟降低超过 90%,Agent Compute Engine 则在 Agent 空闲时暂停会话、把工作内存移出芯片。这些优化作用于服务商的资源利用率和推理延迟(例如 TTFT),对用户可能体现为更快的响应。
但 API 价格是服务商的商业定价,用户账单仍按 Token 计量。硬件效率提升可能在长期内影响定价,却不存在自动、等比例的传导关系。另外,TPU 8tx 与 TPU 8i Max 截至 2026-11-10 仍标记为 Coming soon,尚未公布价格。对开发者而言,能立刻控制的是自己的 Token 结构,而不是上游的硬件。
Agent 多轮调用 API 成本:三家服务商缓存计费对比
三家主流服务商都提供缓存机制,但触发方式、TTL 和计费口径差异明显。下表依据各家官方文档整理,具体以对应模型和接口的说明为准。
| 服务商 | 缓存机制 | TTL 选项 | 写入计费 | 读取计费 | 可用平台 |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching,支持模型自动前缀缓存 | 部分新模型默认 30 分钟,部分模型支持 12 小时 | 支持相应配置的模型与接口:30 分钟为普通输入 1.25 倍,12 小时为 2.5 倍;其他缓存模式可能不另收写入费 | 通常为普通输入 0.1 倍,部分模型更低 | 官方 API、API易 apiyi.com |
| Anthropic | Prompt Caching | 默认 5 分钟,可延长至 1 小时 | 5 分钟为普通输入 1.25 倍,1 小时为 2 倍 | 因模型而异 | 官方 API、API易 apiyi.com |
| Google Gemini | Context Caching,隐式缓存 + 显式缓存 | 显式缓存可设置 TTL | 显式缓存另有按缓存 Token 数与存储时长计算的费用 | 命中可降低重复输入费用 | 官方 API、API易 apiyi.com |
以 Claude Sonnet 5.5 的官方价格为例:普通输入每百万 Token $2.00,5 分钟缓存写入 $2.50,1 小时缓存写入 $4.00,缓存读取 $0.10。缓存读取只有普通输入的 5%,这正是重复前缀能被大幅压缩成本的原因。
需要提醒的是,OpenAI 官方明确说明缓存命中并非每次都能保证;Gemini 的显式缓存也不是“免费存储”,存储时长本身会计费。缓存是一种有条件的折扣,而不是默认生效的降价。
🎯 技术建议:不同上游模型的缓存能力、计费规则和返回字段并不统一,统一网关不会自动让所有模型获得相同的缓存优惠。建议通过 API易 apiyi.com 用同一套 OpenAI 兼容代码分别测试候选模型,以实际返回的 usage 字段和账单为准。
Agent 多轮调用缓存成本实算:12 次调用示例
沿用前文的 30 分钟开发任务,并使用 Claude Sonnet 5.5 官方价格构造示例。假设条件如下:
- 任务共调用模型 12 次,每次输入 22,000 Token;
- 其中 20,000 Token 是重复的系统提示词、工具定义和项目背景;
- 每次新增 2,000 Token;
- 采用 1 小时缓存,后续请求均成功复用。
不使用缓存:12 × 22,000 × $2 / 1,000,000 = $0.528。
使用 1 小时缓存:首次写入 20,000 Token 为 $0.080,首次普通输入 2,000 Token 为 $0.004,后续 11 次缓存读取为 $0.022,后续 11 次新增输入为 $0.044,合计 $0.150,输入费用节省约 71.6%。
这个示例只计算输入 Token,不包含输出 Token、工具调用和外部服务费用。真实 Agent 的历史还会逐轮增长,但结论方向不变:重复上下文是 Agent 多轮调用中最容易被放大的成本。
缓存失效、前缀变化与 TTL 对 Agent 成本的影响
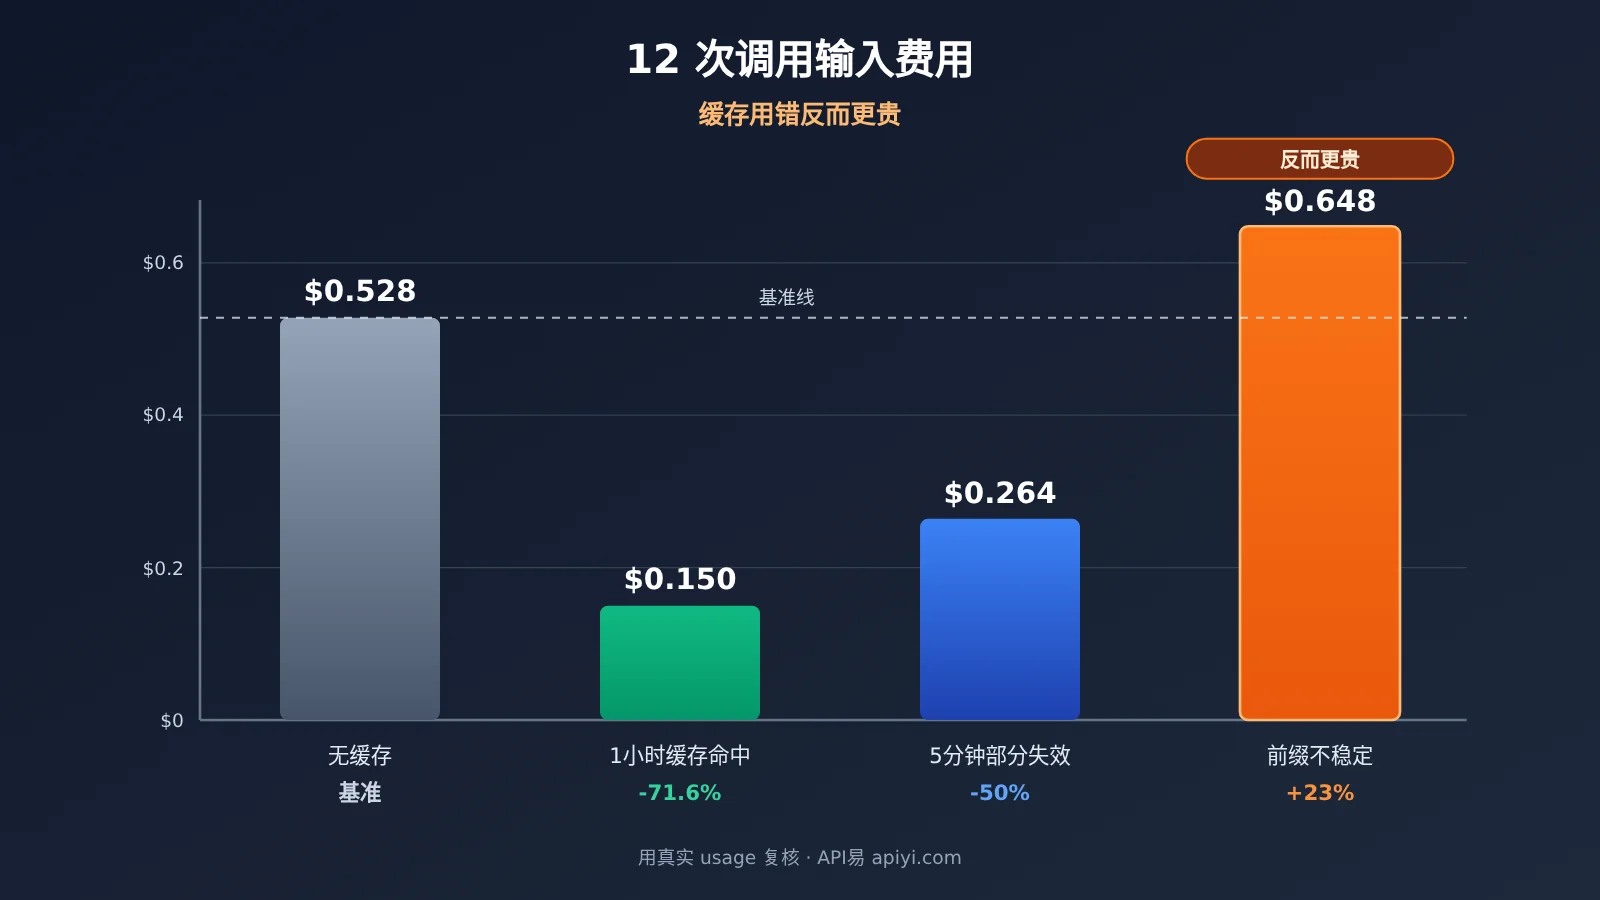
上面是理想情况。下面用同一组价格,对三种常见“走样”做补充推演(以下为本文按官方单价自行计算的示意场景)。
| 场景 | 假设 | 输入费用 | 相对无缓存 |
|---|---|---|---|
| 无缓存 | 12 次全部按普通输入 | $0.528 | 基准 |
| 1 小时缓存全命中 | 写入 1 次,读取 11 次 | $0.150 | 节省约 71.6% |
| 5 分钟缓存全命中 | 写入单价 $2.50,读取 11 次 | $0.120 | 节省约 77.3% |
| 5 分钟缓存部分失效 | 工具等待超时导致共写入 4 次、读取 8 次 | $0.264 | 节省约 50% |
| 前缀不稳定 | 前缀每次变化,12 次都按 5 分钟写入计费 | $0.648 | 反而多花约 23% |
几点解读可以直接用于决策:
- TTL 要覆盖工具等待:5 分钟缓存写入更便宜,但只要测试运行或人工确认超过 5 分钟,缓存就会过期重写,节省幅度明显缩水。
- 前缀稳定比 TTL 更关键:把时间戳、随机 ID 放在提示词最前面,会让每次请求都无法命中,在需要付写入溢价的模式下,缓存反而让账单变贵。
- 长 TTL 不是越长越好:1 小时写入单价是 5 分钟的 1.6 倍,只有当调用间隔确实可能超过 5 分钟时才划算。
如何降低 Agent 多轮调用的 API 成本
极简示例:记录每次调用的缓存命中
优化的第一步是“看见”成本。下面的代码通过 OpenAI 兼容接口发起请求,并打印 usage 中的缓存相关字段:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="your-model-name",  # 替换为要测试的模型
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
查看完整实现:稳定前缀 + 单任务成本追踪
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 固定前缀:系统指令、工具定义、公共项目背景,放在最前且保持字节级不变
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # 单价:美元 / 百万 Token,按所用模型官方价格填写
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # 只追加新消息,不重排历史;动态信息(时间戳等)放在最后
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
注意,上面的估算只覆盖读取折扣;若所用模型对缓存写入单独计费,需要按其返回字段补充写入项。不同模型的 usage 字段名称和含义可能不同,应以实际返回为准。
🚀 快速开始:推荐先在 API易 apiyi.com 用免费测试额度跑通上面的追踪脚本,拿到同一任务在不同模型下的缓存命中率与单任务成本,再决定生产环境用哪个模型、哪种 TTL。
Agent 多轮调用成本优化的五个动作
- 稳定提示词前缀:系统指令、工具定义、公共参考资料放在最前面,时间戳、用户动态信息放在最后,工具定义的顺序和字段也不要随意变动。
- 合理选择 TTL:调用密集、间隔短的任务用短 TTL;存在长时间测试、构建或人工审批的 Agent,评估更长 TTL 的写入溢价是否能被避免的重写抵消。
- 控制历史上下文:只追加、不重排,避免破坏缓存前缀;对冗长的工具输出做摘要,保留关键结论、任务状态和必要证据。
- 减少不必要的模型调用:能批量执行的工具合并成一次调用,确定性步骤交给代码而不是交给模型判断,从源头减少往返轮数。
- 监控真实指标:按任务记录普通输入、缓存写入、缓存读取、输出 Token、缓存命中率、TTFT 和总成本,用任务级成本而非单次请求成本做评估。
Agent 多轮调用 API 成本影响分析
对开发者的影响
- 成本模型要从“单次请求”升级为“单个任务”:Agent 的费用取决于整条调用链,只看单价会严重低估实际账单。
- 提示词工程开始兼顾计费结构:前缀的稳定性直接决定缓存能否生效,提示词结构设计成为成本工程的一部分。
- 多模型选型需要实测:缓存折扣比例、TTL 和写入溢价因模型而异,同样的任务换模型后成本差异可能很大。
对行业的影响
- 基础设施竞争聚焦 Agent 负载:Google 将内存带宽、KV Cache 传输和 Agent 暂停恢复作为重点,说明多轮、长上下文已成为主流负载形态。
- 用户收益更先体现在延迟上:底层优化首先改善 TTFT 和吞吐,Token 价格是否下调取决于服务商定价策略,开发者不宜提前计入预算。
常见问题 FAQ
Q1:Agent 多轮调用的 API 成本为什么比预想高?
因为 API 是无状态的,每次调用都要重新携带系统提示词、工具定义和历史上下文。调用次数越多,这部分固定内容被重复计费的次数越多,工具往返还会进一步增加调用轮数。
Q2:KV Cache 和 Prompt Cache 是一回事吗?
不完全是。KV Cache 是模型推理底层的状态复用;Prompt Cache 是服务商在 API 层对可复用前缀的缓存与计费,OpenAI 文档说明其保存的正是 KV Tensor。用户只能通过计费规则感知 Prompt Cache,无法直接控制 KV Cache。
Q3:Google 新 TPU 发布后,API 价格会马上下降吗?
没有依据这样判断。TPU 8tx 与 TPU 8i Max 截至 2026-11-10 仍为 Coming soon,未公布价格。硬件优化主要改善服务商的资源利用率和延迟,是否传导到 Token 价格取决于各服务商的定价。
Q4:缓存一定能省钱吗?
不一定。若前缀每次变化导致无法命中,而所用模式又对缓存写入收取溢价,费用反而会高于不使用缓存。工具等待超过 TTL 时,频繁重写也会削弱节省效果。
Q5:如何快速对比不同模型的缓存效果?
建议用同一个 Agent 任务在多个模型上跑相同流程,记录缓存命中率和单任务总成本。通过 API易 apiyi.com 可以用一个 API Key 调用 OpenAI、Claude、Gemini 等模型,只需切换 model 参数即可对比。
Q6:上下文压缩有什么风险?
压缩会改变后续请求携带的内容,可能丢失关键细节,导致 Agent 重复犯错、反而增加调用轮数。另外,压缩后的内容如果每轮都重新生成,还会破坏缓存前缀,需要与缓存策略一起设计。
Q7:在统一网关上调用时,缓存优惠是否对所有模型一致?
不一致。缓存能力、计费规则和返回字段取决于上游模型本身。在 API易 apiyi.com 上测试时,应针对每个模型单独确认缓存字段与实际扣费,再纳入成本预算。
Agent 多轮调用 API 成本核心要点 Key Takeaways
- 成本单位是任务:Agent 账单是整条调用链的累加,而非单次请求。
- 重复上下文是大头:12 次调用示例中,1 小时缓存可让输入费用节省约 71.6%。
- 缓存是有条件折扣:前缀不稳定或 TTL 过短时,节省缩水甚至反向增加费用。
- 三家计费口径不同:写入倍率、读取折扣、存储费用需按具体模型确认。
- 硬件优化≠账单下降:底层 KV 优化先改善延迟,价格取决于服务商定价。
- 先度量再优化:借助 API易 apiyi.com 用统一接口实测各模型缓存命中率与任务成本。
总结
Agent 多轮调用的 API 成本由上下文重复计算、缓存命中与工具往返共同决定,三者缺一不可:
- 上下文重复计算决定了成本的基数,调用越多,重复越多;
- 缓存命中决定了重复部分能打几折,前缀稳定性和 TTL 是关键;
- 工具往返既带来外部费用,又放大模型调用次数。
Google 在基础设施层对 KV Cache 和内存墙的投入,会让 Agent 运行得更快,但开发者能立刻掌控的是自己的 Token 结构。建议从稳定前缀、合理 TTL、精简历史、减少调用和任务级监控五个方面着手,并通过 API易 apiyi.com 用真实数据验证每一项优化的效果。
📚 参考资料
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max:第八代 TPU 新系统发布公告
- 链接:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
说明:了解 Agent 内存墙与 KV Cache 背景
-
Google Cloud Blog – Introducing TPU Sync:KV Cache 与权重传输开源库
- 链接:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
说明:底层 KV Cache 传输优化及测试口径
-
OpenAI API 文档 – Prompt Caching:缓存机制与最佳实践
- 链接:
platform.openai.com/docs/guides/prompt-caching -
说明:前缀缓存规则、保留时间与监控建议
-
Anthropic 文档 – Prompt Caching:缓存 TTL 与计费说明
- 链接:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
说明:5 分钟与 1 小时缓存的写入、读取价格
-
Google AI for Developers – Context Caching:Gemini 隐式与显式缓存
- 链接:
ai.google.dev/gemini-api/docs/caching - 说明:显式缓存 TTL 与存储费用说明
作者:APIYI 技术团队
技术交流:欢迎访问 API易 apiyi.com 首页联系我们,更多接入资料可查阅 docs.apiyi.com 文档中心