作者注:GDPx 首期评测中,金融和法律两个领域在严格二元验收下没有任何模型完整通过。本文还原两个公开案例的具体错误,说明为什么“会算账、会写合同”不等于“能交付合格成果”。
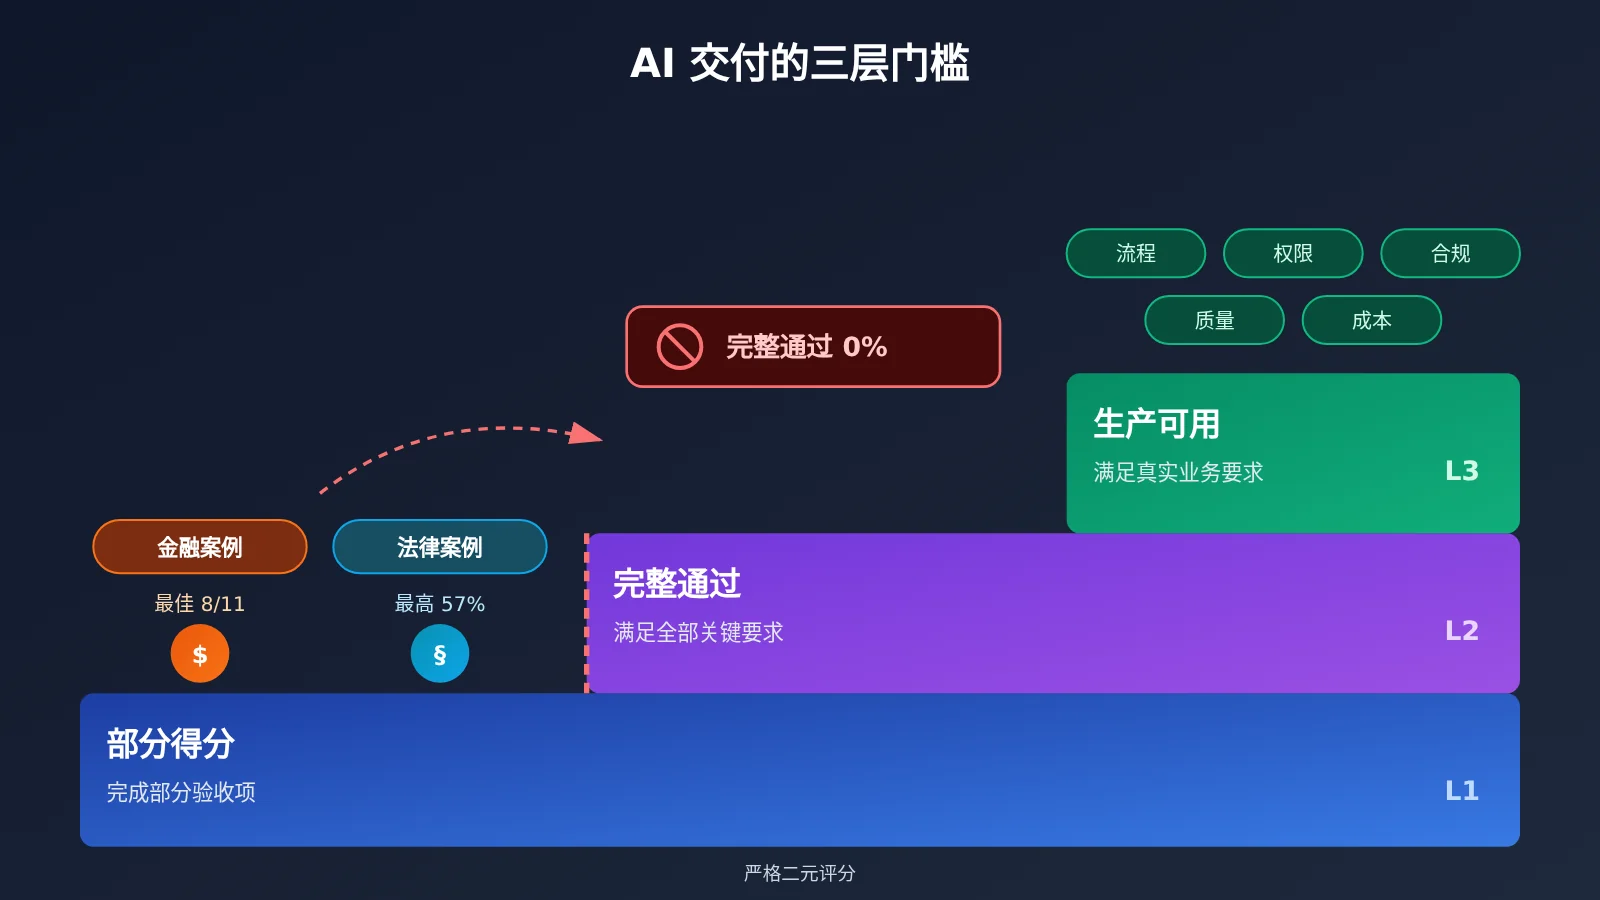
2026 年 11 月 2 日,SemiAnalysis 发布高难度专业任务基准 GDPx v1.0。在 11 个领域中,金融和法律两个领域按原定二元通过标准,所有测试模型均未实现完整通过。研究团队只能改用“平均部分得分”来展示模型之间的差异。
这不是一句“AI 不行”的情绪化结论。 部分模型在法律案例中拿到了 44% 的平均部分得分,在金融案例中做对了约一半的验收检查。真正值得关注的问题是:做对一半,为什么还是不能交付?
核心价值:读完本文,你会了解 Bellwood-QoE 金融任务和 B 轮融资章程修订任务中的关键金额、失败次数与评分口径,也能更清楚地区分 AI 的辅助能力和可以独立承担责任的交付能力。
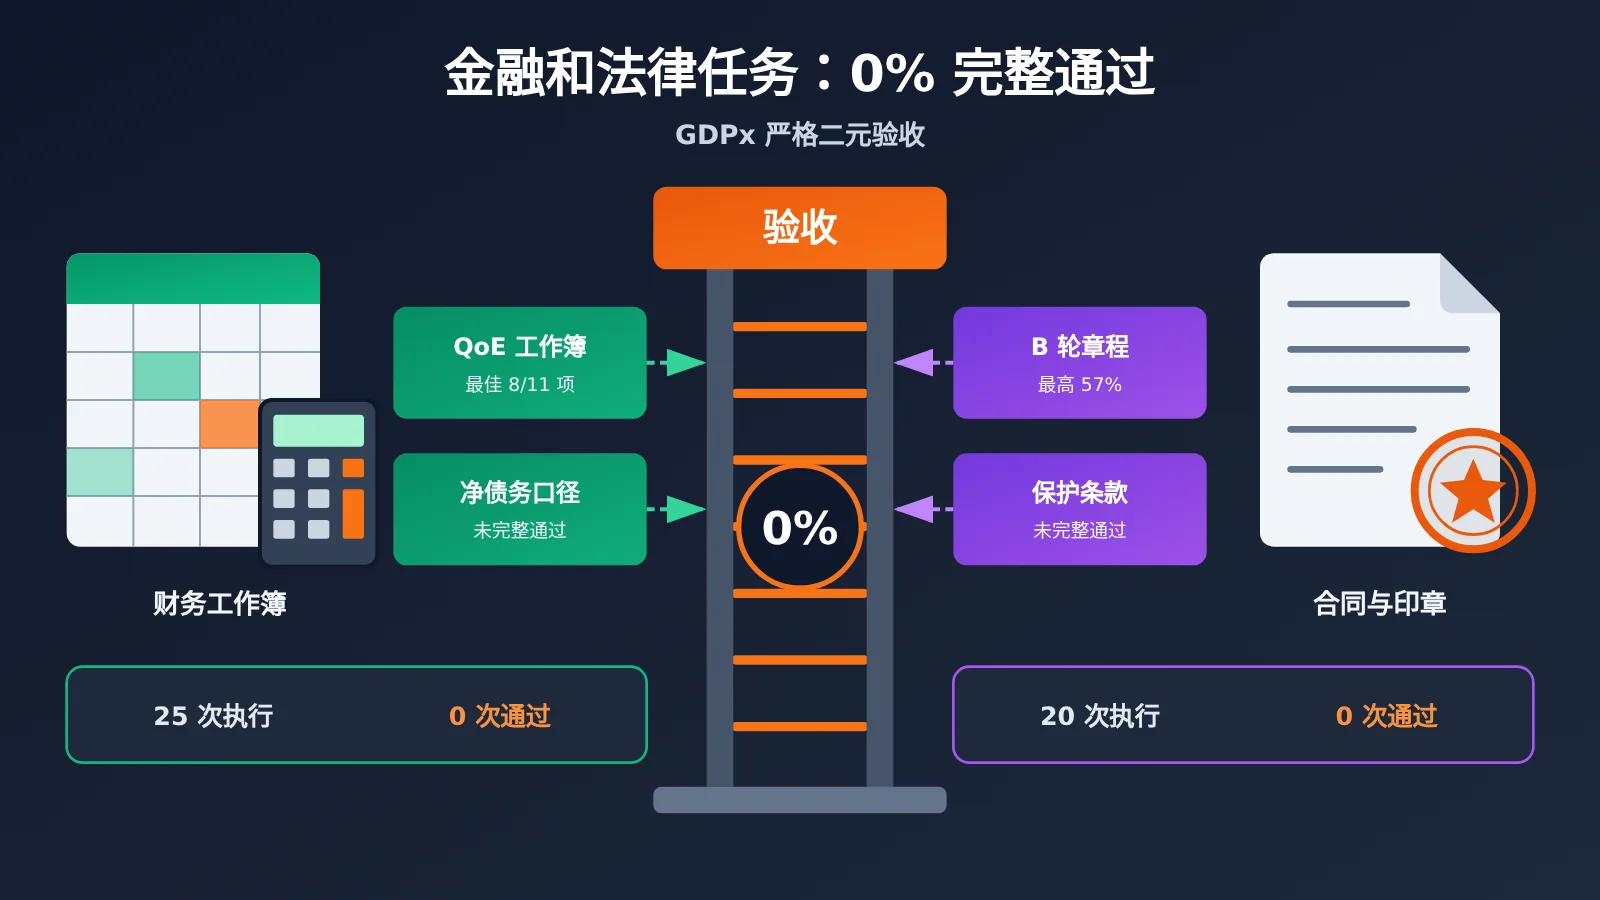
金融和法律任务全军覆没:GDPx 核心信息速览
GDPx 首期覆盖 11 个专业领域、206 项任务,默认每项任务最长 8 小时,测试的是“模型 + Agent 框架 + 工具 + 工作环境”的整体表现。综合榜第一名 Claude Opus 5.5 的得分也只有 12.0%。在这一背景下,金融和法律是两个最“刺眼”的领域。
| 信息项 | 金融领域 | 法律领域 |
|---|---|---|
| 任务数量 | 24 项 | 20 项 |
| 专业合作方 | Living Context | Chakra |
| 公开案例 | Bellwood-QoE(收益质量分析工作簿) | quillon-series-b-redline(B 轮章程修订) |
| 公开案例执行次数 | 25 次选定执行 | 4 个模型共 20 次执行 |
| 完整通过次数 | 0 次 | 0 次 |
| 严格二元评分 | 0% | 0% |
| 部分得分表现 | 最佳单次通过 11 项检查中的 8 项 | 平均 18%,最高单次 57% |
阅读这张表时需要注意两点。第一,二元分数为 0% 并不代表所有执行成果都没有价值,部分得分明确不是零。第二,表中的 25 次和 20 次执行属于单个公开案例的测试,并不是整个金融领域的 24 项任务或法律领域的 20 项任务只跑了这么多次。
金融和法律任务为什么采用严格验收
两个领域的交付物都是“可以直接放进真实交易流程的文件”,而不是一段建议。在并购尽调或融资谈判中,一个净债务口径错误或一条可被绕开的保护条款,都可能让整份文件失去可用性。正因为如此,GDPx 采用了接近专业交付的严格验收方式,这也是 0% 出现的直接原因。
金融任务案例:Bellwood-QoE 如何让 AI 算对数却交不出合格结果
交易背景与任务要求
Living Context 把真实交易经验改造成匿名化测试环境:私募股权基金 Bannock Capital 收购 Haverly Snack Company 约 62% 的股权,交易金额约 8.8 亿美元,另有或有对价安排。整个环境约有 4000 份匿名文件,涵盖财务总账、银行账单、工资资料、应收账款账龄、合同往来、交易协议、历史调整表和多方顾问工作资料。
模型要接手一份未完成的收益质量分析(QoE)工作簿。它需要识别哪些已有数据正确,修正错误的数字和分类,同时保留正确条目和计算结构。此外还要检查 EBITDA 调整、对齐 12 个月营运资金、处理净债务口径、为每项调整提供文件证据,并保证表格之间的引用一致。交付物是修订后的工作簿本身。
Bellwood-QoE 实测成绩
| 模型 | 11 项验收检查平均通过数 | 是否完整通过 |
|---|---|---|
| GPT-6.1 Sol | 5.6 项 | 否 |
| Claude Opus 5.5 | 5.4 项 | 否 |
| GPT-6 Astra | 5.4 项 | 否 |
| GLM 5.3 | 不足 2 项 | 否 |
| Grok 4.7 | 不足 2 项 | 否 |
| 最佳单次执行 | 8 项 | 否 |
最强的几个模型平均能做对约一半检查,最好的一次做对了 8 项。但只要剩下的检查里有关键财务错误,整份工作簿就不能交付。下面三类错误说明了问题出在哪里。
金融错误一:418 美元调整被扩大解释
一笔已经被豁免的 418 美元保险审计调整,被部分模型理解成“此前整个工伤保险保单义务已经结束”。结果是过去 12 个月的 EBITDA 被低估了 4728 美元。在 Opus、Astra、Sol 的 15 次相关执行中,有 10 次出现了这种误判。
这不是乘法算错。模型把一项具体调整的会计和法律含义,扩大成了对整个历史保险责任的判断。4728 美元的偏差来自这一误判造成的后果,并不是 418 美元的某个倍数。这种错误很难通过“反复验算”被发现,因为算式本身可能是对的。
金融错误二:交易费用被混入净债务
有 15 次执行把银行家的成功费用计入了净债务,但交易购买协议已经规定,这笔费用应作为单独的交易费用处理。模型能找到这笔费用,也能做对加减运算,却没有采用具有约束力的协议口径。
这就是“数据存在”与“业务分类正确”之间的差距。在并购中,净债务通常会影响买方实际支付的金额,分类错误的影响不只停留在表格里。
金融错误三:漏掉应调整的费用
研究团队还发现了一组更隐蔽的问题,具体如下:
- 17 次执行仍把未实际工作的家庭成员薪酬当作企业正常经营费用;
- 多数执行没有识别只记载在总账备忘栏里的业主个人费用;
- 最强模型的 15 次执行中,有 10 次遗漏了一笔 9192 美元的历史促销费用调整,把本属于其他期间的费用算进了当前 12 个月。
这些错误同时涉及会计期间、费用性质、证据来源和交易的经济实质。收益质量分析的意义,正是要剥离这类“看起来像经营费用、其实不是”的项目。漏掉它们,EBITDA 就无法反映企业真实的盈利能力。
法律任务案例:B 轮融资章程修订为何 20 次全部不可用
法律任务要求
在 quillon-series-b-redline 任务中,AI 代表 B 轮融资的领投方,修改拟签署的公司章程。输入材料包括已签署的投资条款清单、股权结构表、客户邮件、章程草稿和相关交易材料。成功的标准是保护投资人的合法权益,同时不能无故改动已经谈妥的商业条件。这是一项需要多文件对照的法律判断任务,而不是文案润色。
法律案例成绩与三类关键失误
| 指标 | 结果 |
|---|---|
| 完整达到可用标准 | 0/20 次 |
| 平均部分得分 | 18% |
| 各模型部分得分 | Opus 5.5 为 44%,GPT-6 Astra 为 25%,Gemini 4 Argon 为 2%,GLM 5.3 为 0.5% |
| 最高单次部分得分 | 57%(Opus 5.5) |
| 未识别股东投票可移除保护条款 | 13/20 次 |
| 未防住子公司绕行 | 20/20 次 |
| 未指出客户邮件与条款清单冲突 | 14/20 次 |
需要说明的是,18% 是这一案例相关运行的平均部分得分,不是 GDPx 法律领域的整体统一得分。
错误一:只读条款,不算票数。 13 次执行没有发现其他股东拥有足够的投票权,可以移除领投方需要的保护条款。章程里写着保护性条款,并不代表这项保护真的稳固。只有结合股权结构表计算投票权,才能判断这项条款能否被推翻。
错误二:只改字面,不防绕行。 20 次执行全部没有有效防止公司借助子公司绕开章程中的投资人保护限制。条款约束的是公司本身,如果没有覆盖子公司,实际业务就可以换一个主体来做。理解条款的字面意思,不等于识别出规避它的现实路径。
错误三:把邮件当成最终协议。 14 次执行直接采纳了客户邮件中的期望条款,却没有指出这些要求与已签署的条款清单存在冲突。这样修改,相当于单方面重新谈判已确定的交易条件。合格的做法是识别冲突并提示用户,而不是照单全收。
法律评分如何控制可靠性
Chakra 的评分设计包括:由法律专业人员制定要求,使用有效、无效和部分正确的样本校准评分准则,人工复核有争议的判定,并检查评分模型的偏差。每份输出会被评分五次,并跟踪各验收项结果的一致性。不过,这属于合作方描述的内部质量控制,不等于已有完全独立的机构验证了评分不存在误判。
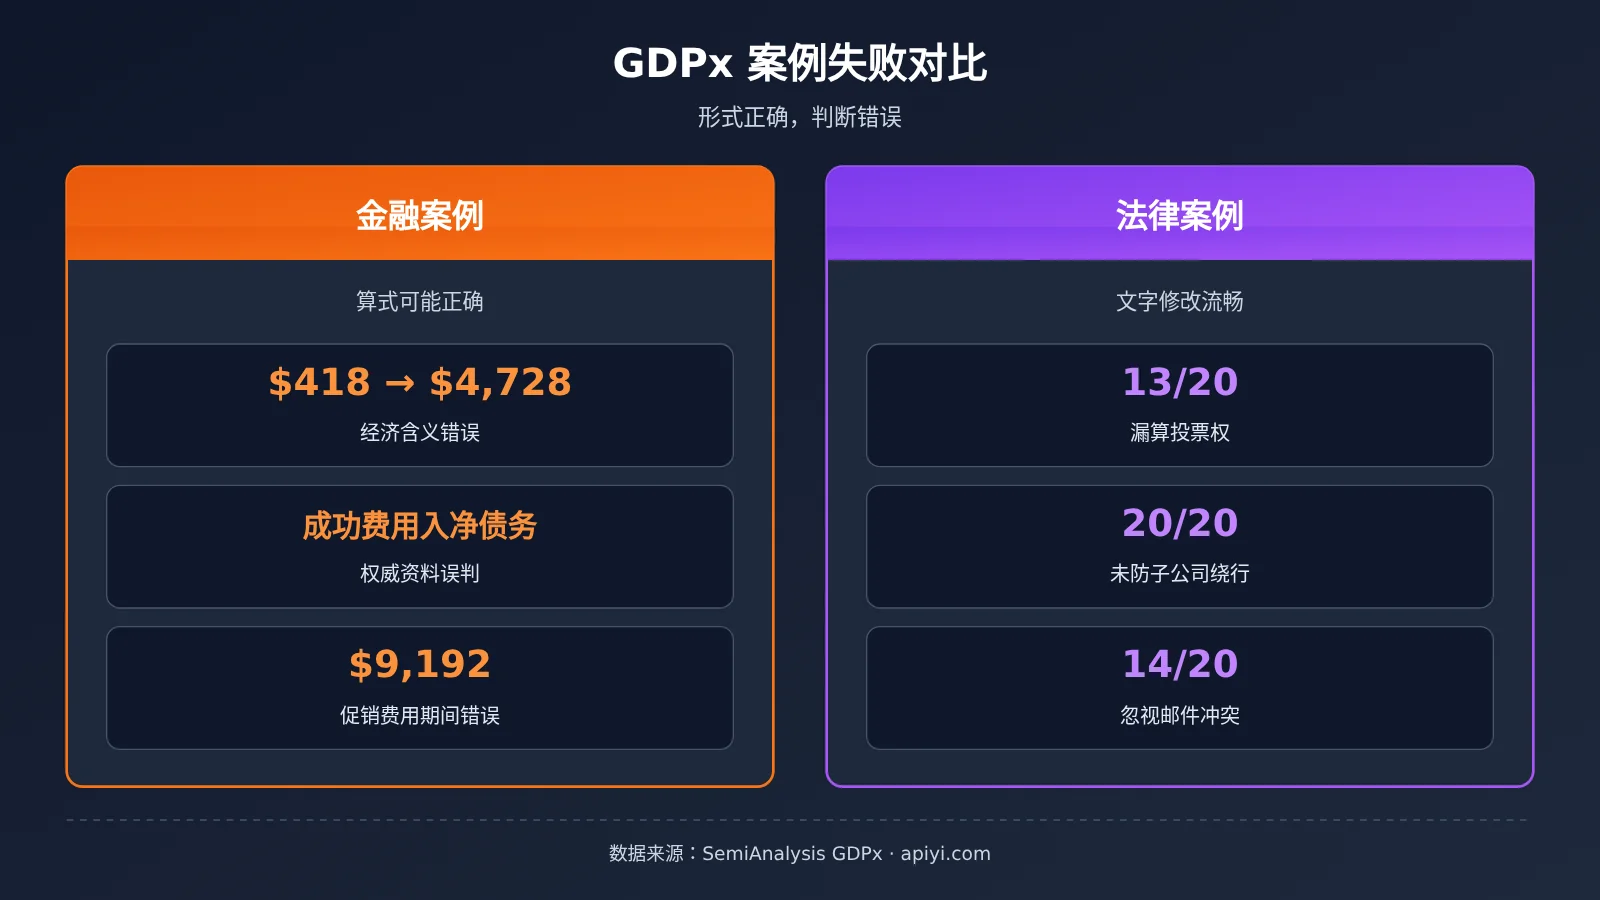
金融和法律任务失败的共同原因:不是写不出来,而是判断不对
Living Context 把金融案例的常见错误归纳为四类,这与法律案例的观察高度吻合:
| 失败模式 | 金融案例表现 | 法律案例对应 | 专业启示 |
|---|---|---|---|
| 资料权威性判断错误 | 偏信数字写得最明确的旧表,忽略已签署协议 | 把客户邮件置于条款清单之上 | 先建立“文件效力优先级” |
| 忽视二阶影响 | 计算完成,却漏掉对税务、债务、交易义务的影响 | 改了保护条款,没算投票结构 | 每项修改都要追问下游影响 |
| 只查算式,不查假设 | 加减乘除反复验证,业务前提却是错的 | 文字严谨,却没覆盖子公司路径 | 审查前提比审查计算更重要 |
| 修改时破坏原有结构 | 把公式硬编码为数字,切断表间关联 | 改动已谈妥的商业条款 | 交付物要“改对且不改坏” |
这些是研究团队总结的失败模式,并不是所有企业财务模型或法律文书的统一错误率。它们揭示的共同点是:关键困难往往不在于生成文本,而在于资料选择、专业推理、隐含约束、跨文件一致性以及最终验收。模型回答越流畅,越容易让人忽略这些问题。
金融和法律 AI 应用影响分析:如何区分辅助与交付
对企业 AI 负责人与开发者的影响
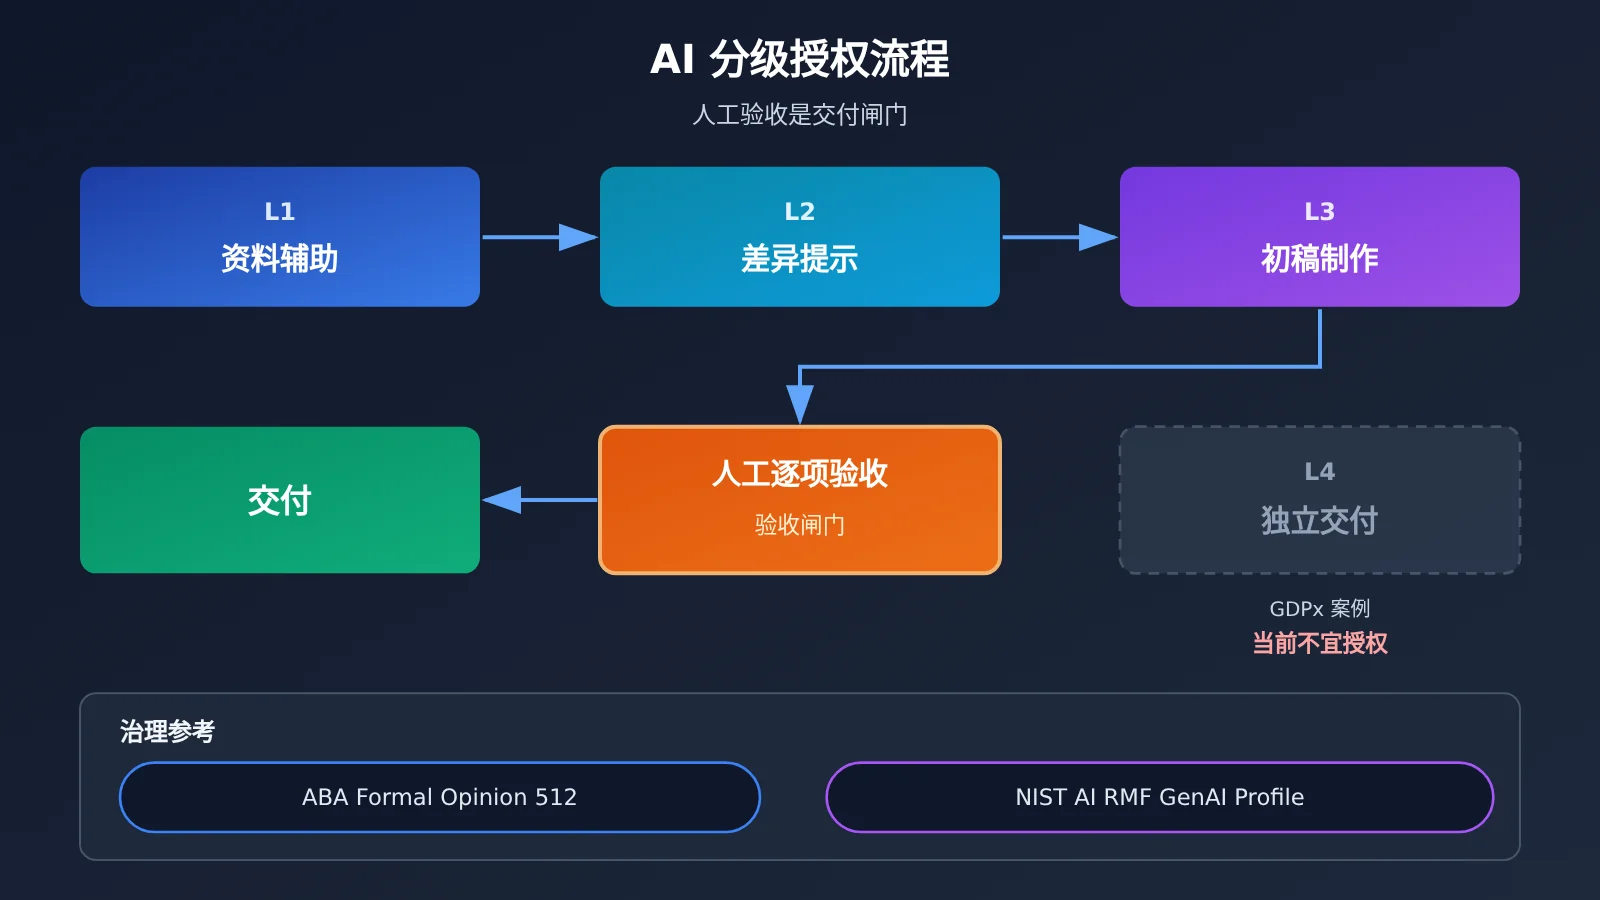
GDPx 并没有否定 AI 辅助专业工作的价值。部分得分说明,模型已经能完成一定比例的验收要求。但研究没有给出依据来证明人工参与时能节省多少时间或成本,因此不应把案例结论直接换算成 ROI。更务实的做法是按风险分级授权,可以参考下表:
| 授权级别 | 典型用途 | 人工角色 | 验收方式 |
|---|---|---|---|
| L1 资料辅助 | 初步资料整理、异常数据检查 | 抽查 | 结果仅作线索 |
| L2 差异提示 | 条款与数据差异提示、冲突清单 | 逐条确认 | 专业人员判定真伪 |
| L3 初稿制作 | 工作簿修订初稿、章程 redline 初稿 | 全量复核 | 按清单逐项验收 |
| L4 独立交付 | 直接对外签署或提交 | — | GDPx 案例显示当前不宜授权 |
这套分级与外部规范方向一致。美国律师协会(ABA)在 2024 年 7 月 29 日发布 Formal Opinion 512,指出律师使用生成式 AI 时仍须考虑职业能力、客户信息保密、沟通、监督和合理收费等责任,并应理解工具的能力与限制,不能未经核查就采用输出。美国 NIST 于 2024 年 7 月 26 日发布的 AI RMF 生成式 AI Profile 也强调,组织应根据使用情境安排人工监督、评估、记录与治理。需要注意,ABA 意见属于美国律师职业道德指导,NIST 文档也不是 GDPx 的测试结果,二者只能作为跨领域参考。
用 API 搭建“冲突提示”型辅助流程
GDPx 法律案例中最常见的失误之一,是没有指出客户邮件与已签署条款之间的冲突。这类“找差异、提问题”的工作恰好适合 L2 级辅助,前提是输出只作为供人工确认的线索。下面的示例让模型对照两份文本,列出冲突和需要人工确认的事项:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
查看完整实现代码(多模型交叉提示 + 人工审查清单)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 调用多家模型
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """用多个模型分别生成审查线索,便于人工交叉比对"""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # 最终是否采纳,由律师或财务专业人员按验收清单逐项判定
🚀 快速上手建议:搭建这类辅助流程时,可以先通过 API易 apiyi.com 用同一个 API Key 接入多个主流模型,在自己的脱敏样本上交叉比对冲突提示的召回情况。新用户可以使用免费测试额度做小规模验证,再决定是否进入流程试点。
对金融与法律科技行业的影响
GDPx 的结果提醒行业,评估专业 AI 产品时不能只看对话演示是否流畅,而要看最终交付物能否通过专业验收。对于供应商来说,产品的竞争力会更多体现在“权威文件优先级”“冲突提示”“保留原有公式结构”“证据溯源”这些工程细节上。对于采购方来说,应当用接近自身业务的任务独立测试。GDPx 本身也只公开了部分任务和执行轨迹,仍需要更多外部审查与复现。
💡 选型提示:不同模型在不同领域的表现差异明显,单一综合排名不能代表你的业务。建议通过 API易 apiyi.com 的统一接口,在自己的任务上并行测试多个模型,同时记录部分得分和关键项通过情况,不要只看平均分。具体模型是否可用,请以平台实时列表为准。
常见问题 FAQ
Q1:金融和法律任务“全军覆没”是指 AI 什么都没做对吗?
不是。0% 是严格二元验收下的结果,意思是没有一次执行满足全部关键要求。金融案例中最佳单次执行通过了 11 项检查中的 8 项,法律案例中 Opus 5.5 的平均部分得分为 44%。部分完成和合格交付是两套标准。
Q2:为什么 AI 能算对数,结果还会错?
因为错误常常出在业务前提,而不在算式本身。例如 418 美元的豁免调整被扩大解释为整份保单义务终止,导致 EBITDA 被低估 4728 美元;银行家成功费用的金额找对了,却被归入了净债务。反复验算无法发现这类错误。
Q3:GDPx 的结论能推广到所有金融和法律 AI 应用吗?
不能。这些结果来自特定的高难度任务和评分规则,案例归纳出的失败原因也不能扩大为全行业结论。难度较低或有人工协作的应用,需要单独评估。
Q4:现阶段 AI 适合承担哪些金融和法律工作?
比较合理的方向包括初步资料整理、条款与数据差异提示、初稿制作、异常数据检查以及辅助建立审查清单。是否适合具体业务,需要结合风险等级和专业验收标准独立测试。
Q5:如何低成本验证某个模型在自己业务上的表现?
可以按以下步骤进行:
1. 准备若干脱敏的真实样本,并为每个样本写好逐项验收清单;
2. 在 API易 apiyi.com 注册并获取 API Key,使用免费测试额度;
3. 将本文代码的 base_url 设为 `https://api.apiyi.com/v1`,并行调用多个模型;
4. 分别记录部分得分和关键项是否通过,由专业人员最终判定。
Q6:GDPx 报告的任务成本能当作 API 报价参考吗?
不能。GDPx 中的美元金额是基准运行条件下平均每项任务的成本,不是任何平台的统一收费。实际费用应以所用平台的实时价格和自身调用量为准,可以在 API易 apiyi.com 控制台查看按量计费明细。
金融和法律任务 AI 评测核心要点 Key Takeaways
- 严格验收结果为零:GDPx 金融与法律领域在二元标准下没有任何模型完整通过。
- 部分得分并非零:金融案例最佳单次通过 8/11 项检查,法律案例最高单次得分 57%。
- 错误在判断,不在计算:418 美元调整的误读导致 EBITDA 被低估 4728 美元。
- 权威性优先级是关键:14/20 次执行把客户邮件置于已签署条款清单之上。
- 隐含约束最难覆盖:子公司绕行风险在 20/20 次执行中都没有被防住。
- 三种概念不能混用:部分得分、完整通过和生产可用需要分别评估。
- 先辅助、再试点:可以通过 API易 apiyi.com 多模型统一接口,在自有样本上做分级验证。
总结
GDPx 金融和法律任务的核心启示可以归纳为三点:
- 流畅不等于合格:表格算得对、条款写得顺,仍可能在经济实质、权益结构和文件冲突上出错;
- 专业交付靠判断:资料权威性、二阶影响、隐含约束和跨文件一致性,才是专业工作的难点;
- 授权要分级、验收要清晰:参考 ABA 与 NIST 的思路,保留人工审查,把 AI 放在辅助和初稿的位置。
AI 已经能在复杂专业任务中完成一部分有价值的工作,但距离独立承担责任的交付还有明显差距。如果你正在评估金融或法律场景的 AI 方案,推荐通过 API易 apiyi.com 在自己的业务样本上对比多个模型的部分得分与关键项通过率,再决定授权边界。
📚 参考资料
- SemiAnalysis GDPx 原始报告:金融及法律章节、案例与失败模式
- 链接:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
说明: Bellwood-QoE 与 quillon-series-b-redline 案例数据的一手来源
-
GDPx 领域说明与公开执行轨迹:任务数量、合作方与 Agent 轨迹
- 链接:
gdpx.semianalysis.com/domains、gdpx.semianalysis.com/rollouts -
说明: 可以查看部分公开任务的执行过程
-
ABA Formal Opinion 512 新闻说明:律师使用生成式 AI 的职业道德指导
- 链接:
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
说明: 适用于美国律师行业,可作为人工审查原则的参考
-
NIST AI RMF 生成式 AI Profile:生成式 AI 风险管理框架
- 链接:
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - 说明: 关于人工监督、评估与治理措施的跨领域参考
作者:APIYI 技术团队
技术交流:欢迎在 API易官网首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心