作者注:系统讲解 Agent 上下文自动压缩的 3 种触发时机、摘要保留策略与可运行代码,帮你在长对话中控制 Token 消耗,同时不丢失关键任务信息。
在 Codex 这类编码 Agent 里连续工作几个小时后,很多开发者会冒出同一个疑问:输入框附近只显示权限模式和当前模型,看不到上下文用了多少,那到底什么时候该新开一个窗口?对话越长,每一轮请求都要带上更多历史,额度消耗自然更快。本文要讲的是 Agent 上下文自动压缩(Context Compaction)的触发时机与摘要策略,帮助你理解 Codex 一类工具背后的机制,并在自己的 Agent 里实现同样的能力。
这不是又一篇“记得清理聊天记录”的泛泛建议,而是基于 OpenAI 与 Anthropic 官方文档中已公开的压缩机制,结合工程实践整理出的可落地方案。
核心价值:读完本文,你将清楚 Agent 上下文自动压缩在什么时候触发、摘要里该保留什么、该丢掉什么,并拿到一份可以直接改造使用的 Python 实现。
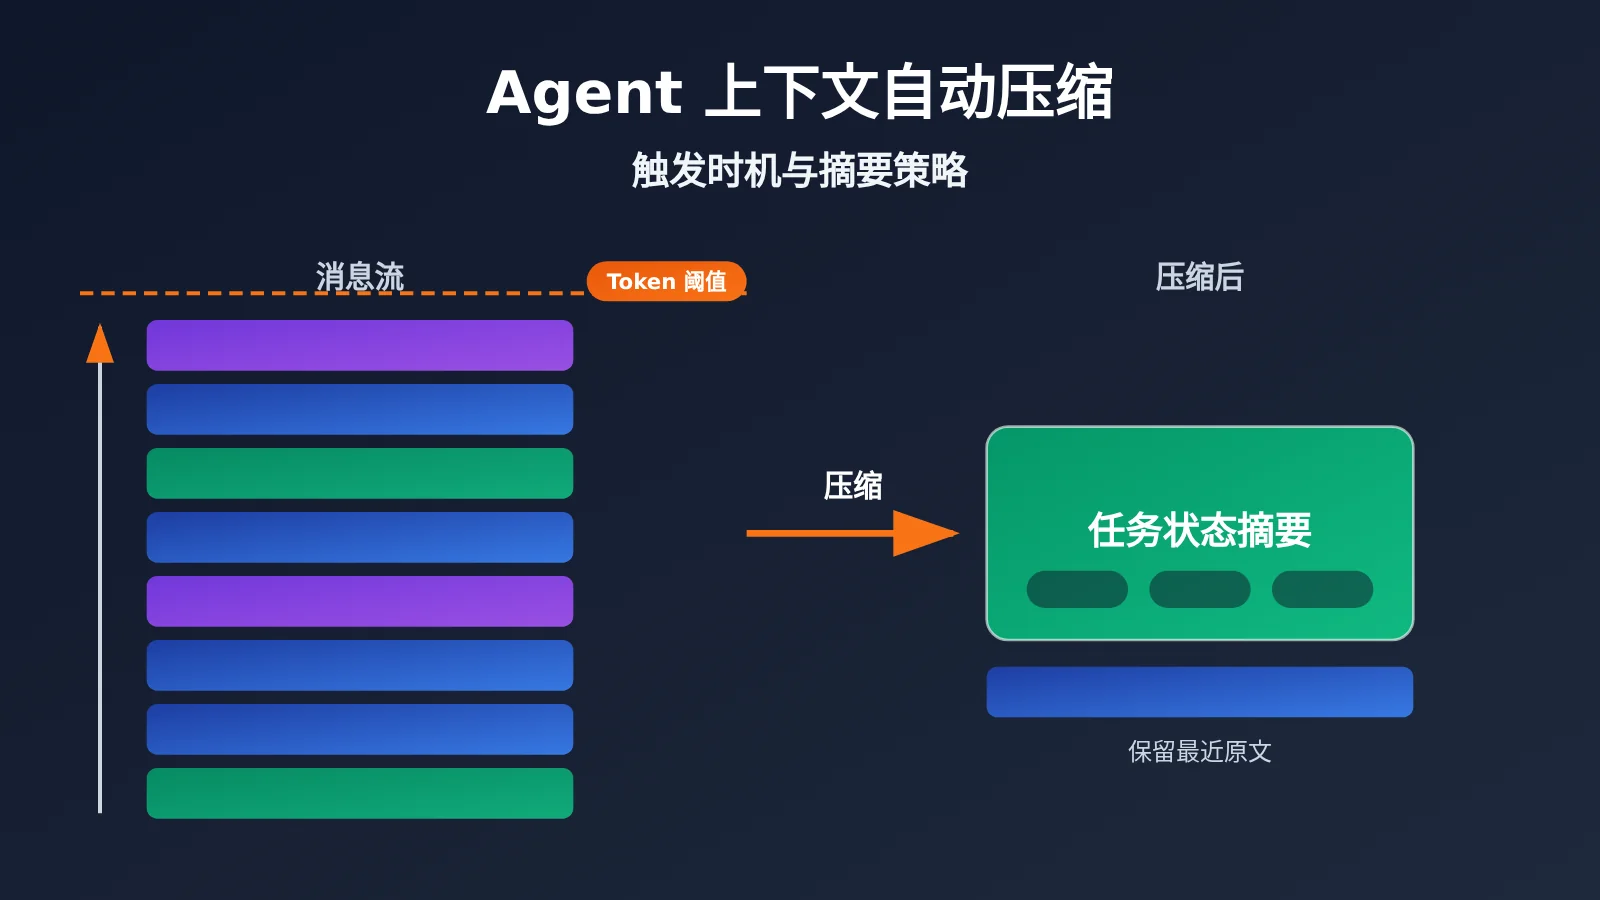
Agent 上下文自动压缩核心要点
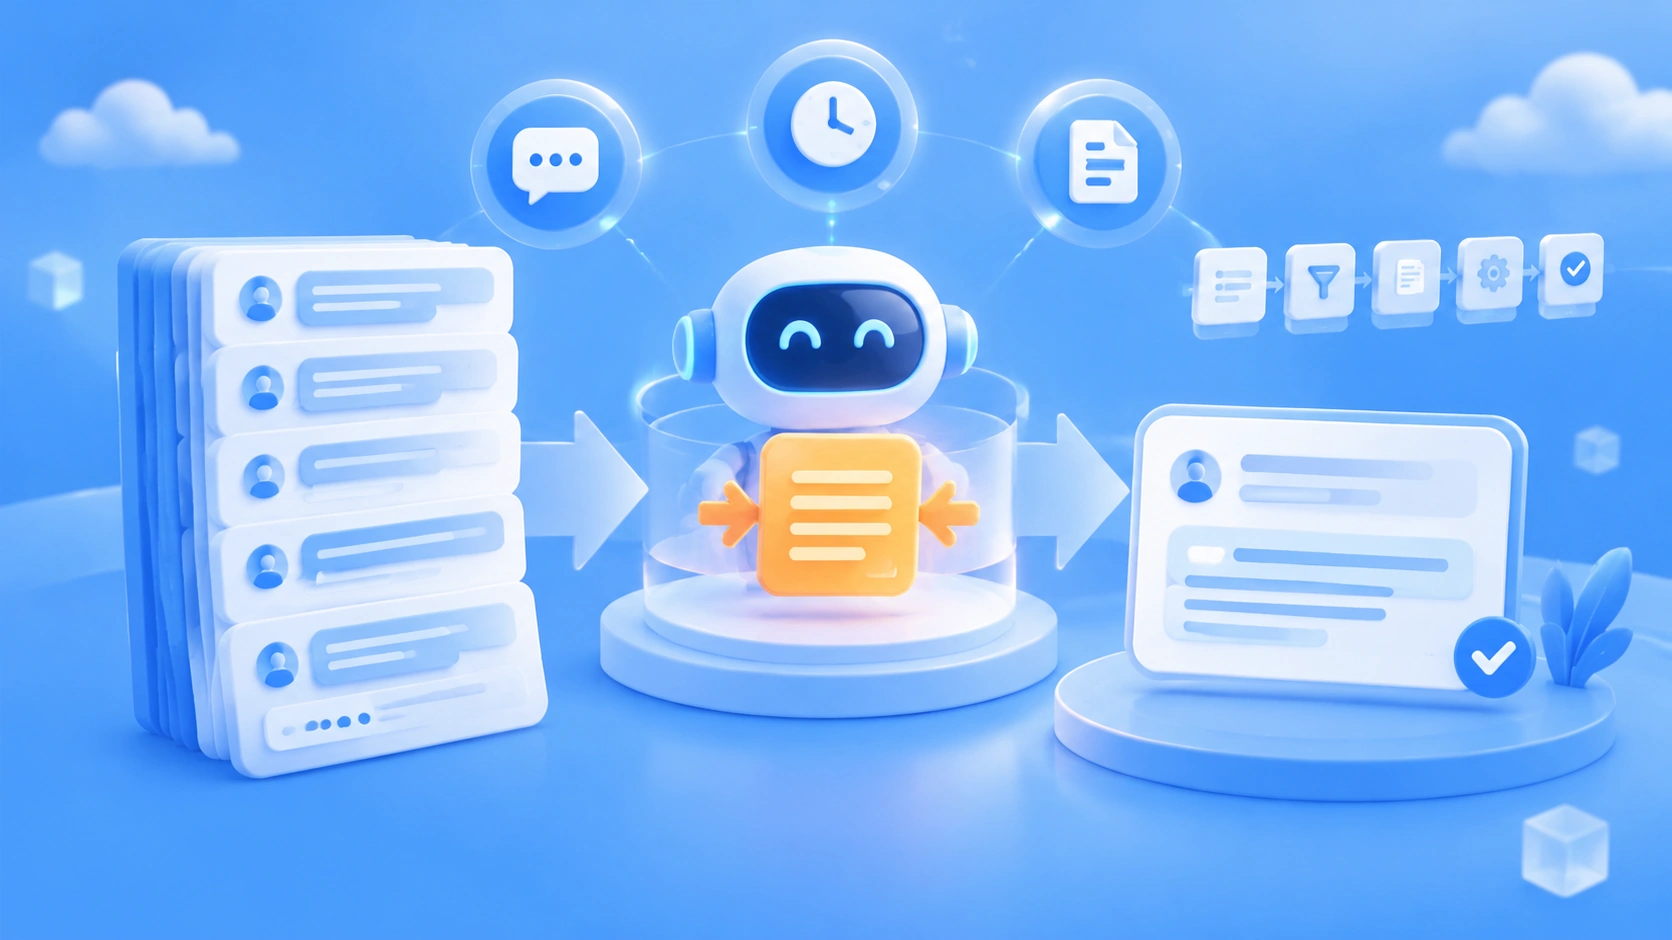
先给出结论:Agent 上下文自动压缩通常在上下文达到指定 Token 阈值时触发,把较早的对话和工具调用记录压缩成一份“还能继续干活”的状态描述。它的目标不是单纯缩短聊天记录,而是保住任务进度、重要事实、已完成操作、关键决策和下一步行动,同时去掉冗余的过程信息。
| 要点 | 说明 | 价值 |
|---|---|---|
| Token 阈值触发 | 上下文达到预设 Token 数后自动压缩 | 无需人工干预,防止撑爆窗口 |
| 主动压缩 | 应用在特定时机(如完成一个任务阶段)主动调用压缩 | 在语义边界压缩,信息损失最小 |
| 框架自动管理 | 由 SDK 或 Agent Runtime 根据上下文压力决定 | 开箱即用,适合快速搭建 |
| 摘要而非截断 | 保留进度、事实、决策、下一步 | 压缩后 Agent 仍能接着执行 |
| 按阶段压缩 | 不建议每轮都压缩 | 兼顾缓存命中与信息完整度 |
为什么 Agent 需要上下文自动压缩
大模型 API 本身是无状态的。所谓“多轮对话”,本质上是每一轮都把完整的 messages 历史重新发给模型,所以第 50 轮的请求里包含前 49 轮的全部内容,输入 Token 呈线性甚至更快地增长。对 Agent 来说情况更严重,因为工具调用的返回结果(文件内容、终端输出、搜索结果)往往非常长,几轮工具调用就能占满大半个窗口。
这带来两个直接问题:一是成本,每轮输入 Token 越多,额度消耗越快;二是质量,上下文过长时模型对早期关键信息的注意力会被稀释,甚至超出窗口直接报错。Agent 上下文自动压缩就是在这两个问题之间找平衡:在信息还完整、窗口还没满的时候,把历史“折叠”成一份精炼的状态,让后续请求轻装上阵。
关于 Codex 不显示上下文用量
客户端为什么不再显示上下文窗口大小,我们没有看到官方给出的明确解释,这里不做猜测。可以确定的是,Codex 自带上下文压缩机制,长对话不会无限制地累积全部原始历史。如果你想精确观察每一轮的消耗,最可靠的办法是在 API 层面看调用日志,后文会讲具体做法。
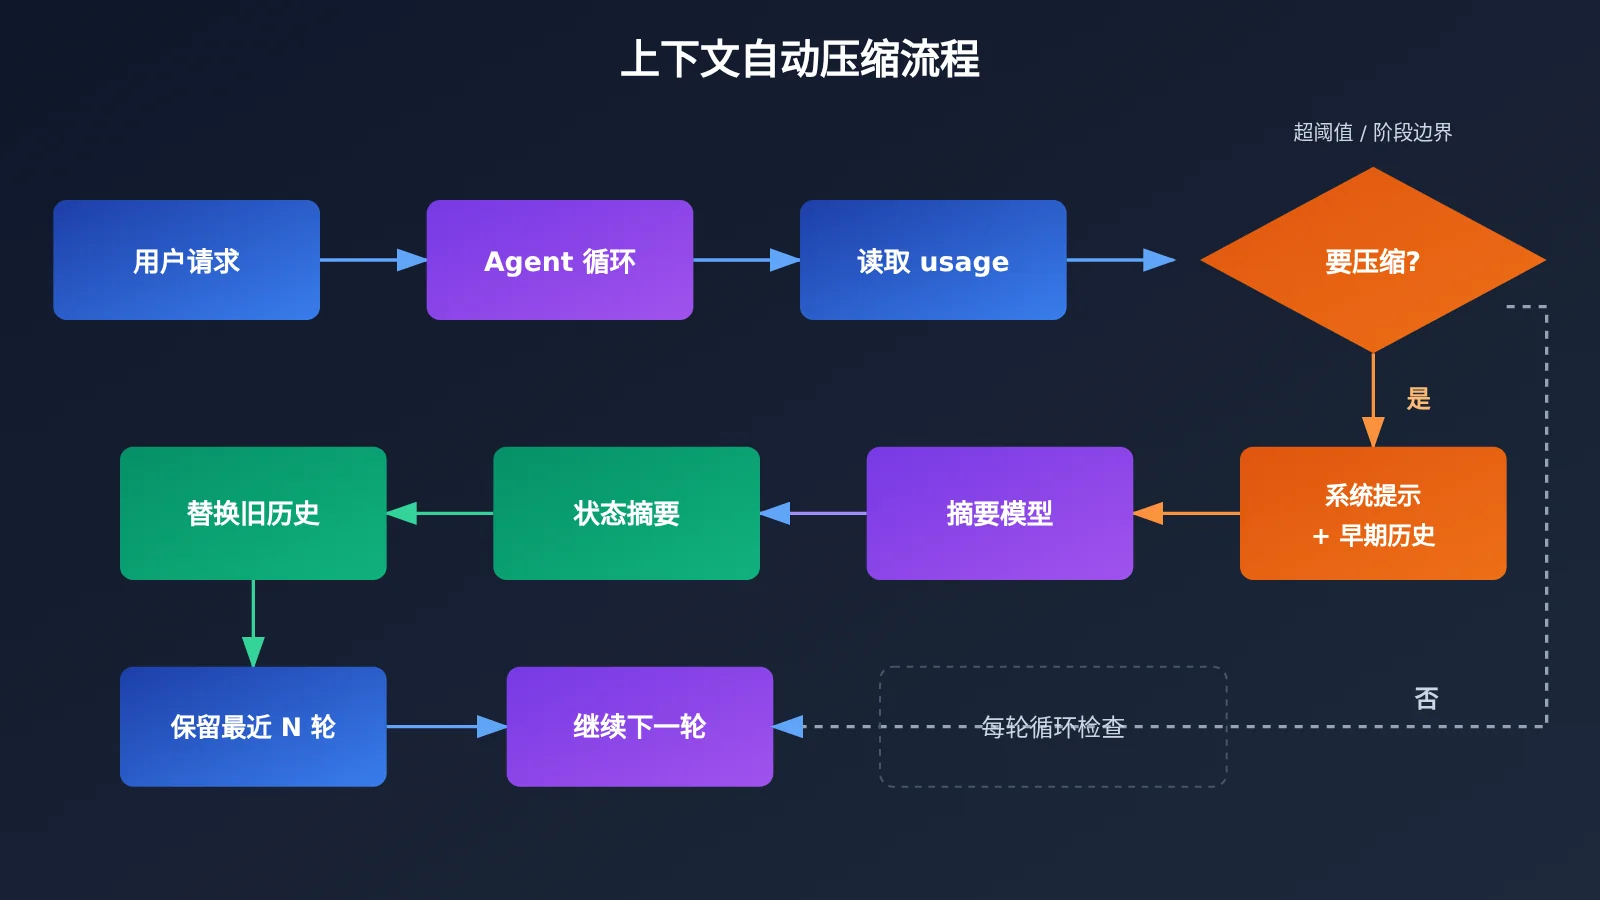
Agent 上下文自动压缩的 3 种触发时机
很多人默认“上下文用到 80% 就压缩”,但这其实不是官方规则。官方 API 文档主要以 Token 数量阈值 定义触发条件,而不是固定的窗口百分比。另外,压缩也不一定要等到接近上限,OpenAI 和 Anthropic 都支持主动压缩。
官方实现的触发规则对比
| 实现方式 | 自动触发规则 | 官方说明 |
|---|---|---|
| OpenAI Responses API | 渲染后的 Token 数达到 compact_threshold |
阈值可自定义,服务端自动处理 |
| OpenAI Agents SDK | 上下文压力或显式阈值策略 | 支持自动、固定阈值和强制压缩 |
| Anthropic Messages API | 输入 Token 达到 trigger.value |
默认 150,000,最低 50,000 |
| Anthropic Tool Runner | 达到 context_token_threshold |
默认 100,000 |
| Anthropic 按需压缩 | 应用程序主动发起 | 可在一个完整对话轮次结束后调用 |
从这张表能看出一个共性:自动触发几乎都以“输入 Token 数”为判断依据,阈值可配置;同时都保留了“由应用主动决定何时压缩”的入口。
时机一:Token 阈值触发
这是最基础的保底机制。每轮调用结束后,读取接口返回的输入 Token 数,一旦超过你设定的阈值就执行压缩。阈值不宜贴着窗口上限设,因为压缩本身需要把旧历史再发一次给摘要模型,还要给下一轮的工具输出留出余量。
实践中可以参考 Anthropic 的默认值思路:在长窗口模型上把阈值设在十万 Token 量级,并保证阈值以上仍有足够空间容纳一次完整的工具调用返回。
时机二:任务阶段边界主动压缩
这是信息损失最小的方式。OpenAI 官方建议在完成一个有意义的工作阶段后再压缩,而不是每轮都压缩。比如 Agent 刚完成“定位 Bug → 修改代码 → 跑通测试”这一整段,此时中间的试错过程已经没有价值,只需要记住“改了哪个文件、为什么改、测试已通过”。
在阶段边界压缩,摘要更容易写得准确,因为任务处于一个“干净”的状态,没有半截的工具调用悬而未决。
时机三:交给框架按上下文压力管理
如果你用的是 Agents SDK 或 Tool Runner 这类框架,可以直接开启内置的压缩策略,由运行时根据上下文压力自动决定。这种方式省心,但你对摘要内容的控制力较弱,适合原型阶段或通用场景。
🎯 技术建议:三种时机并不互斥。推荐的组合是“阶段边界主动压缩为主,Token 阈值触发兜底”。如果想在不同模型上验证阈值设置是否合理,可以通过 API易 apiyi.com 用同一个 Key 切换 OpenAI、Claude、Gemini 等模型对比测试。
Agent 上下文自动压缩的摘要策略
触发时机解决“什么时候压”,摘要策略解决“压成什么样”。压缩失败最常见的表现是:压缩后 Agent 忘了用户最初的约束,或者重复执行已经做过的操作。根本原因是摘要只记录了“聊了什么”,而没有记录“任务状态是什么”。
摘要中该保留与可丢弃的内容
| 类别 | 应保留 | 可丢弃 |
|---|---|---|
| 任务目标 | 用户原始需求、硬性约束、验收标准 | 寒暄、重复确认 |
| 任务进度 | 已完成的步骤、当前所处阶段 | 每一步的详细推理过程 |
| 重要事实 | 文件路径、函数名、配置值、报错关键行 | 完整的文件内容、冗长日志 |
| 关键决策 | 选了哪个方案以及原因 | 被否决方案的展开讨论 |
| 下一步行动 | 待办清单、未解决问题 | 已完成且无后续影响的细节 |
5 步落地摘要策略
- 固定保留系统提示词:系统提示不参与压缩,始终放在 messages 最前面。
- 保留最近 N 轮原文:最近几轮对话通常与当前操作强相关,原样保留,只压缩更早的部分。
- 结构化摘要模板:要求摘要模型按“目标 / 进度 / 事实 / 决策 / 下一步”五个栏目输出,避免自由发挥导致遗漏。
- 工具结果先瘦身:对超长的工具返回只保留关键片段,例如报错的首尾几行、搜索结果的标题与结论。
- 用户原话单独存档:用户给出的明确约束(如“不要改动公共接口”)建议逐字保留,不交给模型改写。
结构化模板是其中最关键的一步。模型做“自由摘要”时倾向于概括对话氛围,而结构化栏目会逼它逐项核对,保住可执行的状态信息。
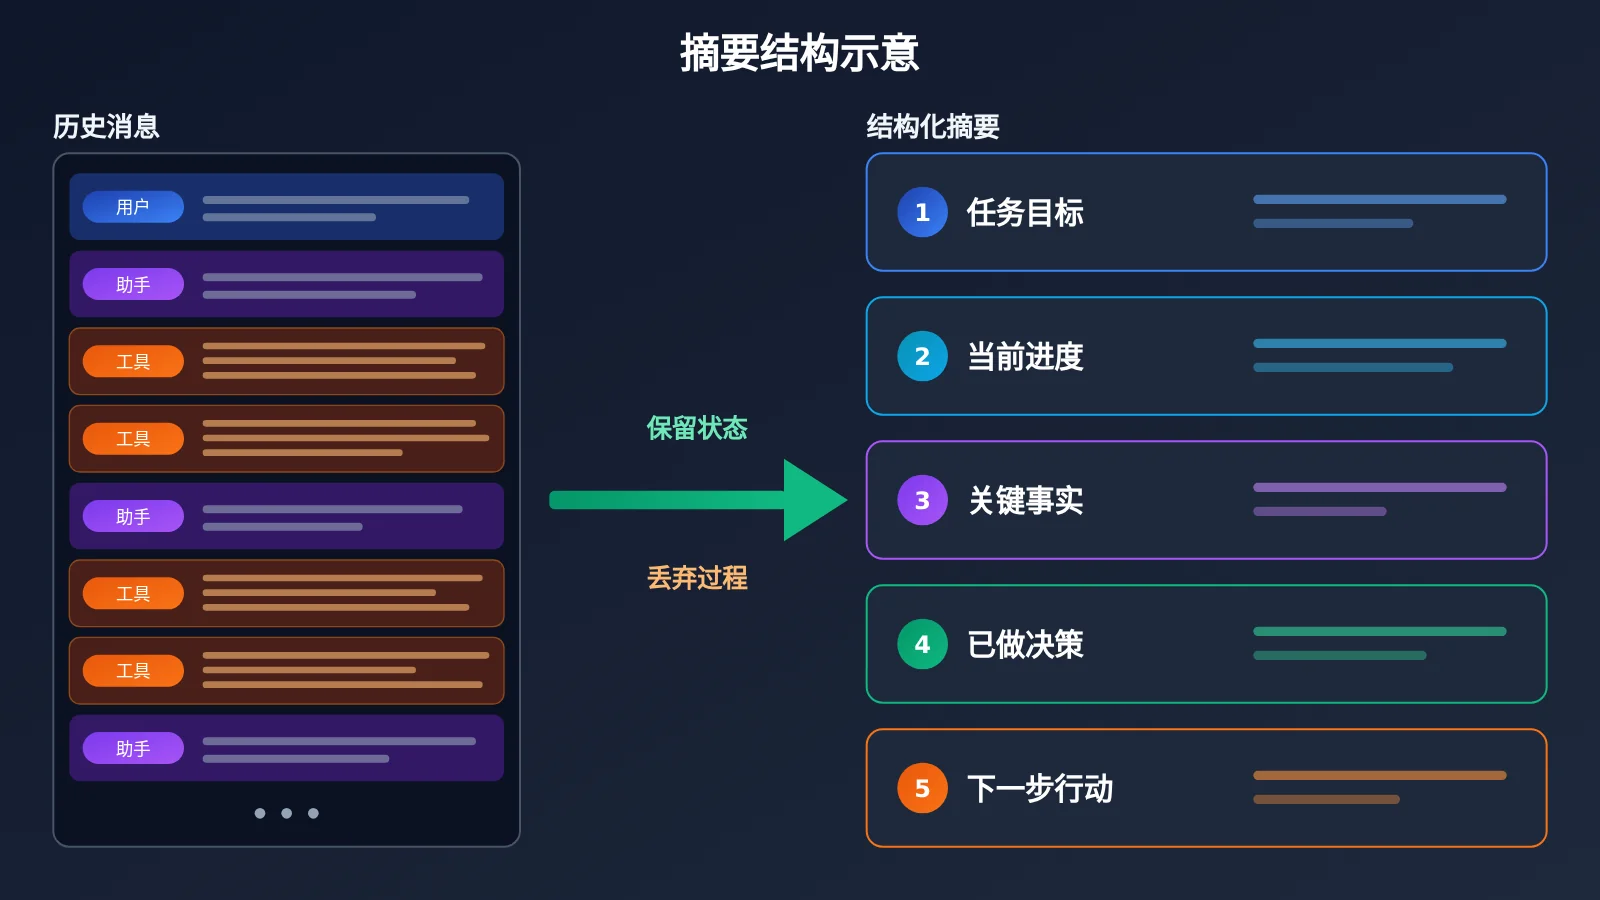
Agent 上下文自动压缩快速上手
下面用客户端手动管理 messages 的方式实现一个通用版本,适用于任何 OpenAI 兼容接口。思路是:每轮调用后从 usage.prompt_tokens 读取输入 Token 数,超过阈值就把早期历史交给摘要模型压缩。
极简示例
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每轮记录输入 Token,作为是否压缩的判断依据
print("本轮输入 Token:", resp.usage.prompt_tokens)
查看完整的 Agent 上下文自动压缩实现代码
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任务模型,可按需替换
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 输入 Token 阈值,兜底触发
KEEP_RECENT = 6                 # 保留最近 N 条消息原文

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 时机一:上一轮输入 Token 超过阈值时先压缩
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 时机二:完成一个任务阶段后主动压缩
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 修复完成后,在阶段边界主动压缩
🚀 快速开始:通过 API易 apiyi.com 注册即可获得免费测试额度,上面的代码只需替换 API Key 就能运行。平台为 OpenAI 兼容接口,主模型和摘要模型可以分别选用不同厂商的模型,方便控制成本。
Agent 上下文自动压缩的实现方案对比
| 方案 | 核心特点 | 适用场景 | 可用平台 |
|---|---|---|---|
| 客户端手动压缩 | 自己拼接 messages,摘要逻辑完全可控 | 自研 Agent、需定制摘要模板 | API易 apiyi.com、各官方 API |
| 服务端阈值压缩 | 如 Responses API 的 compact_threshold |
希望减少客户端状态管理 | 支持该接口的平台 |
| 框架内置压缩 | Agents SDK、Tool Runner 自动管理 | 原型搭建、通用任务 | 依赖对应 SDK |
| 直接新开会话 | 手动总结后开新窗口 | Codex 等客户端日常使用 | 任意客户端 |
客户端手动压缩在控制力上保持领先,但需要自己维护 Token 统计和摘要质量。服务端压缩省去了历史拼接,不过摘要细节对开发者不透明。对于自研 Agent,“客户端结构化摘要 + 阈值兜底”通常是更稳妥的组合。
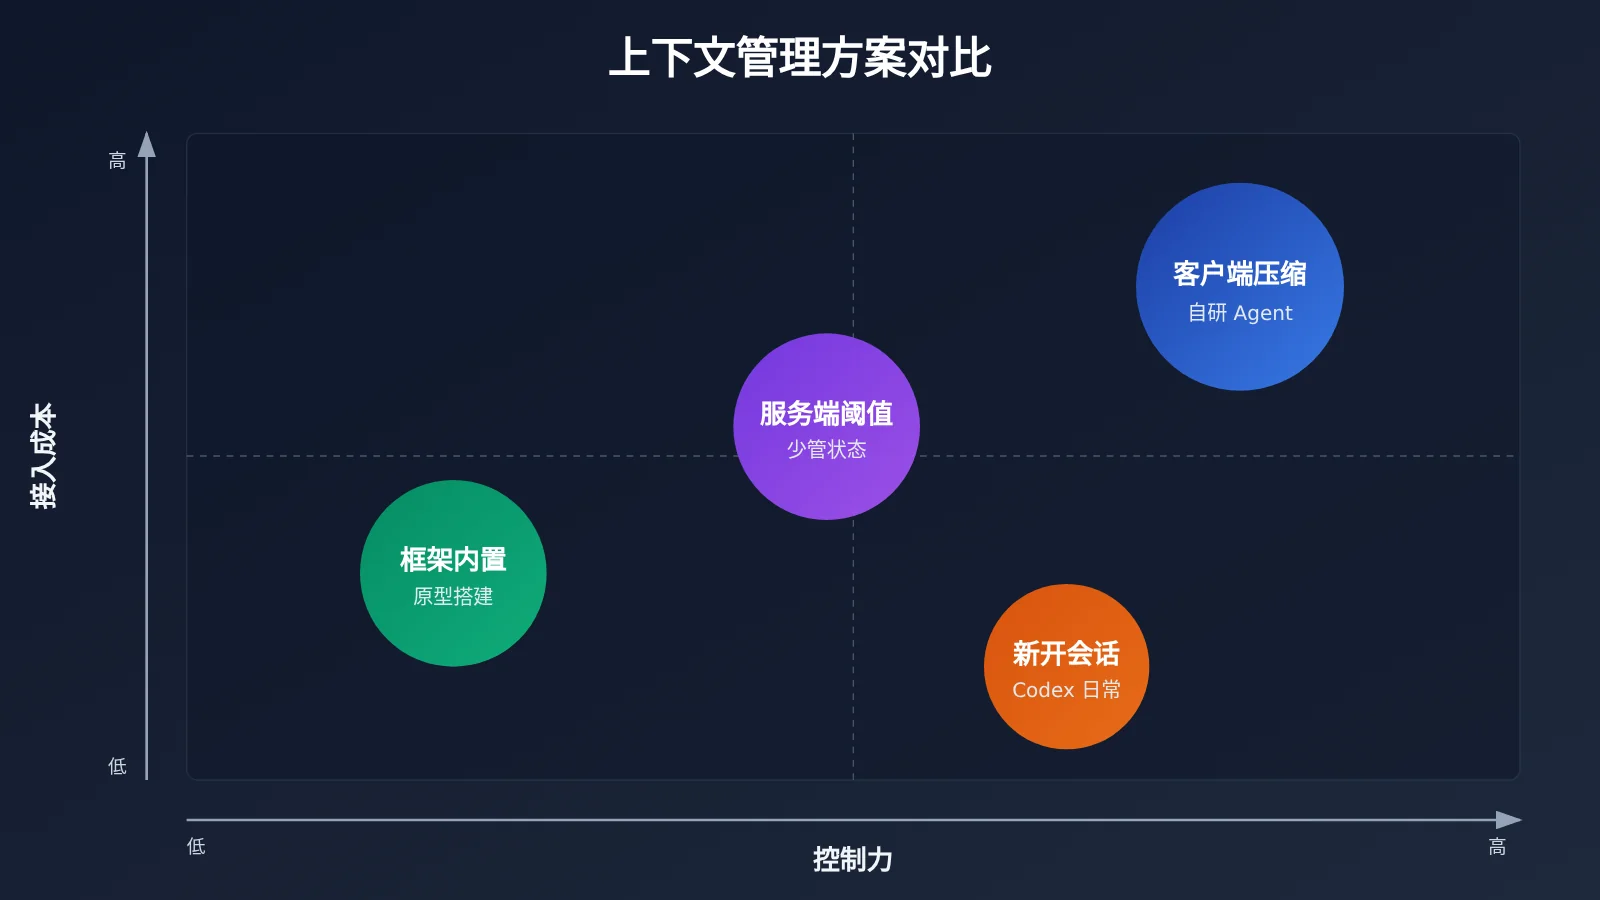
Agent 上下文自动压缩与缓存成本的关系
压缩看上去一定省钱,但还要考虑 Prompt Caching。按照 API易 的 OpenAI 缓存计费说明,缓存命中的输入部分按输入价的 1 折计费。长对话中,历史前缀保持不变时很容易命中缓存,这时每轮新增的“全价”Token 其实并不多。
一旦执行压缩,消息前缀被替换成新的摘要,下一轮请求的缓存会失效,需要按全价重新计算一次。这正是官方不建议“每轮都压缩”的原因:频繁压缩会反复打断缓存,有时反而比不压缩更贵。比较合理的节奏是让历史在一个阶段内稳定增长、充分吃到缓存,到阶段结束或接近阈值时再集中压缩一次。
常见问题 FAQ
Q1: 什么是 Agent 上下文自动压缩?
它是指在上下文达到一定 Token 量或到达任务阶段边界时,把较早的对话、工具调用记录压缩为一份任务状态摘要,替换原始历史。目的是降低每轮输入 Token,同时保留进度、事实、决策和下一步行动,让 Agent 能继续执行。
Q2: 上下文压缩和直接截断历史有什么区别?
截断只是删掉最早的消息,实现简单,但会丢失用户最初的需求和约束。压缩则用模型把历史提炼成结构化摘要,信息保留度高得多。代价是多一次摘要调用,以及压缩后缓存需要重新建立。
Q3: 是否有统一的“用到 80% 就压缩”的规则?
没有。官方文档主要按 Token 数量阈值定义触发条件,例如 Anthropic Messages API 默认 150,000、最低 50,000,Tool Runner 默认 100,000。阈值应结合所用模型的窗口大小和单次工具输出的体量来设置。
Q4: 在 Codex 里什么时候应该新开窗口?
建议在一个完整任务阶段结束后新开,例如一个功能开发完成并通过测试。新开前可以让 Agent 按“目标 / 进度 / 事实 / 决策 / 下一步”输出一份总结,粘贴到新会话开头。如果你要切换到一个和当前任务无关的新话题,也应直接新开窗口,避免无关历史持续消耗额度。
Q5: 客户端不显示上下文用量,怎么观察 Token 消耗?
可以在 API 层面查看。按照 OpenAI Codex 使用场景文档,把 Codex 的接口配置到 API易 后,每次调用都会在 API易 apiyi.com 后台留下详细日志与用量统计,能直观看到长对话中每轮输入 Token 的增长曲线,以此判断何时压缩或新开会话。
Q6: 如何快速验证自己的压缩策略效果?
用本文的完整代码,分别在“不压缩”“阈值压缩”“阶段压缩”三种模式下跑同一个多步任务,对比总 Token 消耗和任务完成质量。通过 API易 apiyi.com 可以用一个 Key 让主模型与摘要模型分别使用不同厂商的模型,便于找到成本与质量的平衡点。
Q7: 上下文压缩有哪些已知的限制?
一是摘要可能遗漏细节,尤其是代码中某个不起眼的配置值;二是每次压缩会让缓存失效,频繁压缩会推高成本;三是摘要模型偶尔会“补全”不存在的信息。应对办法是使用结构化模板、逐字保留用户约束,并把关键事实(如文件路径)写进外部的任务笔记文件而不只依赖摘要。
Agent 上下文自动压缩核心要点 Key Takeaways
- 压缩的本质:把冗长历史转成可继续执行的任务状态,而非简单删减记录。
- 三种触发时机:Token 阈值兜底、阶段边界主动压缩、框架按上下文压力管理。
- 没有 80% 规则:官方以 Token 数阈值为准,阈值需结合窗口与工具输出体量设置。
- 结构化摘要:按目标、进度、事实、决策、下一步五栏输出,用户约束逐字保留。
- 别每轮都压缩:频繁压缩会打断缓存命中,按阶段集中压缩更省钱。
- 用日志弥补盲区:客户端不显示用量时,可在 API易 apiyi.com 调用日志中观察每轮 Token 增长。
总结
Agent 上下文自动压缩的核心要点:
- 触发时机:以阶段边界主动压缩为主,Token 阈值触发作为兜底,框架内置策略适合快速起步。
- 摘要策略:保留系统提示与最近几轮原文,早期历史压缩为五栏结构化摘要。
- 成本平衡:压缩会让缓存失效,节奏应是“阶段内稳定增长、阶段末集中压缩”。
如果你日常使用 Codex,可以把“阶段完成就总结并新开窗口”当作手动版压缩;如果你在自研 Agent,直接改造本文代码即可。推荐通过 API易 apiyi.com 快速验证效果,平台提供免费测试额度和多模型统一接口,配合调用日志能清楚看到压缩前后的 Token 变化。
📚 参考资料
- OpenAI Responses API 文档:上下文压缩与
compact_threshold配置说明 - 链接:
platform.openai.com/docs/api-reference/responses -
说明: 了解服务端自动压缩与状态管理的官方说明
-
OpenAI Agents SDK 文档:Agent 运行时的上下文管理策略
- 链接:
openai.github.io/openai-agents-python -
说明: 自动、固定阈值与强制压缩等策略的配置方式
-
Anthropic 上下文压缩文档:Messages API 与 Tool Runner 的压缩触发参数
- 链接:
docs.anthropic.com - 说明:
trigger.value、context_token_threshold的默认值与按需压缩用法
作者: APIYI 技术团队
技术交流: 欢迎在 API易 网站首页联系我们,Codex 配置、多轮对话与缓存计费等更多资料可访问 docs.apiyi.com 文档中心