最近不少开发者反馈一个“反直觉”的体验:claude-opus-5-5 用起来一点都不慢,很多任务甚至比 claude-sonnet-5-5 更早跑完。既然旗舰模型又快又强,那 Sonnet 是不是只剩下“便宜一半”这一个卖点?答案没那么简单。本文将用 6 组公开数据拆解 claude-sonnet-5-5 对比 claude-opus-5-5 的真实差异,并重点回答一个更实际的问题:在企业级长内容输入、长内容输出的 Agent 场景里,两款模型应该怎样分工搭配。
核心价值: 看完本文,你会知道 Opus “快”的真正原因、Sonnet 除价格外还有哪些硬优势,以及一套可以直接落地的 Opus + Sonnet 双模型 Agent 架构。
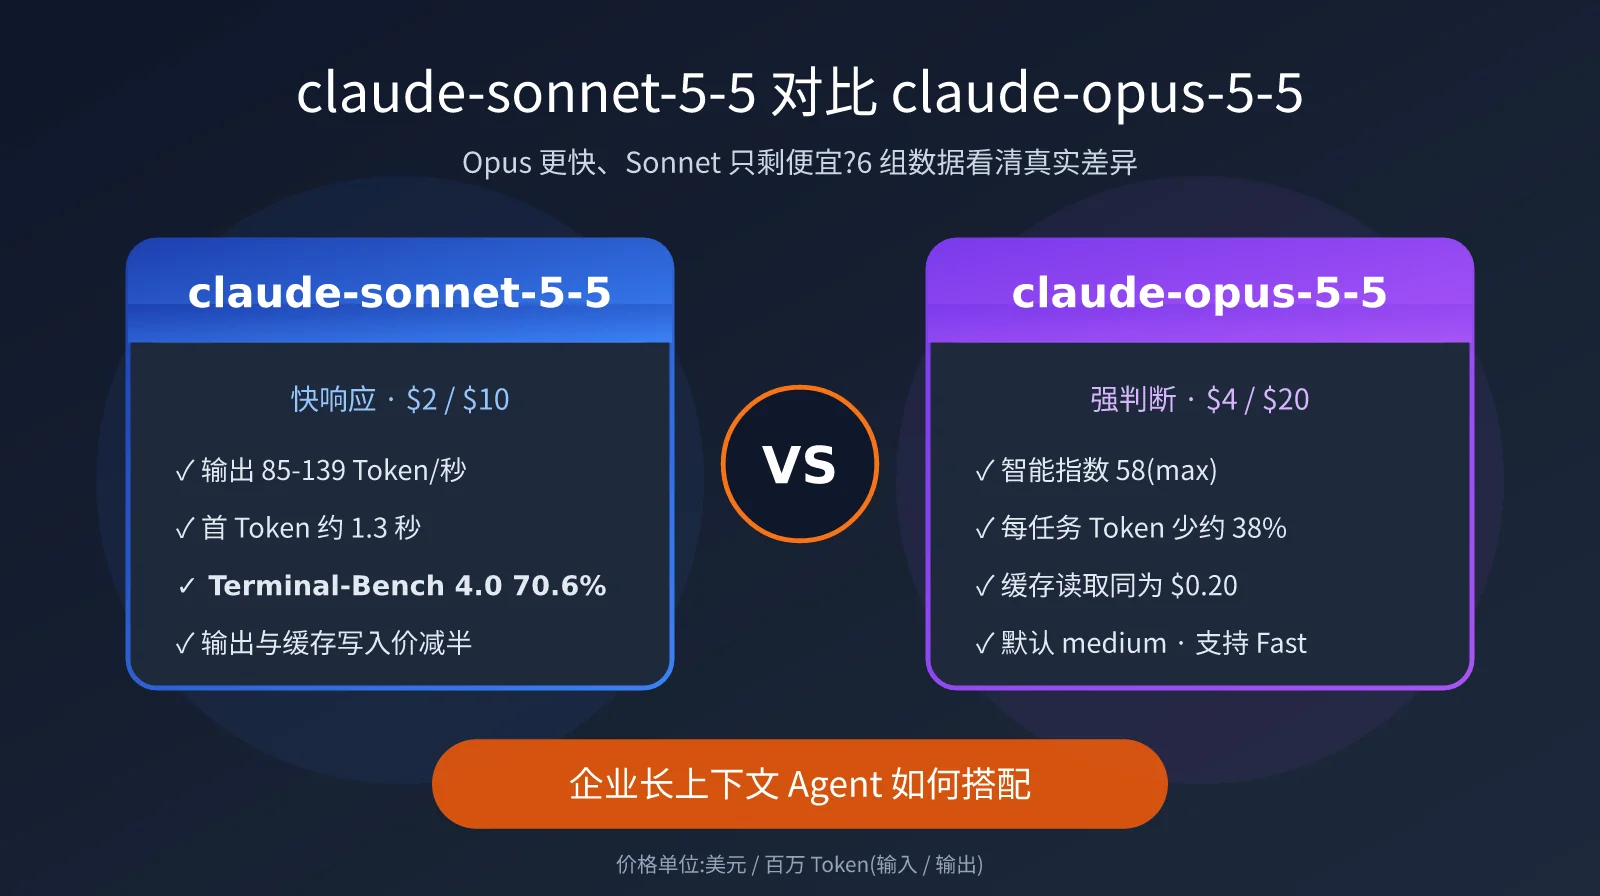
claude-sonnet-5-5 与 claude-opus-5-5 核心参数速览
claude-opus-5-5 于 2026 年 9 月 22 日发布,claude-sonnet-5-5 于 9 月 28 日发布,两者同属 Claude 5.5 家族。这一代最值得关注的变化是 Opus 降价了:标价从 Opus 5 的 $5/$25 下调 20% 至 $4/$20,缓存读取更是从 $0.50 降到 $0.20,与 Sonnet 完全相同。Sonnet 5.5 则延续了 $2/$10 的定价,官方称其单任务成本比上一代最多低约 30%。
| 参数 | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| 发布时间 | 2026-09-28 | 2026-09-22 |
| 输入 / 输出价格 | $2 / $10 | $4 / $20 |
| 缓存读取 | $0.20 | $0.20(基础输入价的 5%) |
| 5 分钟缓存写入 | $2.50 | $5 |
| Batch 价格 | $1 / $5 | $2 / $10 |
| 上下文窗口 | 100 万 Token,无长上下文溢价 | 100 万 Token,无长上下文溢价 |
| 最大输出 | 128K(Batch 测试版 300K) | 128K(Batch 测试版 300K) |
| API 默认推理档位 | high | medium |
| Fast 模式 | 不支持 | 支持,约 2.5 倍输出速度,$8 / $40 |
| 可用平台 | API易 apiyi.com、Anthropic 官方 API | API易 apiyi.com、Anthropic 官方 API |
表格里藏着两个直接影响体验的细节。第一,两者默认推理档位不同,Opus 默认 medium,Sonnet 的 API 默认是 high,这是很多人觉得 Opus 更快的首要原因。第二,缓存读取价格一样,这意味着在大量复用长上下文的 Agent 场景中,两者的输入成本差距会被大幅抹平。
🎯 测试建议: 对比两款模型时一定要显式指定相同的推理档位,否则结论会严重失真。我们建议通过 API易 apiyi.com 用同一个 Key 分别调用 claude-sonnet-5-5 和 claude-opus-5-5,只切换
model与reasoning_effort两个参数即可完成对照测试。
为什么 claude-opus-5-5 用起来比 claude-sonnet-5-5 还快
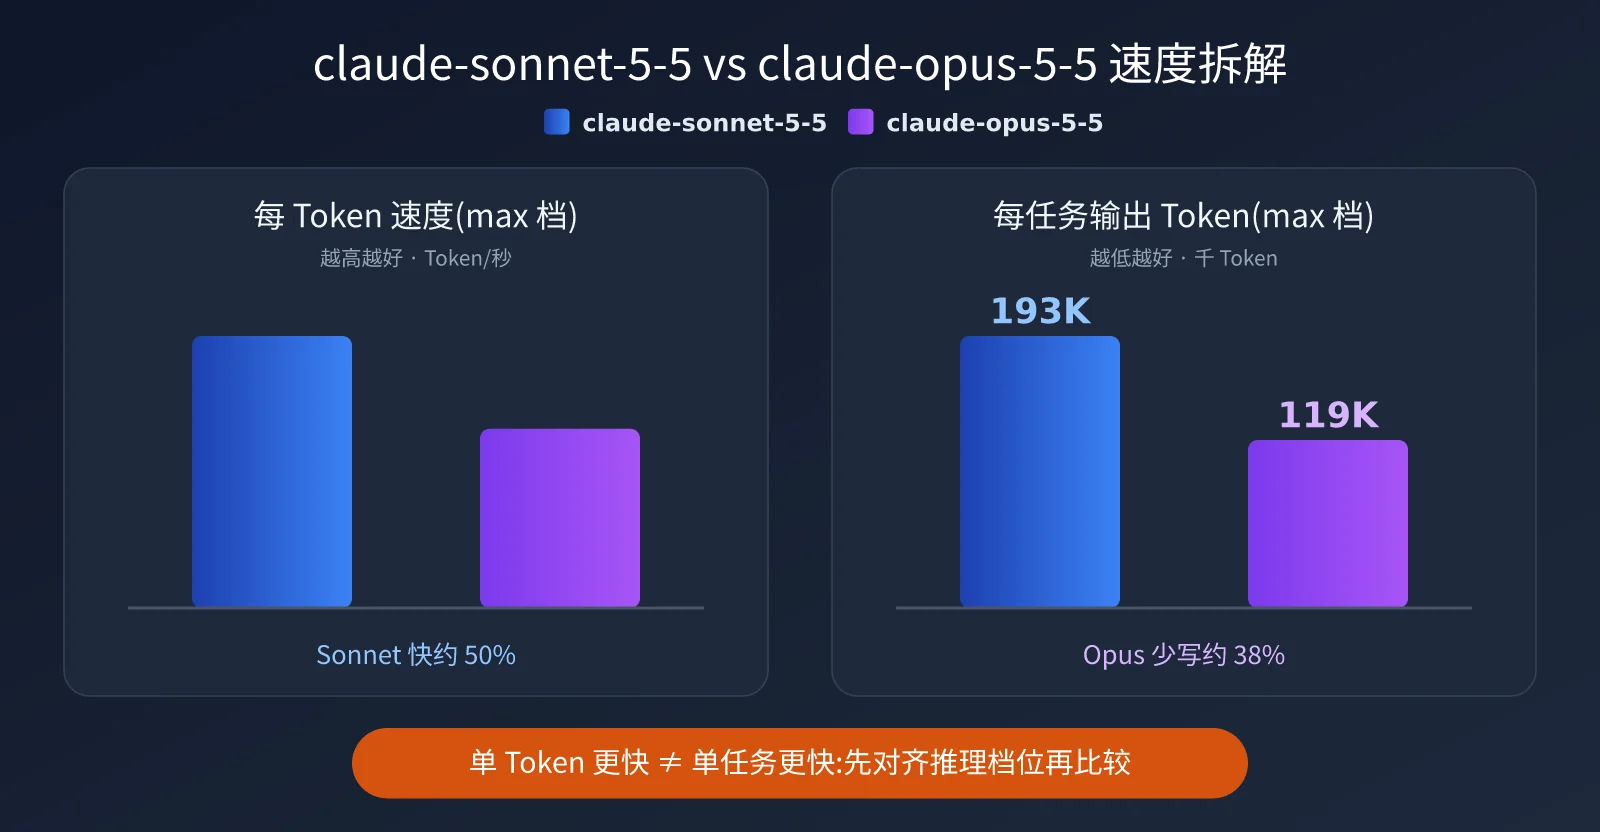
从纯粹的生成速度看,claude-sonnet-5-5 其实明显更快。Artificial Analysis 的测量显示,Sonnet 5.5 在不同推理档位下输出速度为 85-139 Token/秒,Opus 5.5 为 74-93 Token/秒;Anthropic 官方也将 Sonnet 的延迟等级标为“快”,Opus 标为“中等”。那么“Opus 更快”的体感从何而来?主要有三个原因。
原因一:默认档位不同,Sonnet 默认多想一档
Opus 5.5 把 API 默认档位从上一代的 high 下调到了 medium,官方称其 medium 档位已经能达到或超过 Opus 5 在 high 档位的水平。Sonnet 5.5 的 API 默认仍是 high,而且思考模式无法关闭。独立测试发现,Sonnet 在 high 档位下的输出 Token 约是 medium 的两倍,质量却没有明显提升。如果你直接用默认参数调用,Sonnet 实际上在“多想一档”,耗时自然更长。
原因二:Opus 的 Token 效率更高
在 Artificial Analysis 智能指数测试中,Sonnet 5.5 在 max 档位下平均每个任务输出约 19.3 万 Token,是该机构测到的最高值;Opus 5.5 在同档位下约为 11.9 万 Token。单 Token 更快,并不等于单任务更快。Sonnet 每秒多吐出约 50% 的 Token,但如果它需要多写 60% 的内容,端到端时间就可能反被 Opus 追平甚至超过。
原因三:Opus 独享 Fast 模式
Opus 5.5 支持 Fast 模式(研究预览),同一个模型换用更快的推理配置,输出速度最高提升约 2.5 倍,价格为 $8/$40。如果你在编程工具里为 Opus 开启了 Fast 模式,“Opus 很快”的印象会被进一步放大。需要注意,Fast 模式只提升每秒输出 Token 数,不改善首 Token 延迟,且与标准速度之间不共享提示词缓存。
| 速度指标 | claude-sonnet-5-5 | claude-opus-5-5 | 说明 |
|---|---|---|---|
| 输出速度(Token/秒) | 85-139 | 74-93 | Sonnet 单 Token 更快 |
| 每任务输出 Token(max 档) | 约 19.3 万 | 约 11.9 万 | Opus 更省 Token |
| 首 Token 延迟(低档位) | 约 1.3 秒(medium) | 约 14.3 秒(low) | Sonnet 响应更及时 |
| 官方延迟评级 | 快 | 中等 | 来自 Anthropic 模型页 |
| 真实编程任务耗时(第三方) | 29 分 27 秒 | 44 分 50 秒 | Sonnet 约快 1.5 倍 |
结论是:在默认参数下 Opus 可能跑得更快,但把两者放到合适的档位后,Sonnet 在响应速度上仍有明显优势。尤其是首 Token 延迟,Sonnet 在 medium 档位约 1.3 秒就开始输出,对面向用户的交互式 Agent 非常关键。
claude-sonnet-5-5 只有价格优势吗?能力对比数据
先说一个可能出乎意料的数据:在 max 档位下,Sonnet 并不比 Opus 便宜。Artificial Analysis 跑完整套智能指数,Sonnet 5.5(max)花费约 $8,977,Opus 5.5(max)约 $8,708,Opus 反而略低,而且得分更高(58 对 56)。原因正是前面提到的 Token 效率。所以如果你只在 max 档位使用 Sonnet,它连价格优势都不一定有。
那 Sonnet 的价值在哪?下表按推理档位列出两者在智能指数上的得分,可以看出它的正确打开方式:
| 推理档位 | claude-sonnet-5-5 智能指数 | claude-opus-5-5 智能指数 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
在综合智能上,同档位的 Opus 全面领先,而且 Opus 在事实准确率(AA-Omniscience 66% 对 54%)、法律、金融、策略等专业领域的指数上优势更明显。但 Sonnet 在以下几个方面拥有 Opus 无法替代的硬优势:
- 终端类智能体编程:Terminal-Bench 4.0 上 Sonnet(max)为 70.6%,高于 Opus(xhigh)的 66.4%;不过在相同 xhigh 档位下 Opus 仍以 66.4% 对 61.5% 领先,Sonnet 需要开满档才能反超。
- 响应延迟:首 Token 延迟和每秒输出速度都明显更好,适合实时交互、流式输出的前台场景。
- 未命中缓存的输入与缓存写入:单价都只有 Opus 的一半,对“每次都是新文档”的一次性长输入任务更友好。
- 长输出与批处理:输出单价 $10 对 $20,Batch 更是 $5 对 $10,大规模生成长报告、长文档时成本优势直接翻倍。
- 高并发执行:在 Anthropic 官方的定位中,Sonnet 是 Opus 更快、更低成本的搭档,适合作为子 Agent 大量并行执行明确的子任务。
其他公开基准中,Opus 在 CursorBench 4.0(57.8% 对 55.5%)、FrontierCode 1.1(54.4% 对 52.1%)、OSWorld 2.1(81.8% 对 80.1%)上领先 2 个点左右;第三方汇总的长上下文程序重建测试 ProgramBench 中,Opus 为 91.2%,Sonnet 为 79.7%,差距明显拉大。这说明越是需要在超长上下文中做精确判断的任务,Opus 的优势越大。
💡 选型提示: Sonnet 的正确用法是 medium 到 xhigh 档位,把它当作“执行者”;Opus 则适合 medium 档位起步的“决策者”。如果想验证自己业务上的差异,可以在 API易 apiyi.com 用相同的长文档任务分别跑一轮,对比结果质量与实际扣费。
企业长上下文 Agent 场景的真实成本
企业 Agent 的典型负载是:输入端动辄几十万 Token 的合同、代码库或知识库,输出端是长篇报告、批量改写或多文件代码。由于两款模型都支持 100 万上下文且无长上下文溢价,真正决定成本的是缓存命中率和输出长度。下面按官方标价估算几种典型场景(Sonnet 按 Opus 1.6 倍输出 Token 估算,对应两者在 max 档的 Token 效率差距):
| 场景 | 负载构成 | claude-sonnet-5-5 | claude-opus-5-5 | 成本比 |
|---|---|---|---|---|
| 长上下文多轮追问 | 50 万上下文,95% 命中缓存,新增 2.5 万写入 | 约 $0.28(输出 1.2 万) | 约 $0.37(输出 0.75 万) | 1 : 1.3 |
| 首次载入长文档 | 50 万 Token 写入 5 分钟缓存 + 1 万输出 | 约 $1.35 | 约 $2.70 | 1 : 2 |
| 长篇报告生成 | 5 万输入 + 5 万输出(相同输出量) | 约 $0.60 | 约 $1.20 | 1 : 2 |
| 离线批量生成 | Batch 模式,输入输出各 10 万 | 约 $0.60 | 约 $1.20 | 1 : 2 |
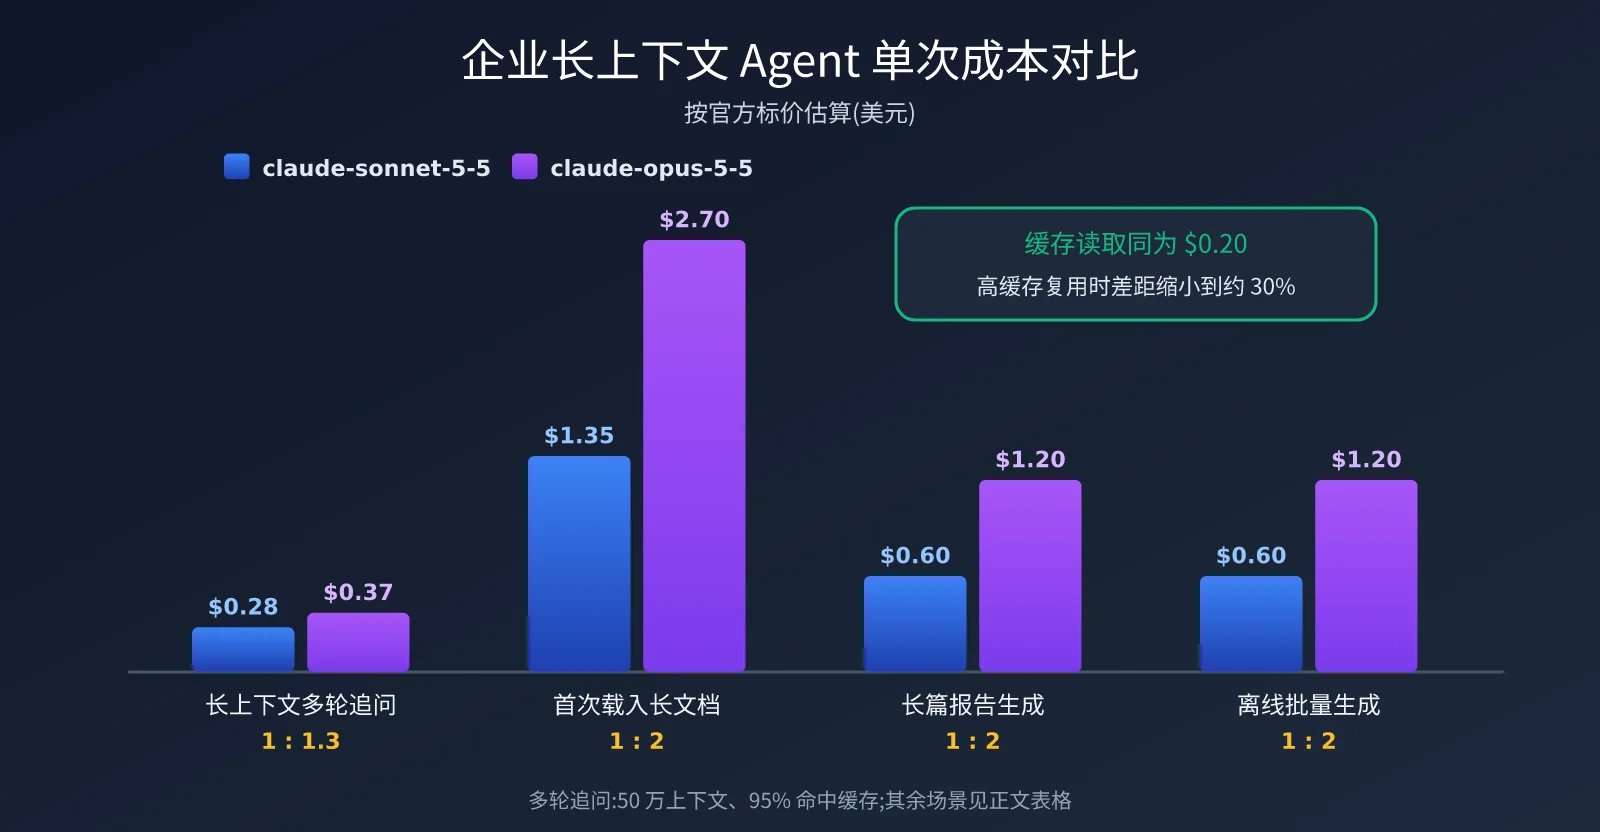
这张表揭示了一个很重要的规律:在“长输入 + 高缓存命中 + 短输出”的多轮追问中,Opus 只比 Sonnet 贵约 30%,因为占大头的缓存读取两者同价,Opus 还更省输出 Token;而在“新文档首次载入”和“长输出生成”场景中,Sonnet 的成本优势恢复到完整的一半。换句话说,Opus 适合“反复阅读同一份长材料并做判断”,Sonnet 适合“一次性吞下新材料”或“大段生成内容”。
还有一个容易踩坑的细节:提示词缓存不能跨模型共享。同一份 50 万 Token 的文档,Opus 读过一次、Sonnet 再读一次,就要分别付两次缓存写入费用。所以双模型架构的关键,是让长上下文尽量只“驻留”在一个模型上,另一个模型只接收精简后的任务摘要。
claude-sonnet-5-5 与 claude-opus-5-5 的合理搭配方案
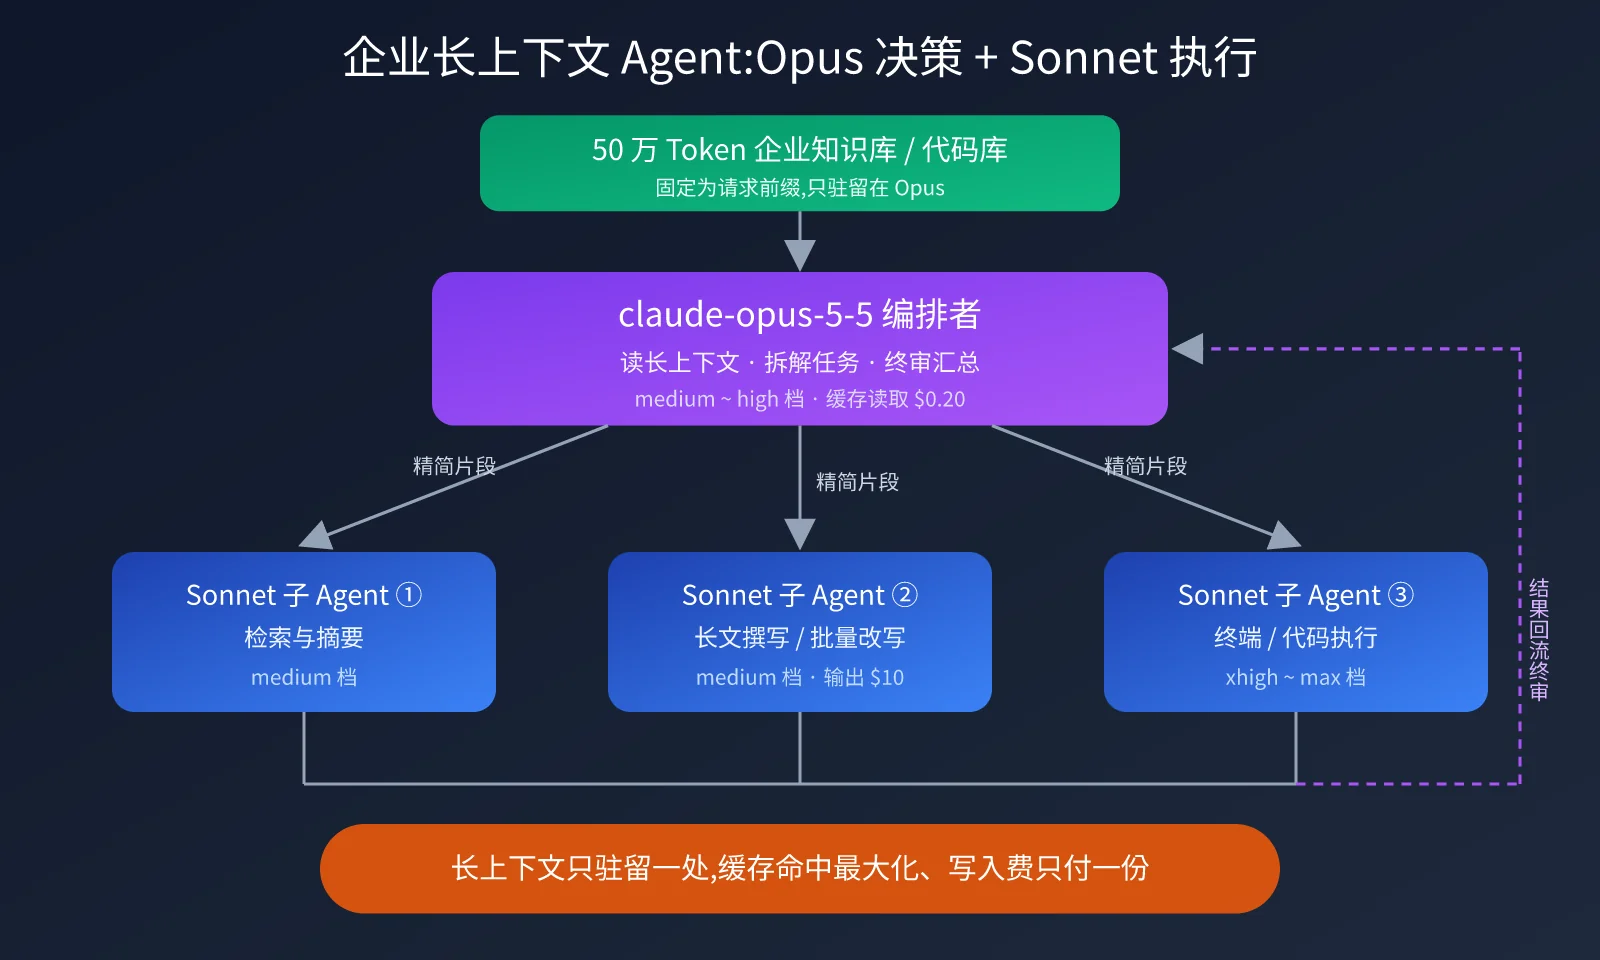
基于以上数据,我们推荐企业长内容 Agent 采用“Opus 决策、Sonnet 执行”的分层架构,并根据长上下文由谁持有,分成两种模式。
模式一:Opus 编排 + Sonnet 并行子 Agent
适合需要在长材料上做复杂判断的场景,比如合同审阅、跨仓库代码迁移、尽职调查。Opus 持有完整的长上下文(并长期命中缓存),负责理解全局、拆解任务、分配给多个 Sonnet 子 Agent;每个 Sonnet 只拿到自己那一小段材料和明确指令,在 medium 档位快速并行执行;最后由 Opus 汇总并终审。这种模式下,贵的长上下文缓存只付一份,Sonnet 负责产出大段文字,享受一半的输出单价。
模式二:Sonnet 前台 + Opus 升级兜底
适合交互式、流量大的场景,比如企业知识库问答、客服 Agent、内部 IT 助手。Sonnet 持有长上下文,以 medium 档位提供约 1 秒级的首 Token 响应;当遇到置信度低、涉及合规判断或用户明确不满意的请求时,把精简后的问题与关键片段升级给 Opus 处理。大部分流量由 Sonnet 以低成本消化,只有少量疑难请求才动用 Opus。
| Agent 角色 | 推荐模型 | 推荐档位 | 理由 |
|---|---|---|---|
| 编排者 / 规划者 | claude-opus-5-5 | medium ~ high | 综合智能与事实准确率更高,Token 效率好 |
| 长上下文分析与终审 | claude-opus-5-5 | high ~ xhigh | 长上下文精确判断优势明显 |
| 长文撰写 / 批量改写 | claude-sonnet-5-5 | medium | 输出单价减半,每秒输出更快 |
| 终端 / 代码执行子 Agent | claude-sonnet-5-5 | xhigh ~ max | Terminal-Bench 满档成绩最佳 |
| 实时对话前台 | claude-sonnet-5-5 | medium | 首 Token 延迟约 1.3 秒 |
| 离线批处理 | claude-sonnet-5-5 | medium | Batch $1/$5,支持 300K 长输出 |
用同一套接口实现 Opus 编排 + Sonnet 执行
下面是模式一的极简示例,通过 OpenAI 兼容接口调用,两款模型共用一个 Key:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "阅读以下合同全文,拆成 3 个独立审查子任务,每行一个:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"完成子任务并输出审查意见:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "汇总并终审以下意见,输出最终报告:\n" + "\n".join(drafts), effort="high")
展开查看:并行子 Agent + 固定长上下文前缀的完整示例
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. 长文档固定放在 system 前缀,只驻留在 Opus 上,便于多轮命中缓存
    base = [{"role": "system", "content": "你是企业文档分析编排者。以下是完整材料:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"目标:{goal}\n请拆成最多 5 个子任务,每个子任务附上所需的原文片段,用 --- 分隔。"}])

    # 2. Sonnet 子 Agent 只接收精简片段,并行执行
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"独立完成以下子任务,输出结构化结论:\n{t}"}])
        for t in tasks])

    # 3. 回到 Opus 终审,复用同一长上下文前缀
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"核对以下子任务结论与原文是否一致,修正错误后输出最终报告:\n{merged}"}],
        effort="high")
    print("终审 Token 用量:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "识别合同中的付款、违约与知识产权风险"))
🚀 快速上手: Claude 官方账号对注册地区和支付方式要求较高,企业团队常常卡在开通环节。可以先在 API易 apiyi.com 注册获取测试额度,用一个 Key 同时调用 claude-opus-5-5 与 claude-sonnet-5-5,把上面的双模型架构先跑通再评估规模化成本。
claude-sonnet-5-5 vs claude-opus-5-5 决策建议
把前面的分析浓缩为 4 条可执行的原则:
- 先定档位再比模型:Sonnet 用 medium~xhigh,Opus 用 medium~high,避免 Sonnet 默认 high 带来的 Token 浪费。
- 高缓存复用的长上下文交给 Opus:缓存读取同价,Opus 只贵约 30%,换来更高的准确率和更少的返工。
- 新材料载入与长输出交给 Sonnet:缓存写入和输出单价都是 Opus 的一半,离线任务再叠加 Batch 5 折。
- 长上下文只驻留一处:缓存不能跨模型共享,子 Agent 只传精简片段,避免重复支付缓存写入。
至于 Opus 的 Fast 模式,它适合对单次响应速度极度敏感、预算充足的场景,但价格翻倍且不共享缓存。对大多数企业 Agent 来说,把实时交互交给 Sonnet medium 档,往往比给 Opus 开 Fast 更划算。
常见问题
Q1:claude-opus-5-5 已经很快了,还有必要用 claude-sonnet-5-5 吗?
有必要。Opus“快”主要来自默认档位更低和 Token 效率更高,而 Sonnet 在每秒输出速度和首 Token 延迟上依然明显领先,输出单价也只有一半。对长文撰写、实时对话和并行子 Agent 这类场景,Sonnet 仍是更合适的执行者。
Q2:claude-sonnet-5-5 开到 max 档位能替代 Opus 吗?
在终端编程这类特定任务上可以,Sonnet(max)的 Terminal-Bench 4.0 成绩甚至高于 Opus。但综合智能指数仍低 2 分,而且 max 档位下 Sonnet 消耗的 Token 更多,整体成本已经与 Opus 持平甚至略高。如果你需要的是满档质量,直接用 Opus 通常更划算。
Q3:企业长文档 Agent 怎么控制两款模型的成本?
核心是提高缓存命中率:把长文档固定在请求前缀,只让一个模型持有完整上下文,子 Agent 只接收精简片段。建议通过 API易 apiyi.com 调用并观察返回的缓存 Token 用量,逐步调整前缀结构,缓存命中率通常是降本最有效的杠杆。
Q4:从 Sonnet 5 或 Opus 5 迁移到 5.5 需要注意什么?
两款 5.5 模型都有接口破坏性变更:思考模式无法关闭,强制工具调用(tool_choice 为 any 或 tool)会返回 400 错误,旧版电脑操作工具也需要升级。迁移前建议先在测试环境跑通回归用例,并行对比新旧模型的输出差异后再切换生产流量。
总结
claude-sonnet-5-5 对比 claude-opus-5-5,并不是“贵的更好、便宜的更差”这么简单。Opus 5.5 降价后缓存读取与 Sonnet 同价,默认 medium 档位又足够高效,在长上下文精确判断和综合智能上全面领先;Sonnet 5.5 则在响应速度、输出成本、终端编程和高并发执行上拥有不可替代的优势。所以 Sonnet 并不只剩价格优势,只是它的优势需要在正确的档位和正确的角色上才能体现。
对企业长内容输入输出的 Agent,最合理的搭配是“Opus 决策、Sonnet 执行”:Opus 持有长上下文并负责规划与终审,Sonnet 在 medium 档位并行完成撰写与执行,离线部分交给 Batch。实操上可以先固定档位跑对照测试,再按本文的角色表拆分 Agent,最后通过缓存命中率和输出 Token 两个指标持续优化成本。
如果你希望快速验证这套双模型方案,推荐通过 API易 apiyi.com 统一调用 claude-opus-5-5 与 claude-sonnet-5-5。平台接口兼容 OpenAI 格式,一个 Key 即可在两款模型间自由切换,适合做选型测试和生产环境的多模型编排。
参考资料:
– Anthropic 定价文档: platform.claude.com/docs/en/about-claude/pricing
– Anthropic Fast 模式文档: platform.claude.com/docs/en/build-with-claude/fast-mode
– Artificial Analysis Sonnet 5.5 与 Opus 5.5 对比: artificialanalysis.ai
– Digital Applied Opus 5.5 发布解读: digitalapplied.com
– Kingy AI 与 Emergent 的 Sonnet 5.5 vs Opus 5.5 对比: kingy.ai、emergent.sh
作者简介:APIYI 技术团队,专注 AI 大模型 API 接入与工程化实践。欢迎通过 API易 apiyi.com 交流 claude-opus-5-5 与 claude-sonnet-5-5 的 Agent 编排与成本优化经验。