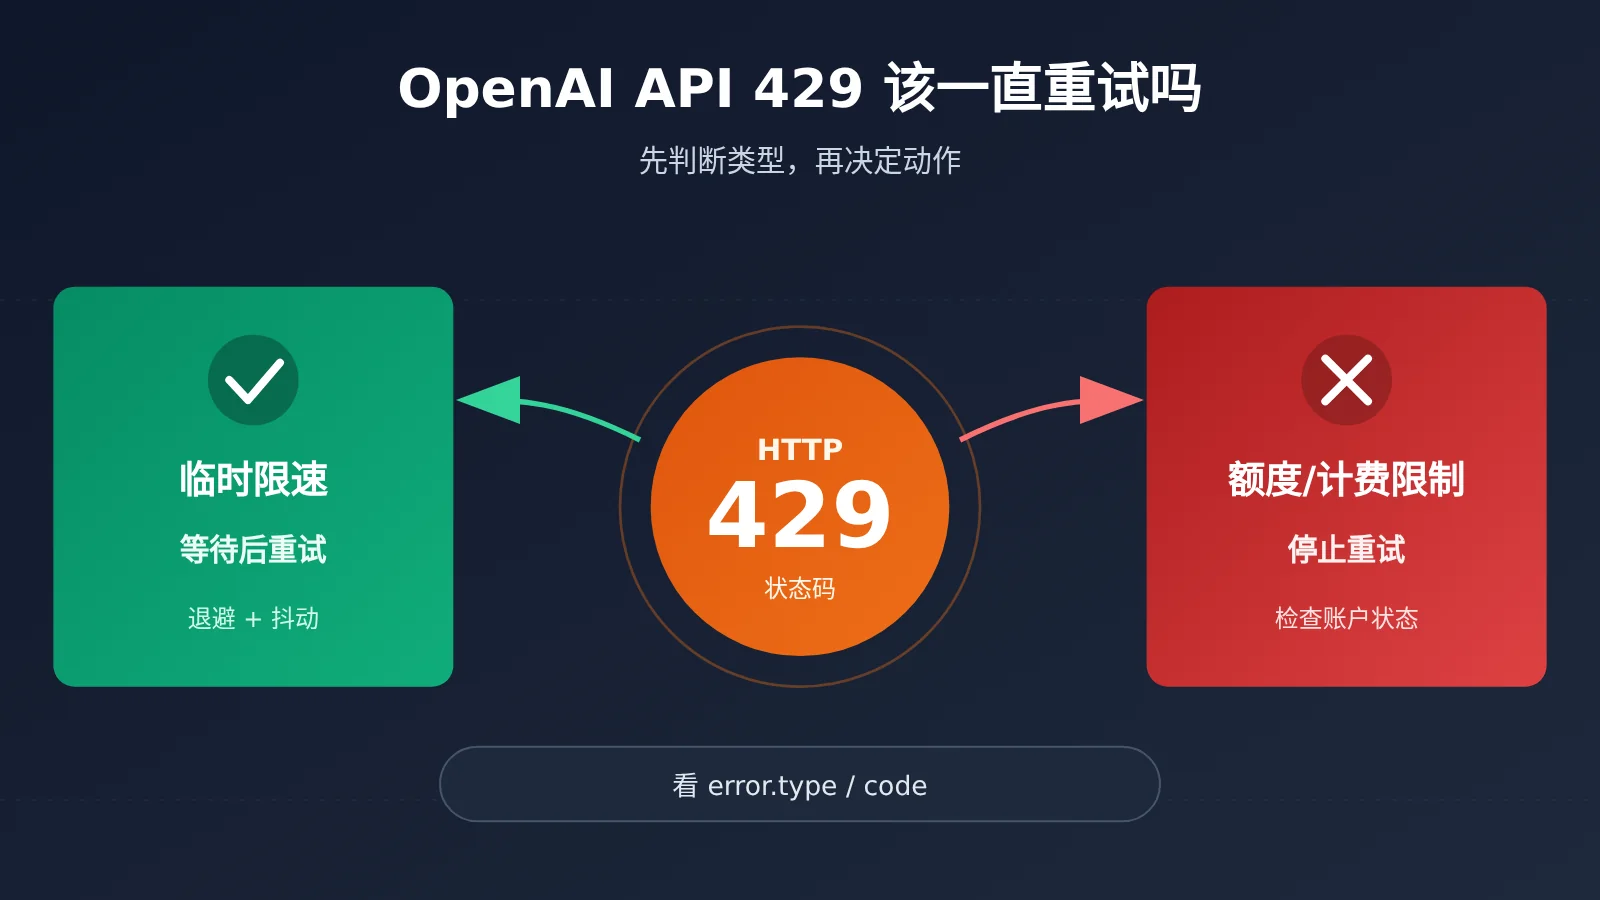
不该一直重试。 OpenAI API 返回 429,并不等于“稍等一下就好”。只有临时性的速率限制适合等待后重试。额度用尽、计费异常或组织层面的使用限制,再怎么重试也不会恢复,反而会把队列堵死。
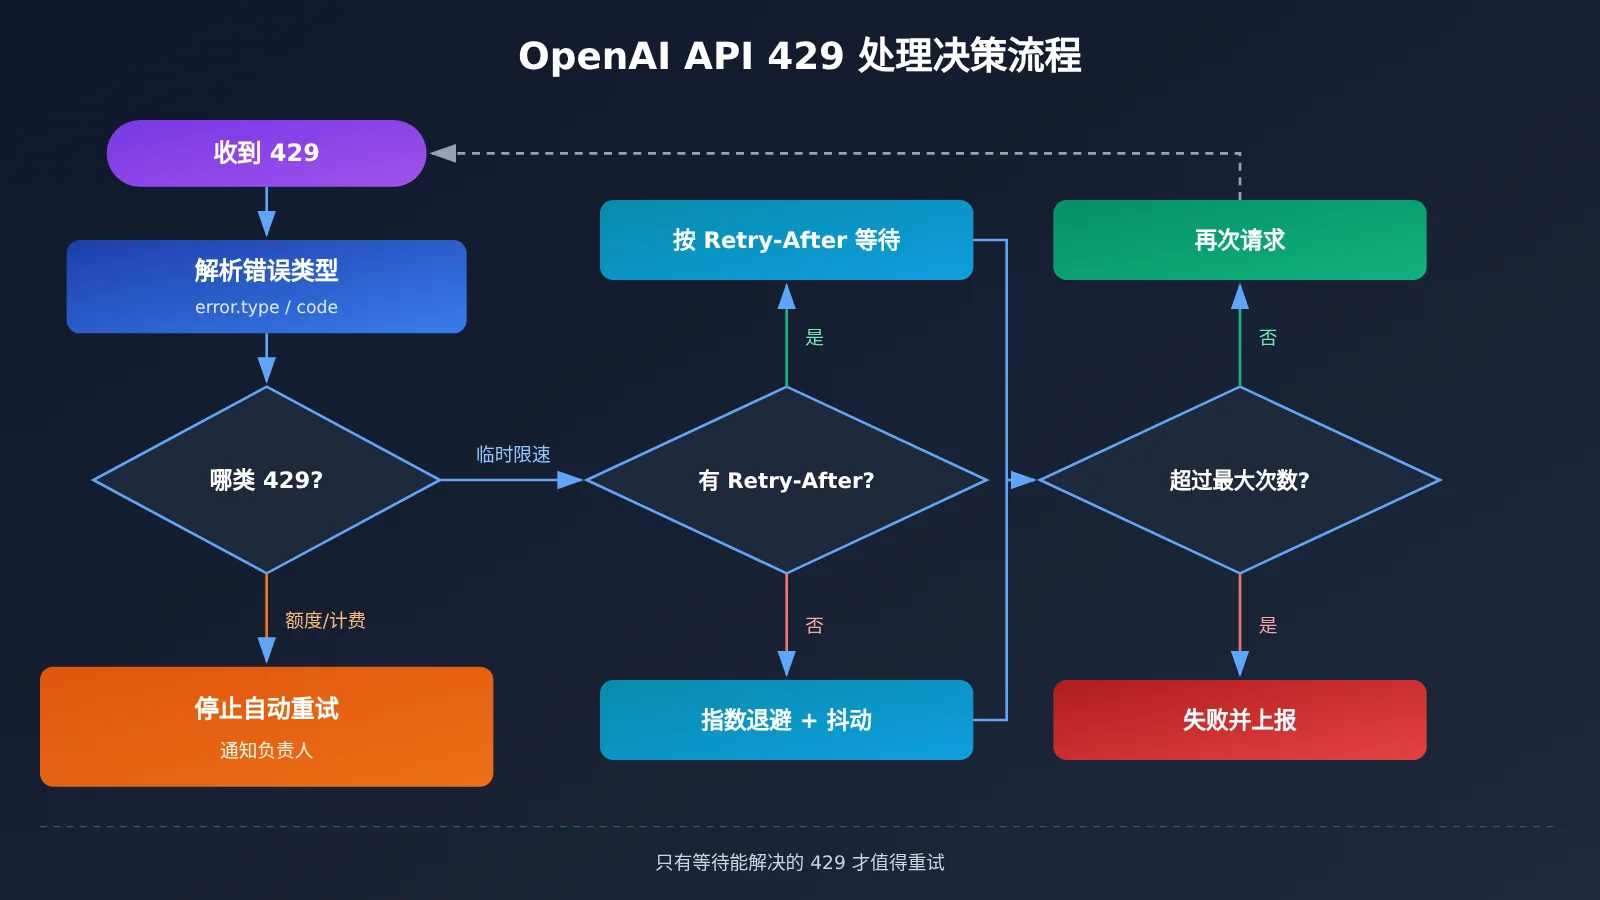
正确做法是先看错误信息、error.type 和可用的 error.code,判断属于哪一类 429。如果是临时限速,有有效的 Retry-After 就照它等待,没有就用带随机抖动的指数退避,并设置次数上限。
您读完此文能了解到什么?
- OpenAI API 的 429 至少分为哪几类,各自应该怎么处理。
Retry-After、指数退避、随机抖动三者是什么关系,什么时候用哪个。- 官方 SDK 自动重试、任务队列和人工“重试”按钮叠加后,为什么会放大 429。
- 请求数瓶颈和 token 瓶颈的不同解法,以及流式请求中途出错时的注意事项。
索引: 正文前先用一张概念表和一张影响速览,帮你统一术语,并找到与自己相关的部分。“客观事实”部分整理 OpenAI 官方文档对 429 的描述,包括错误分类、重试规则和 SDK 行为。“分析判断”部分讨论工程落地,包括按瓶颈类型调整策略、设计队列状态、排查重试叠加,以及迁移到其他网关时要注意的语义差异。
To Know:理解 OpenAI API 429 需要的概念
| 概念 | 简要解释 |
|---|---|
| HTTP 429 | “Too Many Requests”状态码。OpenAI API 用它表示速率限制,也用它表示额度或使用量限制 |
| 速率限制(Rate Limit) | 在一段时间内可以发起的请求量上限。OpenAI 会分别统计请求数和 token 量 |
| RPM / TPM | 每分钟请求数、每分钟 token 数。两者任一触顶都可能触发 429 |
error.type / error.code |
错误响应体中的结构化字段,用来区分 429 的具体原因,比只看状态码更可靠 |
| Retry-After | 响应头字段,表示服务端建议多久之后再试。值有效时应优先遵循 |
| 指数退避(Exponential Backoff) | 每次失败后,等待时间按倍数递增,例如 1 秒、2 秒、4 秒,并设置上限 |
| 随机抖动(Jitter) | 在退避时间上加入随机量,避免大量客户端在同一时刻集中重试 |
| 流式输出(Streaming) | 模型边生成边返回内容。一旦开始输出,中途出错就不能简单地整体重放 |
| 重试叠加 | SDK、业务队列、用户手动操作各自重试,实际请求量被成倍放大的现象 |
影响速览:OpenAI API 429 对不同角色意味着什么
| 角色 | 主要影响 | 需要关注的点 |
|---|---|---|
| 后端开发者 | 重试逻辑写错,会把短暂限速放大成持续故障 | 区分 429 类型,统一由一层负责重试 |
| 批处理与数据任务负责人 | 大批量任务容易同时撞上请求数和 token 两条限制 | 提交节奏、上下文体积、队列状态设计 |
| 产品与前端 | 用户反复点“重试”,会继续制造新的 429 | 告诉用户下次尝试时间,或说明是账户原因 |
| 运维与账户管理者 | 额度、计费类 429 无法靠代码自愈 | 及时发现并处理账户状态,而不是放任自动重试 |
客观事实:OpenAI 官方文档如何描述 429
本部分依据 OpenAI 公开维护的错误码指南、速率限制指南和帮助中心的 429 排查文章,核查日期为 2026-11-17。这些是持续更新的维护文档,本文无法核实相关内容最早发布于何时,因此不把它当作当日新闻,只把它作为当前有效的规则说明。
OpenAI API 429 的不同来源
官方文档的核心立场是:同样是 429,含义可能不同,要结合错误信息、error.type 和可用的 error.code 判断。 临时速率限制与额度、计费、组织使用限制,处理方式不一样。
前者是“当前窗口内请求太快或太多”,过一段时间窗口刷新就能恢复。后者涉及账户本身的状态,例如额度用完、付款问题、组织层面的使用上限。这类问题不会随时间自动消失。
| 429 类型 | 典型信号 | 等待能否解决 | 推荐动作 |
|---|---|---|---|
| 请求数限速 | 错误信息指向请求数上限,常见 code 为 rate_limit_exceeded |
通常可以 | 遵循 Retry-After,或使用带抖动的指数退避 |
| token 量限速 | 错误信息指向 token 上限 | 通常可以,但容易反复触发 | 退避的同时减少单次请求的 token 量 |
| 额度/计费/组织限制 | 错误信息指向额度或账单,常见 code 为 insufficient_quota |
不能 | 停止自动重试,通知负责人处理账户 |
需要强调的是,error.code 的具体取值应以实际返回内容和官方文档为准。上表的 code 只是常见示例,代码中不要只靠硬编码字符串做判断,同时保留错误信息原文用于日志排查。
请求数与 token 量可能分别受限
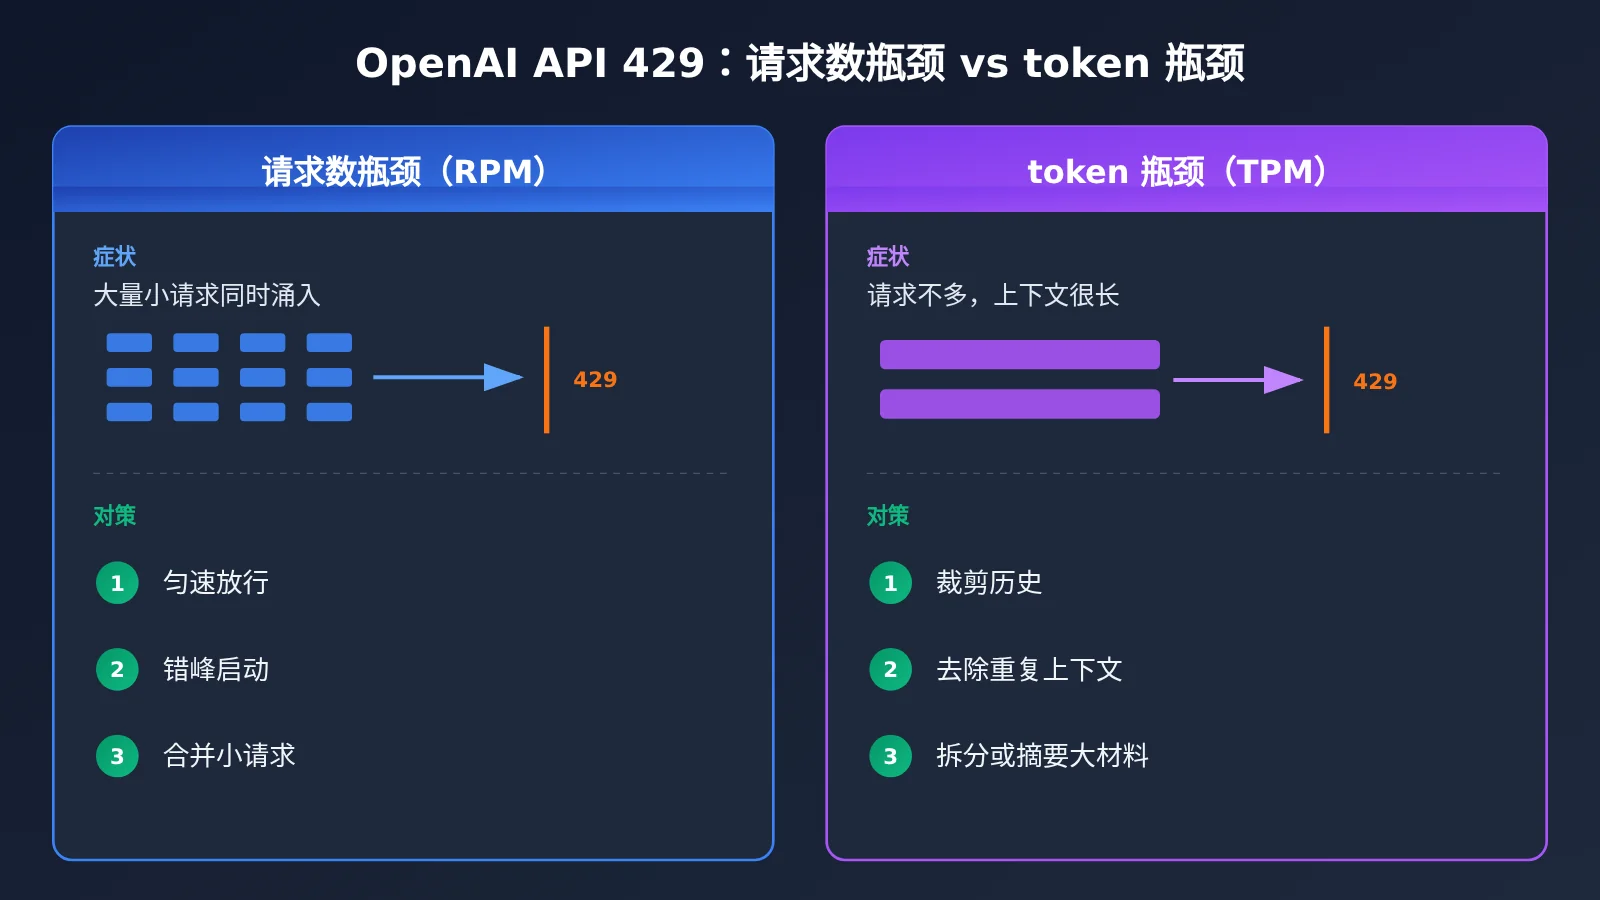
速率限制指南说明,限制会从多个维度计量,其中最常遇到的是请求数和 token 量,两者独立生效。也就是说,请求数还远没到上限时,也可能因为每个请求都带着很长的上下文而先撞上 token 限制。反过来,大量很小的请求也可能先耗尽请求数。
OpenAI 在响应头中提供了与速率限制相关的信息,例如剩余请求数、剩余 token 数和各自的重置时间。这些头字段有助于在真正触发 429 之前判断自己离哪条上限更近。
官方推荐的 OpenAI API 429 重试方式
对于适合重试的临时限速,官方的推荐可以归纳为两条:
- 存在有效的 Retry-After 时,遵循它。 这是服务端给出的最直接信号,比客户端自己猜更准确。
- 没有 Retry-After 时,使用带随机抖动的指数退避。 等待时间随失败次数递增,再叠加随机量,避免所有客户端在同一时刻一起重试。
这两条规则的前提是“这次 429 属于等待能解决的类型”。如果是额度或计费问题,再精确的退避算法也只是在空转。
官方 SDK 的自动重试行为
OpenAI 官方 SDK 会对符合条件的限速错误自动重试,具体行为受客户端配置影响。以 Python SDK 为例,可以通过 max_retries 参数调整,或者设为 0 关闭自动重试。
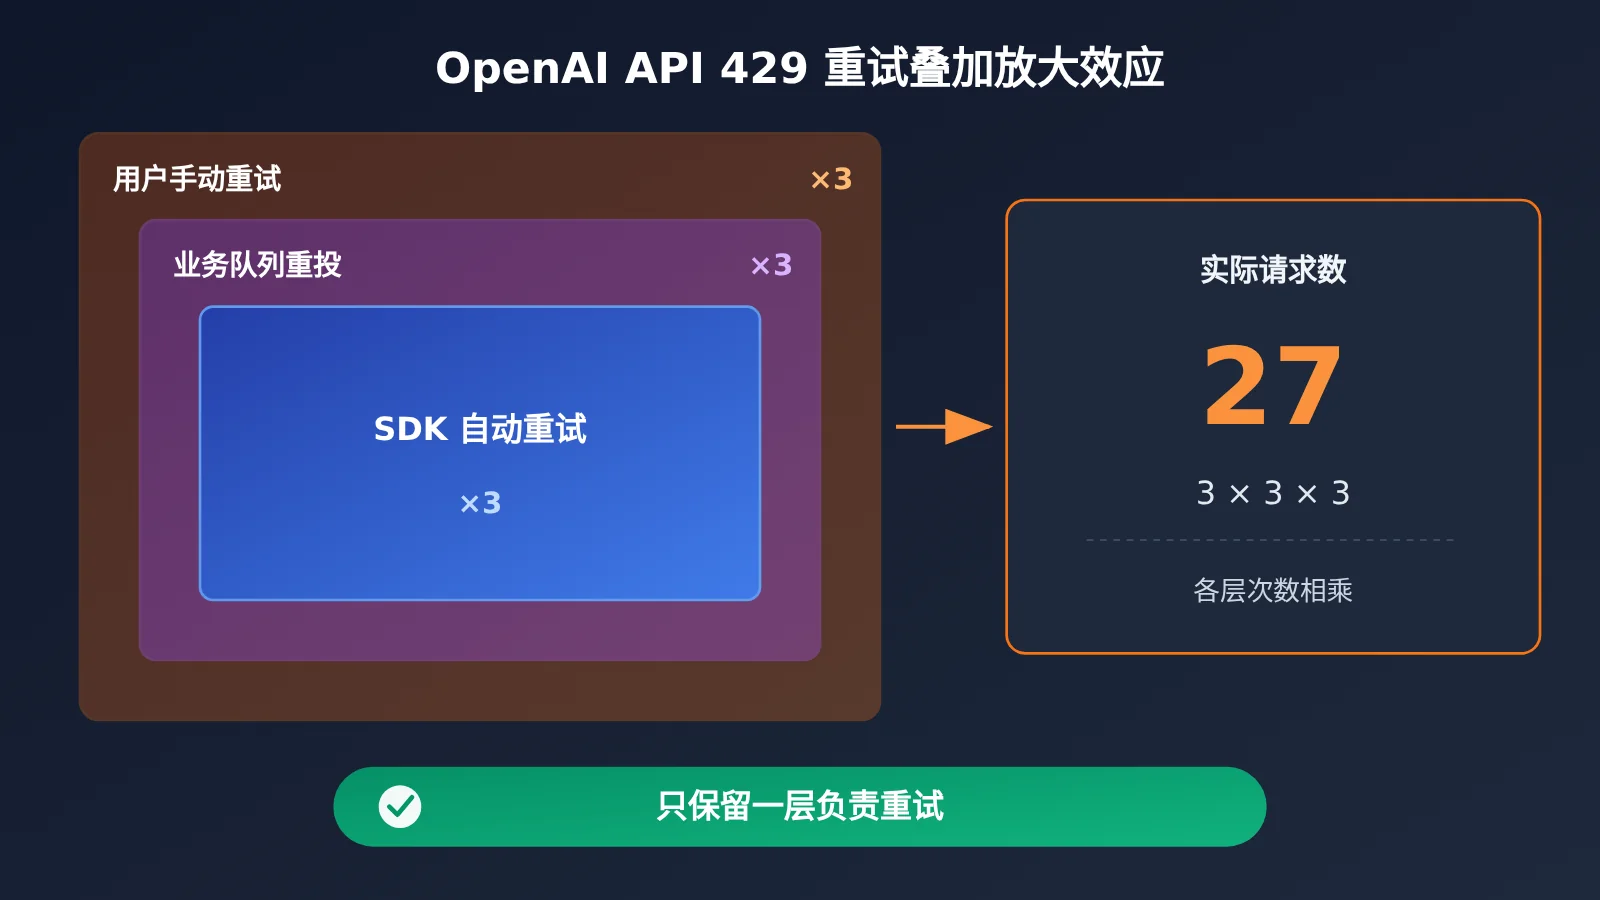
这意味着即使你的业务代码里一行重试逻辑都没写,请求也可能已经被重试过几次。若业务层再包一层重试,实际请求次数就是两者相乘。
流式请求中途出错不能一律重放
官方文档还提到一个容易被忽略的边界:流式输出一旦已经开始,之后发生的错误不能一律通过重放整个请求来处理。 用户可能已经看到了部分内容,下游系统也可能已经消费了部分数据。直接重放会导致内容重复、前后不一致,还会重复消耗 token。
分析判断:OpenAI API 429 在工程中该怎么落地
以下内容是基于上述事实的工程判断,不是 OpenAI 官方的原话。
一段可直接改造的 OpenAI API 429 退避示例
下面的示例体现了几条原则:关闭 SDK 自动重试,由业务层统一负责;额度类错误直接抛出;优先遵循 Retry-After;没有时使用带完全抖动的指数退避;限制最大尝试次数。
import random
import time
from openai import OpenAI, RateLimitError

# 关闭 SDK 自动重试,避免与下面的自定义重试叠加
client = OpenAI(max_retries=0)

# 等待无法解决的 429 类型(以实际返回和官方文档为准)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """解析 Retry-After 秒数;无效则返回 None。HTTP 日期格式可按需补充解析。"""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # 额度/计费类问题,交给账户处理流程
            if attempt == max_attempts - 1:
                raise  # 超过上限,交给队列或告警
            wait = parse_retry_after(e.response)
            if wait is None:
                # 完全抖动:在 [0, 指数上限] 内随机取值
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
示例中的 max_attempts、base、cap 都只是起点,不是推荐值。不同账户的限额等级不同,任务形态也不同,不存在一个适合所有账号的统一并发数或重试次数,应根据自己的监控数据调整。
按瓶颈类型调整:请求数瓶颈和 token 瓶颈解法不同
退避只能解决“这一次怎么等”,解决不了“为什么总是撞线”。要减少 429,得先弄清撞的是哪条线。
请求数瓶颈的关键是拉开提交节奏。在队列入口做匀速放行,比如令牌桶或固定间隔发放,不要让大量任务在同一秒涌出。批量任务启动时也要错峰,不要整点一起触发。
token 瓶颈的关键是减小单次请求的体积。常见的浪费包括:每轮对话都完整带上很长的系统提示和历史记录;同一份大文档在多个请求里反复传入;把整份材料塞给模型,而实际只需要其中一段。先做裁剪、摘要或检索再提交,往往比调大重试次数有效得多。
队列状态要区分“等待重试”和“账户阻塞”
很多系统只有“排队中”和“失败”两种状态。遇到 429 时,这会造成两种误判:临时限速被当成失败而丢弃任务,额度问题被当成排队而无限等待。
更合理的做法是把两种 429 拆成两个状态,并给出不同的展示:
| 队列状态 | 触发条件 | 应展示的信息 | 后续处理 |
|---|---|---|---|
| 等待重试 | 临时速率限制 | 预计下次尝试时间、已尝试次数 | 到时自动重试,达到上限转失败 |
| 账户阻塞 | 额度、计费、组织使用限制 | 阻塞原因(如额度不足) | 暂停同账户的后续任务,通知负责人 |
| 失败 | 超出重试上限或其他不可恢复错误 | 错误类型与原始信息 | 人工介入或业务降级 |
“账户阻塞”还有一个连带效果。同一账户下的其他任务大概率也会遇到同样的 429,此时应整体暂停,而不是让每个任务各自撞一次。
排查重试叠加:SDK、队列、人工按钮
如果你发现 429 越重试越多,第一件事是检查是否有多层重试同时生效。典型链路是:SDK 自动重试数次,业务队列在任务失败后再重新投递数次,前端用户看到报错又手动点了“重试”。三层相乘后,一个原始请求可能变成十几次实际请求,而且这些请求往往集中在限速窗口内,正好加剧限速。
排查时建议逐层确认:
- SDK 层:确认
max_retries的实际取值,不要依赖记忆中的默认值。 - 队列层:确认任务失败后是否会自动重新投递,以及重投是否有退避。
- 交互层:确认“重试”按钮在等待期间是否禁用,并显示下次尝试时间。
- 日志层:为每个原始任务分配唯一 ID,统计它实际发出了多少次请求。
原则很简单:同一条链路上只保留一层负责重试,其他层只负责传递状态。
流式场景要单独设计 OpenAI API 429 的恢复策略
流式请求在建立连接、尚未输出任何内容时遇到 429,可以按普通请求处理。一旦已经开始输出,就应该把“是否重放”交给业务决定。例如,向用户明确提示生成中断,由用户选择重新生成;或者丢弃已输出的部分并整体替换。不要在后台静默重放,导致界面上出现两段重复内容。
迁移到其他平台时,不要照搬 OpenAI 的 429 语义
本文所述的错误分类、error.code 取值、Retry-After 行为和响应头,都是 OpenAI 官方 API 的语义。如果你通过第三方网关、中转或聚合平台(例如 API易)调用模型,对方的错误码、限流维度和重试建议需要以该平台自己的文档为准,另行核实,不能直接照搬 OpenAI 的行为。比较稳妥的做法是在接入层做一层错误归一化,把不同来源的 429 映射到本文所说的“等待重试 / 账户阻塞 / 失败”三类状态,再交给统一的重试模块处理。
值得持续关注的变化
OpenAI 的错误码文档和速率限制文档都在持续维护。限额等级、计量维度、响应头字段都有可能调整。建议在代码中保留错误原文日志,定期对照官方文档复核判断逻辑。另外,不要把“所有 429 都能靠等待解决”写进任何默认配置。这条假设一旦在额度耗尽时生效,代价就是一整晚空转的任务队列。
429 本质上是服务端在说“慢一点”,有时还在说“这条路暂时走不通”。分清是哪一种,再决定是等、是改,还是停,比任何精巧的重试算法都重要。正如《论语·子路》所言:
“无欲速,无见小利。欲速则不达,见小利则大事不成。”