作者注:本文按 2026-10-24 抓取的官方價目表,拆解 Kimi K3.1 Pro 的五檔價格、緩存計費、限流檔位,並用三個可套用的算賬示例說明一次請求到底花多少錢。
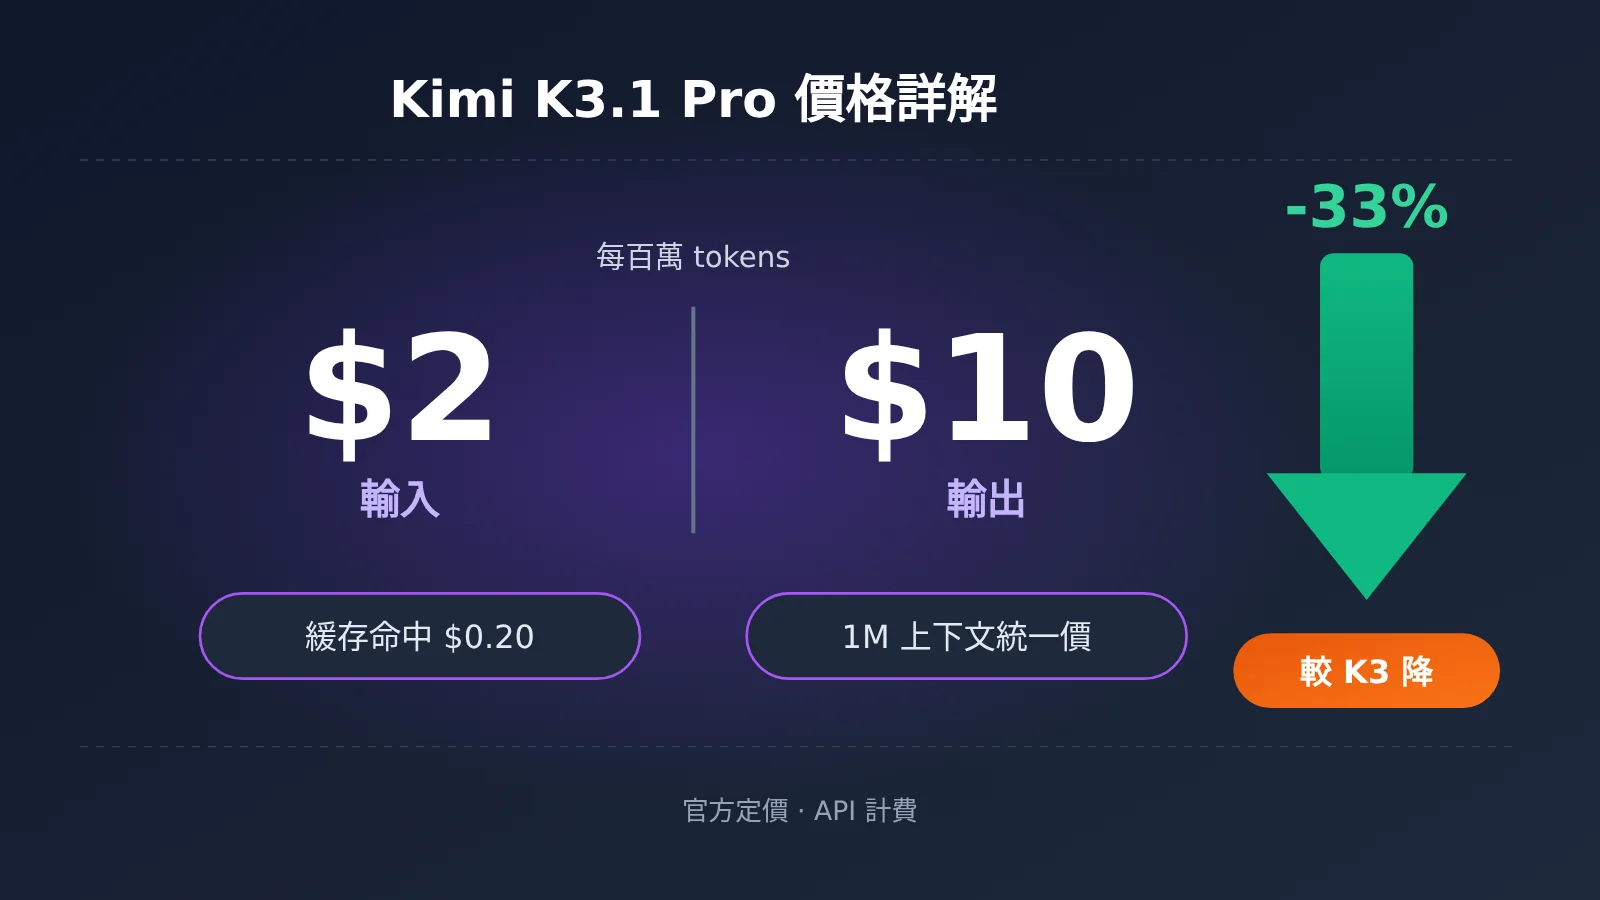
Kimi K3.1 Pro 的官方價格是 輸入 $2、輸出 $10,緩存命中只要 $0.20(單位:美元/百萬 tokens)。這一價格比上一代 Kimi K3 便宜 33%。它和 Claude Sonnet 5.5、GPT-6.1 Sol 同價,是 Claude Opus 5.5 的一半。
以上結論的依據是 Moonshot 官方定價頁(platform.kimi.ai 的 pricing 文檔)和第三方機構 Artificial Analysis 的算賬數據。文中所有數字都會標註來源檔位:「官方」指 Moonshot 博客或官方文檔自報,「第三方」指 Artificial Analysis 等外部測算,查不到可靠來源的標「未覈實」。
這不是一篇只抄價目表的文章。 單價降了 33%,不代表你的賬單一定降 33%,後面會把省錢和不省錢的地方都講清楚。
核心價值:讀完本文,你能自己算出一次 Kimi K3.1 Pro 請求的成本,知道什麼場景該開緩存、什麼時候要提前升級限流檔位,以及國內開發者怎麼付費和接入。
1. Kimi K3.1 Pro 價格核心要點
先用一張表把最常被問到的幾件事說完,後面每一節再展開。
| 要點 | 說明 | 來源 | 對你意味着什麼 |
|---|---|---|---|
| 基礎單價 | 輸入 $2 / 輸出 $10 / 緩存命中 $0.20 | 官方 | 與 Sonnet 5.5、GPT-6.1 Sol 同一價位 |
| 對比上一代 | 三項單價都比 K3 低 33% | 官方 / 第三方 | 單價層面明顯降價 |
| 上下文 | 1,048,576 tokens,統一單價不分檔 | 官方 | 長文檔不會因爲長度觸發漲價 |
| 單任務成本 | 約 $1.98(發佈文章)/ $2.11(模型頁) | 第三方 | 與 K3 基本持平,並未同比下降 |
| 起步門檻 | 至少充值 $1,Tier0 僅 3 RPM | 官方 | 正式上量前要先升檔 |
這裏先解釋兩個後面反覆出現的詞。token 是模型計費的最小單位,可以理解成“字詞碎片”,官方給的參考是英文大約 3-4 個字符算 1 個 token;百萬 tokens(MTok) 就是 1,000,000 個 token,價目表裏的 $2 指每處理一百萬個輸入 token 收 $2。
1.1 Kimi K3.1 Pro 的計費項有哪些
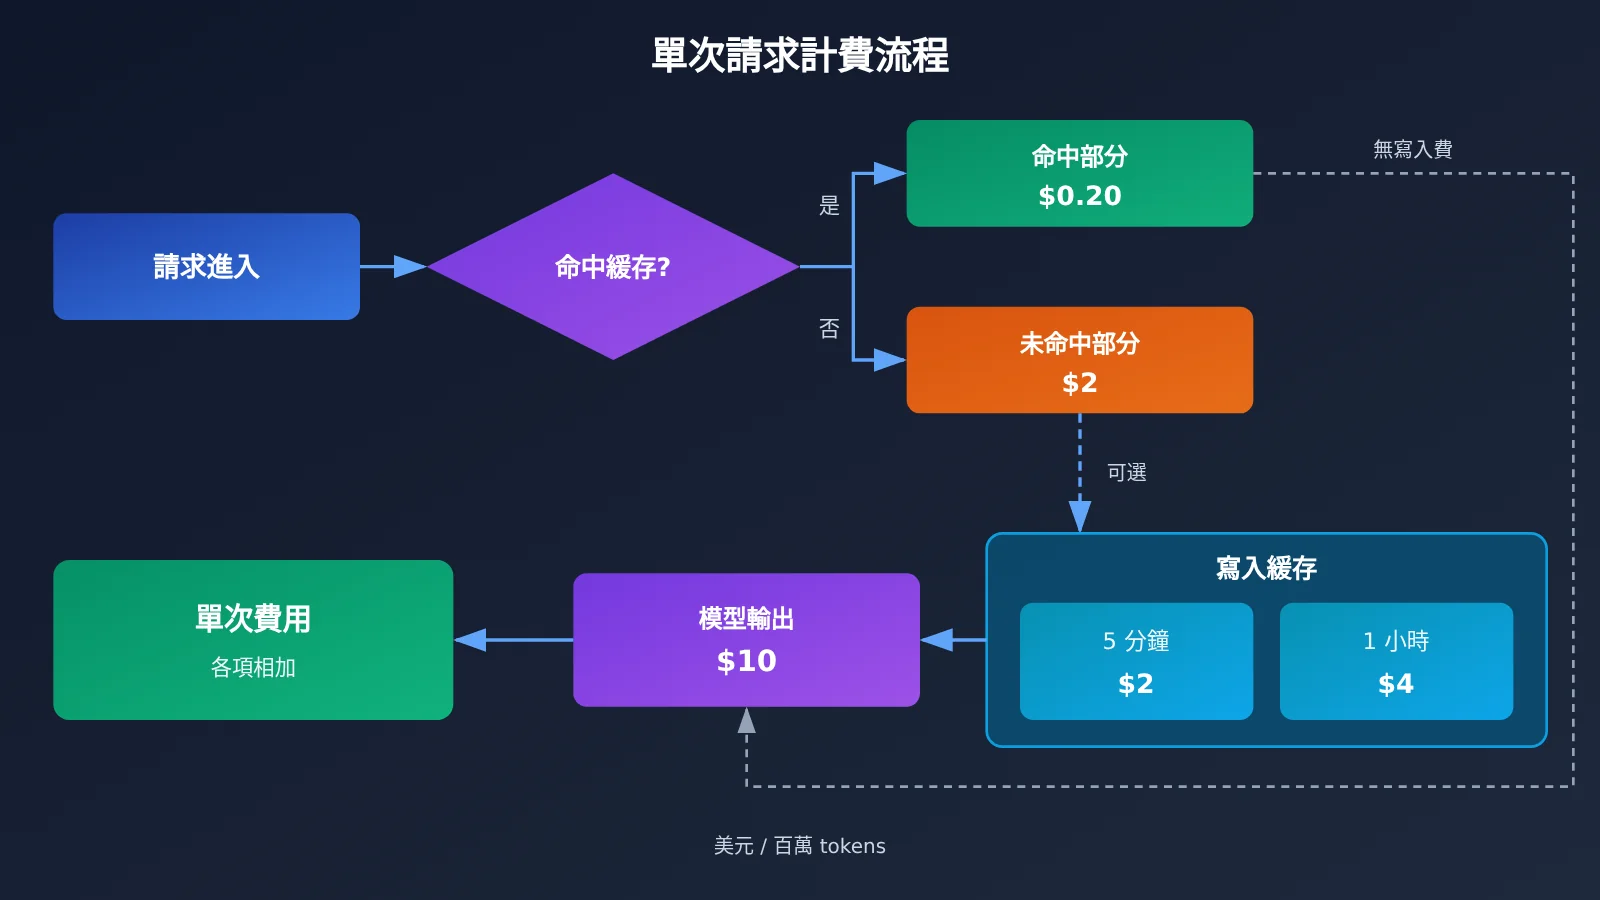
官方文檔列出的可計費項一共三類:緩存寫入(分 5 分鐘和 1 小時兩檔)、輸入(分緩存命中和未命中)、輸出。把它們拆開就是價目表裏的五列價格,每一次請求的賬單都是這幾項按 token 數相加。
上下文緩存是這次定價裏最值得關注的部分。它的意思是:如果你連續幾次請求的開頭部分完全一樣(比如同一段很長的系統提示詞),平臺會把這段內容存起來,下次直接複用,複用部分按便宜得多的“命中價”收費。官方說明 Kimi API 會對重複的請求前綴自動開啓緩存計費,默認 TTL 爲 5 分鐘,TTL 就是“緩存保留多久”的意思。
另外幾條容易忽略的規則也寫在官方文檔裏:K3 系列緩存命中只收命中價,不再額外收寫入費;文件相關 API(文檔內容抽取、文件存儲)暫時免費,但抽取出來的內容送進模型時照樣按 token 計費;價目表是稅前價,最終按付款地區規則結算。
2. Kimi K3.1 Pro 完整價目表:五檔價格一次看全
下面這張表把 Kimi 當前主力型號的五檔價格全部列出,方便你橫向比較。“未列”表示官方定價頁沒有給出該項價格,不代表免費。
| 模型 | 輸入(未命中) | 輸出 | 緩存命中輸入 | 緩存寫入 5 分鐘 | 緩存寫入 1 小時 |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3(上一代) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | 未列 | 未列 |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | 未列 | 未列 |
注:2026-10-24 抓取,單位美元/百萬 tokens,價格不含稅。來源:官方定價頁。
從表裏可以讀出幾個規律。第一,K3.1 Pro 的 5 分鐘緩存寫入價和普通輸入價相同,都是 $2,也就是說開啓 5 分鐘緩存幾乎沒有額外成本;1 小時寫入是 $4,爲輸入價的 2 倍。第二,Highspeed 版本所有項都是標準版的兩倍,唯獨緩存命中價同樣是 $0.20,長前綴複用場景下兩者的差距會被縮小。第三,K2.7 Code 和 K2.6 的單價不到 K3.1 Pro 的一半,對於不需要最強推理能力的任務,它們仍然是更便宜的選擇。
2.1 Kimi K3.1 Pro 與同價位模型橫向對比
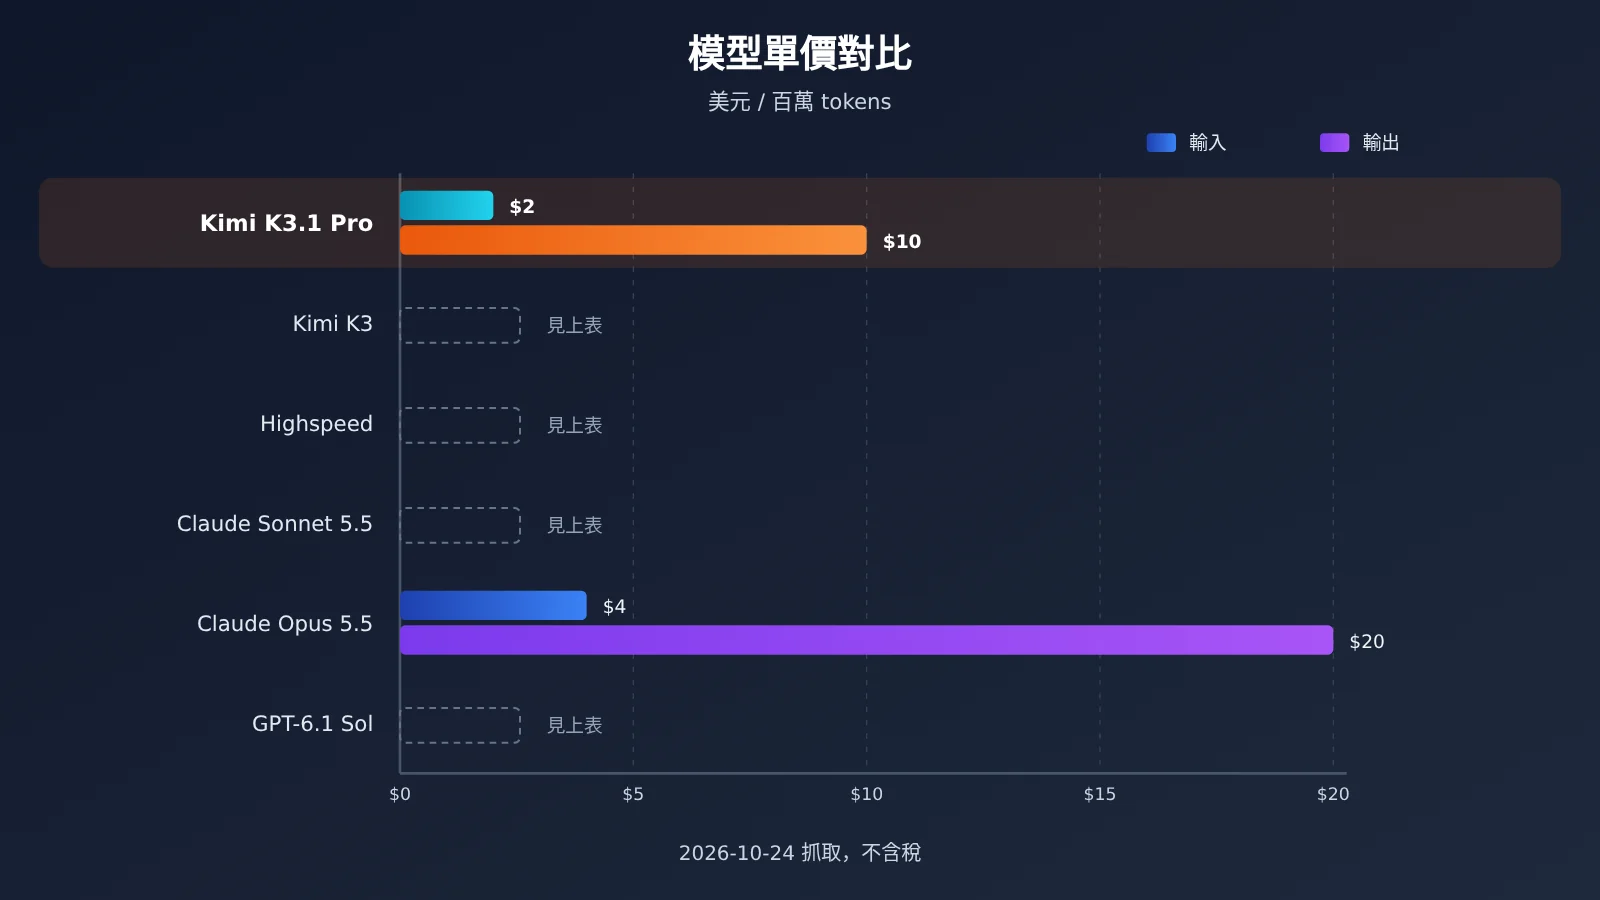
按同一口徑(美元/百萬 tokens)把幾家主流模型放在一起看,K3.1 Pro 的位置會更清楚。
| 模型 | 輸入 / 輸出 | 緩存命中輸入 | 緩存寫入 · 短檔 | 緩存寫入 · 長檔 | 來源 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2(5 分鐘) | $4(1 小時) | 官方 |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4(5 分鐘) | $8(1 小時) | 官方 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50(5 分鐘) | $4(1 小時) | 官方 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5(5 分鐘) | $8(1 小時) | 官方 |
| GPT-6.1 Sol(輸入 ≤272K) | $2 / $10 | $0.10 | $2.50(30 分鐘) | $5(12 小時) | 官方 |
| GPT-6.1 Sol(輸入 >272K) | $4 / $15 | $0.20 | $5(30 分鐘) | $10(12 小時) | 官方 |
| GPT-6 Astra(輸入 ≤272K) | $10 / $50 | $1.00 | $12.50(30 分鐘) | $25(12 小時) | 官方 |
| GPT-6 Astra(輸入 >272K) | $20 / $75 | $2.00 | $25(30 分鐘) | $50(12 小時) | 官方 |
表內數據來自各家官方定價頁,2026-10-24 抓取,單位美元/百萬 tokens,不含稅。三家的緩存檔位不一樣:Kimi 與 Claude 是 5 分鐘 / 1 小時,OpenAI 是 30 分鐘 / 12 小時,寫入價分別是未緩存輸入價的 1.25 倍與 2.5 倍;讀取價多數模型是輸入價的 10%,只有 GPT-6.1 Sol 是 5%。OpenAI 還按輸入長度分檔:≤272K tokens 走短上下文價,>272K tokens 跳到長上下文價。表內只列標準檔,OpenAI 的 Batch 半價、Fast(原 Priority)和 UltraFast 更貴,都沒列。
對比下來,Claude Sonnet 5.5 和 GPT-6.1 Sol 的緩存命中價更低(都是 $0.10),頻繁複用長前綴的場景下它們更有優勢。但 Sonnet 5.5 的 5 分鐘寫入價是 $2.50,比 K3.1 Pro 的 $2 略高。相比之下,K3.1 Pro 在“寫入便宜、上下文統一單價”這兩點上更適合一次性讀入大文檔的任務。Claude Opus 5.5 的輸入輸出都是 K3.1 Pro 的兩倍,選它的理由應該是能力需求,而不是價格。GPT-6.1 Sol 的短板在緩存寫入:30 分鐘檔 $2.50,比 K3.1 Pro 的 5 分鐘檔 $2 貴;而且它按輸入長度分檔,超過 272K tokens 後輸入漲到 $4、輸出漲到 $15,長文檔任務要按長上下文那一行算。
選擇建議:同價位模型實際效果差異要看具體任務,建議用同一批提示詞分別跑一遍再決定。API易(apiyi.com)的模型表裏同時有 claude-sonnet-5-5、claude-opus-5-5、kimi-k3 等型號,可以用一個 Key 對比測試;K3.1 Pro 的具體型號名與價格以平臺型號列表爲準,我們會盡快推出此模型。
3. Kimi K3.1 Pro 一次請求多少錢:3 個算賬示例
價目表看懂了,真正關心的還是“我這一次調用要花多少”。下面三個例子覆蓋了短對話、長提示覆用和長文檔閱讀三類典型場景,算式都寫出來了,你把自己的 token 數代進去即可。通用公式是:費用 = token 數 × 單價 ÷ 1,000,000。
3.1 示例 1:Kimi K3.1 Pro 短請求成本
場景:一次普通問答,輸入 2,000 tokens(沒有命中緩存),輸出 500 tokens。
- 輸入:
2000 × 2 ÷ 1000000 = $0.004 - 輸出:
500 × 10 ÷ 1000000 = $0.005 - 合計:
$0.004 + $0.005 = $0.009
也就是說一次這樣的短對話不到一美分。需要注意的是,輸出單價是輸入的 5 倍,短請求裏輸出往往佔了一半以上的費用,控制輸出長度比壓縮輸入更有效。
3.2 示例 2:Kimi K3.1 Pro 長提示覆用與緩存
場景:系統提示詞 20,000 tokens,在 5 分鐘內連續提 10 個問題,每次追加 1,000 tokens 新輸入,輸出 800 tokens。
不用緩存時,每次請求都要按全價付整段提示詞:
- 單次:
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - 10 次:
$0.05 × 10 = $0.50
用緩存時,第一次需要把系統提示寫入緩存,之後 9 次直接命中:
- 第 1 次:寫入
20000 × 2 ÷ 1000000 = $0.04,加新輸入$0.002、輸出$0.008,共$0.05 - 第 2-10 次每次:命中
20000 × 0.2 ÷ 1000000 = $0.004,加$0.002 + $0.008,共$0.014 - 後 9 次合計:
$0.014 × 9 = $0.126 - 總計:
$0.05 + $0.126 ≈ $0.18
同樣 10 次對話,從 $0.50 降到約 $0.18,省掉約六成。這類“固定長提示 + 多輪追問”的結構在客服機器人、代碼助手、Agent 框架裏非常常見,是緩存最能發揮作用的地方。
3.3 示例 3:Kimi K3.1 Pro 長文檔閱讀
場景:把一份 300,000 tokens 的文檔讀一遍,輸出 3,000 tokens 的總結。
- 輸入:
300000 × 2 ÷ 1000000 = $0.60 - 輸出:
3000 × 10 ÷ 1000000 = $0.03 - 合計:約
$0.63
如果 5 分鐘內針對同一份文檔再問一個問題,文檔部分會命中緩存,光輸入只需要 300000 × 0.2 ÷ 1000000 = $0.06,再加上本次輸出的費用即可。對需要反覆追問同一份合同、財報、代碼庫的場景,把提問集中在緩存有效期內能顯著降低成本。
4. Kimi K3.1 Pro 1M 上下文統一單價:不分檔意味着什麼
上下文可以理解成“模型一次能看到的內容總量”,包括你的提示詞、歷史對話和上傳的文檔。官方文檔寫明 K3 系列全部支持 1,048,576 tokens 上下文,並且 K3.1 Pro 採用扁平按量計費,不按上下文長度分檔。
官方 FAQ 的原意是:K3.1 Pro 用 1M 上下文和扁平按量計費,緩存寫入、輸入(命中與未命中)、輸出全部按統一單價計費。換句話說,你發 2,000 tokens 和發 800,000 tokens,每百萬 token 的單價都是同一個 $2,不會因爲請求變長而換算成更貴的價格。
這一點在對比時很關鍵,因爲不是所有廠商都這樣算。OpenAI 的 GPT-6 系按輸入長度分檔:≤272K tokens 走短上下文價,超過 272K tokens 立刻換成更貴的長上下文價(以 GPT-6 Astra 爲例,輸入從 $10 跳到 $20、輸出從 $50 跳到 $75,緩存命中從 $1.00 跳到 $2.00)。Claude 走的是另一條路:官方定價頁寫明 Claude 4.6 及之後的模型(Claude Haiku 5.5 除外)在完整的 1M 上下文裏都按標準價計費,90 萬 tokens 的請求和 9 千 tokens 的請求單價相同;只有 Claude Haiku 5.5 會在提示超過 10 萬 tokens 後漲價。所以 K3.1 Pro 的「不分檔」不是獨一份,Claude Sonnet 5.5 / Opus 5.5 也不按長度加價,真正會跳檔的是 GPT-6 系。
對開發者來說,統一單價帶來兩個直接好處:
- 預算可以線性估算:token 數翻倍,費用就翻倍,不會在某個長度突然跳漲,示例 3 那種 30 萬 token 的文檔可以放心按單價直接乘。
- 不必刻意切分文檔:在分檔計價的模型上,有人會把長文檔切成多段來避開高價檔;在 K3.1 Pro 上這樣做不會省錢,反而可能因爲丟失上下文影響效果。
5. 爲什麼 Kimi K3.1 Pro 省錢,以及不省錢的地方
這一節把賬算得老實一點。單價確實降了,但實際任務成本還受輸出長度影響。
| 維度 | 具體情況 | 來源 | 對成本的影響 |
|---|---|---|---|
| 單價下調 | 輸入、輸出、緩存命中三項都比 K3 低 33% | 官方 / 第三方 | 省錢 |
| 緩存命中價 | $0.20,只有輸入價的 1/10 | 官方 | 長前綴複用場景大幅省錢 |
| 1 小時緩存寫入 | $4,是輸入價的 2 倍 | 官方 | 長間隔任務更划算,短任務不必用 |
| 始終思考 | 不能關閉思考,平均輸出 55K tokens,比 K3 多 14% | 官方 / 第三方 | 抵消一部分降價 |
| 單任務成本 | $1.98(發佈文章)/ $2.11(模型頁加權) | 第三方 | 與 K3 基本持平 |
5.1 Kimi K3.1 Pro 省錢的三個點
第一是單價直接降 33%,從 K3 的 $3/$15 降到 $2/$10,緩存命中從 $0.30 降到 $0.20,這一點官方價目表和 Artificial Analysis 的數據一致。第二是緩存命中只要輸入價的 1/10,示例 2 已經算過,固定長提示的多輪對話能省掉約六成。第三是 1 小時緩存寫入雖然是 2 倍價,但它讓緩存保留更久,適合兩次調用間隔超過 5 分鐘的任務,比如每隔十幾分鍾跑一次的定時 Agent,或者用戶會停下來思考再追問的長文檔問答。只要 1 小時內命中兩次以上,多付的寫入費通常就能收回來。
5.2 Kimi K3.1 Pro 不省錢的地方
思考指模型在給出答案前先在內部推演一段,這部分推演內容同樣按輸出計費。官方文檔說明 K3.1 Pro 不能關閉思考,只能把 reasoning_effort 調到 low 來減少思考量。
根據 Artificial Analysis(第三方)的測算,K3.1 Pro 在其 Intelligence Index 每個任務上平均輸出約 55K tokens,K3 爲 48K,多出 14%。輸出單價是最貴的一項,多出來的這部分 token 喫掉了一部分降價空間。最終第三方算出的單任務成本約 $1.98(發佈文章口徑),模型頁顯示的加權單任務成本爲 $2.11(緩存摺扣按 90% 計),和 K3 基本持平。
所以結論是:如果你的業務以長輸入、多輪複用爲主,K3.1 Pro 的降價能明顯體現在賬單上;如果主要是複雜推理、輸出很長的任務,單任務成本未必比 K3 低,建議先拿真實任務小規模跑一批,再看實際賬單。
6. Kimi K3.1 Pro 充值門檻與限流檔位
官方採用按量付費,沒有訂閱制,而且 Kimi API 和 Kimi 會員、Kimi Code 是兩套獨立計費,會員不能抵 API 費用。賬戶至少充值 $1 才能開始調用;累計充值滿 $5 送 $5 代金券,代金券不計入累計充值金額(官方)。
限流檔位由累計充值金額決定。先解釋幾個縮寫:併發是同一時刻能同時進行的請求數;RPM 是每分鐘最多請求次數;TPM 是每分鐘最多處理的 token 數;TPD 是每天最多處理的 token 數。
| 檔位 | 累計充值 | 併發 | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 50 萬 | 150 萬 |
| Tier1 | $10 | 15 | 100 | 200 萬 | 不限 |
| Tier2 | $20 | 40 | 100 | 300 萬 | 不限 |
| Tier3 | $100 | 50 | 200 | 300 萬 | 不限 |
| Tier4 | $1000 | 60 | 200 | 400 萬 | 不限 |
| Tier5 | $3000 | 100 | 300 | 500 萬 | 不限 |
注:來源爲官方限流文檔(platform.kimi.ai 的 pricing/limits 頁面),2026-10-24 抓取。
Tier0 的限制非常緊:每分鐘只能發 3 個請求,每天總共 150 萬 tokens。按示例 3 的 30 萬 token 文檔算,一天讀 5 次就到頂了,而且 TPM 50 萬意味着一分鐘內連兩份這樣的文檔都放不下。如果你要做批量處理或者上線給用戶用,建議在測試階段就把累計充值提到 Tier1 以上。
還有一條需要特別注意:官方說明觸發風控限流後不可解除。上線前請在客戶端做好請求速率控制和重試退避,不要用併發腳本去試探上限。
7. Kimi K3.1 Pro 國內怎麼付費、怎麼接
官方渠道按美元計價、按付款地區規則結算,雖然國內能直接支付。對國內開發者來說,常見的顧慮是境外支付方式、發票,以及要同時維護多家廠商的 Key。另一種做法是通過 API 聚合平臺接入,用一個賬戶和一個 Key 調用多家模型。
API易(apiyi.com)是一個 AI 大模型 API 聚合平臺,一個 API Key 可以調用 OpenAI、Claude、Gemini 等主流模型,接口兼容 OpenAI 格式,按量計費,新用戶有免費測試額度。根據 2026-10-24 對平臺模型表 docs.apiyi.com/models 的核對,Kimi 系列目前上架的有:
kimi-k3:輸入 $3 / 輸出 $15 / 緩存讀 $0.3kimi-k2.7-code:輸入 $0.95 / 輸出 $3.99 / 緩存讀 $0.19kimi-k2.6:輸入 $0.6 / 輸出 $2.4 / 緩存讀 $0.1kimi-k2.5:輸入 $0.6 / 輸出 $3.15 / 緩存讀 $0.1
kimi-k3.1-pro 在覈對當天還沒有出現在 API易 的模型表裏,因此本文不給出它在平臺上的價格。K3.1 Pro 的型號名、價格和上架時間請以平臺控制檯的型號列表爲準,我們會盡快推出此模型;在此之前,可以先用 kimi-k3 跑通流程,上架後只需要改型號名。
7.1 Kimi K3.1 Pro 快速上手步驟
無論走官方還是聚合平臺,接入步驟大致相同。以 OpenAI 兼容方式爲例:
- 註冊並獲取 API Key,官方渠道需先充值至少 $1。
- 在你使用的 OpenAI SDK 或客戶端裏,把
base_url設爲https://api.apiyi.com/v1(走 API易 時);如果項目用的是 Anthropic 格式,base 地址填https://api.apiyi.com。 - 把
api_key設爲你的 Key,model填平臺型號列表裏的名稱,例如目前可用的kimi-k3,K3.1 Pro 上架後按列表填寫。 - 如果想壓縮思考帶來的輸出成本,在請求參數里加入
reasoning_effort,值設爲low(官方說明 K3.1 Pro 只支持調低,不支持關閉)。 - 把固定的長系統提示詞放在消息最前面且保持不變,讓重複前綴能自動命中緩存。
- 調用後在賬單或響應的用量字段裏覈對輸入、命中、輸出各自的 token 數,再按第 3 節的公式復算。
快速上手建議:先用 API易 apiyi.com 的免費測試額度把第 3 節的示例 2 跑一遍,對比開啓和不開啓固定前綴時的用量差異,這是驗證緩存是否生效最快的辦法。K3.1 Pro 在平臺上的型號與價格以型號列表爲準,我們會盡快推出此模型。
常見問題 FAQ
Q1:Kimi K3.1 Pro 價格到底是多少?
官方價格爲輸入 $2、輸出 $10、緩存命中 $0.20、5 分鐘緩存寫入 $2、1 小時緩存寫入 $4,單位美元/百萬 tokens,不含稅,2026-10-24 抓取。
Q2:Kimi K3.1 Pro 比 K3 便宜多少?實際賬單會降 33% 嗎?
單價三項都低 33%(官方)。但 K3.1 Pro 始終思考,平均輸出多 14%,第三方 Artificial Analysis 測算的單任務成本約 $1.98 到 $2.11,與 K3 基本持平。長輸入、多輪複用的場景降幅會更明顯。
Q3:Kimi K3.1 Pro 和 Claude Sonnet 5.5 選哪個更省錢?
兩者輸入輸出同爲 $2/$10。Sonnet 5.5 緩存命中更便宜($0.10),K3.1 Pro 的 5 分鐘寫入更便宜($2 對 $2.50),且 1M 上下文統一單價。高頻複用短前綴偏向 Sonnet,大文檔一次性讀入偏向 K3.1 Pro,最好用真實任務對比。
Q4:Kimi K3.1 Pro 的 1 小時緩存值得開嗎?
1 小時寫入是 $4,比 5 分鐘寫入多 $2。只要同一前綴在 5 分鐘以外、1 小時以內會被再次使用兩次以上,通常就值得開;調用都集中在幾分鐘內的,用默認 5 分鐘即可。
Q5:國內開發者如何通過 API 調用 Kimi K3.1 Pro?
可以走官方渠道,也可以通過 API易 apiyi.com 用 OpenAI 兼容接口接入,`base_url` 填 `https://api.apiyi.com/v1`。平臺目前已有 `kimi-k3`、`kimi-k2.7-code` 等型號;K3.1 Pro 的型號與價格以平臺型號列表爲準,我們會盡快推出此模型。
Q6:Kimi 會員能抵扣 API 費用嗎?
不能。官方說明 Kimi API 是按量付費,沒有訂閱制,和 Kimi 會員、Kimi Code 是兩套計費。
Q7:Kimi K3.1 Pro 有哪些計費上的坑?
– 不能關閉思考,輸出 token 會偏多,可用 `reasoning_effort` 設爲 `low` 緩解。
– Tier0 只有 3 RPM、150 萬 TPD,量大要提前升檔。
– 觸發風控限流後不可解除。
– 文件抽取免費,但抽取內容送入模型仍按輸入計費。
Q8:還沒上架 K3.1 Pro 的平臺上,現在能先做什麼準備?
可以先在 API易 apiyi.com 用 `kimi-k3` 搭好調用鏈路、緩存結構和用量統計,K3.1 Pro 上架後替換型號名即可。具體型號名與價格以平臺型號列表爲準,我們會盡快推出此模型。
Kimi K3.1 Pro 價格核心要點 Key Takeaways
- 基礎價格:輸入 $2 / 輸出 $10 / 緩存命中 $0.20,官方價,不含稅。
- 五檔齊全:5 分鐘寫入 $2、1 小時寫入 $4,寫入成本很低。
- 對比定位:與 Sonnet 5.5、GPT-6.1 Sol 同價,是 Opus 5.5 的一半。
- 統一單價:1M 上下文不按長度分檔,預算可線性估算。
- 真實成本:始終思考、輸出多 14%,單任務成本與 K3 基本持平(第三方)。
- 起步門檻:充值 $1 起,Tier0 僅 3 RPM,風控限流不可解除。
- 國內接入:可通過 API易 用 OpenAI 兼容接口接入,K3.1 Pro 型號與價格以平臺列表爲準,我們會盡快推出此模型。
總結
Kimi K3.1 Pro 價格的核心要點:
- 單價:$2 輸入 / $10 輸出 / $0.20 緩存命中,比 K3 低 33%,1M 上下文統一單價。
- 省錢關鍵:把固定長前綴放在最前面,用好緩存,多輪對話能省掉約六成輸入成本。
- 成本預期:始終思考帶來更長輸出,複雜推理任務的單任務成本與 K3 接近,不要按 33% 降幅做預算。
- 上線準備:提前升級限流檔位,做好速率控制,避免觸發不可解除的風控限流。
建議先用第 3 節的公式結合自己的 token 分佈估一遍賬,再用少量真實任務驗證。需要在國內用一個 Key 對比 Kimi、Claude、GPT 等模型的,可以通過 API易 apiyi.com 先拿免費額度測試;K3.1 Pro 在平臺上的型號與價格以型號列表爲準,我們會盡快推出此模型。
參考資料
- Kimi 開放平臺 – 模型定價:K3.1 Pro 及各型號五檔價格與計費規則
- 鏈接:
platform.kimi.ai/docs/pricing/chat -
說明: 本文價目表與 1M 上下文統一計費說明的官方來源
-
Kimi 開放平臺 – 充值與限流:Tier0 到 Tier5 檔位與風控說明
- 鏈接:
platform.kimi.ai/docs/pricing/limits -
說明: 充值門檻、RPM/TPM/TPD 限制的官方來源
-
Artificial Analysis – Kimi K3.1 Pro:第三方單任務成本與輸出 token 測算
- 鏈接:
artificialanalysis.ai -
說明: 本文 $1.98 / $2.11 單任務成本與 55K 輸出 tokens 數據來源
-
API易 模型列表:平臺當前上架型號與價格
- 鏈接:
docs.apiyi.com/models - 說明: Kimi、Claude 等型號在平臺上的實際可用情況
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心