作者注:對比 GPT-Image 官轉、-all、-vip 三類通道在計費、尺寸、局部編輯上的差異,覆盤 2026 年 4–10 月的歷史故障,並給出“有限重試 + 熔斷 + 備用通道”的兜底方案。
接入 GPT-Image 的開發者很快會遇到一個問題:同一個圖像模型,平臺上卻有好幾個名字。官轉(如 gpt-image-2.5-flare)、-all 和 -vip 的計費方式、參數能力不同,出故障的原因也不同。本文從這幾個維度比較三類 GPT-Image 通道,並給出可以直接落地的選型和兜底方案。
這不是一份“各有千秋”的折中分析。 下文的判斷依據來自 API易 文檔中心的通道對比頁、模型註冊表,以及 2026 年 4–10 月的實時狀態播報。我們會區分哪些是平臺公告,哪些是平臺實測,哪些只是歷史記錄。
核心價值:讀完本文,你會知道自己的業務該用哪條 GPT-Image 通道做主通道、哪條做備用,以及遇到 429、408、5xx 時程序應該怎麼處理。
GPT-Image 通道是什麼:官轉、官逆與企業分組
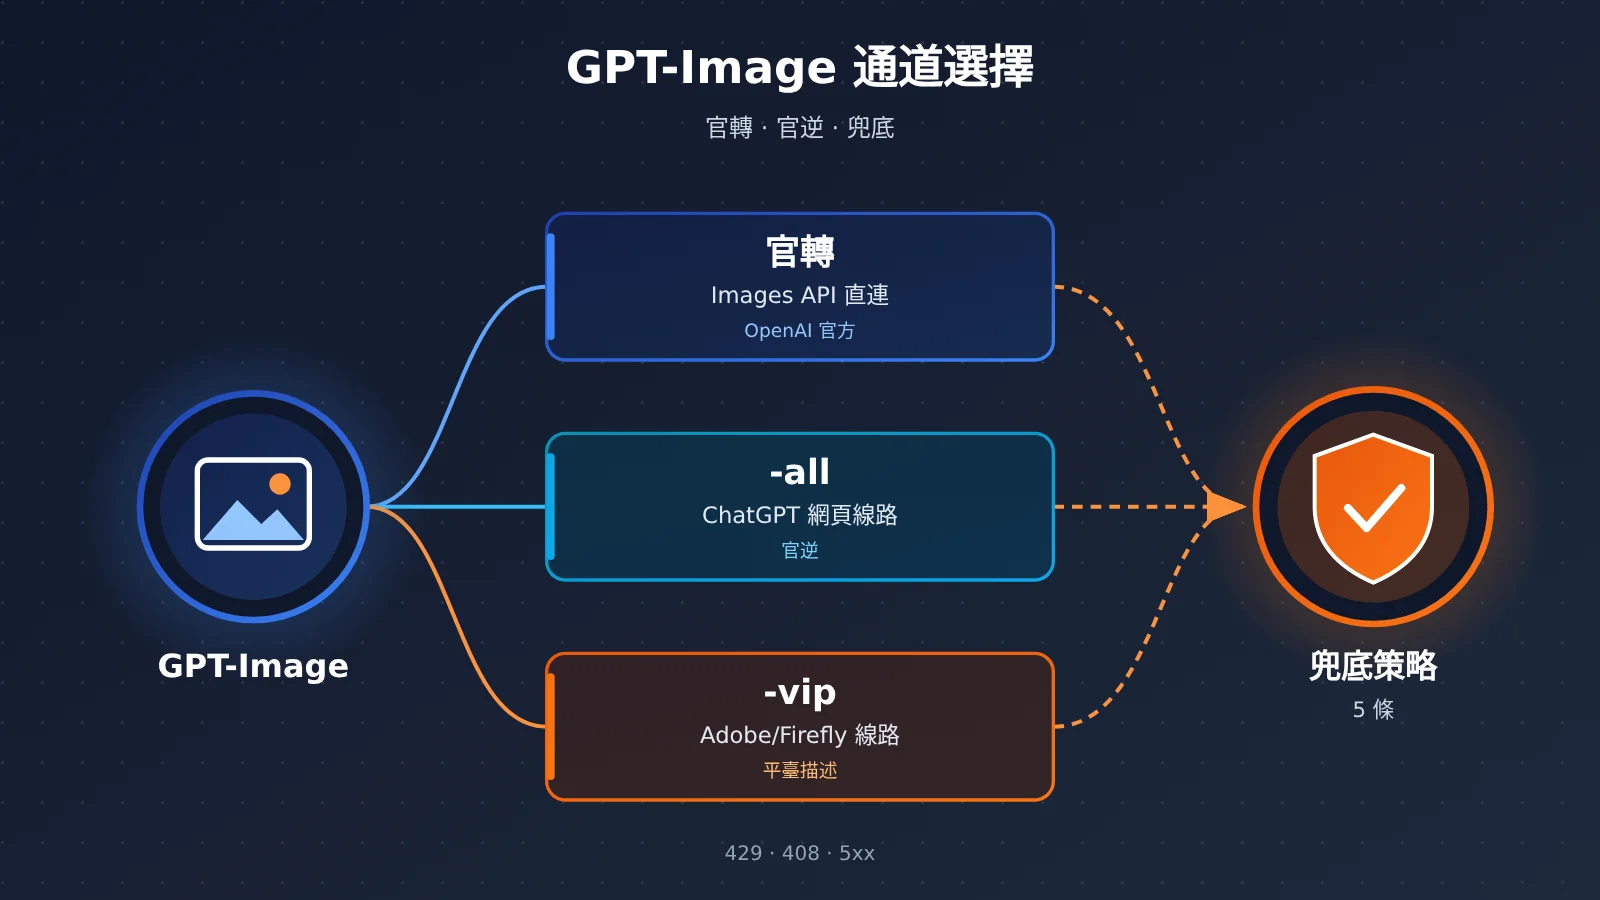
“官轉”和“官逆”是 API易 平臺對通道的分類方式,並不是 OpenAI 官方的術語。官轉指通過 OpenAI 官方 Images API 直連轉發的線路。官逆指通過非官方逆向方式接入的資源,它不代表 OpenAI 提供了這些逆向 API。
| 通道類型 | 平臺文檔定義 | 代表模型 | 主要上游依賴 |
|---|---|---|---|
| 官轉 | OpenAI 官方 Images API 直連轉發 | gpt-image-2.5-flare、gpt-image-2.5-sunburst | OpenAI API 算力與配額 |
| -all(官逆) | ChatGPT 網頁線路的逆向接入 | gpt-image-2-all、gpt-image-2.5-all | ChatGPT 網頁版可用性 |
| -vip(官逆) | 平臺文檔將其描述爲 Adobe / Firefly 線路的逆向資源 | gpt-image-2-vip、gpt-image-2.5-flare-vip、gpt-image-2.5-sunburst-vip | 平臺號池併發與上游風控 |
GPT-Image 企業分組 image2Enterprise 的定位
image2Enterprise 經常被誤認爲一個獨立模型,其實它是令牌分組。它在 2026-04-25 新增,目錄倍率爲 1.2x,Default、image2_OSS、SVIP 分組的倍率爲 1.0x。2026-04-27 和 2026-09-21 都出現過默認分組資源緊張、企業分組仍然穩定的情況,所以它曾經是官轉的兜底路徑。
企業分組也有自己的邊界。2026-05-07 企業分組官轉同樣受到 OpenAI 上游故障影響,可見它能緩解默認分組擁擠,卻不能規避所有上游問題。此外,模型註冊表中列出某個分組,並不等於每個賬戶都有資格使用,具體開通條件請以控制檯爲準。
GPT-Image 2.6 與舊通道的邊界
截至 2026-11-11,API易 模型註冊表中已經有 gpt-image-2.6-flare 和 gpt-image-2.6-sunburst 兩款按 Token 計費的模型,但沒有列出 2.6 對應的 -all 或 -vip 型號。因此,2.5 VIP 的尺寸和畫質能力不能直接推到 2.6 上。還要注意,對比頁稱舊版 gpt-image-2 官方直連已在 2026-09-30 關閉,但註冊表仍保留了這個 ID。新項目的官轉示例建議直接用 2.5 Flare 或 Sunburst。按平臺上線說明,flare 出圖更快,sunburst 的編輯能力更強。
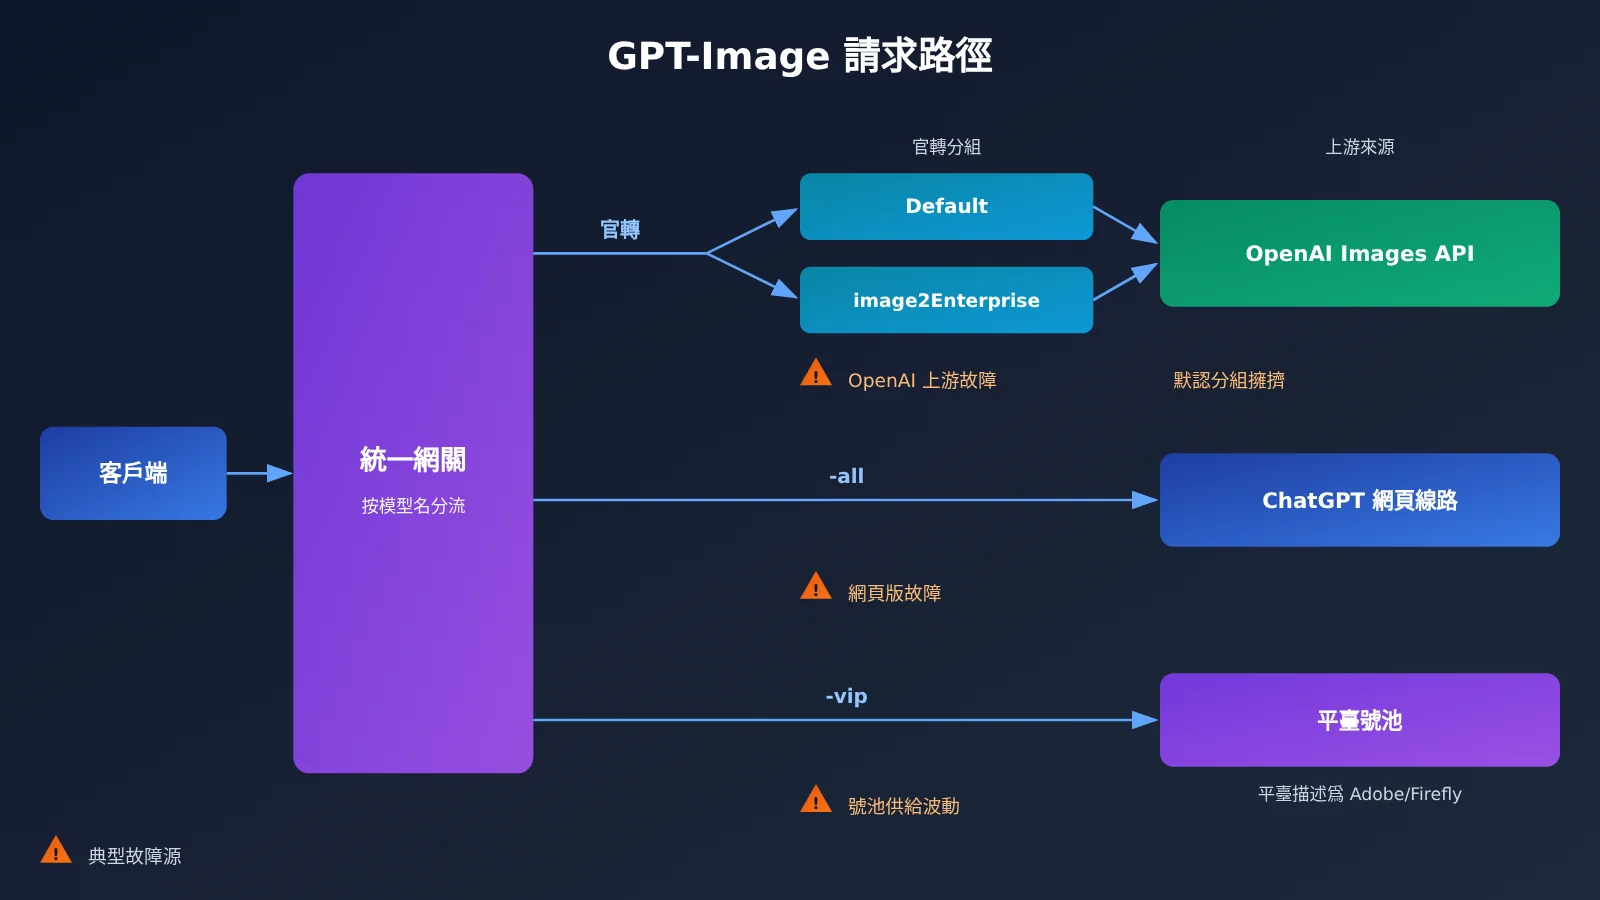
GPT-Image 官轉 vs -all vs -vip 核心差異
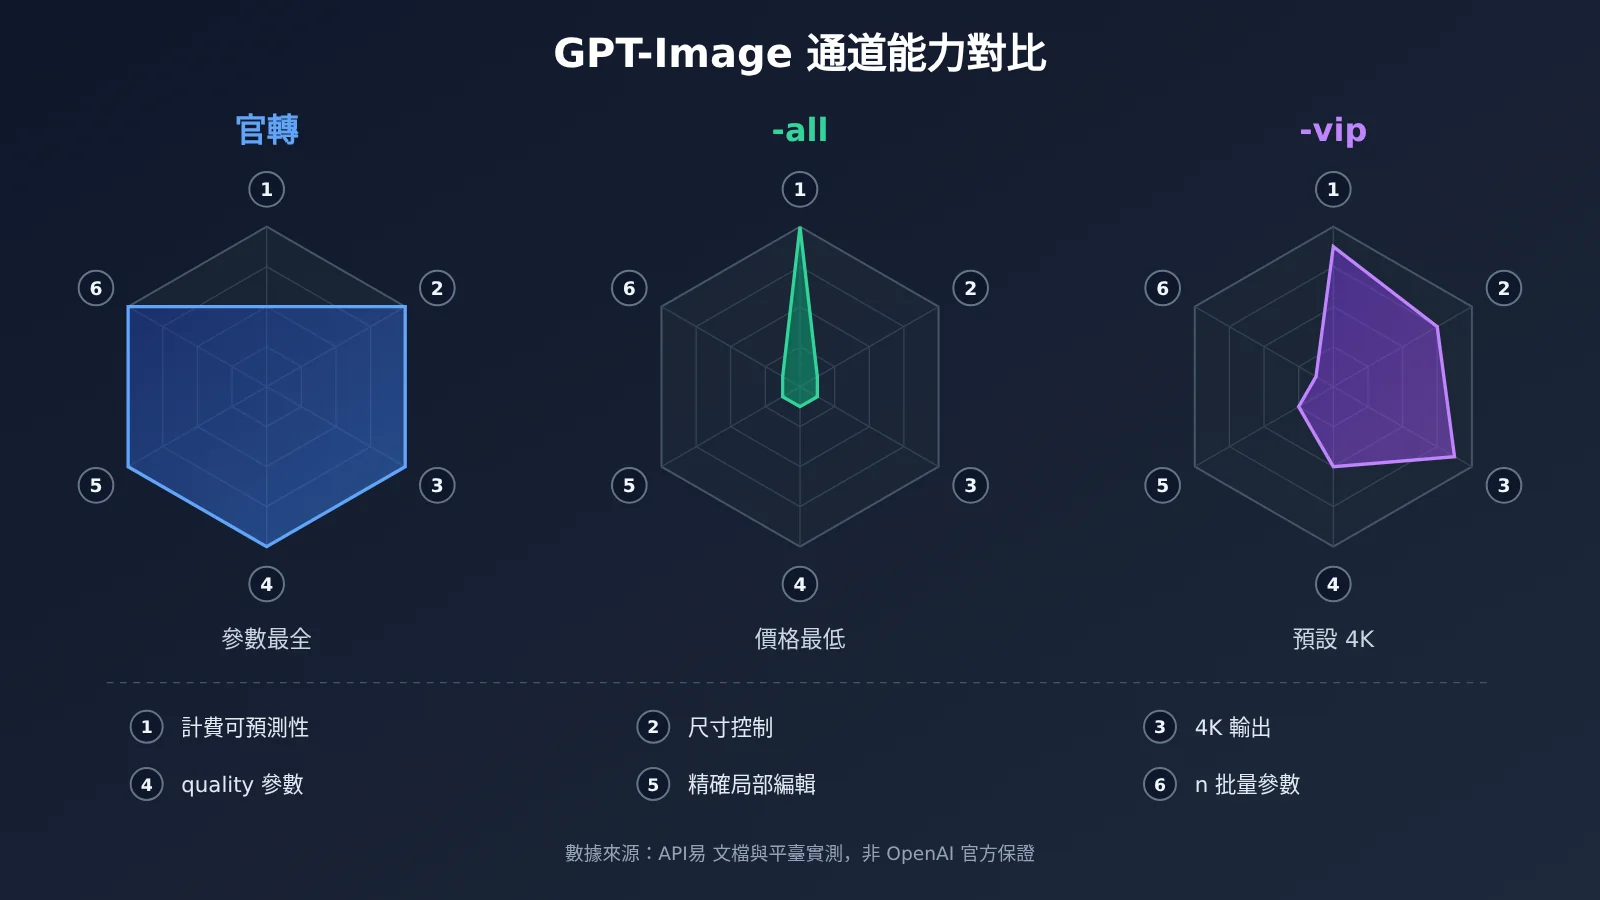
| 對比維度 | 官轉(2.5 flare / sunburst) | -all | -vip | 勝出 |
|---|---|---|---|---|
| 計費方式 | 按 Token,隨尺寸和畫質變化 | $0.025/張(2026-10-10 起) | $0.03/張 | 成本可預測:-all |
| size 參數 | 任意合法尺寸 | 不支持 | 30 檔常見尺寸 | 官轉 |
| 4K 輸出 | 支持 | 不支持 | 支持預設 4K | 官轉 / -vip |
| quality 參數 | 官方參數支持 | 不支持 | 渠道行爲,範圍因型號而異 | 官轉 |
| n 多張生成 | 支持 | 不支持 | 不支持 | 官轉 |
| 精確 mask 局部重繪 | 支持 | 不支持 | 不保證,只能整圖重繪 | 官轉 |
| 典型用途 | 參數控制、精確編輯 | 固定價格批量出圖 | 固定價格、預設尺寸與 4K | — |
GPT-Image 通道對比解讀
官轉對標分析:官轉在參數完整度上領先,size、quality、n、mask 都按官方 Images API 的方式生效,適合需要精細控制的生產環境。不過它按 Token 計費,大尺寸、高畫質的單張成本會上升,不能直接和按次價格比較。平臺實測還發現,官轉提示詞上限約爲 8192 tokens,超出後不會報錯,但出圖會混亂,長提示詞需要在客戶端截斷。另外,gpt-image-2 的透明背景功能已被 OpenAI 官方關停,需要透明底時平臺建議使用 2.5 官轉。
-all 對標分析:-all 的優勢是價格固定且最低,適合大批量、對構圖要求不嚴的出圖任務。它不支持 size、quality、n 和 mask,調用時最好只傳 prompt。-all 依賴 ChatGPT 網頁版,網頁版一出故障它就會同步受影響。
-vip 對標分析:-vip 介於兩者之間,按次計費,同時提供預設尺寸和 4K,適合需要固定成本又要高分辨率的場景。它的參數行爲屬於渠道行爲而非官方保證。2.5 VIP 的 xhigh、max 畫質檔位是平臺實測開放的,不能當成所有逆向模型都具備的能力。
對比說明:上表價格爲 API易 平臺目錄口徑(充值贈送和分組折扣前),不是 OpenAI 官方的按張報價,最終價格以 apiyi.com 控制檯顯示爲準。
GPT-Image 通道歷史故障覆盤:爲什麼不能只押一條線路
只看功能表會漏掉一個關鍵因素:三類通道的故障來源和恢復節奏都不一樣。下面摘錄 2026 年 4–10 月平臺狀態播報中的代表性事件。這些都是歷史記錄,不代表當前狀態。
| 日期(2026) | 通道 | 現象 | 平臺說明 / 建議 |
|---|---|---|---|
| 4 月 23–27 日 | 官轉默認分組 | 併發告急、臨時限額,出現 429 / 408 | 建議切換 image2Enterprise,timeout 調到 360–600 秒 |
| 5 月 7 日 | 官轉企業分組 | 報錯 | 根因在 OpenAI 上游 |
| 5 月 9 日 | 官轉默認分組 | 再次飽和 | 建議令牌切換企業分組 |
| 6 月 16–23 日 | -vip | size 參數失效,分辨率一度降到 1.5K、1K | 判斷爲上游規則調整,期間曾短暫恢復 |
| 7 月 7–13 日 | -all | 上游故障、超時 | 曾臨時指向 vip 通道,事後爲超時調用補發額度 |
| 8 月 24–25 日 | -vip | 上游風控限速、飽和 | 429 可重試,內容安全錯誤無需重試 |
| 9 月 10–15 日 | 2.5 -vip | 受 429 影響、資源不足 | 官轉與 -all 同期正常 |
| 10 月 15 日 | -all / -vip | -all 受 ChatGPT 網頁版故障影響,-vip 負載過高 | 建議官逆不可用時先用官轉兜底 |
| 10 月 19 日 | 2.5 -vip | 併發飽和 | 補充資源中 |
GPT-Image 通道故障模式歸納
把這些記錄放在一起,可以看出四種典型模式:
- 官轉默認分組資源不足:表現爲 429、408,企業分組能緩解一部分,但無法避開 OpenAI 上游本身的故障;
- -all 跟隨網頁版故障:ChatGPT 網頁版一出問題,-all 就同步報錯或變慢,平臺記錄的耗時從約 40 秒到約 80 秒都出現過;
- -vip 資源池飽和與參數漂移:除了 429,還出現過 size、quality 突然失效又恢復的情況,參數可用性本身也不穩定;
- 同一時間多條通道正常:9 月 10 日和 15 日,-vip 不可用時,官轉和 -all 都在正常運行,雙通道接入的價值就體現在這裏。
需要說明時間邊界:截至 2026-11-11 的歸檔中,最後一條明確涉及 GPT-Image 通道健康狀態的播報是 10 月 19 日。11 月 5 日和 9 日的記錄是 2.6 上線和文檔更新,不是狀態公告。所以本文不提供當天的穩定性排名,歷史耗時數據也不能當作 SLA。
GPT-Image 通道場景推薦
選擇官轉的場景
- 電商主圖、廣告圖:需要指定精確尺寸或 4K,還要用 quality 控制畫質;
- 局部重繪、換背景:依賴 mask 精確編輯,-vip 只能整圖重繪,-all 不支持 mask;
- 已有 OpenAI SDK 代碼:參數兼容性最好,遷移成本最低。
選擇 -all 的場景
- 批量素材、靈感草圖:對尺寸沒有硬性要求,最看重固定低價;
- 成本預算嚴格的內容生產:$0.025/張的固定價格方便做成本覈算。
選擇 -vip 的場景
- 需要 4K 但想按次計費:使用平臺提供的預設尺寸即可;
- 整圖生成爲主、不需要精確局部編輯:能接受渠道行爲帶來的參數波動。
| 業務場景 | 推薦主通道 | 推薦備用 | 降級時的注意點 |
|---|---|---|---|
| 精確局部編輯 | 官轉 sunburst | 官轉企業分組(有資格時) | 不要降到 -all / -vip,mask 會失效 |
| 指定尺寸商用圖 | 官轉 flare | -vip 預設尺寸 | 備用尺寸要映射到 30 檔預設 |
| 4K 高清固定成本 | -vip | 官轉 | 切換後改爲按 Token 計費 |
| 海量批量出圖 | -all | -vip(同爲按次計費) | 每張成本從 $0.025 變爲 $0.03 |
| 需要 n 張變體 | 官轉 | 多次循環調用 -all | 逆向通道不支持 n 參數 |
GPT-Image 通道兜底策略:重試、熔斷與降級
可靠的兜底並不是“報錯就重發”,而是先識別錯誤類型,再選擇處理動作。
| 錯誤類型 | 常見原因 | 是否重試 | 推薦處理 |
|---|---|---|---|
| 429 | 併發或速率限制、資源池飽和 | 是,必須退避 | 指數退避加隨機抖動,連續失敗後熔斷切換 |
| 408 / 客戶端超時 | 上游出圖慢、timeout 設置過短 | 有限重試 | 官轉 timeout 調到 360–600 秒,最多重試 2 次 |
| 5xx 系統錯誤 | 平臺或上游故障 | 有限重試 | 最多 2 次指數退避,仍失敗就切換備用通道 |
| 內容安全錯誤 | 提示詞或輸入圖觸發審覈 | 否 | 修改內容後再請求,原樣重試只會浪費配額 |
| 長期不恢復 | 上游大面積故障 | 否 | 熔斷當前通道,轉到經過健康檢查的備用通道 |
這裏有兩個容易踩的坑。第一,平臺曾說明 -all 返回的 500 通常是內容違規(不計費),而且從 5 月起 -all/-vip 的安全類 500 已改爲直接披露、不再內部重試,因此客戶端要讀取錯誤信息,不能見到 5xx 就重發。第二,-vip 曾出現 Unknown error,平臺的經驗是把單張輸入圖壓縮到 1.5MB 以內。
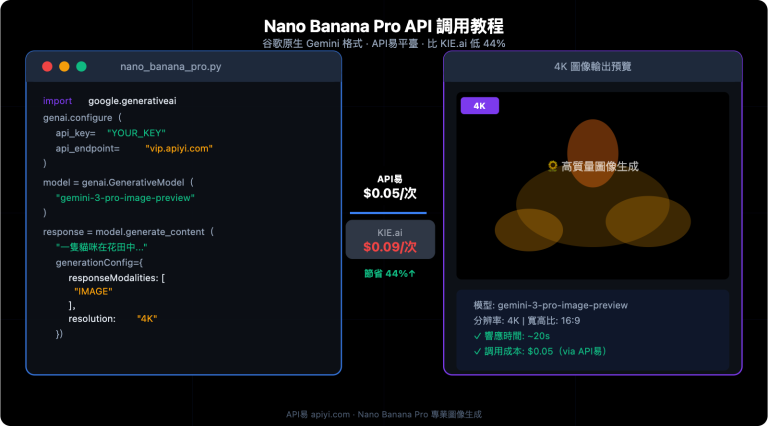
極簡示例
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
    timeout=600,  # 官轉出圖較慢,平臺曾建議 360–600 秒
)

resp = client.images.generate(
    model="gpt-image-2.5-flare",
    prompt="一隻在咖啡館窗邊看書的橘貓,柔和晨光,寫實攝影風格",
    size="1536x1024",
)
item = resp.data[0]
print(item.b64_json[:60] if item.b64_json else item.url)
查看完整實現代碼:多通道重試 + 熔斷 + 降級
import time
import random
import logging
import openai
from openai import OpenAI

logging.basicConfig(level=logging.INFO)
BASE_URL = "https://api.apiyi.com/v1"

# 通道按優先級排列;不同分組使用不同令牌
CHANNELS = [
    {"name": "official", "model": "gpt-image-2.5-flare",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024", "quality": "high"}},
    # 僅在賬號具備 image2Enterprise 分組資格時啓用
    {"name": "official-enterprise", "model": "gpt-image-2.5-flare",
     "key": "KEY_ENTERPRISE", "params": {"size": "1536x1024", "quality": "high"}},
    # -vip 的 size 需替換爲文檔中 30 檔預設之一
    {"name": "vip", "model": "gpt-image-2.5-flare-vip",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024"}},
    # -all 不支持 size / quality / n,只傳 prompt
    {"name": "all", "model": "gpt-image-2.5-all",
     "key": "KEY_DEFAULT", "params": {}},
]

FAIL_THRESHOLD = 3     # 連續失敗幾次後熔斷(示例值)
COOLDOWN = 120         # 熔斷冷卻秒數(示例值)
MAX_RETRY = 2          # 5xx / 超時最多重試 2 次
breaker = {c["name"]: {"fails": 0, "open_until": 0} for c in CHANNELS}


def classify(err: Exception) -> str:
    msg = str(err).lower()
    if any(k in msg for k in ("safety", "content_policy", "moderation", "violat")):
        return "content"
    if isinstance(err, openai.RateLimitError):
        return "rate_limit"
    if isinstance(err, openai.APITimeoutError):
        return "timeout"
    if isinstance(err, openai.APIStatusError):
        if err.status_code == 408:
            return "timeout"
        if err.status_code >= 500:
            return "server"
        return "fatal"
    if isinstance(err, openai.APIConnectionError):
        return "network"
    return "fatal"


def generate(prompt: str, need_mask: bool = False):
    for ch in CHANNELS:
        if need_mask and ch["name"] in ("vip", "all"):
            continue  # 精確編輯不降級到逆向通道
        state = breaker[ch["name"]]
        if time.time() < state["open_until"]:
            continue  # 通道熔斷中
        client = OpenAI(api_key=ch["key"], base_url=BASE_URL, timeout=600)
        for attempt in range(MAX_RETRY + 1):
            try:
                resp = client.images.generate(
                    model=ch["model"], prompt=prompt, **ch["params"])
                state["fails"] = 0
                logging.info("ok channel=%s model=%s", ch["name"], ch["model"])
                return ch["name"], resp.data[0]
            except Exception as e:
                kind = classify(e)
                logging.warning("fail channel=%s model=%s kind=%s req_id=%s",
                                ch["name"], ch["model"], kind,
                                getattr(e, "request_id", None))
                if kind in ("content", "fatal"):
                    raise  # 內容或參數問題:改請求,不重試
                if attempt < MAX_RETRY:
                    time.sleep(2 ** (attempt + 1) + random.uniform(0, 1))
        state["fails"] += 1
        if state["fails"] >= FAIL_THRESHOLD:
            state["open_until"] = time.time() + COOLDOWN
    raise RuntimeError("所有 GPT-Image 通道均不可用")
🚀 快速開始:建議先在 API易 apiyi.com 用新用戶的免費測試額度,對官轉、-vip、-all 做一輪 A/B 通道驗證:相同提示詞、相同尺寸,分別記錄耗時、成功率和畫面差異,再確定主備順序。
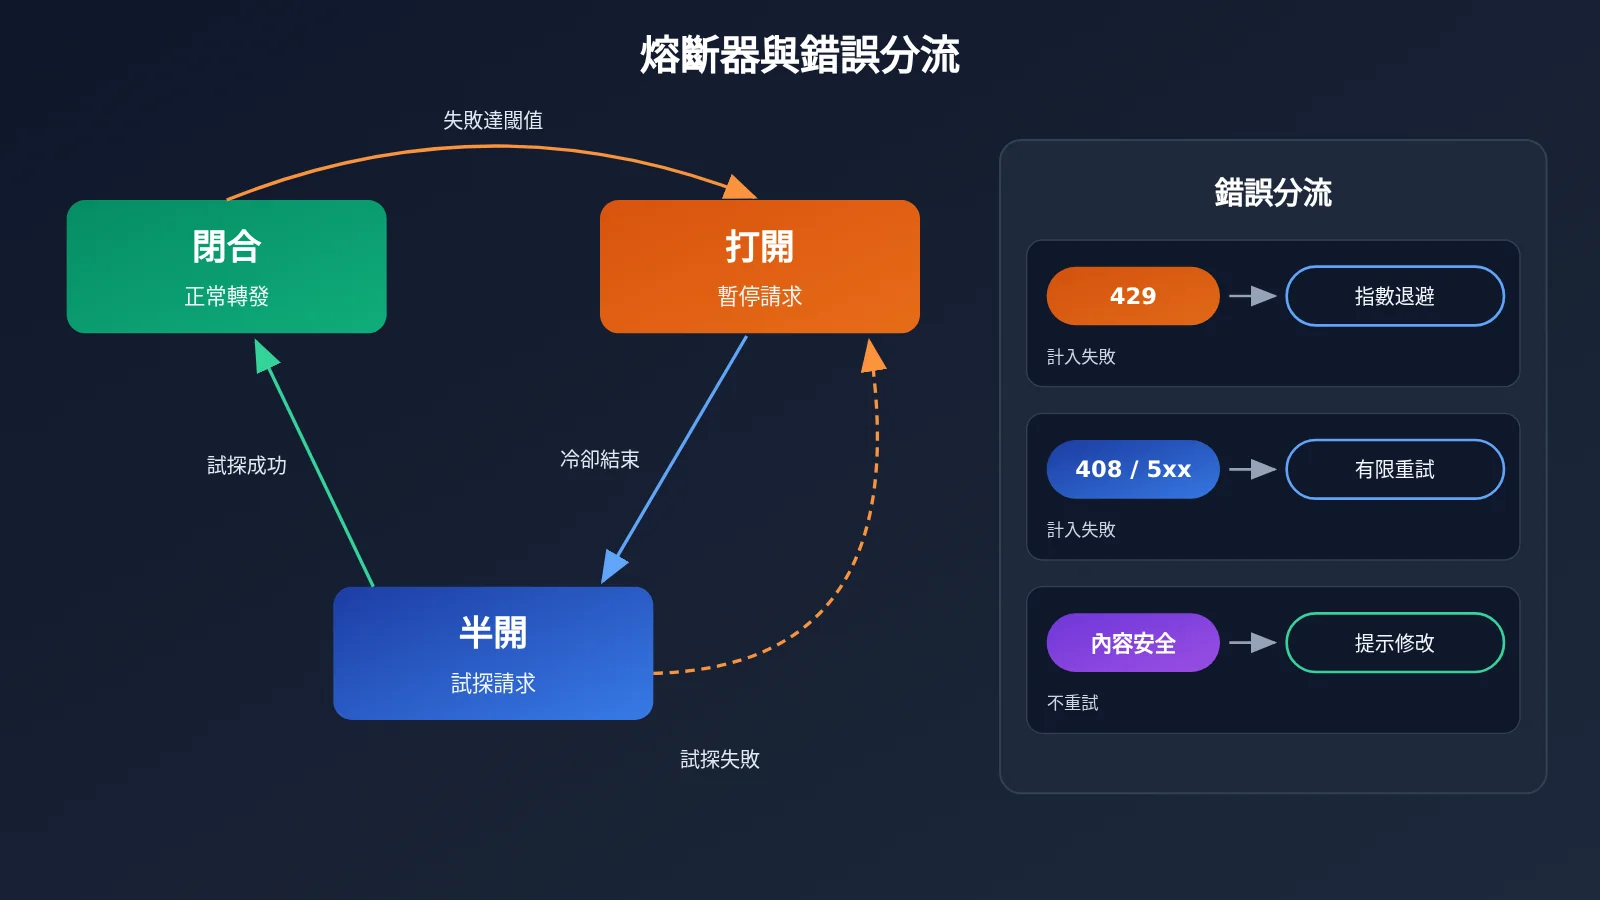
GPT-Image 通道決策建議
如果只能記住一條原則,那就是按業務的硬約束選主通道,按故障來源的差異選備用通道。需要 mask 精確編輯的業務,只能在官轉內部做冗餘,例如默認分組加企業分組。只需要整圖生成的業務,可以組合“官轉 + -vip”或“-all + -vip”,讓兩條故障來源不同的線路互相兜底。另外,每次請求都應記錄實際使用的模型、通道和 request_id,方便事後對賬和排障。
💡 選擇建議:通道表現會隨上游資源變化,歷史穩定不代表未來穩定。我們建議在 API易 apiyi.com 的統一接口下同時接入兩條以上通道,並定期用小流量做健康檢查,而不是憑一次測試結果長期固定選擇。
常見問題 FAQ
Q1:GPT-Image 的官轉和官逆分別是什麼?
官轉是通過 OpenAI 官方 Images API 直連轉發的線路。官逆是平臺對逆向接入資源的分類,包括基於 ChatGPT 網頁線路的 -all,以及平臺文檔描述爲 Adobe/Firefly 線路的 -vip。官逆並非 OpenAI 官方提供的 API。
Q2:GPT-Image -all 和 -vip 有什麼區別?
兩者都按次計費。-all 爲 $0.025/張,不支持 size、quality 和 4K。-vip 爲 $0.03/張,支持 30 檔預設尺寸和預設 4K,但參數行爲屬於渠道行爲,歷史上出現過 size 失效後又恢復的情況。
Q3:GPT-Image 2.6 也有 -all 和 -vip 嗎?
截至 2026-11-11 的模型註冊表中,只列出了 gpt-image-2.6-flare 和 gpt-image-2.6-sunburst 兩款按 Token 計費的模型,沒有 2.6 的 -all 或 -vip 型號。請不要把 2.5 VIP 的能力套用到 2.6 上。
Q4:image2Enterprise 企業分組能保證不出故障嗎?
不能。它在默認分組擁擠時多次穩定運行,但 2026-05-07 也受到過 OpenAI 上游故障的影響。它的倍率是 1.2x,開通資格以控制檯爲準,適合作爲官轉內部的冗餘,不能當成萬能保險。
Q5:如何通過 API 快速測試多條 GPT-Image 通道?
1. 在 API易 apiyi.com 註冊賬號,獲取 API Key 和免費測試額度;
2. 把 base_url 設爲 `https://api.apiyi.com/v1`,按本文代碼切換 model 參數;
3. 用同一提示詞分別調用各通道,記錄耗時、成功率和畫質。
統一接口下更換通道只需要改模型名,不用爲每個上游單獨維護一套 SDK。
Q6:遇到 5xx 應該一直重試嗎?
不應該。平臺文檔建議 5xx 和超時最多做 2 次指數退避重試。-all 的 500 通常與內容違規有關,重試不會成功。超過重試次數後,應熔斷當前通道並切換到備用通道。
Q7:GPT-Image 通道有哪些已知限制?
– 官轉提示詞超過約 8192 tokens 不會報錯,但出圖會混亂;
– gpt-image-2 的透明背景已被官方關停,需要透明底時改用 2.5 官轉;
– 逆向通道不支持 n 參數和精確 mask;
– -vip 輸入圖建議壓縮到 1.5MB 以內。
GPT-Image 通道選型核心要點 Key Takeaways
- 三類通道:官轉走官方 Images API,-all 依賴 ChatGPT 網頁版,-vip 依賴平臺號池;
- 參數差異:只有官轉完整支持任意 size、n 和精確 mask 編輯;
- 計費差異:官轉按 Token 計費,-all 每張 $0.025,-vip 每張 $0.03;
- 企業分組:image2Enterprise 是令牌分組,1.2x 倍率,不是獨立模型;
- 故障規律:各通道故障來源不同,歷史上經常出現一條故障、另一條正常的情況;
- 重試原則:429 退避重試,5xx 和超時最多 2 次,內容安全錯誤不重試;
- 上手方式:在 API易 統一接口下接入雙通道,用 A/B 驗證決定主備順序。
總結
GPT-Image 通道選型的核心要點:
- 按硬約束選主通道:需要精確編輯和任意尺寸選官轉,追求固定低價選 -all,需要按次計費的 4K 選 -vip;
- 按故障來源選備用通道:主備兩條線路的上游依賴不要重合,單一通道遲早會遇到資源飽和或上游故障;
- 按錯誤類型做兜底:有限重試、指數退避、熔斷冷卻、日誌留痕,四件事都要做。
歷史播報說明,沒有一條 GPT-Image 通道能長期保證零故障,可靠性來自架構設計,而不是押中某一條線路。推薦通過 API易 apiyi.com 用同一個 Key 接入多條通道,先跑一輪小流量對比,再定下你的主備方案。
📚 參考資料
- API易 實時動態歸檔:GPT-Image 各通道的歷史狀態播報、價格變動與文檔更新
- 鏈接:
docs.apiyi.com/live/archive -
說明: 本文故障覆盤的時間線來源,查看當前狀態請以最新播報爲準
-
API易 模型註冊表:模型 ID、計費類型、可見分組與分組倍率
- 鏈接:
docs.apiyi.com/model-registry.json -
說明: 本文引用的數據生成於 2026-11-11,價格爲折扣前目錄價
-
OpenAI 狀態頁:OpenAI 官方服務狀態
- 鏈接:
status.openai.com - 說明: 平臺曾建議關注此頁,用於判斷官轉故障是否來自上游
作者:API易 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多 GPT-Image 接入資料可訪問 docs.apiyi.com 文檔中心