作者注:從推理服務的成本結構出發,解釋 Token 服務爲什麼容易虧損,並給出一套評估模型 API 服務商的可執行清單。
Token 已經被拿進直播間售賣,可“硅基流動”這類推理服務商的財務表現仍然不樂觀。另一則新聞裏,一家公司嫌 Claude 太貴,改用 GLM,用 56 張 B200 支撐 2000 名工程師,AI 成本下降約 90%。兩件事放在一起看,Token 服務的成本結構有它自己的規律。本文將從 推理服務的成本結構 出發,說明 Token 服務爲什麼會虧,再落到開發者真正關心的問題:怎樣評估一家模型 API 服務商是否靠譜。
這不是又一篇行業八卦解讀。文中的拆解都圍繞技術變量展開,包括 GPU 折舊、利用率、Prefill 與 Decode 的成本差、KV Cache、緩存命中率和補貼策略。讀完後你可以把它直接用在選型評估裏。
核心價值:讀完本文,你會理解 Token 價格背後的成本構成,並掌握一套 6 維度的服務商評估方法。你還會知道怎樣用真實調用數據覈對計費是否透明。
Token 服務爲什麼會虧:推理成本結構核心要點
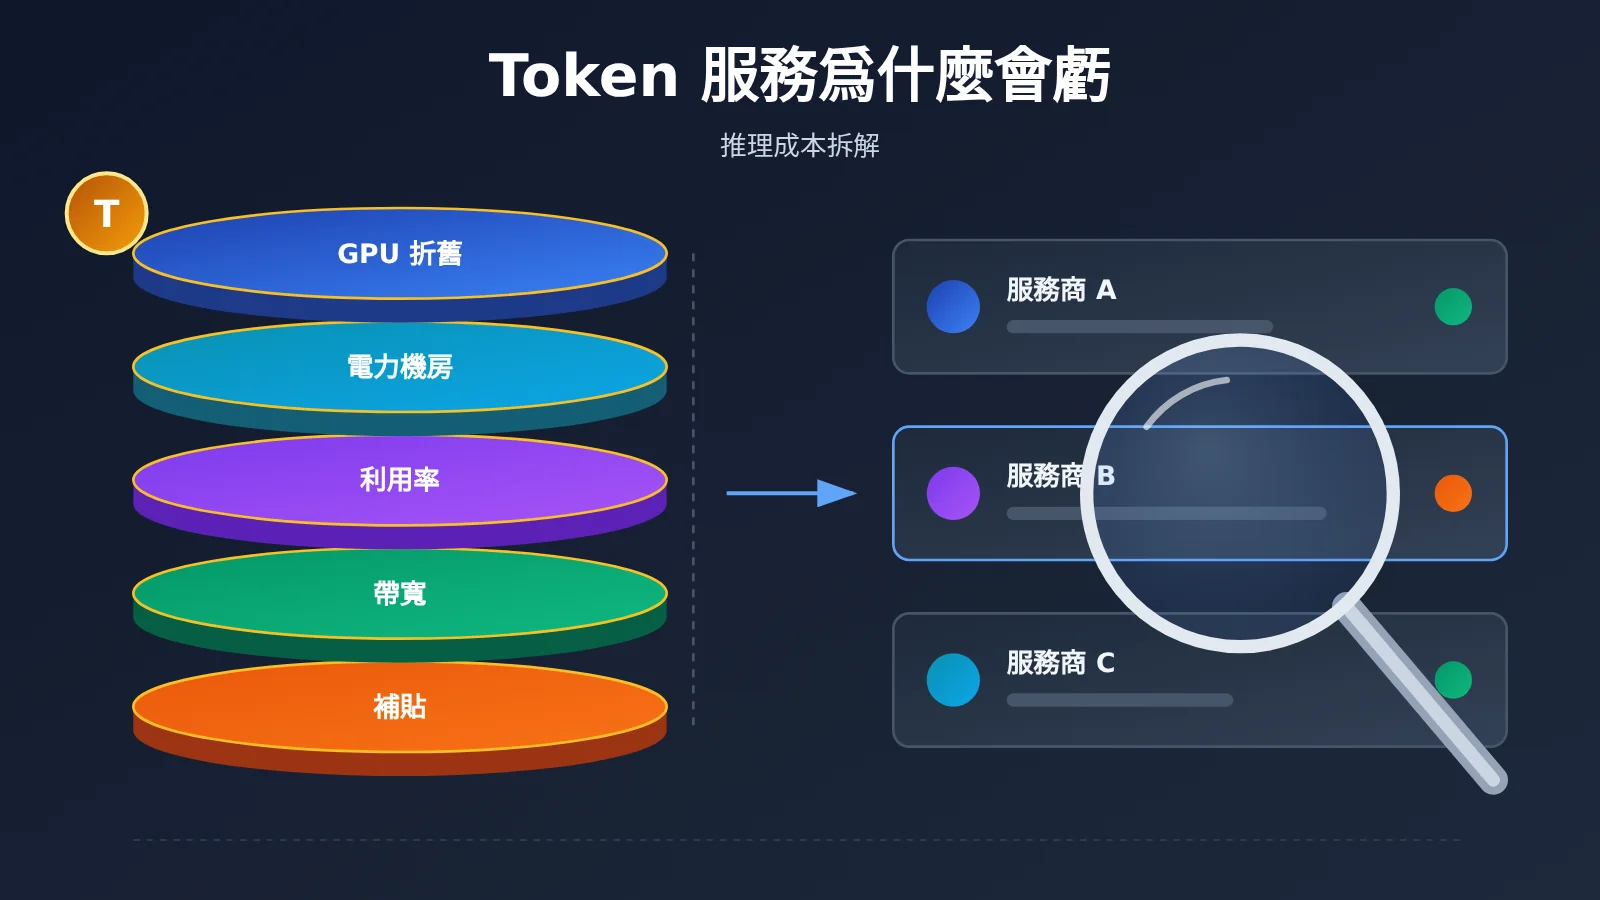
先給出結論。推理服務的成本大部分是固定成本,收入卻按 Token 量計費,兩者之間靠“利用率”連接。利用率上不去,或者價格被競爭壓到邊際成本附近,賬面就會虧損。
| 成本要素 | 說明 | 對 Token 單價的影響 |
|---|---|---|
| GPU 資本開支與折舊 | 高端 GPU 採購或長租費用,按年限攤銷 | 固定成本,利用率越低,單 Token 分攤越高 |
| 機房、電力、網絡 | 託管、散熱、帶寬、跨區容災 | 半固定成本,規模化後才能攤薄 |
| GPU 利用率 | 實際在跑推理的時間佔比與批處理飽和度 | 盈虧的核心槓桿,峯谷差直接喫掉利潤 |
| Prefill / Decode 結構 | 輸入並行處理,輸出逐 Token 生成 | 輸出 Token 更貴,長輸出場景壓力大 |
| 長上下文與 KV Cache | 顯存被緩存佔用,降低併發容量 | 長上下文請求會擠佔可服務的用戶數 |
| 補貼與獲客 | 免費額度、低價引流、渠道分成 | 短期拉量,長期拉低毛利 |
Token 服務成本結構重點詳解
固定成本與按量收入的錯配是第一個原因。一臺滿配 GPU 服務器不論有沒有請求,折舊、電費和機房費用都在發生。用戶卻只按實際消耗的 Token 付費。白天高峯需要預留足夠算力保證延遲,夜間低谷這些算力就閒着,空閒時段的成本最終都要攤到高峯時段賣出的 Token 上。如果定價只參考“滿載時的理論成本”,實際運營幾乎一定虧。
價格競爭把單價壓向邊際成本是第二個原因。開源模型權重人人可用,多家推理服務商部署的是同一個模型,差異化空間很小,價格自然成爲主要競爭手段。把 Token 放進直播間促銷,說明這類商品已經接近“標準化大宗品”。這種情況下,服務商很難靠溢價覆蓋固定成本,只能拼規模和調度效率。
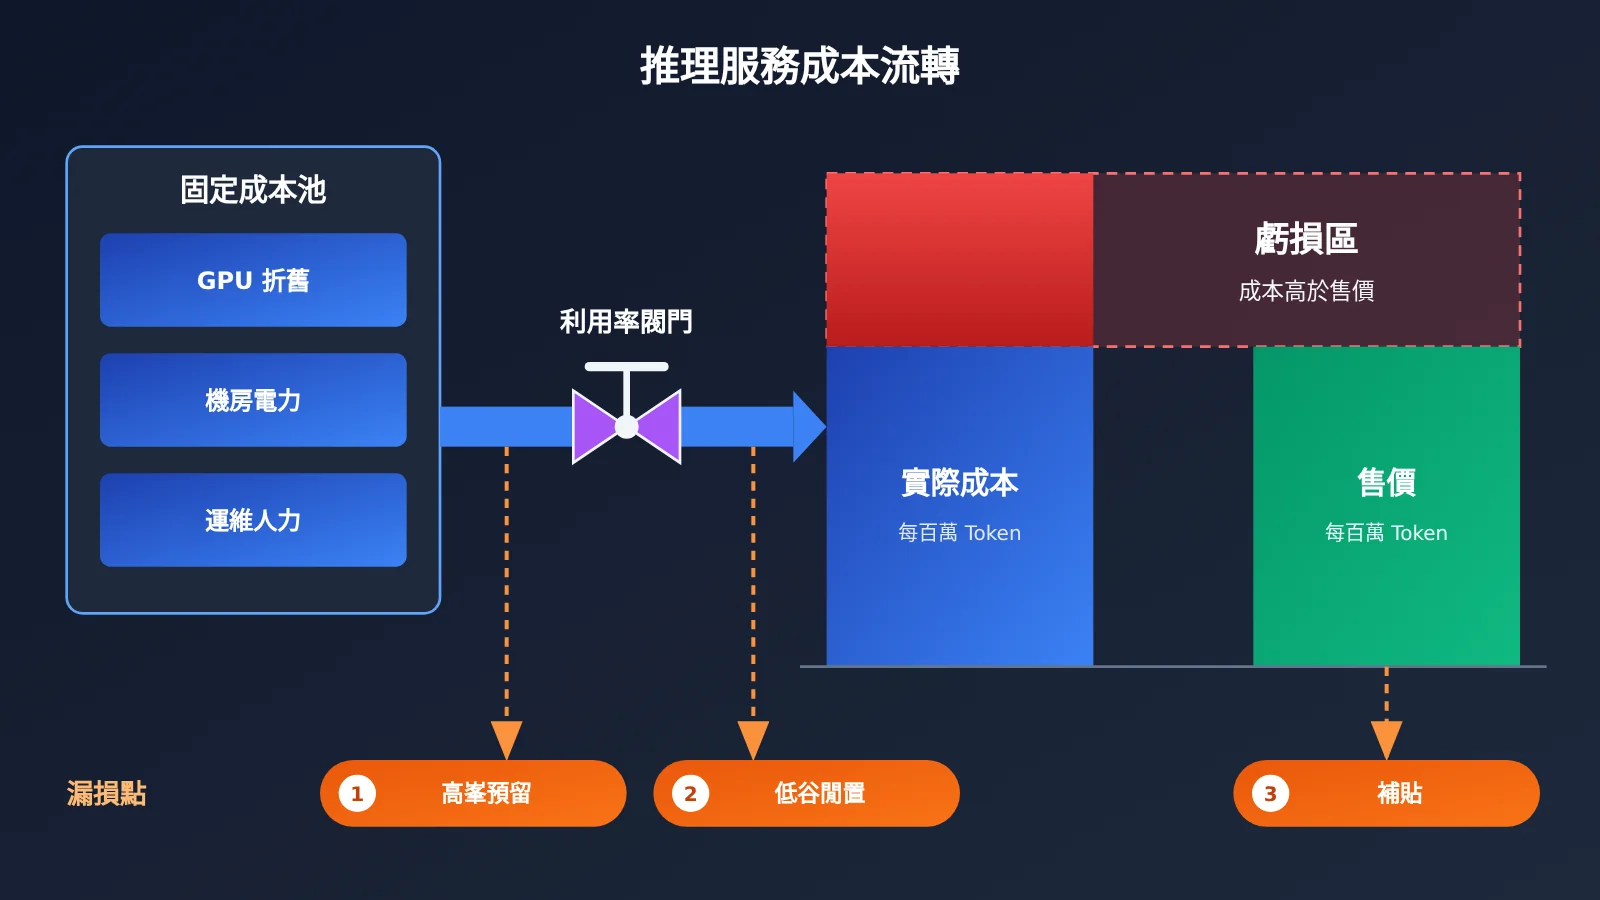
推理服務成本拆解:Token 單價是如何被算出來的
理解 Token 服務爲什麼會虧,需要把一次推理請求拆成兩個階段來看。不同階段消耗的資源不同,計費口徑也就不同。這正是很多服務商把輸入、輸出、緩存分開定價的原因。
Prefill 與 Decode:爲什麼輸出 Token 更貴
一次請求先進入 Prefill 階段。模型並行處理全部輸入 Token,計算密集但效率高,GPU 算力能被充分利用。隨後進入 Decode 階段,模型每次只生成一個 Token,並且要反覆讀取之前的 KV Cache。這個階段更受顯存帶寬限制,GPU 的算力難以喫滿。
所以同樣數量的 Token,輸出的單位成本通常明顯高於輸入。主流服務商的定價也普遍是輸出單價高於輸入單價。如果業務以長輸出爲主,比如代碼生成、長文寫作或 Agent 多輪推理,成本會集中在輸出側。評估服務商時,要優先看輸出單價和輸出吞吐。
KV Cache 與長上下文:看不見的顯存稅
長上下文請求的代價不止“輸入多”。KV Cache 會隨上下文長度增長而佔用更多顯存,一張卡能同時服務的請求數隨之下降。也就是說,一個超長上下文用戶可能擠佔好幾個普通用戶的併發位置。這部分成本不一定完整體現在單價裏,服務商只能通過分檔定價、限流或上下文長度限制來平衡。
緩存命中:既是降本手段,也是定價陷阱
提示詞緩存(Prompt Caching)可以讓重複的前綴不再重新計算,命中部分按更低的緩存讀取價計費。對 Agent、RAG 這種系統提示長且重複的業務,緩存命中率會顯著影響最終賬單。需要注意,不同服務商對緩存寫入、緩存讀取、緩存有效期的計費口徑不一致,有的還需要顯式開啓。評估時一定要確認返回的 usage 字段裏是否包含緩存相關的 Token 統計。
| 計費口徑 | 資源消耗特點 | 評估時要確認的點 |
|---|---|---|
| 輸入 Token | Prefill 並行計算,效率較高 | 是否按上下文長度分檔計價 |
| 輸出 Token | Decode 逐個生成,受顯存帶寬限制 | 輸出單價、輸出吞吐(Token/s) |
| 緩存寫入 | 首次寫入緩存,部分平臺單獨計費 | 寫入是否加價、有效期多長 |
| 緩存讀取 | 命中前綴,跳過重複計算 | 命中部分折扣、usage 是否透出 |
| 推理思考 Token | 推理模型的內部思考過程 | 是否計入輸出、能否限制預算 |
💰 價格口徑說明:上表只說明計費維度,不涉及具體價格。本文涉及模型的輸入單價、輸出單價、緩存讀寫價格,請以 API易 價格頁
https://docs.apiyi.com/models的實際數據爲準。不同模型、不同分組的計費口徑可能不同,下單前請逐項覈對。
自建推理 vs 調用 API:Token 成本賬怎麼算
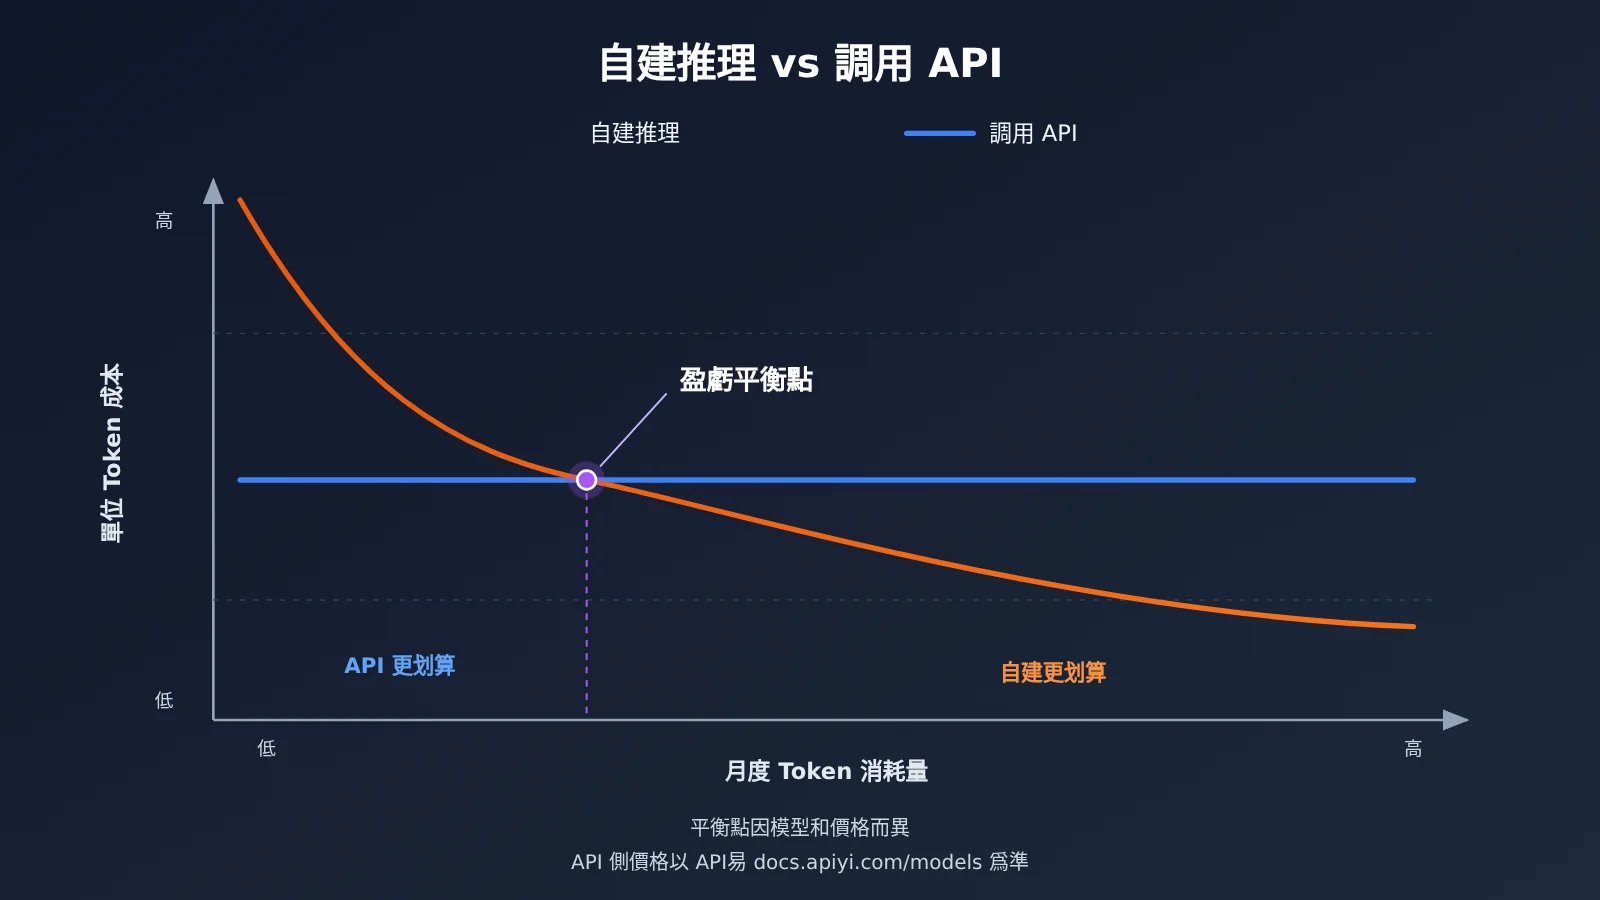
“56 張 B200 支撐 2000 名工程師、成本降低約 90%”這個案例能成立,有幾個前提。這家公司的負載來自內部工程師,請求量大且相對穩定。工作時間集中,可預測性強。模型換成了開源可自部署的 GLM。這三點讓固定成本能被充分攤薄,正好避開了公有推理服務商最頭疼的利用率問題。
反過來說,這個案例並不意味着所有團隊都應該自建。如果請求量小、波動大,或者需要頻繁切換多個閉源模型,自建 GPU 集羣的閒置成本會很快超過 API 賬單。公有推理服務商的價值,正是用大量客戶的負載互相“削峯填谷”,換取更高的整體利用率。
| 方案 | 成本結構 | 適用場景 | 主要風險 |
|---|---|---|---|
| 自建 GPU 集羣 | 高固定成本,低邊際成本 | 用量大、負載穩定、模型固定的大團隊 | 閒置浪費、運維人力、硬件迭代貶值 |
| 單一模型官方 API | 純按量付費 | 強依賴某個閉源模型的業務 | 價格單一、切換成本高、區域可用性受限 |
| 多模型 API 聚合平臺 | 按量付費,統一接口 | 需要對比、切換、混合使用多個模型 | 需覈實計費透明度與穩定性 |
| 混合架構 | 高頻任務自建,長尾任務走 API | 業務規模中大、模型分層明確 | 架構複雜度上升 |
自建方案對標分析:自建在單位成本下限上有優勢,但前提是利用率足夠高,而且團隊有能力處理部署、量化、擴縮容和故障恢復。相比之下,API 方案的單位成本更可預測,更適合負載波動大、需要多模型並行驗證的團隊。
聚合平臺對標分析:官方 API 在模型首發速度上有優勢,但多數情況下一個賬號只覆蓋一家的模型。多模型聚合平臺的好處是一套接口對接多個模型,便於做 A/B 對比和成本分層。像 API易 apiyi.com 這類平臺同時兼容 OpenAI 與 Anthropic 接口格式,現有代碼改動很小就能切換模型。
如何評估模型 API 服務商:6 維度快速上手清單
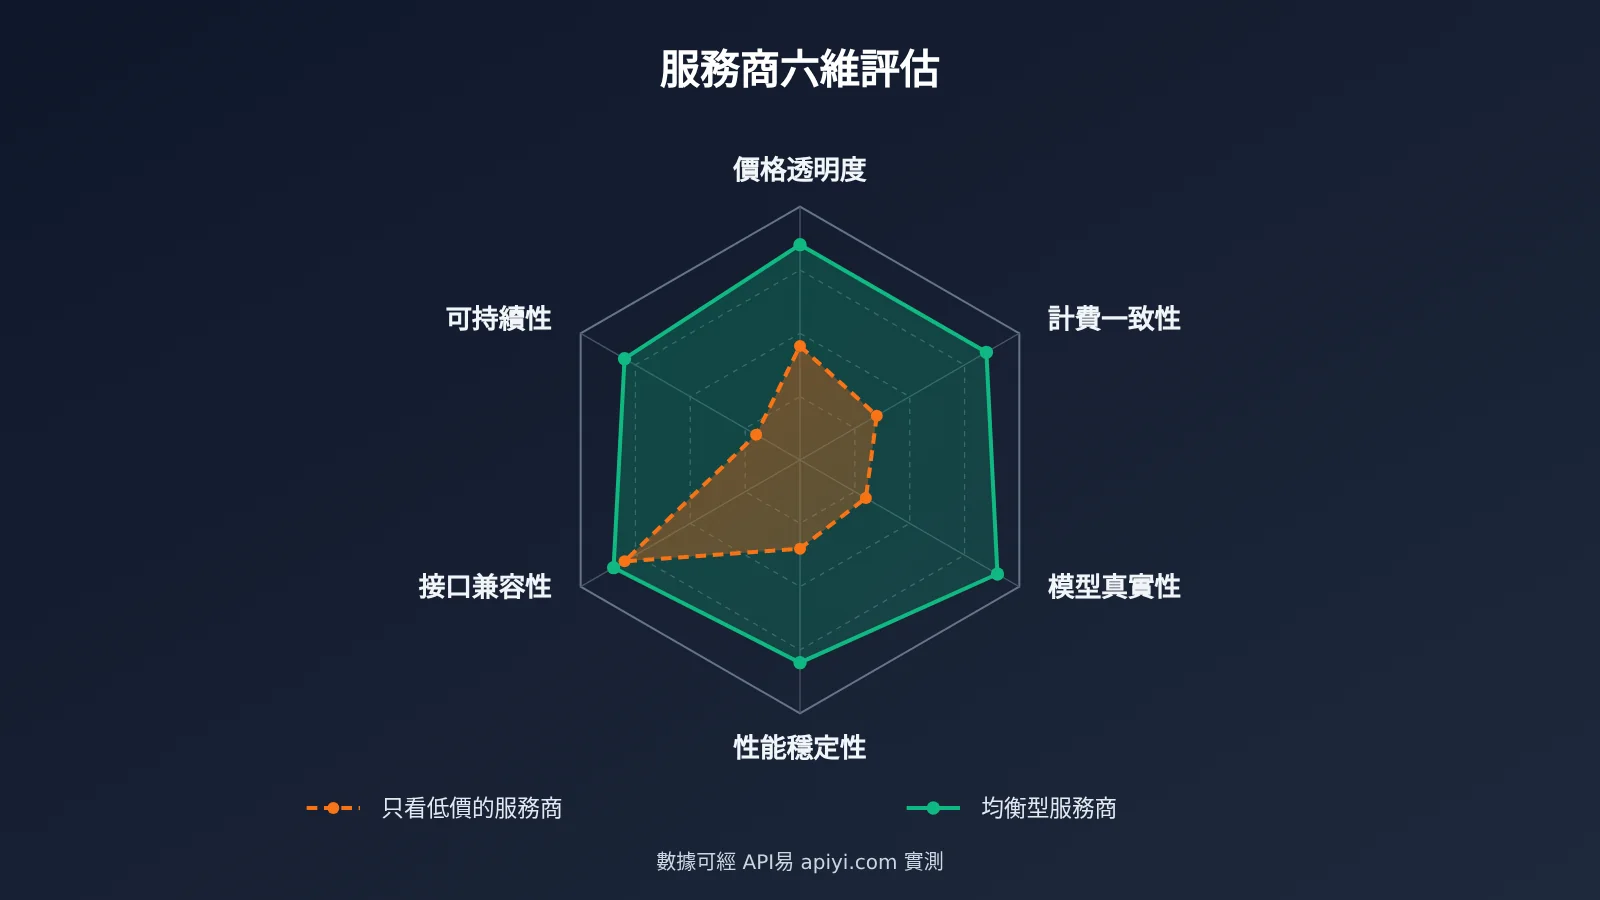
理解成本結構以後,就能反推出一個判斷:長期低於成本的價格不可持續。服務商要麼在某個環節“省”,要麼靠補貼撐一段時間。評估服務商時,不能只盯着標價,下面 6 個維度要一起看。
| 維度 | 核心問題 | 驗證方法 |
|---|---|---|
| 1. 價格透明度 | 輸入、輸出、緩存是否分別公示 | 對照價格頁,逐項記錄口徑 |
| 2. 計費一致性 | 實際扣費是否與 usage 一致 |
小批量調用後覈對賬單明細 |
| 3. 模型真實性 | 是否存在降級、混用或過度量化 | 固定測試集對比輸出質量 |
| 4. 性能穩定性 | 首字延遲、吞吐、錯誤率如何 | 高峯與低谷各測一輪 |
| 5. 接口兼容性 | 是否兼容 OpenAI / Anthropic 格式 | 用現有 SDK 只換 base_url 測試 |
| 6. 可持續性 | 價格是否明顯低於合理成本區間 | 結合成本結構判斷補貼風險 |
第一步:用兼容接口接入並做最小調用
不寫代碼也能把測試流程講清楚。如果你的項目已經在用 OpenAI SDK,通常只需要改兩個配置項:把 api_key 換成服務商提供的密鑰,把 base_url 換成服務商的接口地址。以 API易 爲例,OpenAI 兼容格式的 base_url 爲 https://api.apiyi.com/v1,對話請求走 /v1/chat/completions 路徑,model 字段填寫目標模型名稱即可。
如果項目基於 Anthropic SDK,比如使用 Claude 系列模型或 Claude Code 類工具,同樣可以替換接口地址,走 /v1/messages 路徑的 Anthropic 原生格式。具體地址和模型名稱以 API易 文檔 https://docs.apiyi.com 爲準。做最小調用時建議同時開啓 stream 流式輸出,方便後面測量首字延遲。
第二步:覈對計費口徑與 usage 字段
每次調用的響應裏,OpenAI 格式會返回 usage.prompt_tokens、usage.completion_tokens,部分模型還會給出緩存命中的 cached_tokens。Anthropic 格式對應的是 input_tokens、output_tokens 以及緩存讀寫字段。你可以用一個簡單公式估算單次成本:輸入 Token 數乘以輸入單價,加上輸出 Token 數乘以輸出單價,再加上緩存讀寫 Token 數乘以對應的緩存單價。
把估算值和平臺賬單明細對比,偏差應當可解釋。如果長期出現“賬單比 usage 推算的多”,或者緩存命中從不體現在計費上,就要警惕了。估算時用到的單價,請以 API易 價格頁 https://docs.apiyi.com/models 公示的數據爲準。
第三步:測性能、測質量、測高峯
性能測試建議記錄三個指標:首字延遲(TTFT)、輸出吞吐(每秒 Token 數)、錯誤率(超時、429 限流、5xx)。工作日高峯和夜間低谷各測一輪,波動越小說明服務商的容量規劃越充足。質量測試用一組固定提示詞,覆蓋代碼、推理、長文本,和官方渠道或其他平臺的輸出交叉對比,有助於發現模型被降級或替換。
| 測試項 | 關鍵參數 / 字段 | 合格參考 |
|---|---|---|
| 首字延遲 | 開啓 stream,記錄首個 chunk 時間 |
高峯與低谷差異不過大 |
| 輸出吞吐 | completion_tokens ÷ 生成耗時 |
與同模型其他渠道相近 |
| 計費覈對 | usage 各字段 × 價格頁單價 |
與賬單明細偏差可解釋 |
| 緩存命中 | cached_tokens 或緩存讀取字段 |
長前綴重複請求有命中 |
| 穩定性 | 429 / 5xx / 超時次數 | 錯誤率低且有重試說明 |
🚀 快速開始:如果想在同一套接口下對比多個模型的成本與表現,可以先通過 API易 apiyi.com 註冊並獲取測試額度。平臺提供本文涉及的主流模型 API 調用,兼容 OpenAI 與 Anthropic 接口格式,把
base_url換成https://api.apiyi.com/v1即可開始驗證。各模型價格以https://docs.apiyi.com/models爲準。
常見問題 FAQ
Q1:Token 服務爲什麼會虧損?
推理服務以 GPU 折舊、機房電力等固定成本爲主,收入卻按 Token 量計費。高峯需要預留算力,低谷算力閒置,利用率難以長期維持高位。再加上開源模型同質化帶來的價格戰和免費額度補貼,售價容易被壓到成本以下。
Q2:爲什麼輸出 Token 普遍比輸入 Token 貴?
輸入在 Prefill 階段並行計算,GPU 利用效率高。輸出在 Decode 階段逐個生成,需要反覆讀取 KV Cache,主要受顯存帶寬限制,單位成本更高。因此長輸出業務要重點關注輸出單價和吞吐。
Q3:自建 GPU 一定比調用 API 便宜嗎?
不一定。“56 張 B200 支撐 2000 名工程師”這類案例,依賴的是大規模、穩定、可預測的內部負載。用量小或波動大的團隊自建後閒置嚴重,單位成本反而更高。建議先用 API 跑出真實用量曲線,再評估盈虧平衡點。
Q4:價格特別低的 API 服務商可以用嗎?
可以測,但要多做驗證。明顯低於合理成本區間的價格,通常意味着補貼、限流、模型降級或穩定性折扣中的某一種。按本文的 6 維度清單做質量和計費覈對,比單看標價更可靠。
Q5:如何低成本對比多個模型的 API 表現?
推薦使用兼容主流接口格式的多模型平臺做統一測試:
1. 在 API易 apiyi.com 註冊賬號並獲取 API Key
2. 按文檔 `https://docs.apiyi.com` 配置 OpenAI 或 Anthropic 兼容接口
3. 用固定測試集輪流切換 `model` 字段,記錄延遲、質量與 `usage`
同一套代碼就能完成橫向對比,切換成本很低。
Q6:緩存價格怎麼查?不同平臺口徑一樣嗎?
不一樣。有的平臺對緩存寫入單獨計費,有的只對讀取打折,有效期和開啓方式也不同。在 API易 上調用時,緩存讀寫價格以價格頁 `https://docs.apiyi.com/models` 的實際數據爲準,並結合返回的 `usage` 緩存字段覈對扣費。
Q7:評估服務商時最容易被忽略的指標是什麼?
計費一致性和高峯穩定性。很多團隊只在低峯時段做一次測試就上線,結果高峯期頻繁遇到 429 或超時。也有不少團隊從不覈對 `usage` 和賬單的對應關係。這兩項都應納入上線前的固定檢查。
Token 服務成本與 API 服務商評估 Key Takeaways
- 虧損根源:固定成本高、按量收入、利用率波動,三者錯配導致 Token 服務易虧
- 輸出更貴:Decode 受顯存帶寬限制,長輸出業務要盯緊輸出單價與吞吐
- 長上下文有隱性成本:KV Cache 擠佔顯存,降低併發,服務商只能用分檔與限流平衡
- 自建有門檻:只有大規模穩定負載才能攤薄 GPU 固定成本,小團隊優先用 API
- 評估看六維:價格透明、計費一致、模型真實、性能穩定、接口兼容、可持續
- 上手方式:通過 API易 兼容 OpenAI / Anthropic 格式快速實測,價格以
docs.apiyi.com/models爲準
總結:從成本結構看懂 Token 服務,選對模型 API 服務商
Token 服務爲什麼會虧,歸根結底是推理服務的成本結構決定的:
- 成本端:GPU 折舊、機房電力是固定成本,利用率是盈虧槓桿,輸出 Token 與長上下文進一步推高成本
- 收入端:開源模型同質化讓價格戰難以避免,補貼拉量卻壓低毛利
- 選型端:低價不等於划算,要用價格透明、計費一致、模型真實、性能穩定、接口兼容、可持續這 6 個維度綜合判斷
對開發者來說,與其猜測哪家服務商能撐多久,不如用真實調用數據說話。先用小流量跑通計費覈對和質量對比,再決定主力模型和備用渠道。
推薦通過 API易 apiyi.com 快速驗證效果。平臺提供本文涉及模型的 API 調用,兼容 OpenAI 與 Anthropic 接口格式,接入文檔見 https://docs.apiyi.com。所有模型的輸入、輸出與緩存價格,以價格頁 https://docs.apiyi.com/models 的實際數據爲準。
📚 參考資料
- 36氪 – Token都賣進李佳琦直播間了,“硅基流動”們爲何還在虧損?:推理服務商盈利困境報道
- 鏈接:
36kr.com/p/4055385238017664 -
說明: 瞭解 Token 商品化與推理服務商虧損的行業背景
-
36氪 – 有人每月燒掉1萬美元,嫌Claude太貴,這家公司改用GLM:企業自建推理降本案例
- 鏈接:
36kr.com/p/4055383551038595 -
說明: 56 張 B200 支撐 2000 名工程師的自建推理案例,可用於理解自建與 API 的成本邊界
-
API易 文檔中心:接口接入與模型價格
- 鏈接:
docs.apiyi.com - 說明: 查看 OpenAI / Anthropic 兼容接入方式,模型價格以
docs.apiyi.com/models爲準
作者: APIYI 技術團隊
技術交流: 關於模型選型與 Token 成本評估的問題,歡迎通過 API易 官網 apiyi.com 聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心