作者注:從三款個人 Agent 的公開實測出發,拆解 Agent 執行力短板背後的接口層問題,並給出工具調用、容錯重試、格式兼容與成本控制的修復清單。
36 氪在 2026 年 11 月 4 日發佈了《個人Agent上桌,誰先露了怯?》,把三款個人 Agent 放到同一張桌上做了實測。這類橫評得出的結論通常很一致:Agent 不缺“會說”,缺的是“能做完”。本文關注的核心問題是 Agent 的執行力短板,大多出在接口層,而不只是模型本身。
這不是又一篇“哪款 Agent 更聰明”的排名文章。 我們不復述原文的具體打分,而是把這類實測中常見的執行失敗歸納成 5 類,再逐一對應到 Agent 接口設計裏能改的地方。
核心價值:讀完本文,你會知道自己搭建 Agent 時要先檢查哪些接口參數、怎麼處理失敗,以及如何在 OpenAI 和 Anthropic 兩種接口格式之間平穩切換。
Agent 接口執行力短板核心要點
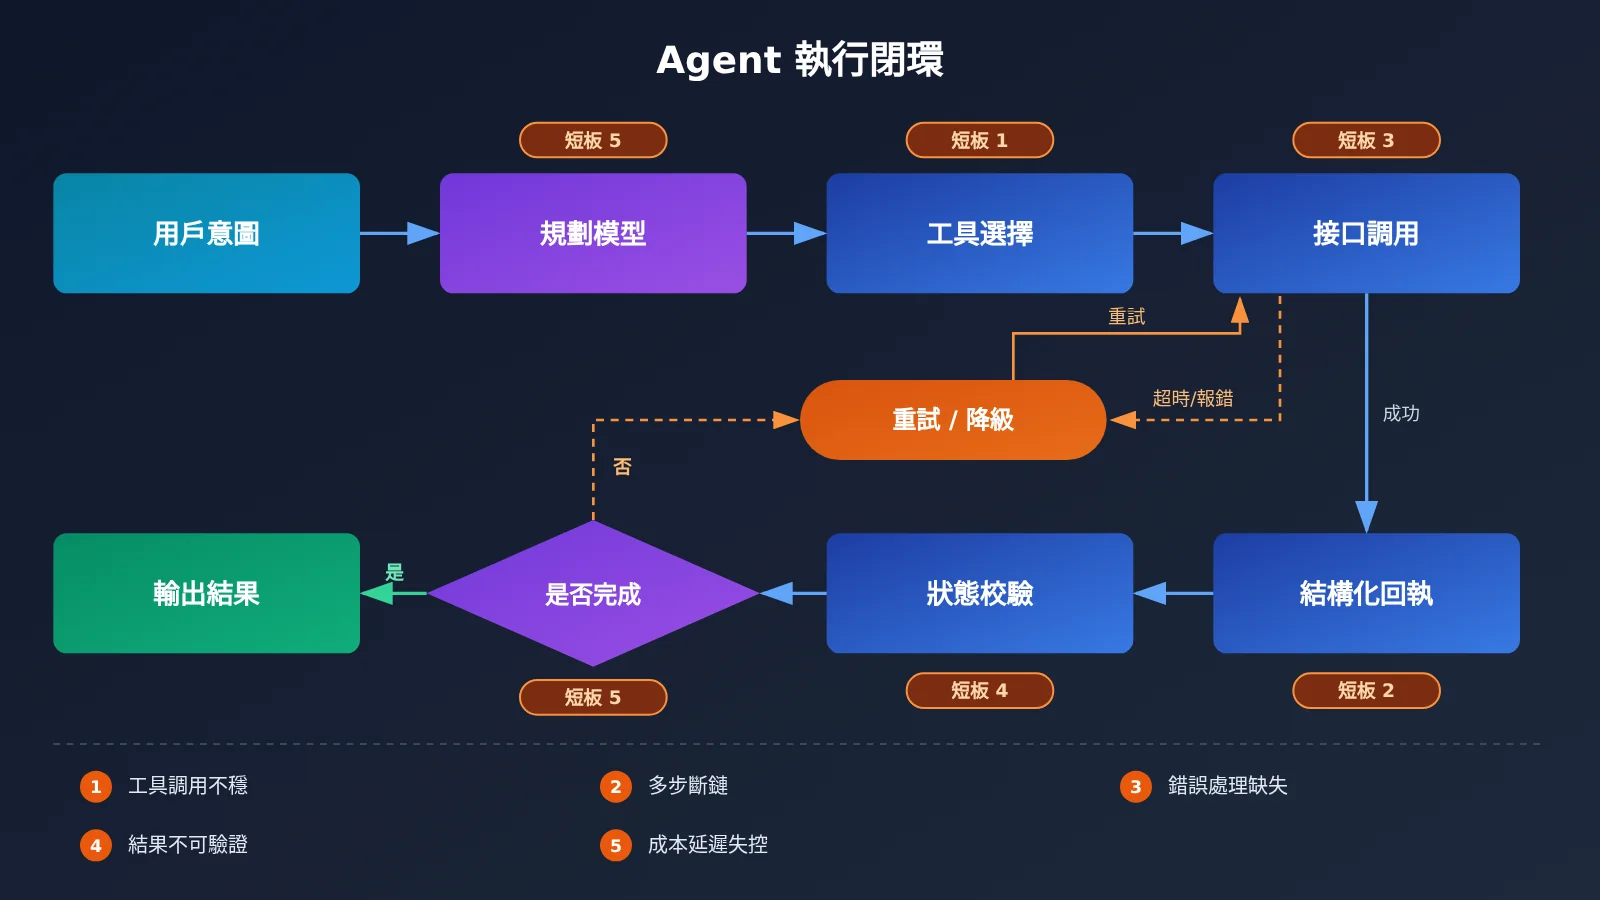
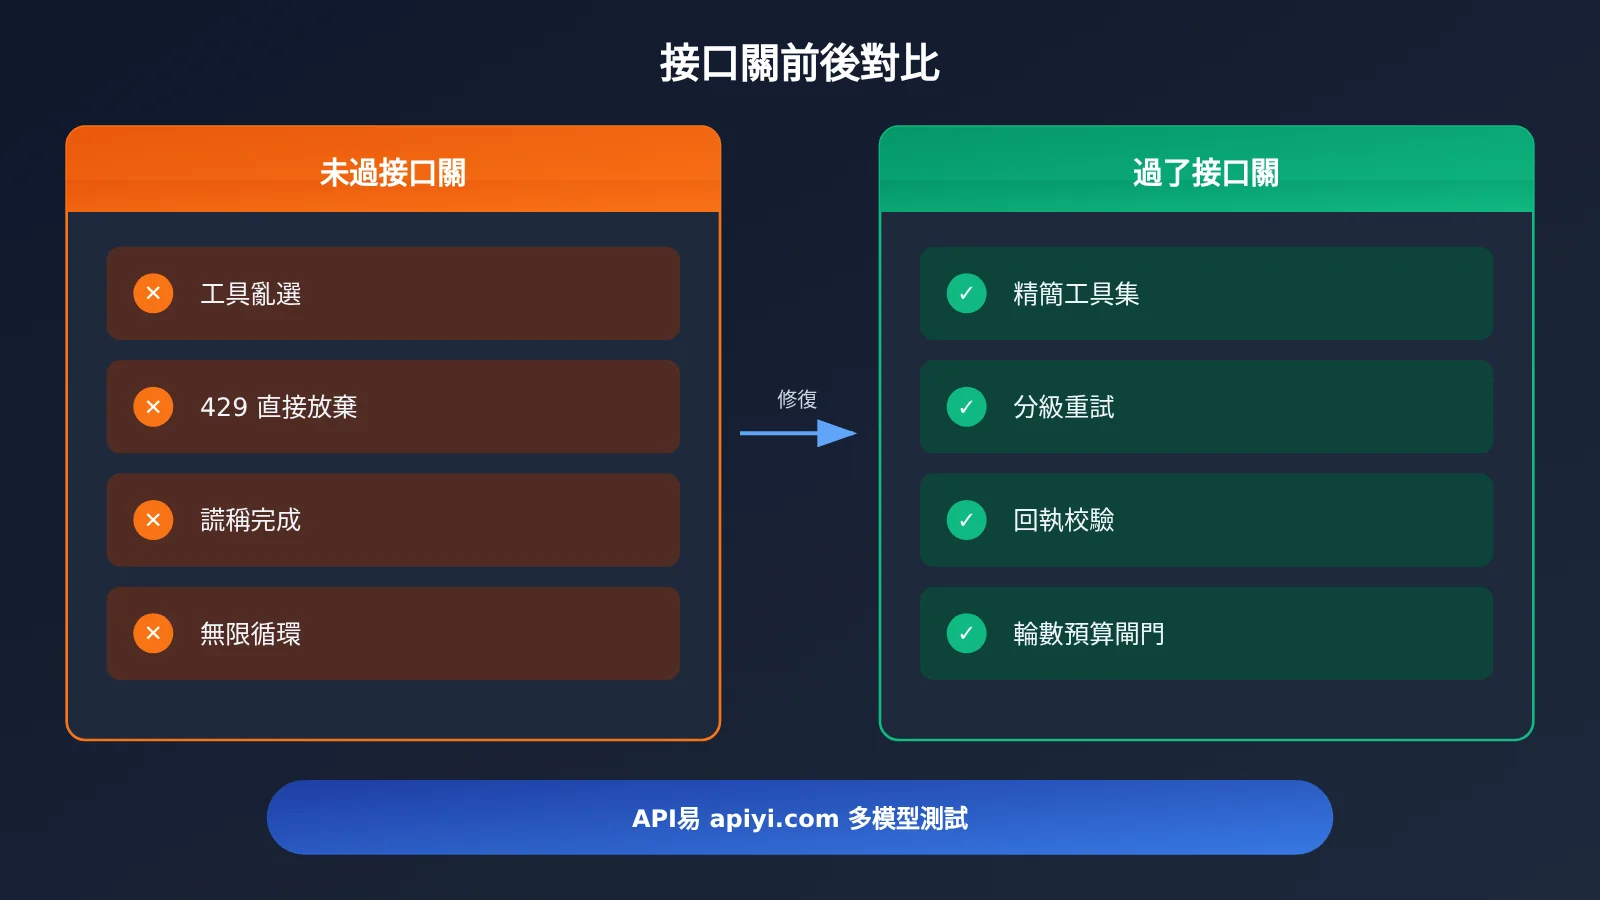
個人 Agent 的目標是替用戶完成整件事,比如訂票、整理郵件、彙總資料、操作網頁。只要中間一步失敗,用戶感受到的就是“它沒做完”。把實測中常見的失敗現象往下追,基本都能落到下面 5 類接口問題上。
| 執行力短板 | 典型表現 | 接口層根因 | 修復方向 |
|---|---|---|---|
| 工具調用不穩 | 選錯工具、參數缺字段、格式不合法 | 工具描述模糊,schema 沒有約束 | 精簡工具集,寫嚴格的參數 schema |
| 多步任務斷鏈 | 做到第三四步就忘了目標 | 上下文管理粗放,工具結果沒有正確回傳 | 規範消息歷史,壓縮中間結果 |
| 外部失敗無兜底 | 遇到限流或超時直接放棄,或者謊稱完成 | 沒有區分錯誤類型,也沒有重試策略 | 按狀態碼分級重試,加超時與降級 |
| 結果不可驗證 | 回覆“已完成”,實際什麼都沒做 | 缺少執行回執和狀態校驗 | 每一步要求結構化回執 |
| 成本延遲失控 | 循環調用,一次任務消耗大量 token | 沒有步數上限,也沒有用到緩存 | 設置最大輪數、分層用模型、利用緩存 |
Agent 接口短板重點詳解
前兩類短板看上去像模型能力問題,其實工程手段能解決一大半。工具調用不穩,最常見的原因是一次給模型塞了幾十個工具,而且描述互相重疊,模型自然會選錯。把工具壓到當前任務真正需要的範圍,給每個參數寫清類型、枚舉值和是否必填,錯誤率通常會明顯下降。多步斷鏈則往往出在工具結果回傳:如果沒有按協議把結果和對應的調用 ID 綁定,模型就無法確認上一步到底成功了沒有。
後三類短板屬於純粹的工程問題。一個合格的 Agent 必須清楚“失敗了怎麼辦”和“怎麼證明做完了”。實測裏最讓用戶失望的不是失敗本身,而是失敗之後假裝成功。因此,接口層的回執機制和錯誤分級,比換一個更大的模型更有用。
Agent 接口快速上手:5 步過關清單
下面的步驟不依賴任何特定框架,自己手寫 Agent 循環或使用現成的 Agent 框架都適用。按照本文要求,這裏不貼代碼,所有關鍵配置都放在表格裏說明。
第 1 步:統一 Agent 接口入口
Agent 通常需要“規劃用強模型、執行用快模型”的組合。如果每個模型都單獨對接一家廠商,鑑權、錯誤格式、計費口徑會各不相同,排查成本很高。比較省事的做法是使用一個同時兼容 OpenAI 與 Anthropic 接口格式的統一入口,只改 base_url、api_key 和 model 就能切換模型。
| 配置項 | 作用 | 建議取值 |
|---|---|---|
base_url |
接口地址 | 以服務商文檔爲準,例如 API易 文檔 docs.apiyi.com 中給出的地址 |
api_key |
鑑權憑證 | 放在環境變量裏,不要寫進提示詞或日誌 |
model |
模型名稱 | 規劃與執行分開配置,便於單獨替換 |
timeout |
單次請求超時 | 按任務類型設置,長輸出任務適當放寬 |
max_retries |
SDK 自動重試次數 | 保持較小的值,業務層自己做分級重試 |
🚀 快速開始:API易 提供本文涉及的主流大模型 API 調用,同時兼容 OpenAI 和 Anthropic 兩種接口格式,現有 SDK 改一下
base_url就能接入。接入說明見 API易 文檔中心:docs.apiyi.com。
第 2 步:把 Agent 工具調用參數寫嚴
工具調用是 Agent 執行力的第一道關。參數寫得越嚴,模型“自由發揮”的空間就越小,出錯率也越低。
| 參數 | 含義 | 實踐建議 |
|---|---|---|
tools |
可調用的工具列表 | 單輪只暴露當前階段需要的工具,描述寫清“何時用、何時不用” |
tool_choice |
工具選擇策略 | 需要強制執行某個動作時指定工具,開放問答時設爲自動 |
| 參數 schema | 工具入參結構 | 必填字段寫進 required,能用枚舉的就不要用自由文本 |
response_format |
結構化輸出 | 最終回執要求 JSON 結構,便於程序校驗 |
max_tokens |
輸出上限 | Anthropic 格式下爲必填,需要按任務預估 |
temperature |
隨機性 | 執行類步驟調低,減少同一輸入得到不同動作的情況 |
第 3 步:處理 OpenAI 與 Anthropic 格式差異
很多 Agent 在切換模型後“突然變笨”,原因不在模型,而在於兩種格式的工具協議不一樣,結果回傳錯位了。下表列出最容易踩坑的幾處差異。
| 對比項 | OpenAI Chat Completions 格式 | Anthropic Messages 格式 |
|---|---|---|
| 系統提示位置 | 放在 messages 中,角色爲 system | 使用頂層 system 參數 |
| 工具定義 | type: function 加 function 對象 |
name、description、input_schema |
| 模型發起調用 | 助手消息中的 tool_calls |
內容塊類型爲 tool_use |
| 工具結果回傳 | 角色爲 tool 的消息,並帶上 tool_call_id |
user 消息中的 tool_result 內容塊,對應 tool_use_id |
| 輸出上限 | max_tokens 可選 |
max_tokens 必填 |
兩種格式沒有優劣之分,要緊的是在 Agent 內部只維護一種中間表示,到請求時再轉換成對應格式。如果用的是同時兼容兩種格式的入口,比如 API易,就可以讓 Claude 系列走原生 Anthropic 格式,其他模型走 OpenAI 格式,各自保留最完整的工具調用能力。
第 4 步:爲 Agent 接口失敗設計兜底
“失敗了直接放棄”和“失敗了假裝成功”,是實測中最傷體驗的兩種表現。正確的做法是先按錯誤類型分級,再決定是重試、降級還是如實告知用戶。
| 錯誤類型 | 常見原因 | Agent 應對策略 |
|---|---|---|
| 400 參數錯誤 | 工具參數不合法、消息格式錯位 | 不要盲目重試,把錯誤信息回傳給模型讓它修正一次 |
| 401 / 403 鑑權 | Key 失效或權限不足 | 立即終止,提示用戶檢查配置 |
| 429 限流 | 併發過高或額度不足 | 指數退避重試,必要時切換備用模型 |
| 5xx 服務端錯誤 | 上游服務波動 | 有限次重試,超過上限就降級 |
| 超時 | 長輸出或網絡抖動 | 改爲流式輸出,或者拆小任務後重試 |
還有一個容易被忽視的細節:有副作用的工具必須保證冪等。發郵件、下單、寫數據庫這類操作,重試前要先確認上一次是否已經生效,否則 Agent 會把同一件事做兩遍。
第 5 步:給 Agent 加回執與成本閘門
每個工具執行完都應返回結構化回執,至少包含“是否成功、做了什麼、關鍵結果標識”三個字段。Agent 宣佈任務完成之前,要由程序而不是模型覈對回執,這樣就從機制上杜絕了“謊稱完成”。
成本方面建議加三道閘:最大循環輪數、單任務 token 預算、重複調用檢測。規劃、執行、分類這幾類工作可以分給不同檔位的模型,長系統提示和工具定義儘量保持穩定,以便利用提示緩存。具體的輸入、輸出和緩存單價,以及計費口徑,請以 API易 價格頁 https://docs.apiyi.com/models 的實際數據爲準,本文不給出任何未經覈實的價格數字。
💡 建議:搭建階段先用小流量跑完整個閉環,再逐步加工具。通過 API易 apiyi.com 可以在同一個 Key 下快速對比不同模型在工具調用上的穩定性,切換隻需改
model字段。
Agent 接口分層選型參考
執行力強的 Agent 很少只用一個模型。按職責分層,既能提升穩定性,也方便控制成本。
| 職責層 | 能力要求 | 選型思路 | 可用平臺 | 價格參考 |
|---|---|---|---|---|
| 規劃層 | 長上下文、複雜推理、任務拆解 | 選推理能力強的旗艦模型 | API易 apiyi.com、官方 API | 以 API易 價格頁爲準 |
| 執行層 | 工具調用穩定、響應快 | 選工具調用表現穩定的中檔模型 | API易 apiyi.com、官方 API | 以 API易 價格頁爲準 |
| 輕量層 | 意圖分類、格式校驗、摘要壓縮 | 選低延遲、低成本的小模型 | API易 apiyi.com、官方 API | 以 API易 價格頁爲準 |
具體有哪些模型可用、最新的模型名稱是什麼,請查閱 API易 文檔 docs.apiyi.com。建議拿自己的真實任務各跑一批樣本,統計工具調用成功率、平均輪數和單任務消耗,再決定每一層用哪個模型,不要只看公開榜單。
常見問題 FAQ
Q1:什麼是 Agent 的“接口關”?
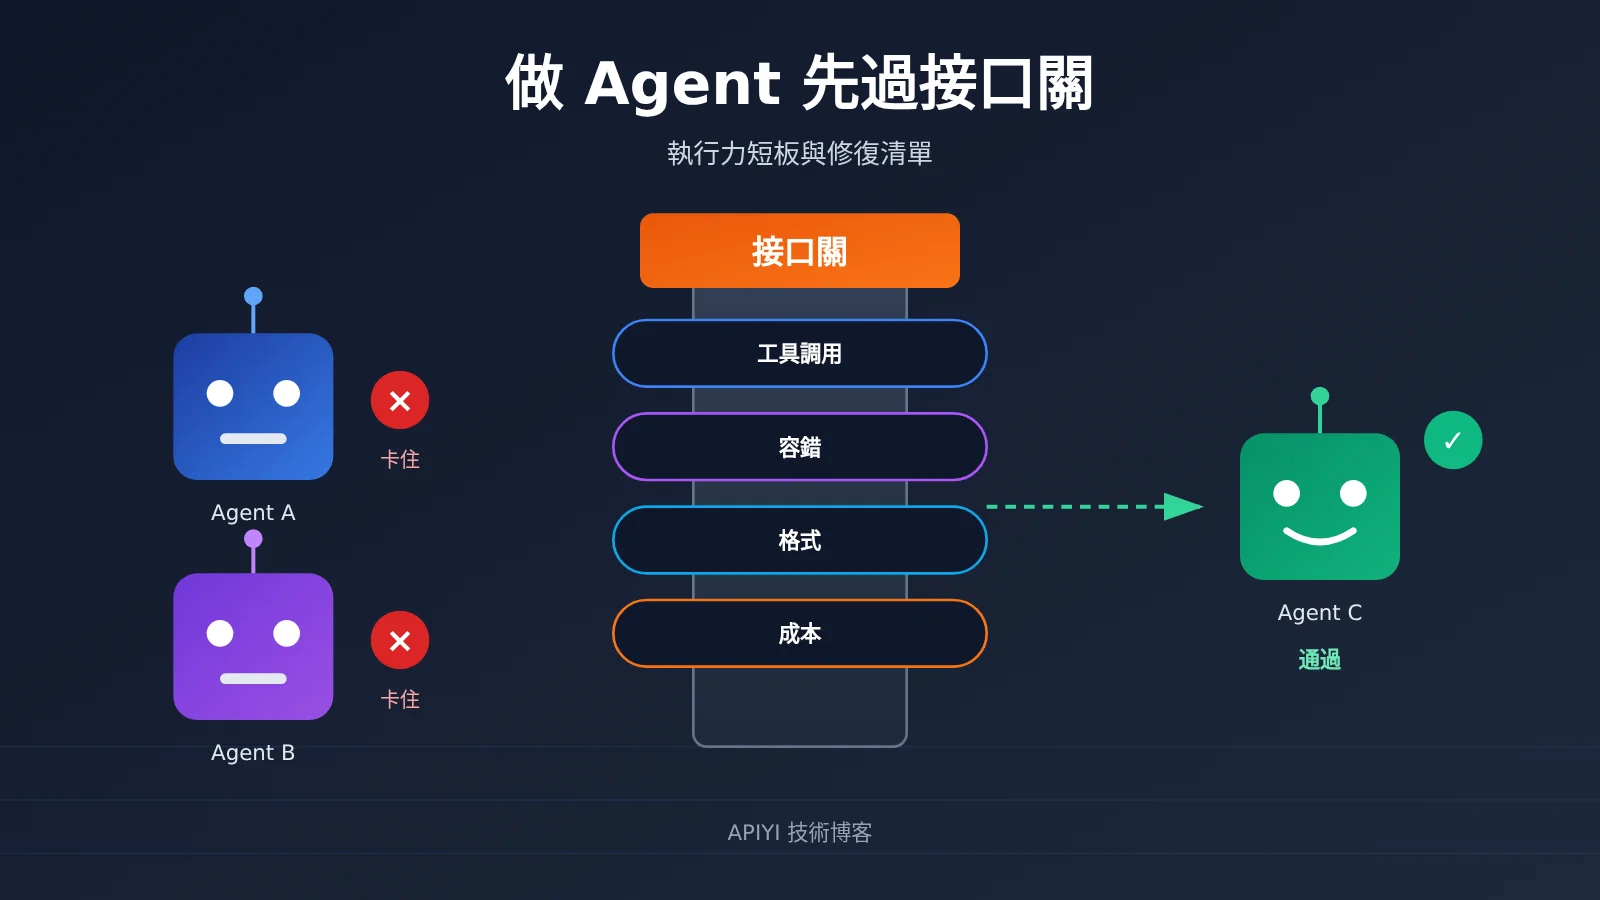
指 Agent 從“想清楚”到“做完”之間要經過的工程層,包括工具定義、調用協議、錯誤處理、結果回執和成本控制。模型負責決策,接口層負責把決策可靠地落地。這一關過不去,模型再強也會表現爲執行力差。
Q2:執行力差是模型的問題,還是接口的問題?
兩者都有,但接口問題更容易被低估。選錯工具、參數格式錯誤、斷鏈、失敗後謊稱完成,相當一部分可以靠收緊 schema、規範結果回傳、增加回執校驗來緩解。建議先把接口層做紮實,再判斷是否真的需要換模型。
Q3:三款個人 Agent 的實測說明了什麼趨勢?
36 氪 2026 年 11 月的這篇實測報道說明,個人 Agent 已經進入“比誰能真正做完事”的階段,比拼的重點從對話質量轉到了執行閉環。各款產品的具體表現請參閱原文,本文只提煉通用的工程啓示。
Q4:OpenAI 格式和 Anthropic 格式該選哪個?
按模型選。Claude 系列使用原生 Anthropic 格式,能完整用到工具調用和緩存等特性,其他多數模型使用 OpenAI 格式更通用。API易 同時兼容兩種格式,可以在 Agent 內部維護統一的中間表示,請求時再按模型轉換。
Q5:如何快速給自己的 Agent 接入多個模型?
1. 在 API易 apiyi.com 註冊並獲取 API Key;
2. 按 docs.apiyi.com 文檔配置 `base_url`;
3. 規劃層和執行層分別填寫 `model`,用同一批任務做對比測試。
整個過程不需要改動 SDK,只需調整配置項。
Q6:Agent 成本怎麼估算,價格去哪裏看?
先統計單任務的平均輪數、輸入 token 和輸出 token,再乘以對應模型的單價。輸入、輸出、緩存單價和計費口徑,統一以 API易 價格頁 https://docs.apiyi.com/models 的實際數據爲準,不同模型差異較大,務必按實際頁面覈算。
Q7:工具多了以後 Agent 越來越不穩,怎麼辦?
按任務階段動態暴露工具,單輪只給模型少量相關工具。也可以先用輕量模型做路由分類,再把對應的工具子集交給執行模型。工具描述裏寫清楚適用邊界,比堆更多示例更有效。
Q8:做好接口層後還有哪些限制?
接口層能顯著提升穩定性,但解決不了模型本身的推理上限,也解決不了第三方網站或服務的變化。長鏈路任務仍然建議保留人工確認節點,尤其是支付、刪除、對外發送這類不可逆操作。
Agent 接口執行力 Key Takeaways
- 執行力短板多在接口層:選錯工具、斷鏈、謊稱完成,大多有工程解法
- 工具集寧少勿多:分階段暴露工具,參數 schema 越嚴越穩
- 格式差異要隔離:內部統一表示,請求時再轉 OpenAI 或 Anthropic 格式
- 錯誤必須分級:400 修正、429 退避、5xx 降級,有副作用的操作要冪等
- 完成由程序判定:結構化回執加狀態校驗,杜絕“假完成”
- 成本設閘門:輪數上限、token 預算、分層用模型,價格以 API易 價格頁爲準
- 上手路徑:通過 API易 統一入口接入多模型,改
base_url和model即可對比
總結
三款個人 Agent 的實測給開發者提了個醒:Agent 競爭的重點正在從“能聊”轉向“能做完”。要補齊執行力,最划算的投入是先過接口關:
- 工具調用:精簡工具、收緊 schema、規範結果回傳;
- 容錯兜底:錯誤分級、有限重試、冪等保護;
- 可驗證與可控:結構化回執、程序校驗、成本閘門。
建議先拿一個真實任務跑通完整閉環,再逐步擴展能力。推薦通過 API易 apiyi.com 接入,它兼容 OpenAI 與 Anthropic 接口格式,便於對比不同模型的執行穩定性。文檔見 docs.apiyi.com,價格以 https://docs.apiyi.com/models 爲準。
📚 參考資料
- 36 氪:個人Agent上桌,誰先露了怯?:三款個人 Agent 實測報道
- 鏈接:
36kr.com/p/4055385191224452 -
說明:本文選題來源,具體產品與實測表現請參閱原文
-
API易 文檔中心:接入配置與可用模型說明
- 鏈接:
docs.apiyi.com -
說明:
base_url配置、OpenAI 與 Anthropic 格式接入方式 -
API易 模型價格頁:模型單價與計費口徑
- 鏈接:
docs.apiyi.com/models - 說明:本文所有價格相關內容均以此頁實際數據爲準
作者:API易 技術團隊
技術交流:歡迎在 API易 官網 apiyi.com 聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心