作者注:比較模型成本時,只看每百萬 token 單價很容易選錯。本文給出「單價 × 實際 token 消耗」的測算框架,以及用自己的任務做小樣本複測的完整步驟。
很多團隊選模型時會先打開價格頁,看到 A 模型每百萬 token 只要幾毛錢,B 模型要好幾美元,就認定 A 更省錢。但月底賬單經常和預期對不上,有時“便宜”的模型反而花得更多。本文介紹 「單價 × 實際 token 消耗 + 緩存摺算」的真實成本測算法,幫助你在選型階段就算清楚賬。
這不是又一篇價格表彙總。價格表會過時,測算方法不會。我們會把公開測算中的個案現象抽象成通用框架,再落到你自己的任務上覆測。
核心價值:讀完本文,你將能夠解釋“標價便宜不等於賬單便宜”的原因,並用 20 到 50 條真實請求測出每個候選模型的單任務成本。
模型真實成本核心要點
| 要點 | 說明 | 對選型的影響 |
|---|---|---|
| 單價只是乘數之一 | 賬單 = 各類 token 數量 × 各自單價,再求和 | 只比單價,相當於只比較了一半公式 |
| 分詞差異 | 同一段文本在不同模型中被切成的 token 數不同 | 輸入成本需要按各模型實際計數折算 |
| 推理 token | 推理型模型的思考過程通常按輸出計費,用戶看不到 | 可見回答很短,賬單卻可能很高 |
| 緩存命中 | 重複的前綴命中緩存後,按更低的緩存價計費 | 長系統提示詞、多輪對話場景差異顯著 |
| 成功率與重試 | 答錯或格式不合格需要重跑 | 有效成本 = 單次成本 ÷ 成功率 |
爲什麼只看每百萬 token 單價會算錯真實成本
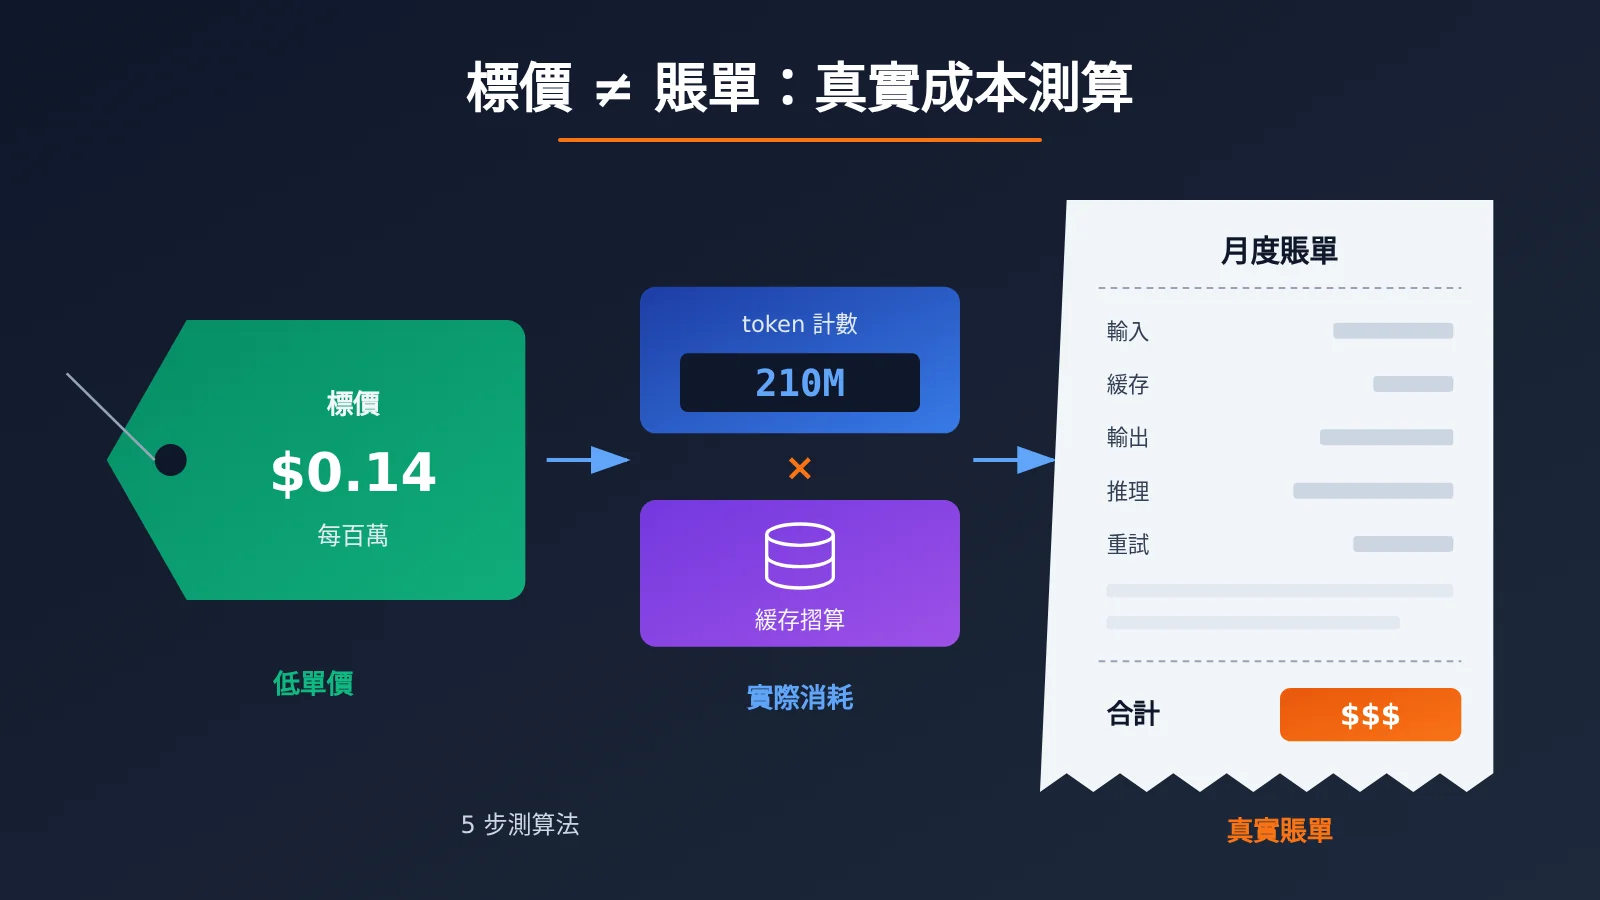
每百萬 token 單價衡量的是“每個 token 多少錢”,但賬單衡量的是“完成一件事多少錢”。兩者之間隔着一個關鍵變量:完成這件事需要多少 token。不同模型在這個變量上的差距,常常比單價差距還大。
一個典型現象來自第三方博客 2026 年 8 月 1 日的測算:DeepSeek V4 Flash 和 Gemini 3.6 Flash 在 Artificial Analysis 上得分相同,都是 50 分。前者標價 $0.14/M,後者 $1.50/M,單價相差約 10 倍。但在同一套評測中,前者消耗約 2.1 億 token,後者約 5900 萬,消耗量相差 3 倍以上。單價優勢被消耗量喫掉了一大部分,實際差距遠沒有 10 倍。
另一個現象是分詞差異。同一來源 2026 年 8 月 12 日的文章把一份完全相同的文檔分別交給 9 個模型計數,結果從 614 到 957 個 token 不等,最大和最小之間相差約 56%。也就是說,即使兩個模型的輸入單價完全一樣,同一份提示詞的輸入費用也可能差一半以上。
💡 數據說明:以上數字來自第三方博客的單次測算,評測任務、模型版本和價格都有時效性,只能作爲“現象存在”的證據,不能直接用於你的預算。你自己的任務需要自己複測。
模型賬單構成:真實成本由哪幾類 token 組成
要把成本算準,先得知道賬單上到底有幾個計費項。大多數廠商的計費可以拆成下表幾類,具體名稱和是否單獨計費以各家官方文檔爲準。
| 計費項 | 含義 | 常見計價方式 | 容易忽略的點 |
|---|---|---|---|
| 未命中緩存的輸入 | 本次新發送、沒有命中緩存的提示詞 | 輸入單價 | 受分詞器影響,同文不同價 |
| 緩存命中的輸入 | 與之前請求相同的前綴部分 | 緩存讀取價,通常遠低於輸入單價 | 前綴必須完全一致才能命中 |
| 緩存寫入 | 部分廠商對首次寫入緩存單獨收費 | 可能高於普通輸入價 | 命中率低時反而更貴 |
| 可見輸出 | 用戶最終看到的回答 | 輸出單價 | 輸出單價通常是輸入的數倍 |
| 推理 token | 模型內部思考過程 | 一般按輸出單價計 | 不顯示在回答裏,但計入賬單 |
把這幾項寫成一個公式,就是本文的核心測算框架:
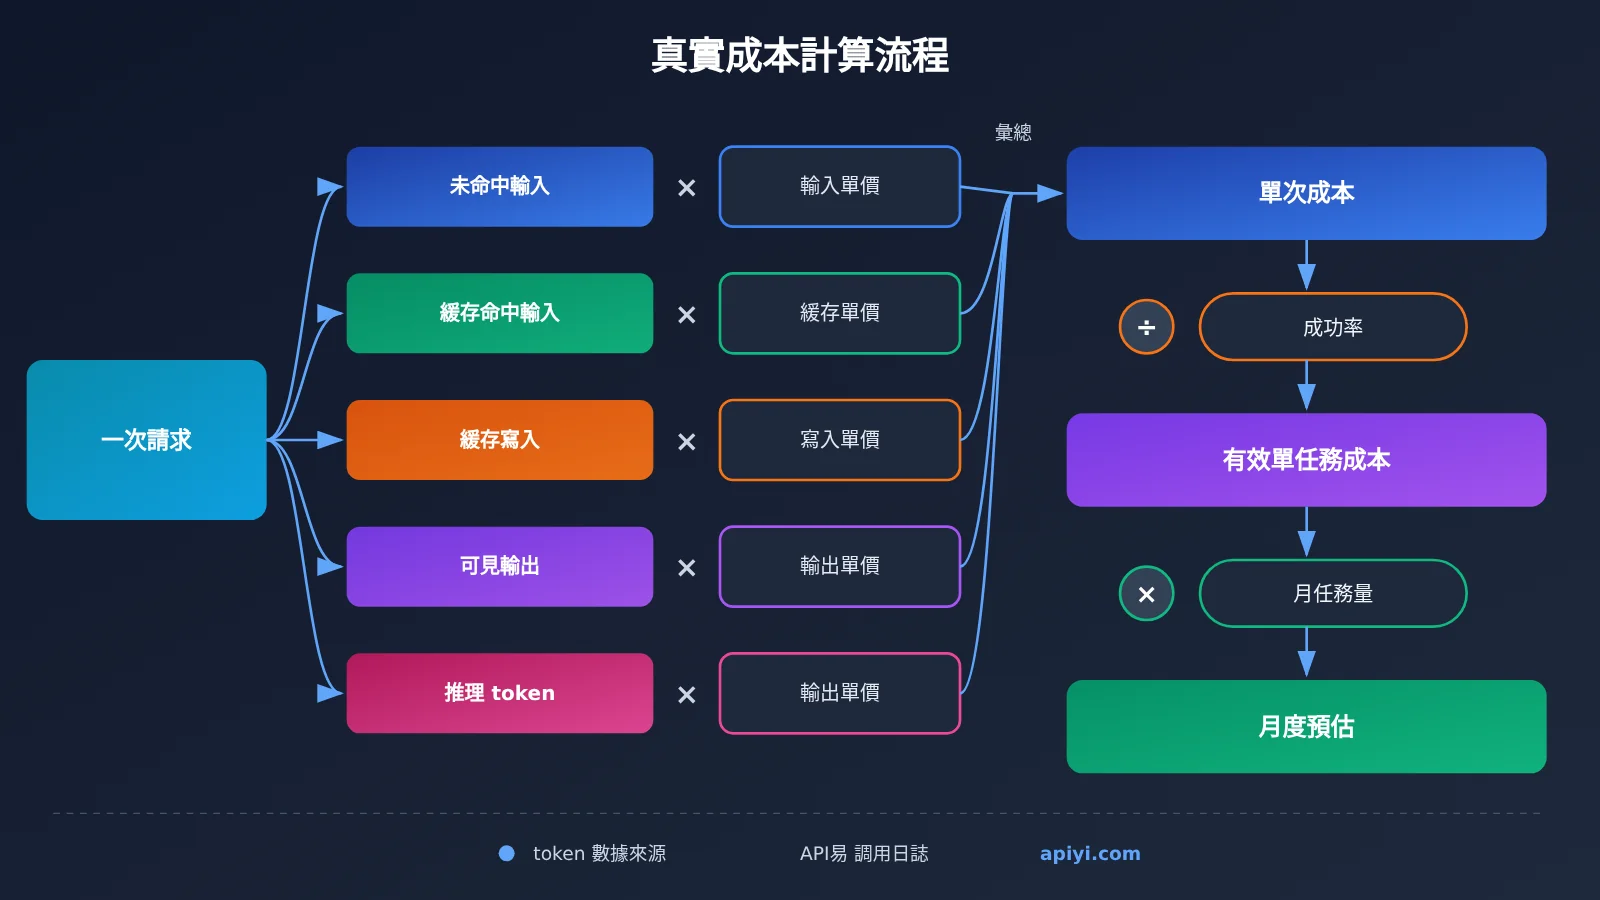
- 單次請求成本 = 未命中輸入 token × 輸入單價 + 緩存命中 token × 緩存單價 + 緩存寫入 token × 寫入單價 + (可見輸出 + 推理 token)× 輸出單價
- 有效單任務成本 = 單次請求成本 × 平均調用次數 ÷ 任務成功率
- 月度預估 = 有效單任務成本 × 月任務量
緩存這一項的影響往往被低估。同一來源 2026 年 8 月 6 日的文章提到,DeepSeek V4 Flash 的緩存命中價格比未命中便宜約 50 倍,而不同託管方的緩存價格之間差距可達 28 倍。這說明“同一個模型、走不同渠道”的賬單也可能完全不同,緩存價格必須按你實際使用的渠道覈實。
推理 token 對真實成本的放大效應
推理型模型是“標價便宜、賬單昂貴”最常見的來源。用戶只問了一句話,模型回答了 200 字,但它在內部可能先思考了幾千個 token。這部分通常按輸出單價計費,而輸出單價本就比輸入高出數倍。
第三方的公開測算也反映了這一點。一篇 2026 年 8 月 4 日的文章稱,Qwen 3.8 Max 在 Artificial Analysis 上比 DeepSeek V4 Flash 高 3 分,但在其實測的 3 個任務上成本高出約 345 倍,速度慢約 6 倍。另一篇同系列文章在相同評測方法下給出:Kimi K3 得 57 分花費 $2,437,DeepSeek V4 Flash 得 50 分花費 $72,Qwen 3.7 Max 得 46 分卻花費 $1,604。分數更低、花費更高的情況確實存在,原因往往就在 token 消耗量上。
同一家廠商的不同版本之間也會出現差異。有文章指出,Claude Opus 4.5 到 4.8 與 Opus 5 標價相同,都是 $5/$25,但實測存在約 1.30 倍的 token 消耗差距。價格不變,賬單卻可能變了 30%,這在升級模型版本時很容易被忽略。
用 token 消耗量估算真實成本:5 步快速上手
下面是一套不需要寫複雜腳本也能執行的小樣本測算流程。核心原則只有一條:同一任務、同一輸入,分別統計輸入、輸出、緩存和推理 token。
第 1 步:準備有代表性的任務樣本
從生產環境或真實需求中挑選 20 到 50 條請求,覆蓋短問答、長文檔、多輪對話等主要類型。樣本要保留完整的系統提示詞和上下文,因爲緩存命中主要發生在這些重複前綴上。不要只用一句“你好”去測,那樣測不出分詞差異和緩存效果。
第 2 步:固定變量,分別調用候選模型
對每個候選模型使用相同的系統提示詞、相同的用戶輸入、相同的 max_tokens 和溫度設置。推理型模型如果支持推理強度參數,需要記錄本次使用的檔位,因爲檔位不同,推理 token 可能相差很多。
在這一步,統一入口能省掉不少麻煩。通過 API易 apiyi.com 這類聚合平臺,可以用同一個 API Key 和同一套 OpenAI 兼容調用方式切換不同廠商的模型,只改模型名就能跑完整組對比,不用爲每家分別開戶、充值和適配 SDK。
第 3 步:逐條記錄各類 token
每次調用後,從響應的 usage 字段中讀取 token 數。以 OpenAI 兼容格式爲例,常見字段包括:
usage.prompt_tokens:輸入 token 總數usage.prompt_tokens_details.cached_tokens:其中命中緩存的部分usage.completion_tokens:輸出 token 總數usage.completion_tokens_details.reasoning_tokens:其中的推理 token
不同廠商的字段名並不統一,例如 Anthropic 格式使用 cache_read_input_tokens 和 cache_creation_input_tokens 區分緩存讀取與寫入,具體以各家文檔爲準。
如果不想自己解析響應,也可以直接看平臺側的記錄。API易 提供每次調用的日誌和用量統計,適合把同一批樣本在不同模型上的消耗放在一起對比。需要注意的是,日誌中是否單獨列出緩存 token 和推理 token、緩存命中是否單獨計價,請以控制檯實際顯示和平臺計費說明爲準,測算前先確認這一點。
🚀 快速開始:建議先在 API易 apiyi.com 上用 20 條樣本跑一輪小規模對比,確認各模型的 token 消耗量級,再決定是否擴大樣本。統一餘額計費的好處是,多模型測試的花費集中在一個賬戶裏,測完對賬也更直觀。
第 4 步:按測算模板彙總
把記錄結果填進下面這張模板,每個模型一行。單價一欄務必註明查詢日期和來源。
| 字段 | 填寫說明 | 數據來源 |
|---|---|---|
| 模型與版本 | 寫明具體版本號或日期後綴 | 調用參數 |
| 單價及查詢日期 | 輸入、輸出、緩存讀取、緩存寫入各一列 | 官方定價頁或所用平臺的價格頁 |
| 平均未命中輸入 token | 樣本均值 | 響應 usage 或平臺日誌 |
| 平均緩存命中 token | 樣本均值,並計算命中率 | 響應 usage 或平臺日誌(如 API易 用量統計) |
| 平均可見輸出 token | 輸出總數減去推理部分 | 響應 usage |
| 平均推理 token | 推理型模型單獨記錄 | 響應 usage |
| 任務成功率 | 人工或規則判定合格比例 | 評審記錄 |
| 有效單任務成本 | 按前文公式計算 | 彙總計算 |
第 5 步:用有效單任務成本做決策
最後比較的不是單價,而是“有效單任務成本”。下面用一組示意價格演示計算過程,數字是爲說明方法虛構的,不代表任何模型的真實報價。
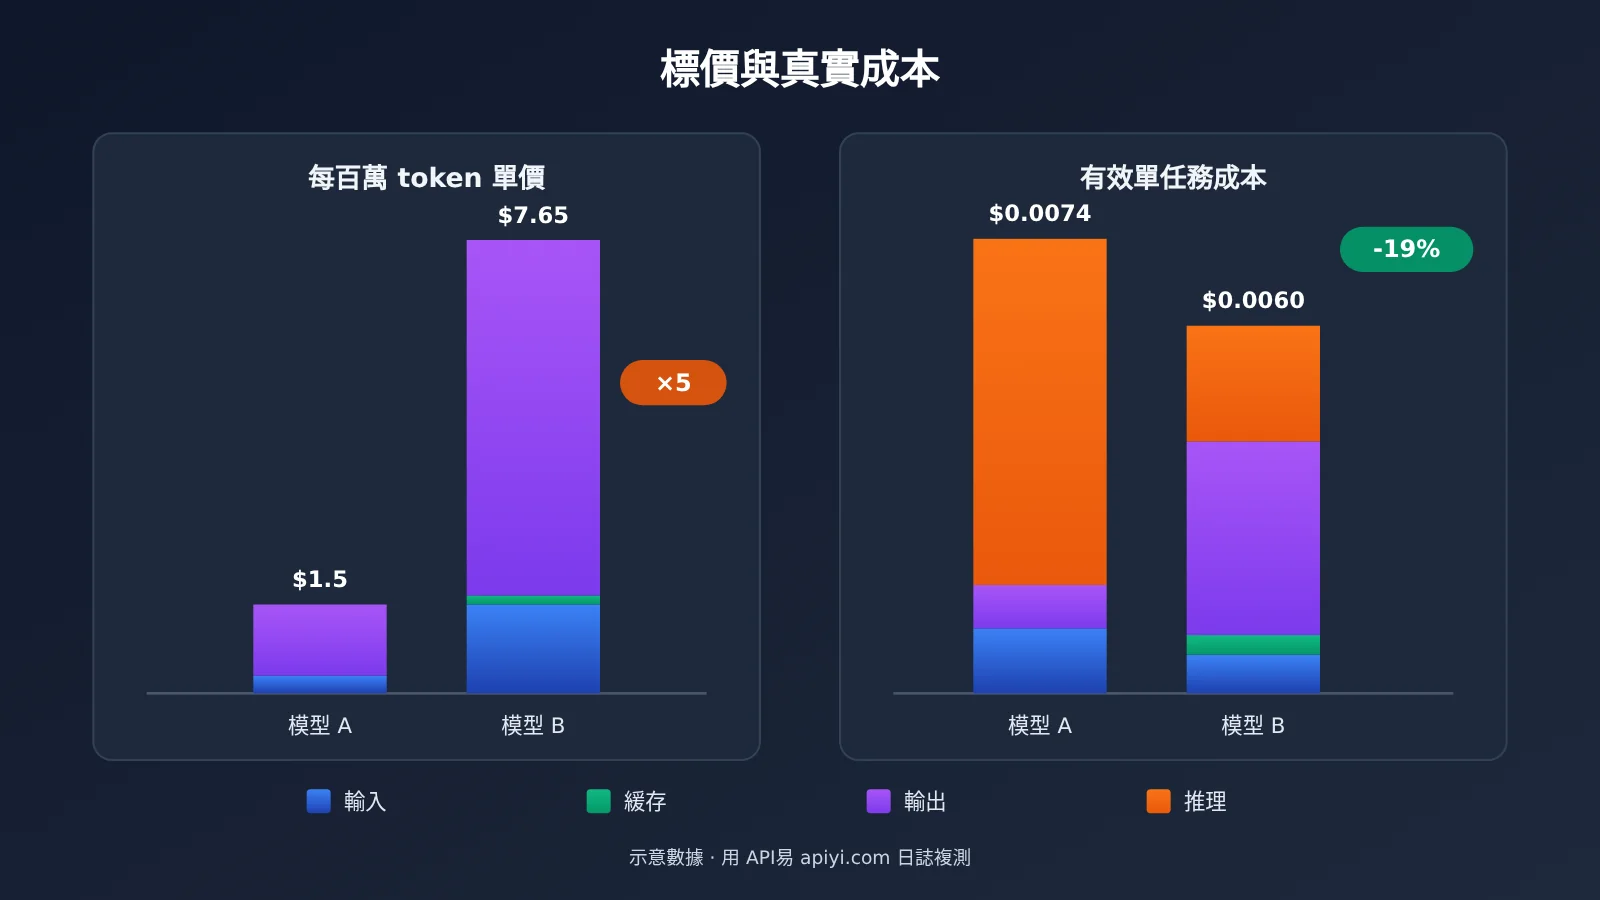
假設模型 A 標價輸入 $0.3/M、輸出 $1.2/M;模型 B 標價輸入 $1.5/M、輸出 $6/M、緩存讀取 $0.15/M,單價是 A 的 5 倍。
| 計算項 | 模型 A(低標價) | 模型 B(高標價) |
|---|---|---|
| 未命中輸入 token | 3,000 | 400 |
| 緩存命中 token | 0 | 2,000 |
| 可見輸出 + 推理 token | 500 + 4,000 | 500 + 300 |
| 輸入費用 | $0.0009 | $0.0006 + $0.0003 |
| 輸出費用 | $0.0054 | $0.0048 |
| 單次請求成本 | $0.0063 | $0.0057 |
| 任務成功率 | 85% | 95% |
| 有效單任務成本 | 約 $0.0074 | 約 $0.0060 |
在這個示意場景中,模型 B 的分詞更緊湊,輸入總量少了 600 token;它的長系統提示詞大部分命中了緩存;推理過程也短得多。最終,標價貴 5 倍的 B,有效成本反而比 A 低約 19%。現實中結論可能相反,這正是必須用自己的任務複測的原因。
測算真實成本時的注意事項
測算框架本身不復雜,但有幾個坑會讓結果失真,執行前值得逐條檢查:
- 價格必須標註日期:模型價格調整頻繁,參考資料中就提到 DeepSeek V4 Pro 0813 從 2026 年 8 月 16 日起實行高峯與非高峯分時定價。同一模型在不同時段、不同渠道的價格都可能不同。
- 注意模型別名指向的版本:有文章提到,某個看起來“最常用”的模型名實際調用的是舊版本。測算時記錄響應中返回的模型標識,避免測 A 版本、上線 B 版本。
- 緩存命中依賴前綴一致:把動態內容(時間戳、用戶 ID)放在提示詞開頭,會導致每次前綴都不同,緩存幾乎無法命中。測算時要用和生產一致的提示詞結構。
- 第三方跑分只作參考:Artificial Analysis 一類的綜合分數,以及按任務計算的成本,反映的是評測機構的任務分佈,不等於你的業務場景。
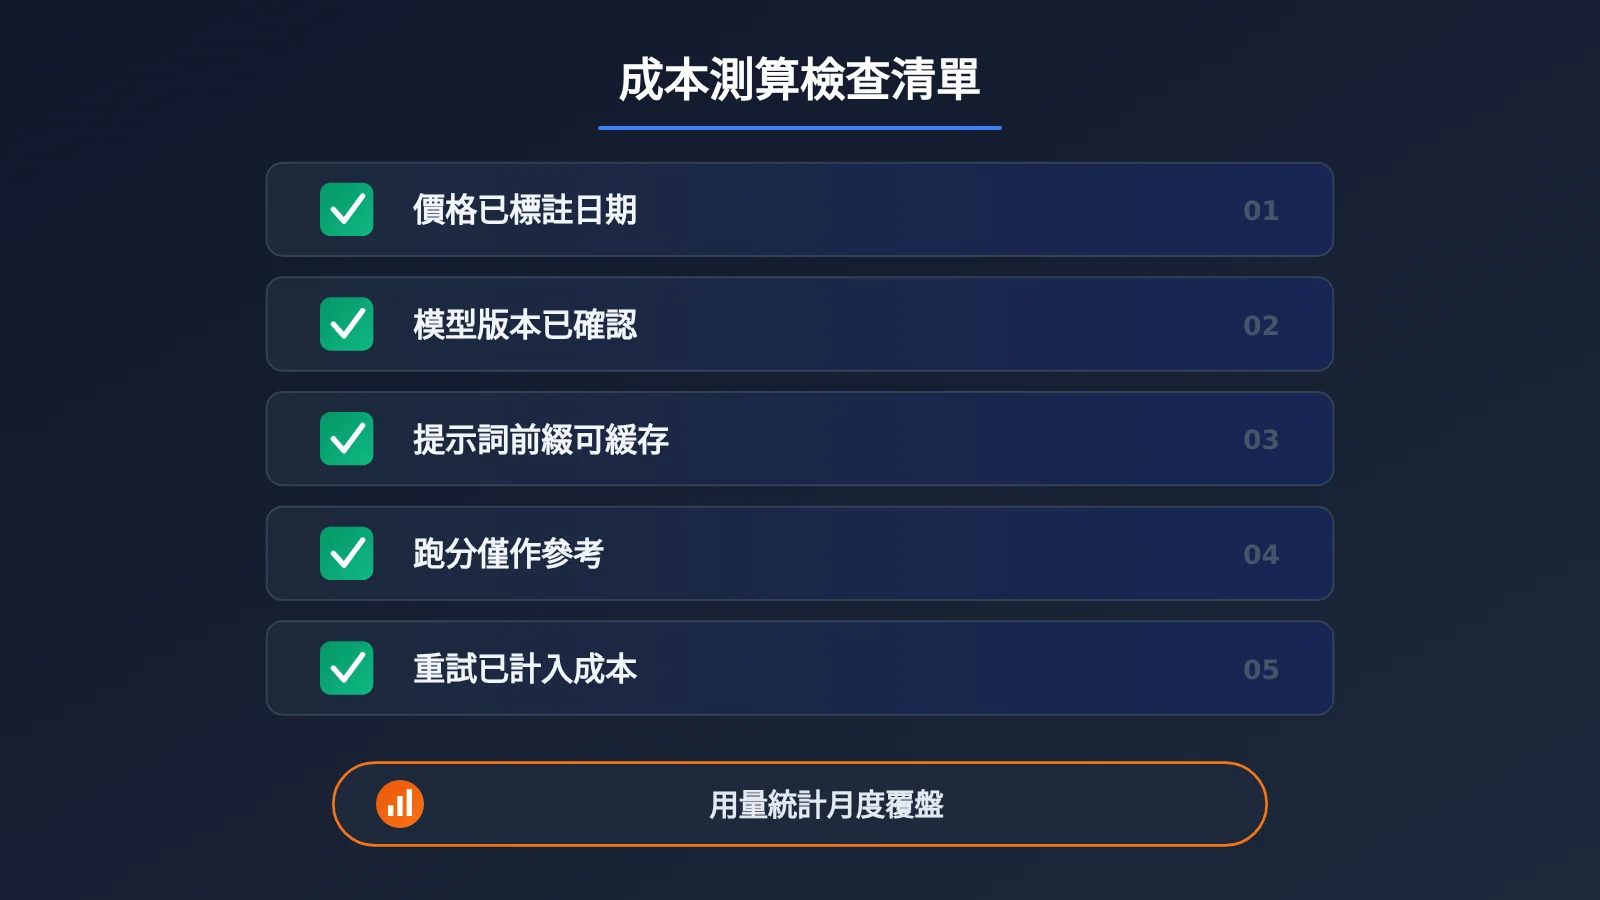
- 把重試算進去:429 限流、格式錯誤、答案不合格導致的重跑都會產生費用,成功率要基於實際判定結果計算。
💰 成本優化建議:測算完成後,可以把“有效單任務成本”作爲選型的主指標,把跑分和延遲作爲約束條件。在 API易 apiyi.com 上切換模型只需修改模型名,便於在測算結論變化時快速調整線上配置,同時繼續用調用日誌監控實際消耗。
常見問題 FAQ
Q1:什麼是模型的“真實成本”?
真實成本是完成一個具體任務實際支付的費用,而不是每百萬 token 的標價。它等於各類 token(未命中輸入、緩存命中、緩存寫入、可見輸出、推理)的實際數量分別乘以對應單價,再考慮成功率和重試後得到的有效單任務成本。
Q2:爲什麼同一份文檔在不同模型裏 token 數不一樣?
因爲每個模型使用的分詞器不同,對中文、代碼、標點的切分粒度不同。公開測算中,同一份文檔在 9 個模型中被計爲 614 到 957 個 token。所以輸入成本必須按各模型自己報告的 token 數計算,不能用一個模型的計數套到其他模型上。
Q3:推理 token 一定要算進成本嗎?
要算。多數廠商把推理 token 計入輸出並按輸出單價收費,它不會出現在回答正文裏,卻可能佔輸出的大部分。測算推理型模型時,建議單獨記錄 `reasoning_tokens`,並在相同推理強度檔位下對比。
Q4:緩存命中能省多少錢?
取決於廠商的緩存定價和你的命中率。參考資料中提到 DeepSeek V4 Flash 緩存命中價約爲未命中的 1/50,但不同託管方的緩存價格差距可達 28 倍。長系統提示詞、固定知識庫前綴、多輪對話等場景收益最大,具體數值請以所用渠道的價格說明爲準。
Q5:如何快速對多個模型做小樣本成本測算?
推薦使用支持多模型統一接入的平臺來做:
1. 在 API易 apiyi.com 註冊並獲取 API Key
2. 準備 20 到 50 條真實任務樣本,固定提示詞和參數
3. 逐個切換模型名調用,用調用日誌和用量統計彙總各類 token
4. 按本文模板計算有效單任務成本
這樣可以在一個賬戶、一套調用方式下完成全部對比,減少多家開戶和對賬的成本。
Q6:第三方博客給出的“每任務成本”能直接用嗎?
不建議直接用於預算。這類數據適合用來發現“可能存在 token 消耗差異”的模型組合,幫你縮小候選範圍。但評測任務、模型版本、價格和緩存條件都和你的業務不同,最終數字需要用自己的樣本複測。
Q7:這套測算方法有哪些侷限?
小樣本只能反映樣本覆蓋的任務類型,業務分佈變化後需要重測。另外,部分平臺的日誌未必區分緩存和推理 token,此時只能從模型響應的 `usage` 字段自行採集。價格和模型版本也會變動,建議每次調價或升級後重新跑一輪。
模型真實成本測算核心要點 Key Takeaways
- 單價只是公式的一半:賬單取決於單價乘以實際 token 消耗量
- 分詞差異不可忽略:同一文檔在不同模型中 token 數可相差 50% 以上
- 推理 token 會放大輸出成本:看不見的思考過程同樣按輸出計費
- 緩存價格因渠道而異:命中率和緩存單價共同決定長提示詞場景成本
- 以有效單任務成本做決策:把成功率和重試一併計入
- 用統一入口做複測:藉助 API易 的統一接口和調用日誌,同一樣本跑多個模型更省事
總結
用 token 消耗量和緩存估算模型真實成本,關鍵在三點:
- 拆開賬單:分別統計未命中輸入、緩存命中、緩存寫入、可見輸出和推理 token,各乘對應單價。
- 用自己的任務複測:第三方跑分和價格只能作爲參考,同一任務、同一輸入下的實測數據纔可靠。
- 比較有效單任務成本:把成功率和重試算進去,再結合月任務量做預算。
模型價格會變,新模型會不斷出現,但這套測算方法可以長期複用。建議在下一次選型前,先用 20 條真實樣本跑一輪對比,再決定上線哪個模型。如果需要在多個廠商的模型之間快速切換測試,可以通過 API易 apiyi.com 統一接入,用調用日誌直接覈對每個模型的實際消耗。
📚 參考資料
- Ofox.ai Blog 第 23 頁:包含 DeepSeek V4 Flash 與 Gemini 3.6 Flash 的 token 消耗對比、緩存價格差異、Qwen 系列成本測算等文章摘要
- 鏈接:
ofox.ai/blog/page/23/ -
說明:文章發佈於 2026 年 8 月,數據爲第三方單次測算,僅作現象參考
-
Ofox.ai Blog 第 22 頁:包含同一文檔在 9 個模型中的 token 計數對比、Claude 版本間 token 消耗差距、DeepSeek V4 Pro 分時定價等信息
- 鏈接:
ofox.ai/blog/page/22/ -
說明:適合瞭解分詞差異和版本差異的具體案例
-
Ofox.ai Blog 第 25 頁:包含 Kimi K3 與 GLM-5.2、Opus 4.8 的單任務成本對比
- 鏈接:
ofox.ai/blog/page/25/ - 說明:價格與跑分有時效性,使用前請以各廠商官方定價頁爲準
作者:API易 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心