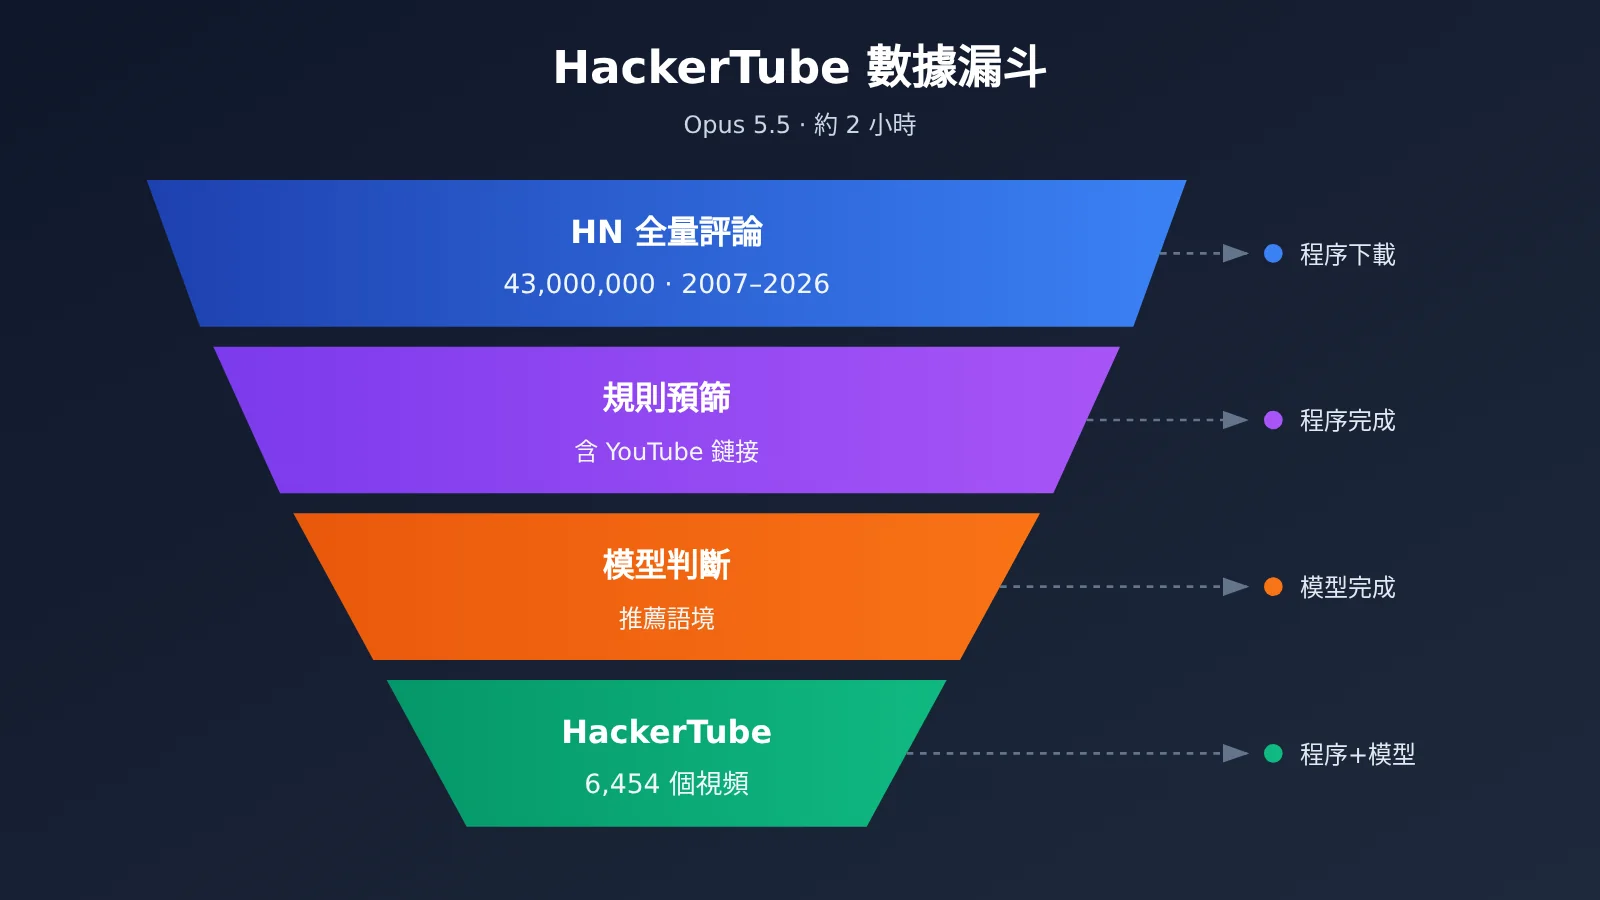
Andrej Karpathy 週末花了大約兩小時做出一個視頻站 HackerTube。他讓 Claude 從 Hacker News 20 年、約 4300 萬條評論裏,篩出 6,454 個被反覆推薦的 YouTube 視頻,整個過程主要是在和 Claude 對話。Karpathy 在 X 上說的原話(2026-11-01)是:「~2 hours with Opus 5.5」。
下面的內容根據 Karpathy 原帖、HackerTube 站點和社區公開轉述整理,把這件事拆成普通開發者可以照着做的 6 個步驟,並列出 3 個最容易卡住的地方。
核心價值:讀完本文,你會得到一條寫清楚「人、程序、模型」各自負責什麼的 6 步流程,一份標明假設的成本估算,以及用 API易 apiyi.com 接入 Claude Code 的最短路徑。
Karpathy 的 HackerTube 到底做了什麼
一句話概括:他把 HN 社區 20 年裏「你一定要看這個視頻」的集體推薦,整理成了一個可以瀏覽的視頻站。
Karpathy 在 X 上說的完整原文(2026-11-01 18:14 UTC)如下:
「Weekend hack: HackerTube. I was annoyed with YouTube’s recommendations so I had Claude filter down 43M comments over 20 years of HN to 6,454 videos that keep being recommended. Significantly better viewing experience, ~2 hours with Opus 5.5」
站點 hackertube.org 的頁面描述是「The YouTube videos that Hacker News keeps telling each other to watch.」。可以看出,它的核心不是推薦算法,而是對已有社區討論做語義篩選。
| 要點 | 公開信息 | 來源性質 |
|---|---|---|
| 數據規模 | HN 20 年約 4300 萬條評論,最終保留 6,454 個視頻 | Karpathy 原帖(2026-11-01) |
| 耗時與模型 | 約 2 小時,使用 Opus 5.5 | Karpathy 原帖(2026-11-01) |
| 工具環境 | Claude Code 桌面端 | 據社區轉述 |
| 人工動作 | 隻手動做三件事:申請 YouTube API key、準備服務器、買域名 | 據社區轉述 |
| 站點形態 | 約 150 個主題,時間跨度 2007-2026,無需登錄 | 據社區統計 |
HackerTube 工作方式重點詳解
據社區轉述,Karpathy 說過「I only talk to Claude and have it do everything」。也就是說,下載數據、寫篩選腳本、調用模型做判斷、生成頁面這些工作,大部分由 Claude 在 Claude Code 裏完成,人主要負責提需求和處理需要賬號或付費的環節。
這和「AI 寫一個網頁模板」不是一回事。真正有難度的部分在數據:4300 萬條評論不可能一次塞進上下文,「鏈接出現」也不等於「被推薦」。所以這個項目更像一條數據管道,加上一個很薄的前端。
Opus 5.5 復刻 HackerTube 的 6 步流程
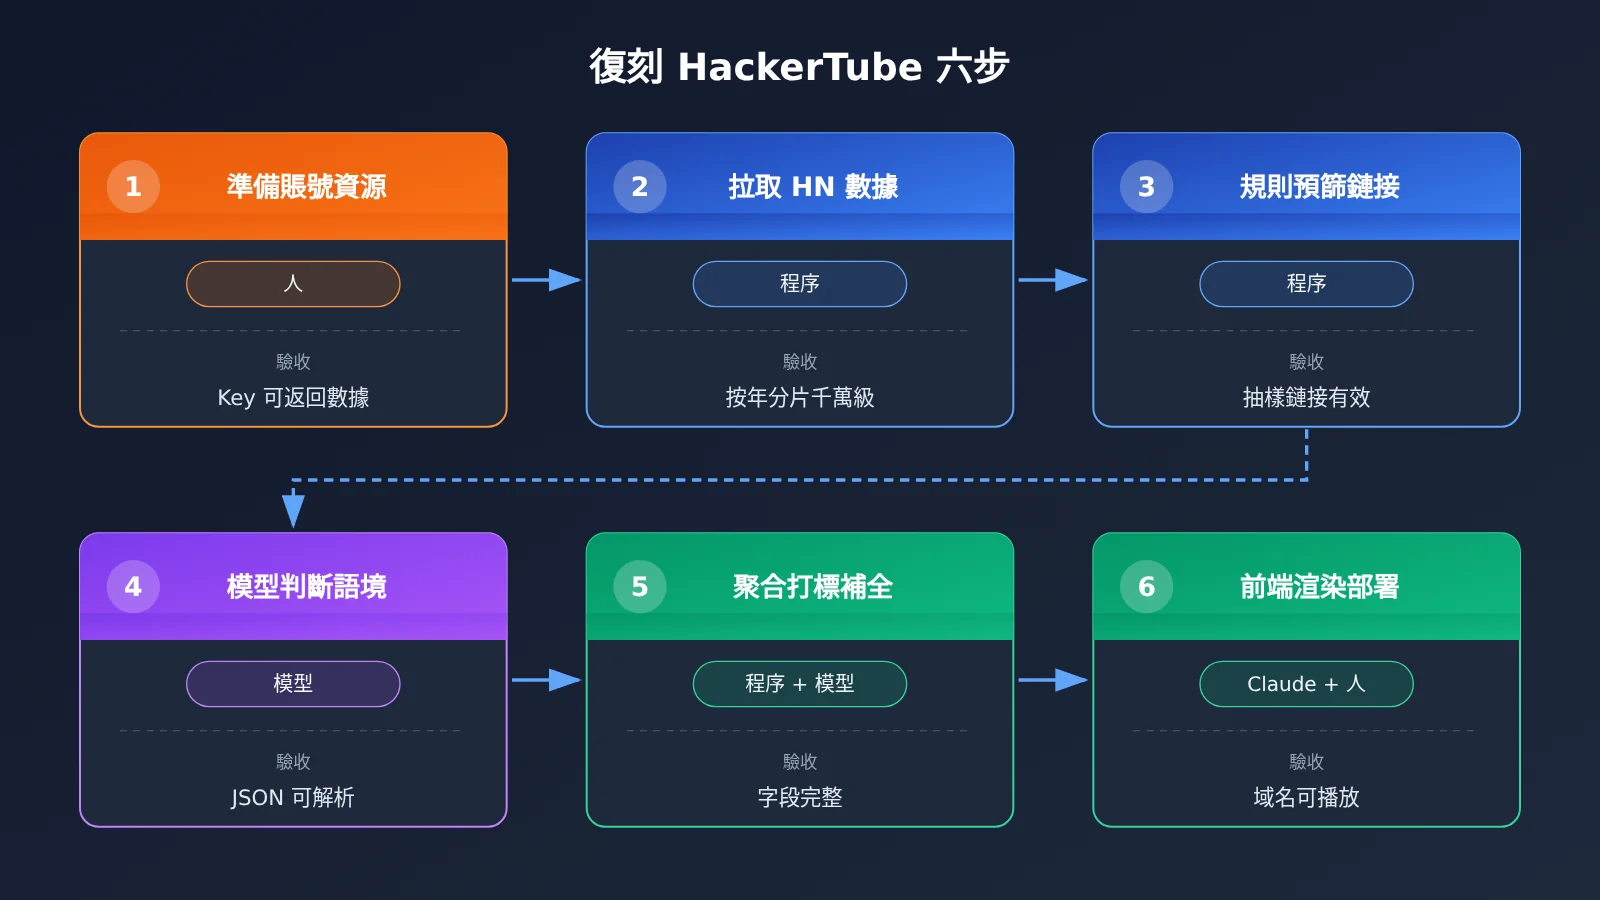
結論先行:照做的關鍵是先讓程序把數據量砍下來,再讓模型只做必須靠理解完成的判斷。下面 6 步按執行順序排列,每一步都寫明誰來做、做完怎麼驗收。
| 步驟 | 做什麼 | 誰來做 | 做完怎麼驗收 |
|---|---|---|---|
| 1 | 申請 YouTube API key、準備服務器、買域名 | 人 | 三樣東西都能登錄,Key 能返回一條視頻信息 |
| 2 | 拉取 HN 全量評論 | 程序(由 Claude 編寫) | 本地有按年份分好的文件,條數與預期量級一致 |
| 3 | 正則抽取含 YouTube 鏈接的評論 | 程序 | 抽樣 50 條,確認每條都含有效視頻鏈接 |
| 4 | 分批讓模型判斷是否爲推薦語境,輸出 JSON | 模型 | JSON 能直接解析,抽樣人工覈對正誤 |
| 5 | 按 videoId 聚合計數、打主題標籤、補標題頻道 | 程序 + 模型 | 每個視頻都有完整字段,主題數量在可控範圍 |
| 6 | 生成前端頁面並部署 | Claude 寫代碼,人綁定域名 | 瀏覽器打開域名,能按主題瀏覽並播放視頻 |
第 1-2 步:準備資源與拉取 HN 數據
第 1 步由人完成。 在 Google Cloud 控制檯創建項目並啓用 YouTube Data API,生成 API key;服務器可以是任意雲主機或靜態託管服務;域名在註冊商購買後備用。這三件事都需要賬號或付款,正是社區轉述中 Karpathy 親自處理的部分。
第 2 步由 Claude 編寫程序完成。 HN 數據有兩個公開來源:官方 Firebase API 可以按 item ID 逐條拉取,BigQuery 上也有 HN 公開數據集可以直接用 SQL 查詢。全量下載建議優先考慮 BigQuery,按年份導出。驗收時只看兩點:文件按時間切好了,總條數在千萬級。
第 3-4 步:規則預篩與 Opus 5.5 語義判斷
第 3 步是省錢的關鍵,完全交給程序。 用正則匹配 youtube.com/watch、youtu.be/ 等鏈接格式,只保留含視頻鏈接的評論,同時帶上評論 ID、時間和父帖標題作爲上下文。在 Claude Code 裏直接描述需求即可,例如「寫一個腳本,把含 YouTube 鏈接的評論抽出來存成 JSONL」。
第 4 步才輪到模型做判斷。 每批交給 Opus 5.5 幾千條評論,要求只輸出結構化結果,字段包括 videoId、是否推薦、主題、代表性評論摘錄。提示詞裏要寫清楚:「這個視頻很爛」「別看這個」屬於不推薦,只有表達「值得看」的纔算。驗收方式是隨機抽取一批結果人工覈對,判斷錯誤率是否可以接受。
第 5-6 步:聚合打標與前端部署
第 5 步先用規則,再用模型。 程序按 videoId 統計被推薦次數,然後調用 YouTube Data API 補齊標題和頻道。主題標籤交給模型統一歸併,避免出現「機器學習」「ML」「深度學習入門」這類拆得過散的標籤。據社區統計,HackerTube 最終約有 150 個主題,可以作爲參考粒度。
第 6 步把數據和頁面分開。 最終產物是一份 JSON 數據文件,加上一個讀取它的靜態前端;視頻用 YouTube iframe 嵌入,按主題和熱度排序。數據更新時只需要重新生成 JSON,頁面代碼不用動。部署可以放在靜態託管服務或你的服務器上,最後由人把域名解析過去。
🚀 快速開始:第 4、5 步需要頻繁調用模型。通過 API易 apiyi.com 接入 Claude Code 後,可以用同一個 Key 在 Opus 和 Sonnet 之間切換,先用小批量數據跑通流程,再決定正式跑數時用哪個模型。
復刻 HackerTube 時三個真會卡住的坑
結論先行:卡住的地方几乎都在數據側,而不在寫網頁。下面三個坑按踩到的先後順序排列。
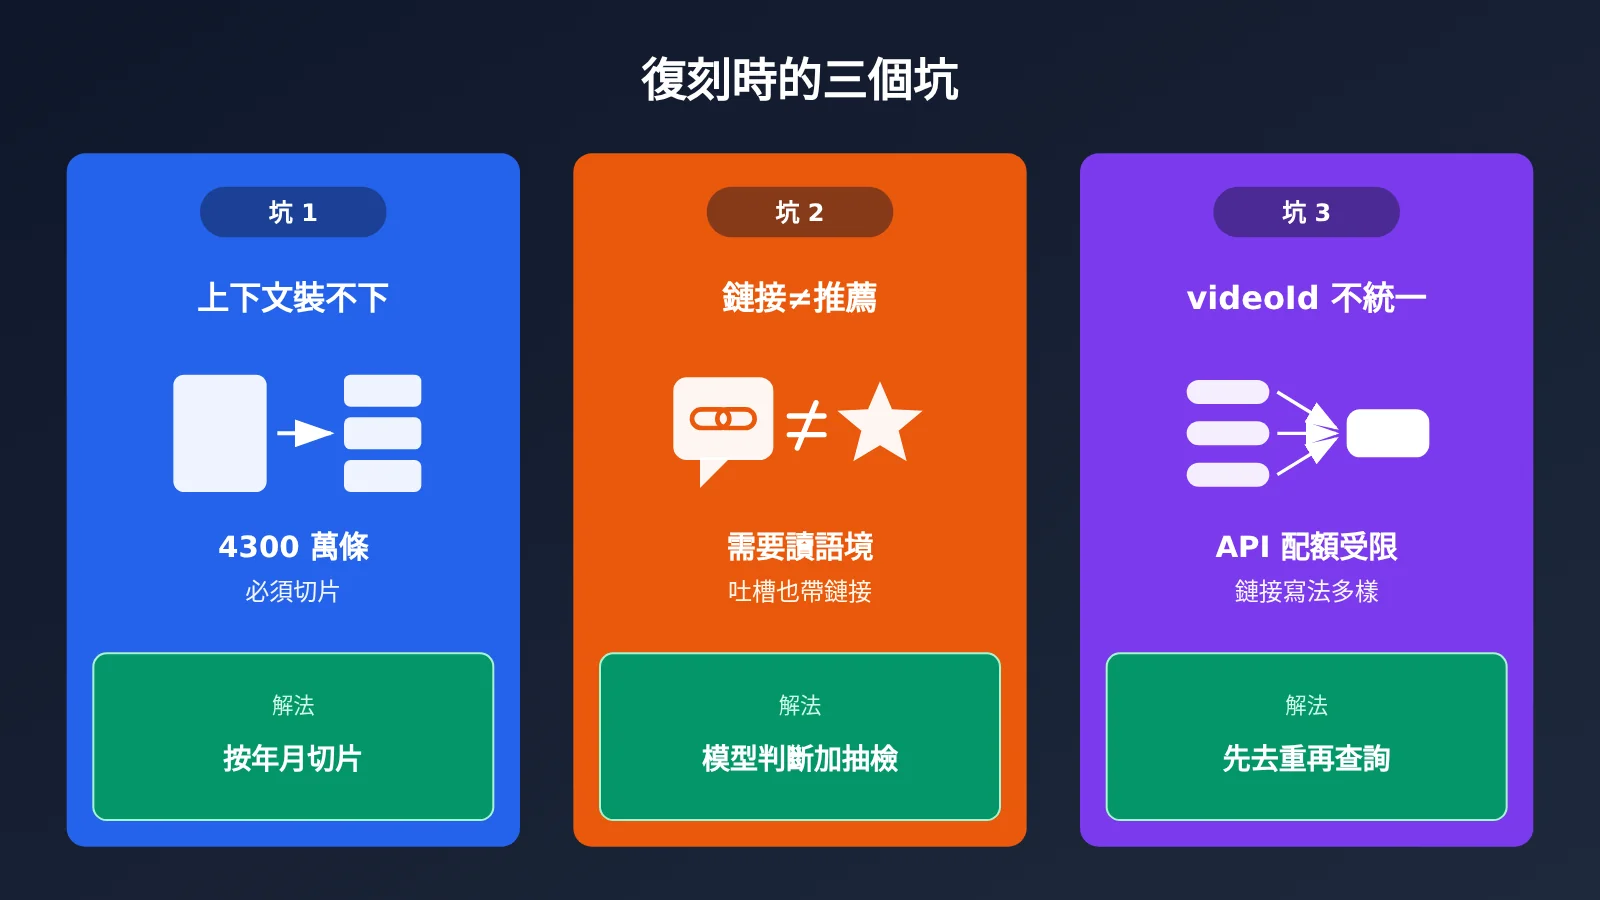
| 坑 | 典型表現 | 解法 |
|---|---|---|
| 上下文裝不下 | 讓模型「讀完所有評論」,結果超長報錯或輸出被截斷 | 按年月切片,每批數千條,只輸出結構化 JSON |
| 鏈接≠推薦 | 吐槽、反諷、糾錯裏的鏈接被當成推薦 | 讓模型讀評論上下文判斷,並人工抽檢 |
| ID 混亂與配額 | 同一視頻多種鏈接寫法、已刪除視頻、API 額度耗盡 | 先統一 videoId 再聚合,元數據只查去重後的 ID |
坑 1:Opus 5.5 上下文裝不下 4300 萬條評論
新手最常見的錯誤是把需求直接寫成「讀完 HN 所有評論,找出被推薦的視頻」。無論模型上下文多大,都不可能一次裝下十幾億 tokens 的文本。正確做法是讓 Claude 先寫分片腳本,按年或按月切開,每批控制在幾千條,並要求模型只返回 JSON,不寫解釋性文字。
還要設計斷點續跑機制:每批結果單獨落盤,並記錄已處理的批次號。跑到一半出錯時,只需要重跑失敗的批次,不必從頭開始。
坑 2:出現 YouTube 鏈接不等於被推薦
HN 評論裏的 YouTube 鏈接可能是推薦,也可能是反例、吐槽,或者「這個視頻講錯了」。只做 URL 匹配會把大量噪聲帶進結果。這一步必須交給模型閱讀上下文,這也是整個流程中真正需要大模型參與的環節。
建議在提示詞裏給出正反例,併爲每條判斷附上一句依據摘錄。這樣人工抽檢時可以快速判斷模型爲什麼這樣分類,前端也可以直接用這段摘錄作爲視頻卡片上的「HN 怎麼說」。
坑 3:videoId 不統一與 YouTube API 配額
同一個視頻可能以 youtube.com/watch?v=、youtu.be/、移動端鏈接、帶時間戳參數等多種形式出現。如果不先歸一化成 11 位 videoId,推薦次數會被拆散,排序也會失真。另外,20 年間不少視頻已經被刪除或設爲私享,需要單獨標記並過濾。
YouTube Data API 有每日配額限制,應該先完成去重,再批量查詢元數據,不要每條評論查一次。批量接口一次可以查詢多個 ID,能大幅減少消耗。
HackerTube 復刻成本大概多少(估算)
結論先行:全量交給 Opus 5.5 處理是數千美元量級;先做規則預篩,可以降到幾十到上百美元量級。 以下全部是估算,不是實際賬單。
先看單價。下表來自 API易 型號價格表,數據時間爲 2026-10-27 14:50(UTC+8),單位是美元 / 百萬 tokens。
| 模型 | 輸入 | 輸出 | 緩存讀 | 可用平臺 |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | API易 apiyi.com、官方 API |
| sonnet-5-5 | $2 | $10 | $0.1 | API易 apiyi.com、官方 API |
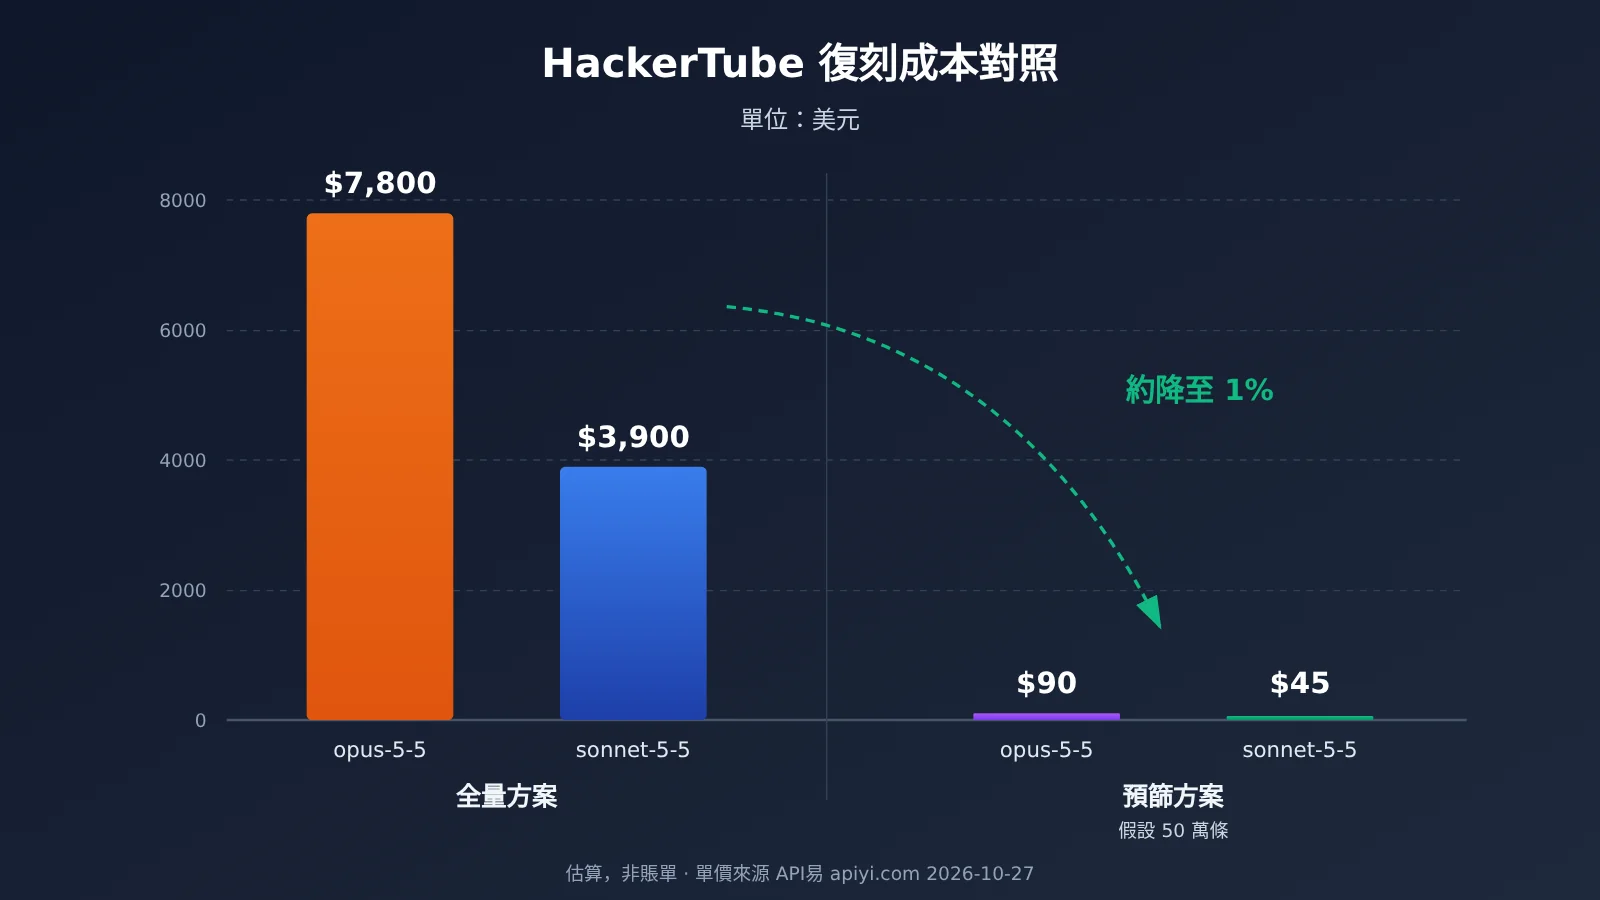
估算假設如下:4300 萬條評論,平均每條 30 tokens,合計約 13 億 tokens;每批輸入 5 萬 tokens、輸出 5 千 tokens,共約 2.6 萬批。預篩方案中的「剩餘 50 萬條」只是爲了演示計算方法而設定的假設,不是 HN 的真實統計,實際條數需要你跑完第 3 步才能知道。
| 方案 | 輸入 tokens | 輸出 tokens | opus-5-5 估算 | sonnet-5-5 估算 |
|---|---|---|---|---|
| 全量直接交給模型 | 約 13 億 | 約 1.3 億 | 約 $5,200 + $2,600 ≈ $7,800 | 約 $2,600 + $1,300 ≈ $3,900 |
| 先規則預篩(假設剩 50 萬條) | 約 1500 萬 | 約 150 萬 | 約 $60 + $30 ≈ $90 | 約 $30 + $15 ≈ $45 |
從這張表可以看出,第 3 步規則預篩決定了整個項目的成本量級。另外,每一批請求的系統提示詞和正反例都是重複內容,配合緩存讀取單價,這部分費用可以進一步壓低。社區裏也有一個參照:X 用戶 @thisiskp_ 稱用 Opus 5.5 約 19 分鐘、約 2 美元做了一個 Show HN 視頻站 demo。這只是單個案例,規模和數據量都不同,不能直接類比。
💰 成本建議:正式跑數之前,先用一個月的數據跑通流程,記下實際 token 消耗,再乘以月份數估算總量。在 API易 apiyi.com 按量計費,沒有固定月費,適合這種「先試小批量,再決定規模」的用法。
用 API易 接 Claude Code 跑 HackerTube 流程
結論先行:只需要設置兩個環境變量,Claude Code 就能通過 API易 調用 Opus 5.5,同一把 Key 可以在 opus-5-5 和 sonnet-5-5 之間切換。
[截圖位:API易 Claude Code 接入文檔]
按照 API易 Claude Code 接入文檔(docs.apiyi.com/scenarios/programming/claude-code),在終端設置以下兩項:
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 API易 Key>
設置完成後啓動 Claude Code,在模型選項中選擇 opus-5-5 或 sonnet-5-5 即可。實際操作中,可以採用「強模型規劃、經濟模型執行」的分工:
- 規劃與寫代碼階段用 opus-5-5:讓它設計分片方案、編寫抓取與預篩腳本、生成前端,這部分 token 量不大,但對質量要求高。
- 批量判斷階段對比兩個模型:用同一批幾百條樣本分別跑 opus-5-5 和 sonnet-5-5,人工比較判斷準確率,再決定 2.6 萬批或預篩後的批次用哪個。
- 主題歸併階段回到 opus-5-5:150 個左右的主題歸併需要全局視角,調用次數少,用強模型更穩妥。
🎯 技術建議:在 API易 apiyi.com 控制檯創建 Key 後,可以爲這個項目單獨設置額度上限,避免批處理腳本出現循環調用時費用失控。新用戶的免費測試額度足夠把一個月的樣本數據跑一遍。
Karpathy 這套 HackerTube 方法還能用在哪些數據上
結論先行:只要數據滿足「大量社區討論裏夾雜着對某類資源的推薦」,就可以套用同一條管道。
- Reddit 技術版塊:篩選被反覆推薦的書、課程或開源倉庫,管道結構幾乎相同,只需替換鏈接正則。
- GitHub Issues 與討論區:提取被多次引用的博客文章或解決方案鏈接,整理成某個項目的「必讀清單」。
- 團隊內部 IM 或文檔評論:內容團隊可以從歷史討論中找出被同事反覆轉發的參考資料,前提是確認數據使用權限。
- 播客與論文推薦:把鏈接正則換成 arXiv 或播客平臺格式,就能得到「社區真正推薦的論文 / 節目」。
遷移時只有兩處需要調整:第 3 步的預篩規則和第 4 步提示詞裏的正反例。數據管道、分批調用、JSON 結構和靜態前端都可以複用。
常見問題 FAQ
Q1:沒有 YouTube API key 能不能做 HackerTube 這類站?
可以做出主體。videoId 從評論鏈接中提取,播放用 iframe 嵌入,都不依賴 API key;缺少的是標題、頻道等元數據。可以先用 HN 評論中的上下文讓模型生成描述,之後再補上 Key。
Q2:Hacker News 的評論數據怎麼拿?
有兩個途徑:HN 官方 Firebase API(github.com/HackerNews/API)可以按 item ID 拉取,適合增量更新;BigQuery 上的 HN 公開數據集適合一次性全量導出。全量復刻建議優先使用後者。
Q3:爲什麼不直接做一個推薦算法?
Karpathy 原帖的出發點就是對 YouTube 推薦不滿意。HackerTube 用的是 20 年社區集體判斷,不需要用戶行爲數據,也沒有冷啓動問題,兩小時內就能做完;推薦算法則需要長期積累和持續調優。
Q4:「2 小時」是全自動完成的嗎?
不是全自動。據社區轉述,Karpathy 手動申請了 YouTube API key、準備了服務器、買了域名,其餘工作通過和 Claude 對話完成。人仍然負責提需求、做驗收和處理需要賬號的環節。普通人復刻時還要預留調提示詞和人工抽檢的時間。
Q5:這套方法成本會不會失控?
如果跳過預篩直接把全量數據交給模型,估算會達到數千美元,確實可能失控。控制方法有三個:先做規則預篩,先跑一個月的樣本測算,再在 API易 apiyi.com 爲 Key 設置額度上限。型號與價格以平臺型號列表爲準。
總結
Karpathy 的 HackerTube 證明了一件事:在 Claude Code 加 Opus 5.5 的組合下,一個人週末就能把千萬級的社區討論變成一個可用的產品。不過,真正起作用的是數據管道的設計,而不是「AI 自動寫網站」。
- 流程:資源準備 → 拉數據 → 規則預篩 → 模型判斷 → 聚合打標 → 部署,人、程序、模型分工明確。
- 難點:上下文切片、推薦語境判斷、videoId 歸一與 API 配額。
- 成本:全量是數千美元量級,預篩後可降到幾十到上百美元量級,都需要以自己跑出的小樣本數據爲準。
- 上手:兩個環境變量即可讓 Claude Code 通過 API易 調用 opus-5-5 與 sonnet-5-5。
如果你想把這套方法用到自己的數據上,建議先從一個月的小樣本開始,通過 API易 apiyi.com 用免費額度跑通全流程,再決定正式規模。
參考資料
- Karpathy 原帖(2026-11-01):HackerTube 發佈說明
- 鏈接:
x.com/karpathy/status/2116957135661945283 -
說明: 數據規模、耗時和模型信息的一手來源
-
HackerTube 站點:項目成品
- 鏈接:
hackertube.org -
說明: 可以查看主題分類和頁面形態
-
API易 Claude Code 接入文檔:環境變量配置
- 鏈接:
docs.apiyi.com/scenarios/programming/claude-code -
說明: Claude Code 接入步驟
-
API易 型號價格總表:模型單價
- 鏈接:
docs.apiyi.com/models -
說明: 型號與價格以此爲準
-
Hacker News 官方 API 說明:數據獲取
- 鏈接:
github.com/HackerNews/API - 說明: item 結構與拉取方式