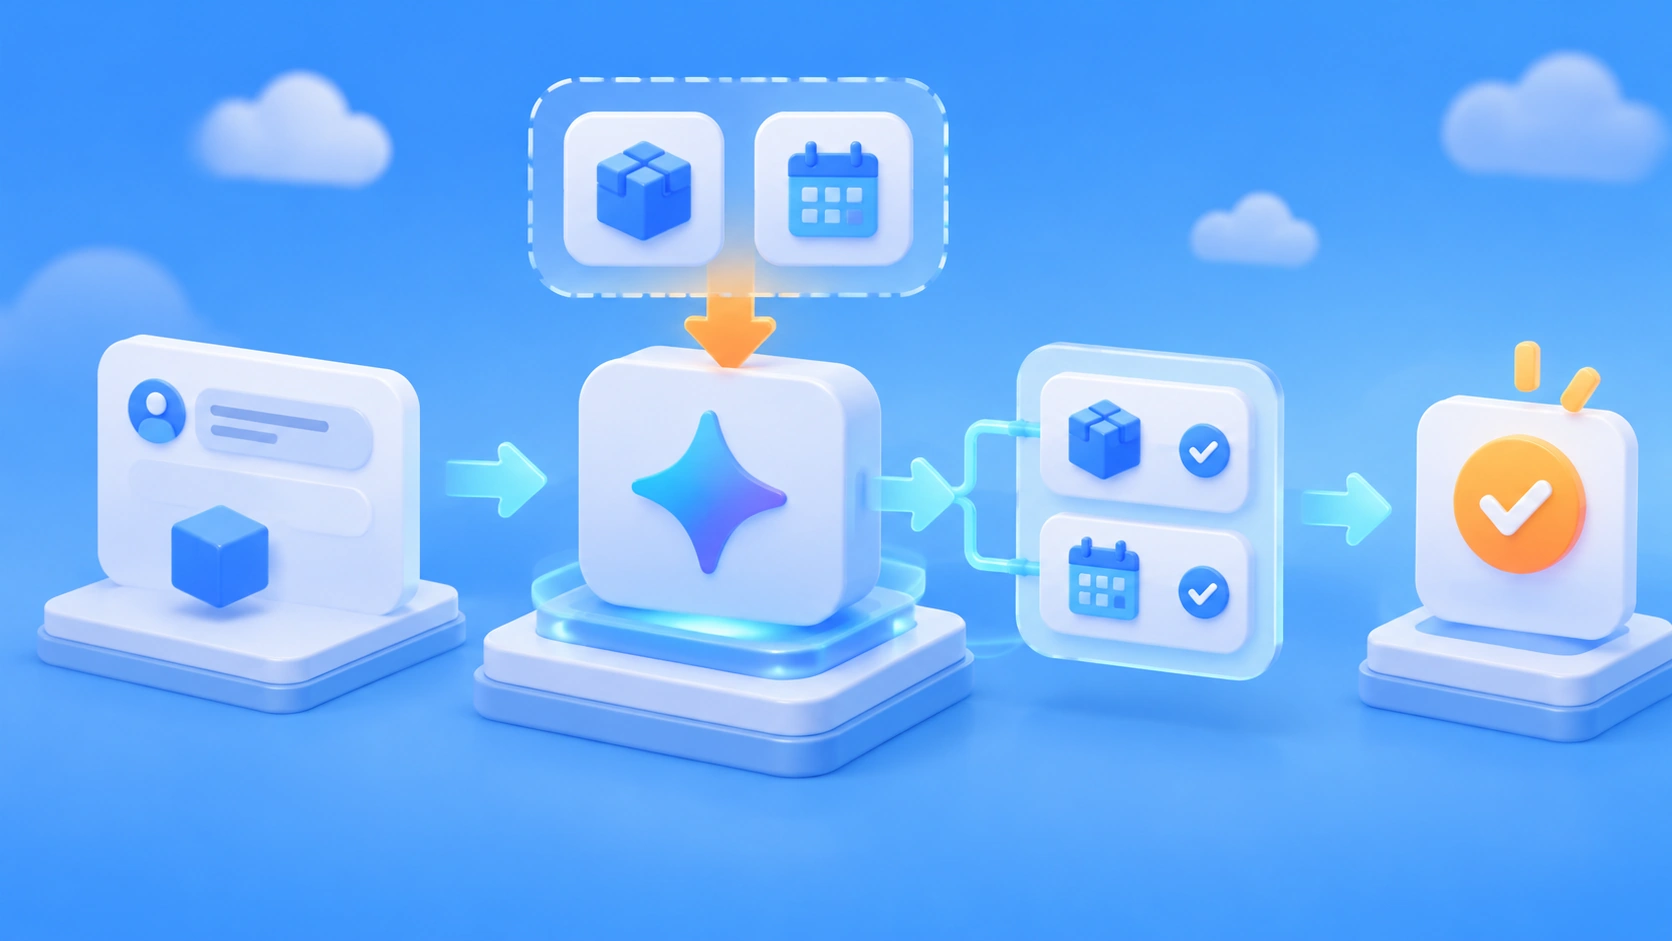
接入 Gemini Tool Retrieval 需要做三件事。第一,在 tools 數組裏加入 {"type": "tool_search"},並給低頻業務函數設置 defer_loading: True。第二,用 v1beta 版本的 Interactions API 發起請求,然後從 interaction.steps 裏找到 function_call。第三,在本地執行函數,按 call_id 構造 function_result,再帶上完整 tools 數組回傳。整個過程不需要自己寫工具搜索器,服務端會完成工具檢索和參數 Schema 裝載。
需要先說清楚:Tool Retrieval 只改變“工具參數定義什麼時候進入模型上下文”,函數仍然要由開發者執行。 它也不保證一定省錢。工具少、上下文長的場景,Token 消耗反而可能上升。
您讀完此文能瞭解到什麼?
- Gemini Tool Retrieval 支持哪些模型、需要哪個 SDK 版本,以及爲什麼必須顯式指定
v1beta - 一份變量名前後一致的 Python 完整示例:庫存與訂單兩個延遲工具,從檢索到最終回答
tool_search_call、tool_search_result、function_call、function_result分別由誰處理- 遠程 MCP 延遲加載、客戶端檢索與自建 Tool Registry 三條擴展路線的區別
- HTTP 400 等常見錯誤的集中排查方法,以及啓用前如何判斷是否划算
索引:先用 To Know 表格解釋核心字段,再用“影響速覽”說明這項預覽功能對不同角色意味着什麼。“客觀事實”部分按接入順序展開:準備環境、定義工具、觀察檢索步驟、回傳函數結果,最後擴展到 MCP 和客戶端檢索,錯誤排查集中放在這一部分末尾。“分析判斷”部分結合 Google 給出的兩組假設性算例,討論 Tool Retrieval 適合和不適合的場景。
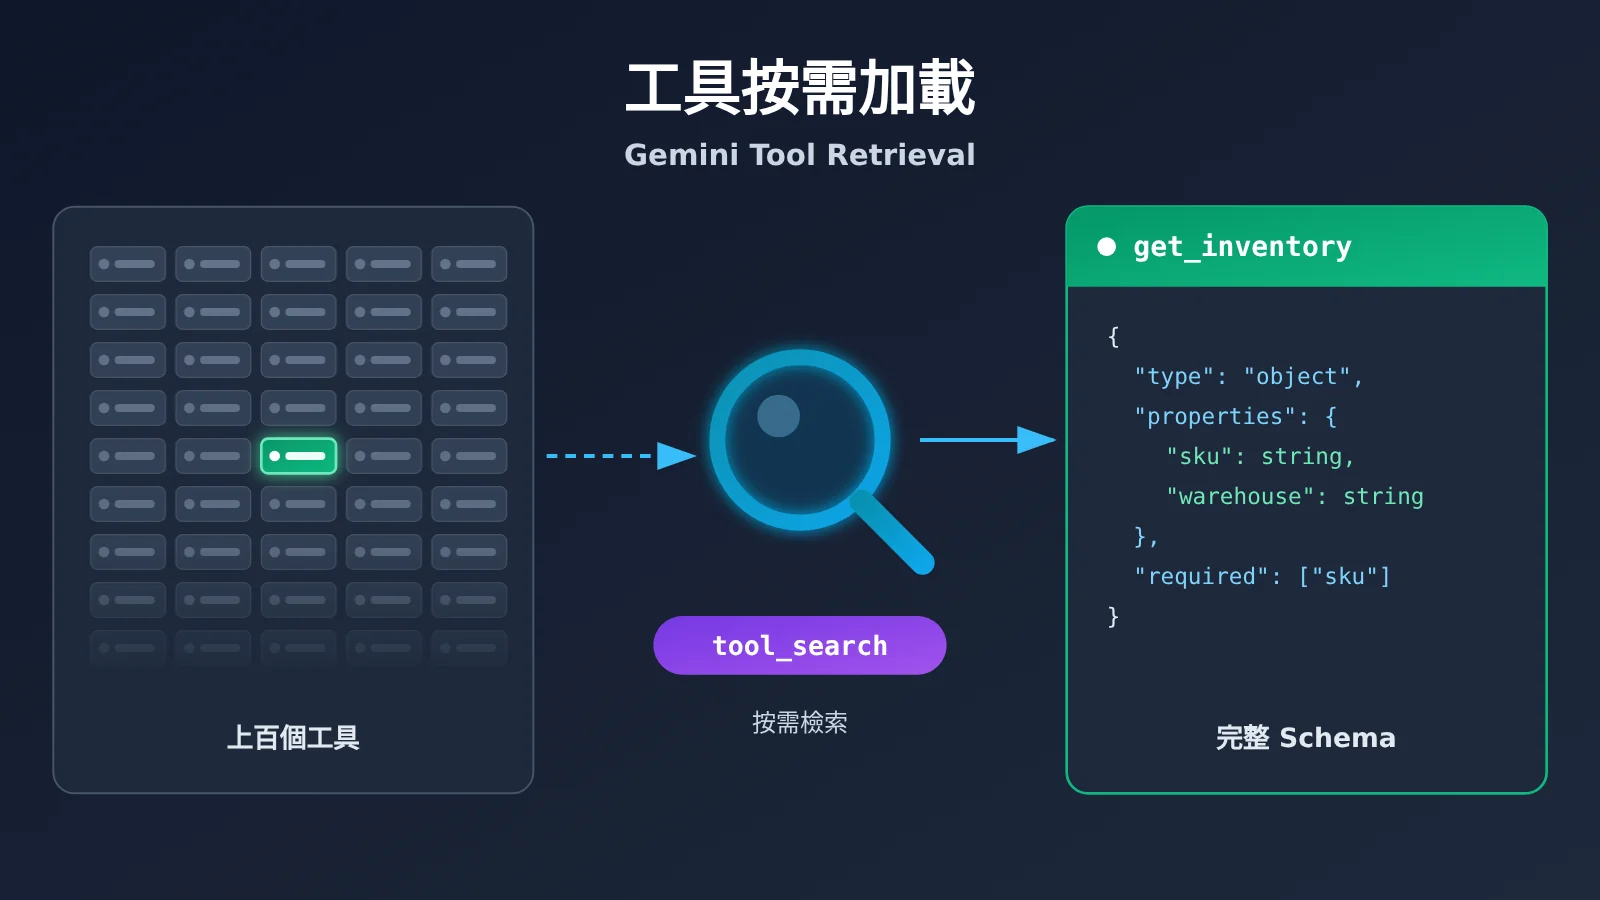
Gemini Tool Retrieval 關鍵概念(To Know)
| 概念 | 簡要解釋 |
|---|---|
| google-genai | Google 官方 Python SDK 包名,導入方式爲 from google import genai |
| v1beta | 預覽接口版本,Tool Retrieval 必須使用,本文在客戶端初始化時顯式指定 |
| Interactions API | Google 面向 Agent 工作流的接口,支持有狀態對話和可觀察的執行步驟 |
tool_search |
聲明啓用工具檢索的特殊工具類型,單個請求最多一個 |
defer_loading |
讓指定函數或 MCP 服務器的完整參數定義延遲進入模型上下文 |
short_description |
模型最初能看到的延遲函數簡述,只能用於延遲函數 |
tool_search_call |
服務端檢索流程中由模型發起的搜索步驟 |
tool_search_result |
服務端返回匹配工具完整 Schema 的步驟 |
function_call |
模型要求開發者代碼執行某個函數,並給出參數 |
function_result |
應用把函數執行結果交還給模型時使用的輸入類型 |
call_id |
把函數執行結果與原始 function_call.id 對應起來的標識 |
previous_interaction_id |
讓後續請求接續服務端已保存交互記錄的標識 |
signature |
無狀態會話回放歷史步驟時,需要隨原步驟一起原樣傳回的簽名字段 |
Gemini Tool Retrieval 影響速覽
| 人羣 | 實際影響 |
|---|---|
| Agent 開發者 | 工具多的 Agent 可以把長尾工具延遲加載,不必自建向量檢索,但要改用 Interactions API |
| 已用 generateContent 的團隊 | 舊方法不支持 Tool Retrieval,需要遷移接口和返回結構解析 |
| MCP 集成方 | 可以在 mcp_server 層整體設置 defer_loading,不用逐個聲明工具 |
| 成本負責人 | 沒有單獨的功能費,但每次服務端搜索都會產生額外的計費模型調用,需要盯住 total_tool_use_tokens |
| 小工具庫項目 | 十幾個工具、長上下文的場景未必划算,靜態加載可能更省 |
Gemini Tool Retrieval 客觀事實:發佈信息與接入流程
Gemini Tool Retrieval 發佈狀態與支持模型
2026 年 11 月 19 日(北京時間 11 月 20 日凌晨),Google 在官方博客發佈《Introducing Tool Retrieval in the Gemini API》,在 Interactions API 中開放 Tool Retrieval 預覽。作者是 Gemini API 產品經理 Lucia Loher 和 Google DeepMind 研究科學家 Nora Kassner。目前功能處於 Preview 狀態,正式發佈前接口可能調整。
公告的表述比較寬泛:“Gemini 3.6 及更新模型,包括所有 Gemini 4 模型”。但開發文檔截至 2026 年 11 月 20 日只明確列出了 4 個模型 ID:gemini-4-hydrogen、gemini-4-argon、gemini-3.8-flash、gemini-3.6-flash。接入時應以文檔名單爲準。對不支持的模型設置 defer_loading,會直接返回 HTTP 400。
Gemini Tool Retrieval 接入前準備:SDK 與 v1beta
Google 官方 Python SDK googleapis/python-genai 於 2026 年 11 月 18 日發佈 v3.6.0,新增了 Tool Retrieval 和函數結果相關的公共 Schema。安裝命令如下:
pip install -U "google-genai>=3.6.0"
export GEMINI_API_KEY="your-key"   # 不要把真實密鑰寫進代碼
版本號有一個容易踩的坑。SDK 從 v3.0.0 起,Gemini Developer API 客戶端默認使用 v1,而 Tool Retrieval 要求 v1beta,所以初始化時必須顯式指定:
from google import genai

client = genai.Client(
    http_options={"api_version": "v1beta"}
)
SDK 會從環境變量 GEMINI_API_KEY 讀取憑據。如果使用 REST,對應的 Endpoint 是 POST https://generativelanguage.googleapis.com/v1beta/interactions,鑑權頭爲 x-goog-api-key。
第一步:用 tool_search 和 defer_loading 定義 Gemini 工具
演示場景只有兩個業務工具:get_inventory 查詢商品庫存,get_order_status 查詢訂單狀態,兩者都設置爲延遲加載。tools 數組裏各字段的分工如下:
{"type": "tool_search"}:開啓服務端檢索,默認execution爲server。沒有它就設置defer_loading,會報defer_loading requires tool_search。defer_loading: True:完整parameters不進入初始上下文,模型一開始只看到名稱和簡述。short_description:初始列表中的簡述。不填時取description的第一句。在非延遲函數上填寫會被判定爲非法。parameters:仍然必須完整提交。延遲的是 Schema 進入模型上下文的時機,服務端仍然需要拿到完整定義。
什麼工具適合延遲?Google 的建議是混合使用:高頻工具保持直接加載,低頻、專業化的長尾工具延遲加載。另外,系統指令裏會直接點名的工具不要設爲延遲。否則模型可能繞過搜索直接調用,導致缺少加載上下文而出錯。名稱相近的工具建議加上業務命名空間,例如用 billing_get_customer 和 crm_get_customer 區分,不要都叫 get_customer。
第二步:發送請求並觀察 Gemini 工具檢索步驟
下面是完整的演示代碼。庫存“12 件”、訂單狀態 demo_pending 都是本地模擬數據,不會查詢真實系統。運行代碼需要有效的 Gemini API Key 和模型訪問權限。
import json
from google import genai

MODEL = "gemini-4-hydrogen"

client = genai.Client(
    http_options={"api_version": "v1beta"}
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "short_description": "Check product inventory by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    },
    {
        "type": "function",
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "short_description": "Check an order's current status.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"]
        }
    }
]

def execute_demo_tool(name, arguments):
    """本地模擬業務函數,不查詢真實庫存或訂單。"""
    if name == "get_inventory":
        return {"sku": arguments["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": arguments["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(f"Unknown tool: {name}")

# 第一次請求:由模型發現並選擇需要的工具
interaction = client.interactions.create(
    model=MODEL,
    input="查詢商品 SKU-42 的可用庫存。",
    tools=tools
)

print("執行步驟:")
for step in interaction.steps:
    print(step.type, getattr(step, "name", ""))
打印出的 interaction.steps 一般按以下順序出現。具體順序和檢索結果由模型決定,一輪裏也可能發生多次搜索。
tool_search_call:模型發現手頭沒有合適的已加載工具,發起服務端搜索。tool_search_result:API 返回匹配的get_inventory完整參數 Schema。function_call:模型讀取 Schema 後,生成get_inventory(sku="SKU-42")這樣的調用。
這三步發生在同一次外部 API 請求中,應用不需要另寫搜索器,也不用再發一次檢索請求。前兩步只需觀察和記錄,不要在本地重複執行搜索。但“同一次請求”不等於“只跑一次推理”:每次服務端搜索都會觸發額外的模型調用,這部分 Token 照常計費。調試時還有一點要注意:不能只看 interaction.status。即使狀態不是 requires_action,steps 裏也可能包含待執行的 function_call。
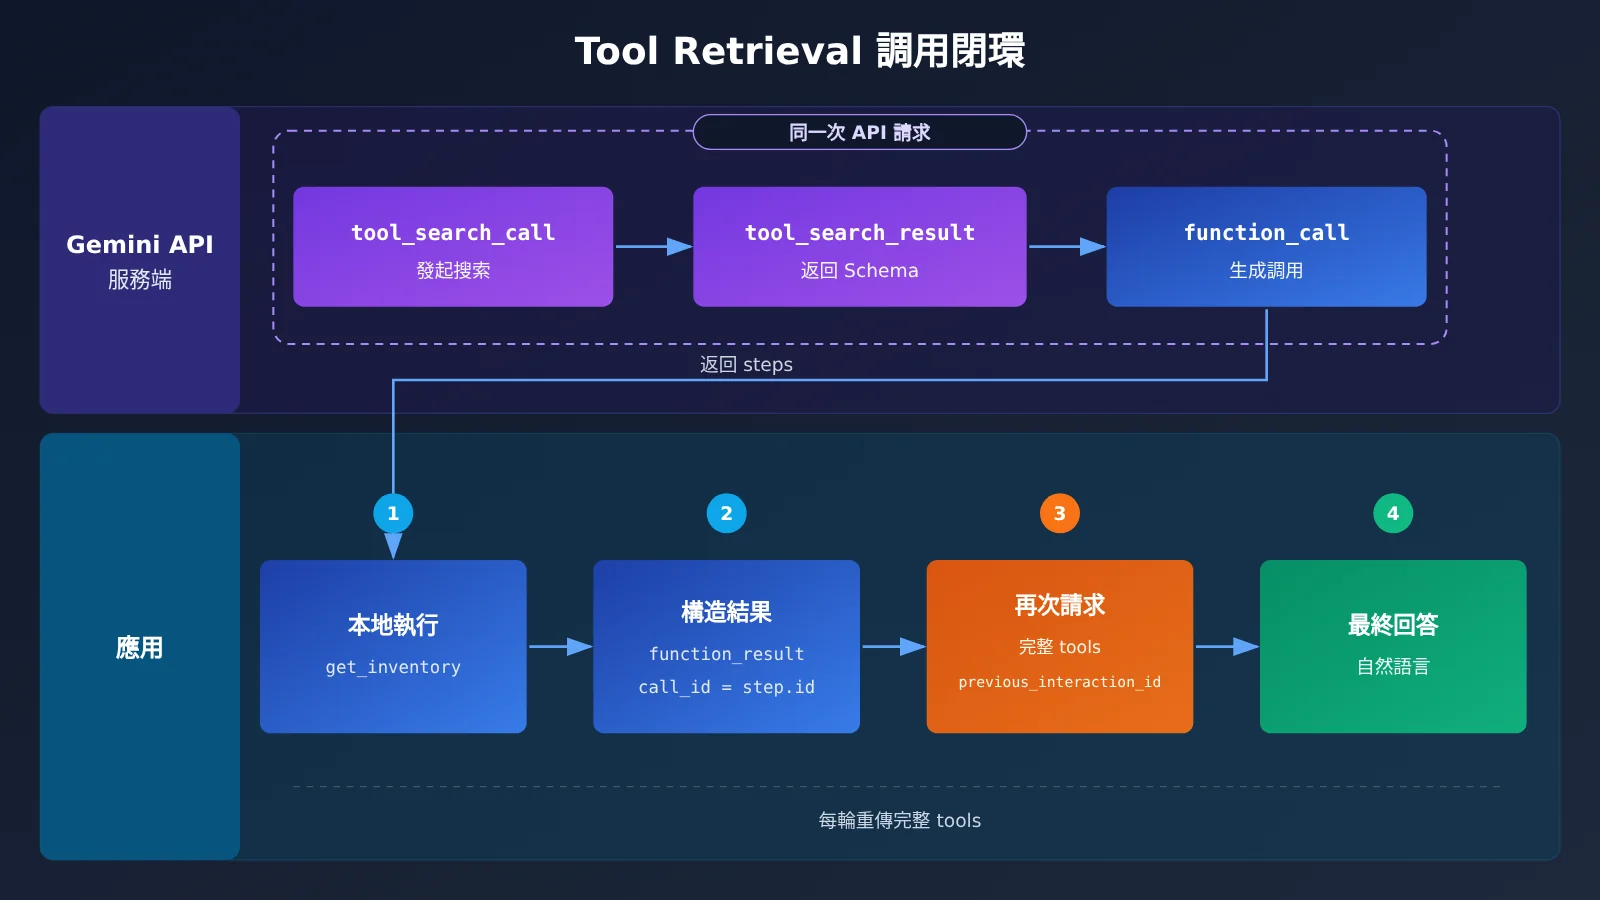
第三步:執行函數並回傳 function_result
Tool Retrieval 只負責找到工具和裝載參數,真正的業務函數仍由應用執行,這部分沿用標準的 Function Calling 機制。接着上面的代碼繼續寫:
# 只執行真正的業務函數調用,不在應用側執行 tool_search_call
function_results = []

for step in interaction.steps:
    if step.type != "function_call":
        continue
    result = execute_demo_tool(step.name, step.arguments)
    function_results.append({
        "type": "function_result",
        "name": step.name,
        "call_id": step.id,
        "result": [{"type": "text", "text": json.dumps(result, ensure_ascii=False)}]
    })

# 將本地函數結果送回 Gemini
if function_results:
    followup = client.interactions.create(
        model=MODEL,
        previous_interaction_id=interaction.id,
        tools=tools,
        input=function_results
    )
    print("最終回答:", followup.output_text)
else:
    print("當前回答:", interaction.output_text)
這段代碼有三處需要注意。第一,call_id 必須取自原始 function_call 的 step.id。一輪裏有多個調用時,模型靠它對應每個結果。第二,previous_interaction_id=interaction.id 讓服務端接續已保存的交互記錄,包括已經檢索過的工具。第三,第二輪仍要傳入整個 tools 數組。API 會保留步驟歷史,但不會保留工具聲明,tool_search、所有延遲和非延遲工具、MCP 配置每輪都要重新提交。
這個示例只演示一次函數調用閉環,沒有包含通用的多輪 Agent 調度器。如果 followup 裏還有 function_call,按同樣的方式繼續處理即可。
🎯 技術建議:Tool Retrieval 本身依賴 Google 官方的
v1betaInteractions API。如果你想先用標準 Function Calling 跑通業務函數、對比不同模型選工具和填參數的表現,可以在 API易 apiyi.com 用同一個 Key 切換 Gemini、Claude、GPT 等模型做基線測試。
擴展:遠程 MCP 與 Gemini 客戶端檢索
遠程 MCP 服務器可以在服務器這一層設置延遲加載,它暴露的工具會按需裝載:
mcp_tools = [
    {"type": "tool_search"},
    {
        "type": "mcp_server",
        "name": "weather_service",
        "url": "https://gemini-api-demos.uc.r.appspot.com/mcp",
        "defer_loading": True
    }
]
和自定義函數不同,遠程 MCP 工具由 API 代爲執行,steps 中出現的是 mcp_server_tool_call 和 mcp_server_tool_result,應用不需要回傳結果。官方文檔目前沒有給出“最大可延遲工具數”。
如果企業已經有自己的工具註冊表、向量檢索或用戶級權限過濾,可以改用客戶端檢索:設置 "execution": "client",並提供完整的 name、description 和 parameters。這時第一輪返回的是對 search_tool_registry 的普通 function_call。應用檢索後,在 function_result.result 中返回完整工具聲明對象數組,不要序列化成一個 JSON 字符串。客戶端模式不使用 defer_loading,並且同一請求不能混用兩種模式。
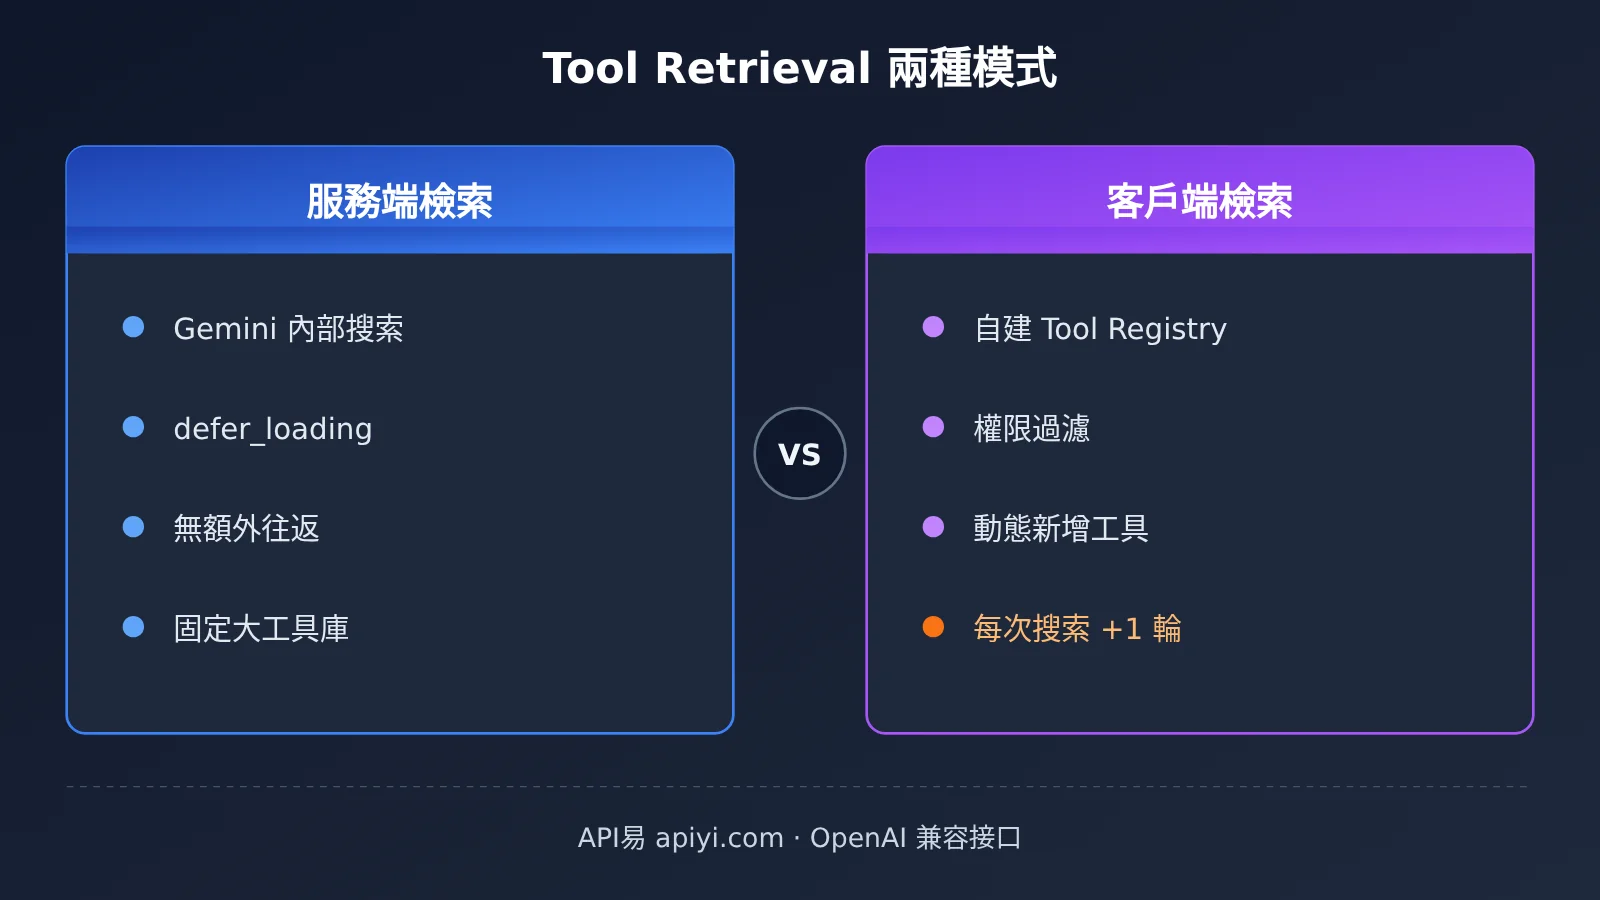
| 維度 | 服務端檢索 | 客戶端檢索(Gemini) | 自建 Tool Registry(通用方案) |
|---|---|---|---|
| 檢索執行方 | Gemini API | 開發者應用 | 開發者應用 |
| 關鍵配置 | tool_search + defer_loading |
tool_search + execution: client |
普通 Function Calling |
| 是否要提前聲明全部工具 | 需要 | 不需要 | 不需要 |
| 額外網絡往返 | 無 | 每次搜索 +1 輪 | 每次搜索 +1 輪 |
| 動態新增工具 | 不便 | 支持 | 支持 |
| 典型場景 | 大型、相對固定的工具庫 | 多租戶、私有註冊表 | 跨模型複用、多廠商切換 |
| 可用平臺 | Google 官方 v1beta | Google 官方 v1beta | API易 apiyi.com 等 OpenAI 兼容接口 |
最後一列不是 Gemini Tool Retrieval,而是一種思路相近的工程實現:先只暴露一個搜索函數,檢索命中後再把對應 Schema 加進 tools。它適合需要在多家模型之間切換的團隊。最小寫法如下:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)
MODEL = "your-model-name"  # 以平臺模型列表爲準

search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}
查看自建 Tool Registry 的完整兩段式調用
import json, os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"
)
MODEL = "your-model-name"  # 以平臺模型列表爲準

TOOL_REGISTRY = {
    "get_inventory": {"type": "function", "function": {
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "parameters": {"type": "object", "properties": {"sku": {"type": "string"}}, "required": ["sku"]}}},
    "get_order_status": {"type": "function", "function": {
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "parameters": {"type": "object", "properties": {"order_id": {"type": "string"}}, "required": ["order_id"]}}},
}
search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools (inventory, orders) by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}

def search_registry(query):
    q = query.lower()
    return [name for name, t in TOOL_REGISTRY.items()
            if any(w in t["function"]["description"].lower() for w in q.split())]

def execute_demo_tool(name, args):
    if name == "get_inventory":
        return {"sku": args["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": args["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(name)

messages = [{"role": "user", "content": "查詢商品 SKU-42 的可用庫存。"}]
tools = [search_tool]

for _ in range(4):  # 簡單循環上限,防止死循環
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    if not msg.tool_calls:
        print("最終回答:", msg.content)
        break
    messages.append(msg)
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        if call.function.name == "search_tool_registry":
            names = search_registry(args["query"])
            tools += [TOOL_REGISTRY[n] for n in names if TOOL_REGISTRY[n] not in tools]
            content = json.dumps({"loaded_tools": names})
        else:
            content = json.dumps(execute_demo_tool(call.function.name, args), ensure_ascii=False)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": content})
💡 選擇建議:註冊表路線的檢索質量取決於你的搜索函數,示例中的關鍵詞匹配只用於演示。在 API易 apiyi.com 上切換模型跑同一組任務,比較“是否搜到正確工具”和“參數是否填對”,就能看出哪個模型更適合你的工具庫。
Gemini Tool Retrieval 常見錯誤集中排查
| 現象 | 原因 | 處理 |
|---|---|---|
defer_loading requires tool_search |
聲明瞭延遲函數,但沒有服務端 tool_search |
在 tools 中加入 {"type": "tool_search"} |
short_description 不合法 |
寫在了非延遲函數上 | 只給 defer_loading=True 的函數使用 |
| HTTP 400 unsupported model | 模型不在支持名單內 | 改用文檔列出的 4 個模型 ID |
| 請求不生效或報版本錯誤 | SDK 默認走 v1,或調用了 generateContent |
顯式設置 api_version="v1beta" 並改用 Interactions API |
| 第二輪 HTTP 400 | store=False 時遺漏檢索步驟或 signature |
原樣回放 tool_search_call/result 及所有簽名 |
| 模型誤用舊工具、工具不可用 | 後續請求漏傳 tools |
每輪重新提交完整 tools 數組 |
| 檢索後參數爲空 | 延遲工具只提交了名稱和簡述 | 延遲工具也要提交完整 parameters |
| 客戶端檢索配置失敗 | 缺少 name、description 等字段 |
補全客戶端搜索函數定義 |
無狀態模式(store=False)需要單獨說明。這時不能依賴 previous_interaction_id,應用要自行保存並按原樣回放用戶輸入、tool_search_call、tool_search_result、function_call、function_result 以及所有 signature。刪改其中任何一步,服務端都可能無法重建檢索上下文。另外,服務端沒搜到匹配工具時,可能直接返回一段文本,而不是結構化錯誤。所以“請求沒報錯”不等於“檢索成功”,驗證時應逐項檢查 steps 裏是否出現了預期的檢索步驟和函數調用。
Gemini Tool Retrieval 分析判斷:什麼時候值得接入
判斷一:收益取決於工具庫規模和上下文長度,不是開啓就省錢。 Google 文檔給了兩組方向相反的假設性算例,並明確說明它們不是生產 Benchmark。第一組是 200 個工具、每個 400 Tokens、基礎上下文 2,000 Tokens、請求 2 次,靜態加載約 164,000 Tokens,Tool Retrieval 約 23,650 Tokens,按此推算下降約 85.6%。第二組是 10 個工具、基礎上下文 30,000 Tokens,靜態加載 68,000 Tokens,Tool Retrieval 反而達到 92,830 Tokens,增加約 36.5%,原因是額外的搜索推理要重新處理整段長上下文。Google 的工程建議是:少於約 20 個穩定工具時,靜態加載通常就夠了。
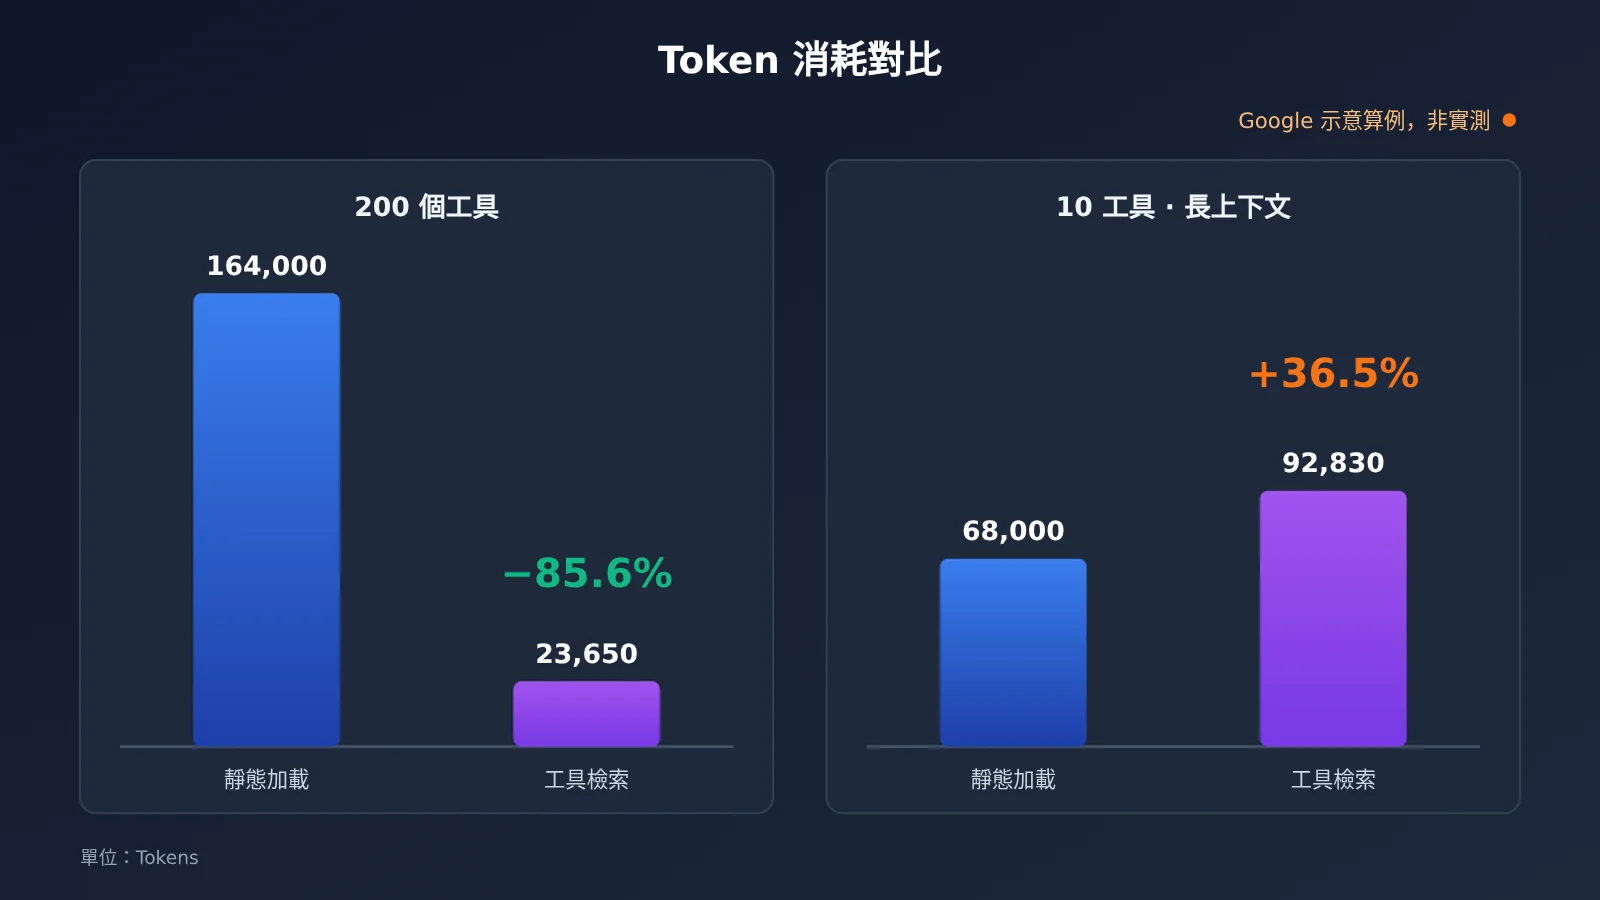
判斷二:評估成本要看 total_tool_use_tokens,不能只看首輪輸入。 官方早期測試中,每個延遲工具的簡述平均約佔 26 Tokens,100 個工具大約是 2,600 Tokens,這是近似值。真正需要盯住的是搜索引發的額外模型調用,以及已加載 Schema 在會話中的累積。當前文檔沒有提供卸載已檢索工具的機制,長會話中檢索的工具越多,上下文就越大。緩存也不是無條件受益:初始提示詞變短後,可能低於隱式緩存的最低門檻。
判斷三:按需工具加載已經成爲行業共識,但各家數據不能橫向套用。 Anthropic 在 2025 年 11 月推出 Tool Search Tool,OpenAI 在 2026 年 3 月隨 GPT-5.4 推出 Tool Search,兩家都公佈過各自條件下的實測節省數據。Google 這次只給出了假設性算例。截至 2026 年 11 月 20 日,還沒有可覈驗的 Gemini Tool Retrieval 獨立生產實測。因此,“Gemini 實測省 85%”之類的說法目前都站不住。
對開發者的建議:先把現有 Agent 的工具按調用頻率分層,高頻工具直接加載,長尾工具延遲加載;再用同一批任務對比靜態加載和 Tool Retrieval 的總 Token、端到端耗時、選對工具的比例和參數正確率。功能仍處於預覽階段,正式發佈時間未定,生產環境中最好保留一條回退到靜態加載的開關。在模型選型階段,可以先借助 API易 apiyi.com 的統一接口低成本跑通標準 Function Calling 基線,再遷移到官方 v1beta 驗證 Tool Retrieval 的淨收益。
工具越多,越要先想清楚每把工具什麼時候拿出來。正如《論語·衛靈公》所言:“工欲善其事,必先利其器。”
📚 參考資料
-
Introducing Tool Retrieval in the Gemini API:Google 官方發佈公告
- 鏈接:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - 說明: 發佈日期、設計目標、MCP 與兩種檢索模式
- 鏈接:
-
Tool retrieval 官方文檔:配置、限制、計費與算例
- 鏈接:
aistudio.google.com/docs/tool-retrieval - 說明: 本文代碼、錯誤規則、無狀態回放和 Token 算例的主要依據
- 鏈接:
-
Function Calling 官方文檔:函數執行與結果回傳
- 鏈接:
aistudio.google.com/docs/function-calling - 說明:
function_result與call_id的標準用法
- 鏈接:
-
Interactions API 官方文檔:接口結構與執行步驟
- 鏈接:
aistudio.google.com/docs/interactions-overview - 說明: 有狀態對話、steps 與 generateContent 的區別
- 鏈接:
-
python-genai v3.6.0 / v3.0.0 Release:SDK 版本記錄
- 鏈接:
github.com/googleapis/python-genai/releases - 說明: Tool Retrieval Schema 支持與默認 API 版本變化
- 鏈接:
作者:APIYI 技術團隊
技術交流:多模型 Function Calling 對比測試可訪問 API易 apiyi.com,更多接入資料見 docs.apiyi.com 文檔中心