作者注:把 GPT-6.2 Sol 和 Claude Fable 5.2 的第三方綜合分、官方標價、緩存讀和單項對照分開梳理,說明哪些數字能直接比,哪些不能用一個“誰更強”概括。
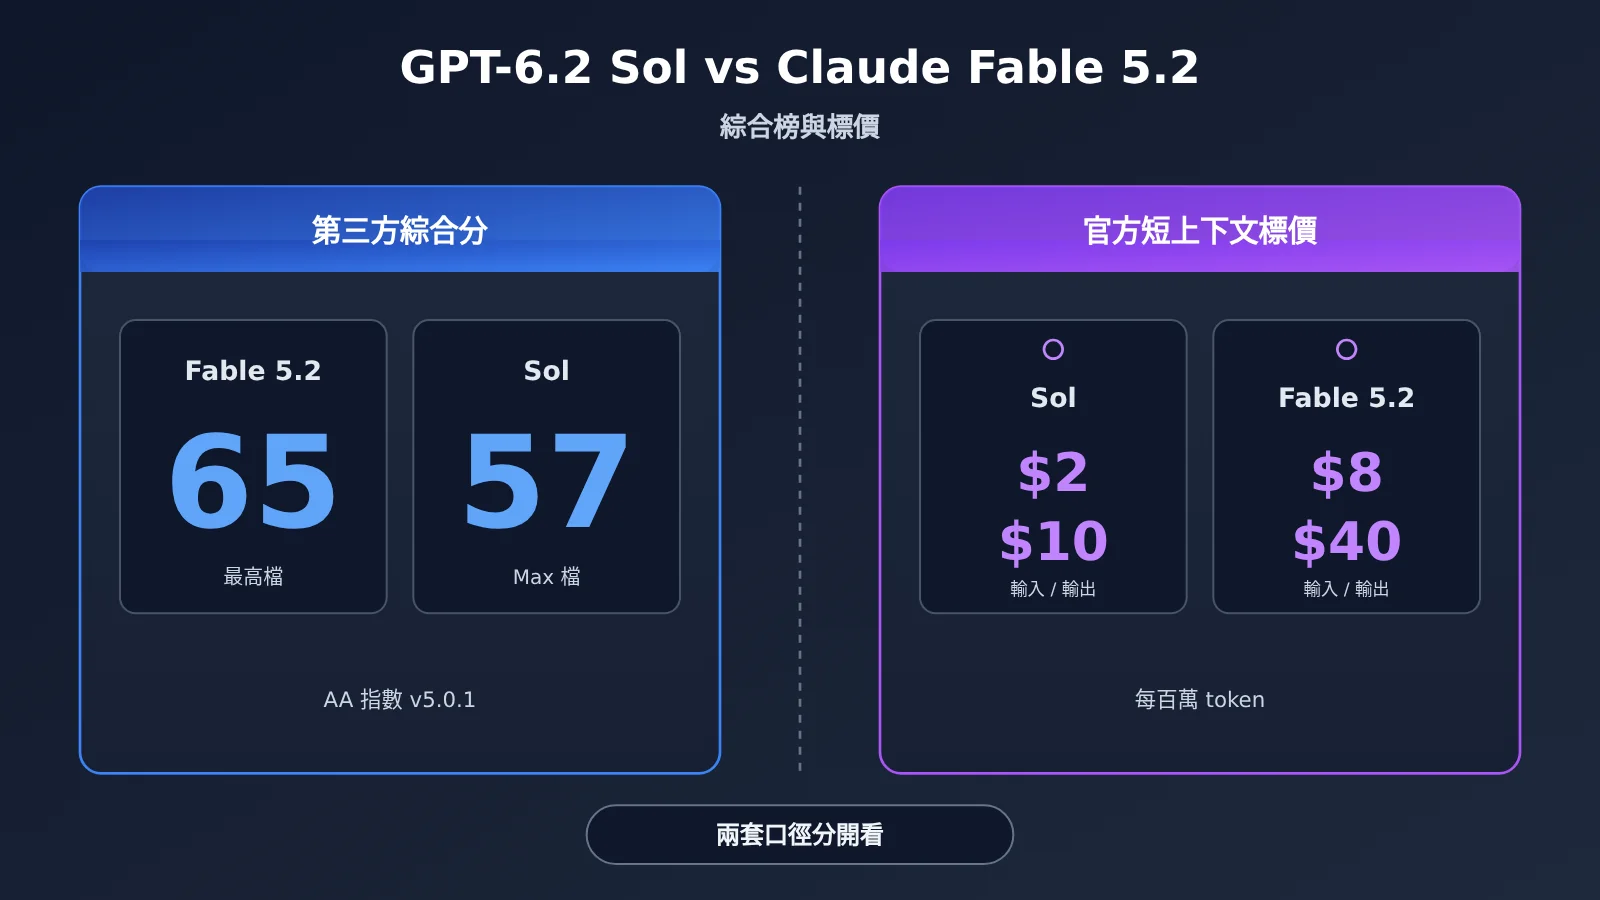
把 GPT-6.2 Sol 和 Claude Fable 5.2 放在一起比較時,最容易出的錯是用一個“誰更強”把所有數字蓋住。2026-11-17 OpenAI 發佈 GPT-6.2 Astra 和 GPT-6.2 Sol,第三方機構 Artificial Analysis 當天更新了綜合榜:Claude Fable 5.2 最高推理檔 65 分,GPT-6.2 Sol 的 Max 檔 57 分。另一方面,按兩家官方的短上下文標價,Sol 的輸入和輸出單價都是 Fable 的四分之一。
分差大,價差也大,兩件事都成立,但不能互相抵消,也不能合併成一個結論。這不是一篇替你選邊的文章。官方自報、第三方榜單和廠商標價屬於三套口徑,本文逐層拆開,並單獨列出哪些單項其實沒有 Sol 對 Fable 的直接官方對照。
核心價值:讀完本文,你會拿到綜合分、標價、緩存讀三組可覈對的數字,知道哪些單項不能拿來做 Sol 對 Fable 的比較,並能按自己的任務決定先查哪一側的數據。
GPT-6.2 Sol 和 Claude Fable 5.2 核心要點
下面這張表先給出結論層面的數字,每一行都註明口徑。後面的章節會逐行展開。
| 要點 | 數字 | 口徑與讀法 |
|---|---|---|
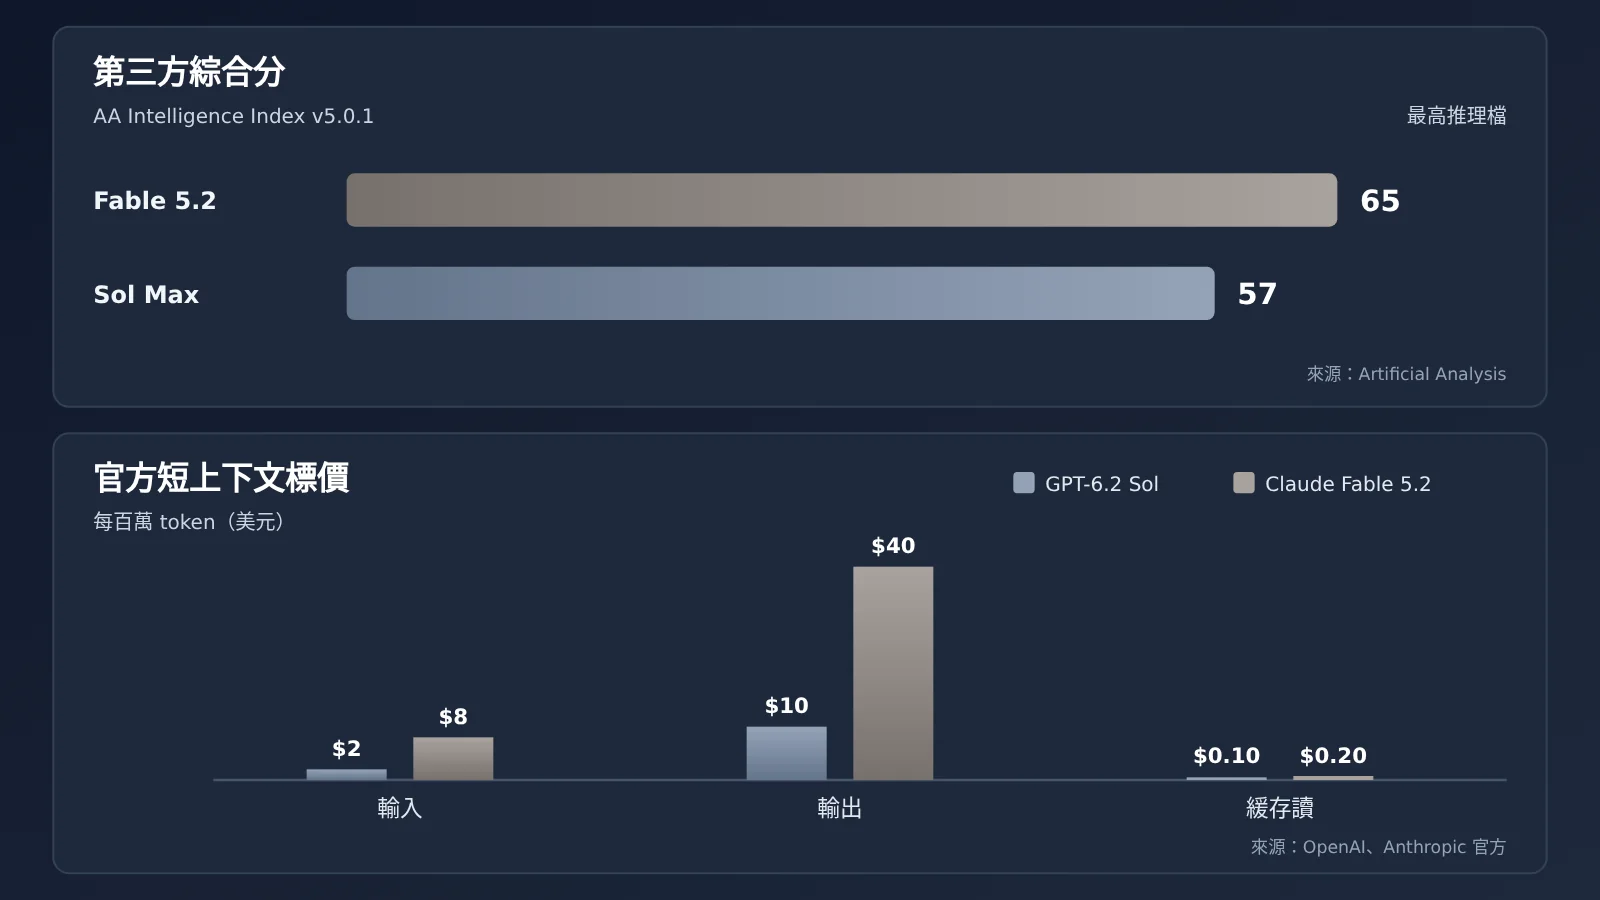
| 綜合分 | Fable 5.2 爲 65,Sol(Max)爲 57 | 第三方 Artificial Analysis Intelligence Index v5.0.1,各自最高推理檔 |
| 短上下文輸入/輸出標價 | Sol $2 / $10,Fable $8 / $40(每 100 萬 token) | 兩家官方標價,Sol 是 Fable 的四分之一,只限這兩項 |
| 緩存讀標價 | Sol $0.10,Fable $0.20 | 官方標價,Sol 是 Fable 的一半,不是四分之一 |
| 官方材料裏的直接對照 | AA-3D 人工盲評 Elo:Sol 1259,Fable 1271 | 官方轉述;其餘官方單項多爲 Astra 對 Fable,或 Sol 對自家舊型號 |
| API易在架情況 | claude-fable-5-2 已在架;gpt-6.2-sol 未在架 |
以平臺型號列表爲準 |
關於表中 GPT-6.2 Sol 的標價:以上是 OpenAI 官方標價,暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。
GPT-6.2 Sol 與 Claude Fable 5.2 的比較爲什麼要分層
綜合指數把幾十項任務壓縮成一個分數,適合回答“整體水平大致在哪一檔”,但回答不了“我這個任務誰更合適”。標價回答的是每百萬 token 多少錢,不等於完成一項任務要花多少錢,因爲兩邊的推理檔、思考 token 數量、緩存命中率都會改變實際賬單。
單項任務又是第三層。OpenAI 發佈文裏提到 Fable 的單項,比較的對象大多是 GPT-6.2 Astra,而不是 Sol。把 Astra 的成績挪給 Sol,是這類比較裏最常見的誤讀,本文會專門把它們分開。
GPT-6.2 Sol 對比 Claude Fable 5.2:核心差異
GPT-6.2 Sol 與 Claude Fable 5.2 的第三方綜合分
Artificial Analysis 是第三方評測機構,下面這組數字不是 OpenAI 或 Anthropic 的自報。它在 Intelligence Index v5.0.1 上給每個模型按推理檔分別打分,比較時要寫清楚用的是哪一檔。
| 模型 | 推理檔 | Intelligence Index v5.0.1 | 綜合指數單任務成本(各自模型頁) |
|---|---|---|---|
| Claude Fable 5.2 | 最高推理檔 | 65(榜單第一) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00(Max) |
| Gemini 4 Carbon | 最高檔 | 60 | — |
| Claude Opus 5.5 | 最高檔 | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
按 Artificial Analysis 的說法,Sol 比 GPT-6.1 Sol 高 2 分,到 57 分,與 GPT-6 Astra 持平,單任務成本約爲後者的 15%。表裏的“單任務成本”是第三方跑這套指數時的花費,反映推理檔、思考長度和標價的綜合結果,不是 API 標價。
需要注意的是,OpenAI 官方說 Astra 在 Agents’ Last Exam 上的成本約爲 Fable 的 5%,那是另一套任務。不能拿 $26.54 和官方的“5%”互相換算,也不能把它套到 Sol 頭上。
GPT-6.2 Sol 與 Claude Fable 5.2 的官方標價和緩存
先說 GPT-6.2 Sol。OpenAI 模型頁的標準檔短上下文標價爲:輸入 $2,緩存讀 $0.10,緩存寫入(保留 30 分鐘)$2.50,12 小時緩存寫入 $5,輸出 $10。暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。發佈文說明 Sol 沿用 GPT-6.1 Sol 的 API token 價。
Claude Fable 5.2 的 Anthropic 文檔標價爲:輸入 $8,輸出 $40,5 分鐘緩存寫入 $10,1 小時緩存寫入 $16,緩存讀 $0.20。API易(apiyi.com)模型總表裏,claude-fable-5-2 和 claude-fable-5-2-thinking 列出的輸入、輸出、緩存讀爲 $8 / $40 / $0.2,與官方一致;兩個型號的說明頁目前返回 404,價格以總表爲準。
| 計價項(每 100 萬 token) | GPT-6.2 Sol(OpenAI 官方) | Claude Fable 5.2(Anthropic 官方) | 兩者關係 |
|---|---|---|---|
| 輸入(短上下文) | $2 | $8 | 四分之一 |
| 輸出(短上下文) | $10 | $40 | 四分之一 |
| 緩存讀 | $0.10 | $0.20 | 一半 |
| 緩存寫入 | 30 分鐘 $2.50;12 小時 $5 | 5 分鐘 $10;1 小時 $16 | 保留時長不同,不宜直接相除 |
| Batch | 標準價 50% | 輸入、輸出五折 | 規則接近 |
| 加速檔 | Fast 爲標準價 2 倍;Ultrafast 到 2027-02-28 爲 3 倍,2027-03-01 起 6 倍 | Fast mode 輸入 $16、輸出 $80,最高約 2.5 倍速 | 機制不同 |
表中 GPT-6.2 Sol 各項爲 OpenAI 官方標價。暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。
“Sol 是 Fable 的四分之一”只在短上下文的輸入和輸出上成立。OpenAI 模型頁還有一條規則:單次請求輸入超過 272K token 時,輸入和緩存單價加倍,輸出按短上下文的 1.5 倍計,而且按整單計算。這時 Sol 的輸出單價不再是 $10,用四分之一去估算就會出錯;Fable 一側的長上下文計價,請以 Anthropic 文檔爲準。
GPT-6.2 Sol 與 Claude Fable 5.2 的規格和接口
兩款模型的上下文都在百萬量級,最大輸出都是 128K。差別在輸入模態、推理開關和接口上,這些會影響集成方式。
| 項目 | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| 上下文 / 最大輸出 | 1,050,000(最大輸入 922,000)/ 128,000 | 1M / 128K |
| 輸入 / 輸出 | 文本、圖像 / 文本 | 以 Anthropic 文檔爲準 |
| 知識截止 | 2026-06-01 | 2026-06 |
| 推理設置 | API 不允許把 reasoning effort 設爲 none | 默認 effort 爲 high,思考開啓且不能關閉 |
| 官方端點 | Chat Completions、Responses、Batch | Anthropic API |
| API易 | 未在架 | claude-fable-5-2、claude-fable-5-2-thinking,端點 chat、messages |
在 API易 調用已在架的 Fable 時,OpenAI 兼容方式的 base URL 是 https://api.apiyi.com/v1,型號填 claude-fable-5-2;如果項目本身走 Anthropic Messages 協議,也可以使用平臺的 messages 端點。分組方面,總表列出 ClaudeCode、Claude_Reverse、Claude_Enterprise、Default、SVIP。
GPT-6.2 Sol 與 Claude Fable 5.2 單項任務分開看
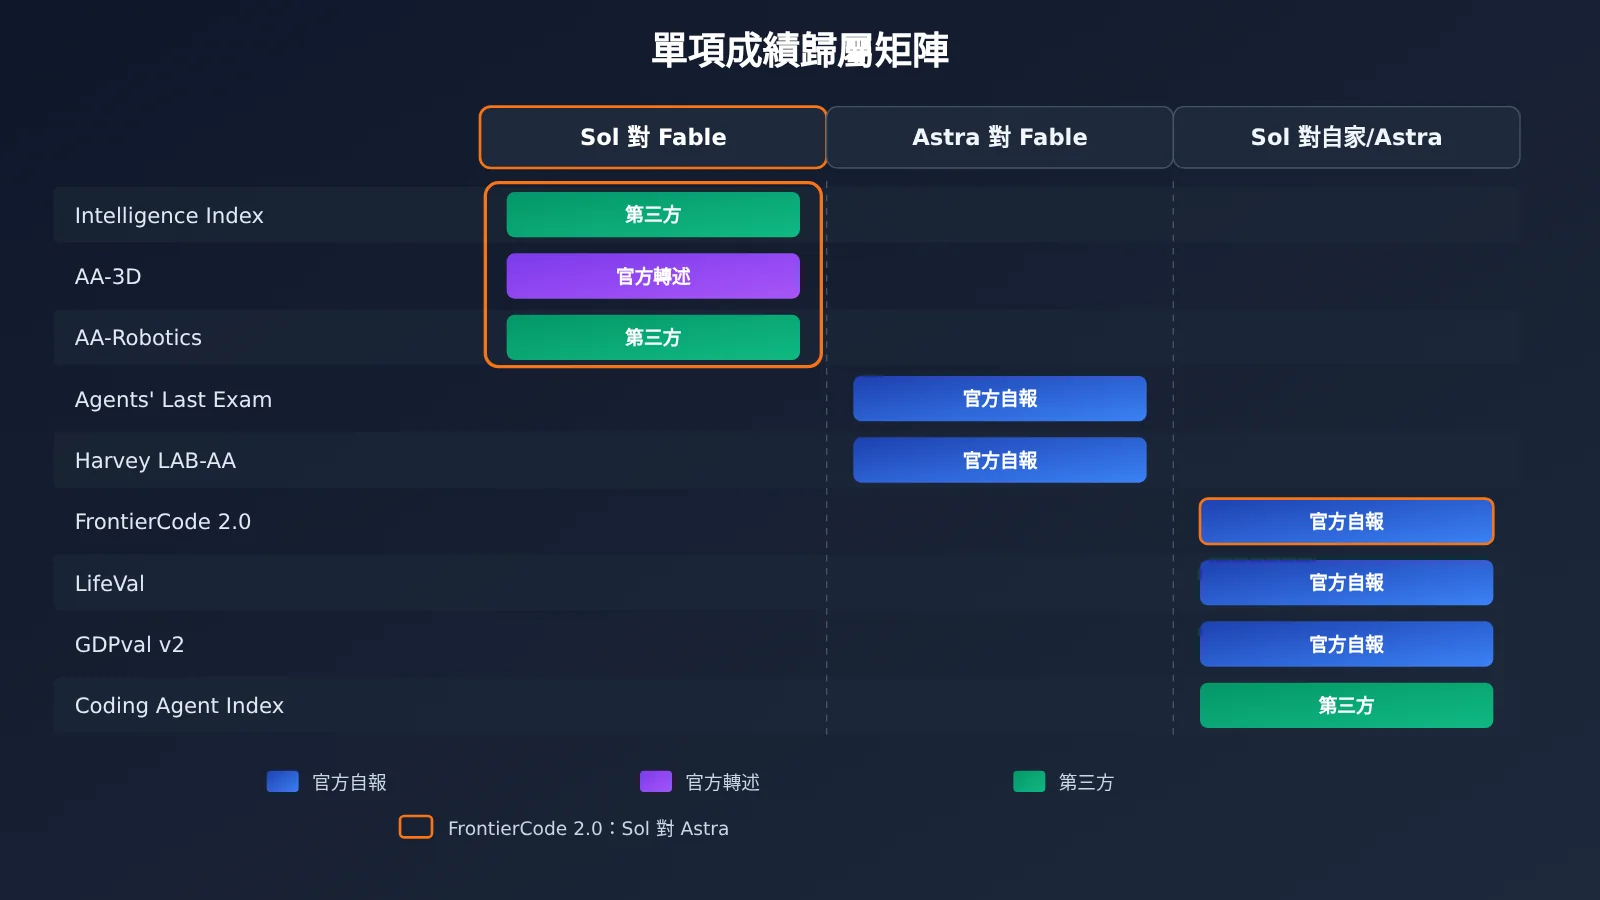
這是本文最重要的一節。OpenAI 發佈文裏有不少單項成績,但其中“Sol 對 Fable”的直接對照很少。下表按來源和對比雙方逐項列出。
| 單項 | 來源 | 對比雙方與結果 | 是否 Sol 對 Fable 直接對照 |
|---|---|---|---|
| Intelligence Index v5.0.1 | 第三方 AA,最高推理檔 | Fable 65,Sol(Max)57 | 是(第三方綜合分) |
| AA-3D 人工盲評 Elo | 官方轉述 | Sol 1259,Fable 1271 | 是(官方材料中唯一一項) |
| AA-Robotics v0.1 | 第三方 AA,研究預覽 | Sol 78,Fable 75 | 是(第三方預覽,推理檔以 AA 頁面爲準) |
| Agents’ Last Exam | 官方自報 | Astra 比 Fable 高 5.5 分,成本約 5% | 否,是 Astra 對 Fable |
| Harvey LAB-AA v1.1 | 官方自報 | Astra 通過率超過 Fable 兩倍,成本約六分之一 | 否,是 Astra 對 Fable |
| FrontierCode 2.0 | 官方自報 | Sol 與 Astra 相差不到 0.5 分,成本約五分之一,雙方均爲 Max | 否,是 Sol 對 Astra |
| LifeVal | 官方自報 | Sol 高於 GPT-6 Astra,成本約七分之一 | 否 |
| GDPval v2 | 官方自報 | Sol 比 GPT-6.1 Sol 高 5.3 分 | 否 |
| Coding Agent Index | 第三方 AA,max 檔 | Sol 比 GPT-6.1 Sol 低 3 分 | 否 |
GPT-6.2 Sol 的 FrontierCode 2.0 成績不能挪給 Fable 比較
FrontierCode 2.0 由 Cognition 設計,考察真實代碼庫的改動能否被維護者合併。官方自報的結果是 Sol 與 Astra 相差不到 0.5 分,成本約爲 Astra 的五分之一,雙方都是 Max 檔。這裏沒有 Fable 參與,不能寫成“Sol 在 FrontierCode 上和 Fable 差不到 0.5 分”。
同理,Agents’ Last Exam 和 Harvey LAB-AA 裏領先 Fable 的是 Astra。Sol 在這兩項上與 Fable 相比如何,發佈文沒有給出,不應推斷。
GPT-6.2 Sol 和 Claude Fable 5.2 的科學與代碼項
Terminal-Bench-Science 0.1 也要小心。官方自報 Astra 比 GPT-6 Astra 高 9 個百分點;腳註裏 Fable 5.2 有兩個數字,一個來自 Artificial Analysis 使用 mini-swe-agent 的測試,另一個是 Anthropic 報告的 Claude Code、Max 推理強度下 74.6%。這兩個 Fable 數字來自不同測試,不能當作同一次比較,也都不是 Sol 的成績。
第三方方面,Artificial Analysis 提到 Sol 在 Coding Agent Index(Codex harness、max)上比 GPT-6.1 Sol 低 3 分,主要原因是 SWE-Atlas-QnA-AA 低了 14 分,更容易漏掉關鍵事實。它測得的 AA-Omniscience 幻覺率(Max)爲 Sol 55%。這些數字沒有對應的 Fable 值,只能用來了解 Sol 自身的短板。
GPT-6.2 Sol 和 Claude Fable 5.2 場景推薦
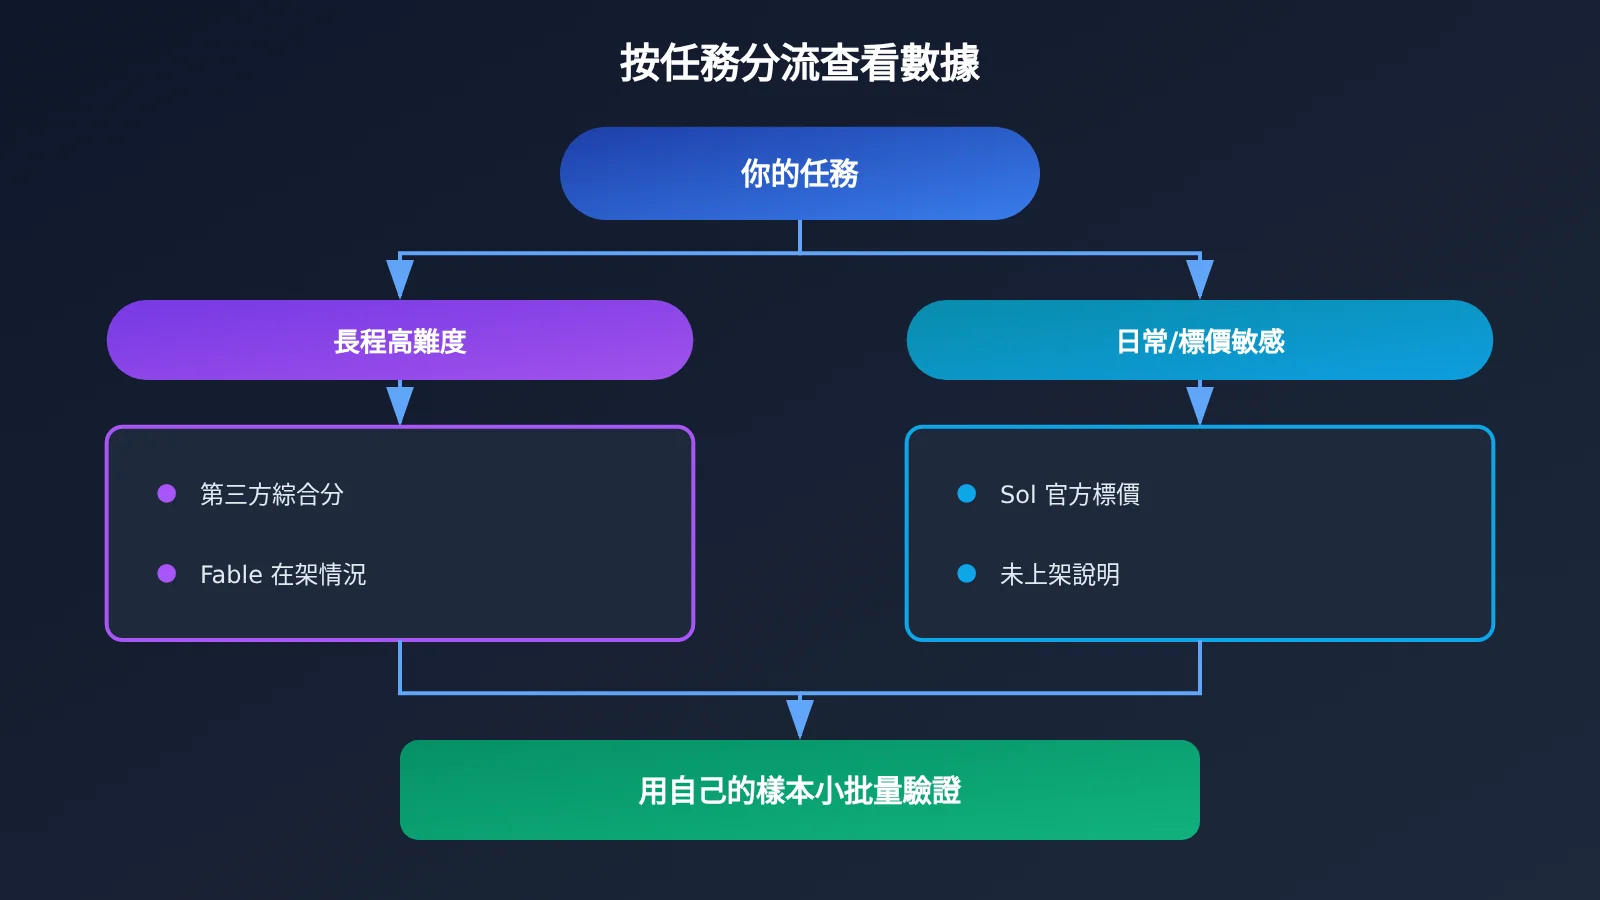
本節不替你決定用哪一個,只說明不同任務應該先看哪組數據。
先查 Claude Fable 5.2 數據的任務
- 長程、高難度、多步驟的綜合任務:先看第三方綜合分。Fable 在 Intelligence Index v5.0.1 最高推理檔是 65,位列榜首,這是目前和 Sol 直接可比的綜合數據。
- 需要馬上接入的項目:
claude-fable-5-2已在 API易 在架,可以立刻用自己的樣本測試。 - 要考慮思考開銷的項目:Fable 的思考默認開啓且不能關閉,默認 effort 爲 high,預算時要把思考 token 算進去。
先查 GPT-6.2 Sol 數據的任務
- 日常任務、對標價敏感的批量任務:先看官方短上下文標價和 Batch 規則,再看 LifeVal、GDPval v2 這類官方自報的日常任務成績。
- 主要在 272K 以內的請求:Sol 輸入、輸出四分之一的價差主要出現在這個區間。
- 已經在 ChatGPT Work 或 Codex 中使用的團隊:官方稱 Plus、Pro、Enterprise、Edu 即日起可用,Pro 200 首次獲得 Ultrafast,從 Sol 開始提供。
GPT-6.2 Sol 和 Claude Fable 5.2 快速上手
本節按任務給出操作順序。全文不放代碼,型號和地址都寫在句子裏。
長程高難度任務:先看 Fable 的綜合分和在架情況。 在 API易 控制檯創建 API Key,把 OpenAI 兼容 SDK 的 base URL 改成 https://api.apiyi.com/v1,model 填 claude-fable-5-2;如果希望型號名明確帶上思考,也可以用 claude-fable-5-2-thinking。總表標價爲輸入 $8、輸出 $40、緩存讀 $0.2,與 Anthropic 官方一致。建議先用 20 到 50 條自己的真實任務記錄完成率和 token 用量,再判斷 65 分在你的場景裏是否能體現出來。
日常、對標價敏感的任務:再看 Sol 的官方標價和未上架說明。 GPT-6.2 Sol 的 OpenAI 官方標價爲輸入 $2、緩存讀 $0.10、輸出 $10。暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。上架前請定期查看 apiyi.com 的型號列表,不要用平臺上的 gpt-6.1-sol 或 gpt-6-sol 代替測試,它們不是 6.2,gpt-6-sol 的緩存讀價也不同。
Sol 上架後,有三點需要注意:reasoning effort 不能設爲 none;超過 272K 輸入會按整單加價;官方端點支持 Chat Completions 和 Responses,平臺的端點以型號列表爲準。
🚀 快速開始:同一個 API Key 可以調用平臺上的多家模型。建議先在 API易 apiyi.com 用免費測試額度跑通 Fable,把評測腳本和樣本準備好,等 Sol 上架後直接替換型號名做同樣本對比。
GPT-6.2 Sol 和 Claude Fable 5.2 決策建議
下面是一份覈對清單,幫助你把數字放回到自己的任務裏。
- 先確認口徑:引用的是第三方綜合分、官方自報單項,還是官方標價?三者不要相加,也不要互相換算。
- 覈對推理檔:Sol 的 57 分是 Max 檔,High 檔是 55,Low 檔只有 41。實際用哪一檔,就看哪一檔的分數。
- 按請求長度算賬:在 272K 以內,可以按四分之一估算輸入和輸出;超過 272K 後要按 OpenAI 的整單規則重新計算。
- 單獨計算緩存:緩存讀是 $0.10 對 $0.20,兩者相差一倍;緩存寫入的保留時長不同,要按自己的緩存策略分別估算。
- 確認單項對照是否存在:你關心的單項如果只有 Astra 對 Fable 或 Sol 對 Astra 的數據,就不能當作 Sol 對 Fable 的結論。
- 考慮安全策略:官方稱兩款 6.2 都達到準備框架網絡安全“嚴重”級,防護更嚴,一部分合法的漏洞研究請求會被拒絕。
💡 選擇建議:用哪個模型取決於任務長度、推理檔和緩存命中率。可以用同一批樣本在 API易 平臺分別調用,用賬單和完成率說話,不必依賴單一榜單。
常見問題 FAQ
Q1:什麼是 GPT-6.2 Sol 和 Claude Fable 5.2?
GPT-6.2 Sol 是 OpenAI 於 2026-11-17 與 GPT-6.2 Astra 一起發佈的模型,型號 ID 爲 `gpt-6.2-sol`,輸入文本和圖像、輸出文本,上下文 1,050,000。Claude Fable 5.2 是 Anthropic 於 2026-11-09 發佈的模型,上下文 1M,最大輸出 128K,思考默認開啓且不能關閉。
Q2:綜合榜 65 對 57,能說明 Claude Fable 5.2 全面領先 GPT-6.2 Sol 嗎?
不能。65 對 57 是第三方 Artificial Analysis Intelligence Index v5.0.1 上的結果,Fable 用的是最高推理檔,Sol 用的是 Max 檔。它反映的是這套指數的整體水平,並不代表每個單項都是這個差距。官方轉述的 AA-3D 人工盲評 Elo 中,Sol 1259、Fable 1271,差距明顯更小;第三方 AA-Robotics v0.1 研究預覽中,Sol 78、Fable 75。
Q3:GPT-6.2 Sol 的價格真的是 Claude Fable 5.2 的四分之一嗎?
只在短上下文的輸入和輸出上成立。按官方標價,Sol 輸入 $2、輸出 $10,Fable 輸入 $8、輸出 $40。暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。緩存讀是 $0.10 對 $0.20,爲一半;超過 272K 輸入時,Sol 按整單加價,輸出變爲短上下文的 1.5 倍,此時不能再按四分之一估算。
Q4:FrontierCode 2.0 裏 GPT-6.2 Sol 和 Claude Fable 5.2 差多少?
官方材料沒有這組對照。FrontierCode 2.0 中“相差不到 0.5 分”比較的是 GPT-6.2 Sol 和 GPT-6.2 Astra,雙方都是 Max 檔,Sol 的成本約爲五分之一。Fable 沒有參與這項比較。
Q5:如何通過 API 調用 GPT-6.2 Sol 和 Claude Fable 5.2?
步驟如下:
1. 在 API易 apiyi.com 註冊並獲取 API Key 和免費測試額度。
2. 將 OpenAI 兼容 SDK 的 base URL 設爲平臺地址,model 填 `claude-fable-5-2`,即可調用 Fable。
3. `gpt-6.2-sol` 目前未上架,上架後型號與價格以平臺型號列表爲準,再用同一批樣本測試。
Q6:GPT-6.2 Sol 和 Claude Fable 5.2 各有哪些已知限制?
Sol 方面:第三方 AA 測得 Max 檔幻覺率爲 55%,Coding Agent Index 比 GPT-6.1 Sol 低 3 分,主要因爲更容易漏掉關鍵事實;reasoning effort 不能設爲 none;網絡安全防護更嚴,一部分合法漏洞研究會被拒絕。Fable 方面:思考不能關閉,默認 effort 爲 high,思考 token 會計入成本;Fast mode 單價爲輸入 $16、輸出 $80。
Q7:官方說 Astra 的成本只有 Fable 的 5%,能和第三方的 $26.54 對照着算嗎?
不能。“約 5%”是官方自報的 Agents’ Last Exam 成本,比較對象是 Astra 和 Fable;$26.54 是 Artificial Analysis 跑綜合指數時 Fable 的單任務成本。兩者任務不同、來源不同,不能相除,也不能用來推算 Sol 的成本。如果只想瞭解大致量級,在 API易 平臺用自己的樣本記錄實際賬單會更可靠。
GPT-6.2 Sol 和 Claude Fable 5.2 核心要點 Key Takeaways
- 綜合分:第三方 AA 指數中,Fable 最高推理檔 65,Sol Max 檔 57,是同一張榜上的直接對照。
- 標價:短上下文輸入、輸出 Sol 爲 Fable 的四分之一($2 對 $8,$10 對 $40)。
- 緩存讀:$0.10 對 $0.20,只差一半,不能套用四分之一。
- 長上下文:Sol 輸入超過 272K 時按整單加價,原有比例不再適用。
- 直接對照少:官方材料中 Sol 對 Fable 只有 AA-3D 一項,1259 對 1271。
- 不要挪用成績:FrontierCode 2.0 是 Sol 對 Astra,ALE 和 Harvey 是 Astra 對 Fable。
- 在架情況:Fable 可在 API易 apiyi.com 直接調用,Sol 暫未上架,以型號列表爲準。
總結
比較 GPT-6.2 Sol 和 Claude Fable 5.2,關鍵是把三層數字分開:
- 第三方綜合分:Fable 65,Sol(Max)57,用於判斷整體所處的檔位。
- 官方標價:短上下文輸入、輸出相差四分之一,緩存讀相差一半,長上下文按各自規則單獨計算。
- 單項任務:大部分官方單項不是 Sol 對 Fable 的直接比較,引用前先確認對比雙方是誰。
分數差和價格差不能合併成一句“誰更值”。更穩妥的做法是用自己的樣本、固定推理檔,分別記錄完成率和賬單。Fable 現在就可以在 API易 apiyi.com 上測試;GPT-6.2 Sol 暫未上架,我們會盡快上架這個模型,型號與價格以平臺型號列表爲準。
📚 參考資料
-
OpenAI 發佈文:GPT-6.2 Astra 與 Sol 發佈說明及官方自報單項
- 鏈接:
openai.com/index/introducing-gpt-6-2-astra-sol - 說明:官方自報的單項成績、可用範圍和標價概括
- 鏈接:
-
OpenAI 模型頁 – GPT-6.2 Sol:規格、標價與 272K 計價規則
- 鏈接:
platform.openai.com/docs/models/gpt-6.2-sol - 說明:緩存寫入價、長上下文加價和加速檔倍率以此爲準
- 鏈接:
-
OpenAI 系統卡:GPT-6.2 Astra 與 Sol 安全評估
- 鏈接:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 說明:準備框架分級與對齊評估
- 鏈接:
-
Artificial Analysis 文章與模型頁:第三方 Intelligence Index v5.0.1
- 鏈接:
artificialanalysis.ai/models/claude-fable-5-2 - 說明:分檔綜合分、單任務成本與 Coding Agent Index
- 鏈接:
-
Anthropic 文檔 – Claude Fable 5.2:官方標價與規格
- 鏈接:
platform.claude.com/docs/en/models/fable-5-2/overview - 說明:緩存寫入、緩存讀、Fast mode 與 effort 設置
- 鏈接:
-
API易 模型總表:平臺在架型號與價格
- 鏈接:
docs.apiyi.com/models.md - 說明:數據時間 2026-11-17 15:54(UTC+8),型號與價格以平臺型號列表爲準
- 鏈接:
作者:API易 技術團隊
技術交流:歡迎在 API易 官網首頁聯繫我們,更多型號與接口說明可查閱 docs.apiyi.com 文檔中心