Примечание автора: разбираем GPT-6 Luna Decisions API с четырёх сторон — принцип работы, методика реальных замеров, метрики задержки и бизнес-сценарии — чтобы вы могли решить, действительно ли «decision-вызовы» быстрее обычного вызова модели и подходят ли они вашему бизнесу.
После того как Decisions API официально запущен, у разработчиков главный вопрос один: насколько он быстрее обычного вызова модели и какие задачи стоит на него перевести. В этой статье — практический взгляд на интеграцию: что умеет GPT-6 Luna Decisions API, за счёт чего он ускоряется, как его тестировать и где применять.
Это не пересказ официального пресс-релиза. На разных аккаунтах, в разных регионах, при разной нагрузке и разных промптах задержка может отличаться очень сильно. Поэтому я не даю «фиксированный коэффициент ускорения» — он бы только ввёл вас в заблуждение. Вместо этого — воспроизводимый скрипт для замеров и критерии оценки, чтобы вы получили реальные цифры на своих данных.
Что вы получите: дочитав статью, вы сможете одним Python-скриптом измерить разницу в задержке между GPT-6 Luna Decisions API и обычным вызовом и понять, подходит ли он для ваших задач классификации, маршрутизации, модерации и оценки рисков.
🎯 О методике тестирования: весь код в статье написан под OpenAI-совместимый интерфейс и запускается напрямую через APIYI apiyi.com. Конкретные ID моделей, параметры интерфейса и тарификацию уточняйте в официальной документации и в консоли платформы.
Ключевые возможности GPT-6 Luna Decisions API
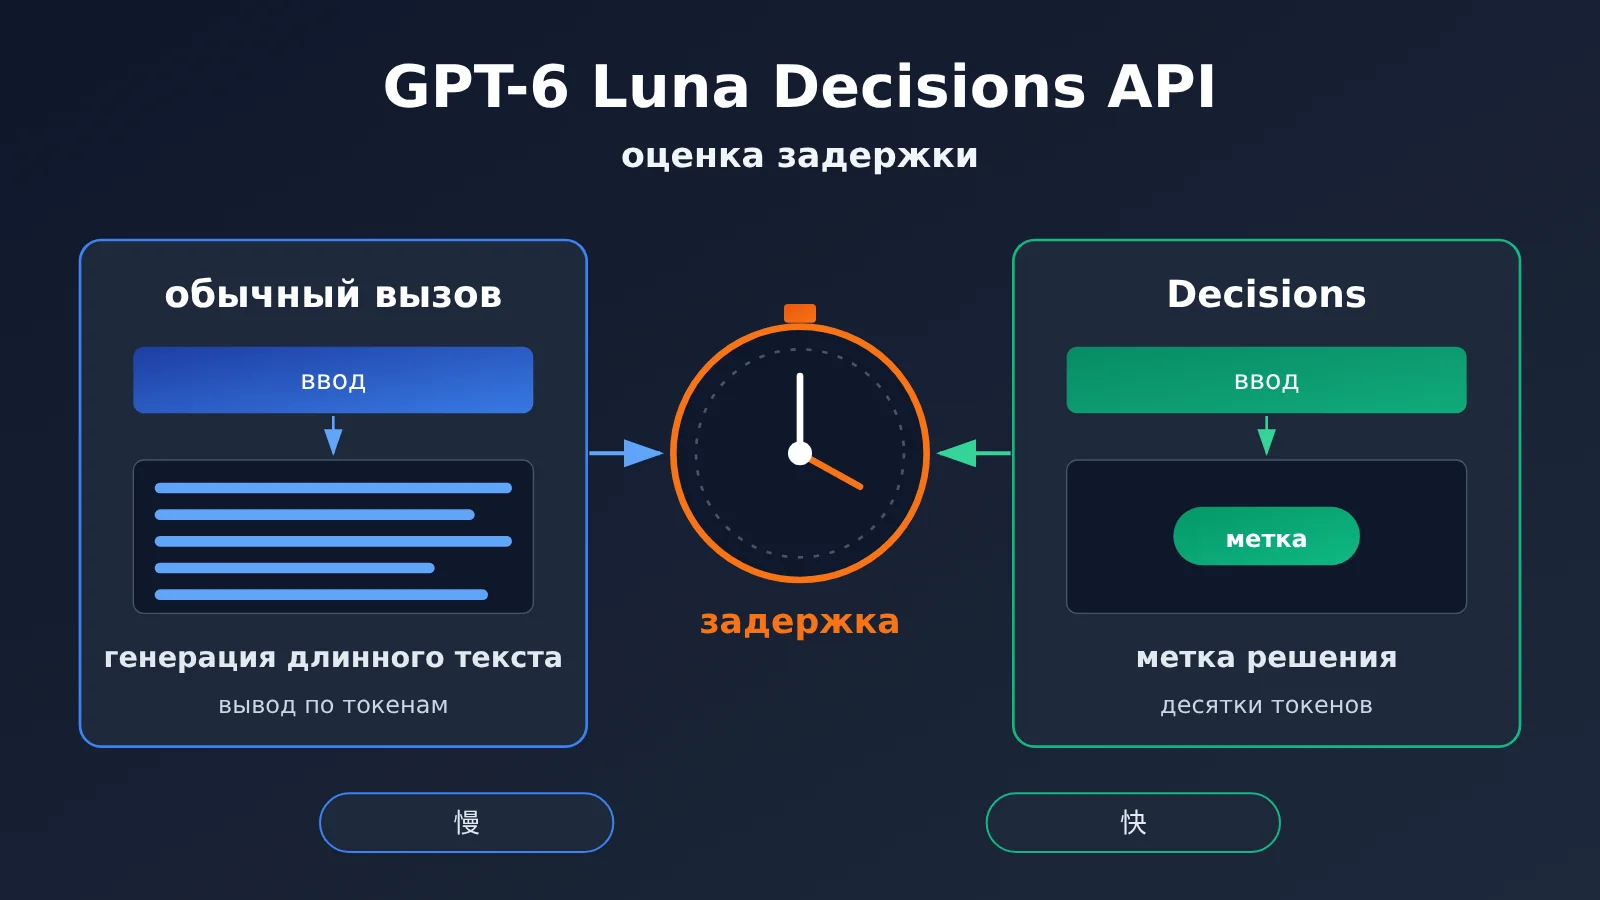
Прежде чем разбираться с Decisions API, стоит понять, чем она отличается по назначению от обычных вызовов чата. Обычный вызов нацелен на «генерацию контента», а вызов решающего типа — на «вынесение суждения в рамках ограниченного набора вариантов». У этих двух типов задач совершенно разные длина вывода, ограничения формата и структура задержки.
| Что важно | Пояснение | Что это даёт разработчику |
|---|---|---|
| Решающий вывод | Вывод сосредоточен на структурированных результатах — метках, вариантах, оценках, — а не на длинном тексте | Результат можно напрямую использовать в программе, без повторного парсинга |
| Короткий вывод | Типичный результат решения — всего несколько десятков токенов, намного меньше, чем в обычных генеративных задачах | Общее время ответа зависит в основном от первого токена и обработки входа |
| Формат можно ограничить | Можно задавать ограничения структурированного вывода, например через JSON Schema | Снижает долю ошибок формата и число повторов |
| Подходит для частых вызовов | Запросы маршрутизации, классификации, модерации обычно массовые и простые по отдельности | Оптимизация задержки и стоимости даёт заметно больший эффект |
Чем Decisions API отличается от обычного вызова
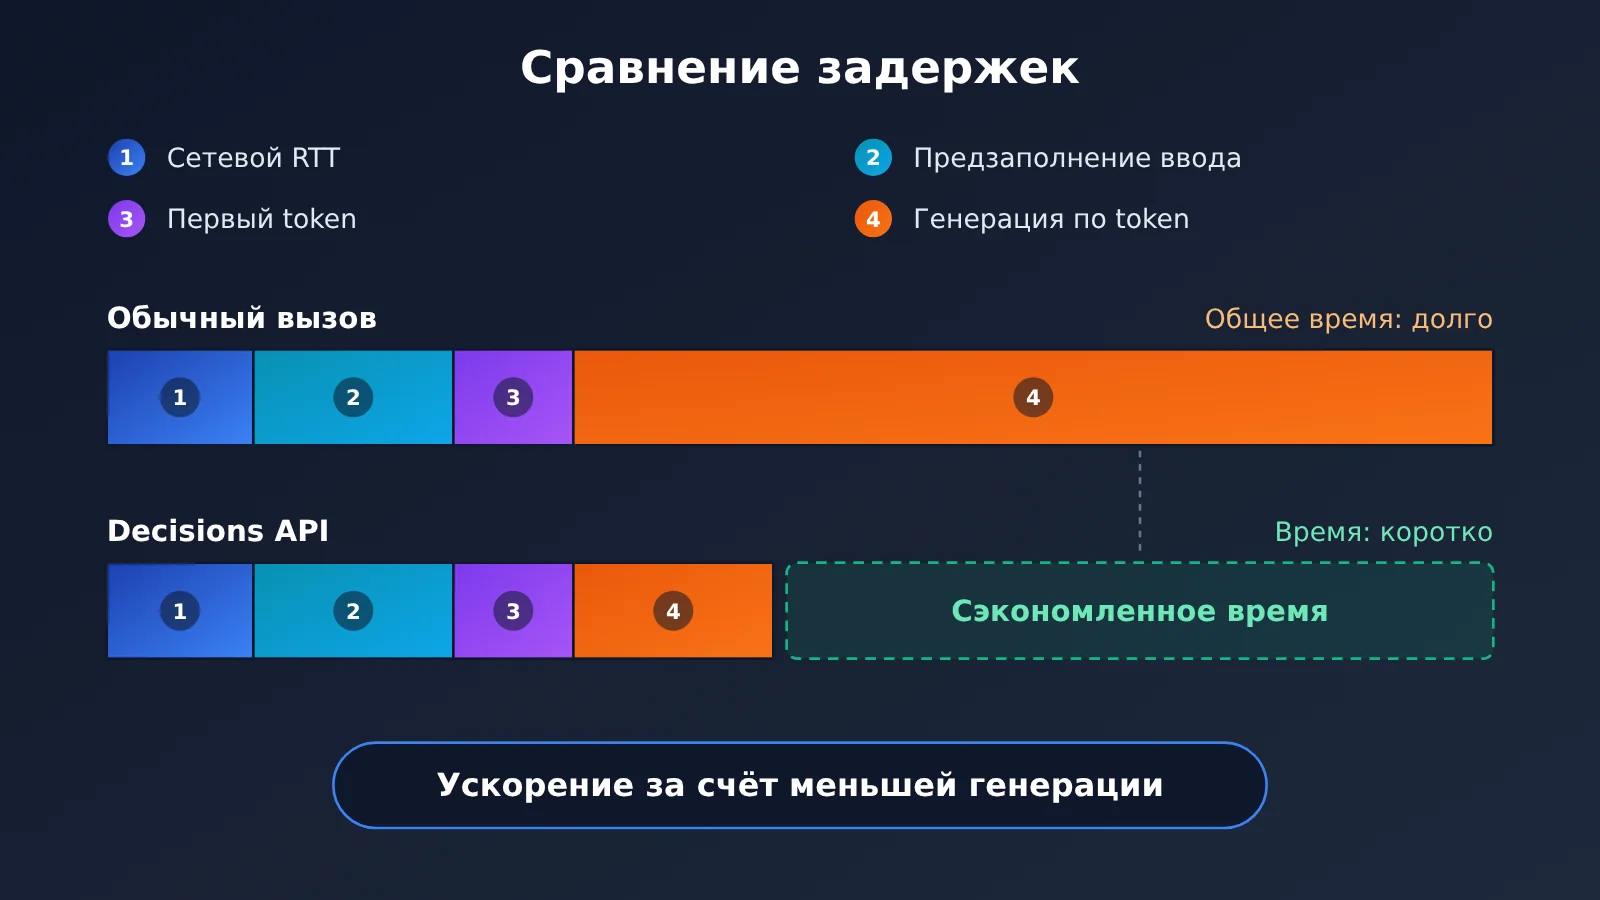
С инженерной точки зрения общее время обычного вызова модели складывается примерно из трёх частей: сетевой обмен, обработка входа (prefill) и генерация токен за токеном. В генеративных задачах основную долю обычно занимает третья часть — чем длиннее вывод, тем медленнее.
Решающий вызов сжимает вывод до одного структурированного результата, и время генерации резко сокращается. Это значит, что ускорение GPT-6 Luna Decisions API идёт главным образом от «меньше генерировать», а не от «генерировать быстрее». Если вашему продукту по-настоящему нужны длинные тексты, этот интерфейс не для вас.
Откуда берётся ускорение Decisions API
Решающий интерфейс обычно даёт дополнительный выигрыш ещё в двух аспектах. Первый — предсказуемый формат: программе не нужно выковыривать ответ из естественного языка регулярками, вероятность повторов из-за ошибок ниже. Второй — управляемый процесс рассуждения: если модель поддерживает регулировку глубины рассуждений, в решающих сценариях длинная цепочка размышлений обычно не нужна, и время ожидания ещё больше сокращается.
Важно подчеркнуть: всё это анализ на уровне механизма. Фактический прирост скорости зависит от того, какой длины вывод был у вас раньше: если модель и так отвечала одним словом, выигрыш после перехода будет очень скромным; если же она «сначала объясняла, потом давала вывод», выигрыш будет очень заметным.
Быстрый старт с GPT-6 Luna Decisions API
Минимальный пример
Ниже — самый простой пример одного вызова для принятия решения через структурированный вывод. Имя модели замените на реальный ID модели GPT-6 Luna, который вы видите в консоли платформы.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # ориентируйтесь на фактическое имя в списке моделей консоли
    messages=[{"role": "user", "content": "Текст заявки: мне выставили неправильный счёт. Определи, какому отделу его передать."}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
Вся суть этого кода — в параметрах max_tokens и response_format: первый ограничивает верхнюю границу вывода, второй гарантирует, что результат можно будет разобрать программно. Именно эти два параметра и лежат в основе ускорения вызовов для принятия решений.
Посмотреть полный скрипт тестирования (сравнение задержки обычного вызова и вызова для принятия решения)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # вызов через единый интерфейс APIYI
)

MODEL = "gpt-6-luna"  # ориентируйтесь на реальный ID модели в консоли; если есть отдельная модель/эндпоинт Decisions — замените здесь

SAMPLES = [
    "我的发票开错了,能重开吗?",
    "App 登录一直提示验证码错误",
    "想把套餐从月付改成年付",
    "订单显示已签收但我没收到",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """Возвращает время до первого токена, общее время и длину вывода"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"请分析下面工单并说明应由哪个部门处理及理由:{prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"工单:{prompt}。只输出部门判断。"}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
Скрипт использует потоковый вывод, поэтому позволяет одновременно получить время до первого токена (TTFT) и общее время выполнения. Рекомендую прогонять каждую модель минимум по 20 раз и чередовать режимы в одном и том же временном окне — так вы избежите искажений из-за колебаний сети.
🚀 Быстрый старт: официально рекомендуемый путь — сначала получить бесплатный тестовый лимит для новых пользователей на APIYI apiyi.com, прогнать приведённый выше скрипт на собственной выборке реальных заявок, и только потом решать, подключать ли GPT-6 Luna Decisions API к продакшену.
Практические данные тестирования GPT-6 Luna Decisions API
На вопрос «насколько это быстрее обычного вызова» нет единого ответа, поэтому в этом разделе приводится воспроизводимая методика оценки. Если провести замеры в описанных ниже условиях и по указанным метрикам, полученные цифры действительно помогут принимать бизнес-решения.
Настройка тестового окружения
| Параметр конфигурации | Рекомендуемая настройка | Пояснение |
|---|---|---|
| Точка входа вызова | OpenAI-совместимый интерфейс (base_url указывает на единый шлюз) | Чтобы оба режима шли по одному сетевому пути |
| Тестовые данные | 20–100 реальных бизнес-запросов | Задержки, измеренные на синтетических данных, обычно выглядят слишком оптимистично |
| Способ вызова | stream=True |
Только так можно измерить время до первого токена |
| Параллелизм | Сначала одиночные запросы, затем постепенно до пиковой нагрузки | Наблюдать за колебаниями задержки при высокой нагрузке |
| Время суток | По одному прогону в пиковые и непиковые часы рабочего дня | Исключить различия нагрузки по времени суток |
Ключевые метрики задержки
| Метрика | Значение | Критерий оценки |
|---|---|---|
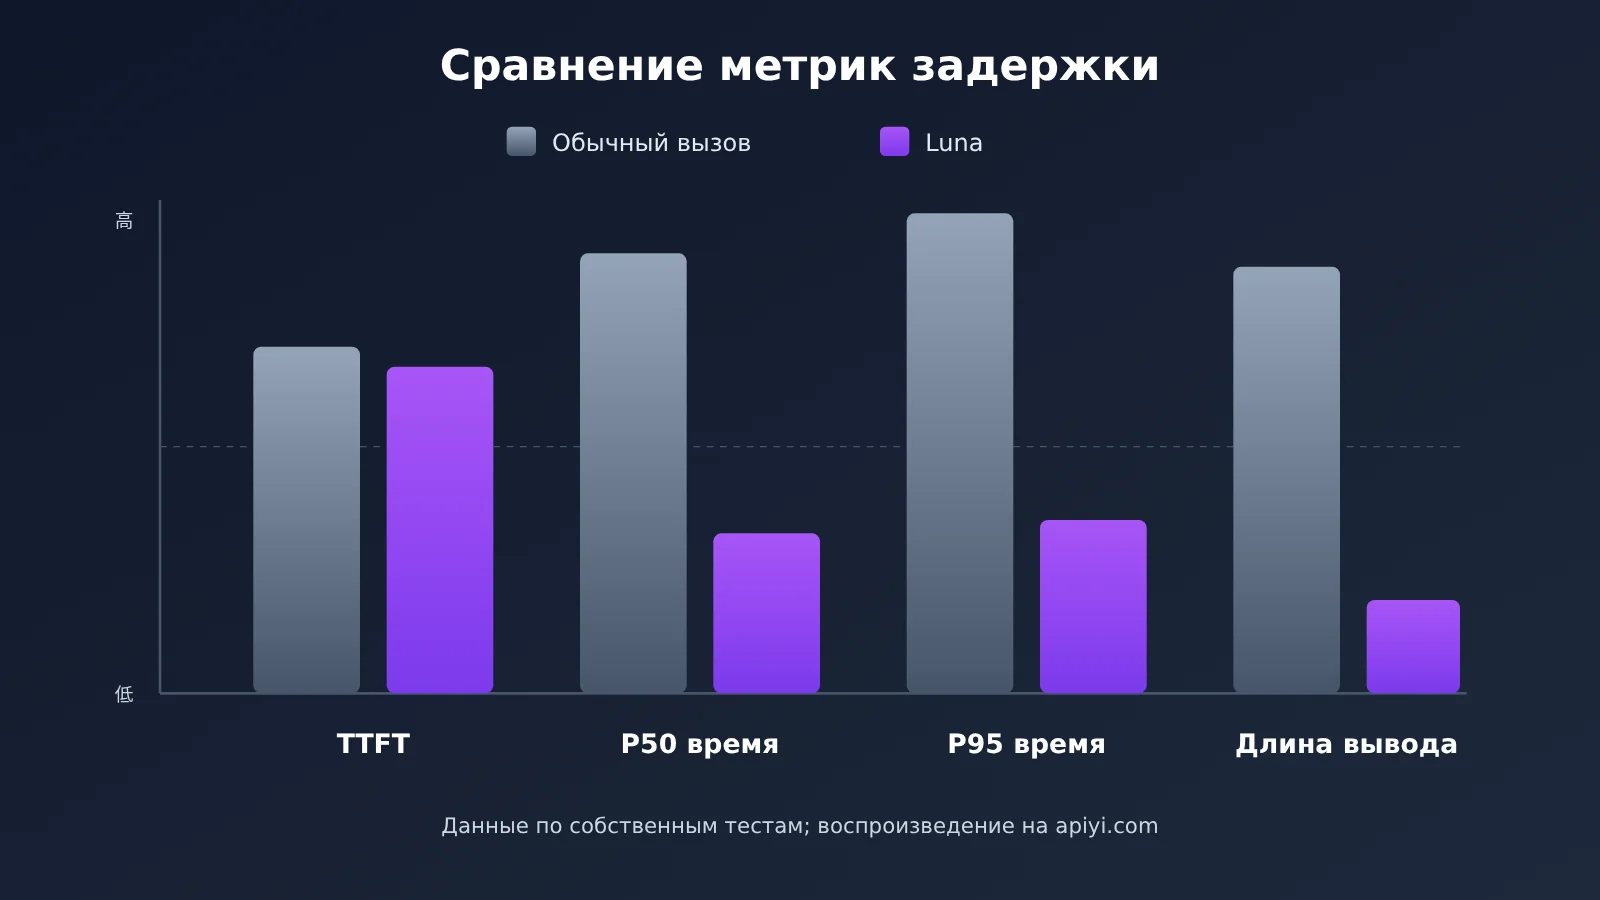
| TTFT — время до первого токена | От отправки запроса до получения первого символа | В обоих режимах обычно близко, в основном зависит от длины ввода |
| P50 — общее время выполнения | За какое время завершается половина запросов | Ключевая метрика преимущества режима Decisions: чем больше разрыв, тем больше смысла переключаться |
| P95 — общее время выполнения | Время выполнения запросов в хвосте распределения | Определяет нижнюю границу пользовательского опыта, обязательно смотреть для онлайн-сервисов |
| Средняя длина вывода | Количество символов или токенов в каждом ответе | Объясняет причину ускорения и напрямую связана со стоимостью |
| Доля успешных ответов в нужном формате | Доля ответов, которые можно сразу распарсить | Повторные попытки при ошибках съедают сэкономленное время |
Как интерпретировать результаты тестирования Decisions API
Если TTFT в обоих режимах почти одинаковое, а разница в P50 заметная, значит ускорение действительно достигается за счёт «меньшей генерации» — это самый ожидаемый результат. Тогда стоит дополнительно сравнить среднюю длину вывода: чем больше разница, тем заметнее экономия времени и затрат на вывод.
Если разница в P50 небольшая, но P95 отличается заметно, значит хвост обычных вызовов в основном создаётся случайными длинными ответами. В этом случае даже без яркого улучшения среднего значения переход на GPT-6 Luna Decisions API заметно повысит стабильность онлайн-сервиса.
Бывает и так, что режимы почти не отличаются — обычно это значит, что ваши промпты уже достаточно сдержанные. Тогда ценность переключения — прежде всего в надёжности формата, а не в скорости.
💡 Совет по проверке: одну и ту же выборку лучше прогонять поочерёдно через один и тот же шлюз. Рекомендуем сравнивать напрямую через единый интерфейс APIYI apiyi.com — так результаты не исказятся из-за разных сетевых выходов.
Для каких бизнес-задач подходит GPT-6 Luna Decisions API
Ценность API для принятия решений не в том, что один вызов стал быстрее на несколько сотен миллисекунд, а в том, что в высокочастотных и простых сценариях, где результат обрабатывается программой, эти миллисекунды умножаются на тысячи и десятки тысяч запросов. В таблице ниже — оценка пригодности для пяти типичных бизнес-сценариев.
| Бизнес-сценарий | Типичный вывод | Пригодность | Пояснение |
|---|---|---|---|
| Маршрутизация обращений в поддержку | Метка отдела + уровень уверенности | Высокая | Большой поток запросов, фиксированный набор вариантов; выигрыш и в скорости, и в формате |
| Модерация контента | Пропустить / отклонить / ручная проверка | Высокая | Чувствительна к задержке P95, результат должен напрямую управлять процессом |
| Выбор инструмента агентом | Какой инструмент вызвать и с какими параметрами | Высокая | В многошаговом агенте экономит время на каждом шаге, эффект суммируется |
| Первичная проверка в риск-менеджменте и антифроде | Уровень риска | Средняя | Подходит для первого фильтра; ключевые решения всё ещё требуют правил или ручной проверки |
| Написание длинных текстов / генерация отчётов | Большие фрагменты естественного языка | Низкая | По своей сути требует длинного вывода, это не целевой сценарий для API принятия решений |
Сравнение решений: Decisions API и другие подходы к принятию решений
Для задач принятия решений большая языковая модель — не единственный вариант. В таблице ниже GPT-6 Luna Decisions API сравнивается с несколькими распространёнными подходами.
| Подход | Ключевые особенности | Когда подходит | Задержка | Доступные платформы |
|---|---|---|---|---|
| GPT-6 Luna Decisions API | Понимание больших языковых моделей + структурированный короткий вывод | Решения со сложной семантикой и чётким набором вариантов | Низкая (ориентируйтесь на собственные замеры) | APIYI apiyi.com, официальный API |
| Обычный генеративный вызов | Гибкий, может сопровождаться объяснением | Низкочастотные решения, где нужно обоснование | Средняя или высокая, растёт с длиной вывода | Популярные платформы больших языковых моделей |
| Классификация лёгкой компактной моделью | Дешево и быстро, но ограниченное понимание | Классификация с простой семантикой и достаточной разметкой | Низкая | Популярные платформы больших языковых моделей или собственное развёртывание |
| Движок правил | Миллисекундный уровень, полный контроль | Чёткие условия, почти неизменные правила | Очень низкая | Собственная разработка |
Сравнительный анализ: движок правил по-прежнему лидирует по скорости и контролю, но при разговорных формулировках и разнообразных вариантах ввода стоимость поддержки правил резко возрастает. У компактных моделей явное преимущество в цене, но им не хватает понимания неоднозначной семантики и длинного контекста. На этом фоне GPT-6 Luna Decisions API лучше подходит для сценариев, где «семантика сложная, а пространство ответов ограничено», и представляет собой компромисс между правилами и обычным вызовом большой модели.
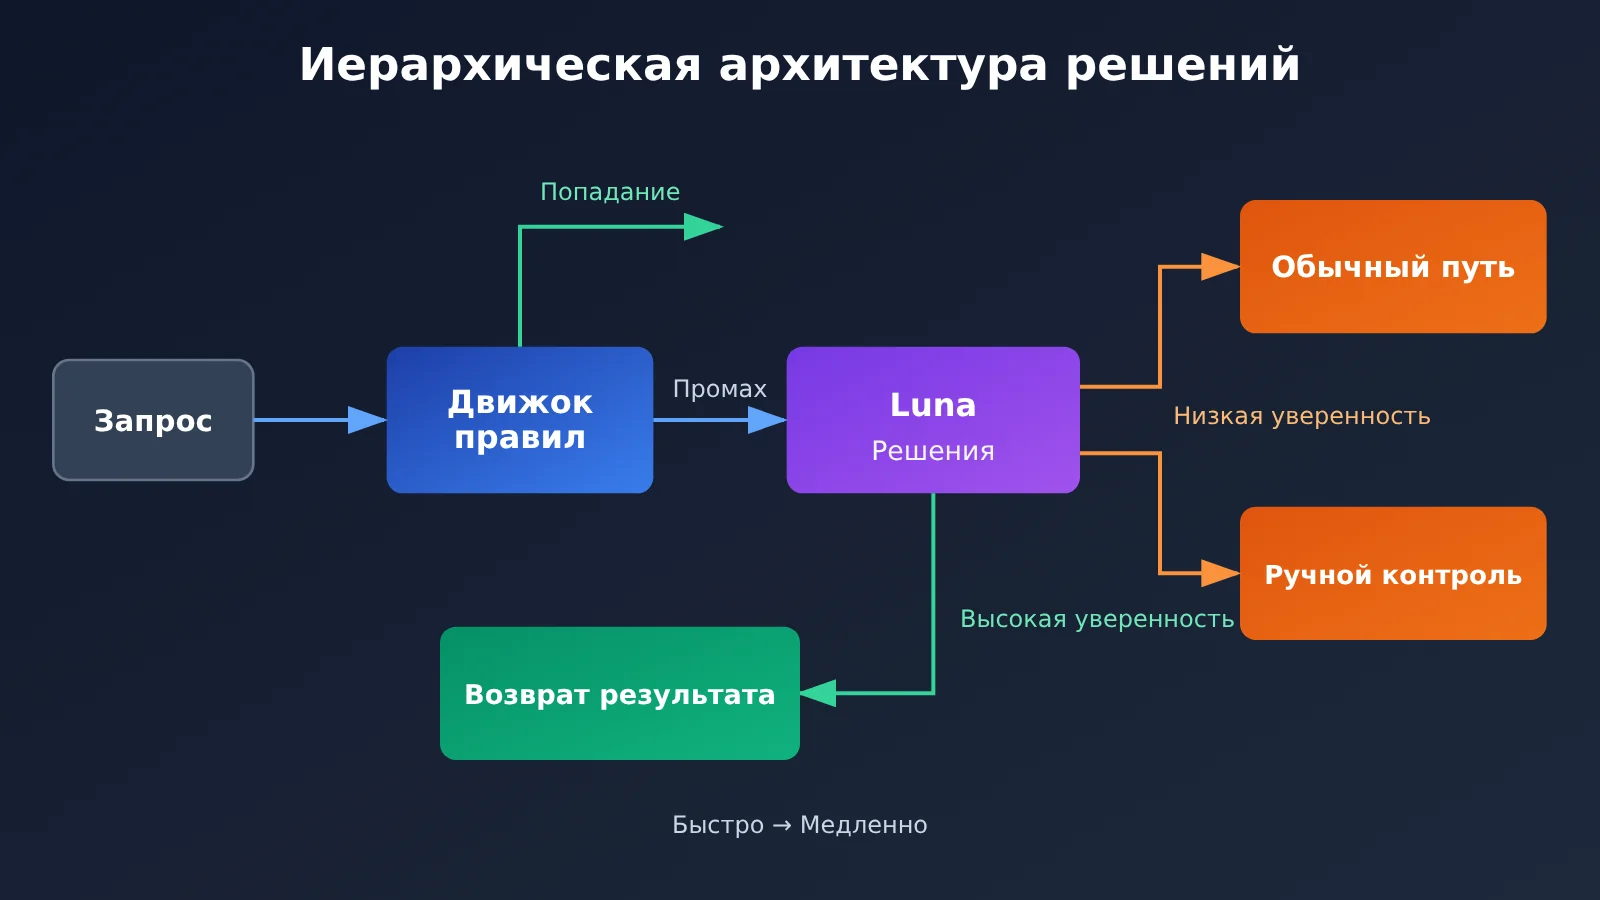
На практике чаще используют многоуровневую архитектуру: движок правил обрабатывает однозначные условия, GPT-6 Luna Decisions API — нечёткие запросы, а к обычному генеративному вызову обращаются только тогда, когда нужно объяснение.
Преимущества и недостатки GPT-6 Luna Decisions API
Преимущества
- Общее время выполнения лучше контролируется: вывод сжимается до структурированного результата, время этапа генерации заметно сокращается, а хвостовые задержки становятся стабильнее.
- Результат можно использовать напрямую: благодаря JSON Schema возвращаемые значения сразу попадают в бизнес-процессы, а кода на разбор ответа и повторных попыток из-за ошибок становится меньше.
- Структура затрат выгоднее: меньше выходных токенов — ниже расходы на выход. Особенно заметно на высоконагруженных сценариях.
- Низкий порог входа: API работает по протоколу, совместимому с OpenAI. В существующем коде обычно достаточно поменять имя модели и ограничения на вывод.
Ограничения
- Не силён в объяснениях: само решение не сопровождается обоснованием. Если нужен аудит, для примеров с низкой уверенностью можно отдельно сделать обычный вызов и получить пояснение.
- Прирост скорости зависит от сценария: если текущий вызов и так возвращает только одну метку, выгода от перехода будет небольшой. Сначала стоит измерить эффект с помощью скрипта оценки, а потом мигрировать.
- Длина входных данных всё ещё остаётся узким местом: decision API оптимизирует сторону вывода, но время предзаполнения для очень длинного контекста никуда не денется. При необходимости сначала сокращайте входные данные или сжимайте результаты поиска.
- Зависимость от качества проработки вариантов: если значения перечисления определены нечётко, модель будет колебаться между похожими вариантами. В схеме нужно задавать чёткие и взаимоисключающие варианты.
Часто задаваемые вопросы (FAQ)
В1: Что такое GPT-6 Luna Decisions API?
Это способ вызова для задач принятия решений. Суть в том, чтобы модель выдавала короткий структурированный результат суждения по заданным вариантам, а не генерировала длинный текст. Подходит для классификации, маршрутизации, модерации и выбора инструментов. Конкретные параметры — в официальной документации.
В2: Насколько Decisions API быстрее обычного вызова модели?
Универсального коэффициента нет. Ускорение в основном даёт сокращение длины вывода: чем длиннее был вывод раньше, тем больше выигрыш после переключения. Рекомендуем воспользоваться скриптом для замеров из этой статьи и сравнить общее время P50 и P95 на ваших реальных образцах — так вы получите вывод, подходящий именно вашему бизнесу.
В3: Чем GPT-6 Luna Decisions API отличается от обычного вызова с JSON-выводом?
Обычный вызов с JSON-ограничениями тоже может дать похожий результат. Разница зависит от того, сделала ли официальная сторона специальную оптимизацию под сценарии принятия решений — например, интенсивность рассуждений, ограничения вывода, планирование сервиса. Самый надёжный способ разобраться — сравнить на практике в одинаковых условиях.
В4: Какие бизнес-задачи стоит переводить в первую очередь?
В первую очередь рассмотрите задачи с большим объёмом запросов, фиксированным пространством ответов и чувствительностью к задержкам: маршрутизация тикетов в поддержке, модерация контента, выбор инструментов для агентов. Задачи, которые сами по себе требуют длинного вывода — написание длинных текстов, генерация отчётов, — переводить не рекомендуется.
В5: Как быстро вызвать GPT-6 Luna Decisions API через API?
Рекомендуем действовать так:
1. Зайдите на APIYI apiyi.com, зарегистрируйте аккаунт и получите API-ключ
2. В списке моделей в консоли уточните фактический ID модели GPT-6 Luna
3. Установите в коде из статьи base_url в `https://api.apiyi.com/v1`, подставьте имя модели и запустите
Платформа использует интерфейс, совместимый с OpenAI: одного ключа достаточно, чтобы заодно вызывать другие популярные модели для контрольных сравнений.
В6: Как контролировать затраты на вызовы Decisions API?
Вывод в формате решений сам по себе экономит выходные токены. Дальше можно оптимизировать в трёх направлениях: обрезать ненужный контекст, отсекать очевидные запросы правилами, делать повторный вызов только для образцов с низкой уверенностью. В консоли APIYI apiyi.com можно смотреть детализацию расхода по моделям, чтобы быстро находить статьи затрат.
В7: Какие известны ограничения у GPT-6 Luna Decisions API?
Главные ограничения: не предоставляются обоснования решений, ускорение зависит от исходной длины вывода, а время префилла при очень длинном вводе устранить нельзя. Для высокорисковых решений в финансах, медицине и подобных сферах используйте его как вспомогательный инструмент и сохраняйте этап проверки человеком.
GPT-6 Luna Decisions API: ключевые выводы
- Чёткое позиционирование: Decisions API нужен для быстрого выбора из ограниченного набора вариантов, а не для генерации длинных текстов.
- Откуда берётся ускорение: в первую очередь из-за более короткого вывода. Чем длиннее был ответ в обычном режиме, тем заметнее выигрыш после переключения.
- На какие метрики смотреть: на общее время P50 и P95. TTFT в обоих режимах обычно примерно одинаков.
- Лучшие сценарии: высокочастотные задачи с принятием решений — маршрутизация тикетов, модерация контента, выбор инструментов агентом.
- Рекомендуемая архитектура: эшелонированная схема с запасным вариантом: движок правил + Decisions API + обычные вызовы.
- С чего начать: запустить сравнительный скрипт через единый OpenAI-совместимый интерфейс и переходить на новый API только после проверки на собственных данных.
Резюме
Ключевые моменты GPT-6 Luna Decisions API:
- Скорость за счёт меньшей генерации: преимущество в скорости даёт в основном структурированный короткий вывод, а не более быстрая генерация отдельного токена.
- Ценность зависит от сценария: больше всего выигрывают задачи, где много однотипных запросов, фиксированный набор вариантов и важна задержка. Для длинных текстов этот API не подходит.
- Выводы — по реальным замерам: при разных промптах и выборках ускорение сильно различается. Обязательно считайте P50 и P95 на реальных данных.
Если вы занимаетесь маршрутизацией обращений в поддержку, модерацией контента или оркестрацией агентов, GPT-6 Luna Decisions API стоит внимательно изучить. Советую сначала оставить текущие вызовы как контрольную группу, перевести на новый режим часть трафика, а затем по задержке и доле успешных ответов в нужном формате решить, стоит ли переходить полностью.
Рекомендую получить бесплатный лимит через APIYI apiyi.com и быстро проверить на скрипте из этой статьи, какое ускорение реально даёт ваш сценарий.
📚 Справочные материалы
- Официальная документация OpenAI API: вызов моделей, потоковый вывод и структурированный вывод
- Ссылка:
platform.openai.com/docs -
Описание: авторитетный источник для проверки параметров, связанных с GPT-6 Luna и Decisions
-
OpenAI Python SDK: официальный Python-клиент
- Ссылка:
github.com/openai/openai-python -
Описание: SDK, использованный в скриптах тестирования для этой статьи; содержит примеры потоковых вызовов
-
Спецификация JSON Schema: стандарт определения ограничений для структурированного вывода
- Ссылка:
json-schema.org - Описание: справочная спецификация при проектировании вариантов решений и значений перечислений
Автор: техническая команда APIYI
По техническим вопросам: свяжитесь с нами на главной странице сайта APIYI; больше материалов по подключению можно найти в центре документации docs.apiyi.com