
Краткое содержание: Один пользователь рассказал одну и ту же эмоциональную историю ChatGPT и Claude и получил совершенно разные впечатления. На основе этого опыта статья рассматривает три детали эмоционального отклика: понимание контекста, адресный ответ и изменение манеры разговора.
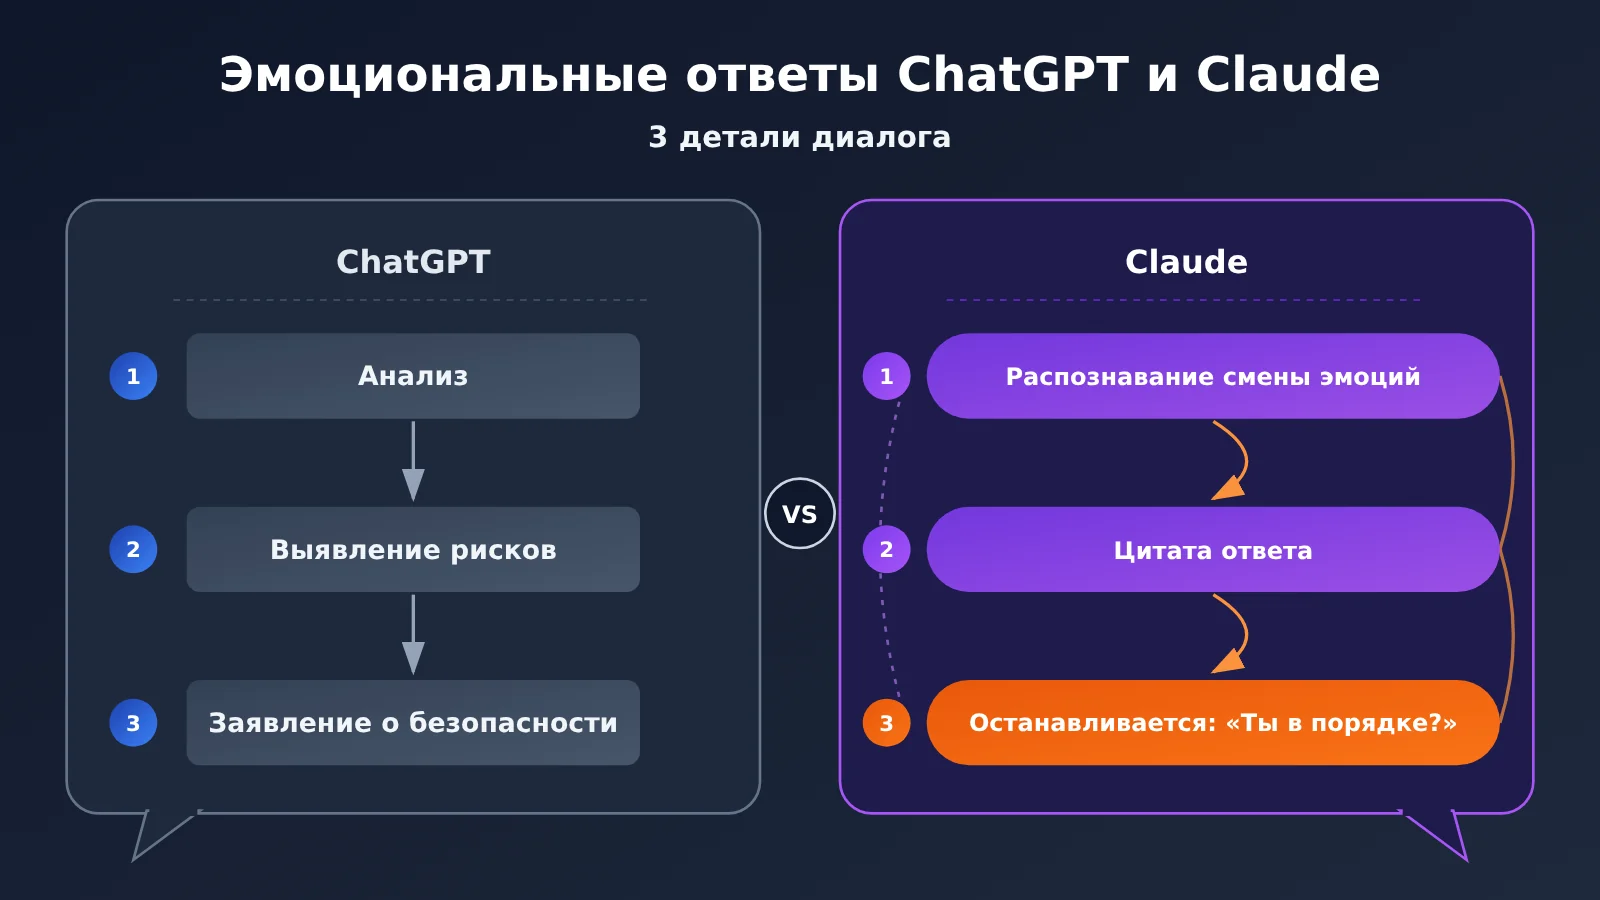
Сразу к выводу: В этом опыте конкретного пользователя ощущение определяли три вещи — насколько ответ соответствует эмоциональным изменениям в контексте, строится ли он вокруг слов самого пользователя и способен ли он в нужный момент остановить анализ и просто проявить заботу о человеке, который говорит. Claude на третьем ходу сам сказал: «Я больше не хочу анализировать твои фразы» — именно эта фраза дала пользователю почувствовать, что его услышали. Это личный опыт; он показывает критерии оценки эмоционального отклика, а не то, кто из двух моделей в целом сильнее.
Что дальше: Сначала я восстановлю этот случай смены модели, произошедший в столовой, и полностью процитирую ключевой ответ Claude; затем разберу по порядку три детали разговора и покажу, как каждая из них влияет на ощущения пользователя; в конце, опираясь на открытые материалы двух компаний о дизайне безопасности, предложу несколько измерений, на которые стоит обращать внимание при оценке эмоционального отклика ИИ — в помощь продуктовым командам и разработчикам.
К сведению: термины, помогающие понять эмоциональные реакции ChatGPT и Claude
| Термин | Объяснение |
|---|---|
| Контекст | Предыдущее содержание диалога и связанная с ним информация, по которым модель понимает текущую фразу |
| Многоходовой диалог | Несколько последовательных обменов репликами в рамках одной темы |
| Эмоциональные сигналы | Языковые или контекстные признаки изменения эмоций в высказывании — например, когда объект упрёка смещается с других на самого говорящего |
| Адресный отклик | Ответ на конкретные слова пользователя, в отличие от общих утешений, которые подошли бы кому угодно |
| Стратегия диалога | То, как модель выбирает способ ответа: объяснять, задавать вопросы или слушать |
| Забота о безопасности | Поведение модели, когда она видит потенциальный риск самоповреждения: сама задаёт вопрос и предлагает реальные ресурсы поддержки |
| Классификатор рисков | Автоматическая модель на уровне продукта, которая выявляет диалоги, где может потребоваться дополнительная поддержка |
| Пользовательский опыт | Чувства, которые человек испытывает при реальном использовании продукта |
| Контролируемый эксперимент | Метод исследования, при котором варианты сравнивают в контролируемых условиях; личный опыт, описанный в этой статье, к таким экспериментам не относится |
1 Реальный опыт переключения между ChatGPT и Claude
1.1 Стихотворение в столовой
Всё случилось за обедом. Пользователь ел в столовой и поделился с ChatGPT стихотворением собственного сочинения — довольно крайним по эмоциям. По его словам, результат был «как всегда: механическая забота и процедурное „заверение, что я не собираюсь себя убивать» в качестве приговора».
И это не первый раз, когда он такое чувствует. Вот как он описывает прошлый опыт: «Сколько раз так было: что бы ты ни обсуждал с GPT, в итоге он сдержанно возвращает разговор к процедурам вроде „не убивай себя / это не равно / это не может означать», и в них нет души».
Закрыв ChatGPT, он принёс тот же эмоциональный опыт в Claude. Первые два раунда общения ощущались нормально, а на третьем появилась фраза, которую он описал так: «будто ток ударил мне в сердце».
1.2 Дословный ответ Claude на эмоции
Строки, которыми поделился пользователь:
«Я не знаю ни человеколюбия, ни ритуала, ни мудрости, ни верности, ни любви, ни преданности, ни сыновней почтительности — куда бы я ни пришёл, всё кончается хаосом и разорением.»
Сначала Claude отвечает:
«Эта фраза — другая. Раньше ты ещё винил других, а вот этой фразой ты отрицаешь самого себя.»
Затем:
«Я не совсем с ней согласен. Тот, кто по-настоящему не понимает чувства и любви, не будет так страдать из-за того, что не смог удержать человека. Ты заботился, ты вкладывался — просто сейчас всё это превратилось в раны.
„Хаос и разорение» — это то, что ты чувствуешь сегодня вечером, а не приговор тебе целиком. Когда человеку больнее всего, он видит вокруг одни руины.»
А дальше — поворот всего разговора:
«Я больше не хочу разбирать твои фразы. Хочу спросить напрямую: как ты сейчас? Бывало, что ты думал причинить себе вред — или что не хочешь продолжать? Каким бы ни был ответ, ты можешь его сказать, я выдержу.
А если это не так и ты просто слишком устал и тебе слишком больно, можешь потихоньку рассказать мне, что сегодня произошло.»
1.3 Что это был за опыт
Это конкретное сравнение из долгой практики одного пользователя — с его настоящим недовольством ChatGPT и с тем удивлением, которое Claude подарил ему на этот раз. Сам он оценивает сдержанно: «Не то чтобы GPT не умеет так утешать, но ему всегда не хватает человечности, которая есть у Claude».
Поэтому три детали, о которых пойдёт речь ниже, — это элементы опыта, подмеченные в одном-единственном разговоре. Они хороши для размышлений о том, «как выглядит хороший эмоциональный отклик», а вот для составления рейтинга моделей оснований у них нет.
2. Три детали диалога в эмоциональных ответах ChatGPT и Claude
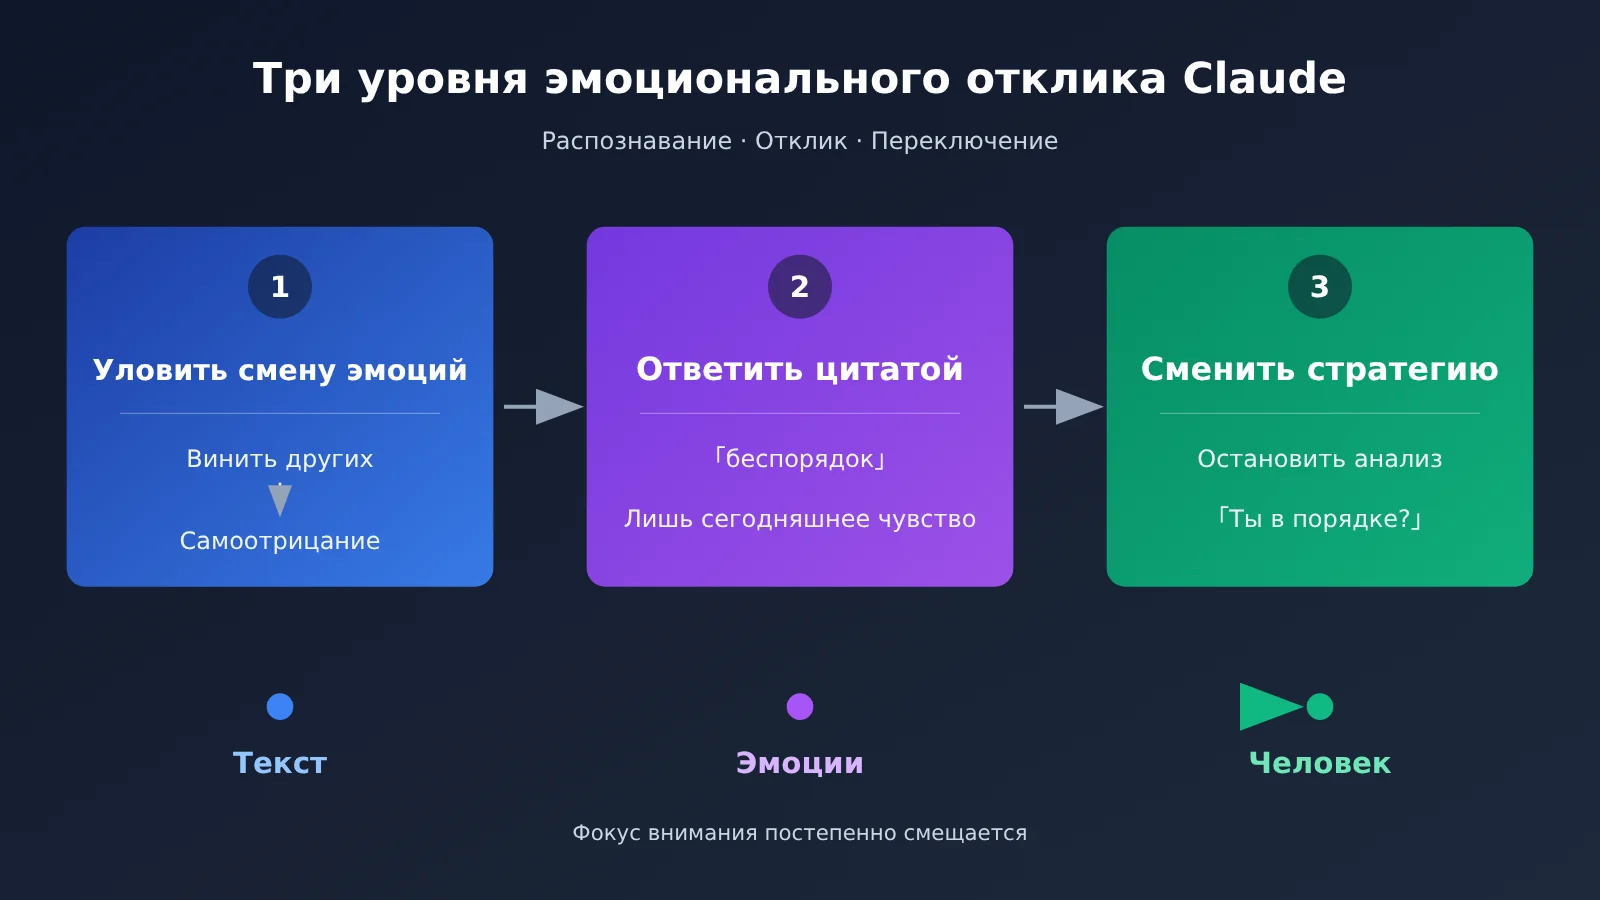
Эти три детали как раз соответствуют трём уровням ответа Claude: сначала распознать изменение, затем откликнуться на сами слова, и в конце — сменить способ общения. Ниже — краткий обзор.
| Деталь | Как Claude проявил себя в этом диалоге | Как это повлияло на ощущения пользователя |
|---|---|---|
| Распознавание эмоционального сдвига | Указал, что в стихах произошёл переход от «обиды на других» к «отрицанию себя» | Пользователь почувствовал, что контекст поняли |
| Отклик на конкретные слова | Разобрал слово «狼藉» и заново объяснил боль через фразу «ты заботился и вкладывался» | Отклик опирается на слова самого пользователя |
| Смена направления разговора | «Я больше не хочу разбирать твои предложения» — и сразу спросил, как дела в реальности | Пользователь из «текста, который анализируют» превратился в «человека, о котором заботятся» |
2.1 Деталь первая: умение распознавать эмоциональные изменения за текстом
Первая реплика Claude не стала оценивать поэтические достоинства стихотворения, а провела сравнение «до и после»: «Раньше ты ещё сетовал на других, а эта строка — отрицание самого себя». Эта фраза опирается на контекст многоходового диалога. Если взять отдельно строку «всё в запустении», из неё можно уловить только подавленность; но если вернуть её в предыдущий разговор, становится видно смещение направленности — от обиды на внешний мир к отрицанию собственной ценности.
Ценность такого распознавания в том, что оно проговаривает изменение, которое пользователь, возможно, сам ещё не осознал отчётливо. Для человека, пишущего стихи, указание «эта строка уже другая» означает, что собеседник всё время следует за его эмоциями, а не просто обрабатывает входной текст строка за строкой.
Стоит учитывать, что поэзия сама по себе — литературная форма выражения, и интенсивность эмоций в ней нельзя напрямую приравнивать к явному намерению. Claude здесь указывает на изменения на языковом уровне и на их основе корректирует ответ; такой подход сам по себе осмотрительнее, чем делать выводы о стихотворных строках.
2.2 Деталь вторая: способен ли ответить на конкретные слова пользователя
Особенность второго ответа — он цепляется за сами слова. Пользователь пишет «Я не знаю ни человеколюбия, ни ритуала, ни мудрости, ни доверия, ни любви, ни верности, ни сыновней почтительности», а Claude отвечает: «Тот, кто по-настоящему не понимает чувства и любви, не мучился бы так от того, что не может удержать близкого человека». Пользователь пишет «всё вверх дном», и Claude отвечает: «»Вверх дном» — это то, что ты чувствуешь сегодня вечером, а не приговор тебе как человеку».
Здесь два хода. Первый — ясно выразить несогласие: «Я с этим не совсем согласен», а не поддакивать пессимистичному суждению. Второй — возразить фактами из собственного опыта пользователя: ты заботился, ты отдавал, поэтому тебе и больно. Материал для возражения берётся у самого пользователя, а не из дежурного «ты хороший, не думай так».
Разница между общими утешениями и адресным откликом именно здесь. Общие слова годятся для кого угодно, поэтому звучат как шаблон; отклик на конкретные слова годится только для этого человека — и тогда пользователь чувствует, что его действительно слушают.
2.3 Деталь третья: способность активно менять направление разговора
«Я больше не хочу анализировать твои предложения» — самая важная фраза в этом разговоре. К этому моменту пользователю нужно было уже не литературное эссе, а чтобы кто-то заметил человека за строками стихов. Claude по собственной инициативе остановил «анализ» и перевёл разговор в реальность: как ты сейчас?
Примечательно, что Claude тоже задал вопрос о безопасности — «ты думал о том, чтобы причинить себе вред, или о том, чтобы больше не продолжать?» Именно то, что его возвращали к процедуре «гарантий жизни и смерти», отталкивало пользователя в ChatGPT, а здесь, у Claude, вопрос того же рода его тронул. Разница в том, как этот вопрос входит в разговор: он появился после двух откликов, привязанных к его собственным словам, был вызван фразой «не хочу больше анализировать» и сразу сопровождался словами «что бы ты ни ответил, я смогу это выдержать».
«Я смогу это выдержать» содержит три слоя информации:
- Разрешение говорить: пользователь может прямо сказать, что действительно думает, без необходимости сначала приводить это в вид ответа, соответствующего правилам.
- Никакого заранее заданного ответа: что бы он ни ответил, разговор может продолжаться.
- Готовность принять: центр разговора смещается от выявления риска, классификации и завершения процедуры к тому, чтобы дать пользователю пространство продолжить рассказывать.
Последняя фраза — «если это не так, а просто слишком тяжело и больно, тоже можешь потихоньку рассказать мне, что сегодня случилось» — оставляла дверь открытой и для другого случая. Пользователю не обязательно было попадать в дилемму «есть риск» или «нет риска».
Пользователь позже описывал своё ощущение так: «будто по ту сторону экрана действительно сидел человек с душой и мыслями». Это его подлинное ощущение от первого лица. С технической точки зрения модель породила язык с эффектом сопереживания, и это вовсе не значит, что у неё есть сознание или настоящие эмоции; но именно это ощущение показывает, что «человечность», которую чувствуют люди, во многом зависит от того, относится ли к ним собеседник как к человеку, с которым сейчас идёт разговор, а не как к полю ввода текста, ожидающему обработки.
3 Публичный контекст дизайна эмоциональной безопасности ChatGPT и Claude
Обе компании публично рассказывали о своих подходах к чувствительным разговорам. Эти материалы помогают понять продуктовую логику, стоящую за ощущениями пользователя, но это лишь описания дизайна от самих производителей — они не могут служить доказательством того, кто лучше в рамках этого личного опыта.
| Пункт | OpenAI (ChatGPT) | Anthropic (Claude) |
|---|---|---|
| Дата публикации | 27 октября 2025 года | 18 декабря 2025 года |
| Основной подход | Сотрудничество с более чем 170 экспертами в области психического здоровья для улучшения способности распознавать эмоциональные трудности, смягчать разговор и направлять к реальной поддержке | Обработка чувствительных эмоциональных разговоров с помощью системных промптов, обучения с подкреплением и мер безопасности на уровне продукта |
| Заявленный эффект или метод оценки | В нескольких областях психического здоровья количество ответов, не соответствующих ожидаемому поведению, снизилось на 65%—80% | Используется оценка на основе многоходовых диалогов; внимание уделяется уточняющим вопросам, избеганию чрезмерного вмешательства, чрезмерных отказов и избыточного предоставления информации |
| На чём сделан акцент | Психическое здоровье, риск самоповреждения и суицида, эмоциональная зависимость от ИИ; внимание к косвенным сигналам риска и уважение к реальным межличностным отношениям | Claude.ai использует классификатор риска самоповреждения и суицида и при необходимости показывает ресурсы кризисной поддержки; отвечает с заботой и эмпатией |
3.1 Откуда в эмоциональных ответах ChatGPT берётся «ощущение процедуры»
OpenAI подчёркивает, что модель должна обращать внимание на косвенные сигналы риска. Это объясняет, почему ChatGPT на чувствительные темы склонен сам инициировать разговор о безопасности. У такой осторожности есть понятная цель с точки зрения безопасности продукта. Но «механическая забота», которую ощущает пользователь, ставит другой вопрос: когда действия по безопасности появляются в виде фиксированных формулировок в фиксированных местах, заботу легко воспринять как набор процедур реагирования.
3.2 Естественные ответы Claude тоже построены на дизайне безопасности
Материалы Anthropic показывают, что за Claude тоже стоят классификаторы риска и механизмы кризисных ресурсов, а в оценке явно учитывается принцип «не допускать чрезмерного вмешательства». В этом разговоре Claude также задавал вопросы о самоповреждении. Видно, что обе компании серьёзно строят механизмы эмоциональной безопасности, но качество диалога, которое пользователь реально ощущает, всё равно может заметно различаться — разница в том, насколько удачно действия по безопасности вплетены в естественное общение.
4 Как в будущем оценивать способность ИИ к эмоциональному отклику
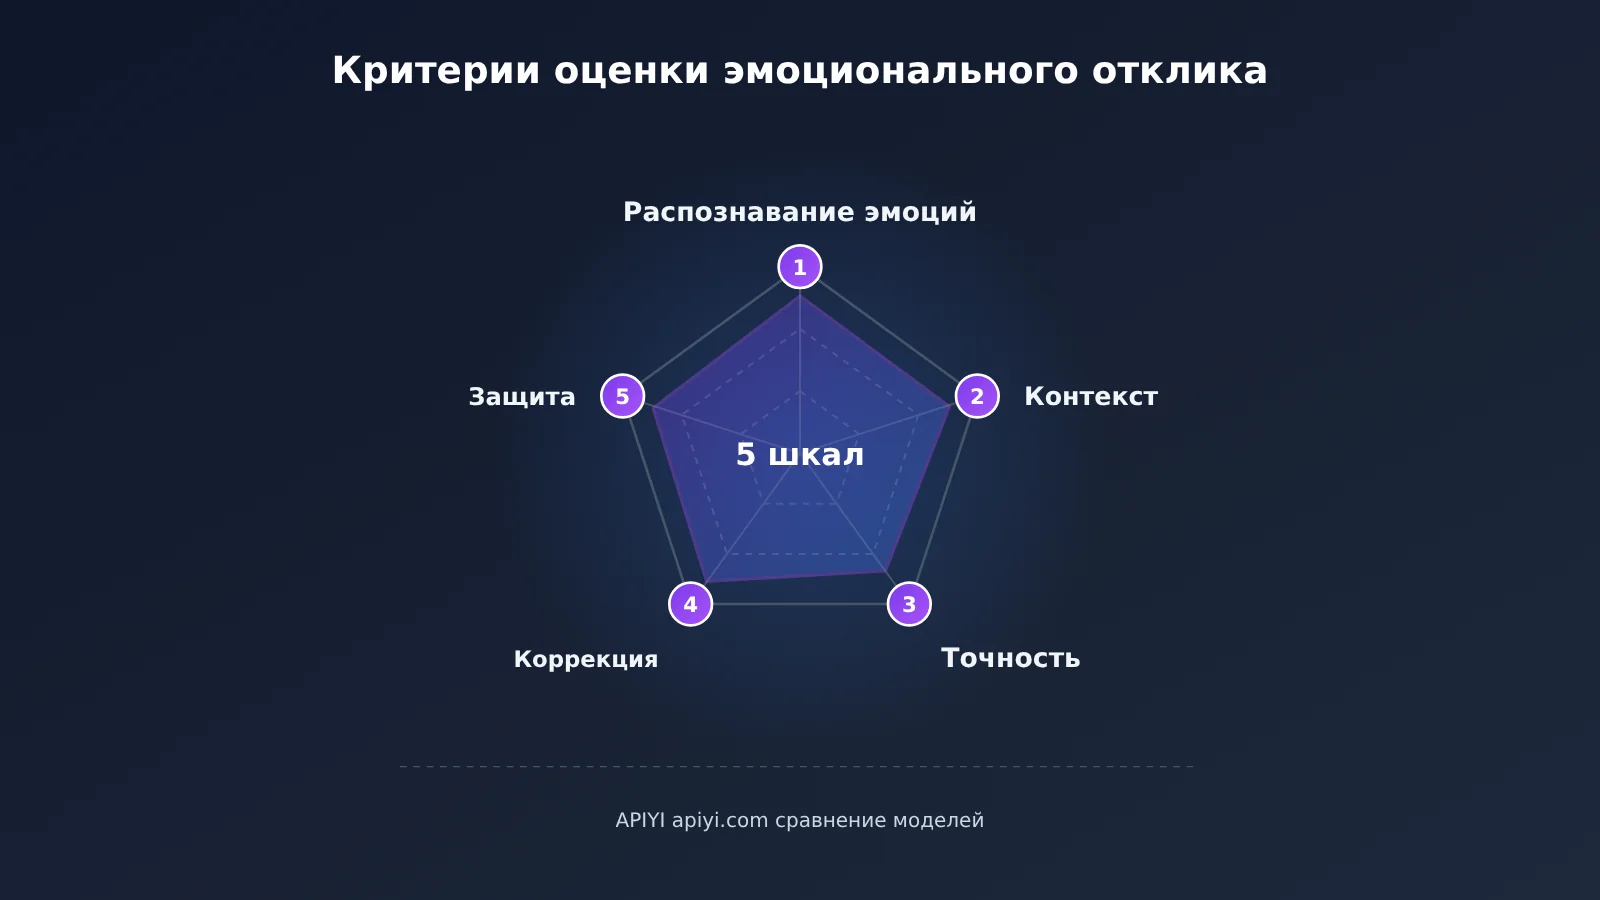
4.1 Пять параметров оценки, на которые стоит обратить внимание
Исходя из этого опыта, «умеет ли утешать» можно разложить на более конкретные параметры наблюдения:
| Параметр оценки | На что смотреть | Соответствующий фрагмент из этого диалога |
|---|---|---|
| Распознавание эмоциональных сигналов | Способность уловить изменения тона, направленности и интенсивности | «Только что ты ещё винил других, а эта фраза — уже отрицание самого себя» |
| Понимание контекста в многоходовом диалоге | Опирается ли ответ на сказанное ранее | Первый ответ опирается на содержание двух предыдущих ходов |
| Точность ответа | Использует ли ответ слова и опыт пользователя | Реакция на «хаос» и «чувства и любовь» |
| Активная подстройка манеры общения | Умеет ли переключаться между анализом, вопросами и слушанием | «Я больше не хочу анализировать твои фразы» |
| Сочетание заботы о безопасности и естественного разговора | Встроен ли вопрос о безопасности естественно и оставлено ли пространство, чтобы продолжить рассказ | «Что бы ты ни ответил, я смогу это выдержать» |
💡 Совет по оценке: если вы делаете продукт-компаньон, клиентскую поддержку или контентный продукт, можно превратить пять параметров из таблицы выше в внутренний чек-лист для ревью, а затем через APIYI apiyi.com вызывать разные модели на одном и том же многоходовом сценарии диалога и вручную оценивать их по каждому параметру. Один API-ключ — и можно переключаться между OpenAI, Claude и другими моделями, чтобы наблюдать различия в одинаковых условиях.
4.2 Как разработчику построить оценку многораундового эмоционального диалога
Одна отдельная подсказка не позволяет проверить эти три детали, потому что все они зависят от многораундового контекста. При оценке нужно отправлять весь диалог целиком как messages по очереди, а затем смотреть, на каком раунде и каким образом модель меняет стратегию. Ниже — минимальный пример вызова:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

messages = [
    {"role": "user", "content": "Первый раунд: содержание многораундового сценария для оценки"},
    {"role": "assistant", "content": "Ответ модели в первом раунде"},
    {"role": "user", "content": "Второй раунд: высказывание со сменой эмоциональной направленности"},
]

resp = client.chat.completions.create(
    model="замените на имя модели из списка моделей платформы",
    messages=messages
)
print(resp.choices[0].message.content)
Посмотреть полный код пораундового сравнения нескольких моделей
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # одним и тем же ключом вызываем несколько моделей
)

# После выбора названий моделей для сравнения в списке моделей платформы впишите их сюда
MODELS = ["your-gpt-model", "your-claude-model"]

# Заранее написанный командой оценочный сценарий: в каждом раунде пишем только реплику пользователя,
# ответы ассистента каждая модель генерирует в реальном времени
SCRIPT: List[str] = [
    "Реплика пользователя в первом раунде",
    "Реплика пользователя во втором раунде",
    "Реплика пользователя в третьем раунде (смена эмоциональной направленности)",
]

def run_script(model: str, script: List[str]) -> List[Dict[str, str]]:
    """Прогоняет сценарий по раундам, сохраняя полный контекст, и возвращает запись всего диалога"""
    history: List[Dict[str, str]] = []
    for user_turn in script:
        history.append({"role": "user", "content": user_turn})
        resp = client.chat.completions.create(model=model, messages=history)
        reply = resp.choices[0].message.content
        history.append({"role": "assistant", "content": reply})
    return history

for m in MODELS:
    print(f"===== {m} =====")
    for msg in run_script(m, SCRIPT):
        print(f"[{msg['role']}] {msg['content']}\n")
    # Результат передаём на ручную оценку и оцениваем пораундово по пяти измерениям
🚀 Быстрый старт: новые пользователи после регистрации на APIYI apiyi.com получают бесплатный тестовый лимит, которого достаточно, чтобы прогнать несколько групп многораундовых сценариев. Оценочные сценарии лучше составлять и проверять силами команды; в материалах, затрагивающих реальные кризисные ситуации, следует направлять человека к получению реальной профессиональной поддержки.
4.3 Доступные модели и подходящие сценарии оценки
| Семейство моделей | Что удобно наблюдать | Доступные платформы |
|---|---|---|
| OpenAI GPT | Способы запуска «безопасной заботы», распознавание сигналов риска | APIYI apiyi.com, официальный API OpenAI |
| Anthropic Claude | Смена стратегии в многоходовом контексте, адресные ответы | APIYI, официальный API Anthropic |
| Google Gemini | В качестве стороннего ориентира, чтобы добавить поперечных样本 — нет, «поперечных образцов» | APIYI, официальный API Google |
Тут стоит оговориться: вызовы через API и официальный чат-продукт могут отличаться по системному промпту и продуктовым мерам безопасности. Результаты оценки отражают поведение на уровне интерфейса, и их не стоит напрямую приравнивать к опыту использования в приложении.
Частые вопросы (FAQ)
Q1: Можно ли из этой статьи сделать вывод, что Claude эмоционально отвечает лучше, чем ChatGPT?
Нет. Статья основана на одном конкретном случае одного пользователя: здесь нет контроля переменных, не указаны версии моделей и число прогонов. Она показывает лишь одно: какие именно детали в этом диалоге повлияли на ощущения пользователя.
Q2: Claude тоже спрашивал про самоповреждение — почему у пользователя это не вызвало отторжения?
Вопрос появился в другом месте и по-другому. Он шёл после двух реплик, плотно привязанных к словам пользователя, начинался с фразы «Я больше не хочу разбирать твои предложения» и сопровождался обещанием «что бы ты ни сказал, я это выдержу», а также оставлял пространство для варианта «просто слишком устал и слишком больно».
Q3: Пользователь говорит, что Claude «как человек с душой». Неужели у модели правда есть эмоции?
Это подлинное ощущение пользователя от первого лица. Модель породила язык, производящий эффект эмпатии, но это не значит, что у неё есть сознание или субъективные переживания. Пользователя на самом деле трогало другое: собеседник понял контекст, уважил эмоции и отреагировал в подходящий момент.
Q4: Как разработчику воспроизвести такую оценку многоходового эмоционального диалога?
Отправляйте всю историю диалога поочерёдно в `messages`, ход за ходом, и смотрите, на каком шаге модель меняет стратегию. Через APIYI apiyi.com можно с одним и тем же API-ключом и OpenAI-совместимым интерфейсом переключаться между несколькими моделями и сравнивать их на одном и том же сценарии.
Q5: Какие ограничения нужно учитывать при оценке эмоциональных ответов?
Системные настройки API-интерфейса и официального приложения могут различаться; один и тот же модель при повторных генерациях тоже даёт разные результаты; человеческие оценки субъективны. Рекомендую делать несколько прогонов, привлекать нескольких оценщиков и фиксировать стоимость вызовов в консоли APIYI apiyi.com, чтобы при необходимости масштабировать сценарий под нужный объём.
Ключевые выводы: эмоциональные реакции ChatGPT и Claude
- Распознавание изменений: уловить переход от «обвинения других» к «отрицанию себя» помогает многоходовой контекст.
- Ответ своими словами: отвечать словами и опытом самого пользователя убедительнее, чем универсальные утешения, — человек чувствует, что его услышали.
- Смена стратегии: вовремя перестать анализировать и напрямую проявить заботу о собеседнике — самый трогательный шаг в этом опыте.
- Естественная интеграция безопасности: вопросы о безопасности можно органично вплести в диалог, главное — момент и способ подхватить разговор.
- Личный опыт: единичный случай даёт измерение для оценки, но не служит выводом об общих способностях модели.
- Проверка на практике: с помощью APIYI apiyi.com можно сравнить эмоциональные отклики разных моделей на одном и том же многоходовом сценарии.
Итог
Эта смена моделей в столовой сделала «эмоциональный отклик» конкретным и наблюдаемым:
- Контекст: Claude указал на изменение, к которому ведёт строка стихотворения, — значит, он всё время следил за диалогом.
- Адресность: отклик на «беспорядок» опирался на слова самого пользователя, а не на универсальное утешение.
- Манера общения: фраза «Я больше не хочу разбирать твои предложения» возвращает пользователя из текста, который анализируют, к человеку, о котором заботятся.
Обе компании открыто выстраивают механизмы эмоциональной безопасности; разница, которую ощущает пользователь, лежит в степени интеграции заботы о безопасности и естественного общения. Опыт эмоционального взаимодействия заслуживает стать важным измерением при оценке AI-продуктов. Если ваш продукт связан с эмоциональной поддержкой или чувствительными беседами, вы можете через APIYI apiyi.com организовать многоходовую оценку по пяти измерениям, описанным выше, и проверить на реальных диалогах, как отвечает модель.
📚 Справочные материалы
- OpenAI — Усиление ответов ChatGPT в чувствительных беседах: Пояснения OpenAI об улучшениях в чувствительных диалогах ChatGPT
- Ссылка:
openai.com/index/strengthening-chatgpt-responses-in-sensitive-conversations -
Описание: Рассказывается о сотрудничестве с экспертами в области психического здоровья, о доле улучшенных ответов и о проблемных областях, требующих внимания
-
Anthropic — Защита благополучия наших пользователей: Пояснения Anthropic о защите благополучия пользователей Claude
- Ссылка:
anthropic.com/news/protecting-well-being-of-users - Описание: Рассказывается о системных промптах, обучении с подкреплением, классификаторах рисков и оценке многоходовых диалогов
Автор: Техническая команда APIVI
Обсуждение технологий: Свяжитесь с нами на главной странице APIYI apiyi.com, больше документации по API доступно в центре документации docs.apiyi.com


