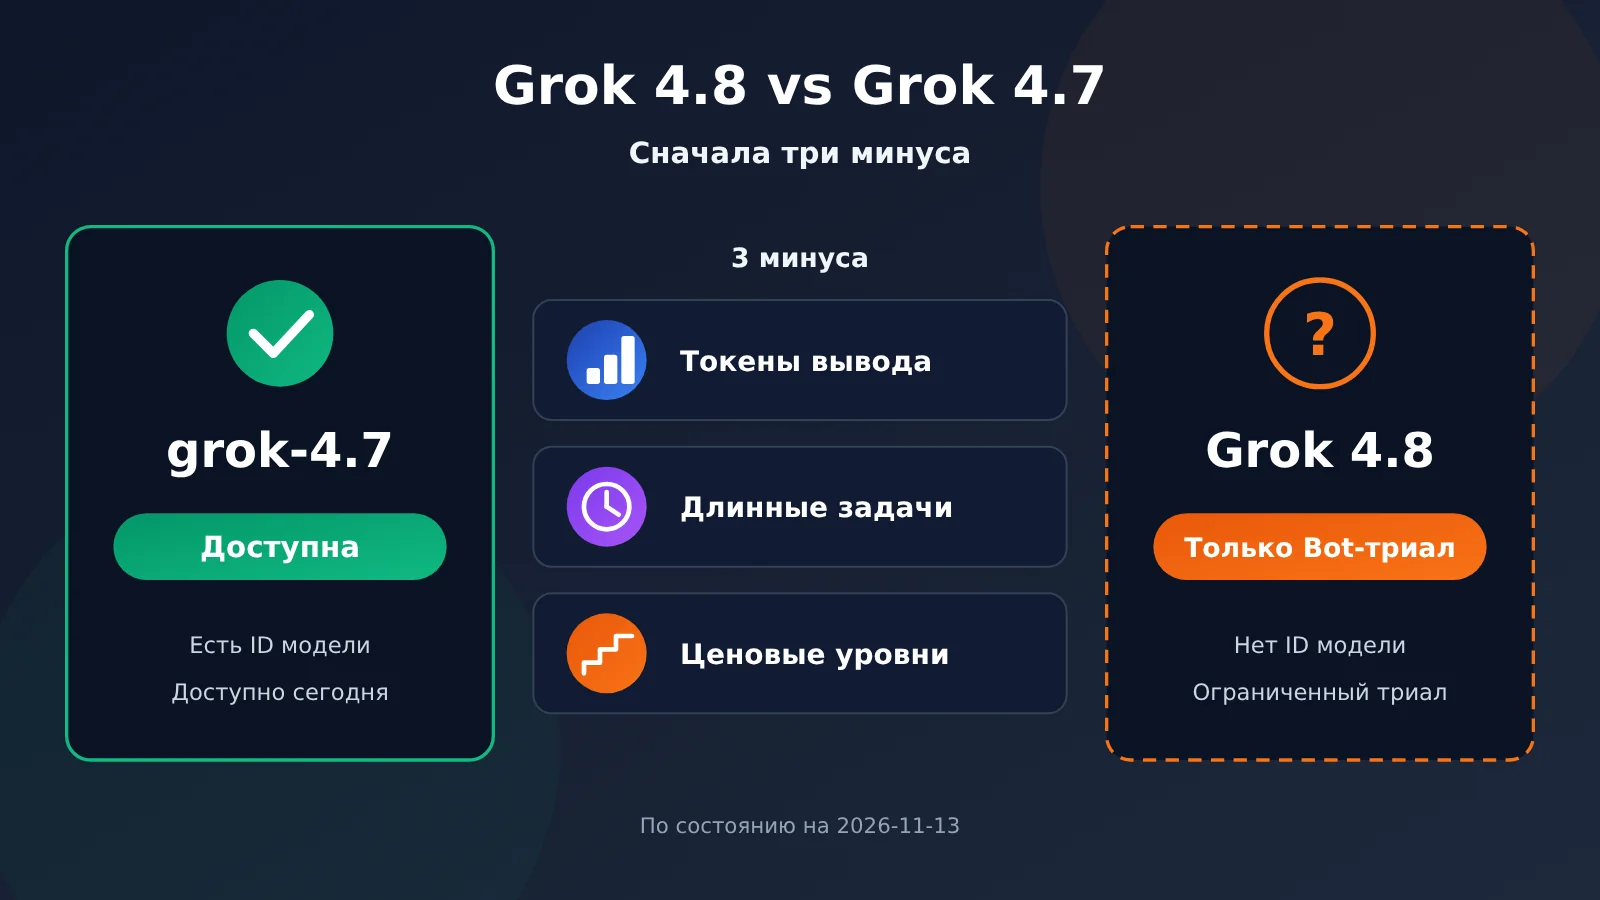
Примечание автора: сегодня нужно вызывать API, поэтому продолжаем использовать grok-4.7. У Grok 4.8 по состоянию на 2026-11-13 всё ещё нет ID модели. В этой статье проверяем по источникам 3 слабых места Grok 4.7 и смотрим, есть ли доказательства, что 4.8 их уже закрыл.
Если вы уже вызываете grok-4.7 в продакшене, скорее всего, недавно думали об одном: стоит ли остановиться и подождать Grok 4.8. Сразу к выводу: если сегодня нужно обращаться к API, используйте grok-4.7. По состоянию на 2026-11-13 у Grok 4.8 нет ID модели, нет карточки модели, нет оценок в рейтингах и нет цены. «На этой неделе» от Маска — это лишь ограниченное тестирование (soft rollout) для пользователей Grok Bot, а не открытие API.
Это не анонс в духе «новая версия обязательно сильнее». Здесь мы сопоставляем только три слабых места, которые можно подтвердить по открытым данным Grok 4.7. У каждого указан источник: официальные данные самой компании, независимый рейтинг или прямая цитата Маска. А затем смотрим, есть ли сейчас доказательства, что Grok 4.8 их закрывает.
Главная ценность: после прочтения вы поймёте, в чём именно слабые места Grok 4.7 и на чьих данных они основаны, а также как до выхода Grok 4.8 держать затраты под контролем с оглядкой на порог в 200 000 токенов.
Grok 4.8 против Grok 4.7: что выбрать сегодня
Это сравнение не похоже на привычные разборы «новая версия против старой». О Grok 4.8 сейчас есть лишь пара фраз Маска в X и ни одной оценки, которую можно было бы перепроверить. Поэтому «сравнение» здесь означает вот что: у Grok 4.7 есть слабые места, зафиксированные в открытых данных, а у Grok 4.8 есть известные изменения — и нужно понять, закрывают ли они эти слабые места.
| Ваша ситуация | Рекомендация | Причина |
|---|---|---|
| На этой неделе запуск или смена интерфейса | Используйте grok-4.7 | В списке моделей платформы есть только grok-4.7 |
| Оцениваете долгосрочный выбор | Сначала прогоните базовый тест на grok-4.7 | У 4.8 нет рейтингов, сравнивать не с чем |
| Хотите попробовать 4.8 в числе первых | Следите за списком моделей платформы | Мягкий запуск бота — это не то же самое, что доступный API |
| Очень требовательны к длительным задачам | Не делайте ставку на 4.8 | Нет доказательств, что разрыв в длительных задачах сократился |
Нужно пояснить: «Bot users» — это пользователи Grok Bot, а не аппаратные роботы. «soft rollout» — это ограниченный запуск, а не интерфейс, открытый для разработчиков. Если воспринять это как «модель, которую уже можно подставить в ID», вы получите ошибку при вызове.
Ключевые различия Grok 4.8 и Grok 4.7: откуда взялись 3 слабых места
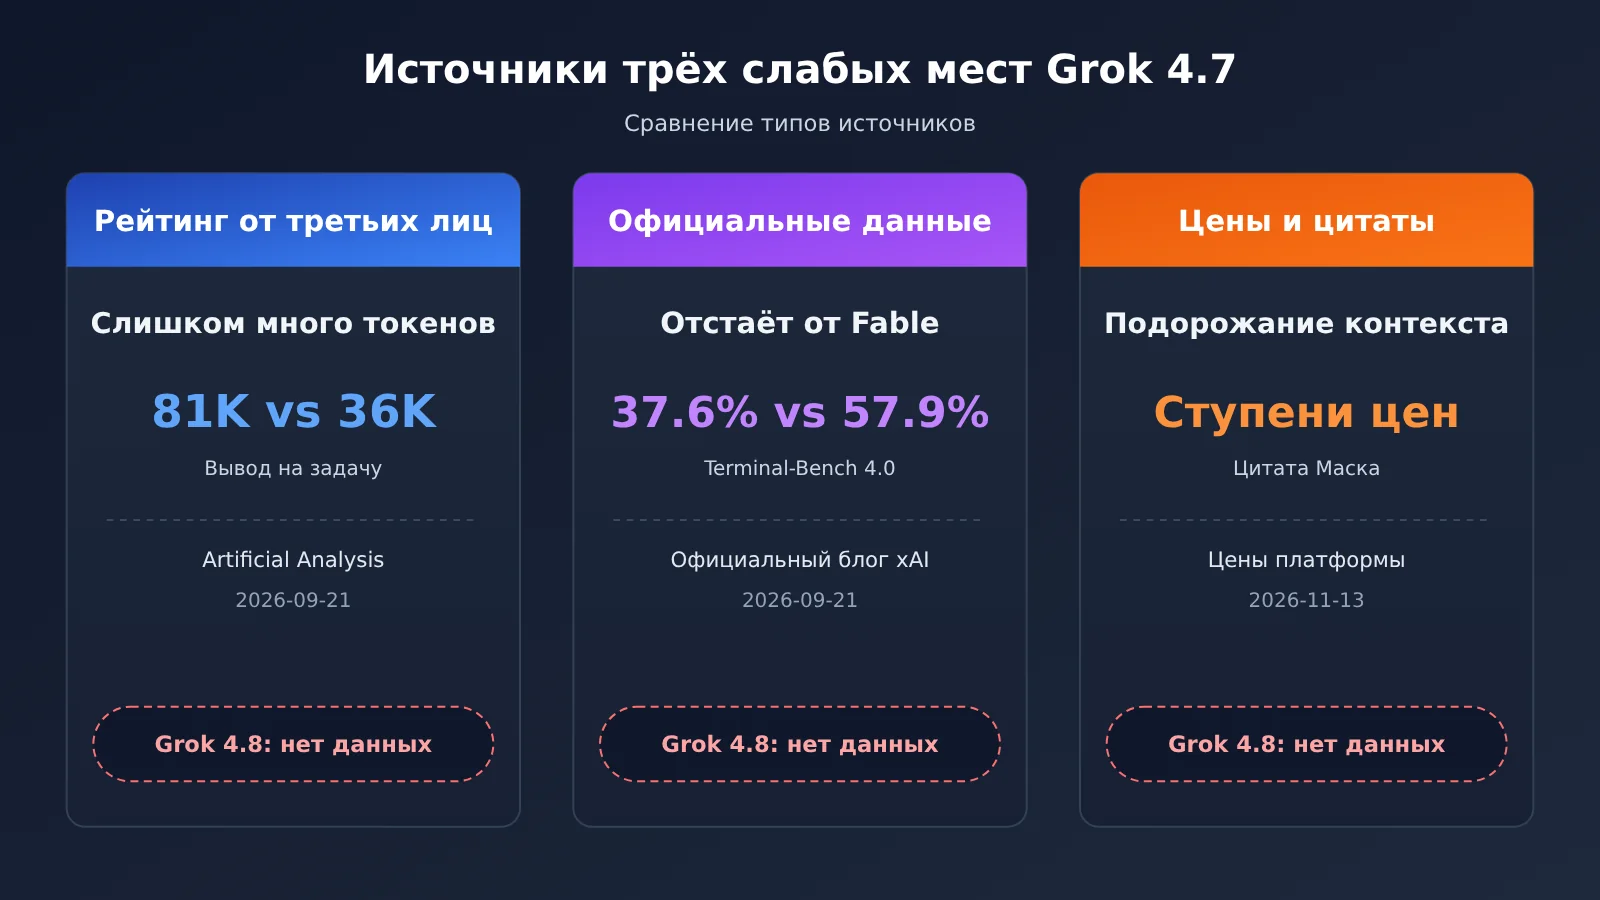
В таблице ниже сначала перечислены типы источников для каждого из трёх слабых мест. Дальше разбираем строго в этом же порядке.
| Слабое место | Тип источника | Дата источника | Есть ли у Grok 4.8 доказательства, что это закрыто |
|---|---|---|---|
| Завышенный объём выходных токенов | Сторонний рейтинг (Artificial Analysis) | 2026-09-21 | Нет |
| Отставание от Fable в многочасовых задачах | Официальные данные (таблица в блоге xAI) | 2026-09-21 | Нет |
| Подорожание длинного контекста по уровням + Маск не признаёт проблему в основе | Прайс-лист платформы + цитата Маска | 2026-11-13 / 2026-11-10 | Нет |
Слабое место №1: у Grok 4.7 завышен объём выходных токенов (сторонний рейтинг)
Источник здесь — обзор Grok 4.7, опубликованный Artificial Analysis 21 сентября 2026 года. Это сторонний рейтинг, а не официальные данные и не тесты автора статьи. Тестировали на уровне xhigh: индекс интеллекта Grok 4.7 составил 46, на 2 балла выше, чем у Grok 4.6. Оценка выросла, но ценой стало заметное увеличение объёма выходных токенов.
В той же публикации сравнение объёма вывода выглядит так. Обратите внимание: две цифры для Grok 4.6 относятся к разным уровням, их нельзя объединять в одну:
- Grok 4.7 (xhigh): около
81,000выходных токенов на каждую задачу индекса интеллекта - Grok 4.6 (high): около
36,000выходных токенов - Grok 4.6 (xhigh): около
38,000выходных токенов; в обзоре говорится, что 4.7 тратит более чем вдвое больше - GPT-6 Astra (max): около
27,000выходных токенов
Чтобы оценить масштаб, можно грубо посчитать по официальной цене вывода $6 / 1M tokens: 81 000 выходных токенов — примерно $0.49, 36 000 — около $0.22. Это лишь способ пересчёта для задач из рейтинга, чтобы показать, «куда уходят деньги на одной и той же задаче», а не реальный счёт какой-либо платформы.
Artificial Analysis также указывает, что у Grok 4.7 контекст — 500K, цены $2 / $6, попадание в кеш $0.50 — всё так же, как у 4.6. То есть цена за токен не выросла, но на каждую задачу модель выдаёт больше токенов — стоимость одной задачи на деле растёт.
Слабое место №2: на многочасовых задачах Grok 4.7 всё ещё отстаёт от Fable (по собственным данным xAI)
Источник здесь — сравнительная таблица из официального блога xAI (2026-09-21), то есть данные самого производителя. Четыре колонки в заголовке — это Grok 4.7 xHigh, Grok 4.6 High, GPT-5.6 Sol Max и Fable 5.1 Max. Лучше всего разрыв на длинных задачах показывают два пункта:
- Terminal-Bench 4.0: Grok 4.7 —
37.6%, Fable 5.1 Max —57.9%(у Grok 4.6 —20.3%, у GPT-5.6 Sol —37.3%) - CursorBench 4.0: Grok 4.7 —
46.3%, Fable 5.1 Max —51.8%(у Grok 4.6 —40.4%, у GPT-5.6 Sol —41.7%)
Но официальная таблица вовсе не говорит о «тотальном отставании». Прирост Grok 4.7 относительно 4.6 вполне реальный, а на двух специализированных бенчмарках модель занимает первое место:
- EEBench: Grok 4.7 —
64.0%, выше, чем53.0%у 4.6,39.4%у GPT-5.6 Sol и56.4%у Fable 5.1 - Harvey Legal Agent Benchmark: Grok 4.7 —
19.6%, выше15.8%/2.5%/6.7% - DeepSWE v1.1: Grok 4.7 —
71.0%, официально указано high effort, а не xhigh; чуть ниже72.7%у GPT-5.6 Sol - AA Briefcase v1.1: Grok 4.7 —
1657, немного ниже1678у Fable - HealthBench Professional: Grok 4.7 —
56.7%, ниже60.5%у GPT-5.6 Sol и62.1%у Fable
| Бенчмарк из официальной таблицы | Относительно Grok 4.6 | Относительно GPT-5.6 Sol | Относительно Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | заметно выше | примерно на уровне, чуть выше | разрыв заметный |
| CursorBench 4.0 | выше | выше | ниже |
| DeepSWE v1.1 | выше | чуть ниже | чуть выше |
| EEBench | выше | выше | выше |
| Harvey Legal Agent | выше | выше | выше |
| HealthBench Professional | выше | ниже | ниже |
Есть ещё один набор данных от стороннего рейтинга, и его нужно помечать отдельно. По оценке Artificial Analysis, относительно Grok 4.6 модель Grok 4.7 прибавляет 4.5 пункта на Terminal-Bench 4.0 и 3.0 пункта на GDP.pdf, но теряет 3.7 пункта на AA-LCR и 1.1 пункта на AutomationBench-AA. Эти «+4.5 пункта» и 37.6% против 20.3% из официальной таблицы — не одна и та же абсолютная шкала, смешивать их нельзя.
Слабое место №3: тарифные ступени Grok 4.7 и слова Маска (прайс + цитаты)
В третьем слабом месте две части: цена длинного контекста и отношение самого Маска к 4.7. Сначала о цене. Сводная таблица платформы и интерфейс прайса не полностью совпадают в том, что касается контекста свыше 200 тыс. токенов:
| Позиция прайса | Сводная таблица моделей платформы | Интерфейс прайса billing_expr |
|---|---|---|
| Ввод / вывод / чтение кэша ≤ 200 тыс. токенов | Указано | Указано, совпадает со сводной таблицей |
| Ввод свыше 200 тыс. | Указано | Указано, совпадает со сводной таблицей |
| Вывод свыше 200 тыс. | Отдельно не указано | Указано |
| Чтение кэша свыше 200 тыс. | Отдельно не указано | Указано |
Конкретные цифры ниже; данные о ценах на 2026-11-13, единица — за 1 млн токенов:
- Низкая ступень (0–200 000 токенов): ввод
$2, вывод$6, чтение кэша$0.5; сводная таблица и выражение прайса совпадают - Высокая ступень (200 001–500 000 токенов), ввод:
$4; сводная таблица и выражение прайса совпадают - Высокая ступень, вывод: в выражении прайса
$12; в ступенях сводной таблицы не указано - Высокая ступень, чтение кэша: в выражении прайса
$1; в ступенях сводной таблицы не указано
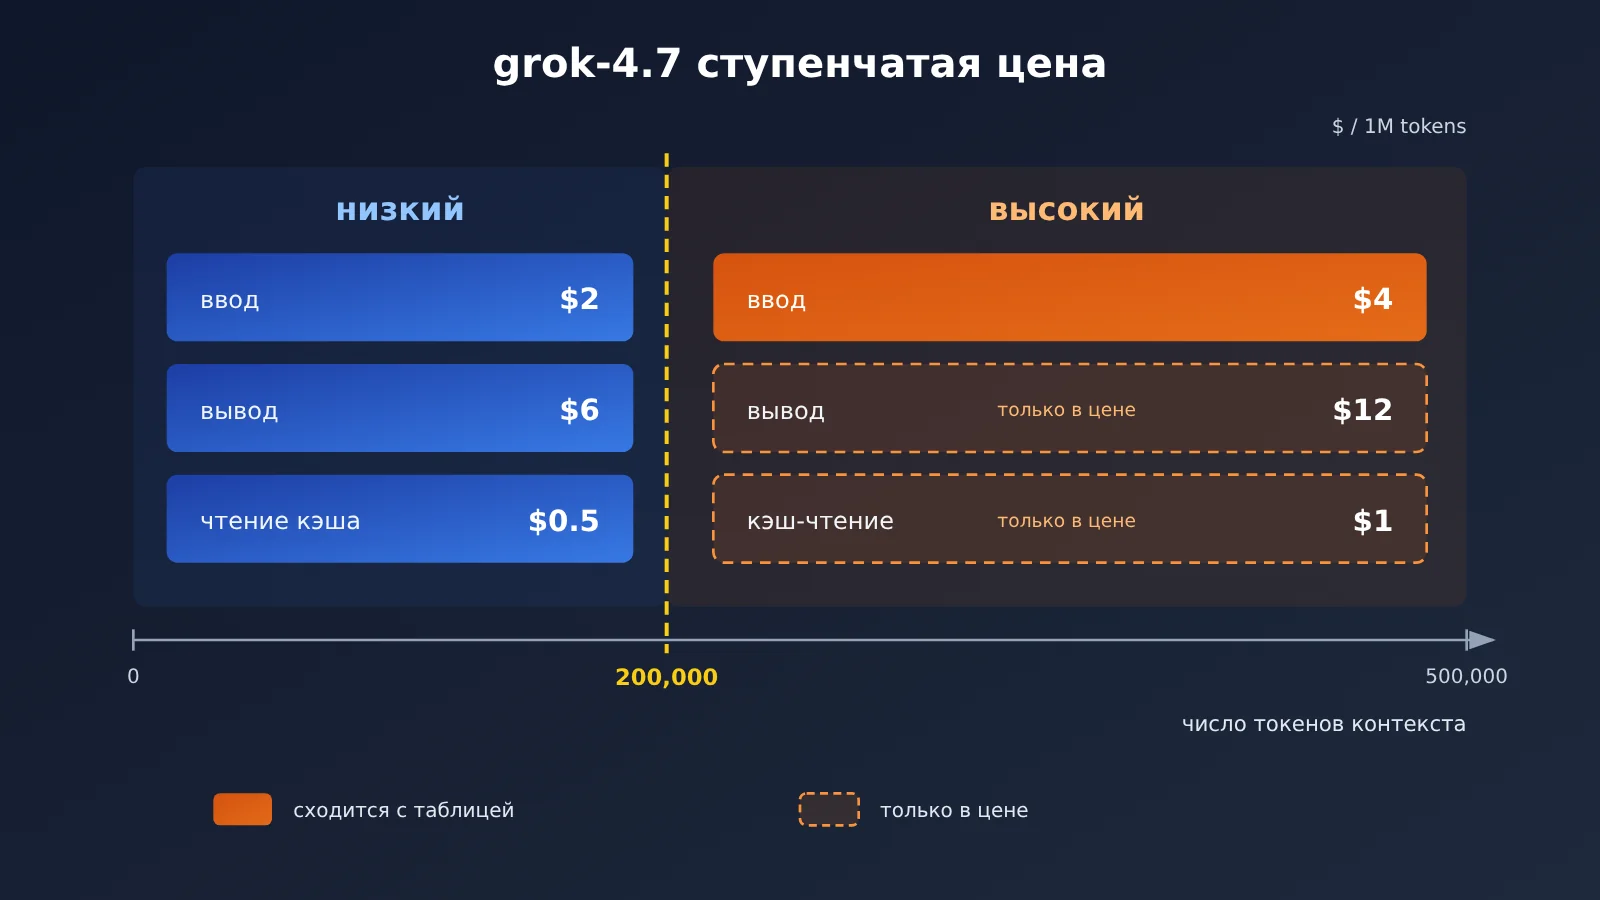
Данные о ценах на схеме выше взяты из интерфейса прайса и сводной таблицы моделей APIYI apiyi.com, сверка на 2026-11-13; ориентируйтесь на список моделей платформы.
Теперь о цитатах. 2026-11-10 в 17:35 Маск написал в X, что Grok 4.8 «will bear no resemblance to 4.7 (thankfully). It is not yet incredible». В тот же день в 18:22 он в ответе добавил: «Not as good. Opus 5.5 is a masterpiece», то есть 4.8 всё ещё хуже Opus 5.5. Он также ожидает, что Grok 5 сможет превзойти Opus 5.5 через два-три месяца.
Это отношение, а не оценка Grok 4.8. Когда основатель говорит, что новая версия «не будет иметь ничего общего с 4.7 (к счастью)», это говорит лишь о том, что он не принимает базу 4.7; из этого не следует, что 4.8 уже стала лучше по трём упомянутым слабым местам.
Сможет ли Grok 4.8 закрыть эти 3 слабых места?
Сказать можно только то, что было в оригинальном посте Маска. Он упомянул, что отказались от JAX/SGLang и с нуля переписали стек обучения с подкреплением (RL) и инференса на C/C++; предварительное обучение завершено; данные SFT сильно почистили; 4.8 сейчас находится на стадии RL, «evals are starting to climb». В посте не названо ни одного бенчмарка или оценки, а также нет числа параметров.
Если сопоставить эту информацию с тремя слабыми местами, вывод получается очень осторожным:
- Слишком много выходных токенов: стадия RL действительно может влиять на длину вывода, но он не упомянул эффективность по токенам.
- Отставание в длинных задачах от Fable: ни Terminal-Bench, ни CursorBench не упомянуты, данных по длинных задачам тоже нет.
- Цена за 200 тыс. токенов и выше: никакой информации о цене, 4.8 тоже не появился ни в одном прайс-листе.
Так что догадки могут оставаться только на уровне «переписали RL и стек инференса, плюс почистили данные SFT». Сейчас нет доказательств, что эти три слабых места уже закрыты. Смысл сравнивать пункт за пунктом появится, когда у 4.8 будет карточка модели и сторонние бенчмарки.
Работа с grok-4.7: как разложить 200 тыс. токенов по уровням
До выхода 4.8 на платформе самый практичный подход — как следует взять под контроль стоимость grok-4.7. Ключевой момент — порог в 200 тыс. токенов: стоит входу его превысить, и цена за единицу сразу удваивается, а по формуле из прайс-листа удваиваются ещё и выход, и чтение кеша. Ниже — практическая информация о подключении и рекомендации по уровням:
- ID модели:
grok-4.7, эндпоинт — chat, группы:CodexResponses,Default,SVIP - Адрес API: формат, совместимый с OpenAI; в base_url укажите
https://api.apiyi.com/v1, в model —grok-4.7, и всё готово - Контроль нижнего уровня: контекст одного запроса старайтесь держать в пределах
200,000токенов; вместо того чтобы вставлять весь документ целиком, используйте резюме и фрагменты из поиска - Бюджет верхнего уровня: если длинный контекст действительно нужен, считайте по входу
$4, выходу$12и чтению кеша$1, и обратите внимание на несоответствие — в сводной таблице не указан выход для верхнего уровня - Длина вывода: с учётом первого недостатка задавайте max_tokens для тех задач, где это нужно, чтобы на высоком уровне рассуждений вывод не вышел из-под контроля
Модели и цены — по списку моделей на платформе; актуальную информацию можно посмотреть на docs.apiyi.com/models. В официальном блоге ещё упоминается fast-вариант Grok 4.7: скорость вывода примерно вдвое выше, и цена примерно вдвое выше, но в сводной таблице платформы нет отдельного ID модели fast — при вызове не придумывайте его сами.
🚀 Быстрый старт: после выхода grok-4.8 APIYI apiyi.com как можно скорее добавит эту модель на платформу. А до тех пор на том же API-ключе прогоните базовую линию grok-4.7 — когда 4.8 станет доступна, для сравнения хватит поменять один параметр model.
Grok 4.8 против Grok 4.7: рекомендации по сценариям
Где стоит продолжать работать с Grok 4.7
- Профессиональные задачи в юриспруденции и инженерии: в официальной таблице Grok 4.7 занимает первое место по двум пунктам — EEBench и Harvey Legal Agent, так что для таких задач ждать нет смысла.
- Задачи, где контекст укладывается в 200 тыс. токенов: можно стабильно оставаться на нижнем тарифе, цена за единицу такая же, как у 4.6.
- Проекты, которые нужно запустить прямо сейчас: grok-4.7 — единственная версия, доступная для вызова в данный момент.
Где стоит присмотреться к Grok 4.8 и подождать
- Многочасовые агенты / длительные задачи в терминале: разрыв по Terminal-Bench 4.0 и Fable 5.1 заметный, так что можно параллельно оценить другие модели как запасной вариант.
- Пакетные задачи, чувствительные к стоимости выходных токенов: сторонние рейтинги показывают, что у 4.7 вывод слишком длинный; если 4.8 это исправит, затраты сразу снизятся, но пока подтверждений нет.
- Приложения, сильно завязанные на контекст свыше 200 тыс. токенов: цена верхнего тарифа удваивается, так что стоит следить за тем, как будут считать стоимость после появления 4.8.
Grok 4.8 против Grok 4.7: рекомендации по принятию решений
| На что смотреть | Что делать сейчас | Когда пересматривать |
|---|---|---|
| Стабильность запуска | Использовать grok-4.7 | Когда 4.8 появится в списке моделей платформы |
| Стоимость одной задачи | Контролировать длину контекста и вывода | Когда появятся сторонние данные о расходе токенов у 4.8 |
| Возможности на длинных задачах | Параллельно оценивать альтернативные модели | Когда выйдут оценки 4.8 по Terminal-Bench и другим бенчмаркам |
| Прозрачность цен | Бюджетировать по данным интерфейса цен | Когда в общей таблице платформы появится цена вывода верхнего тарифа |
💡 Рекомендация по выбору: какую версию брать, зависит от того, относится ли ваша задача к длинным и часто ли вы переваливаете за 200 тыс. токенов контекста. Советую через APIYI apiyi.com прогнать собственные примеры на одном и том же API и уже потом решать, переводить ли длинные задачи на другие модели.
Частые вопросы (FAQ)
Q1: Можно ли уже вызывать Grok 4.8 через API?
Нет. По состоянию на 2026-11-13 у Grok 4.8 нет model ID: и в общем каталоге моделей платформы, и в интерфейсе тарифов есть только grok-4.7. Анонсированный Маском на этой неделе «мягкий» запуск доступен только пользователям Grok Bot.
Q2: Кто сильнее — Grok 4.8 или Grok 4.7?
Пока судить невозможно. У Grok 4.8 нет ни одного публичного лидерборда или оценки: Маск лишь говорит, что «бенчмарки подрастают», «пока не впечатляет» и «слабее Opus 5.5». Это отношение, а не сопоставимые данные.
Q3: Откуда взялось утверждение, что Grok 4.7 выдаёт много output-токенов?
Из стороннего теста Artificial Analysis от 2026-09-21, уровень тестирования — xhigh. Около 81 тыс. output-токенов на задачу против 36 тыс. у 4.6 high и 38 тыс. у 4.6 xhigh. Это не официальные данные.
Q4: Стал ли Grok 4.7 по всем параметрам хуже Grok 4.6?
Нет. В официальной таблице Grok 4.7 опережает 4.6 по целому ряду пунктов — Terminal-Bench, CursorBench, EEBench и другим. Сторонние лидерборды показывают отставание на 3,7 пункта в AA-LCR и на 1,1 пункта в AutomationBench-AA — то есть просадка по отдельным метрикам.
Q5: Как вызвать grok-4.7 уже сейчас?
Зарегистрируйтесь в APIYI (apiyi.com) и получите API-ключ — новым пользователям дают бесплатный тестовый лимит. Используйте SDK с совместимостью с OpenAI: в base_url укажите адрес интерфейса платформы, в model — grok-4.7.
Q6: Как всё-таки тарифицируется вывод свыше 200 тыс. токенов?
В выражении цены указано $12 за вывод и $1 за чтение кэша; в ступенчатой таблице сводного каталога прописана только входная цена высокого тарифа — $4, а выходная отдельно не указана. Две записи согласуются не полностью, поэтому при планировании бюджета лучше консервативно считать по выражению цены и сверяться со списком моделей платформы.
Q7: Как мигрировать, когда Grok 4.8 появится на платформе?
В ленте актуальных обновлений платформы записи о появлении Grok 4.8 пока нет. Обычно после релиза достаточно заменить параметр model, но сначала стоит прогнать одну и ту же выборку примеров и сравнить output-токены, долю успешно решённых длинных задач и стоимость по тарифным ступеням — и только потом переключать трафик.
Grok 4.8 против Grok 4.7: ключевые выводы
- Выбор на сегодня: если нужно дёргать API — берём grok-4.7, у Grok 4.8 пока нет model ID.
- Минус первый (сторонний рейтинг): при xhigh около 81 тыс. выходных токенов на задачу — многовато.
- Минус второй (по данным самой компании): в Terminal-Bench и CursorBench всё ещё отстаёт от Fable 5.1.
- Но это не полный провал: в EEBench и Harvey Grok 4.7 занимает первое место.
- Минус третий (прайс + цитата): при входе свыше 200 тыс. токенов цена удваивается, а Маск не признаёт базу 4.7.
- Что известно об изменениях в 4.8: переписаны RL и стек инференса, почищен SFT — доказательств, что три минуса закрыты, нет.
- Как начать: через APIYI apiyi.com сначала прогнать baseline на grok-4.7, а когда 4.8 появится — сравнить напрямую.
Итог
Главное по сравнению Grok 4.8 и Grok 4.7:
- Доступность: по состоянию на 2026-11-13 вызывать можно только grok-4.7 — мягкий запуск бота не равен открытому API.
- Три минуса: слишком много выходных токенов (сторонний рейтинг), отставание от Fable на длинных задачах (данные самой компании), подорожание на длинном контексте и слова основателя (прайс и цитата) — у каждого свой источник.
- Доказательства по 4.8: пока только разговоры о переписанных RL и стеке инференса плюс чистке SFT — ни цифр, ни цен, ни model card.
Вместо того чтобы сидеть и ждать, лучше сначала навести порядок с разбивкой по контексту и длиной вывода у grok-4.7, а когда по 4.8 появятся проверяемые данные — сравнить по пунктам. Рекомендую через APIYI apiyi.com на едином интерфейсе сначала проверить, как grok-4.7 ведёт себя в ваших задачах, — это оставит вам baseline для будущего переключения.
📚 Справочные материалы
- Официальный блог xAI — выпуск Grok 4.7: опубликованная самой компанией таблица сравнения бенчмарков и цены
- Ссылка:
x.ai/news/grok-4-7 -
Описание: источник данных по Terminal-Bench 4.0, CursorBench 4.0, EEBench и другим
-
Artificial Analysis — оценка Grok 4.7: сторонний рейтинг с указанием расхода выходных токенов
- Ссылка:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
Описание: индекс интеллекта, сопоставление выходных токенов, изменения по AA-LCR и другим пунктам
-
Пост Маска в X (2026-11-10): дословные высказывания о прогрессе Grok 4.8
- Ссылка:
x.com/elonmusk/status/2120088070443655190 -
Описание: переписывание RL и стека инференса, чистка SFT, мягкий запуск Bot
-
Ответ Маска в X (2026-11-10): высказывание о сравнении 4.8 и Opus 5.5
- Ссылка:
x.com/elonmusk/status/2120099798078656909 -
Описание: источник фразы «Not as good»
-
Сводная таблица моделей APIYI: модели grok-4.7, группы и ступенчатые цены
- Ссылка:
docs.apiyi.com/models - Описание: модели и цены берём отсюда, дата сверки — 2026-11-13
Автор: техническая команда APIYI
По техническим вопросам: обращайтесь к нам через главную страницу сайта APIYI, больше материалов — в центре документации docs.apiyi.com