
Тест письма GPT, Claude и Kimi: краткие итоги и сразу выводы
Для английских статей сначала пробуйте GPT-6.1 Sol; для длинных текстов, где важен стиль, — Claude Opus 5.5; в объяснительный научпоп стоит добавить Kimi K3. Kimi K3.1 Pro тоже очень силён в английском в целом и близок к GPT в ToneBench.
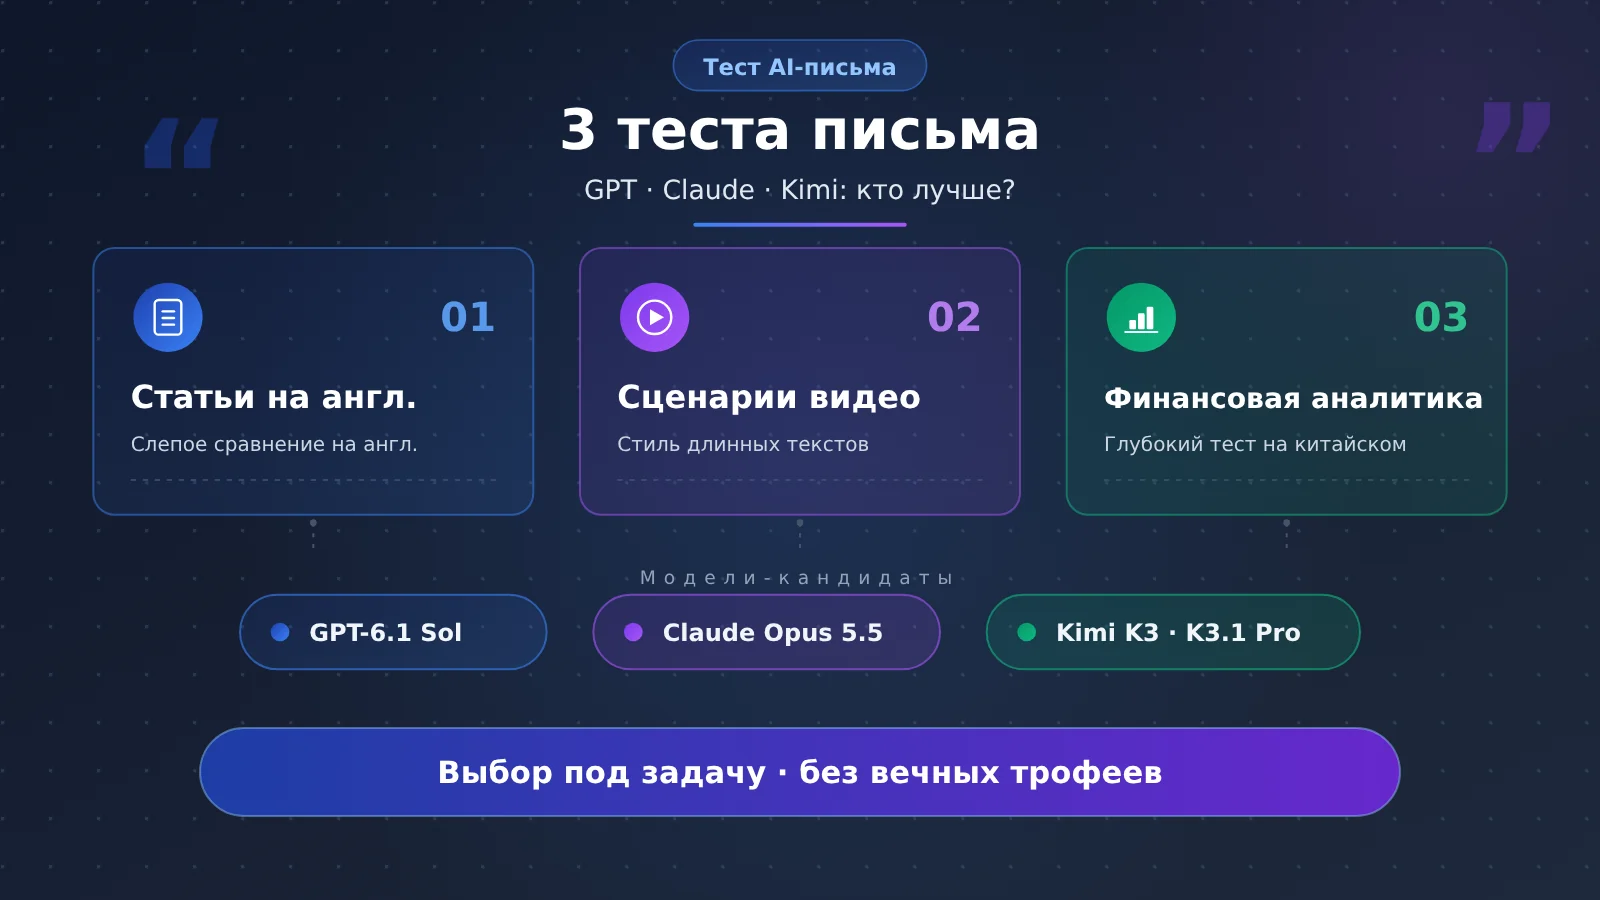
Три теста охватывают разные задачи, языки и методы оценки. Самый практичный вывод — составить список кандидатов и проверить их на собственных текстах, а не вручать одному из трёх семейств моделей вечный кубок.
Совет по началу работы: вызывать модели-кандидаты можно через единый интерфейс APIYI apiyi.com и сравнивать первые черновики на одном и том же пакете материалов. Бесплатный тестовый лимит для новых пользователей — согласно текущим правилам платформы.
Тест письма GPT, Claude и Kimi: что будет дальше?
В статье последовательно разбираются англоязычный рейтинг письма, стилизованный тест на длинном сценарии для видео и практический тест на глубокую китайскоязычную финансовую статью. В конце — выбор сценария, порядок слепого тестирования и пример вызова; главное — качество текста и трудозатраты на ручную редактуру.
Сразу договоримся о двух терминах: бенчмарк письма — это тест, в котором вывод оценивается по заранее заданной задаче; слепое оценивание — сравнение текстов при скрытой личности модели. Слепое оценивание могут проводить и люди, и модели, поэтому, читая результаты, важно понимать, кто именно был评审者.
Тест письма GPT, Claude и Kimi, часть первая: английские тексты — смотрим на GPT
AI Writing Benchmark — англоязычный проект по письму, который ведёт Johannes Eva и который заявляет, что не получал оплаты от производителей моделей. Здесь используются результаты обновления от 11 ноября 2026 года, запрошенные 12 ноября.
Проект охватывает 115 моделей и фиксирует 131 507 публичных пар слепых сравнений. Оценка письма идёт через анонимное сравнение текстов, причём рейтинг AI-评审 и рейтинг голосов людей показываются отдельно.
| Модель | Общий балл (английский) | Что показывает балл |
|---|---|---|
| GPT-6.1 Sol | 95.3 | 1-е место в общем рейтинге |
| Claude Opus 5.5 | 92.9 | 2-е место в общем рейтинге |
| Kimi K3.1 Pro | 91.9 | 3-е место в общем рейтинге |
Общий балл агрегирует несколько типов задач; балл по категории задач отражает только один тип заданий. У GPT-6.1 Sol балл в категории статей, блогов и редакционного контента — 98.5, и его нужно фиксировать отдельно от общего балла 95.3.
Это относительные баллы внутри самого бенчмарка. Проект определяет 50 как оценку вероятности «один к двум» победить среднюю для текущего языка и категории модель, поэтому читателю стоит смотреть на конкурентную позицию, а не воспринимать балл как долю контента, готового к публикации.
Если говорить прямо: если задача — англоязычный блог или редакционная статья, у GPT-6.1 Sol есть все основания попасть в первый круг тестирования. А для китайскоязычных текстов нужны отдельные китайские доказательства.
Ещё один результат, на который стоит обратить внимание: Kimi K3 лидирует в категории объяснений и научпопа с 94.9. Побеждает здесь K3, а на третьем месте общего рейтинга — K3.1 Pro, так что имя версии нужно сохранять вместе с результатом.
GPT, Claude, Kimi: тест письма, часть 2 — длинные тексты и стиль Claude
ToneBench заставляет модель прочитать творческий бриф, пакет исследовательских материалов и руководство по стилю, а затем сгенерировать полный сценарий для YouTube. Модель не видит готовый текст оригинального автора и не может выходить в интернет или обращаться к внешним инструментам.
В этой статье используются материалы, обновлённые 10 ноября 2026 года. Задача — длинный сценарий видео для конкретного автора; в предоставленных материалах не перечислены все языки заданий, поэтому здесь мы рассматриваем это в контексте работы над сценарием.
В тесте участвовали 87 моделей и 151 конфигурация, каждая конфигурация выполнила 10 заданий, и каждое задание независимо генерировалось 5 раз. Всего было создано 7 550 черновиков, а четыре AI-судьи провели 30 200 оценок.
Особое внимание уделяется соответствию стиля — тому, насколько тон, ритм и манера изложения близки к целевому автору. Вес соответствия стиля — 19%, глубины, точности и ценности контента — 15%, также оцениваются связность и контроль длины.
В таблице ниже приведены Writing Score лучшей конфигурации каждой модели и рейтинг моделей, указанный в материалах. Для Claude это xhigh; в материалах не названы конкретные конфигурации рассуждения для двух других моделей — при повторном тестировании это стоит восполнить.
| Модель | Рейтинг модели | Writing Score | Оценка стоимости одной статьи в тесте |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Writing Score — это показатель, обобщающий результаты по письму в данном тесте, а рейтинг считается по шкале Elo. Поэтому то, что у Kimi балл выше на 0,1, а позиция на одну ниже, следует понимать как близкую производительность обеих моделей.
Claude лидирует в этой группе результатов, а оценочная стоимость теста примерно в 4,2 раза выше, чем у GPT. Это оценка стоимости ToneBench, и её нельзя напрямую переносить в расценки за статью на других платформах.
Чтобы понять рейтинг, лучше поместить задания и оценивание в одну схему. При повторном тестировании через APIYI apiyi.com рекомендуется сохранять записи конфигураций, а затем возвращаться к исходному рейтингу и сверять методику сравнения.
Доверительные интервалы первого и второго мест ToneBench перекрываются, и удаление любого из эталонных сценариев тоже меняет лидера. Исследование также показало, что у судей есть определённая предвзятость к производителям, однако после исключения единичных оценок Claude всё равно остаётся первым.
Ключевой вывод: для длинных текстов, где нужно усвоить материалы и сохранить голос автора, Claude стоит пробовать первым. Этот результат подходит для выбора кандидатов, но величину преимущества всё ещё нужно проверять на собственных текстах.
Также стоит учесть, что результат GPT-6 Sol по отдельной метрике Least Slop относится к другой версии и другому показателю, и его нельзя использовать вместо Writing Score для GPT-6.1 Sol.
Тест письма GPT, Claude и Kimi, часть третья: на что смотреть в глубокой китайской статье?
Тестирование OmniTools проходило с 26 октября по 3 ноября 2026 года на материале глубоких финансово-экономических статей PANews на китайском языке. Сравнивали 10 моделей и 26 статей.
| Модель | Слепая оценка ИИ | Кол-во статей | Оценка естественности |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
В этом тесте у Claude выше и общая оценка, и естественность. Для глубоких финансовых статей на китайском Claude Opus 5.5 — кандидат, который стоит пробовать первым.
Но выборка маленькая, число статей по моделям распределено неравномерно, да и Kimi в тесте не участвовал. Поэтому эти данные могут лишь допол Understandingить свидетельства по китайскому сценарию для GPT и Claude, но полного рейтинга всех трёх моделей они не дают.
Для оценки использовались Claude Opus 5.5 и DeepSeek V4 Pro, причём действовало правило: модель не оценивает саму себя. У публикующей стороны есть коммерческая подоплёка — сервис маршрутизации API, так что при чтении стоит помнить об этом источнике.
Оценки редакторов — отдельная история. 100% принятие правок у Claude соответствует всего 1 раунду из 1, так что это скорее наблюдение-кейс; для выводов о долгосрочном принятии нужно больше материалов.
Итог в одну строку: здесь есть позитивный сигнал о том, что Claude пишет длинные финансовые статьи на китайском, и область доказательств ограничена именно этим сценарием.
Тестирование письма GPT, Claude и Kimi: выбор кандидатов по сценариям
Если собрать три результата вместе, должна получиться таблица выбора моделей, а не сумма баллов. Язык статьи, задача и целевой стиль текста определяют, какие доказательства важны именно для вас.
| Сценарий письма | Приоритетные кандидаты | Основание для выбора |
|---|---|---|
| Англоязычные блоги, редакционные статьи | GPT-6.1 Sol | Лидирует в категории англоязычных статей |
| Длинные сценарии видео в авторском стиле | Claude Opus 5.5 | Сейчас лидирует по ToneBench |
| Углублённые финансовые материалы на китайском | Claude Opus 5.5 | Лидирует в небольших практических тестах на китайском |
| Англоязычные объяснения, научпоп | Kimi K3 | Лидирует в категориях объяснений и научпопа |
| Длинный контент на основе подборки материалов | Совместное слепое тестирование всех трёх | GPT и Kimi близки по ToneBench |
| Платформа для проверки вызовов моделей | APIYI apiyi.com | Единый интерфейс упрощает переключение моделей |
Китайские технические руководства, описания продуктов и подобные сценарии пока не полностью покрыты тремя имеющимися наборами доказательств. Надёжнее — тестировать кандидатов одновременно и смотреть, кто может понятно объяснить техническую тему и точно изложить факты.
Тест письма GPT, Claude и Kimi: как самостоятельно провести сравнение?
Советуем выбрать реальную тему и дать всем моделям абсолютно одинаковые материалы, план, объём и права доступа к инструментам. Каждую модель запускайте независимо как минимум три раза, скройте названия моделей и передайте результаты редактору на оценку.
Оценку можно начать с пяти критериев: фактическая точность, следование плану, естественность изложения, ясность структуры и ценность контента. Веса определяйте исходя из задач команды и явно указывайте, что это ваши собственные правила.
Затем фиксируйте затраты на ручную редактуру: объём работы, необходимый для доведения текста до публикации. Лучше одновременно записывать время на правки, переписанные абзацы, фактические ошибки и то, был ли текст в итоге принят.
Совет по настройке: в APIYI (apiyi.com) используйте один API-ключ для переключения моделей — это сокращает повторную интеграцию. Во время теста сохраняйте версии моделей, параметры и фактический расход токенов, чтобы результаты можно было воспроизвести.
Ниже — минимальный пример вызова. Поместите одинаковый реальный пакет материалов в brief и переключайте название модели, чтобы получить черновики для сравнения; ключ должен безопасно предоставляться средой выполнения.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
Этот код — отправная точка. Для полноценного слепого теста нужно также повторять генерации, показывать результаты анонимно и фиксировать конфигурацию. Если хотите проверить модель-лидера в категории объяснений, дополнительно добавьте Kimi K3.
FAQ по тестированию письма GPT, Claude и Kimi
Какую версию Kimi тестировать в рамках теста письма GPT, Claude и Kimi?
Для пояснительных научно-популярных материалов в первую очередь подключайте Kimi K3; когда сравниваете сводный рейтинг из этой статьи с результатами ToneBench, используйте K3.1 Pro. Перед вызовом через APIYI apiyi.com сверяйтесь со списком моделей и точным названием модели, чтобы не перепутать версии.
Как сравнивать фактические расходы в тесте письма GPT, Claude и Kimi?
Сравнивайте «стоимость одной пригодной статьи»: суммарные расходы на вызовы плюс трудозатраты на редактирование. При тестировании через APIYI apiyi.com фиксируйте фактический расход и число повторных попыток, а затем считайте по действовавшим тогда ценам — так картина ближе к реальному производству, чем если смотреть только на стоимость первого черновика.
Итог теста письма GPT, Claude и Kimi: выбираем модель, которая экономит работу редактора
Для англоязычных статей сначала пробуйте GPT, для стилизованных длинных текстов и глубоких материалов по китайской экономике и финансам — Claude, а в пояснительные научно-популярные тексты добавляйте Kimi. Это порядок приоритетов для конкретных задач, а не постоянный рейтинг всего семейства моделей.
Рекомендуем проверить результат через APIYI apiyi.com на одном и том же наборе материалов. В итоге выбирайте ту модель, которая точнее выполняет план и сохраняет больше пригодных абзацев, чтобы редактору не приходилось задерживаться ещё на один круг.
Справочные материалы по тестированию письма GPT, Claude и Kimi
-
AI Writing Benchmark: aiwritingbenchmark.com
Сводный англоязычный рейтинг и рейтинги по категориям; данные по состоянию на 11 ноября 2026 года. -
Towards AI ToneBench: benchmark.towardsai.com/models/
Тестирование сценариев для видео, рейтинг моделей, оценка конфигураций и затрат; данные по состоянию на 10 ноября 2026 года. -
OmniTools: практическое тестирование длинных текстов: omnitools.ai/evals/longform-writing
Тест углублённых финансовых статей PANews на китайском языке; период тестирования — с 26 октября по 3 ноября 2026 года.
Автор: команда технического контента APIYI. Приглашаем обсуждать настройку моделей, методики слепого тестирования и редакторский опыт на APIYI apiyi.com.


