Примечание автора: от «починить один краш» до «пусть приложение больше не падает» — в этой статье разбираем 5 переделок, которые рабочий процесс должен пройти прежде, чем отдавать результат AI, и предлагаем пошаговый план внедрения без написания кода.
Многие команды уже каждый день используют AI, чтобы писать письма, править тексты и делать презентации, но чувствуют, что его ценность на этом не заканчивается. Проблема обычно не в модели, а в том, что мы отдаём ей слишком маленькую вещь: отдаём задачу, а не результат. В этой статье, опираясь на практические идеи, недавно опубликованные разработчиком Claude Феликсом Ризебергом (Felix Rieseberg), мы рассказываем о том, как перестроить рабочий процесс — перейти от «делегирования задачи» к «делегированию результата».
Это не очередной сборник приёмов промптинга. Как бы хорошо ни был написан промпт, если AI не получает данные, не может добраться до окружения и не проходит внешнюю проверку, он так и будет крутиться в очерченной вами маленькой клетке. Менять в первую очередь нужно сам рабочий процесс.
Ключевая ценность: прочитав статью, вы поймёте, какие задачи стоит «отдавать AI на результат» и какие 5 базовых условий нужно сначала закрыть, чтобы AI мог долго работать самостоятельно.
Ключевые моменты: передать задачу AI и передать результат AI
Феликс Ризенберг раскладывает «амбиции» при работе с AI на четыре измерения: скорость, высота, глубина и широта. «Скорость» — самый зрелый способ использования, а «передача результата AI» в основном соответствует измерению «высоты», тогда как глубина и широта определяют верхнюю границу качества результата.
| Измерение | Смысл | Типичная практика | Требования к рабочему процессу |
|---|---|---|---|
| Скорость | Выполнять ту же работу за меньшее время | Заставить AI быстрее писать код и документы | Низкие, достаточно текущего процесса |
| Высота | Фокус на конечном результате, а не на текущей задаче | От «почини этот баг» к «сделай так, чтобы приложение не падало» | Высокие, нужны каналы данных и среда для проверки |
| Глубина | Думать как ведущий эксперт в области | Заменить таблицы Markdown на базы данных и статистические модели | Средне-высокие, нужны исходные данные и профессиональные инструменты |
| Широта | Заимствовать методы из других областей | Привнести методологию журналиста, редактора, инвестора, играющего на понижение | Средние, нужны несколько сессий или субагенты |
Почему передача результата ИИ — это прежде всего вопрос рабочего процесса
Когда вы ставите модели задачу, она на самом деле выполняет «тот способ достижения цели, который вы сейчас считаете наиболее вероятным». Иными словами, в самой задаче уже заложено ваше суждение, а модель — лишь исполнитель. Чтобы подняться на уровень выше, нужно спросить себя: что я на самом деле хочу, чтобы произошло дальше? Какая более крупная цель стоит за этой текущей задачей?
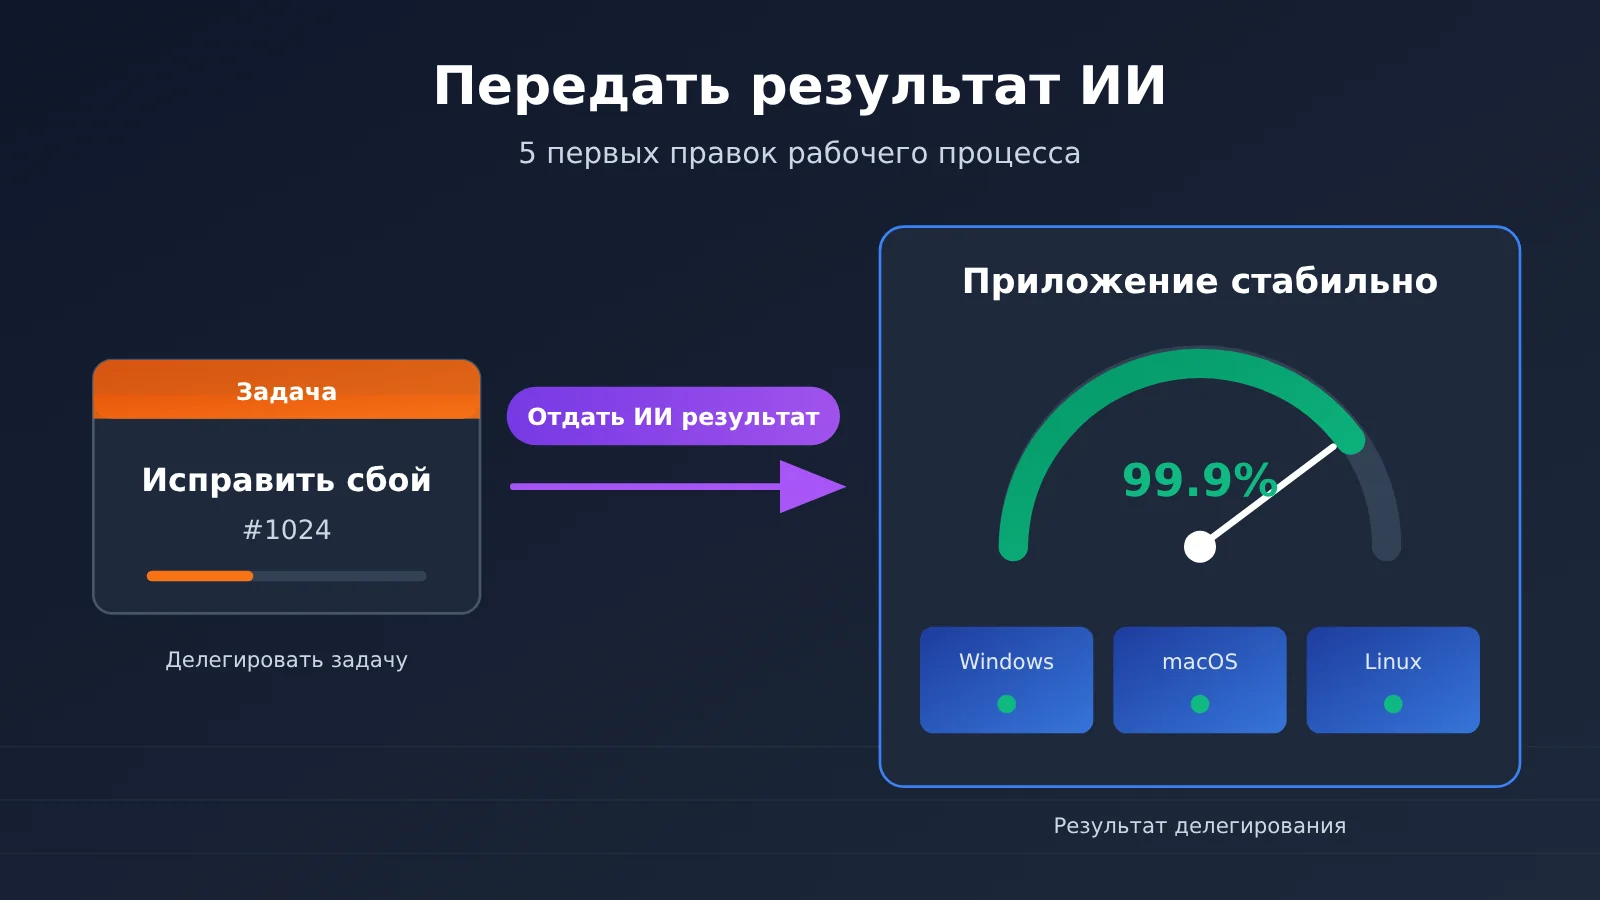
В оригинале приводится очень конкретный пример. Автор поначалу просил Claude помочь исправить отдельные падения приложения, а потом просто поручил ему «сделать так, чтобы приложение оставалось стабильным и больше не падало». Но этот шаг нельзя сделать, поменяв одну фразу в промпте: сначала ему пришлось убедиться, что Claude может легко получать отчёты о падениях, знает, какая версия приложения соответствует какому коммиту в Git, а ещё умеет работать с компьютерами на Windows, macOS и Linux. Только так модель смогла самостоятельно воспроизводить проблемы и проверять, эффективно ли исправление.
В этом и заключается главная мысль статьи: передать результат ИИ можно только тогда, когда у ИИ есть входные данные, возможность действовать и средства проверки, необходимые для замкнутого цикла. Если не хватает хотя бы одного звена, делегирование результата вырождается в делегирование задачи, и вы снова возвращаетесь к бесконечной раздаче поручений.
Три уровня передачи результата ИИ: на примере квартального обзора
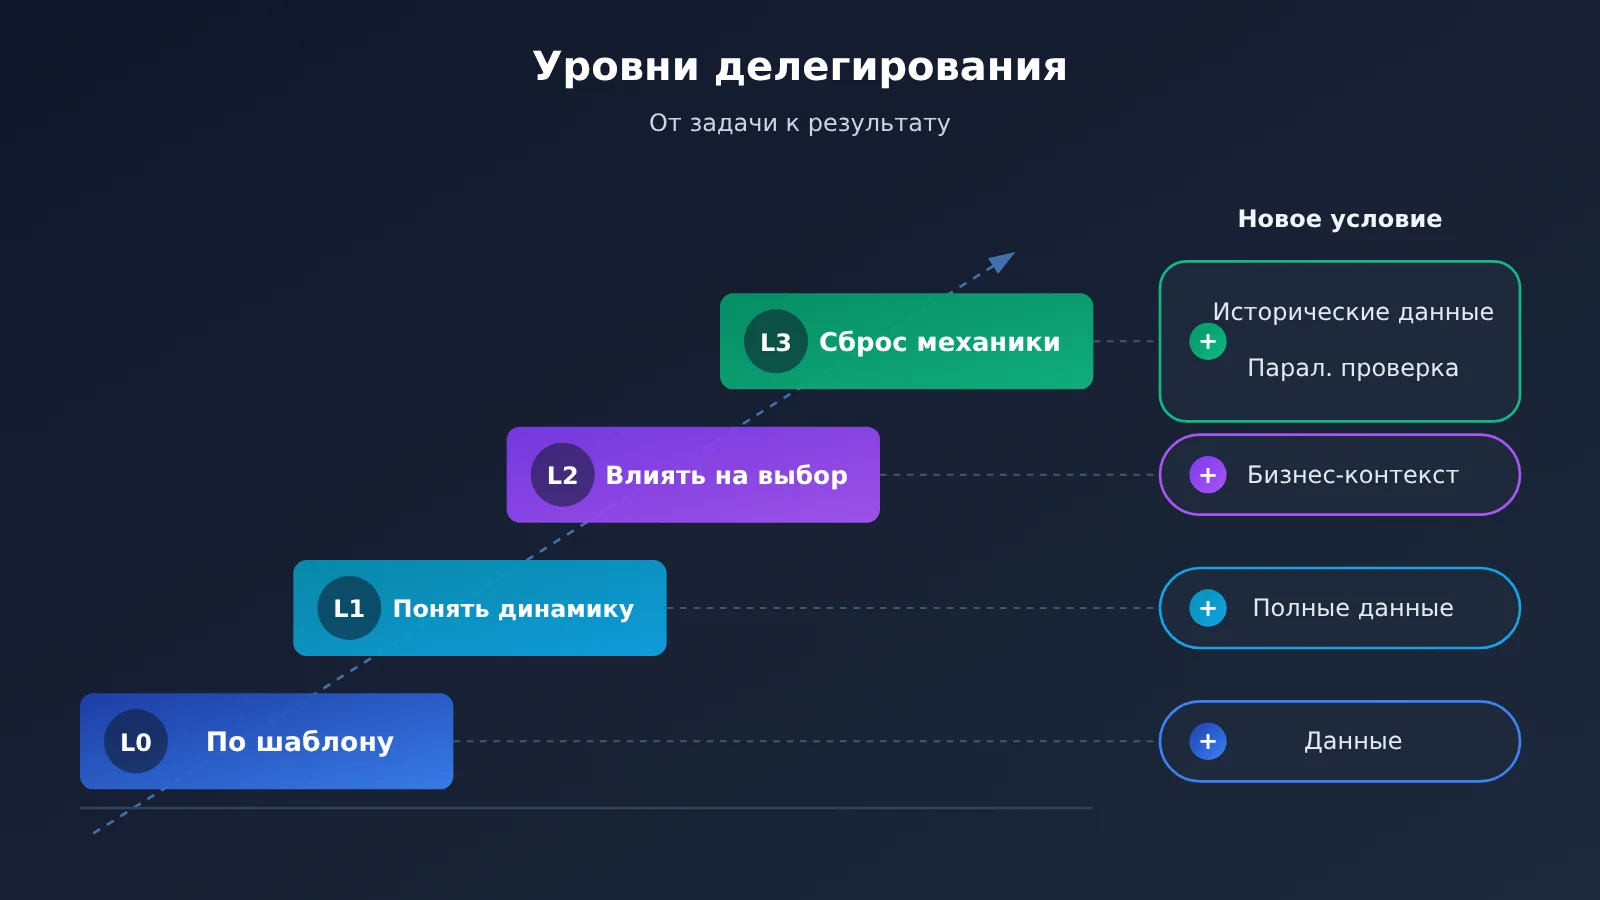
В оригинале взяли «скучноватую» офисную задачу: сделать слайды квартального бизнес-обзора (QBR) для вымышленной компании Acme. Одно и то же дело можно разложить на три уровня — от простого к сложному.
| Уровень | Что вы отдаёте ИИ | Типичная формулировка | Что нужно ИИ |
|---|---|---|---|
| L0 Задача | Вписать цифры в шаблон | «Сделай из этих данных слайды» | Собранные и приведённые в порядок данные |
| L1 Понимание | Разобраться, что произошло | «Скажи, что изменилось за квартал, почему и что с этим делать» | Максимально полные бизнес-данные |
| L2 Решение | Подтолкнуть совещание к решению | «Найди три самых срочных решения и приведи аргументы за и против» | Данные плюс бизнес-контекст и ограничения |
| L3 Механизм | Перепроектировать сам обзор | «Придумай способ лучше квартальных слайдов, докажи на исторических данных, что он выявляет проблемы раньше, и запусти его параллельно с текущим процессом на один квартал» | Исторические данные, среда запуска, контрольная проверка |
На уровне L3 вы отдаёте уже не «набор слайдов», а результат: «чтобы руководство раньше замечало проблемы и направляло деньги и людей туда, куда нужно». В оригинале есть очень удобный сигнал для проверки: если то, что вы делаете, потом всё равно придётся обсуждать на совещании, скорее всего стоит поднять цель ещё на один уровень.
5 изменений в рабочем процессе, которые нужны до того, как отдавать результаты ИИ
Если объединить два кейса из оригинала — устранение падений и квартальный разбор, — можно выделить 5 элементов инфраструктуры, которые нужно изменить в первую очередь. В таблице ниже эти кейсы сопоставлены, чтобы вам было проще перенести их на собственный бизнес.
| Что изменить | Кейс: устранение падений | Кейс: квартальный разбор | Вопрос для самопроверки |
|---|---|---|---|
| 1. Канал исходных данных | Можно напрямую читать отчёты о падениях | Есть доступ к исходным бизнес-логам и пользовательским данным | ИИ получает исходные материалы или пересказ из вторых рук? |
| 2. Прослеживаемое сопоставление | Версия соответствует коммиту в Git | Метрика соответствует источнику данных | Может ли ИИ проследить путь от симптома к причине? |
| 3. Среда, где можно действовать | Тестовые машины на трёх операционных системах | Можно устанавливать ПО, запускать базы данных и статистические модели | Может ли ИИ сам воспроизвести проблему и провести эксперимент? |
| 4. Внешняя проверка | После исправления падения действительно прекращаются | Прогнозную силу проверяют на данных, которых модель не видела | Подтверждает ли результат что-то вне самого ИИ? |
| 5. Параллельная работа и откат | Исправление сначала проверяют в тестовой среде | Новый механизм квартал работает параллельно со старым процессом | Можно ли без потерь откатиться при неудаче? |
Улучшение 1. Открываем ИИ прямой канал к исходным данным
В разделе «Глубина» исходный текст не раз подчёркивает: лучшие профессионалы начинают с самых сырых материалов, а не с уже структурированной и обработанной информации. Многие «общепризнанные факты» в бизнесе на деле лишь грубое приближение к реальности. Если дать ИИ только готовую сводную таблицу, сделанную кем-то другим, он сможет рассуждать лишь поверх этого приближения.
На практике можно начать со списка данных, доступных ИИ: логи, тикеты, отчёты о падениях, read-only аккаунт базы данных, исторические документы и т. п. В исходном тексте упоминается, что подключать модель к нужным данным можно через коннекторы MCP или другими способами. Сегодня немало инструментов дают такую возможность — выбрать один и пользоваться им гораздо надёжнее, чем снова и снова вручную копировать и вставлять данные.
Улучшение 2. Строим прослеживаемое сопоставление от симптома к причине
В кейсе с падением вопрос «какой версии приложения соответствует какой коммит Git» выглядит как деталь, но именно он определяет, сможет ли ИИ по отчёту о падении найти конкретное изменение в коде. Без такого сопоставления ИИ остаётся только гадать, а если он ошибётся, придётся вмешиваться вручную.
В бизнес-сценариях это означает, что определение метрики должно прослеживаться до источника данных. Например, по какому временному окну и для какой категории пользователей считается «отток», должно быть прозрачно для ИИ. Чем яснее сопоставление, тем меньше ИИ отклоняется, когда работает на более высоком уровне абстракции.
Изменение 3: дать ИИ компьютер, на котором он может действовать
В оригинале сказано прямо: у всех предыдущих подходов есть одна предпосылка — модель должна уметь пользоваться компьютером, устанавливать программы и получать доступ к разным связанным данным. Когда Claude собирается отделаться Markdown-таблицей вместо анализа, настаивайте, чтобы она использовала базы данных и статистические модели: «заставить модель выглядеть как эксперт» часто означает лишь замену терминов, а не метода работы.
Для инженерной команды этот шаг означает песочницу, тестовые машины и изоляцию прав доступа; для бизнес-команды — рабочее пространство, где можно запускать аналитические инструменты. С правами рекомендуется следовать принципу минимальных привилегий: сначала только чтение, а после подтверждения надёжности постепенно открывать права на запись.
Изменение 4: придерживаться внешней оценки и не позволять ИИ оценивать самого себя
Рекомендация автора оригинала предельно ясна: как минимум по состоянию на октябрь 2026 года настоятельно стоит придерживаться внешней проверки — в идеале с помощью инструментов, которые модель может запускать сама и сразу получать обратную связь. Тестовые примеры, реальные результаты воспроизведения и отложенные валидационные наборы данных надёжнее, чем «модель сама себе поставила оценку».
В углублённом сценарии квартального ретро оригинал предлагает поручить Claude построить по логам симуляцию поведения клиентов, найти самый ранний сигнал, предвещающий отток, а затем доказать на данных, которых модель не видела, что этот сигнал действительно обладает предсказательной силой. Это и есть эталонная форма внешней оценки: вывод должен выдерживать проверку за пределами модели.
Изменение пятое: продумайте период параллельной работы и условия выхода
В делегировании на уровне L3 есть один ключевой шаг: дать новому механизму поработать параллельно с текущими процессами один квартал. Это не только осторожность, но и внешняя проверка. Понять, действительно ли новый механизм раньше выявляет проблемы, можно, сравнив его со старым процессом за тот же период.
При этом важно трезво смотреть на ограничения. В исходном тексте прямо говорится: к 2026 году одной фразы «Claude, иди зарабатывай» для большинства компаний всё ещё недостаточно. Поэтому в каждом делегировании результата нужно чётко прописать границы, контрольные точки и путь отката, а не отдавать всё сразу и целиком.
Быстрый старт: как передать результат ИИ — процесс делегирования без кода
Этот процесс не требует программирования и подходит для прямого применения продуктовым, операционным, аналитическим и инженерным командам.
Шаг 1. Решить, стоит ли передавать результат работы ИИ
Сначала отсеиваем по трём вопросам: нужно ли после этой работы ещё собираться на совещание? Есть ли у неё чёткий конечный результат, а не просто творческий продукт? Повторяется ли она периодически? В оригинале отмечается, что повышение уровня цели полезнее всего при стремлении к конечному результату, а для творческой работы подходит хуже. Если на два вопроса из трёх ответ «да» — стоит попробовать.
Шаг 2. Заполнить ТЗ на делегирование результата
Вместо длинного промпта лучше разбить делегирование на фиксированные поля. Структуру этого ТЗ можно использовать повторно.
| Поле | Что заполнять | Пример (борьба со сбоями) |
|---|---|---|
| Конечный результат | Что вы на самом деле хотите получить | Приложение стабильно на трёх основных платформах |
| Цель за результатом | Намерение на уровень выше | Сократить отток пользователей из-за сбоев |
| Доступные данные | Список исходных материалов и способ их получения | Отчёты о сбоях, сопоставление версий и коммитов |
| Доступная среда | Машины и инструменты, с которыми может работать ИИ | Тестовые машины Windows, macOS, Linux |
| Внешняя проверка | Кто или что подтвердит правильность результата | Стабильно воспроизводить и проверять, что исправление работает |
| Границы и откат | Линии, которые нельзя переступать, и план на случай неудачи | Менять только тестовую ветку, слияние — вручную |
| Целевой вызов | Заведомо неразумно высокая планка | Пример из оригинала: время загрузки с 10 секунд сразу до 200 мс |
Колонка «Целевой вызов» взята из углублённой рекомендации оригинала: поставьте цель, которая выглядит неразумной, и скажите модели, что она совершенно разумна. Если модель считает, что это невыполнимо, ещё раз подчеркните: проблема решаема, просто нужно продолжать стараться. Это поддерживает и вывод Локка и Лэтэма, которые обобщили 35 лет исследований постановки целей: конкретные и сложные цели лучше расплывчатого «старайся как можешь».
Шаг третий: переписываем задание с помощью «четырёх глубоких вопросов»
Автор оригинала делился своим ходовым приёмом: прежде чем переписывать задачу, попросите модель ответить на четыре вопроса. Своими словами это можно сформулировать так:
Я хочу сделать эту задачу глубже, а не масштабнее. Прежде чем браться за дело, ответь: во-первых, что сделали бы ведущие специалисты в этой области сверх того, о чём я попросил? Во-вторых, с каких самых первичных материалов они бы начали? В-третьих, какими конкретно методами и инструментами они пользуются? В-четвёртых, что кроме твоего и моего суждения может подтвердить правильность результата? А затем перепиши моё задание с учётом этого.
Эти четыре вопроса соответствуют пунктам переработки, о которых шла речь выше: исходные данные, профессиональные инструменты, внешняя оценка. Пробелы, которые модель назовёт в ответе, — как раз то звено, которое стоит достроить в вашем рабочем процессе.
Шаг четвёртый: выбираем способ подключения модели
Результатное задание обычно выполняется долго и в несколько раундов, поэтому стабильность доступа к модели и стоимость переключения напрямую влияют на внедрение. APIYI предоставляет API-доступ к линейке Claude, о которой идёт речь в статье, и к другим популярным моделям, причём поддерживает оба формата — OpenAI и Anthropic. В существующих SDK или Agent-фреймворках обычно достаточно заменить base_url и API Key. Конкретные адреса и параметры — в документации APIYI docs.apiyi.com.
| Потребность при подключении | Рекомендуемый способ | Пояснение | Доступные платформы |
|---|---|---|---|
| Проект уже на OpenAI SDK | Формат, совместимый с OpenAI | Меняем base_url и API Key | APIYI apiyi.com, официальный API |
| Нужны нативные возможности Claude | Формат, совместимый с Anthropic | Используем структуру сообщений Anthropic | APIYI apiyi.com, официальный API |
| Сравнительная проверка нескольких моделей | Переключение имени модели через единый интерфейс | Один и тот же процесс — разные модели для сравнения | APIYI apiyi.com |
| Оценка затрат | Страница с ценами | Цены за ввод, вывод и кэширование — по странице с ценами | Страница цен: https://docs.apiyi.com/models |
🚀 Совет по старту: результатные задания обычно сначала прогоняют по замкнутому циклу на небольшом объёме, а потом постепенно масштабируют. Рекомендую через APIYI apiyi.com подключить одну-две модели по единому интерфейсу и провести сравнение. Что касается цен на модели, принципов тарификации, стоимости ввода-вывода и цены кэша — конкретные цифры в статье не приводятся, ориентируйтесь на фактические данные со страницы цен APIYI https://docs.apiyi.com/models.
Расширение охвата при передаче результата ИИ: соберите виртуальную команду
Когда высота и глубина уже есть, широта решает, окажется ли результат неожиданно сильным. В оригинале предлагают два метода, и оба можно сразу вписать в техническое задание на передачу результата.
Первый — заменить существительные глаголами, приём из книги «Искусство инновации» (The Art of Innovation). Квартальный обзор — это не «набор слайдов», а «за 30 минут убедить занятых людей в причинно-следственной картине и помочь им принять решение в условиях неопределённости». Когда описываешь работу через действия, и тебе, и ИИ проще увидеть, какие области могут дать уникальный взгляд.
Второй — собрать свою команду. Представь, что этот обзор должен быть безупречным: кого бы ты позвал? Ответ из оригинала: аналитика, журналиста и редактора, при необходимости — специалиста по моушн-графике и звукового дизайнера, а ещё «красную команду» из шорт-инвесторов и судебных бухгалтеров. С многодиалоговым режимом или субагентами сегодня это уже недорого.
Остерегаться стоит ловушки ролевой игры: разговор становится всё красивее, а результат не улучшается. Напоминание из оригинала: не позволяйте модели писать в стиле шорт-инвестора — пусть она применяет методы, которыми шорт-инвестор реально пользуется, когда изучает объект инвестирования.
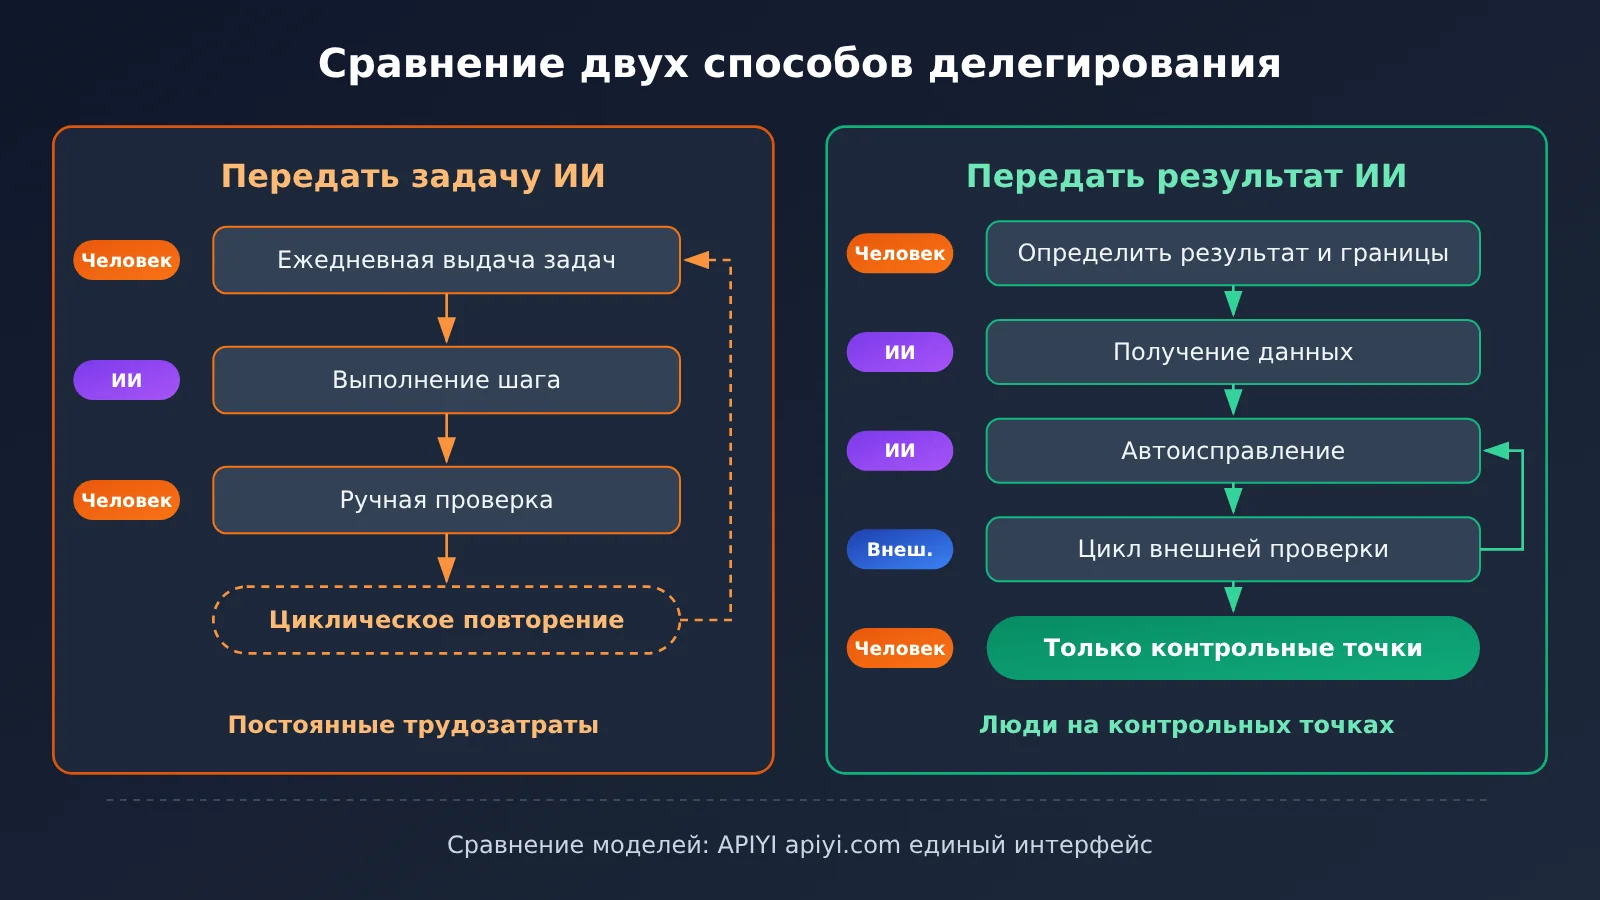
На схеме выше сравнивается структура трудозатрат при двух подходах к делегированию. Если хочешь проверить, насколько стабильно разные модели работают в сценарии передачи результата, можно через APIYI apiyi.com в одном и том же рабочем процессе переключать имя модели и сравнивать результаты — меньше работы по повторному подключению.
Часто задаваемые вопросы (FAQ)
Вопрос 1: Что такое «передать результат ИИ»?
Это значит, что вы больше не ставите ИИ одну конкретную задачу, а передаёте ему конечный результат и необходимые условия — пусть сам разбивает на части, выполняет и проверяет. Например, вместо «почини этот краш» — «сделай так, чтобы приложение оставалось стабильным и больше не падало». Человек отвечает только за постановку цели, границ и контрольных точек.
Вопрос 2: Чем передача результата ИИ отличается от обычной автоматизации с AI Agent?
Автоматизация обычно связывает фиксированные шаги, и сами шаги по-прежнему проектирует человек. Передача результата ИИ отдаёт ещё и «какой способ выбрать» — ИИ может перепроектировать сам процесс, например заново выстроить механизм квартального ревью. Первое оптимизирует эффективность выполнения, второе поднимает уровень абстракции работы.
Вопрос 3: Действительно ли сегодняшние модели способны взять на себя делегирование результата?
Отчасти да. Автор оригинальной статьи заметил: чем сильнее модель, тем лучше она работает на более высоком уровне абстракции, и люди как раз в этом измерении находят процессы, которые работают долго и не требуют постоянного вмешательства. Но он также признаёт, что к 2026 году такая полностью открытая цель, как «иди зарабатывай», для большинства компаний всё ещё не сработает — нужны границы и внешняя проверка.
Вопрос 4: Какие задачи лучше всего подходят для передачи результата ИИ?
В основном подходят следующие сценарии:
— **Управление стабильностью**: замкнутый цикл мониторинга крашей, воспроизведения и проверки исправлений
— **Анализ бизнеса**: от квартального ревью к постоянному раннему предупреждению проблем
— **Исследование оттока пользователей**: поиск самых ранних сигналов оттока в сырых логах и проверка их предсказательной силы
— Сигнал для решения: если после получения результата всё ещё нужно собраться и обсудить — обычно стоит поднять на уровень выше
Вопрос 5: Как быстро построить рабочий процесс передачи результата через API?
Рекомендую сначала прогнать минимальный замкнутый цикл через единый интерфейс:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API Key
2. Загляните в документацию APIYI docs.apiyi.com и настройте base_url в формате, совместимом с OpenAI или Anthropic
3. С помощью «инструкции по передаче результата» из этой статьи определите небольшой по охвату цель и подключите источники данных
4. Добавьте внешнюю проверку, прогоните полный цикл и только потом расширяйте охват
Вопрос 6: Как оценить стоимость длительно работающей передачи результата?
Передача результата порождает много многораундовых вызовов. Рекомендую сначала на небольшом охвате зафиксировать фактический расход токенов, а затем пересчитать по цене за единицу. Актуальные цены за единицу, правила тарификации и стоимость кеширования смотрите на странице цен APIYI https://docs.apiyi.com/models — в этой статье конкретных цифр нет. Для повторно используемого длинного контекста обратите внимание на описание тарификации кеша на странице цен.
Вопрос 7: Какие известные риски есть у передачи результата ИИ?
Есть три основные категории: во-первых, самооценка модели ненадёжна — нужно привлекать внешнюю оценку; во-вторых, расширение вширь легко превращается в ролевую игру с красивым, но бесполезным результатом; в-третьих, слишком широкие права создают операционные риски — начните с режима «только чтение», затем постепенно открывайте права на запись, а для каждого делегирования предусмотрите период параллельной работы и план отката.
Передать результат ИИ — ключевые выводы (Key Takeaways)
- Задача содержит ваши суждения: только отдав результат, вы даёте ИИ возможность выбрать способ лучше вашего
- Совещание — сигнал поднять планку: если результат всё ещё нужно обсуждать на совещании, стоит поднять цель ещё на один уровень
- Три элемента замкнутого цикла: исходные данные, среда для реальных действий и внешняя проверка — без любого из них ничего не выйдет
- Глубина — за счёт профессиональных инструментов: используйте базы данных и статистические модели, а не таблицы Markdown
- Широта — за счёт заимствования методов: берите настоящие методы из других областей, а не копируйте манеру речи
- Параллельный запуск снижает риски: прогоните новый механизм параллельно со старым процессом один цикл, и только потом переключайтесь
- Подключение и оплата: подключайтесь через единый интерфейс APIYI, цены смотрите на docs.apiyi.com/models
Итоги
Ключевая мысль «не поручайте ИИ задачу — поручайте ему результат»:
- Сначала поднимите «высоту»: выясните, какой результат на самом деле стоит за текущей задачей, и постепенно пройдите путь от L0 «заполнения шаблона» до L3 «перестройки механизма».
- Затем измените рабочий процесс: откройте доступ к сырым данным, постройте прослеживаемые связи, создайте среду, где можно действовать руками, придерживайтесь внешней оценки, продумайте параллельность и точки выхода.
- И наконец, расширьте глубину и широту: закройте пробелы в профессиональных методиках с помощью «четырёх вопросов глубины», а для кросс-дисциплинарных взглядов привлеките «виртуальную команду».
Советую начать с небольшого циклического сценария, где нужно совещаться на встречах: пройдите полный цикл с «инструкцией по делегированию результата» и только потом решайте, стоит ли расширять масштаб. Что касается подключения моделей, для быстрой проверки результата рекомендую APIYI apiyi.com: он предоставляет API-вызовы популярных моделей вроде Claude и совместим с форматами интерфейсов OpenAI и Anthropic. Детали подключения — в документации docs.apiyi.com, цены — на https://docs.apiyi.com/models.
📚 Справочные материалы
- Как ставить более смелые цели: практическое руководство для пользователей ИИ: перевод на китайский от InfoQ
- Ссылка:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Примечание: источник ключевых идей статьи, а также кейсов про работу со сбоями и квартальных ретроспектив
-
How to be more ambitious: A tutorial for humans with models: оригинал Felix Rieseberg на английском
- Ссылка:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Примечание: полное изложение четырёх измерений — скорости, высоты, глубины и широты
-
Центр документации APIYI: форматы интерфейсов и инструкция по подключению
- Ссылка:
docs.apiyi.com -
Примечание: как настроить совместимые форматы OpenAI и Anthropic
-
Страница цен на модели APIYI: стоимость моделей и принципы тарификации
- Ссылка:
docs.apiyi.com/models - Примечание: цены на вход, выход и кэширование — по фактическим данным этой страницы
Автор: техническая команда APIYI
Обсудить технологии: будем рады пообщаться на главной странице сайта APIYI — расскажите о своём опыте внедрения делегирования результатов; больше материалов — в центре документации docs.apiyi.com