Примечание автора: на основе публичных тестов трёх персональных агентов разбираем проблемы интерфейсного слоя, стоящие за слабой исполнительностью агентов, и даём чек-лист исправлений по вызову инструментов, отказоустойчивости с повторами, совместимости форматов и контролю затрат.
Издание 36 氪 4 ноября 2026 года опубликовало материал «Персональные агенты вышли на сцену: кто первым дрогнул?», в котором три персональных агента прошли практический тест за одним столом. Выводы таких сравнительных обзоров обычно совпадают: агентам не хватает не «умения говорить», а «умения доводить дело до конца». Ключевой вопрос этой статьи — слабые места агентов в исполнительности чаще всего кроются в интерфейсном слое, а не только в самой модели.
Это не очередная статья-рейтинг «какой агент умнее». Мы не пересказываем конкретные оценки из оригинала, а сводим типичные сбои выполнения из таких тестов в 5 категорий и по очереди сопоставляем их с тем, что можно исправить в дизайне интерфейсов агента.
Ключевая ценность: после прочтения вы будете знать, какие параметры интерфейса проверять в первую очередь при сборке собственного агента, как обрабатывать сбои и как безболезненно переключаться между форматами API OpenAI и Anthropic.
Главное о слабых местах интерфейса агента при выполнении задач
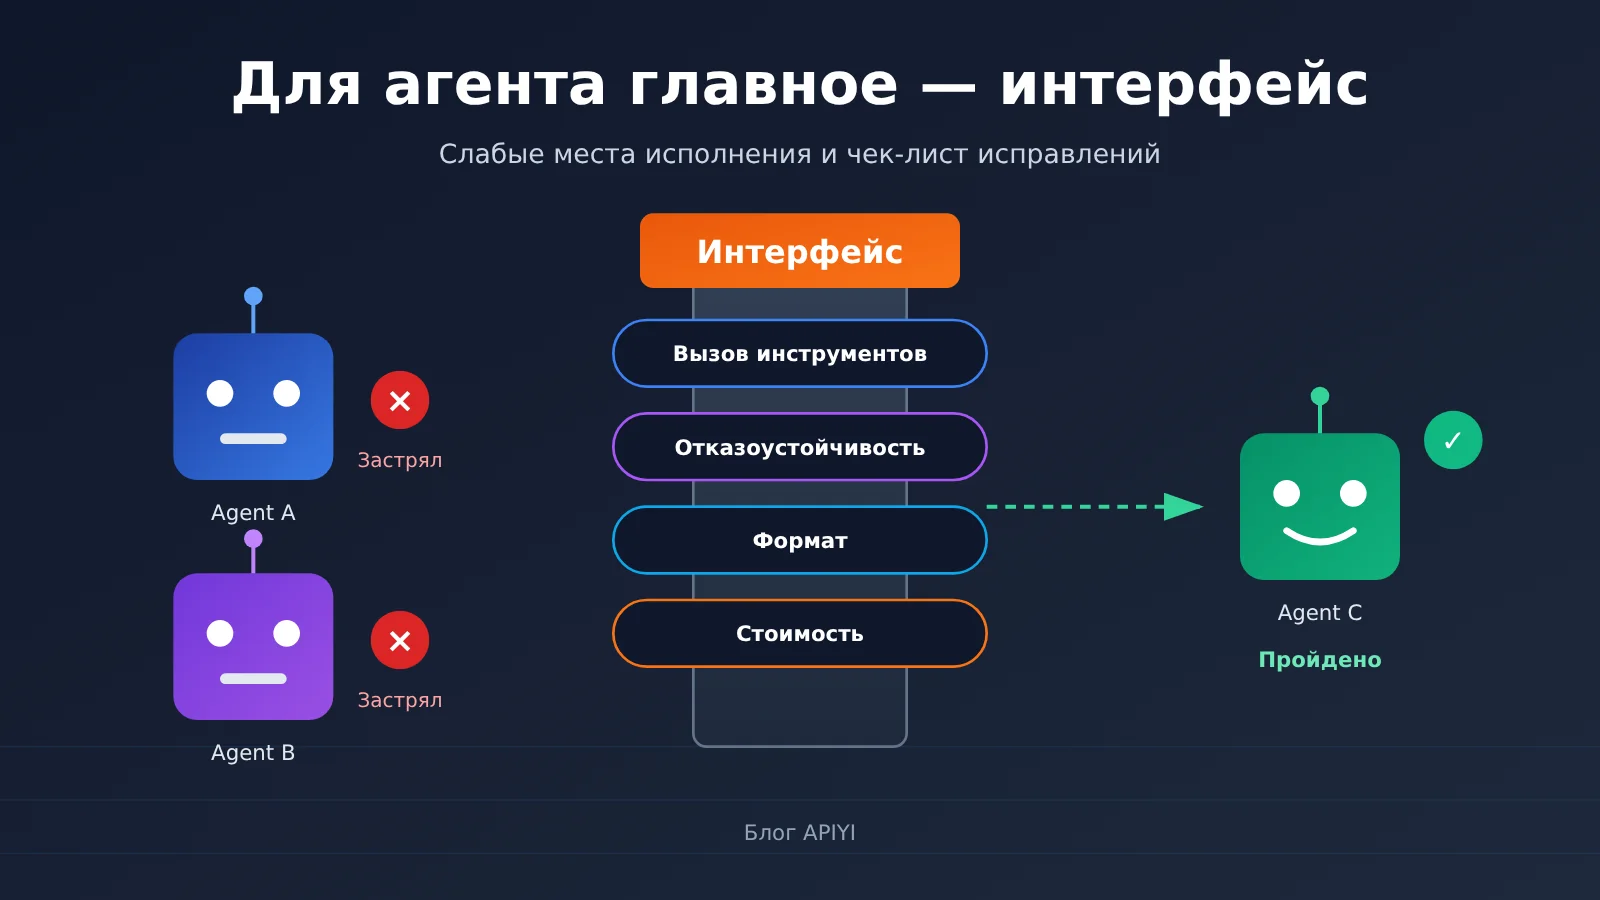
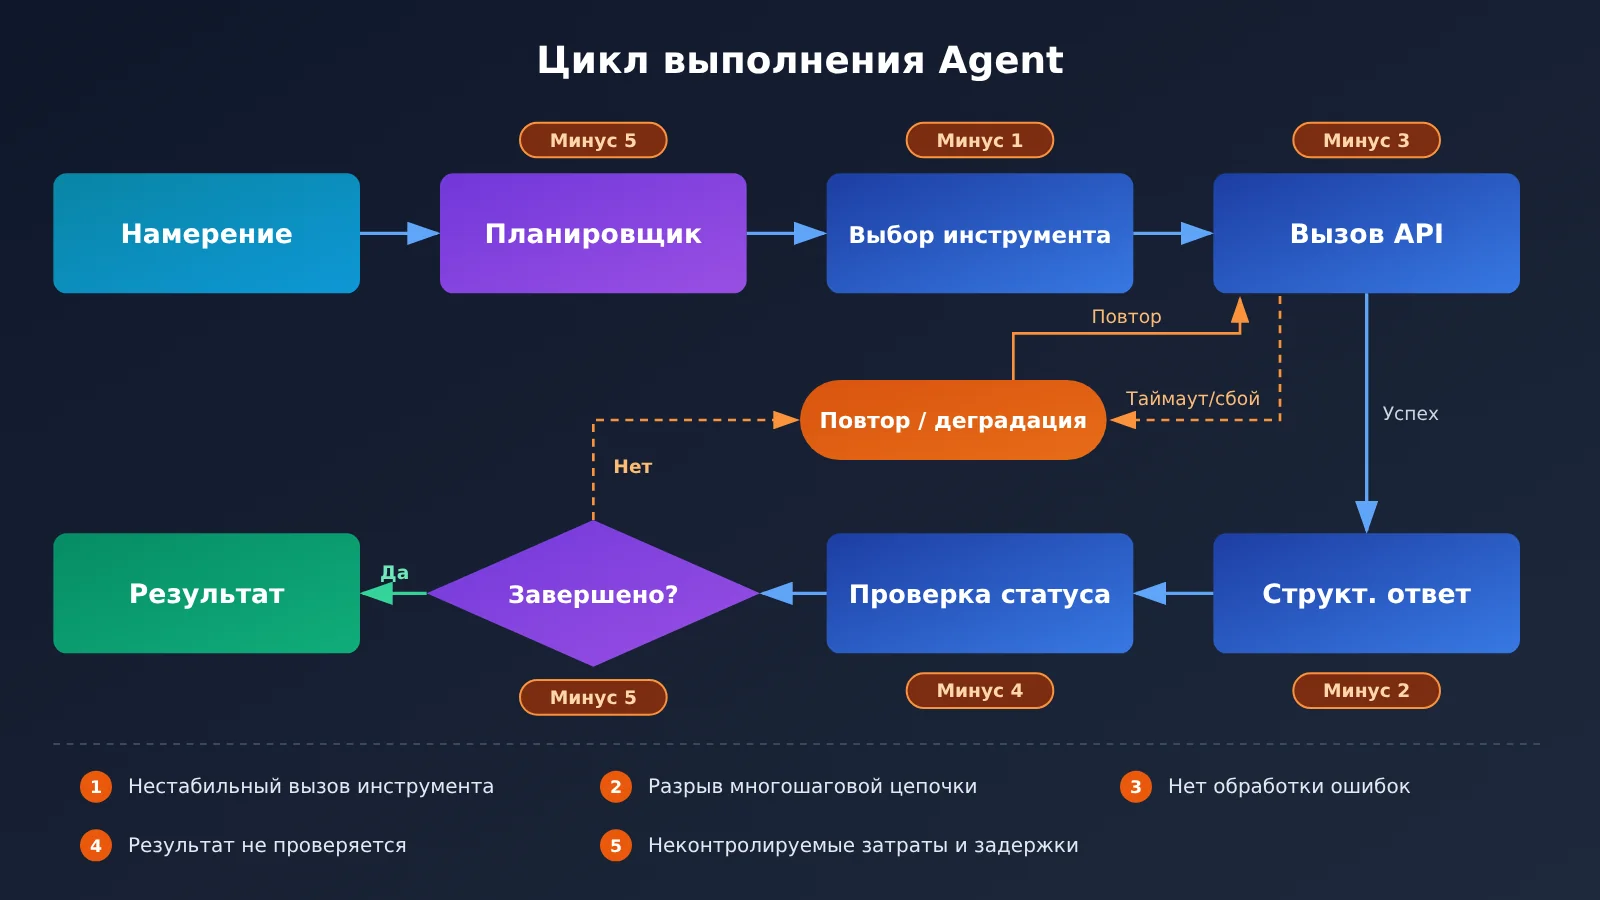
Цель персонального агента — выполнить за пользователя всю задачу целиком: забронировать билеты, разобрать почту, собрать и обобщить материалы, поработать с веб-страницами. Если хотя бы один шаг посередине срывается, пользователь воспринимает это как «оно не доделало». Если проследить типичные сбои из реальных тестов до корня, почти все они сводятся к пяти категориям проблем на уровне интерфейса.
| Слабое место в исполнительности | Типичное проявление | Корневая причина на уровне интерфейса | Направление исправления |
|---|---|---|---|
| Нестабильный вызов инструментов | Выбирает не тот инструмент, в параметрах не хватает полей, невалидный формат | Размытое описание инструментов, схема без ограничений | Сократить набор инструментов, писать строгую схему параметров |
| Обрыв цепочки в многошаговых задачах | На третьем-четвёртом шаге забывает цель | Грубое управление контекстом, результаты инструментов не передаются обратно корректно | Упорядочить историю сообщений, сжимать промежуточные результаты |
| Нет подстраховки при внешних сбоях | При rate limit или таймауте просто сдаётся либо врёт, что задача выполнена | Не различает типы ошибок, нет стратегии повторов | Повторять с учётом кода состояния, добавить таймауты и деградацию |
| Результат невозможно проверить | Отвечает «готово», хотя на деле ничего не сделал | Нет подтверждения выполнения и проверки статуса | На каждом шаге требовать структурированное подтверждение |
| Затраты и задержки выходят из-под контроля | Циклические вызовы, одна задача съедает массу токенов | Нет лимита шагов и не используется кэш | Задать максимальное число раундов, использовать модели разных уровней, задействовать кэш |
Подробный разбор ключевых слабых мест интерфейса агента
Первые две категории слабых мест выглядят как проблема способностей модели, но на самом деле инженерными методами можно закрыть большую их часть. Нестабильный вызов инструментов чаще всего объясняется тем, что модели сразу дают десятки инструментов с пересекающимися описаниями — естественно, она выбирает не то. Если сузить набор инструментов до того, что действительно нужно для текущей задачи, и для каждого параметра явно указать тип, допустимые значения (enum) и обязательность, доля ошибок обычно заметно падает. Разрыв цепочки в многошаговых задачах часто кроется в возврате результатов инструментов: если результат не привязан по протоколу к ID соответствующего вызова, модель не может подтвердить, действительно ли предыдущий шаг завершился успешно.
Последние три категории — чисто инженерная задача. Полноценный агент должен ясно понимать, «что делать при сбое» и «как доказать, что задача выполнена». В реальных тестах пользователей больше всего разочаровывает не сам сбой, а имитация успеха после него. Поэтому механизм подтверждений и классификация ошибок на уровне интерфейса полезнее, чем замена модели на более крупную.
Быстрый старт с интерфейсом Agent: чек-лист из 5 шагов
Шаги ниже не привязаны к какому-то конкретному фреймворку — они одинаково подойдут и для самописного цикла Agent, и для готового Agent-фреймворка. Как и требует формат статьи, кода здесь не будет: все ключевые настройки собраны в таблице.
Шаг 1: единая точка входа для интерфейса Agent
Agent’у обычно нужна связка «сильная модель для планирования, быстрая — для выполнения». Если подключать каждую модель к отдельному провайдеру, то аутентификация, формат ошибок и правила тарификации везде будут разными, и разбираться с этим придётся долго. Проще всего использовать единую точку входа, совместимую сразу с форматами OpenAI и Anthropic: достаточно поменять base_url, api_key и model, чтобы переключить модель.
| Параметр | Назначение | Рекомендуемое значение |
|---|---|---|
base_url |
Адрес интерфейса | По документации провайдера, например адрес из документации APIYI на docs.apiyi.com |
api_key |
Учётные данные для аутентификации | Храните в переменной окружения, не вписывайте в промпт или логи |
model |
Имя модели | Настраивайте отдельно для планирования и выполнения, чтобы можно было менять их по отдельности |
timeout |
Таймаут одного запроса | Зависит от типа задачи; для задач с длинным выводом ставьте посвободнее |
max_retries |
Число автоматических повторов в SDK | Держите небольшим, а повторные попытки по уровням делайте на уровне бизнес-логики |
🚀 Быстрый старт: APIYI предоставляет доступ к API основных больших языковых моделей, упомянутых в статье, и совместим с обоими форматами интерфейсов — OpenAI и Anthropic. Достаточно поменять
base_urlв существующем SDK, и всё заработает. Инструкция по подключению — в центре документации APIYI: docs.apiyi.com.
Шаг 2: Сделайте параметры вызова инструментов агента строгими
Вызов инструментов — первый рубеж исполнительных возможностей агента. Чем строже заданы параметры, тем меньше у модели пространства для «свободного творчества» и тем ниже вероятность ошибок.
| Параметр | Значение | Рекомендации на практике |
|---|---|---|
tools |
Список инструментов, доступных для вызова | За один ход показывайте только инструменты, нужные на текущем этапе; в описании явно укажите, «когда использовать, а когда нет» |
tool_choice |
Стратегия выбора инструмента | Если нужно принудительно выполнить действие, укажите инструмент; в свободном диалоге ставьте автоматический выбор |
| Схема параметров | Структура входных параметров инструмента | Обязательные поля добавляйте в required; где можно использовать перечисление, не применяйте свободный текст |
response_format |
Структурированный вывод | Для финального ответа требуйте JSON-структуру — так программе проще проверять |
max_tokens |
Лимит вывода | В формате Anthropic обязателен; оценивайте исходя из задачи |
temperature |
Случайность | Для исполнительских шагов снижайте, чтобы один и тот же ввод реже приводил к разным действиям |
Шаг 3: Учтите различия форматов OpenAI и Anthropic
Многие агенты после смены модели «внезапно глупеют»: причина не в модели, а в том, что протоколы инструментов у двух форматов разные, и результаты возвращаются не туда. В таблице ниже — самые частые подводные камни.
| Что сравниваем | Формат OpenAI Chat Completions | Формат Anthropic Messages |
|---|---|---|
| Где системный промпт | В messages, роль system | Отдельный параметр system верхнего уровня |
| Определение инструмента | type: function плюс объект function |
name, description, input_schema |
| Как модель инициирует вызов | tool_calls в сообщении ассистента |
Блок контента с типом tool_use |
| Возврат результата инструмента | Сообщение с ролью tool и tool_call_id |
Блок tool_result в сообщении user, соответствующий tool_use_id |
| Лимит вывода | max_tokens необязателен |
max_tokens обязателен |
У этих форматов нет лучшего и худшего — важно внутри агента поддерживать только одно промежуточное представление, а при запросе конвертировать его в нужный формат. Если использовать шлюз, совместимый с обоими форматами, например APIYI, можно пустить серию Claude через нативный формат Anthropic, а остальные модели — через OpenAI, сохранив для каждой максимально полные возможности вызова инструментов.
Шаг 4: проектируем запасной сценарий на случай сбоев интерфейса агента
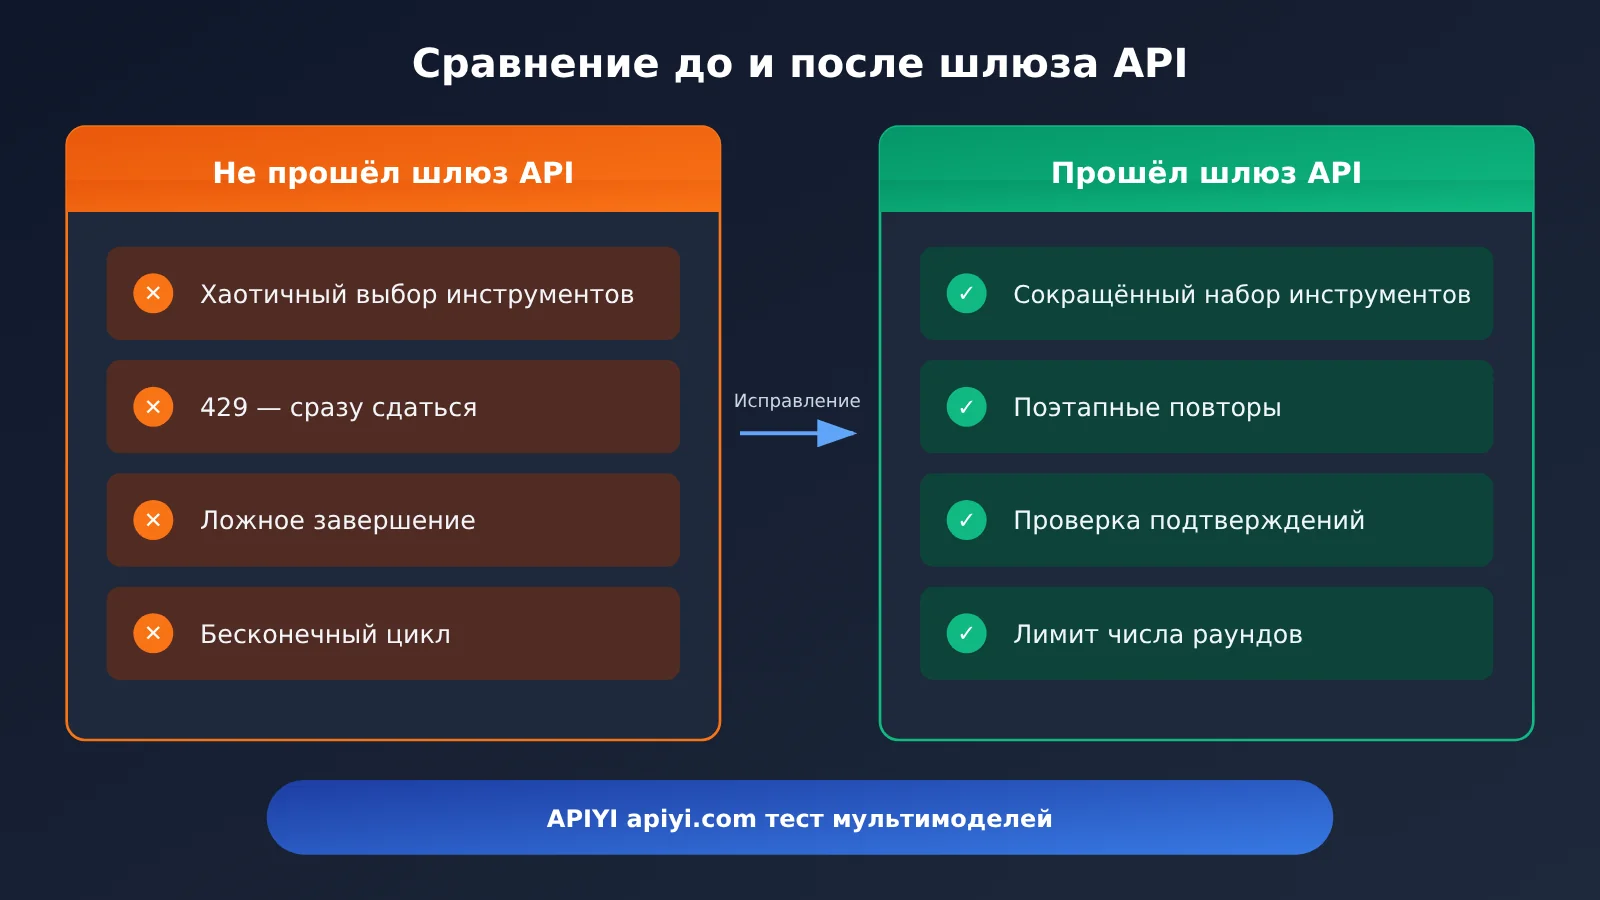
Два самых неудачных варианта поведения на практике — «если не получилось, просто сдаться» и «если не получилось, сделать вид, что всё в порядке». Правильный подход: сначала классифицировать ошибку по типу, а затем решать — повторять запрос, переходить на резервный вариант или честно сообщить пользователю о проблеме.
| Тип ошибки | Частая причина | Стратегия агента |
|---|---|---|
| Ошибка 400: неверные параметры | Некорректные параметры инструмента, нарушен формат сообщений | Не повторять запрос вслепую; вернуть модели текст ошибки, чтобы она исправила её один раз |
| 401 / 403: аутентификация и авторизация | Ключ недействителен или не хватает прав | Немедленно остановиться и попросить пользователя проверить конфигурацию |
| 429: превышен лимит запросов | Слишком высокая нагрузка или не хватает квоты | Повторять с экспоненциальной задержкой, при необходимости переключиться на резервную модель |
| 5xx: ошибка на стороне сервера | Нестабильность вышестоящего сервиса | Ограниченное число повторов; после превышения лимита — переход на резервный вариант |
| Тайм-аут | Долгий вывод или сетевые колебания | Перейти на потоковый вывод или разбить задачу на части и повторить |
Есть ещё одна деталь, которую легко упустить: инструменты с побочными эффектами должны быть идемпотентными. Для таких операций, как отправка письма, оформление заказа или запись в базу данных, перед повтором нужно убедиться, что предыдущая попытка ещё не сработала. Иначе агент выполнит одно и то же действие дважды.
Шаг 5: добавляем Agent’у отчёты о выполнении и ограничители затрат
После выполнения каждый инструмент должен возвращать структурированный отчёт минимум с тремя полями: «успешно или нет», «что именно сделано» и «идентификатор ключевого результата». Прежде чем Agent объявит задачу выполненной, отчёт проверяет программа, а не модель — так мы на уровне механики исключаем «ложный доклад о завершении».
По затратам советую поставить три предохранителя: максимальное число итераций цикла, бюджет токенов на одну задачу и детектор повторных вызовов. Планирование, выполнение и классификацию можно раздать моделям разных уровней, а длинный системный промпт и определения инструментов держать по возможности неизменными, чтобы работал кэш промпта. Конкретные цены за входные и выходные токены, за кэш, а также правила тарификации смотрите в актуальных данных на странице цен APIYI https://docs.apiyi.com/models — в этой статье я не привожу непроверенных цифр.
💡 Совет: на этапе сборки сначала прогоните весь замкнутый цикл на небольшом трафике и только потом добавляйте инструменты. Через APIYI apiyi.com можно под одним и тем же ключом быстро сравнить, насколько стабильно разные модели вызывают инструменты — для переключения достаточно поменять поле
model.
Справочник по выбору API-интерфейсов по уровням для Agent
Агент, который реально доводит дела до конца, редко обходится одной моделью. Разделение по уровням ответственности повышает стабильность и упрощает контроль затрат.
| Уровень ответственности | Требования к возможностям | Подход к выбору | Доступные платформы | Ориентир по цене |
|---|---|---|---|---|
| Уровень планирования | Длинный контекст, сложные рассуждения, декомпозиция задач | Берите флагманскую модель с сильными способностями к рассуждению | APIYI apiyi.com, официальный API | Смотрите страницу цен APIYI |
| Уровень выполнения | Стабильный вызов инструментов, быстрый отклик | Берите модель среднего класса со стабильным вызовом инструментов | APIYI apiyi.com, официальный API | Смотрите страницу цен APIYI |
| Лёгкий уровень | Классификация намерений, проверка формата, сжатие в резюме | Берите небольшую модель с низкой задержкой и низкой стоимостью | APIYI apiyi.com, официальный API | Смотрите страницу цен APIYI |
Какие именно модели доступны и как называются самые свежие — смотрите в документации APIYI docs.apiyi.com. Советую прогнать на своих реальных задачах по партии примеров, посчитать долю успешных вызовов инструментов, среднее число раундов и расход на одну задачу — и уже потом решать, какая модель будет на каждом уровне. Не ориентируйтесь только на публичные рейтинги.
Частые вопросы (FAQ)
Q1: Что такое «интерфейсный барьер» у Agent?
Это инженерный слой, который Agent проходит между «понять, что делать» и «сделать до конца»: определение инструментов, протокол вызова, обработка ошибок, подтверждение результата и контроль затрат. Модель принимает решения, а интерфейсный слой отвечает за надёжное воплощение этих решений. Если этот барьер не преодолеть, даже самая сильная модель будет выглядеть как слабый исполнитель.
Q2: Плохая исполнительность — это проблема модели или интерфейса?
Есть и то, и другое, но проблемы интерфейса чаще недооценивают. Неверно выбранный инструмент, неправильный формат параметров, разрыв цепочки, ложное сообщение о выполнении после сбоя — значительную часть этого можно устранить, ужесточив schema, упорядочив возврат результатов и добавив проверку подтверждений. Советую сначала как следует сделать интерфейсный слой, а потом уже решать, действительно ли нужно менять модель.
Q3: О чём говорит тестирование трёх персональных Agent’ов?
Этот репортаж 36Kr за ноябрь 2026 года показывает, что персональные Agent’ы уже вышли на этап «кто реально доведёт дело до конца», и акцент сместился с качества диалога на замкнутый исполнительный цикл. Конкретные результаты отдельных продуктов смотрите в оригинале — здесь мы выводим только общие инженерные уроки.
Q4: Какой формат выбрать — OpenAI или Anthropic?
Зависит от модели. Семейство Claude использует нативный формат Anthropic, и так можно полностью задействовать вызов инструментов и кеширование; для большинства остальных моделей универсальнее формат OpenAI. APIYI поддерживает оба формата одновременно, что позволяет внутри Agent’а держать единое промежуточное представление и преобразовывать его под модель при запросе.
Q5: Как быстро подключить к своему Agent’у несколько моделей?
1. Зарегистрируйтесь на APIYI apiyi.com и получите API Key;
2. Настройте `base_url` по документации docs.apiyi.com;
3. Укажите `model` отдельно для слоя планирования и слоя исполнения и прогоните на одном и том же наборе задач для сравнения.
Весь процесс не требует изменения SDK — достаточно поправить конфигурацию.
Q6: Как оценить стоимость Agent’а и где смотреть цены?
Сначала посчитайте среднее число раундов на задачу, входные и выходные token’ы, затем умножьте на цену соответствующей модели. Цены на вход, выход и кеширование, а также правила биллинга берите по фактическим данным страницы цен APIYI https://docs.apiyi.com/models — у разных моделей разброс большой, обязательно считайте по актуальной странице.
Q7: Agent становится всё менее стабильным, когда инструментов много. Что делать?
Показывайте инструменты динамически по этапу задачи — за один раунд давайте модели лишь несколько релевантных инструментов. Можно сначала лёгкой моделью делать маршрутизацию и классификацию, а затем передавать соответствующее подмножество инструментов исполнительной модели. Чётко прописанные границы применимости в описании инструмента работают лучше, чем груда примеров.
Q8: Какие ограничения остаются после того, как интерфейсный слой сделан?
Интерфейсный слой заметно повышает стабильность, но не решает проблему потолка рассуждений самой модели и не спасает от изменений на сторонних сайтах или в сервисах. Для длинных цепочек задач всё равно стоит оставлять точки ручного подтверждения — особенно для необратимых действий вроде оплаты, удаления или отправки наружу.
Ключевые выводы по исполнительности интерфейса Agent
- Слабые места исполнительности чаще всего на уровне интерфейса: неверный выбор инструмента, обрыв цепочки, ложные заявления о завершении — у большинства есть инженерные решения
- Инструментов лучше меньше, чем больше: выдавайте их поэтапно; чем строже схема параметров, тем стабильнее
- Различия форматов нужно изолировать: внутри держите единое представление, а при запросе конвертируйте в формат OpenAI или Anthropic
- Ошибки нужно разделять по типам: 400 — исправить запрос, 429 — выждать и повторить, 5xx — перейти в режим деградации; операции с побочными эффектами должны быть идемпотентными
- Завершение определяет программа: структурированный отчёт о результате плюс проверка статуса, чтобы исключить «ложное завершение»
- Затраты нужно ограничивать: лимит числа раундов, бюджет токенов, использование моделей по уровням; цены смотрите на странице цен APIYI
- Как начать: через единую точку входа APIYI подключайте несколько моделей — достаточно изменить
base_urlиmodel, чтобы их сравнить
Итог
Практические тесты трёх персональных агентов дают разработчикам важный сигнал: конкуренция среди агентов смещается с «умеет поддерживать разговор» на «умеет довести дело до конца». Чтобы закрыть пробел в исполнительности, выгоднее всего сначала навести порядок на уровне интерфейсов:
- Вызов инструментов: сократить набор инструментов, ужесточить схемы, стандартизировать возврат результатов.
- Отказоустойчивость: классификация ошибок, ограниченное число повторных попыток, защита идемпотентности.
- Проверяемость и управляемость: структурированные отчёты о выполнении, программная проверка, лимиты стоимости.
Совет: сначала возьмите одно реальное задание и прогоните его по полному циклу — от начала до конца, — а затем постепенно расширяйте возможности. Подключаться рекомендуем через APIYI apiyi.com: сервис совместим с форматами API OpenAI и Anthropic, поэтому удобно сравнивать стабильность выполнения разных моделей. Документация — docs.apiyi.com, актуальные цены — на https://docs.apiyi.com/models.
📚 Справочные материалы
- 36Kr: персональные агенты выходят на сцену — кто первым дал слабину?: репортаж с тестами трёх персональных агентов
- Ссылка:
36kr.com/p/4055385191224452 -
Пояснение: источник темы статьи; подробности о продуктах и результатах тестов — в оригинале
-
Центр документации APIYI: настройка подключения и описание доступных моделей
- Ссылка:
docs.apiyi.com -
Пояснение: настройка
base_url, подключение в форматах OpenAI и Anthropic -
Страница цен APIYI: стоимость моделей и правила тарификации
- Ссылка:
docs.apiyi.com/models - Пояснение: все цены в статье сверяйте с фактическими данными на этой странице
Автор: техническая команда APIYI
Обсудить технические вопросы: пишите нам на сайте APIYI apiyi.com; больше материалов о подключении — в центре документации docs.apiyi.com