Примечание автора: сравнивая стоимость моделей только по цене за миллион токенов, легко ошибиться с выбором. В этой статье мы разберём формулу «цена × фактический расход токенов» и пошагово покажем, как проверить расчёты на небольшой выборке собственных задач.
При выборе модели многие команды первым делом открывают прайс-лист: модель A стоит всего несколько десятых юаня за миллион токенов, а модель B — несколько долларов. Вывод кажется очевидным: A дешевле. Но в конце месяца счёт часто оказывается выше ожидаемого, а иногда «дешёвая» модель обходится дороже. В этой статье мы рассмотрим метод расчёта реальной стоимости: «цена × фактический расход токенов с учётом кеширования». Он поможет разобраться в расходах ещё на этапе выбора модели.
Это не очередная сводная таблица цен. Прайс-листы устаревают, а метод расчёта остаётся актуальным. Мы обобщим наблюдения из опубликованных расчётов, чтобы создать универсальную схему, а затем покажем, как проверить её на ваших задачах.
Главное: прочитав статью, вы сможете объяснить, почему низкая цена в прайс-листе не гарантирует низкий счёт, и рассчитать стоимость одной задачи для каждой модели-кандидата на основе 20–50 реальных запросов.
Что важно знать о реальной стоимости модели
| Фактор | Как это работает | Влияние на выбор модели |
|---|---|---|
| Цена за токен — лишь один из множителей | Счёт = количество токенов каждого типа × соответствующая цена, затем результаты суммируются | Сравнивая только цены, вы учитываете лишь половину формулы |
| Различия в токенизации | Разные модели разбивают один и тот же текст на разное количество токенов | Стоимость ввода нужно рассчитывать по фактическому числу токенов каждой модели |
| Токены рассуждений | Процесс рассуждения модели обычно тарифицируется как вывод, хотя пользователь его не видит | Видимый ответ может быть коротким, а счёт — высоким |
| Попадание в кэш | Когда повторяющийся префикс находится в кэше, он тарифицируется по более низкой цене | Разница особенно заметна при длинных системных промптах и многоходовых диалогах |
| Доля успешных попыток и повторные запросы | При неверном ответе или неподходящем формате запрос приходится выполнять заново | Эффективная стоимость = стоимость одного запроса ÷ доля успешных попыток |
Почему цена за миллион токенов не отражает реальную стоимость
Цена за миллион токенов показывает, сколько стоит один токен, а счёт — сколько стоит выполнить задачу. Между ними есть важная переменная: сколько токенов потребуется для её выполнения. Разница между моделями по этому показателю зачастую больше, чем разница в цене.
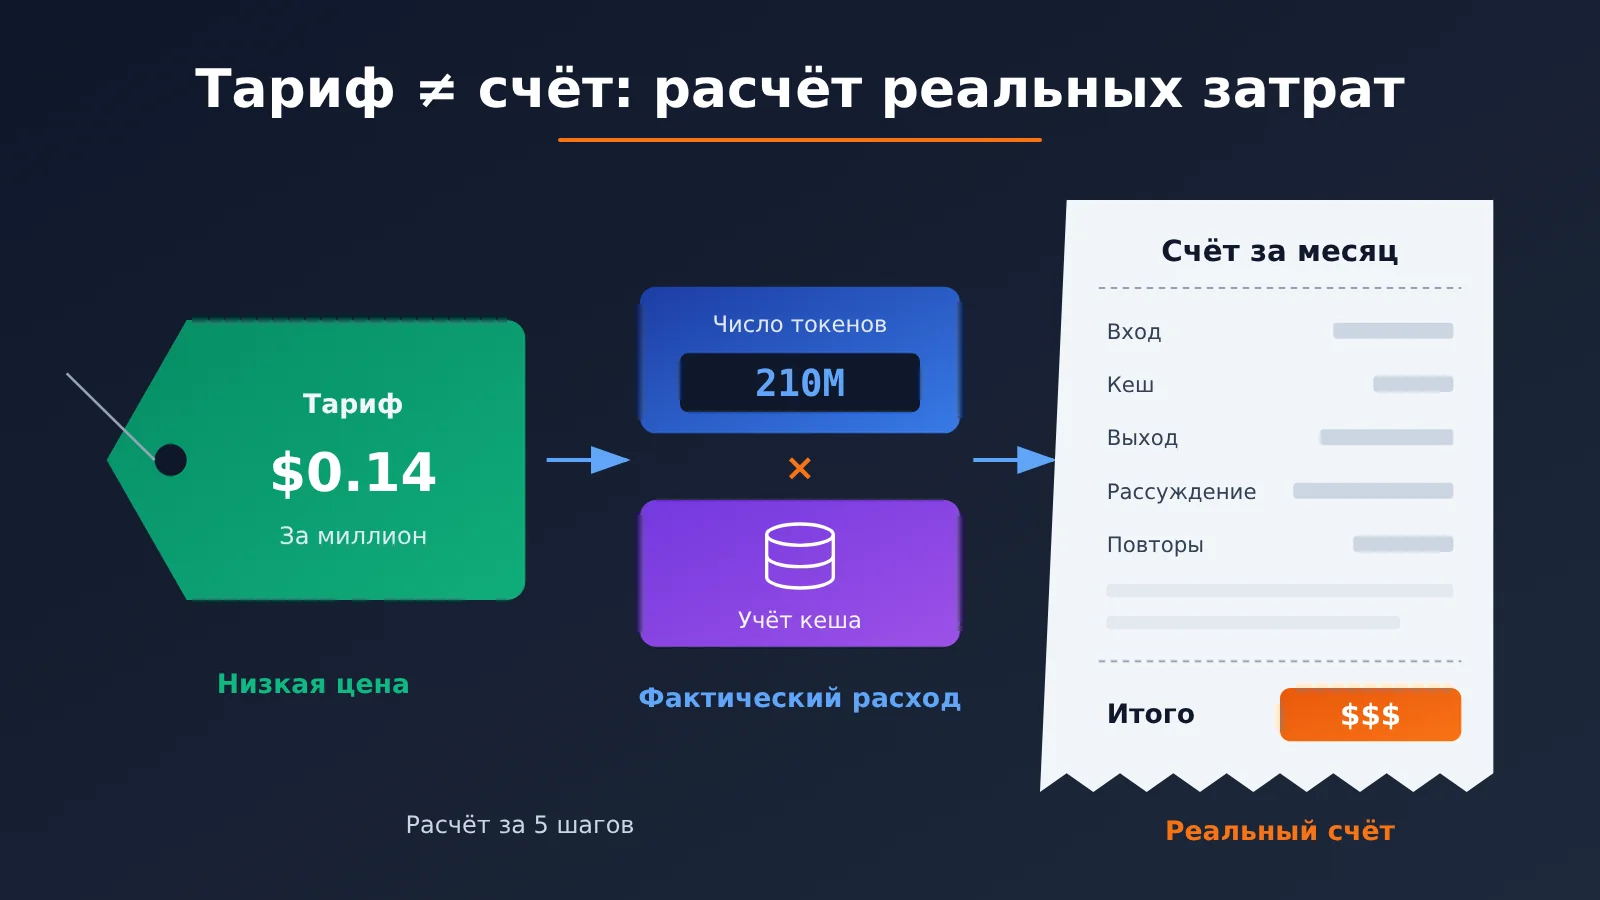
Показательный пример — расчёт, опубликованный в стороннем блоге 1 августа 2026 года. DeepSeek V4 Flash и Gemini 3.6 Flash получили одинаковую оценку на Artificial Analysis — по 50 баллов. Цена первой модели составляет $0.14/M, второй — $1.50/M: разница примерно в 10 раз. Но в одном и том же наборе тестов первая израсходовала около 210 млн токенов, а вторая — около 59 млн, то есть более чем втрое меньше. Расход токенов свёл на нет большую часть преимущества в цене, и фактическая разница оказалась далеко не десятикратной.
Ещё один фактор — различия в токенизации. В статье из того же источника от 12 августа 2026 года один и тот же документ передали 9 моделям для подсчёта токенов. Результаты варьировались от 614 до 957 токенов: разница между максимальным и минимальным значениями составила около 56%. Иными словами, даже при одинаковой цене входных токенов стоимость одного и того же промпта может различаться более чем на половину.
💡 О данных: эти цифры взяты из разовых расчётов стороннего блога. Тестовые задачи, версии моделей и цены со временем меняются, поэтому данные лишь подтверждают, что такая разница существует. Использовать их напрямую для планирования бюджета нельзя — ваши собственные задачи нужно протестировать отдельно.
Из чего складывается счёт за модель: какие токены формируют реальную стоимость
Чтобы точно рассчитать расходы, сначала нужно разобраться, за что именно выставляют счёт. Большинство поставщиков выделяют несколько категорий оплаты, приведённых в таблице. Их названия и то, тарифицируются ли они отдельно, уточняйте в официальной документации каждого поставщика.
| Статья расходов | Что означает | Как обычно тарифицируется | Что легко упустить |
|---|---|---|---|
| Входные данные без попадания в кеш | Промпт, отправленный в текущем запросе и не найденный в кеше | По цене входных токенов | Токенизация влияет на цену: один и тот же текст может стоить по-разному |
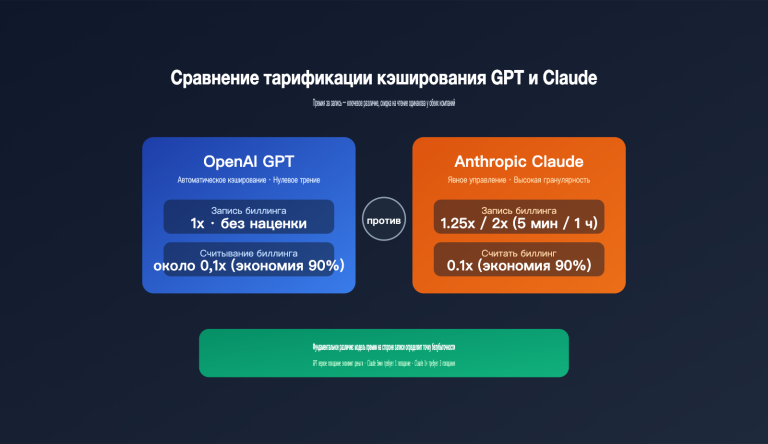
| Входные данные с попаданием в кеш | Часть префикса, совпадающая с предыдущими запросами | По цене чтения из кеша, обычно гораздо ниже цены входных токенов | Для попадания в кеш префикс должен совпадать полностью |
| Запись в кеш | Некоторые поставщики отдельно взимают плату за первую запись в кеш | Может стоить дороже обычных входных токенов | При низкой доле попаданий в кеш расходы могут оказаться выше |
| Видимый вывод | Ответ, который в итоге видит пользователь | По цене выходных токенов | Цена выходных токенов обычно в несколько раз выше цены входных |
| Токены рассуждений | Внутренний процесс рассуждения модели | Обычно по цене выходных токенов | Не отображаются в ответе, но включаются в счёт |
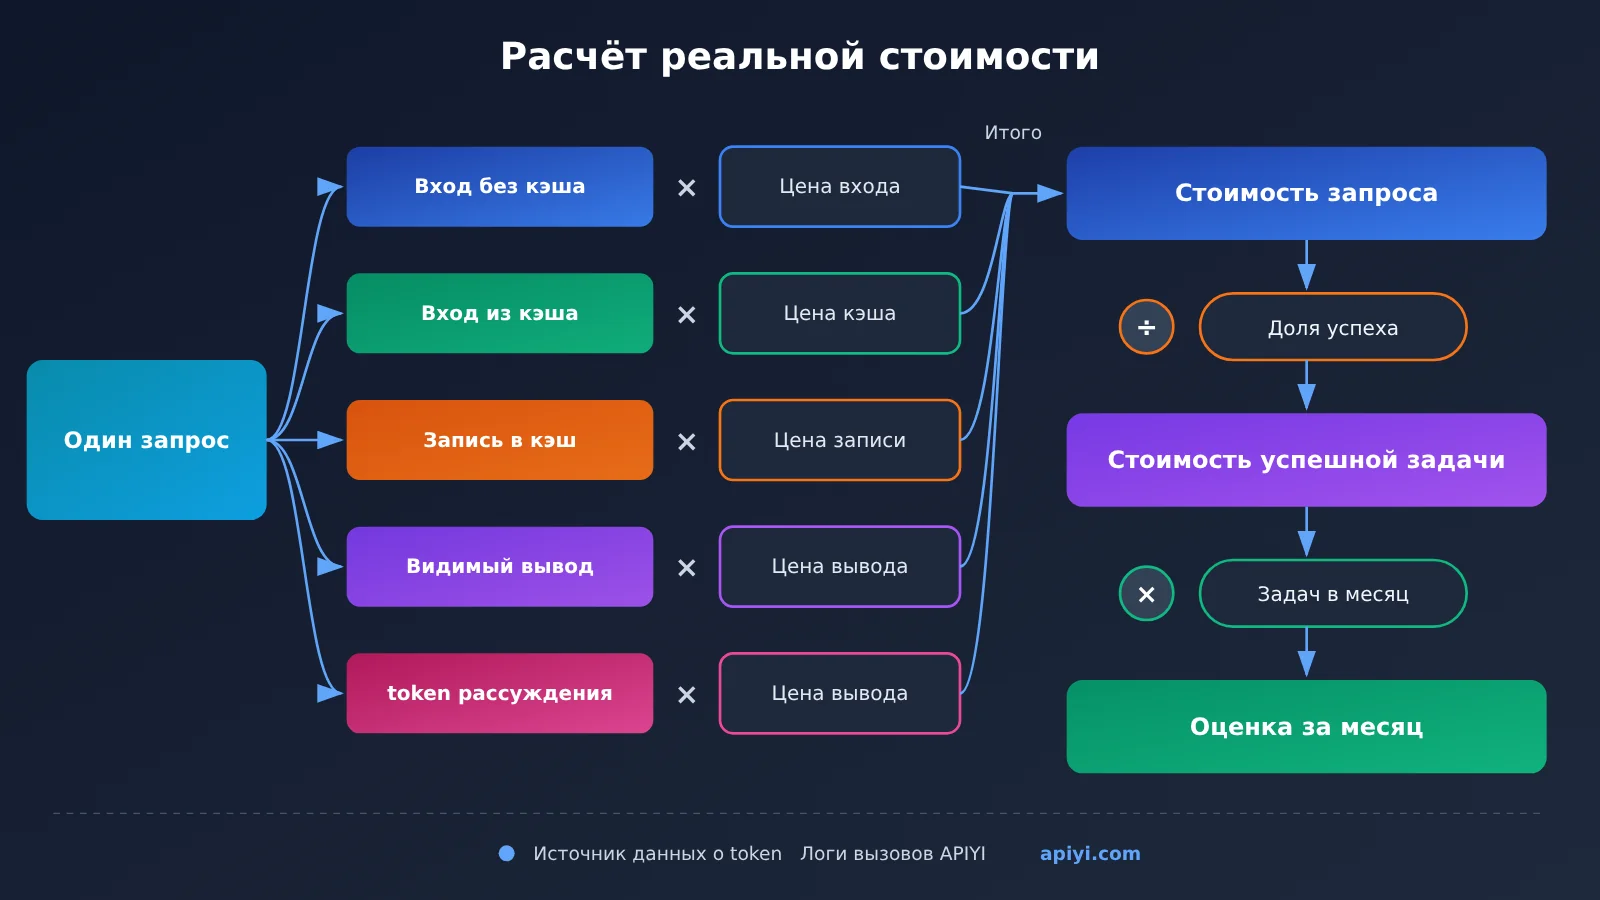
Если объединить эти статьи в формулы, получится основа расчётов для этой статьи:
- Стоимость одного запроса = входные токены без попадания в кеш × цена входных токенов + токены с попаданием в кеш × цена чтения из кеша + токены, записанные в кеш × цена записи + (видимый вывод + токены рассуждений) × цена выходных токенов
- Эффективная стоимость одной задачи = стоимость одного запроса × среднее число вызовов ÷ доля успешно выполненных задач
- Прогноз на месяц = эффективная стоимость одной задачи × число задач в месяц
Влияние кеша часто недооценивают. В статье того же источника от 6 августа 2026 года говорится, что для DeepSeek V4 Flash цена токенов с попаданием в кеш примерно в 50 раз ниже цены токенов без попадания, а цены на кеширование у разных хостинг-провайдеров могут различаться в 28 раз. Это означает, что счета за одну и ту же модель при использовании разных каналов доступа могут сильно отличаться. Поэтому цену кеширования нужно проверять для канала, которым вы пользуетесь.
Как токены рассуждения увеличивают реальные расходы
Модели с рассуждением — самый частый пример того, как низкая цена по прайсу оборачивается высоким счётом. Пользователь задаёт короткий вопрос и получает ответ на 200 символов, но внутри модель может потратить несколько тысяч токенов на рассуждение. Обычно они оплачиваются по тарифу на выходные токены, который сам по себе в несколько раз выше тарифа на входные.
Это подтверждают и опубликованные независимые расчёты. В статье от 4 августа 2026 года говорится, что Qwen 3.8 Max набрала в рейтинге Artificial Analysis на 3 балла больше, чем DeepSeek V4 Flash, но при тестировании на трёх задачах оказалась примерно в 345 раз дороже и в 6 раз медленнее. Другая статья из той же серии, где использовалась та же методика оценки, приводит такие результаты: Kimi K3 набрала 57 баллов при стоимости $2,437, DeepSeek V4 Flash — 50 баллов при стоимости $72, а Qwen 3.7 Max получила 46 баллов, но обошлась в $1,604. Более низкий результат при более высоких расходах — вполне реальная ситуация, и причина часто кроется именно в количестве потраченных токенов.
Различия встречаются и между версиями моделей одного производителя. В одной из статей отмечается, что Claude Opus версий с 4.5 по 4.8 и Opus 5 имеют одинаковую цену — $5/$25, — но в тестах расход токенов различался примерно в 1,30 раза. Цена не меняется, а счёт может вырасти на 30% — и это легко упустить из виду при переходе на новую версию модели.
Оцениваем реальные затраты по расходу токенов: 5 шагов для быстрого старта
Ниже — способ оценки на небольшой выборке, для которого не нужны сложные скрипты. Главное правило одно: для одной и той же задачи с одинаковыми входными данными отдельно считайте входные, выходные, кэшируемые и использованные для рассуждений токены.
Шаг 1. Подготовьте репрезентативную выборку задач
Выберите 20–50 запросов из продакшена или реальных сценариев, охватив основные типы задач: короткие вопросы и ответы, длинные документы, многоходовые диалоги. Сохраните в выборке полные системные промпты и контекст: кэш чаще всего срабатывает именно на этих повторяющихся префиксах. Не ограничивайтесь проверкой на одном слове «привет» — так вы не увидите различий в токенизации и эффекта кэширования.
Шаг 2: Зафиксируйте параметры и вызовите каждую модель-кандидат
Для всех моделей используйте одинаковый системный промпт, пользовательский запрос, значение max_tokens и температуру. Если модель с рассуждениями поддерживает настройку интенсивности рассуждений, запишите выбранный уровень: от него может сильно зависеть количество токенов рассуждения.
На этом этапе единая точка доступа избавит от лишних хлопот. Через платформу-агрегатор, такую как APIYI apiyi.com, можно переключаться между моделями разных поставщиков с одним API-ключом и единым OpenAI-совместимым способом вызова. Для сравнения достаточно менять имя модели — не придётся отдельно регистрироваться у каждого поставщика, пополнять баланс и адаптировать SDK.
Шаг 3: Запишите количество токенов каждого типа
После каждого вызова считайте количество токенов из поля usage в ответе. В OpenAI-совместимом формате обычно используются следующие поля:
usage.prompt_tokens— общее количество входных токеновusage.prompt_tokens_details.cached_tokens— часть входных токенов, найденная в кэшеusage.completion_tokens— общее количество выходных токеновusage.completion_tokens_details.reasoning_tokens— часть выходных токенов, использованная для рассуждений
Названия полей у разных поставщиков отличаются. Например, в формате Anthropic поля cache_read_input_tokens и cache_creation_input_tokens обозначают чтение из кэша и запись в него соответственно. Подробности смотрите в документации конкретного поставщика.
Если не хочется разбирать ответы самостоятельно, можно посмотреть записи на стороне платформы. APIYI предоставляет логи каждого вызова и статистику использования — это удобно для сравнения расходов разных моделей на одной и той же выборке. Но перед расчётами проверьте, выделяются ли в логах токены кэша и токены рассуждения отдельно и тарифицируются ли обращения к кэшу по отдельной цене. Ориентируйтесь на данные в консоли и описание тарифов платформы.
🚀 Быстрый старт: попробуйте провести небольшое сравнение на 20 примерах через APIYI apiyi.com. Оцените порядок расхода токенов у каждой модели и затем решите, стоит ли расширять выборку. Преимущество единого баланса в том, что расходы на тестирование всех моделей собираются в одном аккаунте — после теста их проще сверить.
Шаг 4: Сведите результаты в шаблон
Занесите результаты в таблицу ниже: по одной строке на каждую модель. Для цен обязательно укажите дату проверки и источник.
| Поле | Как заполнить | Источник данных |
|---|---|---|
| Модель и версия | Укажите точный номер версии или суффикс с датой | Параметры вызова |
| Цены и дата проверки | Отдельные столбцы для входных и выходных токенов, чтения и записи кеша | Официальная страница с ценами или страница используемой платформы |
| Среднее число входных токенов без попадания в кеш | Среднее по выборке | usage в ответе или логи платформы |
| Среднее число токенов, найденных в кеше | Среднее по выборке; также рассчитайте долю попаданий в кеш | usage в ответе или логи платформы (например, статистика использования APIYI) |
| Среднее число видимых выходных токенов | Общее число выходных токенов за вычетом токенов рассуждения | usage в ответе |
| Среднее число токенов рассуждения | Отдельно укажите для моделей с рассуждением | usage в ответе |
| Доля успешных задач | Доля результатов, признанных приемлемыми вручную или по заданным правилам | Записи оценки |
| Эффективная стоимость одной задачи | Рассчитайте по формуле выше | Итоговый расчёт |
Шаг 5: Принимайте решение по эффективной стоимости одной задачи
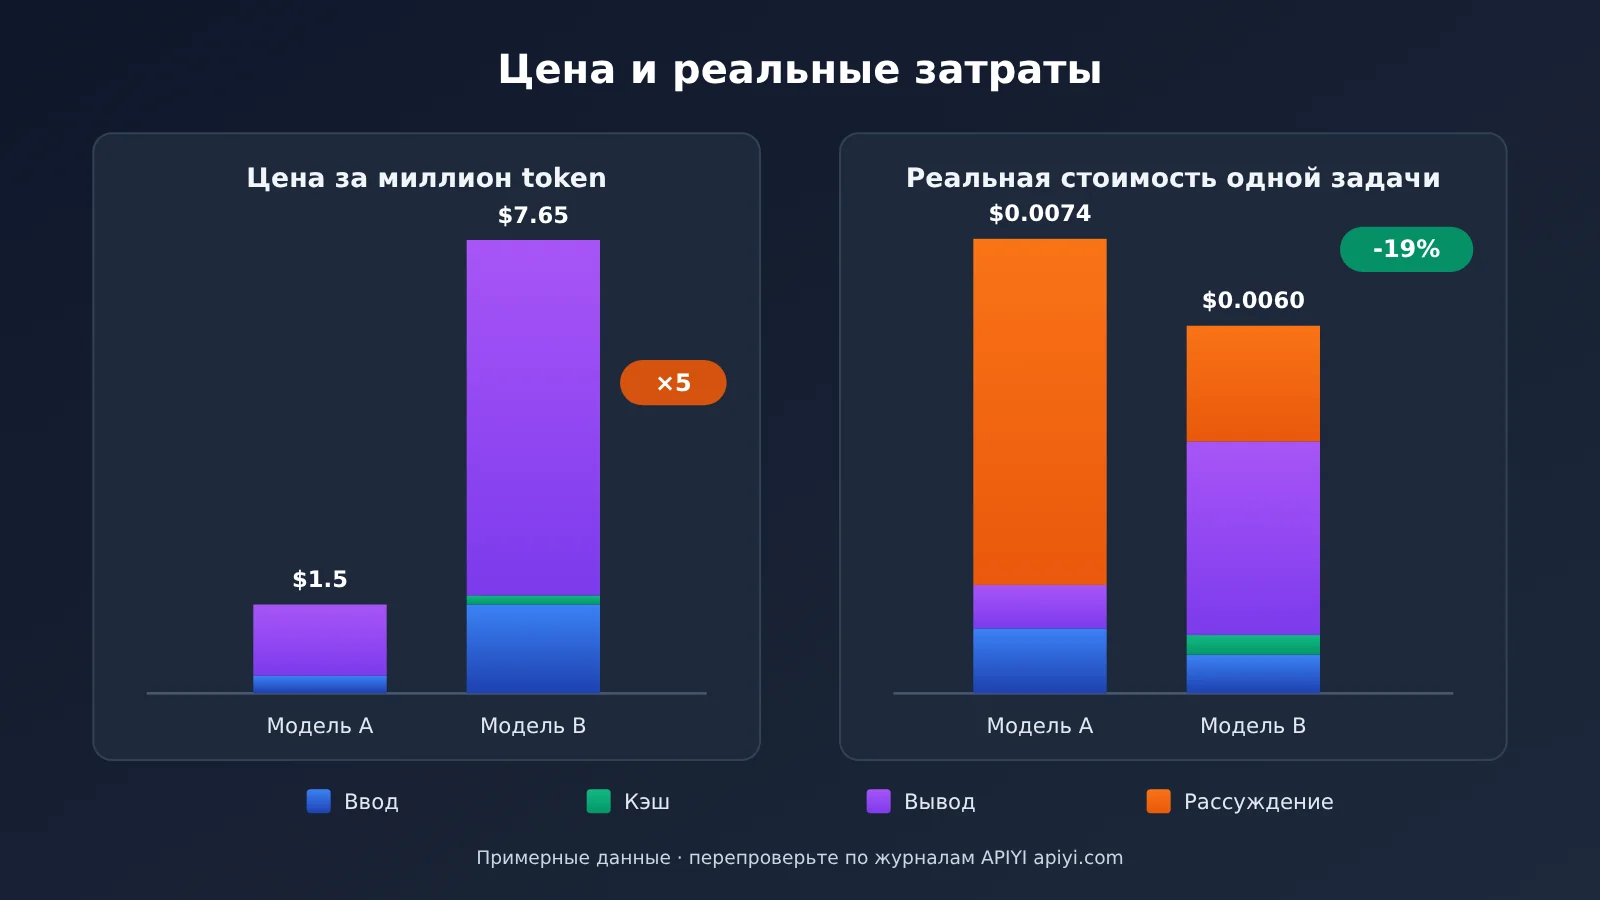
В итоге сравнивать нужно не цены за токены, а «эффективную стоимость одной задачи». Ниже показан пример расчёта с условными ценами. Цифры вымышлены и не отражают реальные цены каких-либо моделей.
Допустим, модель A стоит $0.3/M за входные и $1.2/M за выходные токены. Модель B стоит $1.5/M за входные токены, $6/M за выходные и $0.15/M за чтение из кеша — в 5 раз дороже модели A.
| Показатель | Модель A (низкая цена) | Модель B (высокая цена) |
|---|---|---|
| Входные токены без попадания в кеш | 3,000 | 400 |
| Токены, найденные в кеше | 0 | 2,000 |
| Видимые выходные токены + токены рассуждения | 500 + 4,000 | 500 + 300 |
| Стоимость входных токенов | $0.0009 | $0.0006 + $0.0003 |
| Стоимость выходных токенов | $0.0054 | $0.0048 |
| Стоимость одного запроса | $0.0063 | $0.0057 |
| Доля успешных задач | 85% | 95% |
| Эффективная стоимость одной задачи | около $0.0074 | около $0.0060 |
В этом примере модель B токенизирует текст компактнее: всего на входе получается на 600 токенов меньше. Большая часть длинного системного промпта найдена в кеше, а процесс рассуждения намного короче. В итоге эффективная стоимость модели B, которая по прайсу в 5 раз дороже, оказывается примерно на 19% ниже, чем у A. На практике результат может быть противоположным — поэтому важно повторить замеры на собственных задачах.
На что обратить внимание при расчёте реальной стоимости
Сама схема расчёта несложная, но есть несколько подводных камней, которые могут исказить результаты. Перед началом стоит проверить каждый из них:
- Обязательно указывайте дату цены: цены на модели часто меняются. Например, в одном из источников говорится, что для DeepSeek V4 Pro 0813 с 16 августа 2026 года действуют разные тарифы для пиковых и непиковых часов. Цена одной и той же модели может отличаться в зависимости от времени и канала доступа.
- Проверяйте, на какую версию указывает псевдоним модели: в одной из статей упоминается, что имя модели, которое выглядит как «самое распространённое», на самом деле вызывает старую версию. При расчётах записывайте идентификатор модели из ответа, чтобы не тестировать версию A, а запускать в продакшене версию B.
- Попадание в кэш зависит от совпадения префикса: если поместить динамические данные — временную метку или ID пользователя — в начало промпта, префикс каждый раз будет меняться, и попаданий в кэш почти не будет. При расчётах используйте ту же структуру промпта, что и в продакшене.
- Сторонние бенчмарки используйте только для ориентира: сводные оценки вроде Artificial Analysis и рассчитанная по задачам стоимость отражают распределение задач у авторов тестов и не обязательно соответствуют вашему бизнес-сценарию.
- Учитывайте повторные попытки: повторные запросы из-за ограничения частоты 429, ошибок формата или неудовлетворительных ответов тоже стоят денег. Долю успешных запросов нужно рассчитывать по фактическим результатам проверки.
💰 Совет по оптимизации затрат: после расчётов можно выбрать «стоимость одной успешно выполненной задачи» в качестве главного критерия выбора модели, а результаты бенчмарков и задержку использовать как ограничения. В APIYI apiyi.com для переключения модели достаточно изменить её имя. Это позволяет быстро менять конфигурацию в продакшене, если выводы расчётов изменились, и при этом продолжать следить за фактическими расходами по логам вызовов.
Часто задаваемые вопросы FAQ
Q1: Что такое «реальная стоимость» модели?
Это фактические расходы на выполнение конкретной задачи, а не цена за миллион токенов. Для расчёта количество токенов каждого типа (входных без попадания в кеш, прочитанных из кеша, записанных в кеш, видимых выходных и токенов рассуждения) умножают на соответствующую цену, а затем учитывают долю успешных запросов и повторные попытки. Так получают эффективную стоимость выполнения одной задачи.
Q2: Почему количество токенов в одном и том же документе различается у разных моделей?
Каждая модель использует свой токенизатор, который по-разному разбивает китайский текст, код и знаки препинания. В одном из опубликованных расчётов девять моделей насчитали в одном документе от 614 до 957 токенов. Поэтому стоимость входных данных нужно рассчитывать по количеству токенов, которое сообщает каждая модель, а не использовать результат одной модели для остальных.
Q3: Обязательно ли учитывать стоимость токенов рассуждения?
Да. Большинство провайдеров включают токены рассуждения в выходные токены и взимают за них плату по выходному тарифу. В тексте ответа они не видны, но могут составлять большую часть выходных токенов. При оценке моделей с рассуждением рекомендуем отдельно записывать `reasoning_tokens` и сравнивать модели при одинаковом уровне интенсивности рассуждений.
Q4: Сколько можно сэкономить при попадании в кеш?
Это зависит от тарифов провайдера и доли попаданий в кеш. В источниках указано, что цена токенов при попадании в кеш для DeepSeek V4 Flash составляет примерно 1/50 от цены без попадания. При этом цены на кеш у разных провайдеров хостинга могут отличаться в 28 раз. Наибольшую выгоду кеширование приносит при длинных системных промптах, фиксированных префиксах базы знаний и многоходовых диалогах. Точные цены уточняйте у выбранного провайдера.
Q5: Как быстро оценить стоимость нескольких моделей на небольшой выборке?
Рекомендуем использовать платформу с единым доступом к нескольким моделям:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ
2. Подготовьте от 20 до 50 примеров реальных задач и зафиксируйте промпты и параметры
3. Вызывайте модели по очереди, меняя их названия, и соберите данные о токенах каждого типа из журналов вызовов и статистики использования
4. Рассчитайте эффективную стоимость одной задачи по шаблону из этой статьи
Так можно провести всё сравнение с одним аккаунтом и единым способом вызова, не тратя время на регистрацию и сверку счетов у разных провайдеров.
Q6: Можно ли напрямую использовать «стоимость задачи» из сторонних блогов?
Для планирования бюджета — не рекомендуем. Такие данные помогают найти модели, у которых могут различаться расходы токенов, и сузить круг кандидатов. Но задачи в тестах, версии моделей, цены и условия кеширования могут отличаться от ваших, поэтому итоговые показатели нужно перепроверить на собственных примерах.
Q7: Какие ограничения есть у этого метода оценки?
Небольшая выборка отражает только те типы задач, которые в ней представлены. Если распределение рабочих задач изменится, тестирование нужно повторить. Кроме того, в логах некоторых платформ токены кэша и рассуждений не разделяются — тогда их приходится собирать самостоятельно из поля `usage` в ответе модели. Цены и версии моделей тоже меняются, поэтому после каждого изменения цен или обновления стоит провести новый тест.
Главное о расчёте реальной стоимости моделей
- Цена за токен — лишь половина формулы: сумма в счёте зависит от цены и фактического количества использованных токенов.
- Разницу в токенизации нельзя игнорировать: число токенов в одном и том же документе для разных моделей может отличаться более чем на 50%.
- Токены рассуждений увеличивают стоимость вывода: невидимый процесс обдумывания тоже оплачивается по тарифу на выходные токены.
- Цена кэша зависит от канала доступа: в сценариях с длинными промптами стоимость определяется и долей попаданий в кэш, и ценой кэшированных токенов.
- Принимайте решение по эффективной стоимости одной задачи: учитывайте вероятность успеха и повторные попытки.
- Используйте единую точку доступа для повторных тестов: с единым интерфейсом и логами вызовов APIYI проще проверить несколько моделей на одной и той же выборке.
Итоги
Чтобы оценить реальную стоимость модели с учётом расхода токенов и кэширования, важно сделать три вещи:
- Разобрать счёт на составляющие: отдельно подсчитать входные токены без попадания в кэш, токены при попадании в кэш, токены при записи в кэш, токены видимого ответа и токены рассуждений, умножив каждое значение на соответствующий тариф.
- Проверить на собственных задачах: сторонние тесты и цены — лишь ориентир. Надёжнее опираться на собственные замеры для одной и той же задачи с одинаковыми входными данными.
- Сравнить эффективную стоимость одной задачи: учесть долю успешных попыток и повторные запросы, а затем рассчитать бюджет исходя из месячного объёма задач.
Цены на модели меняются, новые модели появляются постоянно, но этот метод расчёта будет полезен и дальше. Перед следующим выбором модели попробуйте сравнить варианты на 20 реальных примерах и только потом решайте, какой из них запускать в продакшен. Если нужно быстро переключаться между моделями разных поставщиков для тестирования, можно подключить их через APIYI apiyi.com и сверять фактический расход каждой модели по журналу вызовов.
📚 Источники
- Ofox.ai Blog, страница 23: краткие обзоры статей со сравнением расхода токенов DeepSeek V4 Flash и Gemini 3.6 Flash, различий в ценах на кэширование и расчётов стоимости моделей Qwen
- Ссылка:
ofox.ai/blog/page/23/ -
Примечание: статьи опубликованы в августе 2026 года; данные основаны на разовых сторонних замерах и приведены только для общего представления
-
Ofox.ai Blog, страница 22: сравнение количества токенов одного документа в 9 моделях, различия в расходе токенов между версиями Claude, тарифы DeepSeek V4 Pro в зависимости от времени суток и другая информация
- Ссылка:
ofox.ai/blog/page/22/ -
Примечание: конкретные примеры различий в токенизации и между версиями моделей
-
Ofox.ai Blog, страница 25: сравнение стоимости одной задачи для Kimi K3, GLM-5.2 и Opus 4.8
- Ссылка:
ofox.ai/blog/page/25/ - Примечание: цены и результаты тестов со временем меняются; перед использованием сверяйтесь с официальными страницами тарифов поставщиков
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com