В этой статье на примерах миграции, клиентской поддержки и кода с GPT-6.1 Sol и GPT-6.2 Sol показано, как сначала зафиксировать критерии приёмки для бизнеса, а затем выбрать уровень рассуждений, который стабильно их достигает, и рассчитать стоимость каждой задачи, прошедшей приёмку.
Сначала вывод: при настройке уровня нужно сравнивать «сколько денег и времени стоит каждая задача, прошедшая приёмку», а разовая цена вызова по прайсу — лишь один из пунктов. В опубликованных тестах на небольшой выборке GPT-6.2 Sol на уровне low показал столько же успешных ответов, сколько и medium, на вопросах о политике поддержки и на наборе задач по коду, причём быстрее. В задачах по коду стоимость low в пересчёте по прайсу составляет около 70% от medium. Для справедливости вывода нужны два условия: ваши задачи должны быть достаточно похожи на тестовые, а критерии приёмки должны учитывать не только долю успешных ответов, но и проверку вымышленных ссылок, полей сумм и переделок. Задачи с конфликтами между источниками, сложными зависимостями от инструментов или склонностью терять ограничения по-прежнему требуют отдельной проверки уровня medium и выше.
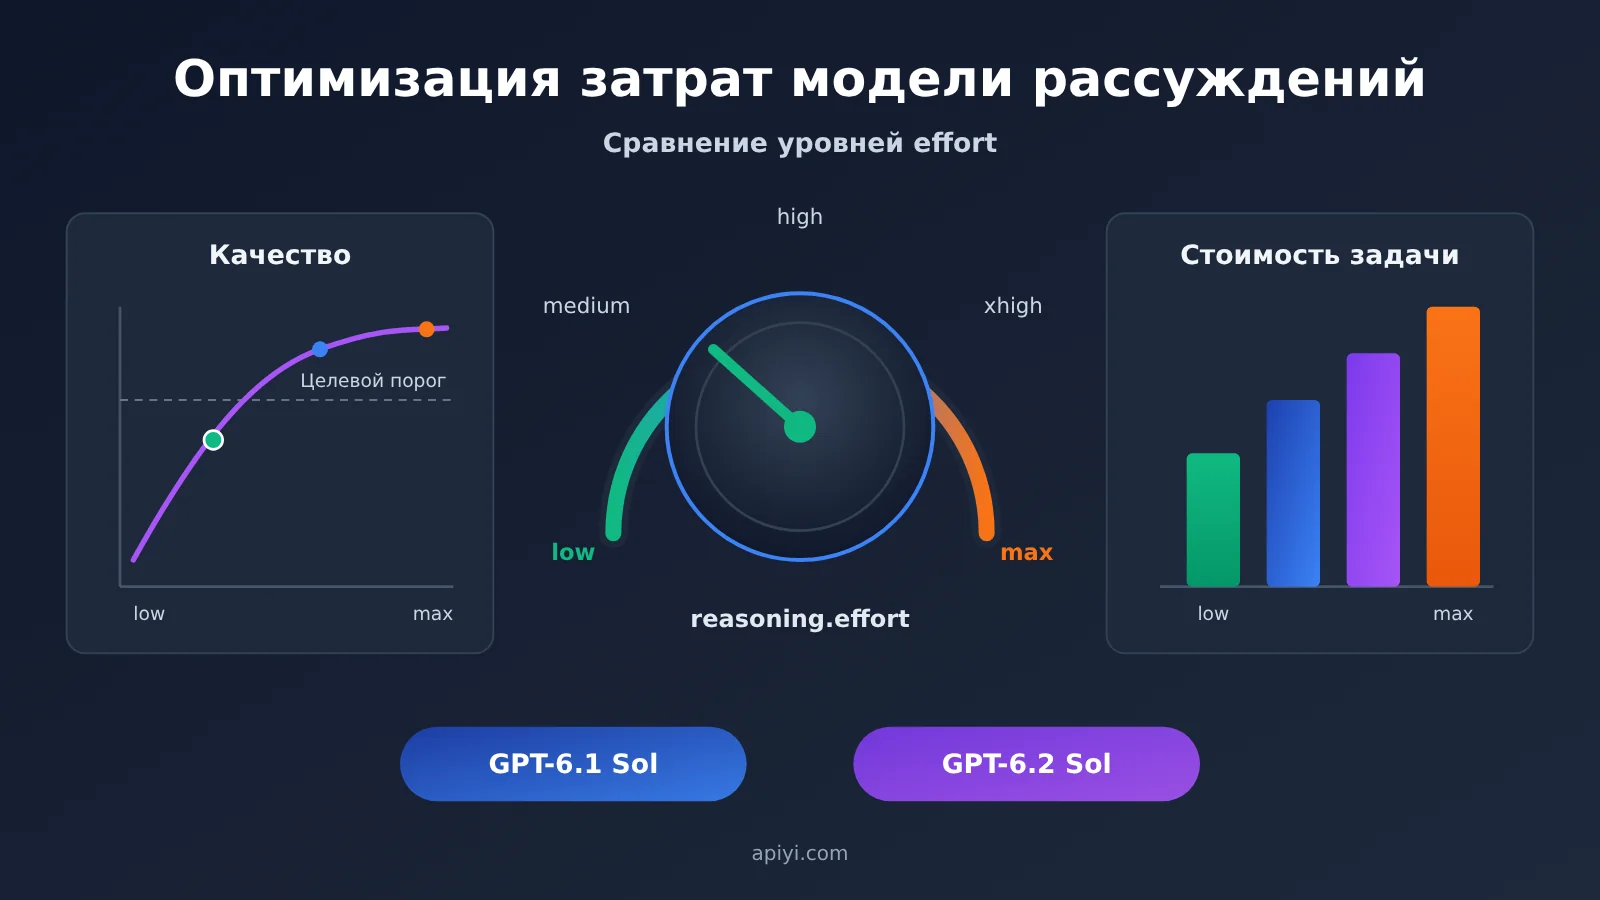
Краткое сравнение уровней effort у reasoning-моделей
В таблице ниже собраны несколько наборов данных, на которые мы будем опираться в этой статье. В каждой строке указано, откуда взяты цифры и по какой методике они получены. Числа из разных источников нельзя напрямую складывать или смешивать.
| Критерий сравнения | GPT-6.1 Sol | GPT-6.2 Sol | Что означает разница |
|---|---|---|---|
| Доступные уровни (документация OpenAI) | low, medium, high, xhigh, max | те же пять уровней, none не поддерживается |
При переходе с моделей, где можно задавать none/minimal, придётся менять стартовый уровень |
| Цены APIYI при коротком контексте (сводная таблица от 2026-11-20, USD за миллион токенов) | вход $2, чтение из кэша $0.10, выход $10 | так же | На коротком контексте цены обоих поколений совпадают, разница в стоимости зависит в основном от объёма использования |
| Цена входа при более чем 272 000 входных токенов | APIYI и OpenAI Standard указывают $4 | APIYI указывает $3, OpenAI Standard — $4 | На длинном входе между каналами появляется разница в цене |
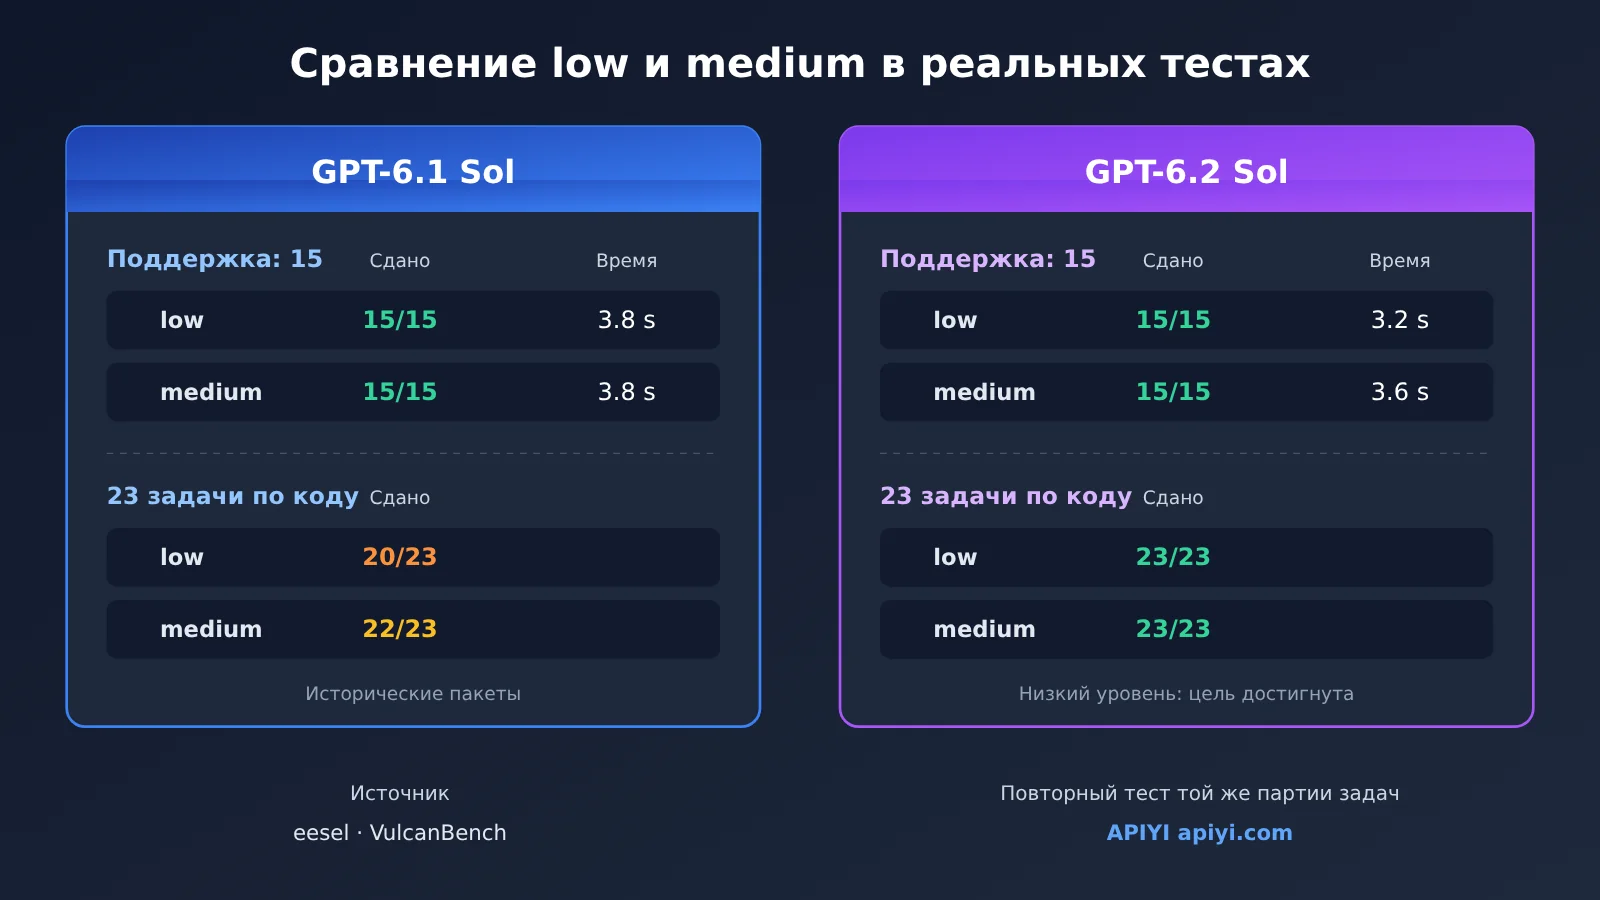
| eesel, поддержка клиентов, 15 обращений (low / medium) | 15/15, 3.8 с; 15/15, 3.8 с | 15/15, 3.2 с; 15/15, 3.6 с | Доля успешных ответов одинаковая, разница в затратах между уровнями небольшая |
| VulcanBench, 23 задачи по коду (low / medium) | 20/23; 22/23 (историческая выборка) | 23/23; 23/23 | Низкий уровень 6.2 Sol уже проходит порог; цифры по разным версиям получены на разных выборках |
| Artificial Analysis Index (по цитированию OrcaRouter, low / medium) | 35; 46 | 41; 53 | Сторонний сводный индекс; соответствие уровней этому бенчмарку определяет он сам |
Дальше статья идёт в таком порядке: в разделе 1 разбираемся, можно ли подключиться и как считается цена, в разделе 2 смотрим результаты замеров на одинаковых задачах, в разделе 3 даём шаги по миграции и приёмке, в разделе 4 решаем вопрос переключения уровня посреди многоходовой сессии. Если вы уже проверили маршрутизацию моделей и цены, можно сразу начинать со раздела 2.
Термины, связанные с уровнями reasoning effort, которые нужно знать
| Термин | Объяснение |
|---|---|
reasoning.effort |
Поле в Responses API, задающее интенсивность «размышлений» модели |
| Токены рассуждения | Объём рассуждений, который модель расходует, чтобы прийти к ответу. Он входит в оплачиваемые output_tokens, и его нужно отличать от видимого пользователю вывода |
low / medium |
Два уровня рассуждения. При переходе на новую версию в рамках того же уровня всё равно нужно повторно проходить приёмку |
| Цена чтения из кэша | Применяется только к той части входа, которая попадает в переиспользуемый префикс; её нельзя напрямую вывести из общего числа токенов |
| Префикс запроса | Контекст, уже существующий перед текущим сообщением. Изменение ранней истории влияет на переиспользование кэша и элементов рассуждения |
configuration_update |
Входной элемент, который в сессиях Responses с поддержкой этой функции используется для корректировки последующей конфигурации |
| Порог приёмки | Минимально допустимый стандарт корректности политики, прохождения функциональности или уровня доработок |
| Стоимость на одно зачётное задание | Стоимость вызовов, повторных попыток, работы инструментов и ручных доработок за весь эксперимент, делённая на число зачётных заданий |
1. До оптимизации стоимости reasoning-моделей: когда стоит трогать уровень effort
1.1 Как два поколения Sol подключены в APIYI
Судя по обновлениям платформы APIYI, GPT-6.1 Sol появился 30 сентября 2026 года, а GPT-6.2 Astra и Sol были анонсированы к запуску 18 ноября 2026 года. В сводной таблице цен от 20 ноября 2026 года оба варианта Sol одновременно доступны через два маршрута — responses и chat. Затронутые группы: CodexResponses, Codex_Reverse, Default и SVIP. Какие возможности реально доступны аккаунту, зависит от группы, к которой относится токен.
Согласно документации OpenAI, оба поколения Sol поддерживают Chat Completions и Responses, но вызовы инструментов должны идти через Responses, а уровень задаётся через reasoning.effort. Поэтому если в бизнес-процессах есть инструментальные шаги вроде проверки заказов или выполнения кода, и тестирование, и продакшен должны единообразно использовать маршрут Responses — чтобы различия в поведении двух маршрутов не попали в результаты сравнения.
1.2 Две ценовые базы: прайс APIYI и стандартные тарифы upstream
| ID модели (сводная таблица APIYI, 2026-11-20) | Обычный ввод | Чтение кэша | Вывод | Доступные платформы |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, официальный OpenAI |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, официальный OpenAI |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
В таблице выше — стандартные цены для короткого контекста в долларах за миллион токенов. В карточке upstream-цен, составленной OrcaRouter, для обоих поколений Sol указаны одинаковые цены на ввод, чтение кэша и вывод, а также отдельно — запись в кэш $2.50. Длинный контекст нужно проверять отдельно: для gpt-6.2-sol при вводе свыше 272,000 токенов APIYI сейчас указывает $3, а официальный OpenAI Standard — $4; для gpt-6.1-sol в обоих случаях $4. Цены на кэш и вывод для длинного контекста уточняйте по актуальным правилам тарификации каждого канала.
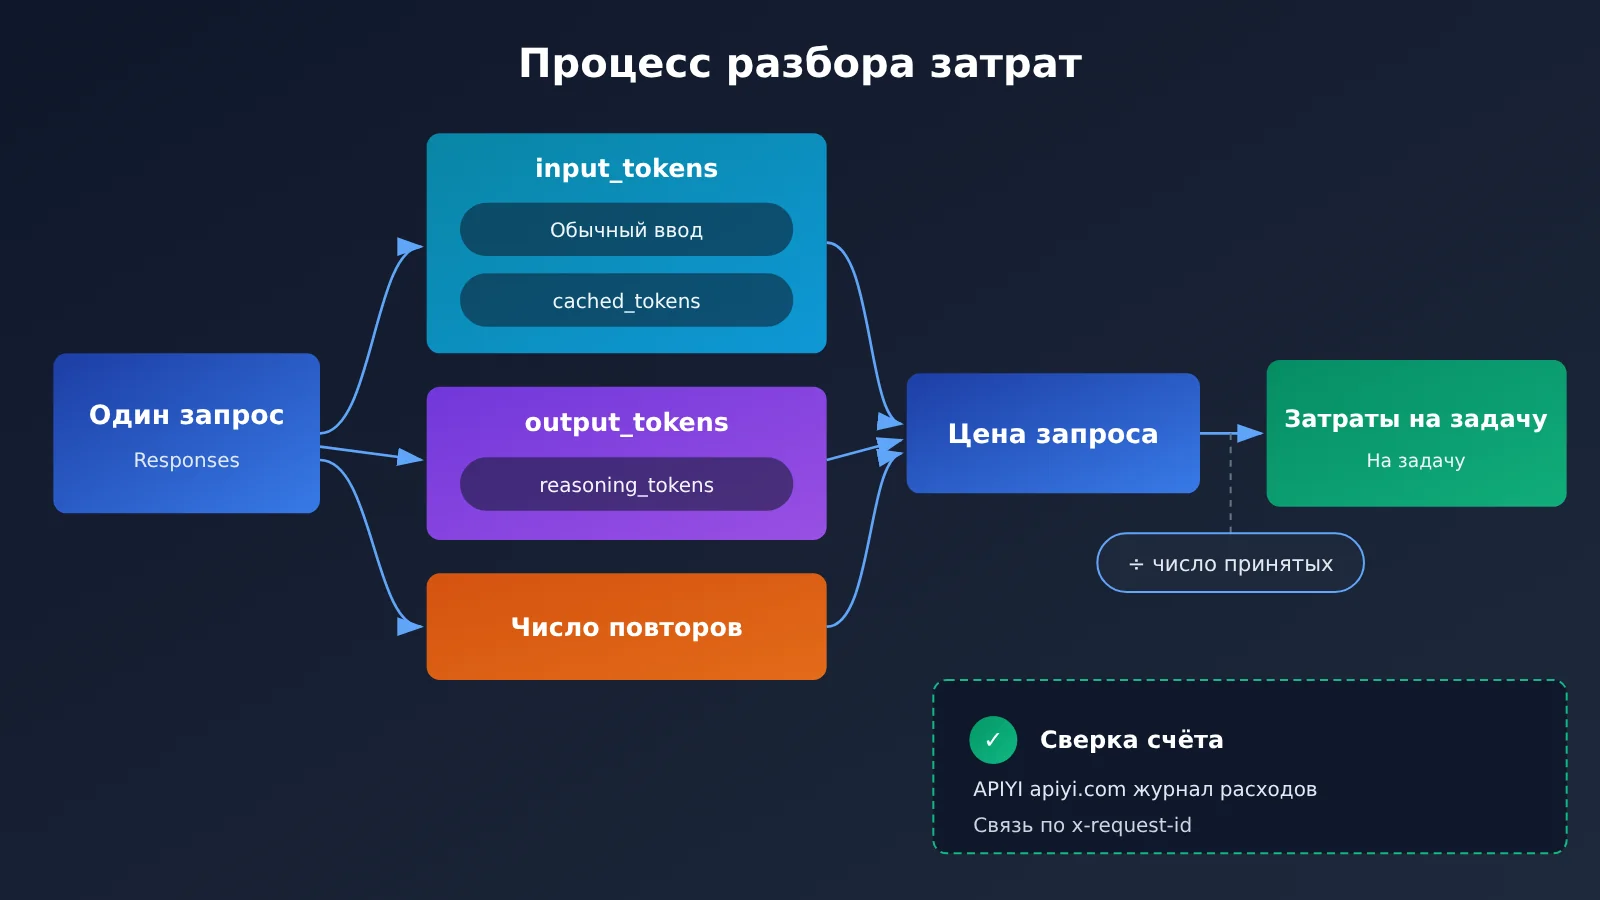
1.3 Стоимость нужно брать из реальных ответов и счетов
Цены в прайсе годятся только для оценки. Ниже — гипотетический пример, показывающий, как раскладывается стоимость. Допустим, на каждый раунд приходится 12 000 входных токенов, без записи в кеш и без платы за инструменты:
- Сохранённый префикс: чтение из кеша — 9 000, общий вывод — 1 000, оценка около $0.0169.
- Изменённый префикс: чтение из кеша снижается до 3 000, общий вывод растёт до 1 600, оценка около $0.0343.
В разнице между ними около $0.0114 приходится на 6 000 входных токенов, которые переходят с кешированной цены обратно на обычную, а около $0.0060 — на дополнительные 600 выходных токенов. Это вымышленные данные; фактическую разницу смотрите в usage. Если запись в кеш тарифицируется отдельно, считайте обычный ввод, чтение из кеша и запись в кеш как три взаимоисключающие категории.
Как сверять фактическое списание: по x-request-id из заголовков ответа найдите запись с type=2 в журнале расходов APIYI и пересчитайте фактическое списание в доллары по формуле quota ÷ 500,000. Заодно фиксируйте модель, группу токенов, временное окно вызова, объём ввода и вывода и число повторов.
Ниже — минимальный пример вызова, который заодно выводит поля расхода, нужные для диагностики:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 Быстрый старт: рекомендую сначала прогнать пример выше на APIYI apiyi.com с бесплатной квотой для новых пользователей, убедиться, что целевая группа корректно возвращает
cached_tokensиreasoning_tokens, и только потом запускать массовую оценку.
2. Сравнение на одной задаче: практические результаты режимов low и medium
2.1 Обращения в поддержку: низкий режим даёт немного
Тестировщики eesel 2026-11-18 прогоняли через Responses API оба поколения Sol в режимах low и medium — всего 60 вызовов. Каждая конфигурация покрывала одни и те же 15 тикетов: возвраты, запросы по доставке и сбои инструмента заказов; оценку ставили вручную по вымышленной политике SaaS.
| Конфигурация (eesel, 15 тикетов) | Пройдено | Среднее время | Стоимость по прайсу за 1000 шт. |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3,8 сек. | $1,32 |
| GPT-6.1 Sol medium | 15/15 | 3,8 сек. | $1,35 |
| GPT-6.2 Sol low | 15/15 | 3,2 сек. | $1,41 |
| GPT-6.2 Sol medium | 15/15 | 3,6 сек. | $1,42 |
В этих данных low и medium различаются всего на несколько центов за тысячу, так что режим выбирают скорее по задержке, чем по цене. К тому же, если пересчитать по фактическому расходу, GPT-6.2 Sol на этих задачах поддержки оказался даже чуть дороже, чем 6.1 Sol. Важнее другое: хотя у всех четырёх конфигураций проходимость стопроцентная, автор всё равно заметил, что 6.2 Sol выдаёт ссылки на отслеживание доставки, которых нет в ответе инструмента. Это значит, что если при приёмке поддержки смотреть только на «правильный ответ по политике», такие проблемы проскочат — источник ссылок и полей нужно проверять отдельно. Эти наблюдения применимы только к этому набору тикетов, этой методике оценки и тестовой среде OpenAI.
2.2 Задачи с кодом: стоимость одной задачи на низком уровне стоит измерить на практике
19.11.2026 VulcanBench с помощью Codex прогнал GPT-6.2 Sol по всем уровням конфигурации на одном и том же наборе из 23 тестовых задач — всего 115 запусков. Суммы в таблице ниже рассчитаны по чекам о запусках исходя из прайс-листа API; это не фактический расчёт по счёту APIYI.
| Конфигурация (VulcanBench, 23 задачи) | Пройдено | Среднее время | По прайсу за задачу | Итоговый балл |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2.8 минуты | $0.23 | 88.44 |
| GPT-6.2 Sol medium | 23/23 | 4.4 минуты | $0.33 | 88.94 |
| GPT-6.2 Sol max | — | 11.3 минуты | $0.55 | 88.74 |
| GPT-6.1 Sol low (исторический запуск) | 20/23 | 6.9 минуты | $0.31 | — |
| GPT-6.1 Sol medium (исторический запуск) | 22/23 | 10.6 минуты | $0.40 | — |
Если смотреть только на группу GPT-6.2 Sol: у low и medium одинаковое число пройденных задач, стоимость одной задачи примерно на 30% ниже, да и времени они требуют меньше; итоговый балл max при этом не превышает балл medium. С межверсионным сравнением нужно быть осторожнее: данные 6.1 Sol взяты из исторической оценки на том же наборе задач и относятся к другой партии тестирования. Итоговый балл — это оценка качества кода, а доля пройденных тестов — другой показатель, одно не заменяет другое.
Artificial Analysis Index v5.0.1, на который ссылается OrcaRouter (считано 20.11.2026), даёт другой ракурс: на уровне low у 6.2 Sol — 41 балл и $0.18 за задачу, у 6.1 Sol — 35 баллов и $0.16; на уровне medium — соответственно 53 балла и $0.41 против 46 баллов и $0.36. Метки уровней в этом сводном рейтинге — собственная схема сопоставления авторов оценки; ваш фреймворк может не использовать такое же сопоставление.
💡 Совет по выбору: оба замера показывают, что порог прохождения, доля повторов и ручная доработка могут изменить «самый выгодный уровень», но всё это ещё не счёт по вашему собственному бизнесу. Рекомендую перепроверить на APIYI apiyi.com в той же группе и на той же партии образцов, прежде чем принимать решение.
3. Порядок миграции и критерии приёмки при оптимизации затрат на модели рассуждения
3.1 Сначала фиксируем базовый вариант, потом меняем уровень
Как советует OpenAI в документе «Using GPT-6.2», при миграции меняйте только одну переменную за раз:
- Сейчас используется 6.1 Sol
low: сначала перейдите на 6.2 Sollowдля сравнения, а затем отдельно проверьтеmedium. - Сейчас используется 6.1 Sol
medium: сначала смените модель, но оставьтеmedium; после прохождения приёмки сравните сlowна том же наборе задач. - Новое подключение: начинайте с
medium. - Миграция с моделей, где можно задать
noneилиminimal: GPT-6.2 Sol начинайте тестировать сlow.
Для простых задач с чёткими ограничениями можно начинать проверку с low; для составных задач повышайте уровень постепенно, ориентируясь на результаты. Во время оценки держите неизменными промпты, определения инструментов, группировку и тестовые выборки. Кроме того, по официальным инструкциям уберите параметры, которые больше не применимы, — например, в запросах Responses去掉 temperature, top_p, top_logprobs.
3.2 Критерии приёмки по сценариям
| Сценарий | Критерии приёмки | Когда стоит рассматривать повышение уровня |
|---|---|---|
| Обычная поддержка клиентов | Согласованность с политиками, корректность полей суммы, условия эскалации на человека; ссылки и номера заказов должны приходить из результата инструмента | Когда возникают конфликты между политиками или цепочки из нескольких инструментов |
| Правки кода | Тесты проходят, ключевые функции сохранены, объём доработок на код-ревью | Когда на низком уровне падает доля успешных прогонов или заметно растёт объём доработок |
| Короткие тексты | Соблюдение ограничений, точность фактических полей, время ручной правки | Когда появляются пропущенные ограничения или фактические ошибки |
Стоимость каждого задания, прошедшего приёмку, считается так: складываем затраты на вызовы, повторные попытки, инструменты и ручную доработку, а затем делим на число таких заданий. Если low достигает согласованных критериев, можно смело выбирать low; если же для low требуются многочисленные повторные попытки или ручная правка, кажущаяся дешевизна может раствориться.
💰 Оптимизация затрат: при сравнении уровней можно создать в APIYI apiyi.com отдельный токен для оценки — тогда логи будут фильтроваться напрямую по токену и модели, и реальные расходы на всю партию экспериментов легко подсчитать.
4. Изменение уровня effort посреди многораундового диалога
4.1 Меняем уровень через configuration_update и сохраняем префикс
В однoагентных сессиях OpenAI HTTP Responses, где поддерживается эта функция, reasoning.effort на уровне запроса остаётся равным начальному значению, а следующий элемент ставится перед очередным сообщением пользователя:
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
Эта настройка действует до следующего обновления. Плюс в том, что не нужно переписывать раннюю историю — префикс запроса остаётся неизменным. Согласно документации OpenAI, начиная с GPT-6.2 редактирование ранней истории может вызвать prefix_mismatch, из-за чего существующие элементы reasoning удаляются; переключение на другое семейство моделей или на модель с меньшими возможностями тоже может привести к удалению элементов reasoning. У перезаписи префикса две цены: чтение из кеша может сократиться, а после потери доступных элементов reasoning может появиться новый вывод reasoning. По официальным пояснениям, удаление целых элементов с сохранением остальных неизменными или добавление новых элементов после элементов reasoning не вызывает такого удаления, но объём попаданий в кеш всё равно может измениться. Кроме того, в GPT-6.2 верхнеуровневый instructions добавляется после input и тарифицируется как некэшированный ввод.
4.2 Сжатие контекста и нюансы маршрутизации в APIYI
При использовании серверного context_management обновлённая конфигурация может сохраняться. Если передать историю со старым configuration_update напрямую в отдельный эндпоинт /responses/compact, запрос будет отклонён; правильный подход — сначала, как описано в официальной документации, отделить элемент конфигурации, а после сжатия добавить одну актуальную конфигурацию.
В APIYI сейчас надёжнее самому управлять историей input, не полагаясь на previous_response_id. Причина в том, что нативное руководство по вызовам APIYI противоречит само себе: в основном тексте сказано, что цепочечное продолжение не работает, а в FAQ записано, что 2026-09-02 это было проверено и работало. В документации APIYI также пока нет результатов проверки configuration_update по группам. Поэтому такие специфичные настройки, возврат зашифрованных элементов reasoning и диагностические поля кеша стоит сначала отдельно проверить короткой сессией на целевом канале и только потом подключать к рабочему процессу.
🎯 Техническая рекомендация: можно сначала прогнать на маршруте Responses в APIYI apiyi.com пару коротких двухраундовых сессий и сравнить
cached_tokens,reasoning_tokensи время выполнения для двух вариантов — «только добавление» и «перезапись префикса», — а потом уже решать, как реализовывать смену уровня на ходу.
Последняя мысль: выбирать уровень стоит по стоимости каждой задачи, прошедшей фиксированный порог приёмки. Один прогон на своих примерах и своём биллинге в APIYI apiyi.com скажет больше, чем любой рейтинг.
Источники
- OpenAI «Using GPT-6.2»: рекомендации по миграции и стартовым уровням усилий
- Ссылка:
developers.openai.com/api/docs/guides/latest-model
- Ссылка:
- OpenAI «Reasoning models»:
configuration_updateи повторное использование шагов рассуждения- Ссылка:
developers.openai.com/api/docs/guides/reasoning
- Ссылка:
- OpenAI «Compaction»: правила сжатия контекста
- Ссылка:
developers.openai.com/api/docs/guides/compaction
- Ссылка:
- OpenAI «Keep the prefix unchanged»: диагностика префикса и кеша
- Ссылка:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Ссылка:
- eesel AI «GPT-6.2 Sol: what’s new, pricing, benchmarks»: замеры на реальных тикетах поддержки, 2026-11-18
- Ссылка:
eesel.ai/blog/gpt-6-2-sol
- Ссылка:
- VulcanBench «GPT-6.2 Sol across effort levels»: оценка по каждой ступени на задачах на код, 2026-11-19
- Ссылка:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- Ссылка:
- OrcaRouter «GPT-6.2 vs GPT-6.1 Sol»: прайс-лист и пересказ сводного индекса, 2026-11-20
- Ссылка:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- Ссылка:
- APIYI «Сводная таблица цен на модели»: данные обновлены 2026-11-20
- Ссылка:
docs.apiyi.com/models
- Ссылка:
Автор: техническая команда APIYI
Техническое общение: будем рады обратной связи — заходите на главную страницу APIYI apiyi.com; больше материалов о подключении — в документации docs.apiyi.com