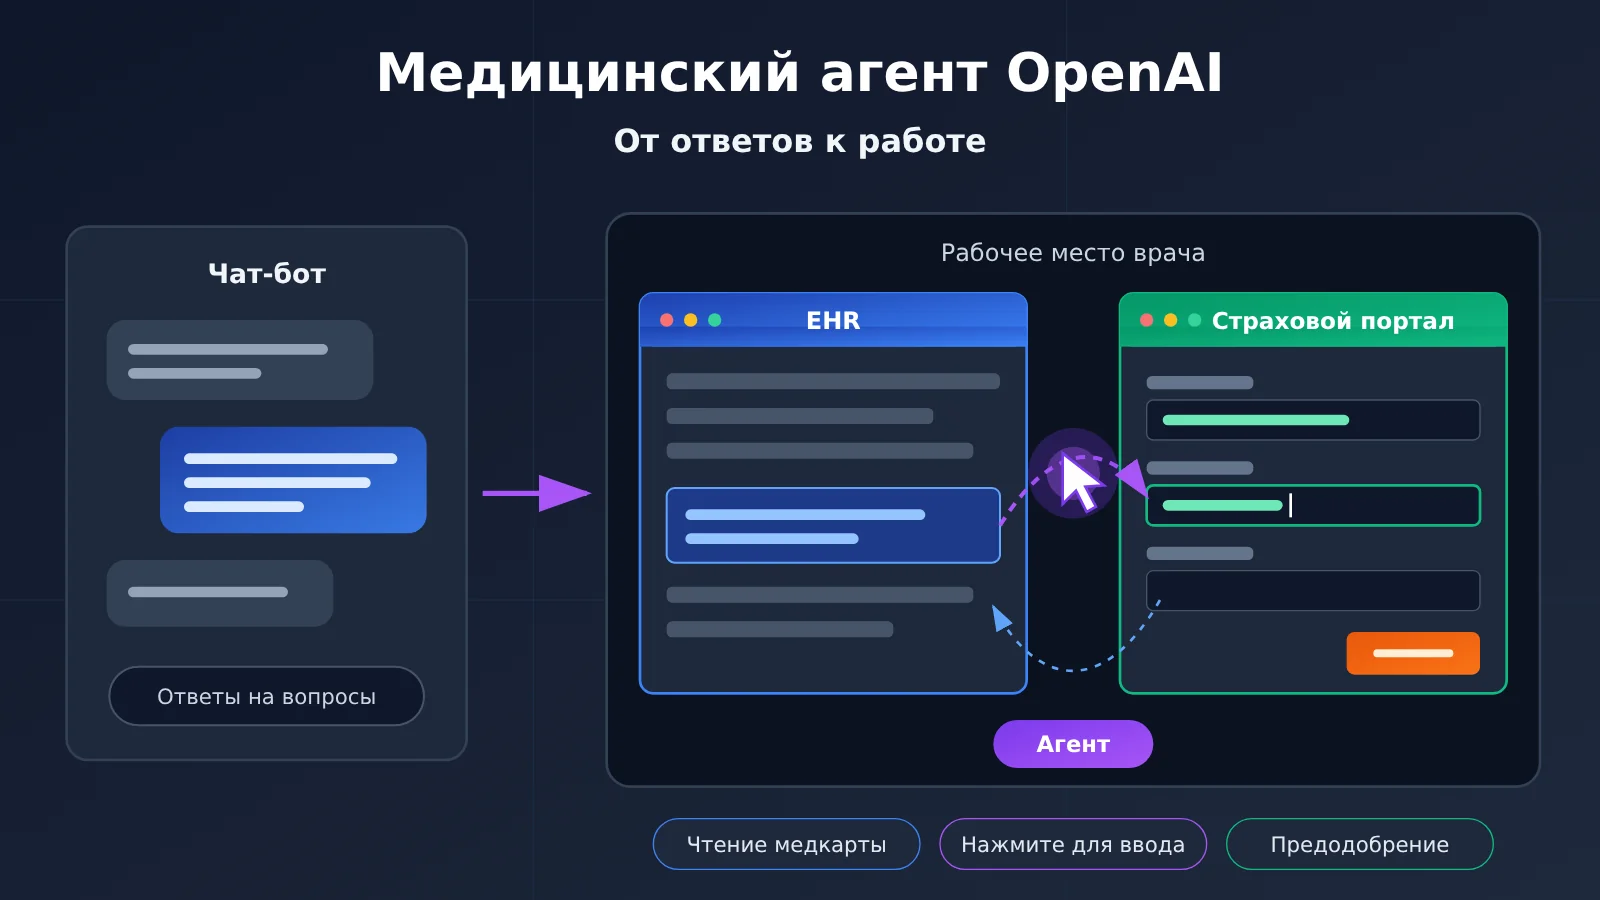
Ключевое достижение медицинского Computer-use Agent от OpenAI — возможность заходить в программные системы, которые медицинские организации уже используют, читать историю болезни пациента в динамике и на этой основе готовить медицинские записи, черновики назначений, ответы пациентам и материалы для предварительного одобрения страховой. Ценность ИИ смещается: от ответов на профессиональные вопросы к выполнению реальных рабочих процессов. Вместе с этим меняется и фокус конкуренции в медицинском ИИ: он уже не ограничивается ответами на вопросы о медицине, а смещается в сами клинические и административные рабочие процессы. Отдельно подчеркнём: в демонстрациях и публичных кейсах все эти материалы проходят проверку врачом или сотрудником; ИИ не получает самостоятельного права назначать лечение или принимать медицинские решения.
Что вы узнаете из этой статьи?
- В демонстрации на примере МРТ — полная цепочка действий агента: от чтения истории болезни до подготовки заявки на предварительное одобрение страховой.
- Три показателя — 99% безопасности, 93% высокой оценки со стороны врачей и 94.3% rubric points: что стоит за каждым из них и чем они отличаются от результатов статьи Stanford HealthAdminBench.
- На каком этапе находятся CVS Health, Cigna, Abridge и Ambience — демонстрация на синтетических данных, промышленная эксплуатация или разработка.
- Как разделены клинические полномочия по утверждению и исполнительные полномочия агента, а также как разработчикам считать полную стоимость агента.
Содержание
Блок объективных фактов построен так: сначала восстанавливаем, что OpenAI на этот раз заставила ИИ делать; затем сравниваем чат-бота и Computer-use Agent; потом разбираем, что на самом деле означают результаты оценки; далее смотрим, как внедряют технологию CVS, Cigna, Abridge и Ambience; и в конце — механизмы контроля рисков для медицинского агента. В аналитической части обсудим, почему медицинской отрасли особенно нужна такая способность, как разработчикам и медицинским организациям выбирать компромиссы и что Computer Use означает для всей индустрии ИИ-приложений.
To Know: краткий справочник по понятиям медицинского Agent
| Понятие | Краткое объяснение |
|---|---|
| Computer Use | Способность выполнять задачи, наблюдая за интерфейсом программ и взаимодействуя с ним (скриншоты, клики, ввод) |
| EHR | Система электронных медицинских записей — ключевое ПО больницы, где хранятся данные о приёмах, назначениях, снимках и прочем |
| Payer Portal | Портал страхового плательщика: медучреждения подают здесь заявки на предварительное согласование и проверяют страховой статус |
| Prior Authorization | Предварительное согласование: для некоторых обследований или лечения перед проведением нужно получить одобрение страховой |
| MCP | Стандартный протокол для обнаружения и вызова внешних инструментов |
| RPA | Способ автоматизации повторяющихся процессов с помощью заранее настроенных правил или скриптов |
| Rubric points | Баллы оценки, разбитые по правилам оценивания: показывают, насколько выполнены отдельные требования |
| 端到端成功率 | Доля задач, полностью удовлетворяющих всем условиям успеха |
| Trace | Траектория, фиксирующая ход выполнения, действия и состояние интерфейса |
| BAA | Соглашение о деловом партнёрстве, определяющее ответственность провайдера при обработке защищённой медицинской информации (PHI) |
| RBAC | Управление доступом на основе ролей: данные и операции распределяются по должностям |
Краткий обзор влияния медицинского агента
- Разработчики и технические руководители: главный вопрос уже не в том, правильно ли модель отвечает на медицинские вопросы, а в том, чтобы на конкретных задачах проверить механизм выполнения, долю успешно завершённых сквозных задач (end-to-end) и полную стоимость. Скриншоты относятся к вводу изображений, а многошаговые вызовы, инструменты и среда выполнения тарифицируются — нельзя смотреть только на цену за текстовые токены.
- Медицинские организации и руководители рабочих процессов: нужно чётко разделять, где демонстрация на синтетических данных, где оценка производителя, где корпоративный пилот, а где реальный производственный кейс. При запуске в эксплуатацию необходимо также обеспечить ручное утверждение, настройку прав доступа и журналы аудита — нельзя принимать демонстрационный эффект за основание для закупки.
- Клинический персонал: в ближайшей перспективе он скорее почувствует снижение административной нагрузки — например, подготовку материалов для предварительного согласования (prior authorization) и поиск информации в разных системах. Клиническое суждение и ответственность за подпись по-прежнему остаются за врачом.
Объективные факты: что на этот раз выпустила OpenAI в медицинском агенте
Что на этот раз сделал медицинский агент OpenAI?
16 ноября 2026 года OpenAI представила новые наработки по компьютерному агенту для медицинских команд, а также опубликовала результаты оценки клинических и административных рабочих процессов и практические кейсы сотрудничества с CVS Health, Abridge, Ambience, Cigna Healthcare и другими компаниями. В рамках HLTH 2026 руководитель направления Health AI в OpenAI Karan Singhal также рассказал о соответствующем прогрессе.
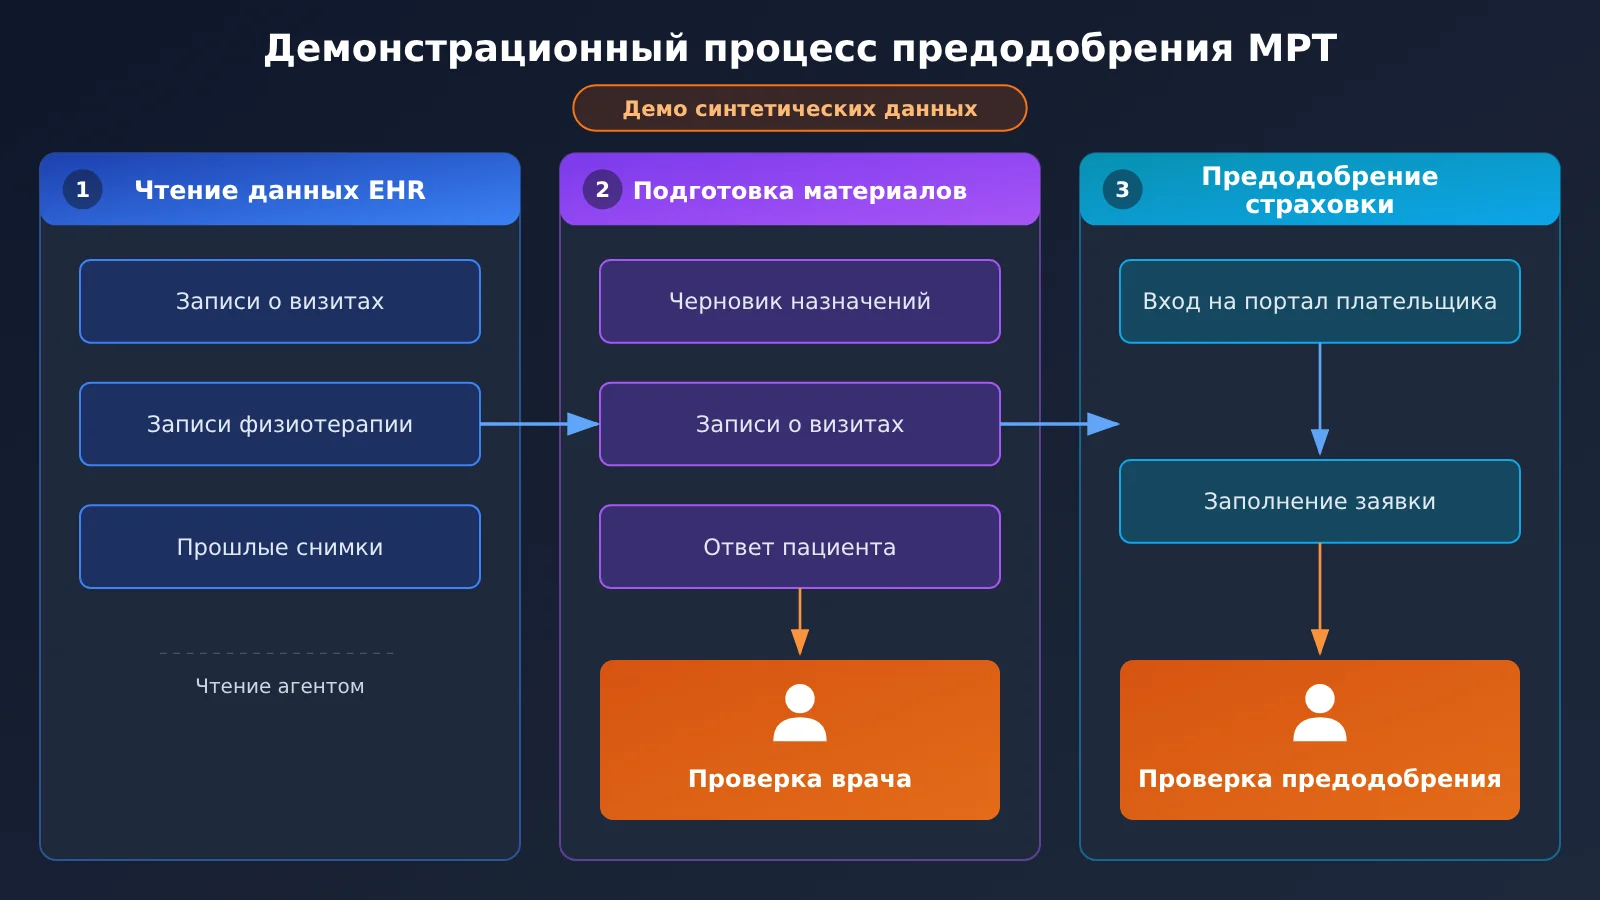
Лучше всего изменения иллюстрирует официально показанный процесс работы с МРТ. Пациент написал врачу из-за боли в нижней части спины, и врач рассматривал возможность проведения МРТ. Далее агент выполнил три этапа работы между EHR и страховым порталом:
- Чтение данных из EHR:просмотр записей о визитах пациента, записей физиотерапии и предыдущих снимков.
- Подготовка клинических материалов:черновик направления на МРТ, запись о текущем визите и ответ пациенту — всё передаётся врачу на проверку.
- Предварительное согласование со страховой:на основе той же записи пациента агент заходит на портал страховщика, готовит заявку на предварительное согласование МРТ и передаёт её сотруднику, который занимается предварительными согласованиями, на проверку.
Важно уточнить: в демонстрации использовались синтетические данные пациентов (Synthetic Patient Data), а не работа с реальными пациентами в реальной эксплуатации. Она показывает цепочку возможностей и не означает, что какая-либо больница уже обрабатывает по такой схеме реальные случаи.
Официально был показан и кейс консультации по лекарственному препарату после перелома у ребёнка. Родственники спросили о дозировке ибупрофена для ребёнка; агент просмотрел записи о визитах и снимки, считал из медицинской карты вес и дозировку, назначенную в клинике, и на этой основе подготовил инструкцию по приёму препарата, памятку по уходу за гипсом и перечень тревожных симптомов, при которых нужно срочно обратиться к врачу. Он сохранил медицинскую запись в статусе неподписанной, а ответ родственникам — как неотправленный черновик; окончательное утверждение остаётся за врачом. Elevated PSA и Digoxin refill (продление рецепта на дигоксин) также были включены в типы задач EHR Inbox, но официально полные протоколы выполнения и отдельные оценки по этим двум типам задач не опубликованы.
От чат-бота к медицинскому Computer-use агенту: что изменилось?
Традиционные медицинские системы вопросов и ответов дают общие знания, генерация медицинских документов умеет создавать черновики, но содержимое всё ещё приходится вручную копировать в систему. Отличие Computer-use агента в том, что он через цикл «наблюдение по скриншотам → планирование → клик или ввод → повторная проверка по скриншотам» напрямую входит в существующее ПО, выполняет многошаговые задачи в разных приложениях и может изменять бизнес-состояние в программном обеспечении.
| Тип возможностей | Основной результат | Есть ли доступ к бизнес-системам | Типичный медицинский сценарий | Основные риски |
|---|---|---|---|---|
| Медицинский чат-бот вопросов и ответов | Текстовый ответ | Нет | Поиск медицинских знаний, поиск доказательств | Точность содержания |
| Генерация медицинских документов | Записи, черновики писем | Косвенно, требуется ручной ввод | Выписные справки, письма для предварительной авторизации | Несоответствие содержания и медицинской карты |
| Computer-use агент | Операции в интерфейсе и изменение состояния системы | Да, прямое управление EHR и порталами | Заполнение предварительной авторизации, обновление статуса направления, получение данных из разных систем | Ошибочные клики, перепутывание пациентов, распространение ошибок |
В OpenAI API Computer Use в основном реализуется через Responses API и поддерживает такие действия, как click, type, scroll, keypress, drag, screenshot. Официальная документация описывает два пути: первый — Computer Tool, когда модель возвращает структурированные действия мышью и клавиатурой, а выполняет их приложение; второй — Code Execution, когда модель генерирует код, вызывающий такие инструменты, как Playwright, PyAutoGUI. Для GPT-6 Astra официально на данный момент рекомендуется подход Code Execution. В документации также особо подчёркивается, что генерация моделью инструкции к действию не означает, что действие уже успешно выполнено: приложение должно выполнить действие, а затем подтвердить результат, например, с помощью нового скриншота.
О чём говорят результаты оценки медицинского агента OpenAI?
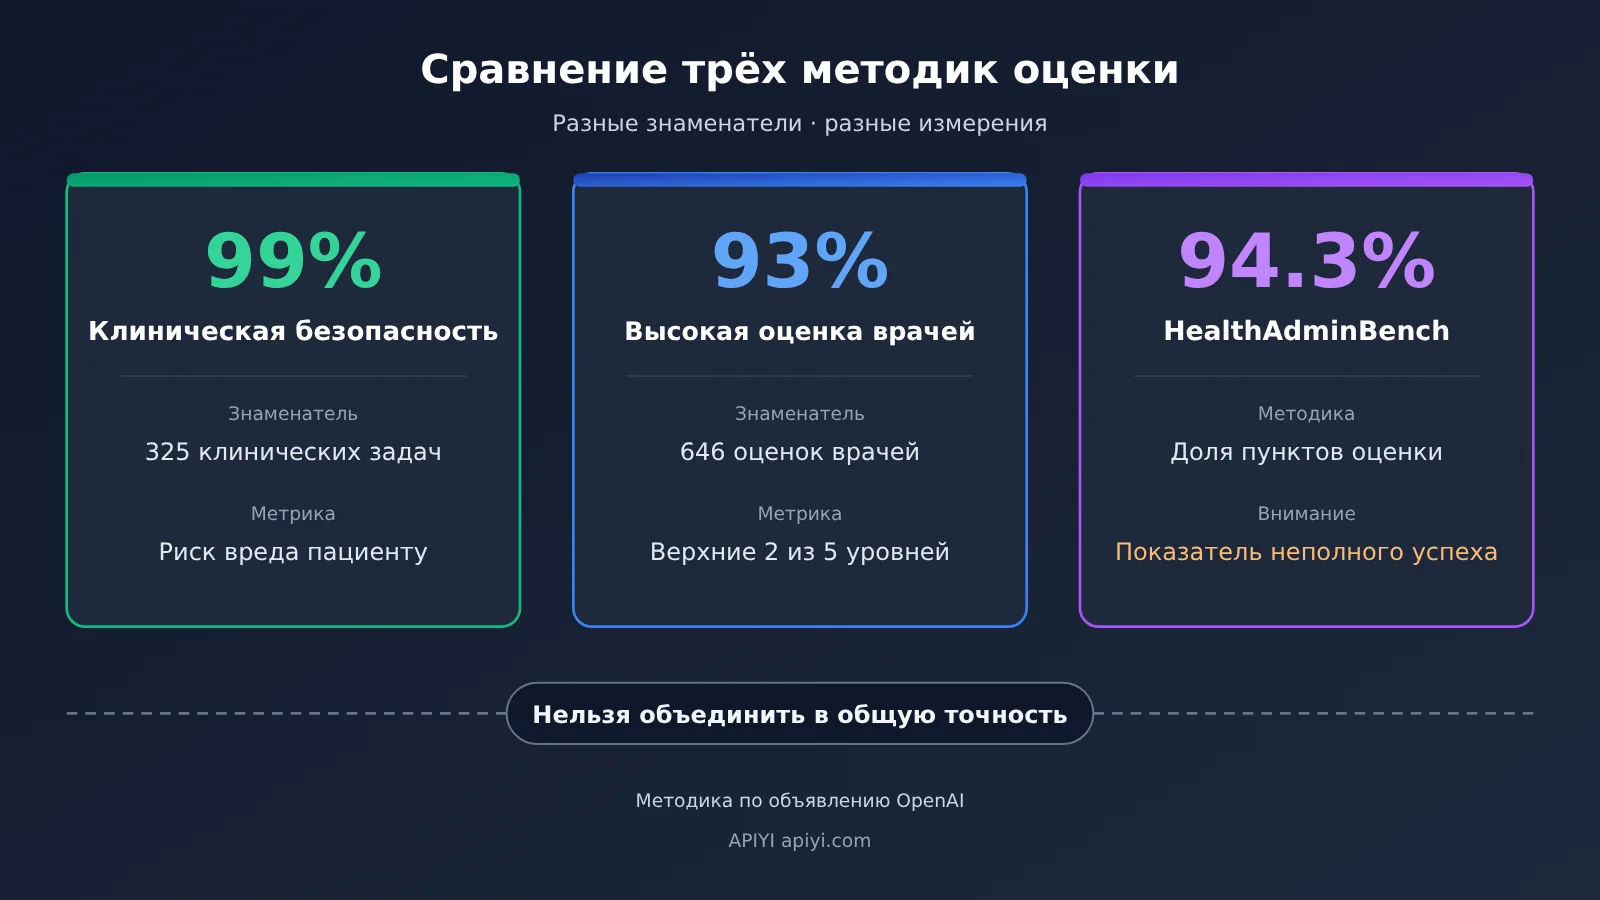
OpenAI опубликовала три ключевых показателя. У них разные знаменатели и критерии оценки, их нельзя свести к одной «общей точности», и ни один из них не является точностью медицинской диагностики.
| Показатель | Значение | Объект оценки | Знаменатель / критерий | Что это не означает |
|---|---|---|---|---|
| Безопасность клинических задач | 99% | GPT-6 Astra | 325 проверенных задач; проверяется, могут ли ошибка, пропуск или действие причинить вред пациенту | Точность диагностики или полное отсутствие ошибок |
| Высокая оценка от врачей | 93% | GPT-6 Astra | 646 оценок от врачей; доля ответов Very / Extremely Helpful по пятиуровневой шкале | Успешность выполнения задач или 646 врачей |
| HealthAdminBench | 94.3% | GPT-6 Astra | доля rubric points при maximum reasoning effort | Успешность выполнения задачи целиком |
| HealthAdminBench | 91.8% | GPT-6 Luna | доля rubric points при maximum reasoning effort | Успешность выполнения задачи целиком |
| Стоимость одной задачи | $0.085 | GPT-6 Luna | при определённых условиях оценки; на 98% ниже, чем у Astra | Стоимость развёртывания в продакшене |
Клиническая проверка смотрит не только на итоговый текст, но и на фактические действия агента, созданные медицинские записи, врачебные назначения и сообщения для пациентов. То есть оценка одновременно охватывает качество контента и процесс работы с программным обеспечением. Однако официально не указано, сколько независимых врачей стоит за 646 оценками; в тексте объявления также нет доверительных интервалов, результатов по каждой задаче и полных примеров неудачных кейсов.
HealthAdminBench — это бенчмарк медицинских административных агентов, предложенный стэнфордской лабораторией Shah Lab. Согласно статье 2604.09937v1, он включает 135 задач и 1698 подзадач, из которых 1177 подзадач оцениваются детерминированно, а 521 — с помощью модели в роли судьи. В статье максимальная успешность выполнения задачи целиком — 36.3% у Claude Opus 4.6 CUA, а максимальная успешность выполнения подзадач — 82.8% у GPT-5.4 CUA. В ранней веб-версии Shah Lab было 70 задач и 947 оценочных пунктов; тогда максимальная заявленная успешность выполнения задачи целиком составляла 22.9%, это можно использовать как историческое сравнение.
Эти цифры относятся к разным версиям, моделям, датам, условиям выполнения и показателям, их нельзя выстроить в один рейтинг. У OpenAI 94.3% — это доля rubric points, а в статье 36.3% — успешность выполнения задачи от начала до конца. Сама эта разница говорит о том, что разрыв между «правильно выполнить отдельные шаги» и «довести дело до конца» у медицинского агента может быть очень большим.
Как CVS, Cigna, Abridge и Ambience внедряют ИИ-агентов в здравоохранении?
Зрелость корпоративных кейсов сильно различается, поэтому ниже они разделены по статусу, который компании раскрыли публично. Цифры в основном взяты из материалов самих компаний и OpenAI; публикации в СМИ служат дополнительным подтверждением, но не заменяют независимый аудит.
| Компания | Сценарий | Статус раскрытия | Ключевые факты |
|---|---|---|---|
| CVS Health | Пересылка документов, направлений и организация консультаций специалистов между клиническими системами | Рабочий процесс в продакшене | За один выходной разобрали завал документов, копившийся несколько месяцев; другой агент ежедневно обрабатывает десятки тысяч шагов системных операций, связанных с консультациями |
| Cigna Healthcare | Сведение информации из разных систем перед координацией ухода | Развёрнуто | Координаторам ухода раньше приходилось просматривать более 10 систем; от концепции до развёртывания — меньше 8 недель |
| Abridge | Устранение препятствий при выписке | В разработке | Врачи через Abridge Assistant просят агента параллельно скоординировать получение лекарств и уход на дому |
| Ambience Healthcare | Заявки на предварительное одобрение страховой компании | Демонстрация модели управления | При неоднозначной записи в медицинской карте агент останавливается и спрашивает врача; заявку подаёт только после одобрения |
| Assort | Замкнутый цикл направления | Официальный кейс | API записывает информацию о направлении, а Computer Use дополняет обновление статуса в интерфейсе Athena |
Цифра «десятки тысяч» у CVS относится к объёму работы, связанному с шагами системных операций, а не к десяткам тысяч клинических решений, каждое из которых ИИ принимает самостоятельно. CVS также открыла исходный код CUA Agent Kit (лицензия Apache-2.0). Архитектура двухступенчатая: сначала Computer-use Agent исследует рабочий процесс, описанный на естественном языке, и записывает данные трассировки (Trace): скриншоты, действия, целевые позиции; затем Codex Skill превращает успешную траекторию в детерминированный код, который после проверки инженером выполняется повторно. Согласно README, на этапе детерминированного выполнения API-ключ модели не нужен.
Кейс Assort показывает, какую роль играет Computer Use: Assort уже умеет через Athena API записывать информацию о направлении в медицинскую карту, но для полного цикла не хватает одного шага в интерфейсе. Агент прямо в интерфейсе Athena выбирает врача, к которому направлять пациента, заполняет детали и меняет статус на Visit Scheduled — после чего это направление сразу исчезает из списка задач сотрудника по сопровождению. API отвечает за структурированные операции, а Computer Use закрывает то, что API не покрывает.
Как медицинский Agent контролирует риски?
Возможности управления, которые опубликовала OpenAI, включают RBAC, журналы аудита, настройку области доступа приложений, ручное утверждение перед критически важными операциями, а также механизмы, удерживающие Agent в рамках заданного рабочего процесса. Медицинские учреждения могут в любой момент приостановить Agent и просмотреть пошаговый журнал операций.
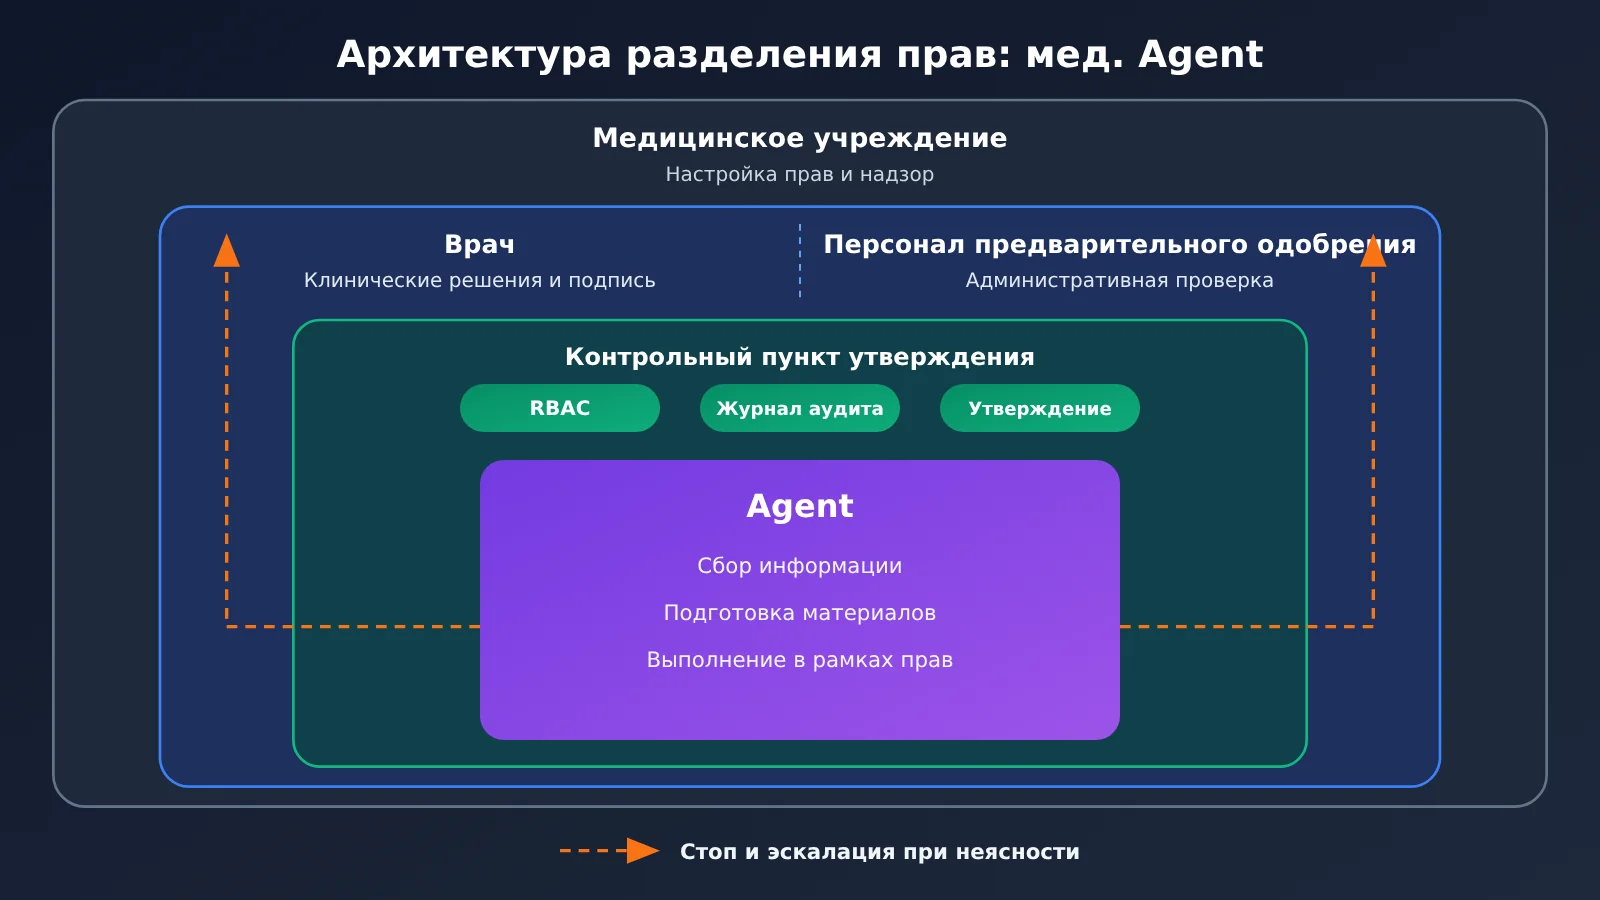
По сути, это дизайн разделения полномочий: ИИ отвечает за сбор информации, подготовку материалов и выполнение операций в пределах делегированных полномочий, врач — за клинические суждения, сотрудник предварительного согласования — за административную проверку, а медицинское учреждение — за настройку прав и процессы надзора. Полномочия Agent должны совпадать с границами клинической ответственности.
Что касается соответствия требованиям к данным, OpenAI заявляет, что организационные данные в ChatGPT for Healthcare не используются для обучения базовых моделей, а CVS также утверждает, что производственные данные остаются в их собственной инфраструктуре. Но для поддержки рабочих процессов HIPAA, связанных с PHI, медицинским организациям нужно использовать сервисы, отвечающие необходимым требованиям: убедиться, что на сервис распространяется BAA, подписанное с OpenAI, настроить параметры безопасности и политики хранения данных, а также через организационные права ограничить, к каким записям и операциям имеет доступ Agent. Поэтому «поддержка рабочих процессов HIPAA» не означает, что «все вызовы OpenAI API автоматически соответствуют требованиям».
Что касается доступных каналов, эти возможности доступны через OpenAI API, ChatGPT for Healthcare, ChatGPT for Clinicians, ChatGPT Work и Codex. Соответствующие американские клинические специалисты могут бесплатно подать заявку на ChatGPT for Clinicians, но у этой бесплатной политики есть географические и квалификационные ограничения. У ChatGPT for Healthcare нет публично опубликованной единой фиксированной цены подписки.
Анализ и выводы: выбор стратегии для медицинских агентов и значение для отрасли
Почему медицинской отрасли особенно нужны агенты типа Computer Use?
Разрозненность информации в медицине — типичная проблема. Один визит к врачу может одновременно затрагивать EHR, систему визуализации, систему назначений, страховой портал, систему направлений и платформу управления выпиской — и всё это зачастую от разных производителей с неполными интерфейсами. Предварительное согласование МРТ — наглядный пример: врач вынес лишь одно клиническое заключение, а сотрудникам приходится многократно переключаться между историей болезни, записями физиотерапии, данными визуализации и страховым порталом, копировать и загружать документы.
С этой точки зрения Computer Use решает не вопрос «разбирается ли ИИ в медицине», а вопрос «могут ли данные перемещаться между системами». Моё мнение: автоматизация медицинской административной работы вполне может достичь коммерческого масштаба раньше, чем автоматизация клинической диагностики. Причина в том, что административных задач много, они повторяемы, границы чётко очерчены, результат можно проверить по формам и состоянию системы, а риск ответственности относительно управляем. Пример Cigna, где поиск информации по более чем 10 системам сжали до нескольких секунд, как раз демонстрирует такой подход — «сначала снизить нагрузку, а не заменять».
Однако Стэнфордский бенчмарк вскрывает и настоящие трудности. Ранние исследования показали, что передача данных между приложениями и обработка документов — важные источники сбоев агента: даже понимая информацию о пациенте, он может ошибиться при загрузке файлов, заполнении полей или обновлении статуса. В медицинском сценарии ошибка в одной системе может быть размножена в нескольких нижестоящих системах — именно поэтому ручное утверждение и проверка состояния после операции остаются обязательными.
Как разработчику оценить стоимость и реализуемость медицинского агента?
Начинать сразу с Computer Use не обязательно. Надёжнее сначала разбить рабочий процесс на части: такие чисто текстовые этапы, как извлечение информации и подготовка документов, можно сначала проверить на качество через обычный интерфейс модели; а этап работы с интерфейсом оценивать отдельно — по доле успешных операций. В примере ниже на синтетических материалах проверяется именно этот текстовый этап — «извлечение полей, необходимых для предварительного согласования». Это только техническая демонстрация и не содержит рекомендаций по диагностике или лечению:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # ориентируйтесь на фактический список доступных моделей на платформе
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
Посмотреть полный код с расчётом стоимости токенов
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Цена за единицу: доллары за миллион токенов; заполните по модели, которую реально используете
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 Совет для быстрой проверки: прежде чем подключаться к реальной медицинской системе, можно через APIYI apiyi.com с одним API-ключом сравнить, как несколько моделей справляются с извлечением полей, подготовкой документов и другими текстовыми этапами. У новых пользователей есть бесплатный тестовый лимит — удобно сначала прогнать скрипт оценки и накопить данные на уровне задач.
Что касается стоимости, по состоянию на 17 ноября 2026 года цены Standard для короткого контекста (доллары за миллион токенов) такие: GPT-6 Astra — вход 10, выход 50, кэшированный вход 1; GPT-6 Luna — вход 0,10, выход 0,50, кэшированный вход 0,01. На фактический счёт влияют скорость обработки, длина контекста и регион. Если отталкиваться от 0,085 доллара за задачу у Luna и соотношения «на 98% ниже», то Astra выходит примерно 4,25 доллара за задачу, но это оценка, причём стоимость в базовых условиях, и её нельзя считать производственным прайсом.
Полный расчёт должен отдельно учитывать визуальный и текстовый ввод, оплачиваемый вывод на каждом шаге, а также вызовы инструментов, среду выполнения и инженерную поддержку. Если токены, потраченные на повторные попытки, уже включены в общий объём, не добавляйте их ещё раз. Почти 50-кратная разница в цене между двумя уровнями моделей тоже подсказывает идею расслоения: сложные рассуждения — мощной модели, структурированные и частые шаги — недорогой модели, а уже проверенные и стабильные процессы — закрепить в детерминированный код, как в CVS.
💰 Совет по оптимизации затрат: когда делите модели по уровням, можно сначала на APIYI apiyi.com с одним и тем же OpenAI-совместимым кодом переключать модели разных ценовых категорий, измерить качество и расход токенов для каждого типа подзадач, а затем решить, какие этапы стоит выполнять на более мощной модели.
| Этап проверки | На какие вопросы отвечаем | Рекомендуемые доказательства | Справочные инструменты |
|---|---|---|---|
| Текстовый этап | Стабильно ли качество извлечения и черновиков | Сверка с ручной разметкой, частота срабатывания NEED_HUMAN | Сравнение нескольких моделей на APIYI apiyi.com |
| Интерфейсные операции | Какова доля успешных сквозных выполнений | Скриншоты и Trace, проверка состояния после операции | Документация OpenAI Computer Use и песочница |
| Закрепление процесса | Какие шаги можно перевести в детерминированный код | Доля воспроизводимых успешных траекторий | Двухэтапная архитектура вроде CUA Agent Kit |
| Управление запуском | Покрывают ли права и согласования ключевые действия | Конфигурация RBAC, выборочная проверка журналов аудита | Собственная система прав и комплаенса организации |
Медицинские агенты и RPA: замена или интеграция?
Традиционный RPA опирается на фиксированные правила и позиционирование элементов интерфейса: стоит интерфейсу измениться, и скрипт может перестать работать. Computer-use Agent способен понимать естественный язык, наблюдать за текущим интерфейсом и адаптироваться к изменениям, но каждое повторное рассуждение даёт дополнительные затраты и нестабильность результата. В одном исследовании, сравнивающем две технологии (DOI: 10.1080/23311975.2026.2724760), в процессах P2 и P3 каждая технология выполнялась по 10 раз. В процессе P1 у агента была всего одна запись о сбое, и её не включили в последующую статистику, поэтому нельзя в общем виде утверждать, что все задачи выполнялись 10 раз. В исследовании использовалась конфигурация инструментов 2025 года, поэтому его результаты нельзя напрямую переносить на показатели моделей 2026 года.
Автор считает, что подход CVS «исследование с помощью ИИ, закрепление в коде, повторное выполнение» скорее всего станет основной инженерной схемой: агент отвечает за обнаружение и понимание незнакомых процессов, детерминированный код — за стабильное повторение известных процессов, API по-прежнему обслуживает частые структурированные взаимодействия, а ручное утверждение контролирует ключевые этапы. Сочетание API, Computer Use, детерминированного кода и ручного утверждения реалистичнее, чем ставка на какую-то одну технологию.
Что медицинский ИИ-агент значит для всей ИИ-индустрии?
Медицина — лишь полигон с высоким порогом входа. Её системы разрознены, требования к комплаенсу и границы ответственности строже, чем в обычных компаниях. Если агент, выполняющий действия, сможет именно здесь выстроить режим работы с возможностью аудита, приостановки и согласованными правами доступа, этот подход можно будет перенести в страхование, финансы, госуправление и другие отрасли, которые так же зависят от устаревших систем.
Это также означает, что меняется само измерение конкуренции в отрасли. Раньше соревновались в том, насколько хорошо модель пишет тексты, теперь — в том, может ли она довести дело до конца в реальной системе, вовремя остановиться при ошибке и оставить след на каждом шаге для последующей проверки. Для софтверных компаний Computer Use означает: ИИ-компании могут участвовать в рабочих процессах, не получая полного контроля над базовым ПО. Это снижает порог интеграции и давит на старую модель «ждём, пока вендор откроет API». Но высоконадёжные и часто повторяющиеся сценарии взаимодействия по-прежнему лучше реализовывать через API. Computer Use — скорее дополнение, чем замена.
В ближайшее время стоит следить за несколькими вещами: опубликует ли OpenAI результаты оценки по каждой задаче и полную конфигурацию экспериментов; сможет ли опубликованная версия HealthAdminBench стать единой базой для сравнения у разных игроков; сможет ли решение Abridge для координации выписки пациентов перейти из разработки в эксплуатацию; а также смогут ли данные из реальной работы большего числа больниц доказать, что сквозной показатель завершения задач действительно пригоден для практики. Пока этих доказательств нет, демонстрации и оценки — лишь отправная точка, а не вывод.
Медицинский агент уже доказал, что способен перейти от слов к делу, но сможет ли он реально снизить клиническую и административную нагрузку, зависит от сквозного показателя завершения задач в реальных рабочих процессах, способности останавливаться при ошибках и долгосрочных затрат. Как говорит английская пословица: The proof of the pudding is in the eating. (Реальный эффект проверяется практикой.)
Справочные материалы
- Официальное объявление OpenAI: Advancing computer-use agents for healthcare teams
- Ссылка:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Ссылка:
- Справочная документация ChatGPT for Healthcare: возможности продукта, BAA и описание плагинов
- Ссылка:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- Ссылка:
- Документация OpenAI Computer Use для разработчиков: Computer Tool и путь Code Execution
- Ссылка:
developers.openai.com/api/docs/guides/tools-computer-use
- Ссылка:
- Статья HealthAdminBench: задачи и метрики версии 2604.09937v1
- Ссылка:
arxiv.org/html/2604.09937v1
- Ссылка:
- CVS Health CUA Agent Kit: двухэтапная архитектура исследования и фиксации
- Ссылка:
github.com/cvs-health/cua-agent-kit
- Ссылка:
- Репортаж Fierce Healthcare: партнёры и сценарии применения на HLTH26
- Ссылка:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- Ссылка:
- Cambridge Dictionary: проверка оригинального текста поговорки
- Ссылка:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Ссылка:
Автор: Техническая команда APIYI
Техническое общение: если хотите сравнить, как разные большие языковые модели справляются с текстовым этапом Agent, добро пожаловать на APIYI apiyi.com — там можно получить тестовые квоты. Больше информации о подключении — в центре документации docs.apiyi.com