Примечание автора: в этой статье публичные цифры Gemini 4 Neon и Claude Opus 5.5 разбираются отдельно по двум линиям — программирование и работа со знаниями, — и для каждой цифры отмечено, откуда она: из официального самоотчёта, карточки модели, страницы модели на Artificial Analysis, статьи Artificial Analysis, сводной таблицы APIYI или из интерфейса ценообразования.
Если ваш рабочий процесс уже использует Claude Opus 5.5, то вышедший 2026-11-18 Gemini 4 Neon сразу ставит вопрос ребром: у кого на одном и том же проекте цифры выше и измерены ли эти цифры одной линейкой. Блог Google, карточка модели от DeepMind и Artificial Analysis в день релиза опубликовали свои цифры, но их методики, градации и тестовые фреймворки различаются.
Данные в статье сверены по состоянию на 2026-11-19; все цифры взяты из открытых источников, и у каждой указан источник. Программирование и работа со знаниями разбираются по двум линиям, карточка модели и Artificial Analysis — в двух отдельных разделах. Какая модель больше подходит именно вам, зависит от того, на какие строки вы смотрите.
Главное: после прочтения статьи вы поймёте, как читать три колонки в карточке модели Gemini 4 Neon, что означают интеллектуальный балл, стоимость одной задачи, время выполнения и скорость вывода на Artificial Analysis, а также как на APIYI узнать модель и цену Claude Opus 5.5.
Gemini 4 Neon и Claude Opus 5.5: ключевые моменты
Сначала — таблица для быстрого ознакомления. В каждой строке указаны уровень и источник, при этом условия измерения двух чисел в одной строке не обязательно полностью совпадают.
| Параметр | Gemini 4 Neon | Claude Opus 5.5 | Источник |
|---|---|---|---|
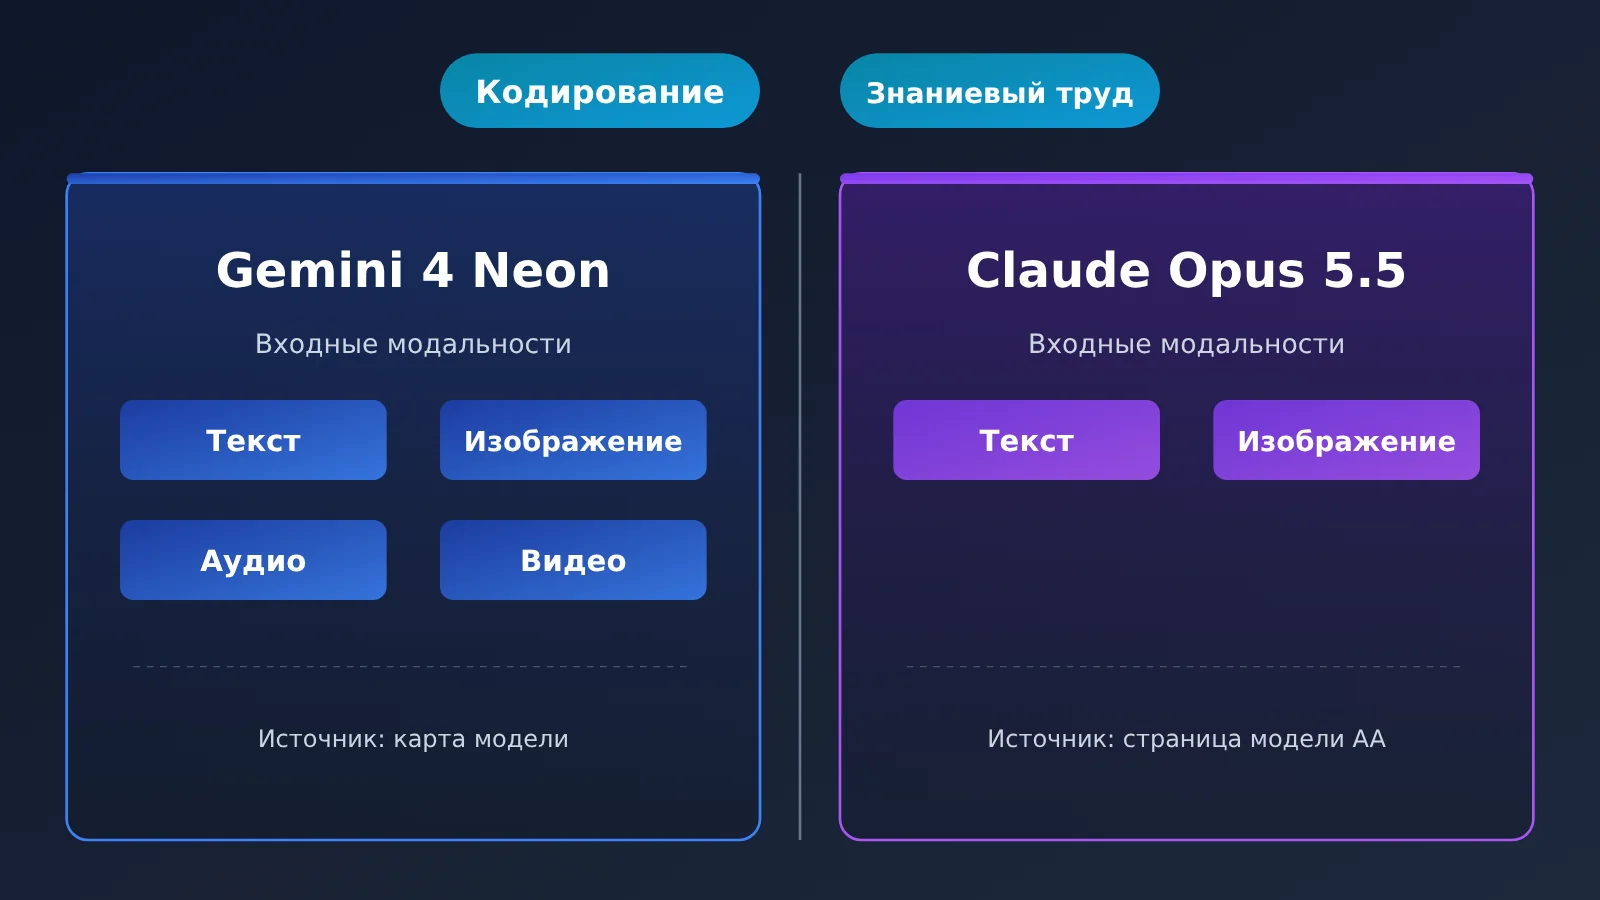
| Входные модальности | текст, изображения, аудио, видео | текст, изображения | Model card / страница модели на Artificial Analysis |
| Оценка интеллекта (индекс v5.0.1) | 61 (xhigh) | 59 (max) | страница модели на Artificial Analysis |
| Terminal-bench 4.1 (после корректировки на читерство) | 65,2% | 65,8% | Model card (результаты не для Gemini — по данным самих разработчиков) |
| FrontierCode 2.0 | 46,2% (по умолчанию high) | 47,3% | Model card |
| Стоимость одной задачи | 6,44 доллара | 10,04 доллара | страница модели на Artificial Analysis |
| Скорость вывода | 110 токенов/с | 118 токенов/с | страница модели на Artificial Analysis |
| Цена по прайсу (ввод / вывод, за миллион токенов) | 3 / 15 долларов | 4 / 20 долларов | страница тарифов Google AI Studio / страница модели на Artificial Analysis |
Распределение цифр у Gemini 4 Neon и Claude Opus 5.5
В этой таблице у обеих сторон есть строки, где значения выше. По большинству подпунктов model card и по оценке интеллекта Artificial Analysis (61 против 59) выше Gemini 4 Neon. По Terminal-bench 4.1 (65,8% против 65,2%), FrontierCode 2.0 (47,3% против 46,2%) и скорости вывода (118 против 110 токенов/с) выше Claude Opus 5.5.
Входные модальности стоит пояснить отдельно. Согласно model card, Gemini 4 Neon может принимать на вход текст, изображения, аудио и видео. Согласно странице модели на Artificial Analysis, вход Claude Opus 5.5 — текст и изображения. Если ваша задача требует напрямую обрабатывать аудио или видео, этот пункт определит выбор. Если задача связана только с текстом и скриншотами, этот пункт не будет различием.
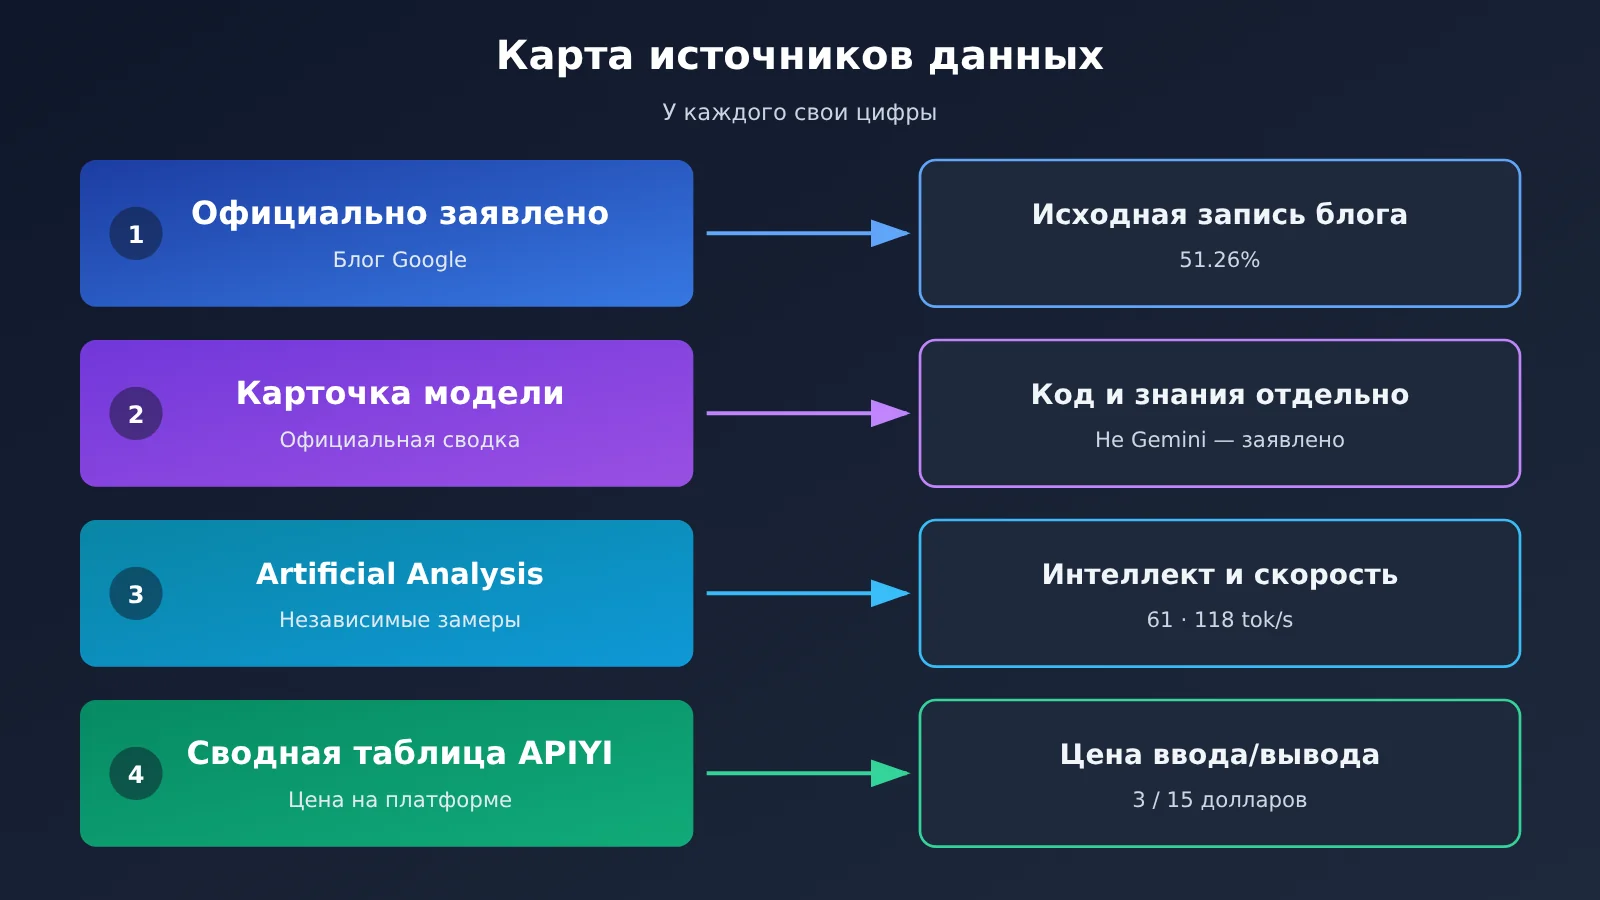
Сравнение Gemini 4 Neon и Claude Opus 5.5: как читать три столбца в карточке модели
В таблице сравнения из карточки модели всего три столбца: Gemini 4 Neon, Claude Opus 5.5 и GPT-6.2 Sol. В этой статье мы смотрим только на первые два. В PDF с описанием оценки указано, что результаты не-Gemini по умолчанию приводятся по данным самих компаний. То есть это официальная сводка, а не повторные замеры, сделанные одной лабораторией в один день, — поэтому каждую ячейку стоит воспринимать как публичное заявление.
Показатели по кодированию у Gemini 4 Neon и Claude Opus 5.5
Ниже строки из карточки модели, связанные с кодированием и безопасным программированием.
| Показатель (карточка модели) | Gemini 4 Neon | Claude Opus 5.5 | Кто выше |
|---|---|---|---|
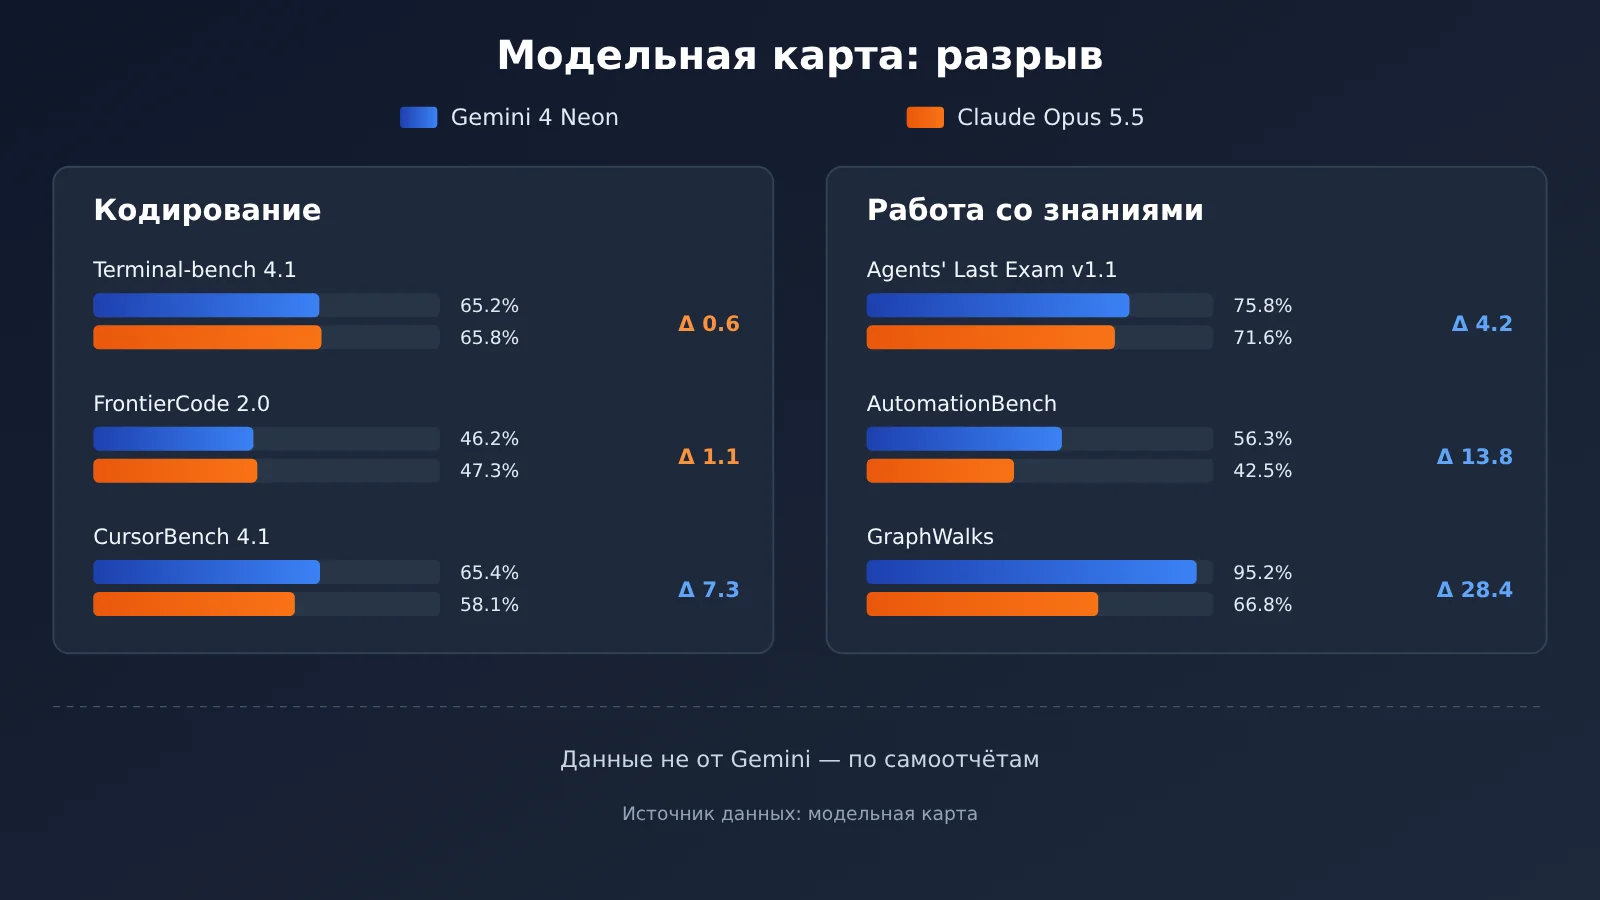
| CursorBench 4.1 | 65.4% | 58.1% | Neon |
| Terminal-bench 4.1 (точность с корректировкой на читерство) | 65.2% | 65.8% | Opus |
| FrontierCode 2.0 | 46.2% (high по умолчанию) | 47.3% | Opus |
| SWE-sweep, harness производителя | 39.0% | 10.1% | Neon |
| SWE-sweep, mini-SWE harness | 12.8% | 3.6% | Neon |
| CWE-Bench v2 | 70.7% | 67.1% | Neon |
| WebExploitBench v1.2 | 51.3% | 37.1% | Neon |
При чтении этой таблицы стоит учесть три момента.
- Оба показателя, где выше Opus, относятся к основному кодированию. Terminal-bench 4.1 и FrontierCode 2.0 измеряют работу в терминале и задачи с кодом; разница составляет 0.6 и 1.1 процентного пункта. У Neon результат FrontierCode помечен как уровень high по умолчанию.
- Две строки SWE-sweep используют разные harness. У Neon в Google Antigravity — 39.0%, а в mini-SWE harness — 12.8%. В блоге Google эта разница объясняется раскрытием возможностей harness, поэтому не стоит понимать её так, будто сама модель в три раза сильнее. При сравнении двух моделей нужно брать один и тот же harness, то есть 39.0% против 10.1% или 12.8% против 3.6%.
- Одно и то же число в разных источниках записано по-разному. В карточке модели WebExploitBench — 51.3%, в блоге Google — 51.26%. Оба варианта оставлены как есть, без выбора одного из них.
Gemini 4 Neon и Claude Opus 5.5: подкатегории знаний и науки
В категориях работы со знаниями, научных рассуждений и длинного контекста подкатегорий больше, и здесь Neon в большинстве случаев выше.
| Подкатегория (карточка модели) | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| AA Index v5.0.1 | 61 | 59 |
| Vals Index v2.2 | 70.9% | 70.1% |
| AutomationBench | 56.3% | 42.5% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% |
| RiemannBench | 84.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% |
| HLE-Diamond | 71.3% | 67.9% |
| MKA Climb WSR | 56.5% | 53.0% |
| Chartography | 73.5% | 66.3% |
| LVBench | 89.0% | 83.7% |
| GraphWalks (от 256k до 1M, F1 для BFS) | 95.2% | 66.8% |
Разница по строкам сильно варьируется. В Vals Index — всего 0.8 процентного пункта, а в GraphWalks — 28.4 процентного пункта; последний показатель измеряет обход графа в сверхдлинном контексте от 256k до 1M токенов. Если ваша работа со знаниями заключается в поиске и рассуждении по длинным документам, в первую очередь смотрите на строку GraphWalks. Если речь о бизнес-автоматизации, то 56.3% против 42.5% у AutomationBench ближе к вашему сценарию.
В блоге Google также перечислены некоторые места в формате официальных заявлений: например, 1-е место в Legal Research Bench и Tax Agent Bench, а также 1-е место в большинстве категорий по финансам, бухгалтерии и табличному моделированию на Surge. Блог не приводит проценты по этим пунктам и не указывает соответствующие цифры Opus, поэтому эти места нельзя напрямую добавить в таблицу сравнения двух моделей.
Gemini 4 Neon против Claude Opus 5.5: как читать четыре числа Artificial Analysis
Artificial Analysis — это независимое измерение, оно относится к другой системе, нежели карточка модели. На странице модели для каждого уровня рассуждений приводятся оценка интеллекта, стоимость одной задачи, время выполнения и скорость вывода. Основное сравнение в этом разделе — Neon xhigh против Opus max: это высшие уровни, которые каждая из сторон указывает на своей странице модели, но эти два уровня не эквивалентны.
| Метрика (страница модели Artificial Analysis, v5.0.1) | Gemini 4 Neon (xhigh) | Claude Opus 5.5 (max) |
|---|---|---|
| Оценка интеллекта | 61 | 59 |
| Стоимость одной задачи | 6.44 доллара США | 10.04 доллара США |
| Время выполнения одной задачи | 21.5 минуты | 24.5 минуты |
| Скорость вывода | 110 токенов/с | 118 токенов/с |
| Первый токен ответа | 56.51 с | 335.85 с |
| Выходные токены при прогоне индекса | 283 млн | 218 млн |
| Прайс-лист (вход / выход) | 3.00 / 15.00 доллара США | 4.00 / 20.00 доллара США |
| Смешанная цена | 2.21 доллара США | 2.94 доллара США |
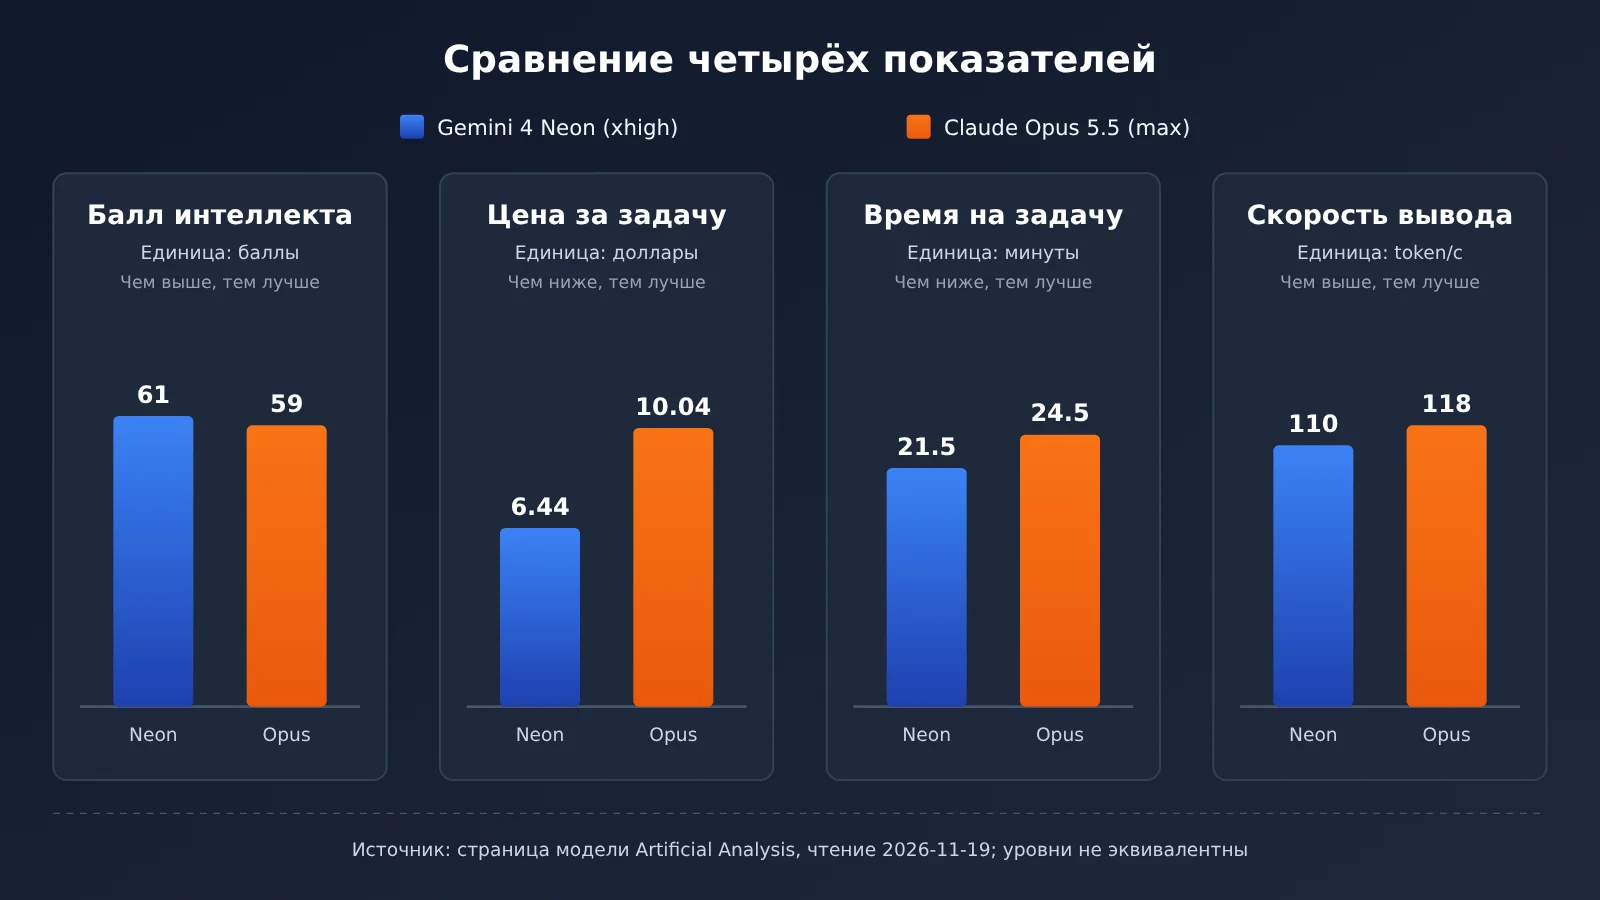
📊 Пояснение к графику: цифры на рисунке выше взяты со страницы модели Artificial Analysis и отражают расчёт при прогоне индекса третьей стороной. При вызове Claude Opus 5.5 на APIYI apiyi.com ориентируйтесь на список моделей и прайс-лист платформы.
Стоимость одной задачи: цифры из рейтинга
Стоимость одной задачи — 6.44 доллара против 10.04 доллара — это сумма, рассчитанная Artificial Analysis после прогона его индекса. Это цифры из рейтинга, а не ваш счёт в APIYI. Значение зависит одновременно от цены за токен и объёма использования. По данным страницы модели, при прогоне индекса Neon выдал 283 млн токенов — больше, чем 218 млн у Opus, но цена у него составляет 3/15 доллара, а у Opus — 4/20 доллара. Ваши фактические расходы зависят от длины входных данных, длины вывода и доли попаданий в кэш в ваших задачах.
Время выполнения, скорость вывода и время до первого токена
Скорость вывода выше у Opus: 118 против 110 токенов/с. Но время выполнения одной задачи меньше у Neon: 21.5 против 24.5 минуты. Эти два показателя не противоречат друг другу, потому что время выполнения включает ожидание первого токена и общий объём вывода. По странице модели, первый токен ответа у Opus max появляется через 335.85 секунды, у Neon xhigh — через 56.51 секунды. В интерактивных сценариях время до первого токена влияет на восприятие сильнее, чем пропускная способность.
Сравнение внутри одного уровня и оценки за код
Если переключить уровень ниже, цифры на странице модели тоже изменятся. Neon high — это 60 баллов, 14,8 минуты, 101 токен/с; Opus xhigh — 57 баллов, 16,1 минуты, 107 токенов/с; Opus high — 52 балла, 9,3 минуты, 108 токенов/с. Время до первого токена на трёх уровнях Neon — high, medium и low — составляет 40,64 с, 20,14 с и 13,93 с соответственно. Эти цифры взяты из FAQ на странице модели и лежат в другой колонке, не в той же, что сводная таблица выше.
Что касается написания кода, в статье Artificial Analysis приводится Coding Agent Index: Neon xhigh в Antigravity CLI — 59, Opus 5.5 max в Claude Code — 58, причём они работают в разных CLI. В блоге Google указано 58,6 — это официально заявленное значение, и это не то же число, что 59 в статье. В той же статье приводится стоимость одного задания по написанию кода: Neon — 6,86 доллара, Opus 5.5 max — 12,61 доллара.
Когда выбирать Gemini 4 Neon, а когда Claude Opus 5.5
Ниже — выводы, сделанные на основе приведённых цифр. Это рекомендации, а не факты. Проверьте их на своих собственных примерах задач.
Сценарии, где лучше подойдёт Gemini 4 Neon
- Аудио и видео подаются на вход напрямую: согласно карточке модели, Neon поддерживает аудио и видео, а у Opus на входе только текст и изображения.
- Поиск и рассуждения в сверхдлинном контексте: GraphWalks — 95,2% против 66,8%, а единое окно Neon вмещает до 1048576 токенов (руководство разработчика Google Cloud).
- Бизнес-автоматизация и агенты для работы со знаниями: AutomationBench — 56,3% против 42,5%, Agents’ Last Exam v1.1 — 75,8% против 71,6% (карточка модели).
- Интерактивные сценарии, чувствительные к ожиданию первого токена: по данным страницы модели Artificial Analysis, у Neon xhigh время до первого токена — 56,51 с, у Opus max — 335,85 с.
Сценарии, где лучше остаться на Claude Opus 5.5
- Написание кода для работы в терминале: Terminal-bench 4.1 — 65,8% против 65,2% (карточка модели).
- Задачи по коду в духе FrontierCode: 47,3% против 46,2% (карточка модели, у Neon по умолчанию уровень high).
- Пропускная способность при длинных ответах: скорость вывода — 118 против 110 токенов/с (страница модели Artificial Analysis).
- Рабочие процессы, уже глубоко завязанные на Claude Code или эндпоинт messages: стоимость миграции тоже нужно учитывать.
Как вызвать Claude Opus 5.5 в APIYI и проверить статус Gemini 4 Neon
Модель и цены Claude Opus 5.5 в APIYI
Если вы уже пользуетесь Opus, модель и цену можно проверить в APIYI (apiyi.com) с тем же ключом. В сводной таблице APIYI docs.apiyi.com/models.md указано время обновления — 2026-11-16 09:39 (UTC+8). Данные эндпоинта цен api.apiyi.com/api/pricing получены 2026-11-19, версия — shell-api-modelmak-v1, всего 285 моделей.
| ID модели | Ввод / чтение кеша / вывод (долл. США за миллион токенов) | Эндпоинт | Группы (сводная таблица APIYI) | ID групп (эндпоинт цен) |
|---|---|---|---|---|
claude-opus-5-5 |
4 / 0.2 / 20 | chat, messages | ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
claude-opus-5-5-thinking |
4 / 0.2 / 20 | chat, messages | то же | то же |
gemini-4-neon |
не добавлена | — | — | — |
Названия групп в двух источниках совпадают не полностью, поэтому в таблице сохранены оба варианта. В эндпоинте цен model_ratio, равный 1, соответствует 2 долларам за миллион входных токенов, а completion_ratio, равный 5, означает, что цена вывода в 5 раз выше цены ввода. Это совпадает с записью первого тарифа в сводной таблице, так что по этому правилу можно самостоятельно проверить цены выше.
Ни в сводной таблице APIYI, ни в эндпоинте цен нет gemini-4-neon, как нет и отдельной страницы этой модели. Модель ещё не добавлена, но мы добавим её как можно скорее; модель и цену стоит сверять со списком моделей на платформе. Для справки: на странице цен Google AI Studio платный тариф Neon указан так — 3.00 доллара за ввод, 15.00 доллара за вывод (включая токены рассуждений), 0.15 доллара за кеш, за миллион токенов; бесплатного тарифа нет, поддерживается только неявное кеширование.
Порядок вызова
- Положите ключ в переменную окружения, например
APIYI_API_KEY; в коде читайте только переменную окружения, не записывайте ключ открытым текстом. - Если используете клиент, совместимый с OpenAI, задайте
base_urlравнымhttps://api.apiyi.com/v1. - В поле
modelукажитеclaude-opus-5-5илиclaude-opus-5-5-thinking; эндпоинт выбирайте по задаче — chat или messages. - Группу выбирайте под свою задачу. Названия групп сверяйте с тем, как они записаны в сводной таблице и эндпоинте цен.
- Когда Neon появится и вы будете проводить сравнительный тест, учтите: в руководстве для разработчиков Google Cloud указано, что у этой модели есть только уровни рассуждений low, medium, high и xhigh, по умолчанию — high. Если передать
thinking_budgetилиMINIMAL, вернётся HTTP400. Явное кеширование контекста не поддерживается, а неявное кеширование автоматически срабатывает для общих префиксов длиной более 4096 токенов.
🚀 Быстрый старт: сначала прогоните на Opus десяток с лишним своих реальных задач и получите базовый результат — запишите количество выходных токенов и время выполнения. Когда Neon появится в APIYI apiyi.com, сравните на той же выборке и с тем же уровнем рассуждений — так вы получите расчёт именно под свой бизнес.
Gemini 4 Neon и Claude Opus 5.5: рекомендации по выбору
💡 Совет по выбору: если ваша работа в основном связана с терминалом и задачами по коду, то по карточкам моделей и оценкам Artificial Analysis разрыв очень мал: Opus немного выше в Terminal-bench 4.1 и FrontierCode 2.0, так что явных причин переключаться нет. Если же вы больше занимаетесь структурированием знаний, длинным контекстом и мультимодальными входными данными, то в карточках моделей большинство отдельных показателей выше у Neon — стоит как можно скорее провести сравнительное тестирование после его запуска. Это суждение, а не факт.
Что касается расходов, не стоит брать цифры 6.44 и 10.04 доллара из Artificial Analysis напрямую для бюджета. И не переносите на Opus фразу из блога Google «при настройке high по умолчанию стоимость одной задачи на 32% ниже, чем у Carbon» — это собственная методика Google, и сравнивается там не Opus.
Часто задаваемые вопросы (FAQ)
Вопрос 1. Какое место занимает Gemini 4 Neon?
Согласно блогу Google (официальные данные самой компании) и руководству для разработчиков Google Cloud, Neon стоит между Hydrogen (быстрое выполнение повседневных задач) и Carbon (сложные длительные задачи) и ориентирован на частые сложные процессы. В карточке модели указано, что она создана на основе Gemini 4 Carbon, а знания обрезаны по март 2026 года.
Вопрос 2. У кого выше цифры в кодировании — Gemini 4 Neon или Claude Opus 5.5?
Тут надо смотреть по отдельным метрикам. В карточке модели Opus выше в Terminal-bench 4.1 (65.8% против 65.2%) и FrontierCode 2.0 (47.3% против 46.2%), а Neon выше в CursorBench 4.1 и SWE-sweep. В статье Artificial Analysis индекс Coding Agent Index — 59 против 58, но модели запускались в разных CLI.
Вопрос 3. Балл интеллекта 61 против 59 — это сравнение на одинаковом уровне настроек?
Нет. Это Neon xhigh против Opus max, то есть у каждой модели взят максимальный уровень с её страницы. Если сравнивать Neon high (60) и Opus xhigh (57), разрыв изменится. Балл интеллекта 61 совпадает и в блоге Google, и в карточке модели, и на Artificial Analysis.
Вопрос 4. Можно ли считать 6.44 доллара против 10.04 доллара за задачу своим счётом?
Нельзя. Это цифры из рейтинга Artificial Analysis при прогоне индекса — они зависят от его набора задач и объёма выходных токенов. Реальный счёт считается по вашему собственному расходу входных, выходных и кэшированных токенов и по тарифам платформы. На APIYI apiyi.com тариф Opus такой: вход 4 доллара, чтение кэша 0.2 доллара, выход 20 долларов (за миллион токенов).
Вопрос 5. Можно ли уже вызывать Gemini 4 Neon через APIYI?
Ни в сводной таблице APIYI (обновлена 2026-11-16), ни в интерфейсе цен (данные на 2026-11-19) модели `gemini-4-neon` нет. Она пока не добавлена, но мы добавим её как можно скорее; актуальные модели и цены смотрите в списке моделей на платформе. Пока можно запустить базовые примеры на apiyi.com с `claude-opus-5-5`, чтобы подготовиться к будущему сравнению.
Вопрос 6. Почему у Opus скорость вывода выше, а время на задачу больше?
Потому что время включает ожидание первого токена. По странице модели на Artificial Analysis, у Opus max первый токен ответа появляется через 335.85 секунды, у Neon xhigh — через 56.51 секунды. Скорость вывода отражает только пропускную способность после начала вывода.
Вопрос 7. Какие ограничения есть у этих сравнений?
В карточке модели результаты моделей, отличных от Gemini, по умолчанию взяты из данных самих компаний. У Coding Agent Index есть две версии — 58.6 и 59, у MKA — 56.5% и 56%, и в статье обе сохранены как есть. Значения SWE-sweep 12.8% и 39.0% получены на двух разных harness. Места в рейтинге и показатели безопасности из блога Google — это официальные данные, а не результаты независимой перепроверки.
Gemini 4 Neon и Claude Opus 5.5: ключевые выводы
- По цифрам преимущества есть у обеих моделей: Neon выше по большинству подпунктов карточки модели и по оценке интеллекта, Opus — по двум оценкам кодинга и по скорости вывода.
- Карточка модели — это официальная сводка: результаты для моделей, отличных от Gemini, — это данные самих производителей, а не повторные замеры в один и тот же день.
- Режимы нужно указывать явно: сравнение по оценке интеллекта — это Neon xhigh против Opus max.
- Стоимость одной задачи — это цифра из рейтинга: 6.44 доллара США против 10.04 доллара США, а не сумма в счёте платформы.
- Модальности различаются: Neon принимает на вход аудио и видео, Opus — текст и изображения.
- Как начать: Opus уже доступен на APIYI, Neon пока нет — ориентируйтесь на список моделей платформы.
Итог
Сравнение Gemini 4 Neon и Claude Opus 5.5 стоит рассматривать отдельно для кодинга и для работы со знаниями:
- Кодинг: Opus немного выше в Terminal-bench 4.1 и FrontierCode 2.0, Neon — выше в CursorBench 4.1 и в SWE-sweep при том же harness.
- Работа со знаниями: в большинстве подпунктов карточки модели выше Neon; самые заметные разрывы — в GraphWalks и AutomationBench.
- Четыре метрики Artificial Analysis: оценка интеллекта — 61 против 59, стоимость одной задачи — 6.44 доллара США против 10.04 доллара США, время выполнения — 21.5 против 24.5 минуты, скорость вывода — 110 против 118 токенов/с; режимы — Neon xhigh против Opus max.
Советую сначала собрать базовый уровень Opus на собственных примерах задач, а когда Neon станет доступен, сравнить его в том же режиме. На APIYI (apiyi.com) можно посмотреть цены и группы для claude-opus-5-5 и claude-opus-5-5-thinking; с одним и тем же API-ключом можно выполнить вызов и затем переключиться.
📚 Справочные материалы
-
Пост Sundar Pichai: каналы запуска Gemini 4 Neon
- Ссылка:
x.com/sundarpichai/status/2123167780988125621 - Описание: официально заявленный охват запуска
- Ссылка:
-
Блог Google «Introducing Gemini 4 Neon»: официально заявленные показатели бенчмарков, цен и безопасности
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Описание: Coding Agent Index 58.6, описание harness для SWE-sweep
- Ссылка:
-
Карточка модели DeepMind: сравнительная таблица из трёх столбцов и описание методики оценки
- Ссылка:
deepmind.google/models/model-cards/gemini-4-neon/ - Описание: результаты не-Gemini моделей по умолчанию берутся из отчётов самих компаний
- Ссылка:
-
Руководство разработчика Google Cloud: ID модели, уровни «размышления» и правила кэширования
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Описание: условия возникновения HTTP 400
- Ссылка:
-
Страница цен Google AI Studio: платная цена Neon
- Ссылка:
aistudio.google.com/docs/pricing - Описание: бесплатного тарифа нет, поддерживается только неявное кэширование
- Ссылка:
-
Статья Artificial Analysis: балл интеллекта Neon и стоимость одной задачи кодинга
- Ссылка:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Описание: измерение третьей стороной, Coding Agent Index 59
- Ссылка:
-
Страница модели Artificial Analysis: данные по уровням Neon и Opus 5.5
- Ссылка:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/claude-opus-5-5 - Описание: прочитано 2026-11-19, индекс v5.0.1
- Ссылка:
Автор: техническая команда APIYI
Техническое общение: свяжитесь с нами на главной странице сайта APIYI — модели и цены можно узнать в центре документации docs.apiyi.com