Nota do autor: este artigo analisa a informação divulgada no balanço do terceiro trimestre de 2026 da Alphabet de que “as APIs de modelos próprios processam quase 32 bilhões de tokens por minuto”, distinguindo as conclusões sustentadas por dados daquilo que ainda é desconhecido.
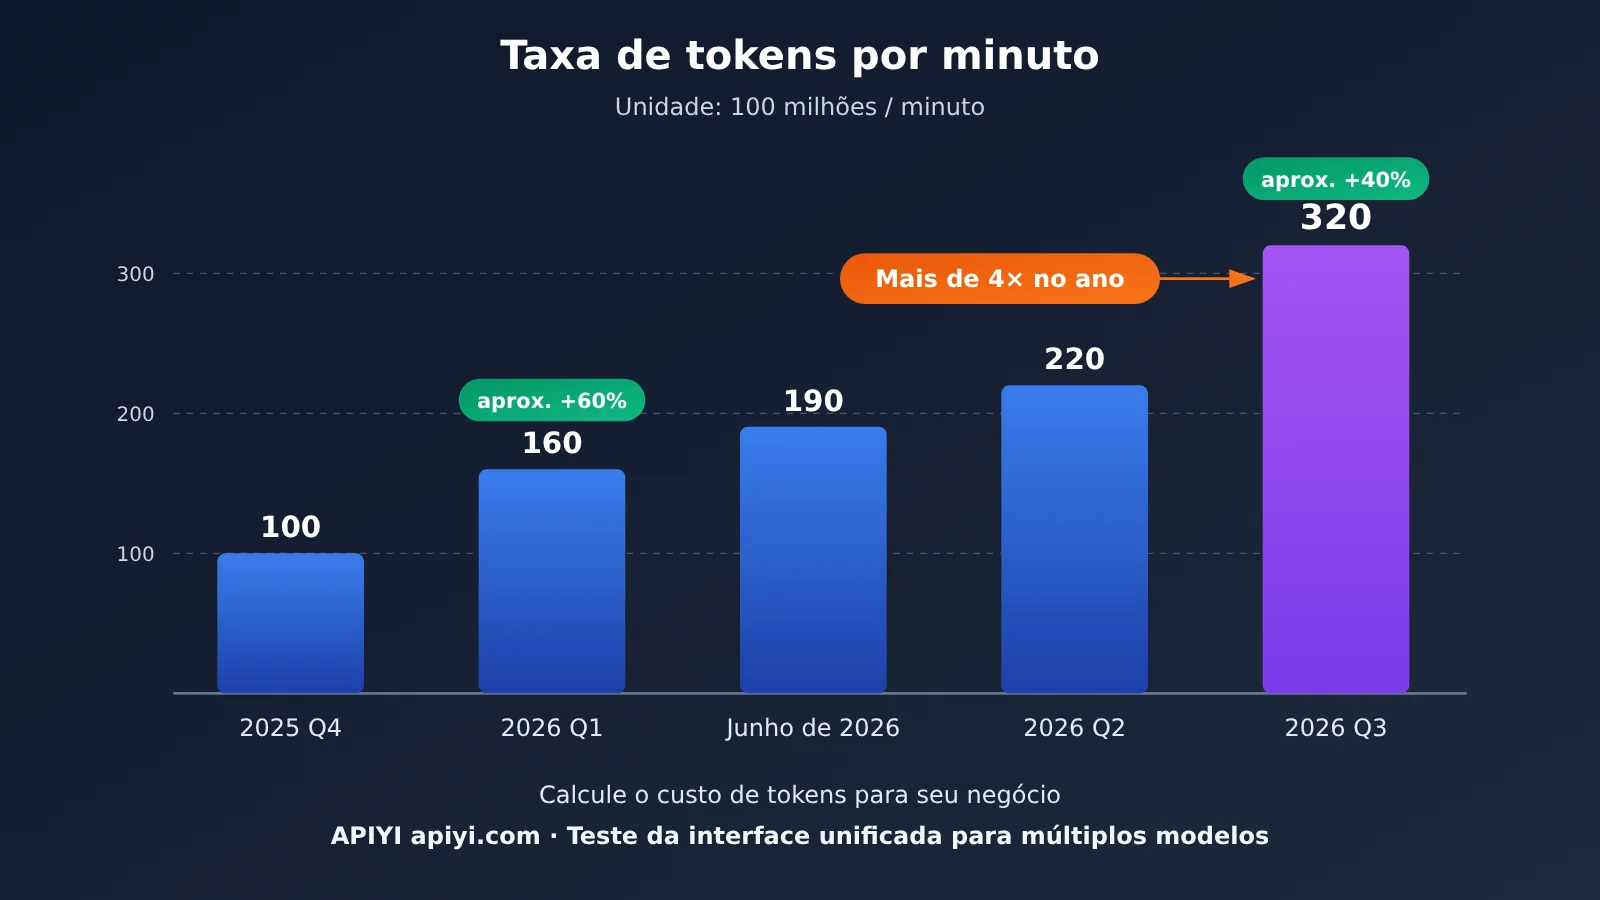
Em 28 de outubro de 2026 (horário dos Estados Unidos), a Alphabet divulgou o balanço do terceiro trimestre. Em seu pronunciamento, o CEO Sundar Pichai apresentou um número: as APIs de modelos próprios do Google processam quase 32 bilhões de tokens por minuto. Isso representa um crescimento de cerca de 40% em relação ao número divulgado no trimestre anterior e mais de quatro vezes o registrado um ano antes.
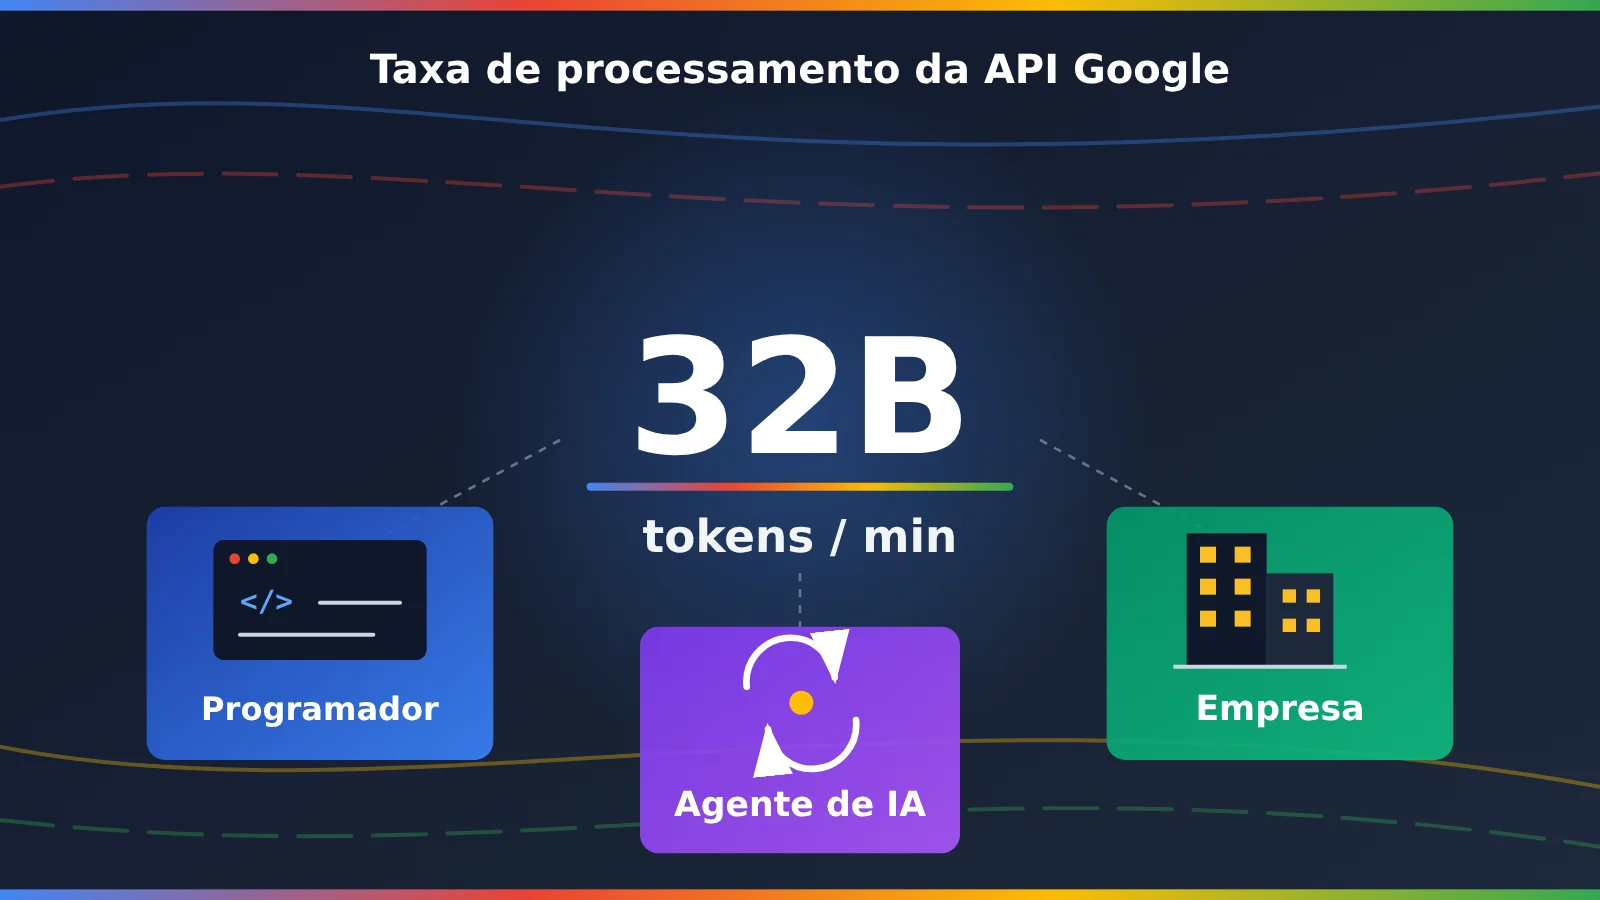
Não se trata de uma estimativa extraoficial. As palavras vieram do pronunciamento do CEO sobre o balanço, publicado no blog oficial do Google: “Nossas APIs de modelos próprios estão processando quase 32 bilhões de tokens por minuto”. É fácil, porém, interpretar esse número de forma errada: ele não representa 32 bilhões de invocações nem o uso do aplicativo Gemini.
O essencial: entenda em 3 minutos o que os 32 bilhões de tokens das APIs do Google medem, como esse número cresceu e como desenvolvedores, clientes corporativos e agentes consomem esses recursos computacionais.
Google API: os principais dados sobre os 32 bilhões de tokens
Primeiro, vamos reunir os fatos divulgados em uma tabela. A análise a seguir parte dessas informações.
| Item | Detalhes |
|---|---|
| Data da divulgação | 28 de outubro de 2026, teleconferência de resultados do terceiro trimestre da Alphabet |
| Responsável pela divulgação | Sundar Pichai, CEO da Alphabet |
| Número principal | As APIs de modelos próprios processam quase 32 bilhões de tokens por minuto |
| Variação trimestral | Crescimento de cerca de 40% em relação ao valor divulgado no trimestre anterior, segundo dados oficiais |
| Variação anual | Mais de 4 vezes o volume registrado um ano antes |
| Escopo da medição | Conjunto das APIs de modelos próprios do Google, não um único modelo Gemini |
| Dados não divulgados | Distribuição por modelo, cliente, setor ou produto de API |
O que está incluído nos 32 bilhões de tokens da Google API
Para entender a notícia, é importante separar algumas métricas que costumam ser confundidas. Os 32 bilhões representam a quantidade de tokens, não de requisições à API. Uma única requisição para analisar um documento longo pode conter centenas de milhares de tokens. O número também representa a taxa de processamento atual descrita em 28 de outubro, e não a média de todo o terceiro trimestre.
O relatório e a teleconferência de resultados também mencionaram números de desenvolvedores, licenças empresariais e uso do Gemini Enterprise. Cada métrica tem um escopo diferente: elas não podem ser somadas nem usadas para calcular umas às outras.
| Métrica | Valor e período | Escopo da medição | Pode ser somada aos 32 bilhões de tokens/minuto? |
|---|---|---|---|
| Volume processado pelas APIs de modelos próprios | Quase 32 bilhões de tokens/minuto (28/10/2026) | Taxa de processamento atual | É a própria métrica principal |
| Desenvolvedores ativos mensais | Mais de 9 milhões/mês (divulgado no segundo trimestre) | Desenvolvedores que usam APIs de modelos e os principais produtos para desenvolvedores | Não. É uma contagem de pessoas, não de clientes pagantes |
| Tokens em ferramentas para desenvolvedores | Mais de 3 trilhões por dia (material de junho de 2026) | Uso relacionado a ferramentas para desenvolvedores | Não. O escopo é diferente |
| Clientes do Gemini Enterprise com alto uso | Mais de 2.600 clientes com uso ≥100 bilhões de tokens (nos últimos 12 meses) | Uso de clientes do produto empresarial | Não |
| Licenças para trabalho intelectual | Mais de 100 milhões vendidas no total | Todos os serviços de IA do Google | Não. São licenças, não clientes de API |
Outro ponto importante: esse número não permite afirmar que o aplicativo Gemini consome 32 bilhões de tokens por minuto. Aplicativo, Search, licenças empresariais e tokens de API são linhas de negócio e métricas diferentes.
Linha do tempo do crescimento de tokens processados pela API do Google
Ao reunir as divulgações públicas mais recentes, a inclinação da curva revela mais do que qualquer número isolado.
| Data da divulgação | Ocasião | Tokens/minuto | Observações |
|---|---|---|---|
| 4º trimestre de 2025 | Divulgação trimestral | Cerca de 10 bilhões | Ponto de partida |
| 2026-04-29 | Resultados do 1º trimestre | Mais de 16 bilhões | Crescimento de cerca de 60% em relação ao trimestre anterior |
| Junho de 2026 | Material para investidores | Cerca de 19 bilhões | Dado do meio do trimestre |
| 2026-07-22 | Resultados do 2º trimestre | Cerca de 22 bilhões | — |
| 2026-10-28 | Teleconferência de resultados do 3º trimestre | Quase 32 bilhões | Segundo o Google, alta de cerca de 40% em relação ao trimestre anterior e mais de 4 vezes o volume de um ano antes |
Se calcularmos diretamente com 22 bilhões e 32 bilhões, o aumento é de aproximadamente 45,5%. Mas os dois valores são aproximações (“cerca de” e “quase”), então vale considerar a informação oficial do Google: “cerca de 40%”. Isso não significa que a empresa tenha errado a conta.
O que representam 32 bilhões de tokens por minuto
Para ter uma ideia da escala, vamos fazer uma conversão matemática supondo uma taxa constante. Vale destacar que os valores diários e mensais são apenas resultados desse cálculo hipotético, não o uso real divulgado pelo Google.
- Por segundo: cerca de 533 milhões de tokens
- Por hora: cerca de 1,92 trilhão de tokens
- Durante 24 horas, nessa taxa: cerca de 46,08 trilhões de tokens
- Durante 30 dias, nessa taxa: cerca de 1.382,4 trilhões de tokens
Quem está consumindo os 32 bilhões de tokens da API do Google?
Essa é a pergunta do título. Com base nas informações divulgadas pelo Google, é possível identificar três grupos importantes de usuários, mas a empresa não revelou a participação exata de nenhum deles.
Primeiro grupo: o ecossistema de desenvolvedores da API do Google
Segundo o relatório financeiro do segundo trimestre, mais de 9 milhões de desenvolvedores criam aplicativos mensalmente usando as APIs de modelos e os principais produtos para desenvolvedores do Google. Esse número mostra que a comunidade potencial é enorme, mas não equivale a 9 milhões de clientes pagantes nem significa que todos esses desenvolvedores chamem diretamente a API do Gemini.
No mesmo período, a plataforma de desenvolvimento de agentes Antigravity tinha mais de 2,4 milhões de usuários ativos por semana. Entre os usos que consomem tokens pelos desenvolvedores estão:
- Programação e desenvolvimento de software: leitura de repositórios de código, refatoração, geração de testes, identificação de erros e chamadas em ciclo por agentes de programação
- Desenvolvimento de aplicações de IA: chatbots em sites e aplicativos, automação do atendimento ao cliente, busca interna em empresas e análise de PDFs e documentos longos
- Fluxos de trabalho com agentes: planejamento de tarefas, chamadas a ferramentas externas, leitura dos resultados, correção de erros e execução das próximas etapas
Segunda categoria: clientes corporativos do Gemini Enterprise
Thomas Kurian, CEO do Google Cloud, apresentou dados sobre o mercado corporativo na teleconferência do terceiro trimestre. Nos últimos 12 meses, mais de 2.600 clientes usaram pelo menos 100 bilhões de tokens no Gemini Enterprise, dos quais cerca de 75 usaram pelo menos 10 trilhões de tokens. Além disso, quase 90% das empresas da Fortune 100 usam o Gemini Enterprise.
Outro sinal importante é o crescimento dos gastos: os clientes que já usavam o Gemini Enterprise no terceiro trimestre de 2025 aumentaram seus gastos em mais de 4 vezes no terceiro trimestre de 2026, em comparação com o ano anterior. Isso indica que a IA empresarial está passando de testes em pequena escala para implantações em larga escala. No entanto, o uso do Gemini Enterprise e os 32 bilhões de tokens da API de modelos próprios são métricas diferentes. Não se pode presumir que esses 2.600 clientes tenham sido responsáveis pela maior parte desse volume.
Terceira categoria: agentes setoriais e processos de negócios complexos
O Google divulgou vários casos de implantação em diferentes setores durante a teleconferência e no blog do Cloud. Todos os resultados abaixo foram divulgados oficialmente pelo Google e não foram verificados por terceiros independentes. A empresa também não informou quantos tokens cada uma dessas organizações consumiu.
| Empresa | Setor | Implantação divulgada pelo Google | Resultado divulgado pelo Google |
|---|---|---|---|
| BNP Paribas | Serviços financeiros | Gemini Enterprise implantado para mais de 65.000 funcionários | Simplificação dos fluxos de trabalho, com atenção à segurança e à governança de dados |
| Tata Steel | Manufatura | Mais de 300 agentes especializados implantados em 9 meses, abrangendo segurança, cadeia de suprimentos e reclamações de clientes | Redução de cerca de 50% no tempo de resolução das reclamações |
| Ulta Beauty | Varejo | Assistente de compras com IA | Taxa de conversão cerca de 3 vezes maior que a da navegação convencional no site |
| Hitachi HMAX | Operações industriais em campo | Técnicos da linha de frente criaram mais de 200 casos de uso para agentes, como a comparação de fotos tiradas antes e depois de uma tarefa | Aumento de produtividade de até cerca de 30% nos cenários correspondentes |
| NTT DOCOMO | Análise de dados | Agente de análise de dados | Obtenção de alguns insights passou de duas semanas para quase instantânea, com economia estimada de cerca de 450.000 horas por ano |
O que esses casos têm em comum é que o modelo não é mais usado apenas para conversar: ele está integrado a processos reais, como segurança operacional, cadeia de suprimentos, decisões de compra e análise de dados. No caso da Ulta Beauty, o aumento de 3 vezes se refere à taxa de conversão do assistente de compras, não a um crescimento de 3 vezes nas vendas totais.
Multimodalidade: outro fator que amplia o consumo de tokens da API do Google
Perguntas e respostas em texto, revisão de contratos, análise de repositórios de código completos, compreensão de imagens e vídeos e transcrição de áudio têm perfis de consumo de tokens bem diferentes. Não dá para converter diretamente a quantidade de imagens, a duração de vídeos ou o tamanho de arquivos em tokens usando como referência o número de palavras de um texto comum.
O Google não divulgou como os 32 bilhões de tokens se distribuem entre texto, imagem, vídeo e áudio. Também não informou quantos são tokens de entrada, quantos são de saída e quantos vêm do processo interno de raciocínio do modelo.
Por que agentes aumentam o consumo de tokens da API do Google
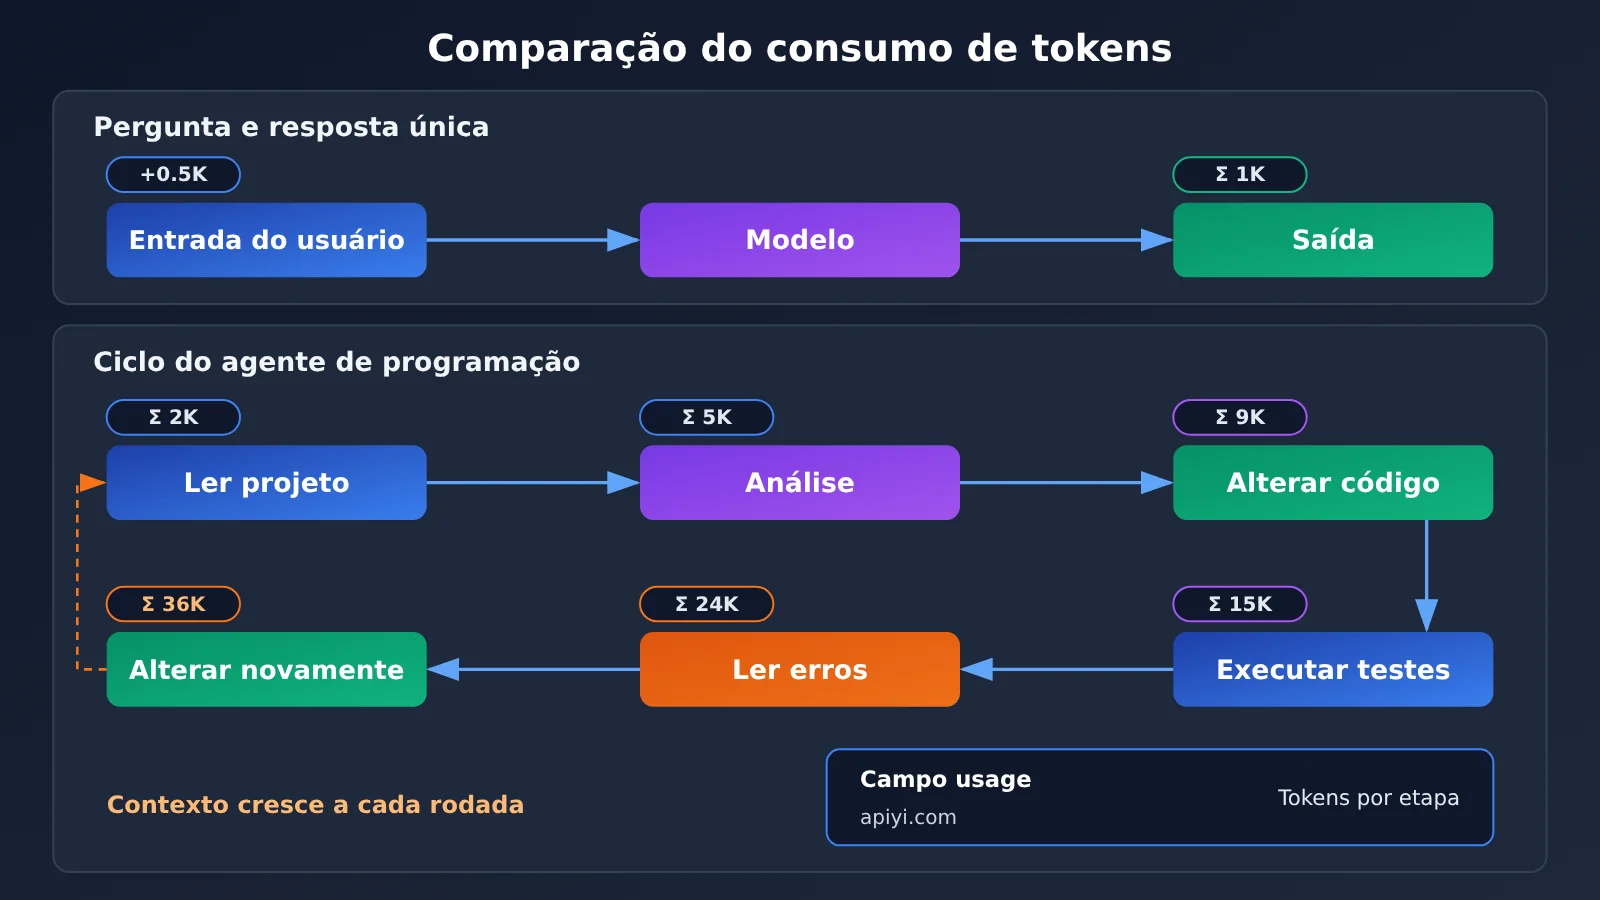
Uma conversa comum pode ter apenas uma entrada e uma resposta. Já para concluir uma tarefa, um agente de programação pode passar por várias etapas: ler arquivos, analisar o problema, modificar o código, executar testes, ler erros, fazer novas alterações e testar novamente. Cada etapa pode envolver uma chamada ao modelo e, em geral, exige que o contexto acumulado seja enviado novamente.
Por isso, há uma explicação fundamentada para afirmar que “agentes são uma fonte potencial importante de demanda”. Mas não há dados públicos que sustentem a afirmação de que “agentes responderam pela maior parte dos 32 bilhões de tokens”. Na hora de escrever sobre o assunto ou tomar decisões, é importante separar as duas afirmações.
Como observar o acúmulo de tokens de um agente com código
A maneira mais simples de entender isso na prática é registrar o campo usage retornado em cada chamada. O exemplo abaixo simula um processo de correção em várias rodadas e imprime os tokens de entrada e saída de cada etapa:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "写一个计算斐波那契数列的 Python 函数"}]
resp = client.chat.completions.create(model="YOUR_GEMINI_MODEL", messages=messages)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)
Ver o código para contabilizar os tokens em um ciclo de agente com várias rodadas
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "YOUR_GEMINI_MODEL"  # 替换为平台模型列表中的 Gemini 模型名称

steps = [
    "写一个计算斐波那契数列的 Python 函数",
    "为这个函数补充单元测试",
    "测试报错:输入负数时没有处理,请修复",
    "再检查一遍边界条件并给出最终版本",
]

messages = [{"role": "system", "content": "你是一个严谨的编程助手"}]
total_in, total_out = 0, 0

for i, step in enumerate(steps, 1):
    messages.append({"role": "user", "content": step})
    resp = client.chat.completions.create(model=MODEL, messages=messages)
    reply = resp.choices[0].message.content
    messages.append({"role": "assistant", "content": reply})

    usage = resp.usage
    total_in += usage.prompt_tokens
    total_out += usage.completion_tokens
    print(f"第 {i} 步:输入 {usage.prompt_tokens},输出 {usage.completion_tokens}")

print(f"累计输入 {total_in},累计输出 {total_out}")
Ao executar o código, você verá que os tokens de entrada aumentam a cada rodada por causa do histórico de contexto. É por isso que a dinâmica de consumo de tokens em um fluxo de trabalho com agentes é bem mais complexa do que em uma única pergunta e resposta.
🚀 Dica para começar: se quiser medir a evolução do consumo de tokens de diferentes modelos em um ciclo de agente, cadastre-se na APIYI apiyi.com para obter créditos gratuitos de teste. Com a mesma chave API, você pode alternar entre modelos como Gemini, Claude e GPT e comparar o consumo de tokens na mesma tarefa.
Análise do impacto dos 32 bilhões de tokens da API do Google
Impacto para desenvolvedores
- A estrutura de custos passa de “por chamada” para “por fluxo”: o custo de uma tarefa de agente depende do número de ciclos e do tamanho do contexto. Por isso, é importante planejar o orçamento de tokens já na fase de projeto, por exemplo, reduzindo o histórico de contexto e colocando em cache o conteúdo que não muda.
- A escolha entre modelos ganha importância: modelos de alto desempenho e modelos econômicos coexistem. Uma prática comum para controlar os custos é usar modelos mais avançados para planejamento complexo e modelos econômicos para classificação em lote.
- O faturamento multimodal precisa de uma avaliação separada: imagens, vídeos e áudios têm formas de cálculo de tokens diferentes das usadas para texto. Antes de entrar em produção, vale medir o consumo com amostras reais.
💡 Dica para escolher: o consumo de tokens e os resultados de uma mesma tarefa podem variar bastante entre modelos. Experimente amostras reais por uma interface unificada com a APIYI apiyi.com antes de decidir a combinação de modelos para produção.
Impacto para o setor e para o Google Cloud
Durante a teleconferência, Kurian explicou que, ao criar agentes, as empresas geralmente precisam de mais do que a invocação do modelo: também precisam de recursos computacionais, serviços para armazenar a memória dos agentes e bancos de dados para fornecer contexto. Assim, a adoção de modelos também pode impulsionar o crescimento de outros produtos de nuvem.
| Indicador financeiro (Q3 encerrado em 30/09/2026) | Valor | Observação |
|---|---|---|
| Receita total da Alphabet | US$ 127,577 bilhões, alta de 25% em relação ao ano anterior | Grupo como um todo |
| Receita do Google Cloud | US$ 30,709 bilhões, alta de 103% em relação ao ano anterior | Inclui infraestrutura de IA empresarial, soluções de IA, serviços principais do GCP e vendas de sistemas TPU |
| Lucro operacional do Google Cloud | US$ 11,121 bilhões | Margem operacional trimestral de aproximadamente 36,2% |
| Receita separada da Gemini API | Não divulgada | Não pode ser substituída pela receita do Cloud |
Vale destacar dois pontos. Os US$ 30,7 bilhões são a receita de todo o Google Cloud, não da Gemini API. Também não é possível estimar a receita de API do Google multiplicando 32 bilhões de tokens pelos preços públicos: a distribuição entre modelos não foi divulgada, os preços variam de um modelo para outro e clientes empresariais ainda podem ter acesso a processamento em lote, cache, contratos exclusivos e descontos.
Uma armadilha de datas fácil de ignorar
O período financeiro do Q3 da Alphabet vai de 1º de julho a 30 de setembro de 2026; o Gemini 4 Argon foi lançado oficialmente em 13 de outubro de 2026; e o volume de 32 bilhões de tokens por minuto foi divulgado em 28 de outubro. Portanto, não dá para tratar os 32 bilhões como a taxa média do terceiro trimestre, muito menos afirmar que o crescimento da API em todo o Q3 foi impulsionado principalmente pelo Argon, lançado apenas em outubro. Uma forma mais segura de dizer isso é: o lançamento do Argon e o marco de 32 bilhões de tokens refletem, juntos, os avanços do Google em modelos e negócios em outubro de 2026.
Perguntas frequentes (FAQ)
Q1: O que significam 32 bilhões de tokens por minuto na API do Google?
Essa é a taxa geral de processamento da API dos modelos do próprio Google, informada em 28 de outubro de 2026. A unidade é token, não número de requisições, e o dado não se refere ao uso de um modelo Gemini específico nem do aplicativo Gemini.
Q2: Quem contribui para esses 32 bilhões de tokens?
Entre os usuários confirmados estão mais de 9 milhões de desenvolvedores por mês, mais de 2.600 clientes do Gemini Enterprise com alto volume de uso e implantações de agentes em setores como finanças, manufatura, varejo e operações industriais. Mas o Google não divulgou a participação específica de cada grupo, setor ou modelo. Portanto, não há dados públicos que sustentem afirmações de que uma determinada categoria de usuário responde pela maior parte do volume.
Q3: Os 32 bilhões de tokens têm alguma relação com o Gemini 4 Argon?
O Argon foi lançado em 13 de outubro de 2026, e os 32 bilhões representam a taxa atual em 28 de outubro. Ambos fazem parte dos avanços do Google naquele mês. Mas o período de apuração do terceiro trimestre terminou em 30 de setembro, então não é possível atribuir todo o crescimento do trimestre ao Argon.
Q4: Como os desenvolvedores podem estimar o consumo de tokens de suas aplicações?
O método mais confiável é fazer testes com amostras reais e registrar o campo `usage` retornado em cada chamada. Você pode obter créditos gratuitos para testes na APIYI, em apiyi.com, e usar o código deste artigo com `base_url` definido como `https://api.apiyi.com/v1`. Teste separadamente cenários de texto, documentos longos e agentes com múltiplas rodadas de interação; depois, estime os custos com base no volume de uso.
Q5: É possível estimar a receita do Google com APIs a partir dos 32 bilhões de tokens?
Não. A distribuição entre modelos, os preços efetivos, os descontos por processamento em lote e cache e os contratos exclusivos de empresas não são públicos. O Google também não divulgou a receita e o lucro da Gemini API separadamente.
Q6: Quais são as limitações conhecidas dos dados dessa notícia?
Há três limitações principais: não há detalhamento por cliente, setor ou modelo; não há proporção de uso entre texto, imagem, vídeo e áudio; e não há divisão entre tokens de entrada, saída e raciocínio interno. Além disso, os resultados dos casos empresariais foram divulgados pelo próprio Google e não passaram por verificação independente de terceiros.
Google API: principais pontos sobre os 32 bilhões de tokens
- Número principal: a API de modelos próprios do Google processa quase 32 bilhões de tokens por minuto, mais de quatro vezes o volume registrado um ano antes
- Curva de crescimento: passou de cerca de 10 bilhões para quase 32 bilhões em aproximadamente um ano
- Três grupos de usuários: ecossistema de desenvolvedores, clientes empresariais do Gemini Enterprise e aplicações de agentes em diferentes setores
- Como os agentes funcionam: ciclos de múltiplas interações e acúmulo de contexto multiplicam o consumo de tokens de uma única tarefa
- Limites das métricas: tokens, número de requisições, licenças, quantidade de desenvolvedores e receita do Cloud não podem ser confundidos nem somados
- Maior incógnita: o Google ainda não divulgou como os 32 bilhões de tokens se distribuem entre clientes e casos de uso
- Sugestão de teste: use a interface unificada da APIYI, em apiyi.com, para medir a curva real de consumo de tokens do seu negócio
Resumo
Os principais pontos da notícia sobre os 32 bilhões de tokens por minuto da Google API são:
- A escala está crescendo rapidamente: um crescimento de mais de quatro vezes em um ano indica que a invocação de modelos está passando da fase de testes para o uso em larga escala
- As fontes de demanda já são identificáveis: desenvolvedores, clientes empresariais e agentes usados em diferentes setores são grupos reais de alto consumo
- A participação de cada grupo ainda é desconhecida: o Google não divulgou dados detalhados; reconhecer isso é respeitar os limites dos dados, não apontar uma falha na informação
- O valor comercial ainda precisa ser observado: o que realmente vale acompanhar é quantas dessas invocações se transformarão em aplicações empresariais sustentáveis e lucrativas
Para os desenvolvedores, a lição mais direta é que agentes e recursos multimodais tornarão o orçamento de tokens ainda mais importante. Por isso, a escolha do modelo e o gerenciamento de contexto precisam entrar no planejamento da arquitetura desde cedo. Uma opção é usar a APIYI, em apiyi.com, para comparar o desempenho e o consumo de vários modelos com uma única chave API antes de escolher a solução mais adequada.
📚 Referências
- Resultados financeiros da Alphabet no 3º trimestre de 2026 (SEC): fonte original dos dados financeiros
- Link:
sec.gov/Archives/edgar/data/1652044/000165204426000080/googexhibit991q32026.htm -
Detalhes: receita, receita do Google Cloud e lucro operacional
-
Comunicado do CEO do Google sobre os resultados do 3º trimestre de 2026: fonte da declaração sobre 32 bilhões de tokens por minuto
- Link:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Detalhes: números principais e métricas oficiais de crescimento
-
Transcrição da teleconferência de resultados da Alphabet no 3º trimestre de 2026: dados e casos de clientes empresariais
- Link:
fool.com/earnings/call-transcripts/2026/10/29/alphabet-googl-q3-2026-earnings-call-transcript/ -
Detalhes: dados do Gemini Enterprise divulgados por Thomas Kurian
-
Comunicado do CEO do Google sobre os resultados do 2º trimestre de 2026: dados sobre desenvolvedores e 22 bilhões de tokens
- Link:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q2-2026/ -
Detalhes: 9 milhões de desenvolvedores ativos por mês e dados de usuários ativos semanais do Antigravity
-
Comunicado do CEO do Google sobre os resultados do 1º trimestre de 2026: dados sobre 16 bilhões de tokens
- Link:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q1-2026/ -
Detalhes: marco na linha do tempo do crescimento
-
Apresentação do Google para investidores de junho de 2026: 19 bilhões de tokens e uso de ferramentas para desenvolvedores
- Link:
blog.google/alphabet/investor-presentation-june-2026/ -
Detalhes: mais de 3 trilhões de tokens por dia em ferramentas para desenvolvedores
-
Google Cloud: Gemini at Work 2026: casos de clientes empresariais que usam agentes
- Link:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Detalhes: casos de implementação em empresas como a Hitachi
Autor: equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial do site oficial da APIYI. Para mais informações sobre integração, acesse a documentação em docs.apiyi.com.