作者注:本文解读 Alphabet 2026 年第三季度财报中“第一方模型 API 每分钟处理近 320 亿 Token”的披露,并区分哪些结论已有数据支撑,哪些目前仍属未知。
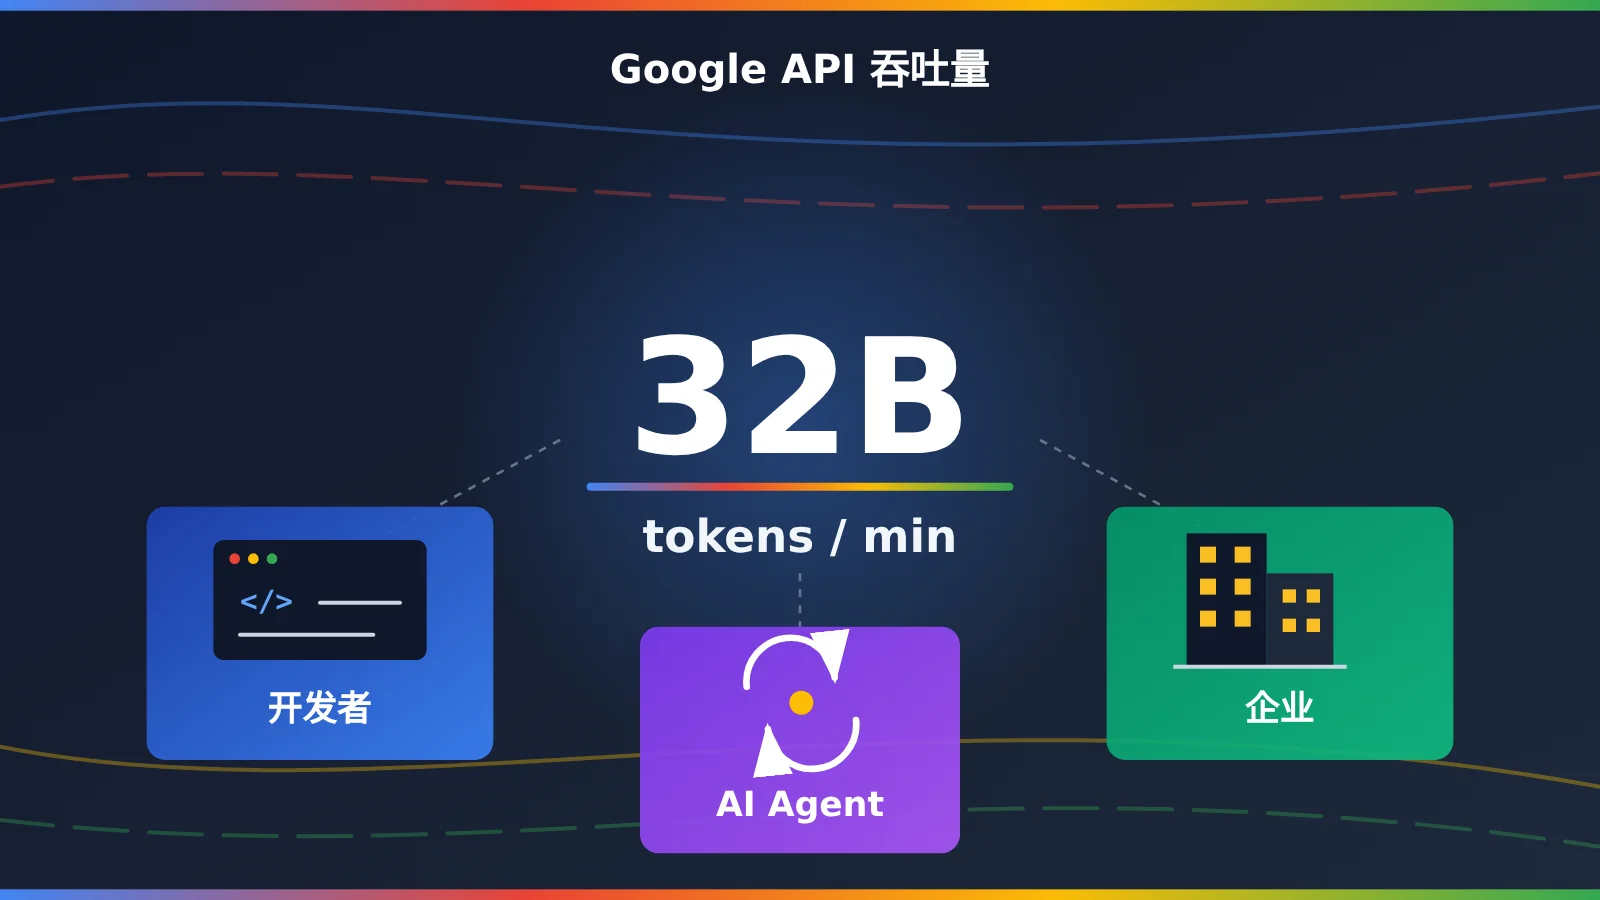
2026 年 10 月 28 日(美国时间),Alphabet 发布第三季度财报。CEO Sundar Pichai 在讲话中给出一个数字:Google 第一方模型 API 每分钟处理近 320 亿 Token,比上一季度披露值增长约 40%,是一年前的 4 倍以上。
这不是坊间估算,原话来自 Google 官方博客的 CEO 财报讲话:“Our first-party model APIs are now processing nearly 32 billion tokens per minute”。不过这个数字很容易被误读,比如当成 320 亿次调用,或者当成 Gemini App 的用量,这两种理解都不对。
核心价值:3 分钟看懂 Google API 320 亿 Token 的统计口径、增长曲线,以及开发者、企业客户和 Agent 场景各自在哪里消耗这些算力。
Google API 320 亿 Token 核心信息速览
先把新闻事实放在一张表里,后面的分析都从这些已披露的信息出发。
| 信息项 | 详情 |
|---|---|
| 披露时间 | 2026 年 10 月 28 日,Alphabet Q3 财报电话会 |
| 披露人 | Alphabet CEO Sundar Pichai |
| 核心数字 | 第一方模型 API 每分钟处理近 320 亿 Token |
| 环比变化 | 较上一季度披露值增长约 40%(官方口径) |
| 同比变化 | 达到一年前的 4 倍以上 |
| 统计对象 | Google 第一方模型 API 整体,并非某个单独的 Gemini 模型 |
| 未披露内容 | 模型、客户、行业、API 产品的分项构成 |
Google API 320 亿 Token 的统计口径边界
理解这条新闻,首先要分清几个经常被混在一起的指标。320 亿是 Token 数量,不是 API 请求次数,一次长文档分析请求就可能包含几十万 Token。它也是 10 月 28 日描述的当前处理速率,并不是整个第三季度的平均值。
财报和电话会还提到了开发者人数、企业席位、Gemini Enterprise 用量等数据。这些指标口径各不相同,不能相加,也不能互相推算。
| 指标 | 数值与时间 | 统计口径 | 能否与 320 亿 Token/分钟 相加 |
|---|---|---|---|
| 第一方模型 API 吞吐 | 近 320 亿 Token/分钟(2026-10-28) | 当前处理速率 | 本身就是核心指标 |
| 月活开发者 | 超过 900 万/月(Q2 披露) | 使用模型 API 及主要开发者产品的开发者 | 否,是人数,不是付费客户数 |
| 开发者工具 Token | 每天超过 3 万亿(2026 年 6 月材料) | 开发者工具相关使用 | 否,口径不同 |
| Gemini Enterprise 高用量客户 | 超过 2600 家用量 ≥1000 亿 Token(过去 12 个月) | 企业产品客户用量 | 否 |
| 知识工作席位 | 累计售出超过 1 亿个 | 跨 Google 全部 AI 服务 | 否,是席位,不是 API 客户 |
还有一点要特别说明:这一数字不能用来声称 Gemini App 每分钟消耗 320 亿 Token。App、Search、企业席位和 API Token 是不同的业务线和指标。
Google API Token 吞吐量增长时间线
把过去几次公开披露串起来,曲线的陡峭程度比单个数字更能说明问题。
| 披露时间 | 场合 | Token/分钟 | 备注 |
|---|---|---|---|
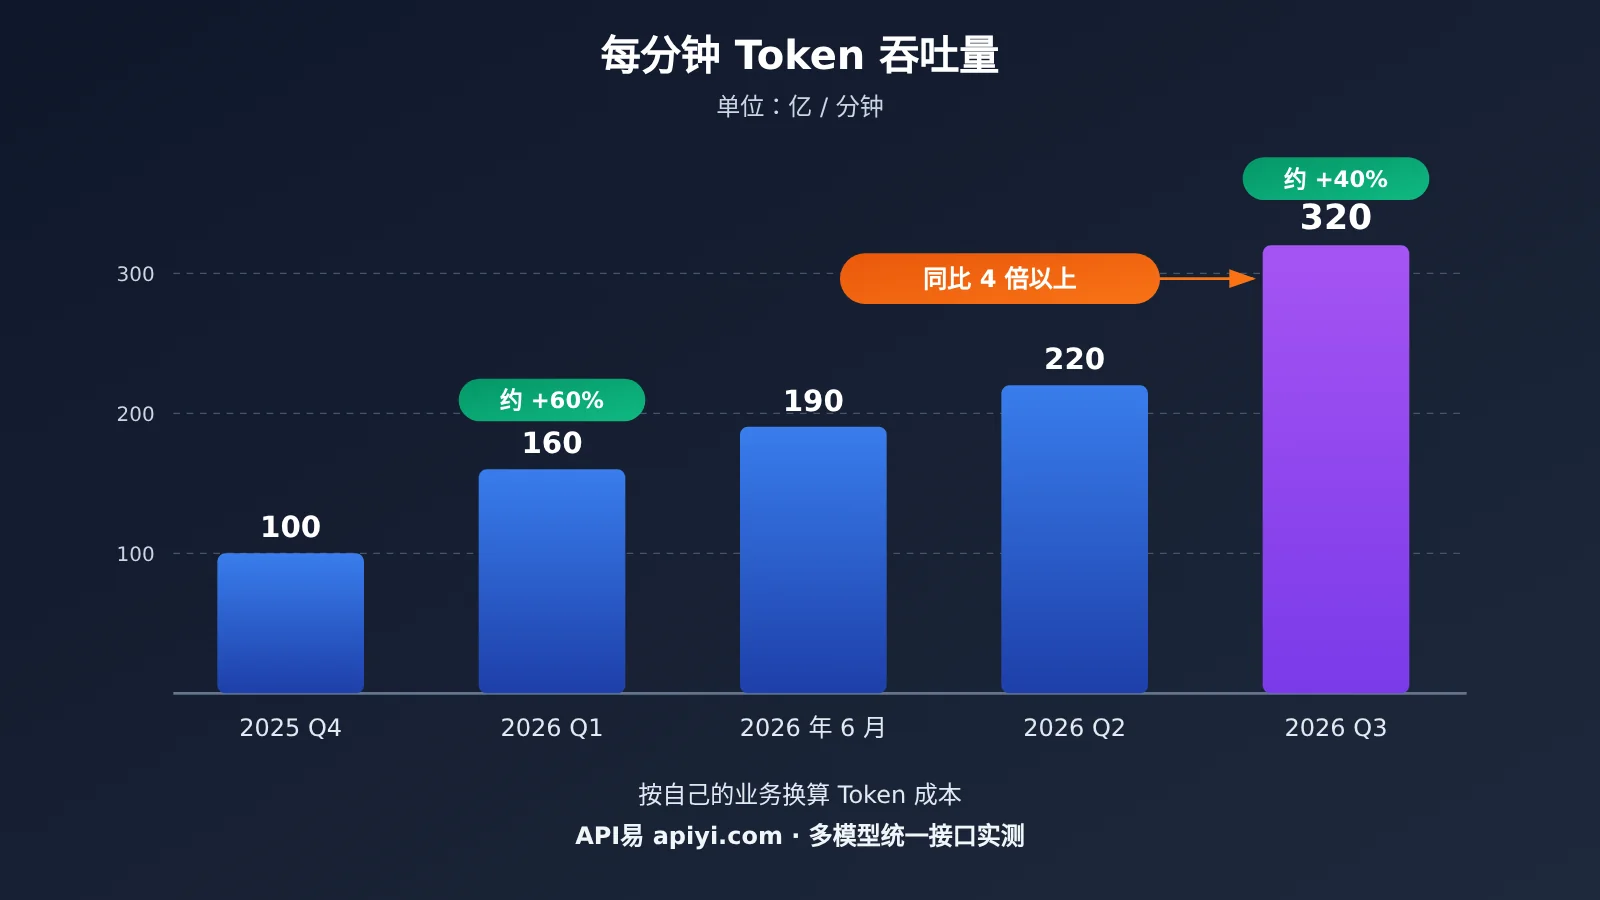
| 2025 年 Q4 | 季度披露 | 约 100 亿 | 起点 |
| 2026-04-29 | Q1 财报 | 超过 160 亿 | 较前一季度增长约 60% |
| 2026 年 6 月 | 投资者介绍材料 | 约 190 亿 | 季度中期数据 |
| 2026-07-22 | Q2 财报 | 约 220 亿 | — |
| 2026-10-28 | Q3 财报电话会 | 近 320 亿 | 官方称环比约 40%,同比 4 倍以上 |
如果直接用 220 亿和 320 亿计算,增幅约为 45.5%。但两个数值都是近似值(“约”“近”),所以应以 Google 官方表述的“约 40%”为准,这并不代表官方算错了。
320 亿 Token/分钟 的数量级换算
为了直观感受规模,下面按恒定速率做一次数学换算。需要强调,日、月数据只是假设条件下的计算结果,不是 Google 披露的实际用量。
- 每秒:约 5.33 亿 Token
- 每小时:约 1.92 万亿 Token
- 假设持续 24 小时:约 46.08 万亿 Token
- 假设持续 30 天:约 1382.4 万亿 Token
谁在消耗 Google API 320 亿 Token
这正是标题提出的问题。根据 Google 已公开的信息,可以确认三类重要使用者,但没有任何一类的精确占比被公开。
第一类:Google API 开发者生态
Q2 财报显示,每月超过 900 万名开发者通过 Google 模型 API 及主要开发者产品构建应用。这个数字说明潜在开发群体非常庞大,但它不等于 900 万付费客户,也不意味着每位开发者都直接调用 Gemini API。
同一时期,Antigravity 智能体开发平台已有超过 240 万周活跃用户。开发者消耗 Token 的场景大致包括:
- 编程与软件开发:阅读代码仓库、重构代码、生成测试、定位错误,以及编程 Agent 的循环调用
- AI 应用开发:网站和 App 里的聊天机器人、客服自动化、企业内部搜索、PDF 与长文档分析
- 智能体工作流:任务规划、调用外部工具、读取工具结果、修正错误、执行后续步骤
第二类:Gemini Enterprise 企业客户
Google Cloud CEO Thomas Kurian 在 Q3 电话会上给出了企业端数据。过去 12 个月,超过 2600 家客户在 Gemini Enterprise 上使用至少 1000 亿 Token,其中约 75 家使用至少 10 万亿 Token;接近 90% 的财富 100 强企业在使用 Gemini Enterprise。
另一个值得注意的信号是支出增长:2025 年 Q3 就已使用 Gemini Enterprise 的客户,在 2026 年 Q3 的支出同比增长超过 4 倍。这说明企业 AI 正在从小规模试用走向规模化部署。不过 Gemini Enterprise 用量与第一方模型 API 的 320 亿 Token 属于不同口径,不能假定这 2600 家客户贡献了其中大部分。
第三类:行业 Agent 与复杂业务流程
Google 在电话会和 Cloud 博客中披露了多个行业部署案例。以下效果数据均来自 Google 官方披露,并非独立第三方验证,Google 也没有公开这些企业各自消耗了多少 Token。
| 企业 | 行业 | Google 披露的部署内容 | Google 披露的效果 |
|---|---|---|---|
| BNP Paribas | 金融服务 | 向超过 65000 名员工部署 Gemini Enterprise | 简化工作流程,兼顾安全与数据治理 |
| Tata Steel | 制造业 | 9 个月内部署超过 300 个专业 Agent,覆盖安全、供应链、客诉 | 客诉处理周转时间缩短约 50% |
| Ulta Beauty | 零售 | AI 购物助手 | 转化率约为传统网站浏览的 3 倍 |
| Hitachi HMAX | 工业现场 | 一线技术人员构建超过 200 种 Agent 场景,如图像核对作业前后照片 | 相关场景生产率最高提升约 30% |
| NTT DOCOMO | 数据分析 | 数据分析 Agent | 部分洞察获取从两周压缩到近乎即时,估算每年节约约 45 万小时 |
这些案例的共同点是:模型不再只用于聊天,而是嵌入生产安全、供应链、购物决策和数据分析等真实流程。Ulta Beauty 的 3 倍是购物助手的转化率,不能理解为整体销售额增长 3 倍。
多模态:Google API Token 的另一个放大器
文本问答、合同审查、整个代码仓库分析、图片和视频理解、语音转写,这些场景的 Token 消耗结构差别很大。图片数量、视频时长和文件大小,都不能直接按普通文本字数换算 Token。
Google 没有公开 320 亿 Token 在文本、图像、视频、音频之间的分配,也没有说明其中多少是输入、多少是输出、多少来自模型的内部思考过程。
为什么 Agent 会放大 Google API Token 消耗
一次普通聊天可能只有一轮输入输出。编程 Agent 完成一个任务,则可能依次经历读取文件、分析问题、修改代码、执行测试、读取报错、再次修改、再次测试。每一步都可能调用模型,而且通常要把前面积累的上下文重新带入。
所以“Agent 是重要的潜在需求来源”是有依据的机制分析,但“Agent 贡献了 320 亿 Token 中的大部分”没有公开数据支持。写作和决策时,需要把这两种说法分开。
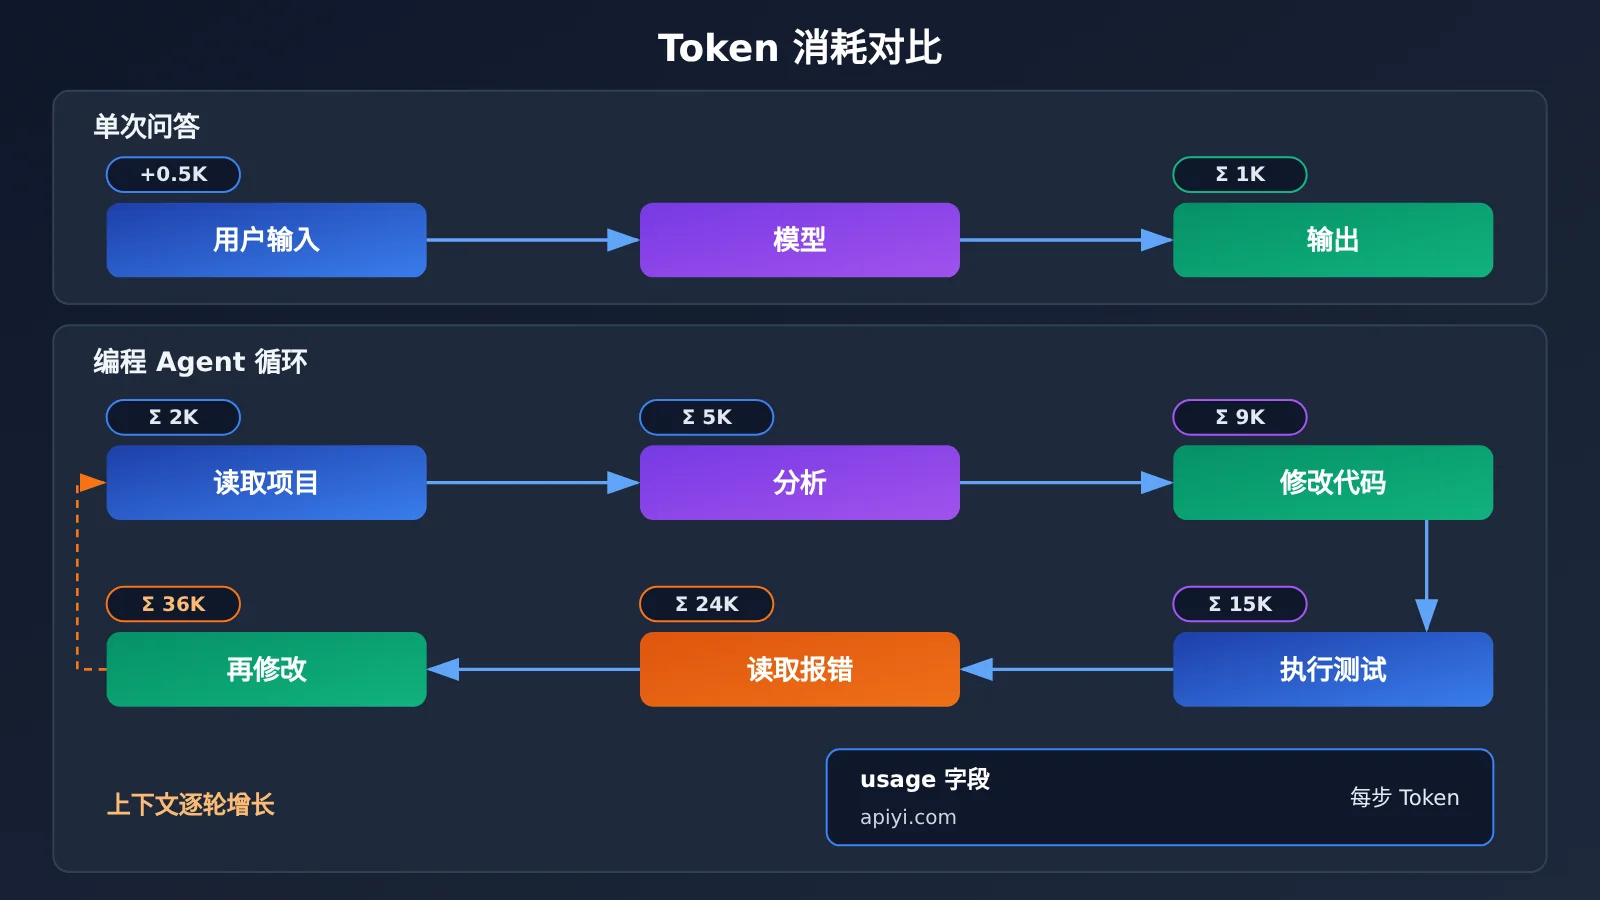
用代码观察 Agent 的 Token 累积
想直观理解这一点,最简单的方法是记录每一轮调用返回的 usage 字段。下面的例子模拟一个多轮修正流程,并打印每一步的输入、输出 Token:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

messages = [{"role": "user", "content": "写一个计算斐波那契数列的 Python 函数"}]
resp = client.chat.completions.create(model="YOUR_GEMINI_MODEL", messages=messages)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)
查看多轮 Agent 循环的 Token 统计代码
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "YOUR_GEMINI_MODEL"  # 替换为平台模型列表中的 Gemini 模型名称

steps = [
    "写一个计算斐波那契数列的 Python 函数",
    "为这个函数补充单元测试",
    "测试报错:输入负数时没有处理,请修复",
    "再检查一遍边界条件并给出最终版本",
]

messages = [{"role": "system", "content": "你是一个严谨的编程助手"}]
total_in, total_out = 0, 0

for i, step in enumerate(steps, 1):
    messages.append({"role": "user", "content": step})
    resp = client.chat.completions.create(model=MODEL, messages=messages)
    reply = resp.choices[0].message.content
    messages.append({"role": "assistant", "content": reply})

    usage = resp.usage
    total_in += usage.prompt_tokens
    total_out += usage.completion_tokens
    print(f"第 {i} 步:输入 {usage.prompt_tokens},输出 {usage.completion_tokens}")

print(f"累计输入 {total_in},累计输出 {total_out}")
运行后会发现,每一轮的输入 Token 都会因为历史上下文而增加。这就是 Agent 工作流 Token 结构比单次问答复杂得多的原因。
🚀 快速上手建议:想亲自测量不同模型在 Agent 循环中的 Token 曲线,可以在 API易 apiyi.com 注册获取免费测试额度,用同一个 API Key 切换 Gemini、Claude、GPT 等模型,对比相同任务的 Token 消耗。
Google API 320 亿 Token 的影响分析
对开发者的影响
- 成本结构从“按次”转向“按链路”:Agent 任务的成本取决于循环轮数和上下文长度,开发者需要在设计阶段就做 Token 预算,比如裁剪历史上下文、缓存不变内容
- 模型梯度选择更重要:高性能模型和经济型模型并存,复杂规划交给强模型、批量分类交给经济模型,是控制费用的常见做法
- 多模态计费需单独评估:图片、视频、音频的 Token 计算方式与文本不同,上线前应先用真实样本测量
💡 选择建议:同一任务在不同模型上的 Token 消耗和效果差异可能很大。建议通过 API易 apiyi.com 用统一接口跑一遍真实样本,再决定生产环境的模型组合。
对行业与 Google Cloud 的影响
Kurian 在电话会上特别解释:企业建设 Agent 时,除了调用模型,往往还需要计算资源、存储 Agent 记忆的服务,以及为 Agent 提供上下文的数据库。因此模型采用也可能带动云业务其他产品增长。
| 财务指标(截至 2026-09-30 的 Q3) | 数值 | 说明 |
|---|---|---|
| Alphabet 总收入 | 1275.77 亿美元,同比增长 25% | 集团整体 |
| Google Cloud 收入 | 307.09 亿美元,同比增长 103% | 含企业 AI 基础设施、AI 解决方案、核心 GCP、TPU 系统销售 |
| Google Cloud 营业利润 | 111.21 亿美元 | 季度营业利润率约 36.2% |
| Gemini API 独立收入 | 未披露 | 不能用 Cloud 收入代替 |
需要强调两点。307 亿美元是整个 Google Cloud 的收入,不是 Gemini API 收入。也不能用 320 亿 Token 乘以公开 API 价格去估算 Google 的 API 收入,因为模型分布未公开,各模型价格不同,企业客户还可能享有批处理、缓存、专属合同和折扣。
一个容易踩的时间陷阱
Alphabet Q3 的财务统计周期是 2026 年 7 月 1 日到 9 月 30 日;Gemini 4 Argon 于 2026 年 10 月 13 日正式推出;320 亿 Token/分钟 在 10 月 28 日披露。所以不能把 320 亿视为第三季度平均速率,更不能说整个 Q3 的 API 增长主要由 10 月才发布的 Argon 驱动。比较稳妥的说法是:Argon 的发布与 320 亿 Token 里程碑,共同体现了 Google 在 2026 年 10 月的模型与商业进展。
常见问题 FAQ
Q1:Google API 每分钟 320 亿 Token 是什么意思?
这是 Google 第一方模型 API 在 2026 年 10 月 28 日描述的整体处理速率,单位是 Token,不是请求次数,也不是某个单独 Gemini 模型或 Gemini App 的用量。
Q2:这 320 亿 Token 主要是谁贡献的?
可以确认的使用者包括:每月超过 900 万的开发者、超过 2600 家高用量 Gemini Enterprise 客户,以及金融、制造、零售、工业现场等行业的 Agent 部署。但 Google 没有披露各群体、行业、模型的具体占比,任何“某类用户贡献了大部分”的说法都缺乏公开数据支持。
Q3:320 亿 Token 和 Gemini 4 Argon 有关系吗?
Argon 于 2026 年 10 月 13 日发布,320 亿是 10 月 28 日的当前速率,两者都属于 Google 在 10 月的进展。但 Q3 统计周期截至 9 月 30 日,不能把整个季度的增长归因于 Argon。
Q4:开发者如何估算自己业务的 Token 消耗?
最可靠的方法是用真实样本实测,记录每次调用返回的 usage 字段。可以在 API易 apiyi.com 获取免费测试额度,用本文代码把 base_url 设为 `https://api.apiyi.com/v1`,分别测试文本、长文档和多轮 Agent 场景,再按量推算成本。
Q5:能用 320 亿 Token 推算 Google 的 API 收入吗?
不能。模型分布、实际单价、批处理与缓存折扣、企业专属合同都未公开,Google 也没有披露 Gemini API 的独立收入和利润。
Q6:这条新闻目前有哪些已知的数据局限?
主要有三点:没有客户、行业、模型的分项构成;没有文本、图像、视频、音频的分配比例;没有输入、输出与内部思考 Token 的拆分。此外企业案例效果均来自 Google 官方披露,并非第三方独立验证。
Google API 320 亿 Token 核心要点 Key Takeaways
- 核心数字:第一方模型 API 每分钟处理近 320 亿 Token,同比 4 倍以上
- 增长曲线:从约 100 亿到近 320 亿,用了大约一年时间
- 三类使用者:开发者生态、Gemini Enterprise 企业客户、行业 Agent 部署
- Agent 机制:多轮循环和上下文累积,让单个任务的 Token 消耗成倍放大
- 口径边界:Token、请求数、席位、开发者人数、Cloud 收入不能混用或相加
- 最大未知:Google 尚未披露 320 亿 Token 的客户与场景构成比例
- 实测建议:用 API易 apiyi.com 的统一接口测量自身业务的真实 Token 曲线
总结
Google API 320 亿 Token/分钟 这条新闻的核心要点:
- 规模在快速扩大:一年 4 倍以上的增长,说明模型调用正在从试用走向规模化
- 需求来源已可识别:开发者、企业客户和行业 Agent 都是真实存在的高用量群体
- 占比仍然未知:Google 没有公开分项数据,这是对数据边界的准确认识,而不是信息缺失
- 商业价值待观察:真正值得持续关注的,是这些调用中有多少能变成持续、可盈利的企业应用
对开发者来说,这条新闻最直接的启示是:Agent 和多模态会让 Token 预算变得更重要,模型选择和上下文管理需要尽早纳入架构设计。推荐通过 API易 apiyi.com 用一个 API Key 对比多个主流模型的效果和消耗,再决定适合自己的方案。
📚 参考资料
- Alphabet Q3 2026 财报(SEC):财务数据原始来源
- 链接:
sec.gov/Archives/edgar/data/1652044/000165204426000080/googexhibit991q32026.htm -
说明: 收入、Google Cloud 收入与营业利润
-
Google CEO Q3 2026 财报讲话:320 亿 Token/分钟 原始表述
- 链接:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
说明: 核心数字与官方增长口径
-
Alphabet Q3 2026 电话会实录:企业客户数据与案例
- 链接:
fool.com/earnings/call-transcripts/2026/10/29/alphabet-googl-q3-2026-earnings-call-transcript/ -
说明: Thomas Kurian 披露的 Gemini Enterprise 数据
-
Google CEO Q2 2026 财报讲话:开发者与 220 亿 Token 数据
- 链接:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q2-2026/ -
说明: 900 万月活开发者、Antigravity 周活数据
-
Google CEO Q1 2026 财报讲话:160 亿 Token 数据
- 链接:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q1-2026/ -
说明: 增长时间线节点
-
Google 2026 年 6 月投资者介绍材料:190 亿 Token 与开发者工具用量
- 链接:
blog.google/alphabet/investor-presentation-june-2026/ -
说明: 开发者工具每天超过 3 万亿 Token
-
Google Cloud:Gemini at Work 2026:企业 Agent 客户案例
- 链接:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - 说明: Hitachi 等企业部署案例
作者: APIYI 技术团队
技术交流: 欢迎在 API易官网首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心