Nota do autor: uma leitura do impacto do cache de prompt de 12 horas da OpenAI nos custos da API GPT-6, com uma fórmula de payback e 5 critérios para mostrar em quais cenários ativar o cache economiza dinheiro e em quais o ganho é limitado.
A OpenAI adicionou ao Prompt Cache a retenção de cache por 12 horas, e isso é um sinal claro de que as equipes que chamam a API GPT-6 precisam refazer as contas. Antes, o cache normalmente só valia por alguns minutos de ociosidade, então muitas requisições de baixa frequência simplesmente não conseguiam o desconto. Agora, com a janela bem mais longa, um monte de requisições que “só voltam horas depois” também têm chance de acertar o cache.
Isso não é o papo de marketing de “ativou o cache e economizou metade automaticamente”. Se o cache economiza ou não depende de o prefixo ser estável, do intervalo entre as requisições, do tamanho do prefixo em cada chamada e de existir ou não custo extra na escrita do cache. Este artigo usa uma fórmula simples de payback para ajudar você a decidir se o seu negócio realmente deve ou não ativar o cache de 12 horas.
Valor principal: entender em 5 minutos o que muda no mecanismo do Prompt Cache de 12 horas e aprender a usar 5 critérios para identificar quando o cache da API GPT-6 realmente economiza.
Visão rápida do Prompt Cache de 12 horas da OpenAI
Vamos começar com uma tabela para organizar as informações principais desta atualização. Como preços e parâmetros oficiais mudam com frequência, os percentuais de cobrança devem sempre ser confirmados na documentação e na página de preços da OpenAI.
| Item | Detalhes |
|---|---|
| Conteúdo da atualização | O Prompt Cache ganha uma opção de retenção de cache por 12 horas |
| Responsável pelo lançamento | OpenAI |
| Modelos envolvidos | GPT-6 API e outros modelos com suporte a Prompt Caching (conforme a lista oficial de modelos) |
| Lógica de cobrança | Tokens de entrada que acertam o cache são cobrados com preço unitário menor que o da entrada normal; o desconto específico deve ser consultado na página oficial de preços |
| Mudança principal | O cache passa de “expiração após alguns minutos de inatividade” para retenção de até 12 horas |
| Âmbito de impacto | Cenários como comandos de sistema longos, definições de ferramentas de agentes, conhecimento fixo em RAG e conversas multiturno |
Como o Prompt Cache funciona
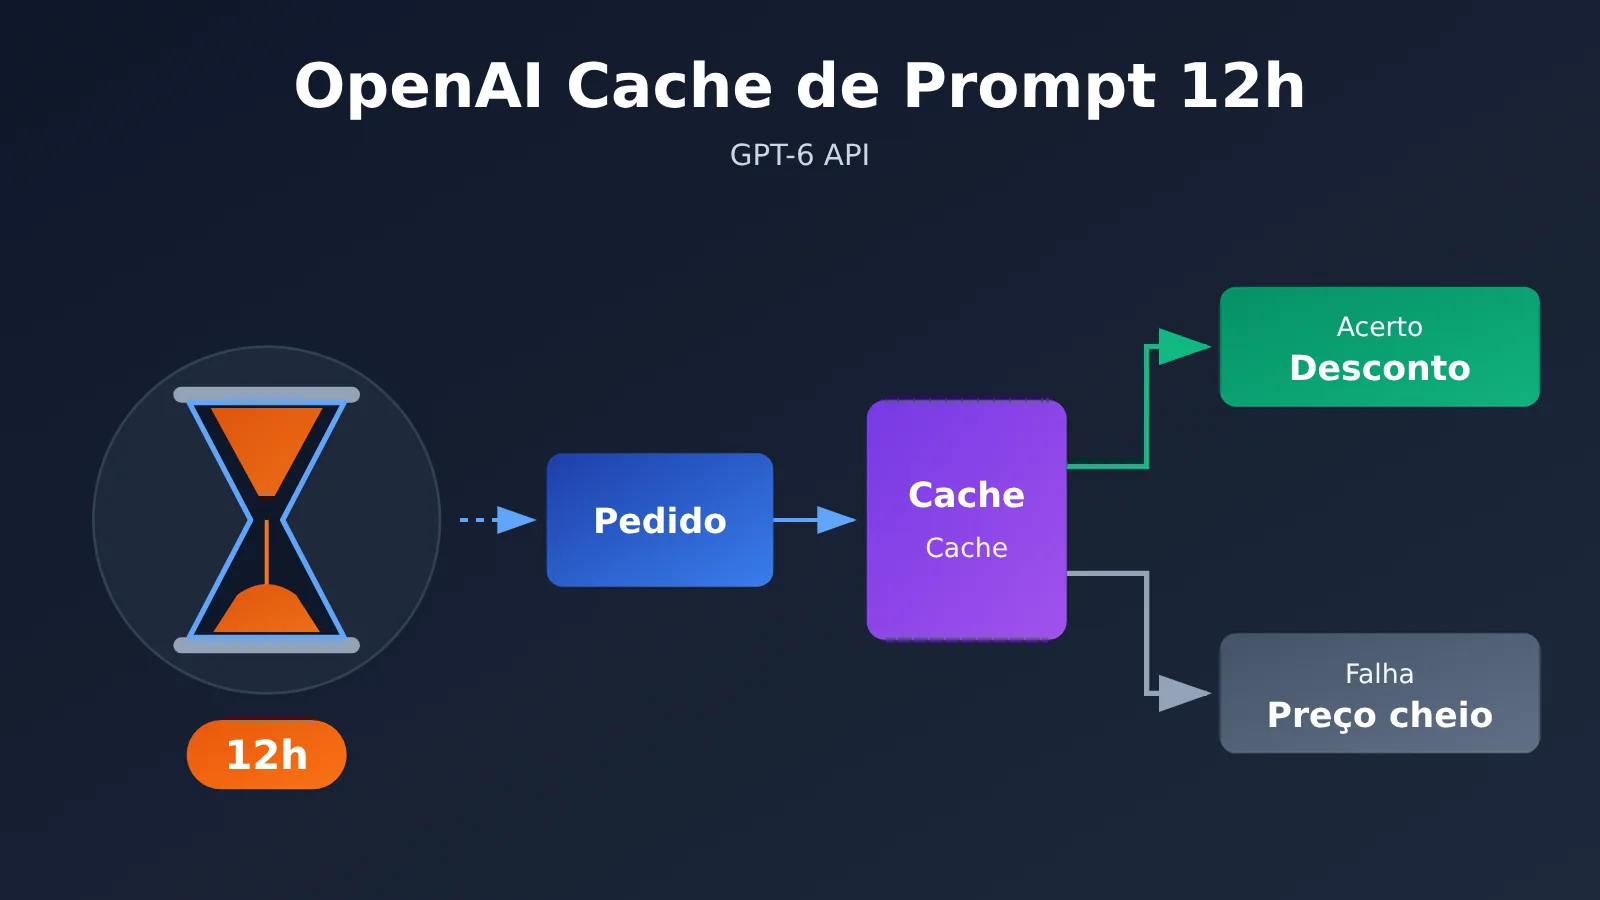
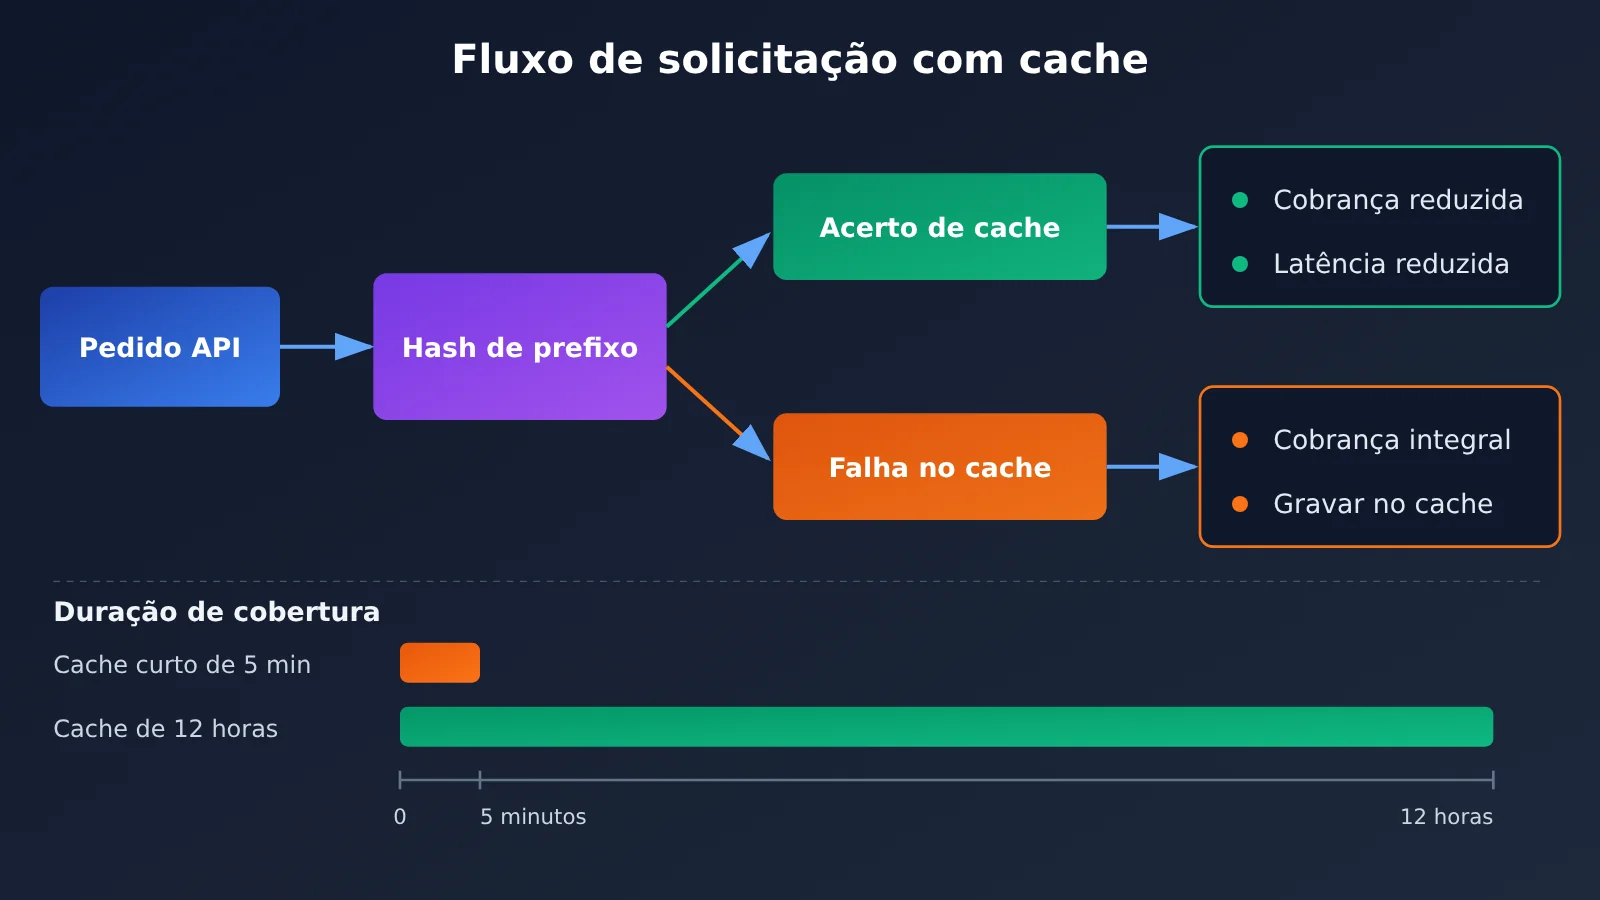
O Prompt Caching da OpenAI é um mecanismo baseado em “correspondência de prefixo”. Quando o início da requisição (comando de sistema, definições de ferramentas, documentos fixos etc.) é exatamente igual ao de alguma requisição recente e o tamanho atinge o limiar mínimo definido oficialmente, esses tokens são reconhecidos como um acerto de cache, cobrados com desconto e a latência do primeiro token também cai de forma perceptível.
É importante observar que o cache só considera a parte “contínua e idêntica desde o primeiro token”. Se houver um timestamp ou ID de usuário inserido no meio do prefixo, todo o conteúdo posterior deixa de acertar o cache. Por isso, a estrutura do comando é mais importante do que “ativar ou não o cache”: conteúdo estático vem primeiro; conteúdo dinâmico fica por último.
Diferença entre o cache de 12 horas e o cache curto
O cache curto anterior era limpo após alguns minutos de inatividade, então apenas requisições de alta frequência e contínuas conseguiam acertar o cache de forma estável. Já a retenção de 12 horas amplia a “janela de acerto” de alguns minutos para até meio dia, o que muda diretamente a estrutura de custos em cenários de baixa frequência.
| Dimensão de comparação | Cache curto padrão | Cache de 12 horas |
|---|---|---|
| Tempo de retenção | Expira após alguns minutos de inatividade | Até cerca de 12 horas |
| Frequência de requisições adequada | Requisições de alta frequência e contínuas | Requisições de média/baixa frequência e intermitentes |
| Cenários típicos beneficiados | Atendimento ao cliente em tempo real, chamadas em lote contínuas | Usuário retornando à conversa após algumas horas, tarefas agendadas ao longo do dia |
| Estabilidade da taxa de acerto | Muito afetada pela variação de tráfego | Mais favorável em períodos de baixo tráfego |
| Custo adicional | Normalmente sem sobretaxa de escrita | A existência de sobretaxa deve ser confirmada na documentação oficial |
Quando o cache da API do GPT-6 realmente economiza: a fórmula de payback
Muitos artigos só dizem “o cache economiza dinheiro”, mas não explicam quanto nem em que condições. Abaixo uso uma fórmula genérica para quantificar a questão — basta você substituir pelos parâmetros do seu próprio negócio.
Dedução da fórmula de payback do Prompt Cache
Defina as seguintes variáveis:
L: número de tokens do prefixo cacheávelP: preço unitário da entrada normald: proporção do preço de acerto de cache em relação ao preço normal (0 < d < 1)w: proporção de custo adicional na primeira gravação do cache (w = 0 quando não há taxa extra)N: número de chamadas ao mesmo prefixo dentro do período de validade do cache
Sem cache, o custo total do prefixo é N × L × P. Com cache, a primeira chamada é cobrada pelo custo de gravação e as seguintes pelo preço de acerto, resultando em um custo total de L × P × (1 + w) + (N − 1) × L × P × d.
Subtraindo um do outro, chegamos a uma condição de payback bem enxuta: N > 1 + w / (1 − d). A fórmula revela duas coisas: se a gravação não tem taxa extra (w = 0), basta o mesmo prefixo ser reutilizado uma vez dentro do período de validade para começar a economizar; se houver taxa de gravação, o número de reutilizações precisa ultrapassar um limiar para o payback acontecer — e quanto maior o desconto (menor o d), mais rápido o retorno.
Cálculo de payback em diferentes cenários
A seguir faço uma estimativa ilustrativa com “parâmetros hipotéticos”, apenas para mostrar como usar a fórmula — os números não representam os preços reais da OpenAI. Assumimos que o preço de acerto de cache é uma certa proporção do preço normal e observamos o número de chamadas necessárias para o payback com e sem taxa de gravação.
| Cenário hipotético | Taxa de gravação w | Desconto de acerto d | Chamadas necessárias para payback N | Conclusão |
|---|---|---|---|---|
| Sem taxa de gravação | 0 | Qualquer | N > 1 | Reutilizar 1 vez já economiza |
| Taxa de gravação baixa | Baixa | Desconto alto | Cerca de 2 vezes | Vale a pena na grande maioria dos cenários |
| Taxa de gravação alta | Alta | Desconto baixo | Mais de 3 vezes | Só compensa em cenários de alta reutilização |
Pelo cálculo dá para ver que o valor real do cache de 12 horas não está no “desconto em si”, mas em fazer o N crescer. Requisições que antes apareciam só a cada poucas horas têm N praticamente igual a 1 em cache curto — não dá nem para falar em economia. Ao estender para 12 horas, o mesmo prefixo é reutilizado várias vezes no mesmo dia, e aí a economia aparece de verdade.
🚀 Início rápido: para validar a fórmula de payback com tráfego real, recomendo usar a mesma chave API no APIYI apiyi.com para comparar a taxa de acerto de cache entre diferentes modelos. A plataforma usa interface compatível com OpenAI, e novos usuários ganham créditos gratuitos de teste.
Como verificar acertos de Prompt Cache na API do GPT-6
A forma mais confiável de saber se o cache está economizando dinheiro é ler o campo usage da resposta. A interface compatível com OpenAI retorna em usage.prompt_tokens_details.cached_tokens o número de tokens que acertaram o cache naquela chamada — é com esse número que você calcula a taxa real de acerto.
Exemplo minimalista
O código abaixo envia duas requisições seguidas com o mesmo prefixo. Repare se o cached_tokens da segunda é maior que 0:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada APIYI, compatível com OpenAI
)

SYSTEM_PROMPT = "Você é um consultor técnico sênior... (coloque aqui um prompt fixo e longo, acima do limite mínimo de cache)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # use o nome real da lista de modelos da plataforma
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"Pergunta {i+1}: como otimizar o custo da API?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"Requisição {i+1}, tokens que acertaram o cache: {cached}")
Ver o código completo (com estatísticas de acerto e chave de roteamento de cache)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """Conteúdo estático vai na frente, conteúdo dinâmico vai no final, para manter o prefixo estável"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key ajuda a rotear requisições com o mesmo prefixo para o mesmo cache
        # Para habilitar a retenção de 12 horas, adicione o parâmetro correspondente conforme a documentação oficial da OpenAI
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["Como criar prompts amigáveis ao cache?", "Onde devem ficar as definições de ferramentas?", "Como medir a taxa de acerto?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"Taxa de acerto geral do cache: {stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"Requisição {idx}: prompt={p}, cached={c}")
Sugestão: rode primeiro com pouco tráfego por um dia, meça a taxa de acerto geral e a distribuição dos intervalos entre requisições, e só então decida se ativa o cache de 12 horas em produção. Você consegue fazer esse tipo de validação usando créditos de teste obtidos em APIYI apiyi.com, sem precisar abrir várias contas oficiais separadas.
5 critérios para economizar com o Prompt Cache de 12 horas
Ao aplicar a fórmula de retorno na prática do seu negócio, dá para resumir a decisão em 5 critérios. Quanto mais critérios forem atendidos, mais evidente será o ganho de ativar o cache de 12 horas.
- Prefixo longo o suficiente: a parte fixa que pode ser cacheada precisa atingir o limite mínimo oficial e, quanto maior for, maior será o desconto total. Um comando curto de algumas centenas de tokens, mesmo quando acerta o cache, economiza muito pouco.
- Prefixo estável o suficiente: o comando de sistema, as definições de ferramentas e a ordem do Schema devem permanecer iguais ao longo do dia. Alterar o comando com frequência faz o cache invalidar repetidamente.
- Intervalo entre requisições dentro de 12 horas: se o mesmo prefixo é chamado a cada intervalo que vai de dezenas de minutos a algumas horas, essa é justamente a faixa de maior ganho incremental do cache de 12 horas em comparação com o cache curto.
- Número de reutilizações acima do limiar de retorno: faça a conta com
N > 1 + w / (1 − d)e confirme que o número de reutilizações dentro do dia fica consistentemente acima do limiar. - Alto peso do custo de entrada: se a maior parte da sua fatura vem dos tokens de saída, o cache otimiza apenas o lado da entrada e a redução total acaba diluída.
Adequação do cache de 12 horas a diferentes cenários de negócio
| Cenário de negócio | Característica do intervalo entre requisições | Efeito do cache curto | Valor incremental do cache de 12 horas |
|---|---|---|---|
| Chatbot de atendimento em tempo real | Alta frequência e contínuo | Já funciona bem | Moderado; serve principalmente para cobrir os períodos de baixa de tráfego |
| RAG de base de conhecimento corporativa | Frequência média, prefixo de documento fixo | Bastante variável | Significativo, com várias reutilizações do conhecimento fixo ao longo do dia |
| Sessão de agente de programação | O usuário volta à sessão de forma intermitente | Frequentemente expira | Muito alto, com reutilização de contexto longo ao longo de horas |
| Processamento em lote agendado ao longo do dia | Um lote a cada poucas horas | Praticamente ineficaz | Muito alto, com vários lotes do mesmo template por dia |
| Análise única de documento longo | Chamada apenas uma vez | Ineficaz | Quase nenhum; com N = 1 não se paga |
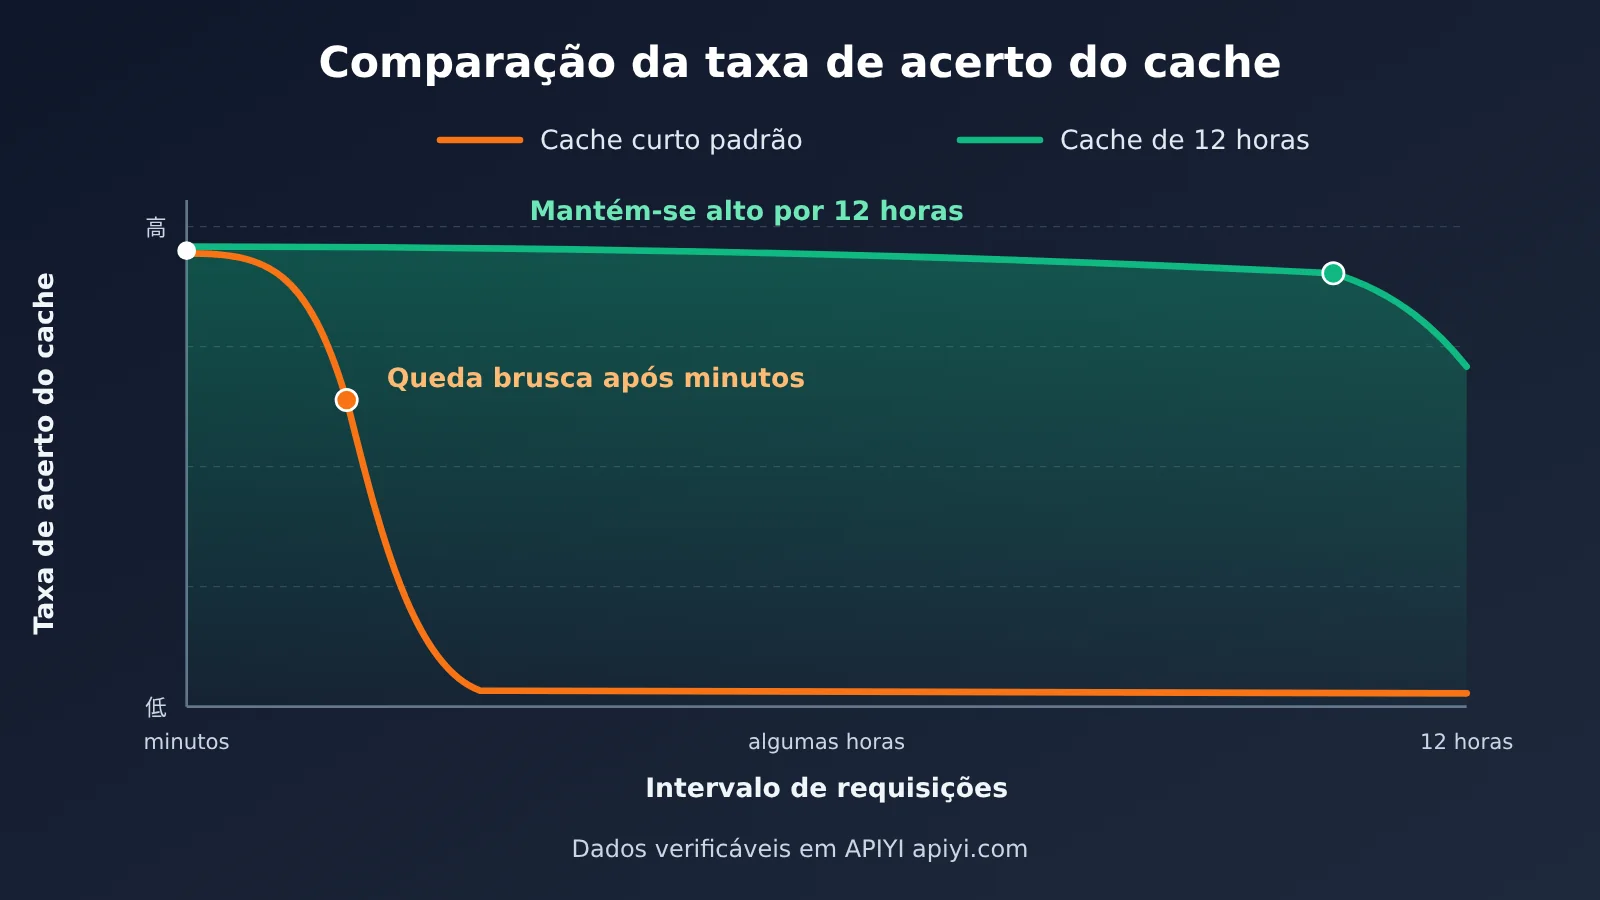
Nota de comparação: o gráfico acima mostra a diferença de tendência na taxa de acerto das duas estratégias de cache em diferentes intervalos entre requisições. A taxa real depende da estabilidade do seu prefixo e da distribuição de tráfego; vale a pena comparar usando os logs reais das suas requisições.
Análise de impacto do Prompt Cache de 12 horas da OpenAI
Impacto para os desenvolvedores
- A engenharia de prompt precisa evoluir para uma “engenharia de cache”: é necessário organizar prompts de sistema, definições de ferramentas e conhecimento fixo em blocos de prefixo estáveis, além de gerenciar as versões de forma explícita, para evitar que pequenas alterações invalidem tudo.
- A avaliação de custo muda de “preço unitário” para “preço unitário efetivo”: com a mesma GPT-6 API, equipes com alta taxa de acerto de cache e equipes com baixa taxa podem ter uma diferença considerável no custo real por mil requisições. Monitorar
cached_tokensdeve se tornar uma métrica de rotina. - Agentes com contexto longo se tornam mais viáveis: assistentes de programação e agentes de pesquisa costumam ter contextos bem longos. Antes, se o usuário saísse por um tempo e voltasse, tudo era recalculado a preço cheio; agora, com a reutilização ao longo de horas, a economia em sessões longas melhora bastante.
- A latência também melhora: requisições que acertam o cache têm menor latência para o primeiro token, o que é um ganho extra para produtos sensíveis à experiência de interação.
Impacto para o setor
- O cache virou uma dimensão de competição no preço dos modelos: os principais fornecedores oferecem suas próprias soluções de cache de prompt, e o tempo de retenção, o tamanho do desconto e a cobrança (ou não) pela escrita estão se tornando referências importantes na hora de o desenvolvedor escolher.
- A comparação multi-modelo em plataformas agregadoras ganha valor: como as regras de cache variam bastante entre fornecedores, comparar lado a lado a fatura real por meio de uma interface unificada faz mais sentido do que olhar apenas o preço de tabela oficial.
- A arquitetura RAG pode ser reavaliada: quando o prefixo de um documento longo pode ser reutilizado por meio dia a custo baixo, parte dos cenários de bases de conhecimento de pequeno e médio porte pode migrar da “recuperação por trechos” para “colocar o trecho inteiro no contexto + cache”.
Referência para escolha de soluções de cache multi-modelo
| Direção do modelo | Características do cache (conforme a documentação oficial de cada fornecedor) | Cenários indicados | Plataformas disponíveis |
|---|---|---|---|
| GPT-6 API | Cache automático de prefixo, com nova opção de retenção de 12 horas | Prompts de sistema longos, sessões de agentes | APIYI apiyi.com, OpenAI oficial |
| Série Claude | Exige marcação explícita dos pontos de cache e suporta diferentes tempos de retenção | Cenários que precisam de controle fino da posição do cache | APIYI, Anthropic oficial |
| Série Gemini | Suporta cache de contexto implícito e explícito | Documentos muito longos, contexto multimodal | APIYI, Google oficial |
💡 Sugestão de escolha: as regras de cache variam bastante entre os modelos. Vale testar o mesmo prompt de negócio em vários modelos, medindo taxa de acerto e fatura, e só então decidir considerando também a qualidade dos resultados.
Perguntas frequentes (FAQ)
Q1: O que é o Prompt Cache de 12 horas da OpenAI?
É uma opção de retenção estendida do mecanismo de Prompt Caching da OpenAI. Requisições com o mesmo prefixo podem acertar o cache por até cerca de 12 horas, e os tokens de entrada da parte que acertou são cobrados com desconto, além de reduzir a latência do primeiro token.
Q2: Qual é a diferença entre o cache de 12 horas e o cache curto padrão?
O cache curto padrão expira depois de alguns minutos de inatividade, então só serve para requisições contínuas de alta frequência; já o cache de 12 horas cobre requisições de média e baixa frequência, com intervalos. Para cenários de alta frequência, como atendimento ao cliente em tempo real, a diferença entre os dois é pequena; para cenários com intervalos de várias horas, como sessões de Agent ou processamento em lote agendado, o ganho adicional do cache de 12 horas é bem visível.
Q3: Ativar o cache de 12 horas garante economia?
Não necessariamente. Se não houver taxa extra para gravar no cache, basta reutilizar o mesmo prefixo uma vez dentro do período de validade para começar a economizar; se houver taxa extra, é preciso reutilizar mais de `1 + w / (1 − d)` vezes para empatar. Em cenários de chamada única, prefixo que muda com frequência ou prefixo muito curto, o ganho é bastante limitado.
Q4: Como aumentar a taxa de acerto do cache na API do GPT-6?
O princípio central é “estático na frente, dinâmico no final”:
– Comando de sistema, definições de ferramentas e documentos fixos vão no início das mensagens, mantendo sempre a mesma ordem
– Conteúdo dinâmico como timestamps, IDs de usuário e resultados de recuperação vai no final
– Use uma chave de roteamento de cache fixa para o mesmo tipo de requisição, aumentando a chance de cair no mesmo cache
– Concentre as revisões de comando em lançamentos únicos, evitando pequenas alterações várias vezes ao dia
Q5: Como testar rapidamente o efeito do cache de 12 horas via API?
A recomendação é testar em uma plataforma agregadora de API com suporte a múltiplos modelos:
1. Acesse APIYI apiyi.com e crie uma conta
2. Obtenha a chave API e a cota gratuita de testes
3. Use o exemplo de código deste artigo (substituindo o base_url por `https://api.apiyi.com/v1`) e leia `cached_tokens` para medir a taxa de acerto
A APIYI usa interface compatível com a OpenAI, então com uma única chave você compara o desempenho de cache do GPT, Claude e Gemini.
Q6: Quais são as limitações conhecidas do Prompt Cache?
O cache só funciona para prefixos contínuos que atinjam o limite mínimo de comprimento, e otimiza apenas o custo do lado de entrada — tokens de saída não têm desconto. O cache é um mecanismo de “melhor esforço”: em situações de alta concorrência ou mudanças no roteamento de tráfego pode haver falhas de acerto, então não convém tratar a taxa de acerto como garantia de 100%. Para os detalhes de cobrança e os modelos suportados na retenção de 12 horas, consulte a documentação oficial da OpenAI.
—
## Principais pontos do Prompt Cache de 12 horas
– **Mecanismo em essência**: baseado em correspondência exata de prefixo; os tokens de entrada que dão hit no cache são cobrados com desconto.
– **Mudança central**: o tempo de retenção passa de minutos para cerca de 12 horas, cobrindo requisições de baixa frequência.
– **Fórmula de payback**: o número de reutilizações N > 1 + w / (1 − d) é o ponto a partir do qual começa a economizar.
– **Cenários de maior benefício**: sessões longas de Agent, RAG de base de conhecimento e processamento em lote agendado ao longo do dia.
– **Cenários de benefício limitado**: chamadas únicas, prefixos curtos e comandos alterados com frequência.
– **Ponto-chave para implementação**: conteúdo estático no início e uso de cached_tokens para monitorar continuamente a taxa de acerto.
– **Como validar**: testar em pequena escala com tráfego real pela APIYI (apiyi.com) antes de ativar em larga escala.
—
## Resumo
Principais impactos do Prompt Cache de 12 horas da OpenAI no custo da API do GPT-6:
1. **A chave para economizar é o número de reutilizações**: a janela de 12 horas permite que requisições de média e baixa frequência reutilizem o mesmo prefixo várias vezes; aumentar N acima de 1 é o verdadeiro valor incremental.
2. **O custo de escrita define o limiar de payback**: sem taxa adicional de escrita, a economia é quase garantida; com taxa adicional, é preciso calcular com a fórmula de payback.
3. **A estrutura do prompt importa mais do que o interruptor**: conteúdo estático no início, gestão de versões e monitoramento da taxa de acerto são o que realmente transformam o desconto de cache na fatura.
Recomendamos começar por cenários de alto retorno, como comandos de sistema longos e sessões de Agent: rode um dia com tráfego real para ver a taxa de acerto e só então decida o escopo da adoção completa. Para comparar rapidamente o efeito de cache entre vários modelos, recomendamos a APIYI (apiyi.com); a plataforma oferece cota de teste gratuita e uma interface compatível com OpenAI unificada.
—
## 📚 Referências
1. **Guia oficial do Prompt Caching da OpenAI**: explica o mecanismo de cache, o limite mínimo e os campos de `usage`
– Link: `platform.openai.com/docs/guides/prompt-caching`
– Descrição: fonte autoritativa para entender as regras de acerto de cache e os parâmetros mais recentes de tempo de retenção
2. **Página de preços da API da OpenAI**: preço unitário de entrada comum, entrada em cache e saída de cada modelo
– Link: `openai.com/api/pricing`
– Descrição: ao aplicar a fórmula de retorno, use os preços em tempo real desta página como referência
3. **OpenAI API Reference**: descrição dos parâmetros das interfaces Chat Completions e Responses
– Link: `platform.openai.com/docs/api-reference`
– Descrição: consulte o uso específico de parâmetros relacionados a cache, como `prompt_cache_key`
—
> **Autor**: Equipe técnica da APIYI
> **Contato técnico**: fique à vontade para nos contatar pela página inicial do site da APIYI e obter mais soluções de integração de modelos e otimização de custos