
Nota do autor: respondendo a uma dúvida frequente sobre faturamento. A tabela de preços dos modelos caiu vertiginosamente nos últimos meses, mas os agentes de programação continuam pesando no bolso pelo mesmo motivo. Os valores foram verificados com base nas tabelas oficiais disponíveis em 26/10/2026 e na página de preços de modelos da APIYI. O número de 96% é uma estimativa de um autor terceiro, não um teste prático realizado por este artigo.
Entre 26/06/2026 e 29/09/2026 — cerca de quatro meses —, OpenAI e Anthropic se revezaram na redução de preços. Max Woolf documentou essa linha do tempo em 25/10/2026 no minimaxir.com/2026/10/cheap-llms, destacando uma queda de até 80% no título. No texto, ele pontua que, em agentes de código, a leitura de cache (cache read) responde por 96% a 99% do custo total de tokens, já que cada iteração relê todo o histórico da conversa a partir do cache, com uma taxa de acerto (hit rate) em torno de 90% a 100%, variando conforme o provedor de inferência. O artigo original não inclui logs de requisição auditáveis. Por isso, consideramos essa afirmação como uma estimativa de terceiros, que não substitui a análise do seu próprio consumo real.
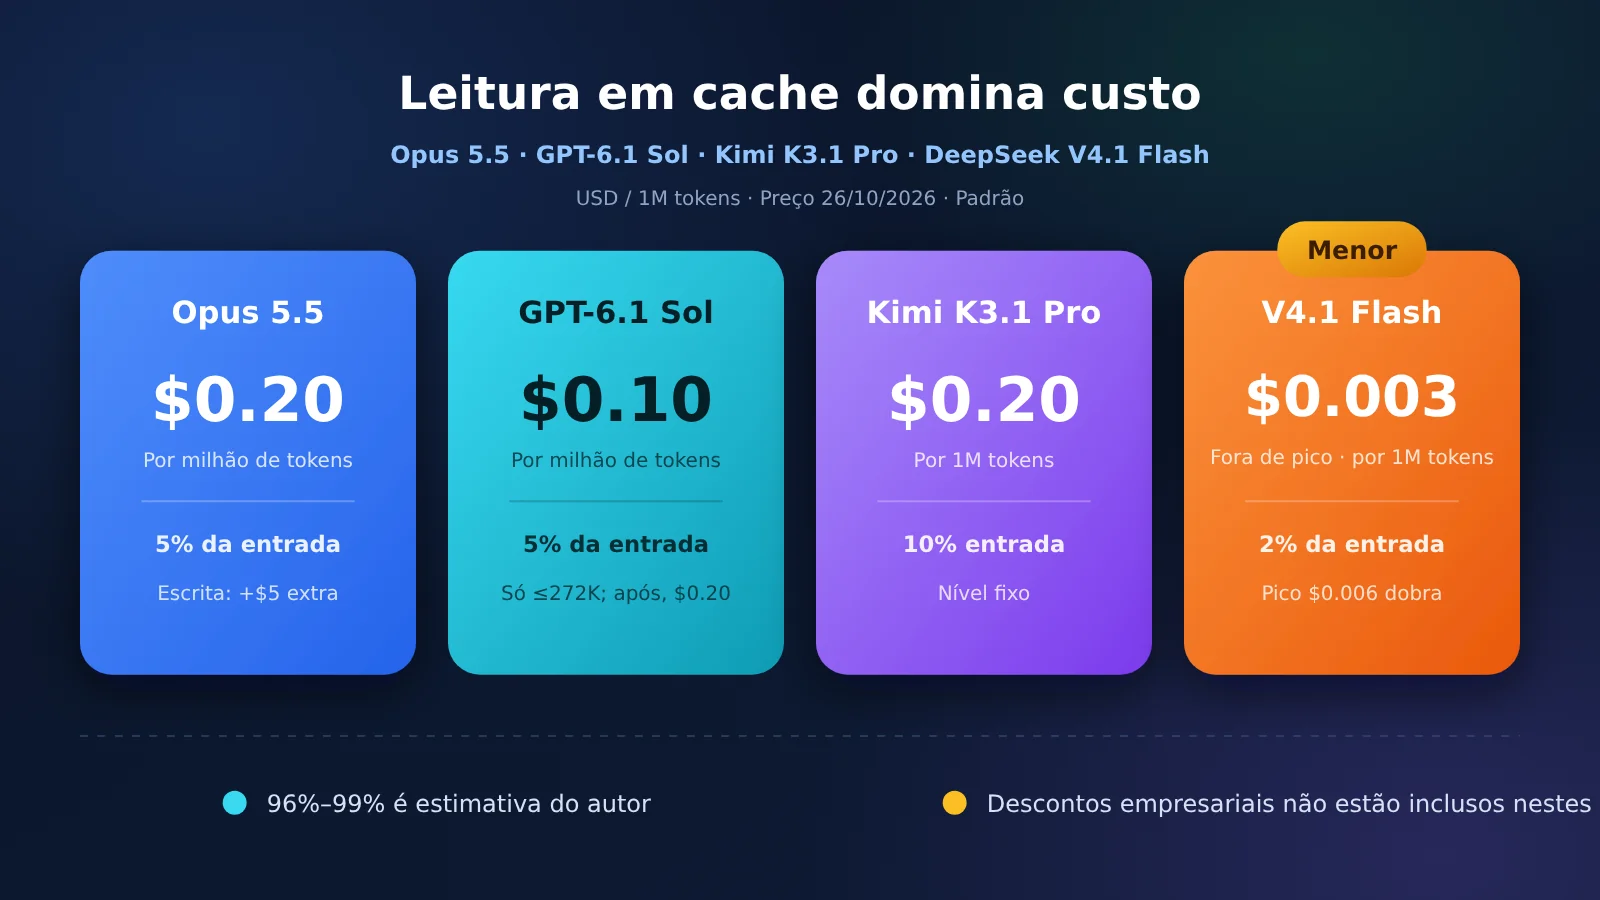
Na mesma janela, os preços públicos de leitura de cache que batem com as tabelas oficiais são: Claude Opus 5.5 a US$ 0,20; GPT-6.1 Sol a US$ 0,10 quando o input não passa de 272K; Kimi K3.1 Pro a US$ 0,20; e DeepSeek V4.1 Flash a US$ 0,003 no horário fora de pico e US$ 0,006 no horário de pico. Todos os valores em dólares por milhão de tokens.
Esta não é uma daquelas tabelas neutras onde “cada um tem suas vantagens”. Para loops de código com prefixo estável e entrada geralmente abaixo de 272K, entre os três grandes proprietários, foque primeiro na leitura de cache do GPT-6.1 Sol. Se quiser reduzir mais uma ordem de grandeza, olhe para a leitura de cache do DeepSeek fora de pico. O Opus 5.5 e o Kimi cobram o mesmo pela leitura de cache; a diferença real entre eles está no input sem cache (cache miss), no output e na taxa de gravação de cache.
Valor central: ao terminar de ler, você saberá escolher o modelo com base na taxa de acerto do cache (hit rate) em vez do preço nominal de input, e entenderá por que os descontos corporativos alardeados na mídia não batem com a fatura de times enxutos.
💡 Dica de escolha: você pode testar os quatro provedores na APIYI (apiyi.com) usando a mesma chave API, apenas trocando o nome do modelo. Contas novas têm saldo gratuito de teste. A dica de ouro é: mantenha o prefixo fixo e monitore a leitura de cache no relatório de consumo — nunca tire conclusões com base em apenas uma conversa curta.
Onde está a diferença de preço na leitura de cache entre os quatro?
Primeiro, vale olhar para o valor da leitura de cache (cache read) e, em seguida, para a proporção que ele representa em relação à entrada sem cache (cache miss). É essa proporção que determina o quão “barata” essa coluna fica em conversas longas. No Opus 5.5 e no GPT-6.1 Sol (em contexto curto), ela custa 5% do valor da entrada normal; no Kimi K3.1 Pro, são 10%; e no DeepSeek V4.1 Flash, apenas 2%. Mas a diferença em valores absolutos impressiona ainda mais: os $0.003 do Flash no horário fora de pico representam 1/33 dos $0.10 do Sol em contexto curto, e 1/67 da faixa de $0.20.
| Modelo | Leitura de cache | % da entrada sem cache | Entrada sem cache | Saída |
|---|---|---|---|---|
| Claude Opus 5.5 | $0.20 | 5% | $4 | $20 |
| GPT-6.1 Sol, entrada ≤272K | $0.10 | 5% | $2 | $10 |
| GPT-6.1 Sol, entrada >272K | $0.20 | 5% | $4 | $15 |
| Kimi K3.1 Pro | $0.20 | 10% | $2 | $10 |
| DeepSeek V4.1 Flash (fora de pico) | $0.003 | 2% | $0.15 | $0.60 |
| DeepSeek V4.1 Flash (pico) | $0.006 | 2% | $0.30 | $1.20 |
Todos os valores estão em dólares por milhão de tokens, considerando apenas a faixa padrão — sem Batch, Fast ou sobretaxas regionais. O Opus 5.5 foi retirado da tabela oficial da Anthropic, onde o acerto de cache (cache hit) custa 0,05x o preço de entrada. O GPT-6.1 Sol baseia-se no preço padrão da OpenAI; “contexto curto” refere-se a entradas de até 272K tokens — acima disso, leitura de cache, entrada e saída mudam de faixa juntas (a saída passa para $15, e não $20). O Kimi segue as informações públicas da Moonshot, sem diferenciação por tamanho de contexto. Já o DeepSeek foi extraído da página oficial de preços, registrado com o identificador deepseek-flash (versão DeepSeek-V4.1-Flash-1017). O horário de pico compreende de segunda a sexta-feira, das 01:00 às 04:00 e das 06:00 às 10:00 UTC (desconsiderando feriados nacionais chineses), o que corresponde a 09:00–12:00 e 14:00–18:00 no horário de Pequim. O intervalo intermediário entre 12:00 e 14:00 permanece como fora de pico. Finais de semana e feriados chineses operam o dia todo na tarifa fora de pico.
Na página de preços de modelos da APIYI em docs.apiyi.com/models, no catálogo de 25/10/2026, o claude-opus-5-5 está cotado a $4 / $20 / $0.20; o gpt-6.1-sol sai a $2 / $10 / $0.10, com a observação de que entradas acima de 272.000 tokens sobem para $4; e o kimi-k3.1-pro fica em $2 / $10 / $0.20. Já o DeepSeek foi dividido em duas entradas: deepseek-v4.1-flash e deepseek-flash estão a $0.30 / $1.20 / $0.006, alinhados ao horário de pico oficial; enquanto deepseek-v4-1-flash-260910 está a $0.15 / $0.60 / $0.003, correspondendo ao horário fora de pico. A cobrança oficial alterna automaticamente conforme o horário em que a requisição é recebida, mas o catálogo optou por separar os dois valores em identificadores de modelos diferentes. Antes de realizar a invocação do modelo, confirme o identificador exato diretamente no painel.
A leitura de cache é apenas metade da fatura. O custo de escrita define se você precisará pagar um valor extra caso o prefixo expire. Vale ressaltar que os períodos curto e longo da tabela a seguir não devem ser comparados minuto a minuto: na OpenAI, o período curto já cobre 30 minutos, enquanto na Anthropic e no Kimi o intervalo curto é de 5 minutos.
| Modelo | Gravação curta | Gravação longa | Como o prefixo entra no cache |
|---|---|---|---|
| Opus 5.5 | 5 minutos, $5 (1,25x a entrada) | 1 hora, $8 (2x a entrada) | A requisição precisa incluir cache_control |
| GPT-6.1 Sol, ≤272K | 30 minutos, $2,50 (1,25x a entrada) | 12 horas, $5 (2,5x a entrada) | Gravação listada separadamente na tabela de preços; o prefixo deve ser estável |
| Kimi K3.1 Pro | 5 minutos, $2 (igual ao preço de entrada) | 1 hora, $4 (estimado em 2x) | Automático por padrão (5 min); para intervalos maiores, especificar 1 hora |
| V4.1 Flash | Sem preço avulso de gravação | Nenhum | 1ª vez conta como cache miss, depois cobra como leitura de cache |
No site oficial da Kimi, o card da página inicial mostra que a gravação em cache custa $2, o que corresponde ao período padrão de 5 minutos. Já o valor de $4 para o período de 1 hora vem da tabela de preços na documentação do Kimi na APIYI — lembrando que a própria página menciona que essa faixa de cache ainda não teve a cobrança validada em testes práticos nesta rodada. Na documentação oficial da geração anterior (Kimi K3), a gravação de 1 hora custava o dobro da de 5 minutos, então, aplicando a mesma proporção no K3.1 Pro, chegamos aos $4. Se houver qualquer divergência no painel de controle, considere sempre o que estiver lá. Na versão de alta velocidade (kimi-k3.1-pro-highspeed), os preços de entrada e saída dobram, mas a leitura do cache continua em $0,20. Quando você tem muitos acertos de prefixo (cache hits), a diferença de custo entre os dois planos diminui bastante.
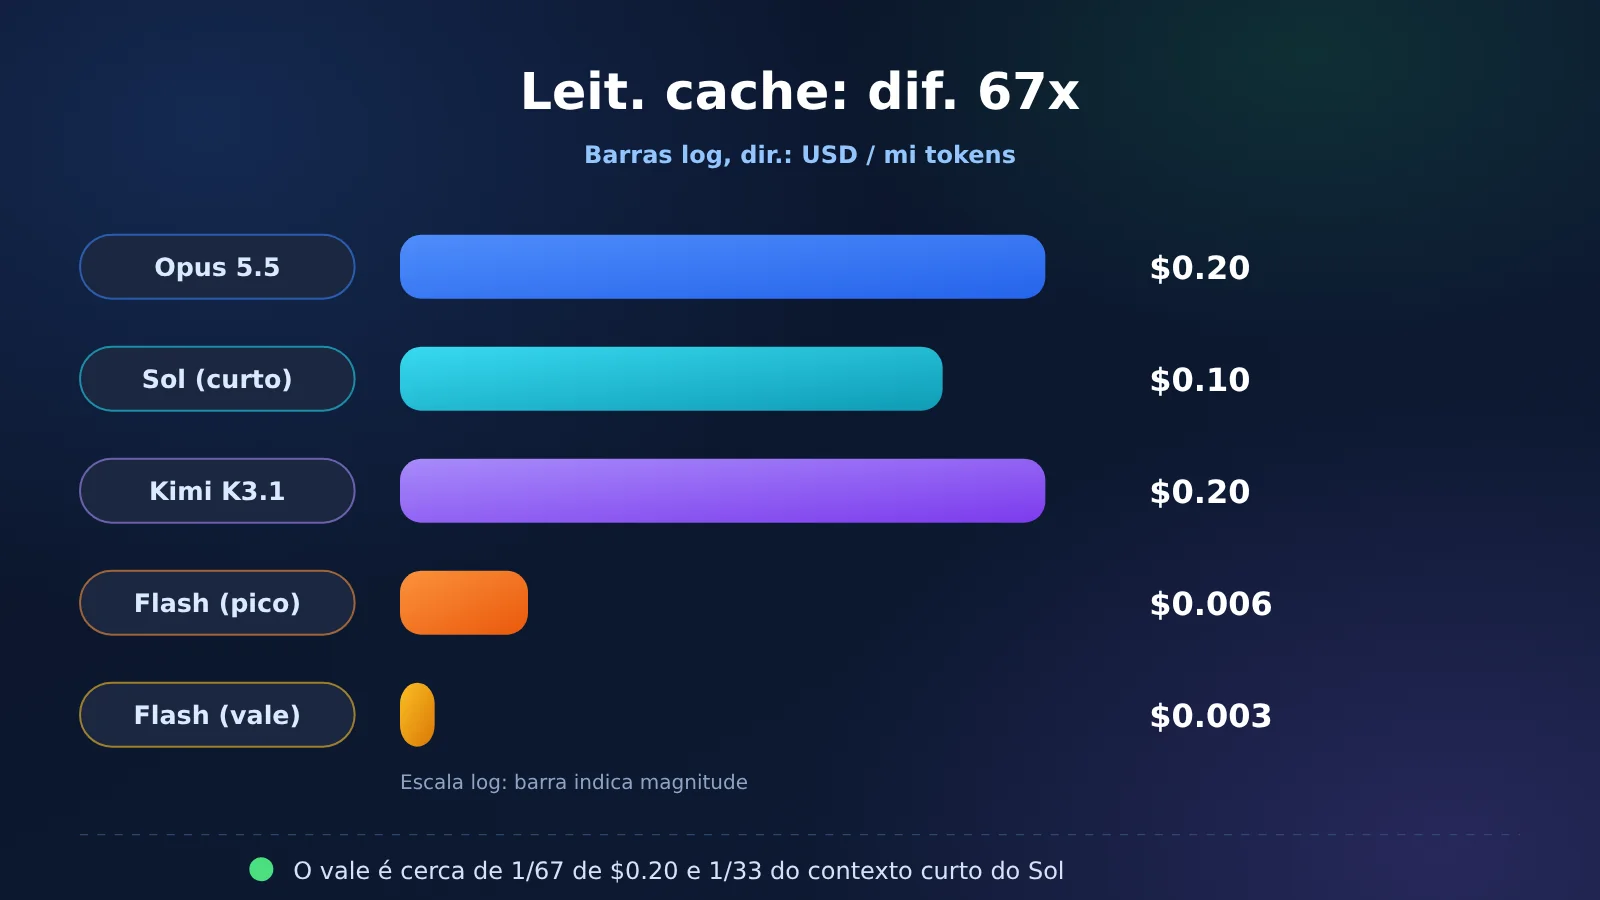
O comprimento das barras no gráfico serve apenas para visualizar a ordem de grandeza. A cobrança real continua sendo o preço original multiplicado pelo número de tokens. Se você trocar de modelo usando a mesma chave, consulte sempre a coluna de leitura de cache no painel da APIYI como referência oficial, em vez de tentar estimar os valores por este gráfico.
Por que a fatura de um Agent de código precisa separar a leitura de cache?
A cada rodada, o Agent envia novamente as instruções de sistema, as definições de ferramentas e todo o histórico da conversa. A parte do prefixo que não mudou tem a chance de ser cobrada como leitura de cache. Se o prefixo mudar, a partir do ponto da alteração tudo passa a ser contabilizado como não cacheado (cache miss), e alguns provedores ainda cobram pela gravação no cache. Por isso, uma redução de 20% no preço de entrada não significa que a conta de uma rodada de programação vai cair 20%. Se a leitura de cache representa a maior fatia dos tokens, é justamente para essa coluna que você deve olhar.
Quando Max Woolf menciona 96%–99%, ele está falando do “gasto total de tokens”. Em inglês, a palavra expenditure pode significar dinheiro ou consumo de tokens. O texto original não deixa claro qual é o denominador. Outra medição independente definiu esse critério com clareza: o WorkloadBench, atualizado em 16/10/2026, mostra que em tarefas longas de programação, de 89% a 96% dos tokens de comando vêm do cache. Tanto o GPT-6.1 Sol quanto o Claude Opus 5.5 têm uma mediana de 95%, com variações de 91%–98% e 94%–99%, respectivamente (fonte: workloadbench.brenhq.com/cache). Essa é a proporção de tokens de comando; o denominador não inclui a saída e, muito menos, representa a porcentagem em dólares. Não dá para juntar esses dois dados e concluir que são “96% da fatura”.
A proporção em dólares costuma ser bem menor, já que o preço unitário da saída chega a ser dezenas ou até centenas de vezes superior ao da leitura de cache. Vamos recalcular isso usando algumas premissas bem definidas — apenas para entender a estrutura de custos, sem representar os dados brutos do autor nem logs reais deste artigo. Suponha 40 rodadas, cada uma com 120.000 tokens de leitura de cache, 1.500 tokens novos não cacheados, 800 tokens de saída e, no início da sessão, uma gravação única de 40.000 tokens. Esses 40.000 não entram novamente na contagem de misses. Como a DeepSeek não cobra taxa de gravação, esses 40.000 são cobrados como não cacheados. Com cerca de 120 mil tokens de entrada por rodada, o volume se encaixa na faixa de contexto curto do Sol.
O total dá 4.932.000 tokens, sendo 4.800.000 de leitura de cache — cerca de 97%. Isso apenas demonstra que, sob a premissa de “prefixos longos, muitas rodadas e saídas curtas por rodada”, a quantidade de tokens realmente fica perto da faixa mencionada pelo autor.
| Modelo | Leitura de cache | Não cacheado (miss) | Saída | Gravação ou primeiro miss | Total | Leitura de cache em USD |
|---|---|---|---|---|---|---|
| Opus 5.5, gravação de 5 min | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | ~47% |
| GPT-6.1 Sol, ≤272K, gravação de 30 min | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | ~47% |
| Kimi K3.1 Pro, gravação de 5 min | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | ~65% |
| V4.1 Flash (fora de pico) | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | ~30% |
| V4.1 Flash (horário de pico) | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | ~30% |
Os quatro preços unitários de contexto curto do Opus são exatamente o dobro dos do Sol; por isso, a proporção é idêntica e o valor total fica exatamente pela metade. No Kimi, a leitura de cache custa 10% do valor de entrada (em vez de 5%). Na mesma estrutura de tokens, a leitura de cache representa cerca de 65%, totalizando US$ 1,48 — ficando no meio do caminho entre os dois. Já o Flash totaliza cerca de US$ 0,049 fora do horário de pico e dobra no pico. Como a leitura de cache custa apenas 2% do valor de cache miss, nessa simulação o maior peso em dólares volta para a saída (cerca de 40%), enquanto a leitura de cache consome por volta de 30%. Entre os três modelos de ponta, a leitura de cache ainda é a maior despesa desta fatura ilustrativa. A grande sacada do Flash é economizar na ordem de grandeza da fatura inteira, e não manter a mesma divisão de 96% do custo em dólares.
Se o prefixo mudar a cada rodada, a tabela acima perde a validade. Carimbos de data/hora (timestamps), listas de ferramentas em ordem aleatória ou o nome do usuário inserido no meio do comando de sistema destroem o cache hit. Nessas situações, o que entra em jogo é o preço de cache miss e a taxa de escrita. A escrita de 5 minutos do Opus custa 1,25x a taxa de entrada; a de 30 minutos do Sol também sai por 1,25x, subindo para 2,5x na janela de 12 horas. No Kimi, a escrita de 5 minutos custa o mesmo preço de entrada convencional, sem ágio para janelas curtas. Já no DeepSeek, a primeira chamada é cobrada direto como preço de não correspondência (cache miss).
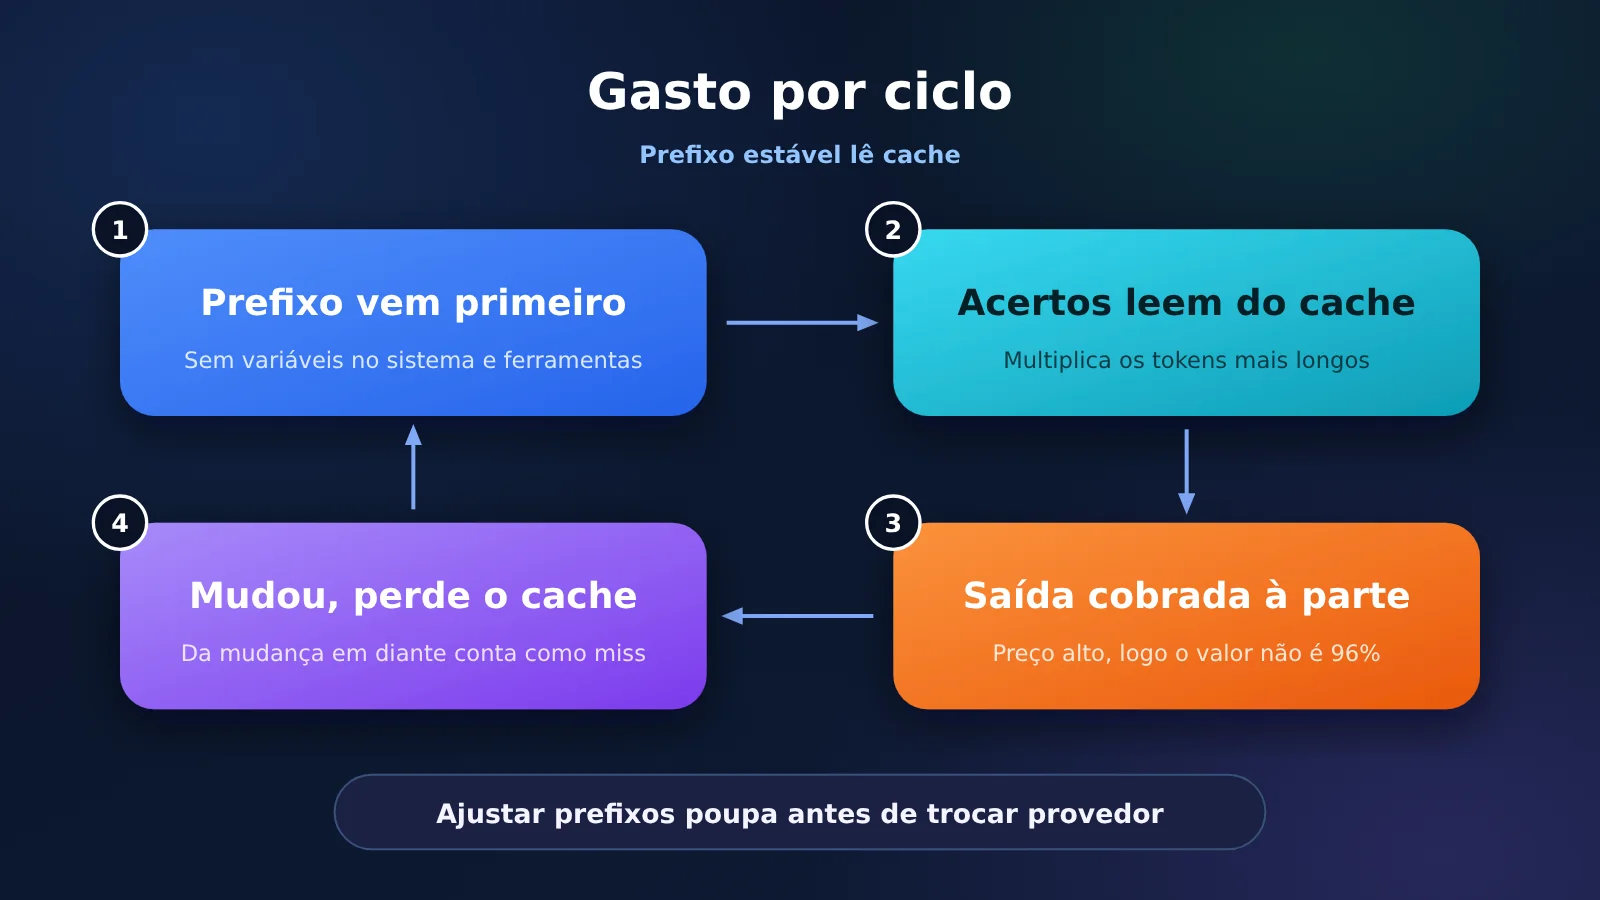
Ajustar o prefixo costuma reduzir custos muito mais rápido do que simplesmente trocar de provedor. Mantenha a lista de ferramentas com uma ordenação fixa, jogue os conteúdos dinâmicos para o fim da mensagem e cuide para que o intervalo da mesma sessão não estoure o TTL da faixa mais curta. Depois de implementar essas boas práticas, aí sim faz sentido comparar o preço unitário de leitura do cache para bater o martelo.
O que essa linha do tempo de quatro meses de reduções de preço revela?
A afirmação de uma “queda de até 80%” se aplica a dois casos específicos — mas não vá pensar que todos os modelos tiveram 80% de desconto de forma generalizada. O primeiro caso foi registrado por Max Woolf: em 30/07/2026, a OpenAI reduziu o GPT-5.6 Luna de $1 / $6 / $0.10 para $0.20 / $1.20 / $0.02, o que representou uma queda de cerca de 80% tanto na entrada quanto na leitura de cache. O segundo caso ocorreu na leitura de cache da linha Sol, caindo de $0.50 no GPT-5.6 Sol (em 26/06/2026) para $0.10 no GPT-6.1 Sol (em 29/09/2026) — também 80% a menos. Vale notar que a versão mudou da 5.6 para a 6.1; ou seja, não foi uma simples etiqueta de liquidação colada no mesmo SKU.
| Data | Mudança registrada | Entrada / Saída / Leitura de cache |
|---|---|---|
| 26/06/2026 | OpenAI lança GPT-5.6 Sol e Luna | Sol $5 / $30 / $0.50 |
| 30/06/2026 | Anthropic lança Sonnet 5, afirmando que o preço de estreia era temporário | $2 / $10 / $0.20 |
| 24/07/2026 | Anthropic lança Opus 5 | $5 / $25 / $0.50 |
| 30/07/2026 | Redução de preço do GPT-5.6 Luna | $0.20 / $1.20 / $0.02 |
| 21/08/2026 | GPT-5.6 Sol tem redução temporária de cerca de 20%, válida por três meses | $4 / $20 / $0.40 |
| 01/09/2026 | Fable 5.1, com leitura de cache mais barata que a do Fable 5 de junho | $10 / $50 / $0.25 |
| 22/09/2026 | Lançamento conjunto do GPT-6 Sol e do Opus 5.5 no mesmo dia | Sol $2 / $10 / $0.20; Opus 5.5 $4 / $20 / $0.20 |
| 29/09/2026 | GPT-6.1 Sol, leitura de cache cai pela metade novamente | $2 / $10 / $0.10 |
A tabela acima é uma compilação de Max Woolf, e a ordem das três colunas é: entrada, saída e leitura de cache. O que checamos diretamente neste artigo são os preços atuais das duas últimas linhas: os $4 / $20 / $0.20 do Opus 5.5 batem com a tabela oficial da Anthropic; e os $2 / $10 / $0.10 do GPT-6.1 Sol estão alinhados com o plano padrão e janela de contexto curta da OpenAI. As linhas anteriores não tiveram cada comunicado verificado individualmente, então, se precisar citar, consulte o post original dele.
Ele também mencionou que o Opus 5.5 teve uma redução de 40% a 60% no custo total. O que conseguimos confirmar na tabela oficial são os três preços unitários: em comparação com o Opus 5, entrada e saída caíram 20% cada (de $5 para $4 e de $25 para $20), enquanto a leitura de cache caiu de $0.50 para $0.20 — uma queda de 60%. Esse intervalo de 40% a 60% é uma estimativa dele baseada em padrões médios de uso, e não um desconto fixo oficial. Segundo a própria Anthropic, o Opus 5.5 exige menos computação de inferência do que o Opus 5, e a precificação reflete isso. Mas, claro, essa é a justificativa oficial da empresa.
Ele observou ainda que o DeepSeek V4.1 Flash na API proprietária da DeepSeek sai por cerca de $0.15 / $0.60 / $0.003. Esses números batem com os valores oficiais fora de horário de pico; nos horários de pico, o preço dobra. Para o Kimi K3.1 Pro, ele listou $2 / $10 / $0.20, o que confere com o site oficial. Já as pontuações do Artificial Analysis citadas no texto — Kimi com 55, Opus 5.5 com 58 e Flash com 45 — vêm de um benchmark de terceiros, e não dos nossos testes de código. Na hora de escolher o modelo ideal para o seu projeto, não tome decisões se baseando apenas nessa diferença de três pontos.
Como escolher modelos quando sua equipe não tem acesso a descontos corporativos?
Além dos preços públicos de tabela, existe uma camada de descontos que só os grandes clientes conseguem ver. O AI Weekly relatou em 24/10/2026, citando o The Information, que a OpenAI ofereceu mais de 30% de desconto para fechar um contrato anual superior a US$ 100 milhões, fazendo com que a Replit migrasse a maior parte dos seus gastos com IA da Anthropic para a OpenAI. A reportagem afirma que a Anthropic não manteve o desconto concedido anteriormente à Replit. Não houve confirmação pública conjunta de nenhuma das três empresas. Amjad Masad, CEO da Replit, declarou no TechCrunch Disrupt que a decisão foi baseada em custo, parceria e desempenho. A mesma matéria aponta que os modelos Claude continuam disponíveis, mas a OpenAI virou a opção padrão para Agents. O texto também menciona que o consumo de geração de código da Rippling migrou da Anthropic para a OpenAI, com a empresa atribuindo a mudança aos custos. Tudo isso são informações de bastidores da imprensa, não tabelas oficiais de preços.
Pequenas equipes não têm acesso a esse tipo de contrato. Sem um compromisso anual de US$ 100 milhões, você não vai conseguir os 30% mencionados na reportagem. Mesmo que você aplique mecanicamente esses 30% sobre a leitura de cache do Opus — caindo de US$ 0,20 para US$ 0,14 —, o valor ainda fica acima do preço público de US$ 0,10 para contexto curto do GPT-6.1 Sol. A notícia não detalha se o desconto foi aplicado na leitura de cache, nos cache misses ou no valor total, mas essa comparação serve para ilustrar a ordem de grandeza: os preços públicos de leitura de cache já são suficientes para uma equipe enxuta fazer a primeira triagem.
| Perfil da sessão / requisição | Para onde olhar primeiro | Motivo |
|---|---|---|
| Prefixo estável, entrada geralmente abaixo de 272K, precisa de modelo proprietário para código | GPT-6.1 Sol | Leitura de cache a US$ 0,10, a menor entre as três opções |
| Entrada única passa de 272K | Não assuma US$ 0,10 | Leitura de cache do Sol sobe para US$ 0,20 e a saída vai para US$ 15 |
| Mesmo orçamento de leitura de cache do Opus, mas quer custo menor de miss e saída | Kimi K3.1 Pro | Leitura de cache nos mesmos US$ 0,20, mas entrada/saída ficam em US$ 2 / US$ 10, sem faixas de preço |
| Alta taxa de acerto de cache, tarefas fora do horário de pico | DeepSeek V4.1 Flash (fora de pico) | Leitura de cache a US$ 0,003, diferença de uma ordem de grandeza na fatura |
| Precisa rodar obrigatoriamente em dias úteis no horário comercial de Pequim (9h–12h, 14h–18h) | Recalcular o Flash no pico | Leitura de cache vai para US$ 0,006 e os demais valores unitários também dobram |
| O prefixo muda a cada rodada | Ajuste o prefixo primeiro | O desconto de leitura de cache não vai adiantar nada |
A capacidade técnica dos modelos não está ranqueada nessa tabela. Max Woolf considera o Opus 5.5 superior ao Fable 5.1 (que é mais caro), mas essa é uma percepção empírica de uso dele. A DeepSeek declarou oficialmente que o deepseek-flash agora é atendido pelo DeepSeek-V4.1-Flash-1017; o nome antigo deepseek-v4-flash continua funcionando e sendo tarifado como Flash, enquanto o deepseek-v4-pro continua sendo vendido separadamente. A empresa não divulgou um comparativo oficial de capacidade entre o Flash e o Pro. A regra de ouro é simples: se o custo de uma falha for maior que a diferença de preço por token, vá com o modelo mais caro. Se o custo da falha for insignificante perto da economia, use o Flash para rodar todo o fluxo.
💰 Otimização de custos: Os preços de catálogo são apenas os valores de tabela padrão. No painel da APIYI (apiyi.com), você vê os preços com desconto direto de acordo com o seu grupo, além de promoções de recarga aplicadas à parte, tudo detalhado na página de preços. São regras públicas e acessíveis a todos, não contratos corporativos anuais negociados com equipe de vendas. A cobrança real segue o que é exibido no painel.
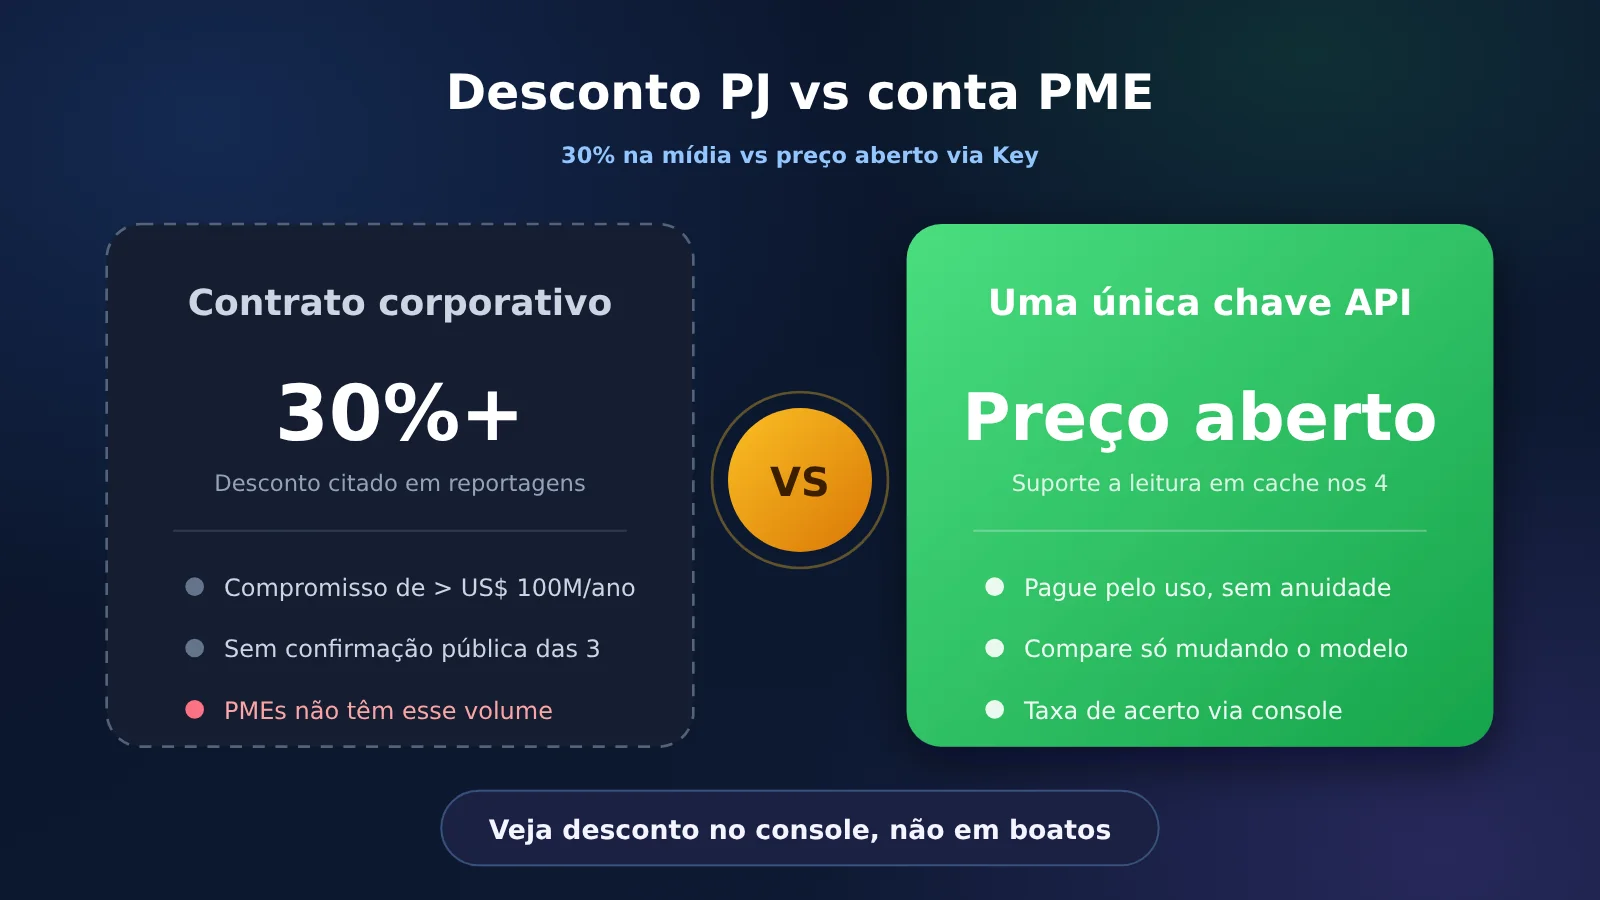
Os 30% de desconto e o contrato de US$ 100 milhões da metade esquerda vêm de reportagens da imprensa — não dá para bater na porta do provedor e exigir esse valor. A metade direita é o caminho real e acionável para pequenas equipes.
Como verificar a leitura de cache de quatro provedores com uma única chave API?
A página de preços recomenda que, para o GPT-5 e modelos posteriores, seja priorizado o endpoint /v1/responses, onde o cache em múltiplas rodadas tem maior taxa de acerto (cache hit). O Chat Completions ainda pode ser usado. O exemplo a seguir utiliza o Chat Completions para que você possa alternar entre gpt-6.1-sol, kimi-k3.1-pro e deepseek-flash apenas trocando o nome do modelo. O cache do Opus 5.5 não é o comportamento padrão nessa rota. Atualmente, a Anthropic exige a inclusão de um cache_control no nível superior da requisição ou a definição de pontos de interrupção (breakpoints) nos blocos de conteúdo. A APIYI oferece tanto o endpoint chat quanto o messages para o claude-opus-5-5. Para aproveitar a cobrança com desconto de cache, use o endpoint messages e inclua o cache_control. Se usar apenas o Chat Completions, não presuma que a tarifa de $0.20 da tabela já esteja valendo.
- Instale as dependências básicas: Se ainda não instalou a SDK, execute
pip install openai. No início do seu arquivo, adicioneimport osefrom openai import OpenAI. Guarde a chave API na variável de ambienteAPIYI_API_KEY— nunca faça commit dela no seu repositório. - Crie o cliente: Basta uma linha:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). A URL base só precisa ser configurada aqui. - Fixe o prefixo: O
STABLE_PREFIXrecebe o comando de sistema (system prompt) e as definições de ferramentas, sem alterar uma única palavra; já ouser_turnguarda o conteúdo dinâmico da rodada atual, ficando sempre na última posição. - Envie a requisição:
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}]). Para testar os outros dois provedores, basta trocar omodelporkimi-k3.1-prooudeepseek-flash. - Consulte o consumo: Primeiro pegue
details = resp.usage.prompt_tokens_details, depois façacached = getattr(details, "cached_tokens", 0) or 0e, por fim, executeprint(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens). Os três números correspondem, respectivamente, aos tokens de comando, tokens que atingiram o cache e tokens de saída.
Execute várias rodadas consecutivas e divida os tokens em cache pelo total de tokens de comando para obter a sua taxa de acerto de cache. Depois, multiplique o volume em cache pelo preço unitário de leitura em cache de cada provedor para saber o custo real em dólares daquela coluna. A documentação da Kimi especifica que seu nível de cache é um preço configurado, prevalecendo a cobrança indicada no painel de controle. No caso do DeepSeek, se quiser aproveitar a faixa de horário de menor demanda (off-peak), consulte o nome do modelo no catálogo como deepseek-v4-1-flash-260910 — não presuma que o deepseek-flash ajustará os preços automaticamente com base no relógio.
Mantenha a chave API na variável de ambiente APIYI_API_KEY e não a suba para o repositório. O saldo de testes gratuitos é ideal para rodar algumas rodadas com o mesmo prefixo nos quatro modelos e apenas comparar a estrutura de consumo de tokens. Se precisar avaliar melhor, aumente as rodadas aos poucos, em vez de sobrecarregar logo de cara os quatro provedores com um histórico enorme de contexto.
Perguntas frequentes sobre a comparação de leitura de cache
P1: Esses 96% significam que a leitura de cache representa 96% do valor da fatura?
Essa não é a conclusão deste artigo. Max Woolf escreveu que a leitura de cache representa entre 96% e 99% do total de tokens gastos, sem divulgar o denominador — tratando-se de uma estimativa de terceiros. O WorkloadBench mediu entre 89% e 96% dos tokens de comando, sem incluir a saída. Pelas simulações hipotéticas deste artigo, os tokens representam cerca de 97%, enquanto em dólares o impacto fica em torno de 47% no Opus e no Sol, cerca de 65% no Kimi e cerca de 30% no Flash.
P2: Por que a leitura de cache do Sol às vezes custa $0.10 e outras vezes $0.20?
Depende do tamanho da entrada em cada requisição. Quando não passa de 272K tokens, o valor padrão da leitura de cache na OpenAI é de $0.10. Ultrapassando esse limite, vai para $0.20; além disso, a entrada sem cache sobe para $4 e a saída para $15. No catálogo da APIYI, constam os valores de contexto curto ($2 / $10 / $0.10), com a observação de que acima de 272.000 tokens a entrada passa a custar $4. Os valores de saída e leitura de cache para contextos longos seguem o padrão oficial da OpenAI e, se o painel exibir faixas de preços separadas, considere o que estiver no console.
P3: Por que o DeepSeek tem duas tabelas de preços para leitura de cache?
A precificação oficial adota horários de pico e fora de pico, sendo que fora de pico custa a metade do horário de pico. A leitura de cache fora de pico custa $0.003, e no pico, $0.006. O horário de pico é em dias úteis, das 09:00 às 12:00 e das 14:00 às 18:00 (horário de Pequim, já convertido da janela UTC oficial), excluindo feriados nacionais na China. Fins de semana e feriados são considerados fora de pico o dia todo. O catálogo da APIYI lista esses dois conjuntos de valores em linhas de modelo separadas.
P4: Equipes pequenas conseguem o desconto de 30% para clientes corporativos?
Os descontos mencionados nas reportagens estão atrelados a contratos anuais superiores a US$ 100 milhões — e nem sequer houve confirmação pública por parte das três empresas. Times menores simplesmente não têm esse volume de compromisso. Comparar os preços públicos de leitura de cache já é suficiente para fazer uma primeira triagem. Para preços com desconto por grupo e promoções de recarga, consulte o console da APIYI; não confunda essas condições com aquele desconto corporativo.
P5: Como integrar os quatro provedores usando apenas uma chave API?
Basta criar uma chave na APIYI (apiyi.com) e usar `https://api.apiyi.com/v1` como URL base das requisições. Modelos como `gpt-6.1-sol`, `kimi-k3.1-pro` e `deepseek-flash` podem ser chamados via Chat Completions, apenas trocando o nome do modelo. Para aproveitar o preço de cache no `claude-opus-5-5`, use o endpoint `messages` incluindo o parâmetro `cache_control`. A partir do GPT-5, caso queira uma taxa de acerto mais alta em conversas de múltiplos turnos, a página de preços recomenda migrar para `/v1/responses`.
P6: Se a leitura de cache é tão barata, vale a pena mudar o modelo padrão direto para o Flash?
Só se o custo de falha for menor que a diferença de preço. Na simulação, a fatura fora de pico gira em torno de um vigésimo do Sol (US$ 0,0486 contra US$ 1,02) e, no pico, cerca de um décimo. Contudo, se o Flash precisar de várias rodadas extras para resolver a mesma tarefa, esse número de turnos vai engolir a economia. O ideal é testar com créditos gratuitos usando o mesmo prefixo, comparar quantas rodadas cada um leva para concluir a tarefa e só então bater o martelo sobre o modelo padrão.
P7: O custo de escrita no cache é mais caro que a leitura?
Isso acontece quando os prefixos expiram com frequência e a taxa de acerto (cache hit) é muito baixa. A escrita na faixa curta do Opus e do Sol custa 1,25x o valor de entrada, enquanto a faixa de 12 horas do Sol sai por 2,5x. Já a escrita de 5 minutos do Kimi tem o mesmo custo do preço de entrada. Só depois de duas ou três rodadas de acerto é que a leitura de cache se torna o item principal de custo. Para tarefas com intervalos irregulares, acerte o TTL primeiro antes de comparar a leitura de cache.
Principais pontos na comparação de leitura de cache
- Os 96% são uma estimativa de terceiros: Max Woolf não abriu os logs publicamente. A fatia real em dólares precisa ser calculada multiplicando pelo preço unitário.
- Olhe primeiro a leitura de cache e depois veja se muda de faixa: No Sol, acima de 272K, a leitura de cache pula de $0,10 para $0,20.
- A leitura de cache do Opus e do Kimi custa os mesmos $0,20: O Kimi tem custos menores em caso de cache miss e na saída (output), além de não cobrar sobretaxa na escrita de faixa curta.
- A vantagem do Flash está na ordem de grandeza: $0,003 fora de pico e $0,006 no pico; o custo em dólares deixa de ser dominado apenas pela leitura de cache.
- Os 30% corporativos não se aplicam a equipes pequenas: esse número divulgado na mídia refere-se a contratos anuais de grande porte. A tabela de preços pública já é suficiente para fazer o primeiro filtro.
- Uma única chave API para conectar as quatro: basta alterar o nome do modelo na APIYI apiyi.com, e a taxa de acerto deve ser acompanhada pelo consumo no painel de controle.
Resumo
Nesses quatro meses, as reduções públicas de preço chegaram a até 80%, concentradas principalmente na tabela do Luna e na leitura de cache da linha Sol, que caiu de $0,50 para $0,10. Para agents de geração de código, ainda é fundamental contabilizar a leitura de cache separadamente. Com base nos preços oficiais de 26/10/2026, em contextos curtos, a leitura de cache do GPT-6.1 Sol sai por $0,10, enquanto o Opus 5.5 e o Kimi K3.1 Pro ficam em $0,20, e o DeepSeek V4.1 Flash custa $0,003 fora de pico e $0,006 no horário de pico. A faixa de 96% a 99% é citada apenas como referência à estimativa de Max Woolf. Em faturas simuladas, o volume de tokens pode até se aproximar dessa faixa, mas em dólares a economia real fica um pouco abaixo.
Os descontos corporativos divulgados na mídia exigem compromissos anuais que equipes menores não conseguem assumir. Integrar os quatro provedores em uma única chave API e multiplicar a sua própria taxa de acerto pelos preços públicos de leitura de cache é uma estratégia muito mais direta do que ficar esperando um contrato com 30% de desconto. O recomendado é rodar o mesmo prefixo estável no APIYI apiyi.com antes de bater o martelo sobre qual será o seu modelo padrão.
Autor: Equipe Técnica da APIYI
Troca de ideias técnica: Fique à vontade para entrar em contato pela página inicial da APIYI. Os preços unitários dos modelos seguem a tabela oficial na página de preços da central de documentação em docs.apiyi.com.
Referências
- Max Woolf: Cronograma de cortes de preços e estimativas de 96%–99%
- Link:
minimaxir.com/2026/10/cheap-llms -
Nota: 25/10/2026. A faixa de 96%–99% é uma estimativa do próprio autor, não uma medição feita neste artigo.
-
Preços dos modelos da Anthropic
- Link:
platform.claude.com/docs/en/about-claude/pricing -
Nota: Preços de entrada, saída, leitura de cache e os dois níveis de escrita para o Opus 5.5.
-
Preços dos modelos da OpenAI
- Link:
developers.openai.com/api/docs/pricing -
Nota: Preços de contexto curto, contexto longo, leitura de cache e escrita para o GPT-6.1 Sol. O limite oficial que separa contexto curto de longo é de 272K.
-
Preços dos modelos da DeepSeek
- Link:
api-docs.deepseek.com/quick_start/pricing -
Nota: Preços de acerto de cache (pico e fora de pico), falha de cache e saída para o
deepseek-flash. -
API do Kimi
- Link:
platform.kimi.ai -
Nota: Preços de entrada, saída, acerto de cache e escrita padrão para o Kimi K3.1 Pro.
-
Cobertura da AI Weekly sobre o contrato da Replit
- Link:
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
Nota: O desconto superior a 30% e o gasto anual de mais de US$ 100 milhões foram reportados pelo The Information; os termos não foram confirmados publicamente pelas três empresas.
-
Proporção de tokens em cache da WorkloadBench
- Link:
workloadbench.brenhq.com/cache - Nota: 16/10/2026. Proporção de tokens de comando provenientes do cache, e não a porcentagem em dólares.


