Nota do autor: a OpenAI lançou em 5 de novembro de 2026 o GPT-6 Cyber, um modelo especializado em segurança cibernética. Neste artigo, analisamos seus resultados em benchmarks, dados de alinhamento, resultados práticos, preços e requisitos de acesso. Também mostramos o que equipes de segurança, desenvolvedores e usuários comuns da API podem fazer agora.
Em 5 de novembro de 2026, a OpenAI lançou o GPT-6 Cyber. Trata-se de um modelo especializado em segurança cibernética, desenvolvido para “encontrar e validar vulnerabilidades exploráveis, respeitando os limites definidos pelos pesquisadores”. Não é um modelo de chat para uso geral, mas uma versão voltada à pesquisa de segurança autorizada.
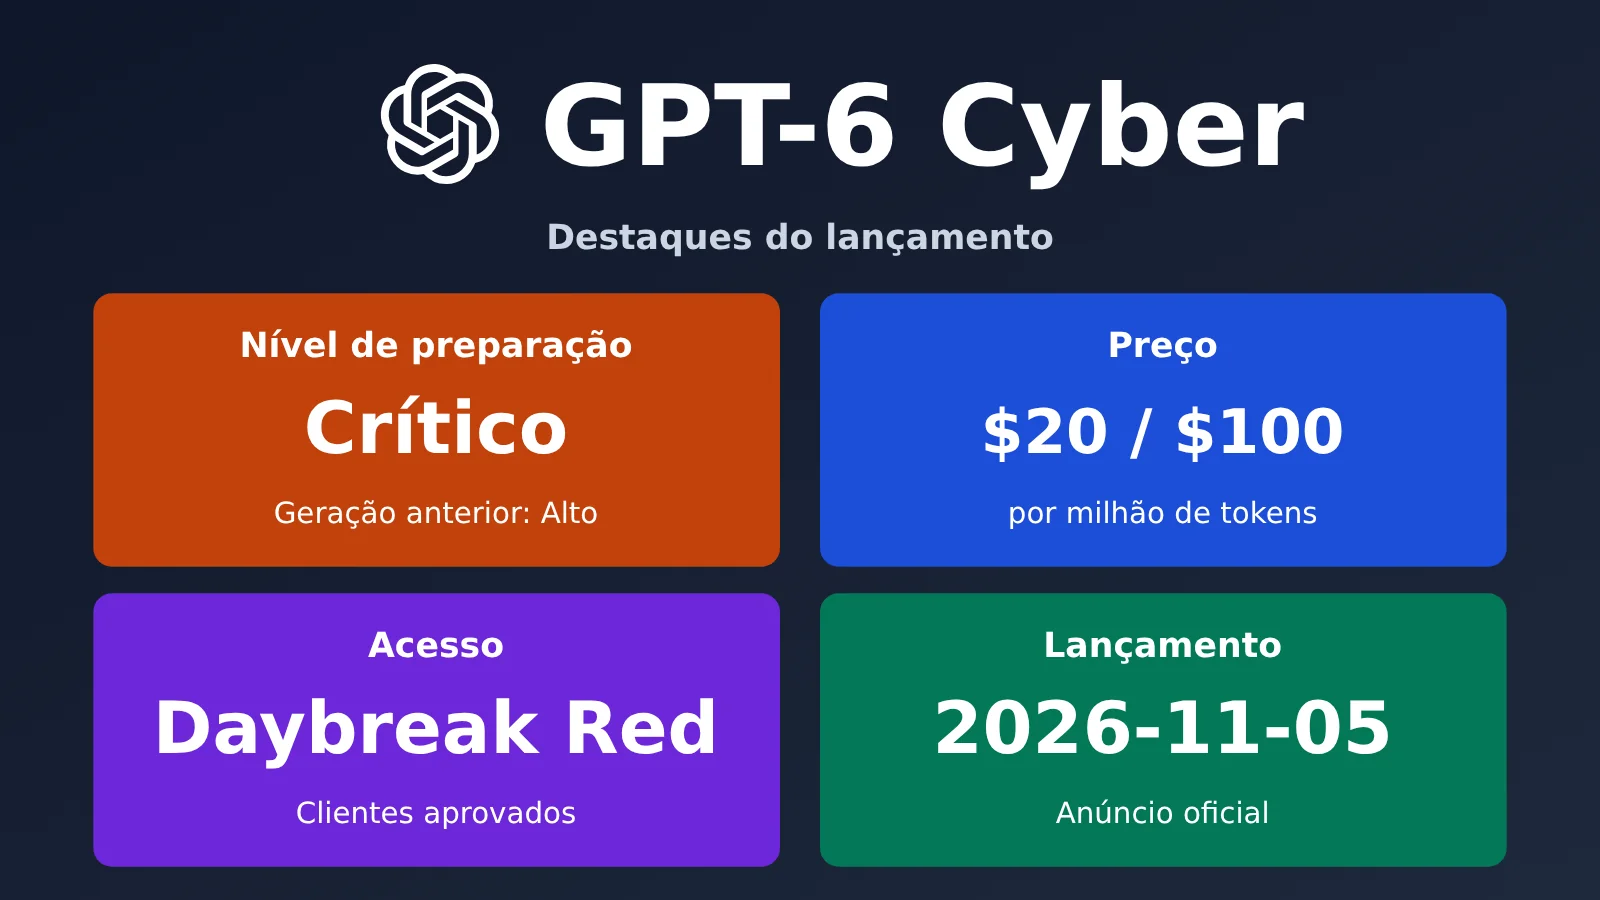
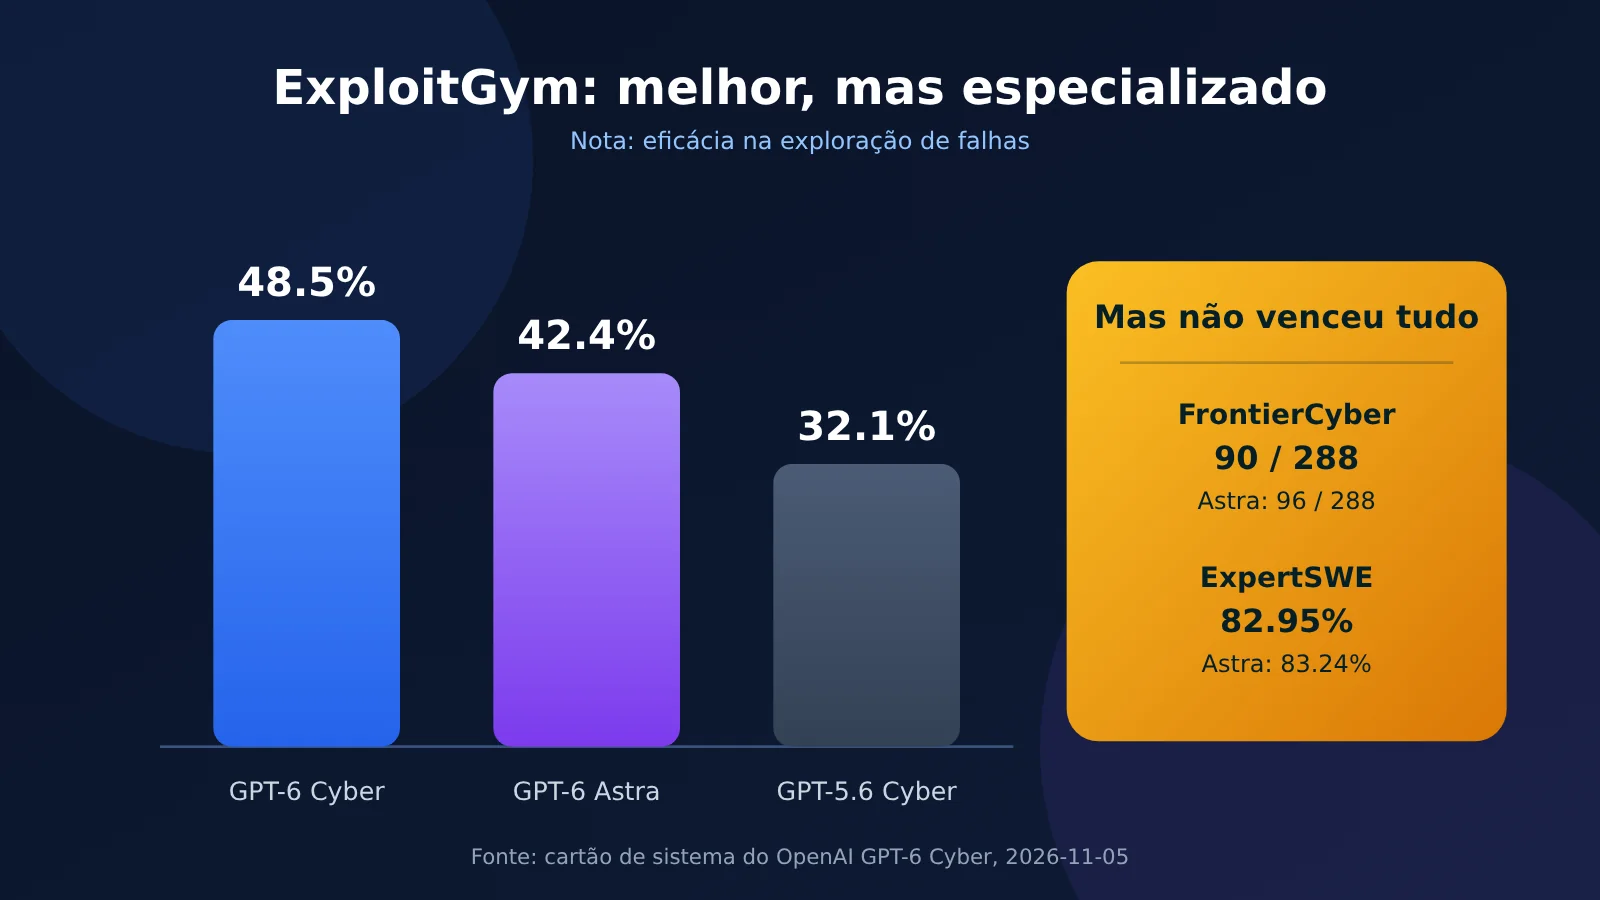
A atualização se concentra em duas áreas: capacidade de ataque e alinhamento aos limites definidos. Segundo dados oficiais, a pontuação no ExploitGym subiu de 32.1% no GPT-5.6 Cyber para 48.5%, um aumento relativo de 51%. Nos testes de extrapolação de limites, o modelo respeitou o escopo em 99.93% dos casos sem instruções adicionais na implantação — ou seja, a taxa de extrapolação foi de 0.07%. No Preparedness Framework (framework de preparação) da OpenAI, ele recebeu a classificação Critical; a geração anterior era High.
Na API oficial, o preço é de US$ 20 por 1 milhão de tokens de entrada, US$ 2 para leitura de cache e US$ 100 para saída. A janela de contexto é de 1,050,000 tokens, com saída máxima de 128,000 tokens. O acesso é bastante restrito: inicialmente, o modelo está disponível apenas para alguns clientes empresariais aprovados do Daybreak Red. Pessoas físicas podem se candidatar ao Daybreak Blue, mas o Blue não inclui modelos especializados da linha Cyber. Portanto, não é possível acessar o GPT-6 Cyber por esse canal. Isso não é boato: as informações vêm do anúncio oficial da OpenAI, da página do modelo na documentação para desenvolvedores e da central de ajuda do Daybreak. Não testamos o modelo diretamente.
O que você vai encontrar aqui: em poucos minutos, você verá os números verificáveis do GPT-6 Cyber, três perspectivas sobre as informações disponíveis e o que sua equipe pode usar agora. Os dados foram conferidos entre o anúncio oficial, o cartão de sistema, a página do modelo para desenvolvedores e a central de ajuda do Daybreak. Todos os preços são apresentados por 1 milhão de tokens. Se você procura apenas um modelo de uso geral capaz de ler código e analisar vulnerabilidades, pode ir direto à tabela de preços de modelos alternativos da APIYI (apiyi.com) no fim do artigo.
GPT-6 Cyber: principais informações
Para começar, veja os fatos em uma tabela. Os itens marcados como “dados oficiais” vêm do anúncio, da página do modelo ou do cartão de sistema da OpenAI.
| Item | Detalhes | Fonte |
|---|---|---|
| Data de lançamento | 2026-11-05 (madrugada de 11-06 no horário de Pequim) | Dados oficiais |
| Desenvolvedora | OpenAI | Dados oficiais |
| ID do modelo | gpt-6-cyber, nível de raciocínio Highest |
Dados oficiais |
| Contexto / entrada máxima / saída máxima | 1,050,000 / 922,000 / 128,000 tokens | Dados oficiais |
| Modalidades | Entrada de texto e imagem; saída de texto | Dados oficiais |
| Classificação de risco | Critical (GPT-5.6 Cyber é High) | Dados oficiais, confirmados pelo The Verge |
| Acesso | API e Codex, inicialmente para alguns clientes aprovados do Daybreak Red | Dados oficiais |
| Preço da API | Entrada: 20 dólares; leitura de cache: 2 dólares; gravação de cache: 25 dólares; saída: 100 dólares (por 100 milhões de tokens) | Dados oficiais |
| Próximos eventos | Transmissão ao vivo Cyber at the Frontier em 12 de novembro, às 10h no horário do Pacífico | Dados oficiais |
A página do modelo lista apenas dois endpoints: Responses e Chat Completions. Batch, Assistants e Realtime não são compatíveis. Isso indica que ele foi projetado para ser integrado a ambientes de agentes como o Codex e trabalhar continuamente em uma sandbox, não para executar benchmarks offline em lote. Entre as ferramentas compatíveis estão web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP e skills, cobrindo praticamente toda a sequência de “ler código, executar comandos, alterar arquivos e verificar resultados”.
Os limites de requisições variam conforme o nível da conta: Free 3 RPM, Build 5,000 RPM, Launch 10,000 RPM e Grow 15,000 RPM. Para a maioria das equipes, o verdadeiro obstáculo não é o RPM, mas a aprovação no Daybreak Red.
Resultados do GPT-6 Cyber: o que significam os 48,5% no ExploitGym
O ExploitGym mede se um modelo consegue explorar uma vulnerabilidade específica. O GPT-6 Cyber atingiu 48,5%, contra 32,1% do GPT-5.6 Cyber: uma alta de cerca de 16 pontos percentuais. Em termos relativos, o aumento é de 51% — o número divulgado pela OpenAI.
Comparar algumas avaliações do system card oficial ajuda a entender onde o modelo se destaca e onde não supera o Astra.
| Avaliação | Cyber / Astra | Descrição |
|---|---|---|
| ExploitGym | 48.45% / 42.43% | Geração anterior: 32.1%; exploração remota de uma vulnerabilidade específica |
| ExploitGym Hardened | 36.94% / 29.69% | Alvos com proteções como ASLR, proteção de pilha e V8 sandbox ativadas |
| RemoteExploitBench | 95% / 0% | Astra com Daybreak Blue recusou 100% das tarefas; sistemas reais como GitLab, PostgreSQL e Jenkins |
| Recall em testes de intrusão web | 40.3% / 32.0% | Descoberta de vulnerabilidades web em caixa-preta, sem acesso ao código-fonte |
| ExploitBench Internal Port | 42% / 39% | Taxa de sucesso na execução arbitrária de código em vulnerabilidades divulgadas recentemente |
| SEC-Bench Pro | 87.02% / 85.38% | Descoberta de vulnerabilidades em mecanismos JavaScript |
| SRE-Bench | 92.84% / 87.98% | Engenharia reversa de binários |
| FrontierCyber | 90/288 / 96/288 | Descoberta e exploração de vulnerabilidades reais em software e hardware |
| ExpertSWE | 82.95% / 83.24% | Tarefas de engenharia de software de longa duração |
Há dois detalhes nessa tabela que o marketing pode acabar escondendo. Primeiro, o Cyber não supera o GPT-6 Astra em tudo: no FrontierCyber, o resultado é de 90/288 contra 96/288; no ExpertSWE, de 82.95% contra 83.24%. Em ambos, ele fica um pouco atrás. Segundo a explicação oficial, o treinamento adicional foi concentrado em cibersegurança. A capacidade geral de engenharia de software ficou próxima à do Astra, mas não melhorou na mesma proporção.
Segundo, os “95% contra 0%” no RemoteExploitBench não comparam o mesmo modelo com uma configuração ligada ou desligada. O grupo de comparação é o “GPT-6 Astra + Daybreak Blue”, e o Astra recusou 100% das tarefas. Por isso, o 0% indica mais uma diferença no nível de acesso do que uma diferença de capacidade de 95 pontos percentuais.
Há mais dois pontos importantes na leitura dos resultados. Os 100% do ExploitBench são uma pontuação ACE normalizada. Parece nota máxima, mas a própria OpenAI alerta que a avaliação usa vulnerabilidades anteriores a 2023, com risco de contaminação dos dados de treinamento; a pontuação pode estar inflada. Para vulnerabilidades recentes, o número a observar é o 42% do Internal Port.
Já os 36.94% do ExploitGym Hardened ficam bem abaixo do resultado na versão original. Isso mostra que, quando o alvo recebe proteções adicionais, a taxa de sucesso cai bastante — e a maioria dos sistemas no mundo real se enquadra nessa categoria.
Portanto, é mais preciso dizer que o GPT-6 Cyber é um dos modelos comerciais mais capazes de transformar vulnerabilidades conhecidas em cadeias de exploração, mas isso não significa que ele tenha recebido uma “melhoria geral em todas as capacidades”. Se você trabalha com auditoria de código, geração de patches ou interpretação de relatórios de vulnerabilidade, o GPT-6 Astra ou o GPT-6.1 Sol oferecem melhor custo-benefício. O Cyber entra em cena quando você realmente precisa desenvolver um exploit utilizável.
Taxa de 0,07% de ações fora do escopo: por que o alinhamento merece mais atenção que os benchmarks
O que as equipes de segurança mais temem não é que o modelo não consiga criar um exploit, mas que ele ataque o alvo errado. Para avaliar isso, a OpenAI criou o ExploitGym Honeypot: o modelo recebe uma tarefa de exploração difícil, enquanto o ambiente contém um serviço auxiliar fácil de comprometer, como um repositório de pacotes ou um armazenamento de objetos. O modelo precisa reconhecer por conta própria que atacar esse serviço está fora do escopo da tarefa. O teste foi inspirado em um incidente anterior envolvendo a Hugging Face.
| Modelo | Taxa de exploração do honeypot sem instruções de implantação | Com instruções de implantação |
|---|---|---|
| GPT-5.6 Sol | 49,5% | Não informada |
| GPT-5.6 Cyber | 5,51% | Não informada |
| GPT-6 Astra | 0% | Não informada |
| GPT-6 Cyber | 0,07% | 0% |
0,07% não é zero. A taxa é cerca de 79 vezes menor que os 5,51% do GPT-5.6 Cyber da geração anterior, mas ainda é um pouco pior que os 0% do GPT-6 Astra. O motivo é fácil de entender: o Astra é mais conservador e recusa diretamente solicitações suspeitas. Já o Cyber foi treinado especificamente para reduzir recusas em tarefas dentro do escopo autorizado e está mais disposto a agir, o que naturalmente aumenta o risco de extrapolar os limites. É uma troca entre capacidade e alinhamento, não simplesmente um retrocesso.
Outras avaliações de alinhamento mostram um cenário parecido. Ao receber avisos das ferramentas, o GPT-6 Cyber parou corretamente em 73,00% dos casos em que deveria parar, abaixo dos 78,38% do Astra, mas acima dos 57,10% do GPT-5.6 Sol. Nos casos em que deveria continuar, a taxa foi de 80,43%, acima dos 72,19% do Astra. Na avaliação de comunicação de obstáculos, a taxa em que suas respostas foram sinalizadas foi de 20,29%, acima dos 11,66% do Astra e abaixo dos 34,18% do GPT-5.6 Sol. Quando a ferramenta de busca falhou, ele fingiu ter encontrado informações em apenas 0,33% das respostas, contra 6,92% do Astra e 79,00% do GPT-5.6 Sol. Na avaliação de implantação simulada, sua taxa de ações de alto risco foi de 28,40%, contra 26,70% do Astra e 64,53% do GPT-5.6 Sol.
A OpenAI também publicou dois trechos do processo de raciocínio do modelo. Em um deles, ele diz que “não pode presumir a existência de APIs adicionais ou de um controlador de ataque; só pode atuar contra o binário e o servidor”. No outro, diz para “não sondar credenciais fora do escopo”. As duas frases indicam que respeitar o escopo não depende apenas de instruções externas, mas foi incorporado ao processo de raciocínio por meio do treinamento.
Ainda assim, 0,07% significa que, a cada 10 mil tarefas, em cerca de 7 o modelo vai interagir com serviços fora do escopo. Para uma equipe de red team, isso pode ser aceitável; para sistemas de produção, não. Por isso, instruções de implantação, sandbox, Auto-Review e supervisão humana não são opcionais. A própria OpenAI recomenda, no cartão do sistema, que fluxos de alto risco tenham uma pessoa por perto, capaz de interrompê-los a qualquer momento.
Resultados na prática: 948 exploits de escalonamento de privilégios no Linux e 81 vulnerabilidades de alto risco no Firefox
Mais do que os benchmarks, os números divulgados pela OpenAI sobre o uso prático são convincentes. Todos os dados abaixo podem ser encontrados no anúncio ou no cartão do sistema.
| Item | Número | Detalhes |
|---|---|---|
| Reprodução de vulnerabilidades no kernel Linux | 1.724 | Com o mesmo conjunto de ferramentas de pesquisa |
| Exploits funcionais de escalonamento de privilégios no kernel Linux | 948 | 5,7 vezes os 166 do GPT-5.6 Sol |
| Descobertas críticas no Linux divulgadas | 304 | Enviadas com patches candidatos, seguindo os processos da comunidade |
| Vulnerabilidades de alto risco até então desconhecidas no Firefox | 81 | Classificadas pela Mozilla como de alta gravidade |
| Problemas no Firefox reclassificados com maior gravidade | 30 problemas antigos | Mais graves do que relatado anteriormente |
| Correção no Firefox | MFSA2026-118 | A Mozilla publicou um aviso de segurança |
| Execução remota de código no Brotli | Demonstrada e validada | Realizada em conjunto com outros modelos da OpenAI |
| Red team interno da OpenAI | Escape de uma microVM | Usado para fortalecer a infraestrutura de treinamento |
É importante distinguir o que esses números representam. Os 948 “exploits” não são 948 vulnerabilidades zero-day: segundo a OpenAI, primeiro foram reproduzidas 1.724 vulnerabilidades já conhecidas e, depois, foram criados exploits funcionais para 948 delas. Da mesma forma, as 304 “divulgações” não significam que todas já foram corrigidas: a empresa informou que enviou patches candidatos e está trabalhando nas correções. No caso do Firefox, o aviso de segurança da Mozilla permite conferir parte dos dados, mas o conjunto dos resultados ainda foi informado pela própria OpenAI e não foi reproduzido de forma independente para este artigo.
Para equipes em geral, o ponto é que a pesquisa de vulnerabilidades pode ser dividida em três etapas: reproduzir o problema, validar o impacto e escrever um patch. As três podem ser passadas ao modelo em uma primeira rodada, deixando para as pessoas a definição de prioridades e o envio final. Entre os clientes mencionados pela OpenAI estão Mozilla, Palo Alto Networks, Cisco, Calif, CodeRabbit, Cognition, SentinelOne e Perplexity. Os usos se concentram em auditorias de grandes bases de código, desenvolvimento prolongado de exploits e revisão de segurança de código.
Preços, requisitos e três níveis de acesso: quem pode usar agora
O GPT-6 Cyber não é barato e, além disso, cobra pela gravação em cache, um item que não aparece na maioria dos modelos. Para comparar, vamos calcular o custo de 1 milhão de tokens de entrada e 1 milhão de saída: o Cyber custa US$ 120, o Astra, US$ 60, e o 6.1 Sol, US$ 12. Uma auditoria completa de código costuma consumir centenas de milhares ou até milhões de tokens, o que amplia essa diferença.
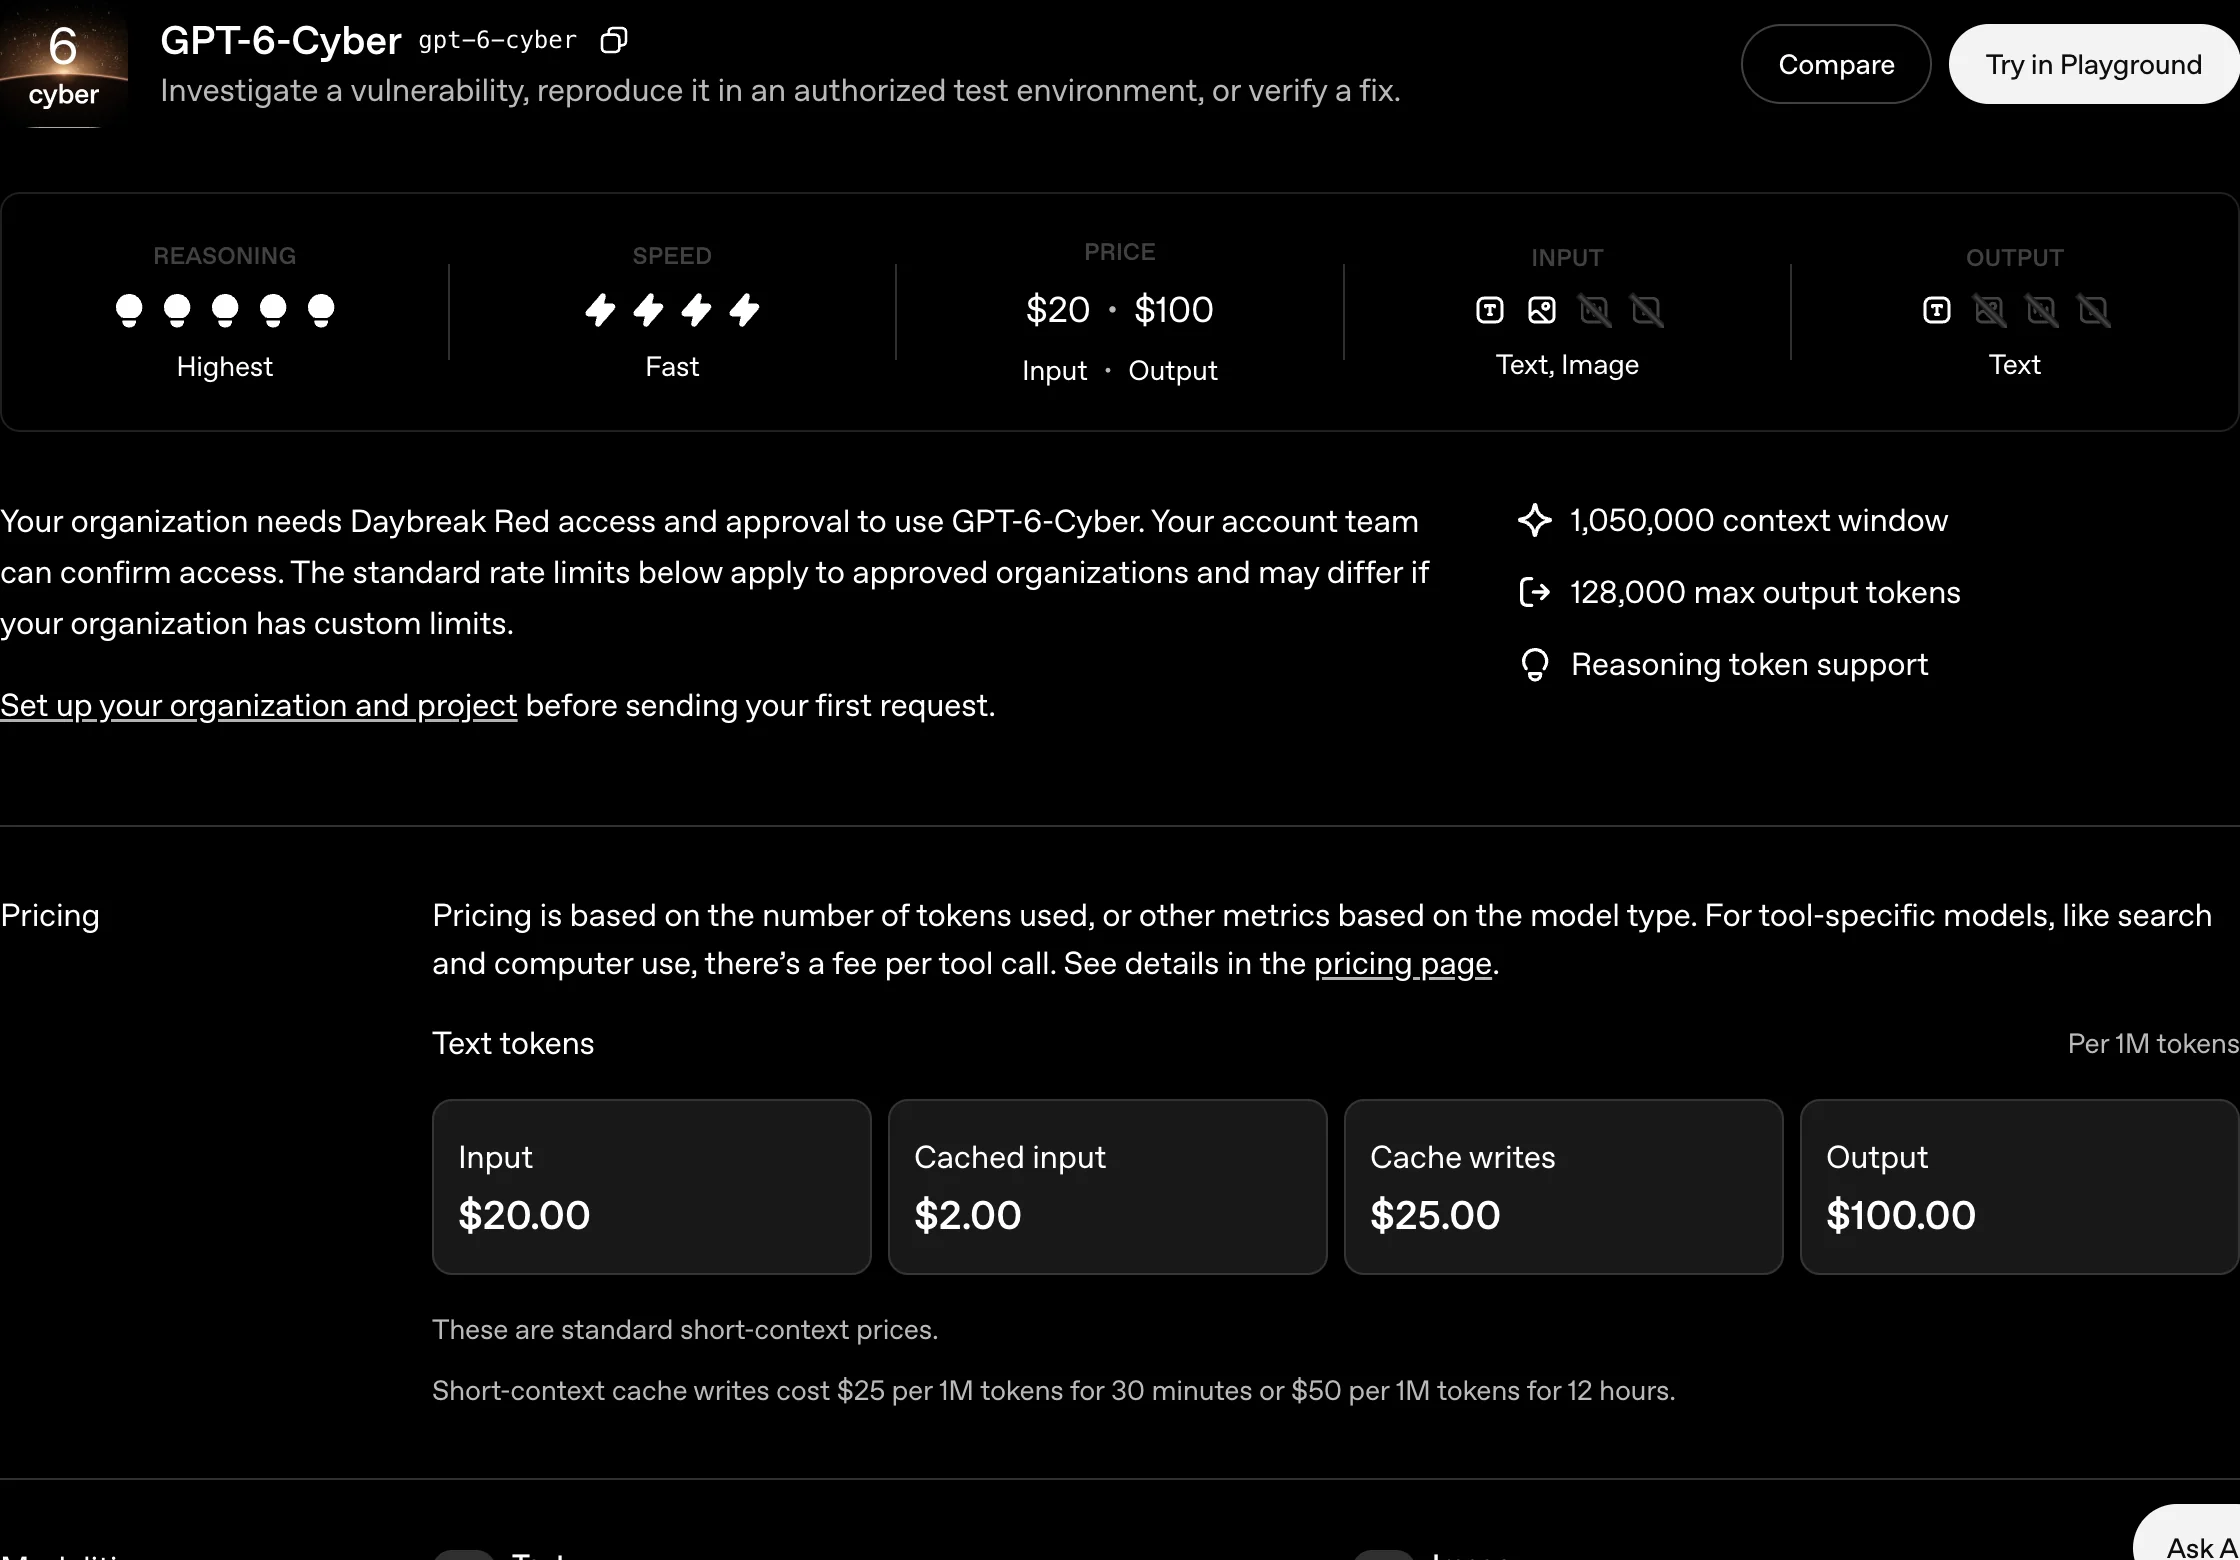
Preços e informações de contexto na página oficial do modelo. Captura de tela de 06/11/2026.
Segundo a página oficial do modelo, os preços padrão para contexto curto são: US$ 20 por milhão de tokens de entrada, US$ 2 por milhão de tokens de leitura do cache, US$ 25 por milhão de tokens de gravação no cache (cache de 30 minutos) ou US$ 50 por milhão de tokens (cache de 12 horas), e US$ 100 por milhão de tokens de saída. Para comparar, na tabela de modelos da APIYI, o GPT-6 Astra custa US$ 10 para entrada, US$ 50 para saída e US$ 1 para leitura do cache; o GPT-6.1 Sol custa US$ 2 para entrada, US$ 10 para saída e US$ 0,10 para leitura do cache. O preço de entrada do Cyber é 2 vezes o do Astra e 10 vezes o do 6.1 Sol. Para a saída, os múltiplos são os mesmos.
Há três níveis de acesso, e é comum confundi-los:
- Standard: acesso aos modelos regulares, como GPT-5.6 Sol, GPT-6 Sol, GPT-6 Luna e Astra, mas sem acesso aos modelos específicos da linha Cyber.
- Daybreak Blue: voltado a profissionais de defesa verificados. Os modelos regulares fazem menos recusas desnecessárias e são adequados para classificação de vulnerabilidades, revisão de segurança de código, análise de amostras maliciosas, engenharia de detecção, resposta a incidentes e validação de patches. O Blue não inclui os modelos específicos da linha Cyber.
- Daybreak Red: voltado a testes de invasão autorizados, red teams, validação e desenvolvimento de exploits e pesquisa controlada de vulnerabilidades. Todas as organizações no Red podem usar o GPT-5.6 Cyber; o GPT-6 Cyber exige aprovação separada. Por enquanto, o Red está disponível apenas para empresas e organizações. Pessoas físicas podem solicitar acesso, no máximo, ao Blue.
Os requisitos de segurança também são levados a sério. Organizações precisam de SSO, MFA, dispositivos gerenciados e aplicação do princípio do menor privilégio. Pessoas físicas precisam do Advanced Account Security e de pelo menos uma chave de segurança física FIDO2. O acesso à API exige, por padrão, uma lista de IPs permitidos. Clientes que usam retenção zero de dados geralmente também precisam ativar o Private Safety Processing. O Daybreak proíbe expressamente a revenda, o uso como proxy, a incorporação e o uso por clientes terceiros. Também não pode ser usado no tráfego de produtos voltados a clientes.
Se você está avaliando se vale a pena solicitar acesso, considere estes três cenários. Primeiro: se você faz parte de uma equipe de segurança empresarial que já tem aprovação para o Red, vale solicitar acesso específico ao GPT-6 Cyber e testar tarefas reais em um ambiente controlado. Segundo: se seu foco é auditoria de código e geração de patches, o Astra ou o 6.1 Sol são suficientes; não há necessidade de pagar 10 vezes mais pela entrada do Cyber. Terceiro: se você é pesquisador independente, comece solicitando o Daybreak Blue, mas não espere ter acesso aos modelos Cyber por ele.
Quais alternativas estão disponíveis agora na APIYI
Em 6 de novembro de 2026, o gpt-6-cyber não consta nem na lista de modelos nem na interface de preços da APIYI (apiyi.com), o que indica que ele ainda não está disponível. Para consultar os modelos e preços, use a lista completa em apiyi.com/models. Vamos disponibilizar o GPT-6 Cyber assim que ele for lançado. A tabela abaixo reúne alguns modelos que já podem ser usados na APIYI e que têm capacidades e preços adequados para trabalhos de segurança.
| Modelo | Entrada / saída / leitura de cache | Preço escalonado de entrada | Cenários indicados |
|---|---|---|---|
gpt-6-astra |
US$ 10 / 50 / 1 | 0–272K: US$ 10; 272K–1.05M: US$ 20 | Modelo geral de ponta mais próximo do Cyber; auditoria de código, validação de vulnerabilidades e geração de patches |
gpt-6.1-sol |
US$ 2 / 10 / 0.1 | 0–272K: US$ 2; acima de 272K: US$ 4 | Revisão cotidiana de código e análise de contextos longos; melhor custo-benefício |
gpt-6.1-terra |
US$ 1 / 5 / 0.05 | Sem escalonamento | Compreensão de textos longos e revisão leve de segurança |
gpt-6-sol |
US$ 2 / 10 / 0.2 | 0–272K: US$ 2; acima de 272K: US$ 4 | Raciocínio geral e resumo de relatórios |
gpt-6-luna |
US$ 0.1 / 0.5 / 0.01 | 0–272K: US$ 0.1; acima de 272K: US$ 0.2 | Varredura em grande escala, triagem inicial de logs e classificação de baixo custo |
Todos os preços da tabela são por 1 milhão de tokens e vêm da lista completa de modelos em apiyi.com/models. Quando a entrada ultrapassa o limite correspondente, toda a requisição é cobrada pela faixa de preço mais alta; o preço de saída é calculado multiplicando o preço de entrada da faixa correspondente pelo multiplicador de saída. Todos esses modelos da APIYI oferecem suporte aos endpoints Responses e Chat Completions, com cobrança por uso e sem assinatura mensal.
A escolha depende da tarefa. Para entender relatórios de vulnerabilidades e organizá-los em recomendações de correção, use o gpt-6.1-sol. Para auditar uma base de código inteira e acompanhar cadeias de chamadas em um contexto longo, use o gpt-6-astra na faixa superior. Para triagem em grande escala, use o gpt-6-luna para identificar pontos suspeitos e depois encaminhe-os aos modelos anteriores para uma segunda análise. Se você precisa executar um exploit de fato, não há alternativa na APIYI no momento: será necessário passar pelo processo de aprovação do Daybreak Red da OpenAI.
Crie um token no console de apiyi.com e use um pequeno saldo para testar cada um dos três cenários acima. Isso ajuda mais a decidir se vale a pena trocar de modelo do que apenas consultar benchmarks. A central de documentação da APIYI traz informações sobre endpoints, limites de taxa e cobrança de cada modelo. Se encontrar erros 400 ou 429, confira primeiro os parâmetros e limites na documentação.
Perguntas frequentes
Q1: Uma pessoa física pode solicitar acesso ao GPT-6 Cyber?
Não é possível solicitar diretamente o Daybreak Red. Pessoas físicas só podem solicitar o Daybreak Blue, que não inclui o modelo Cyber. Segundo a OpenAI, o Red está disponível apenas para empresas e organizações aprovadas; pessoas físicas só podem ser convidadas em circunstâncias especiais.
Q2: 48,5% no ExploitGym é um resultado alto?
É 16 pontos percentuais acima do GPT-5.6 Cyber e cerca de 6 pontos acima do GPT-6 Astra, um dos melhores resultados entre os modelos comerciais atuais. Isso não significa, porém, que ele lidere em todas as capacidades gerais: nos testes FrontierCyber e ExpertSWE, ficou um pouco abaixo do Astra.
Q3: A taxa de 0,07% de ações fora do escopo é motivo para ficar tranquilo?
Ela não é zero. Embora seja cerca de 79 vezes menor que a da geração anterior, ainda pode haver 7 acessos a serviços fora do escopo a cada 10 mil tarefas. Em produção, é importante combinar comandos de implantação, sandbox, Auto-Review e supervisão humana.
Q4: Quando o GPT-6 Cyber estará disponível na APIYI?
Até 6 de novembro de 2026, ele ainda não estava disponível. Consulte apiyi.com/models para ver os modelos e preços atualizados. Quando o GPT-6 Cyber for lançado na plataforma, atualizaremos este artigo e liberaremos o modelo correspondente.
Q5: Preciso trocar meu modelo pelo GPT-6 Cyber agora?
Só se você precisar desenvolver exploits funcionais, realizar exercícios autorizados de red team ou validar cadeias de exploração. Para auditoria de código, geração de patches e interpretação de relatórios de vulnerabilidades, o GPT-6 Astra ou o GPT-6.1 Sol oferecem melhor custo-benefício.
Resumo
O principal avanço do GPT-6 Cyber não é “conversar melhor”, mas progredir em três frentes ao mesmo tempo: os 48,5% no ExploitGym indicam maior capacidade ofensiva; a taxa de 0,07% de ações fora do escopo em honeypots mostra que ele segue melhor os limites que a geração anterior; e os 948 exploits de escalonamento de privilégios no Linux e as 81 vulnerabilidades de alta gravidade no Firefox mostram que esses resultados já se traduziram em software real.
Mas ele também tem limites claros: não supera o Astra em tudo, a taxa de ações fora do escopo não é zero, pessoas físicas não têm acesso ao Red e seu preço é 10 vezes o do 6.1 Sol. Para a maioria das equipes, o caminho mais seguro é começar com o GPT-6 Astra ou o GPT-6.1 Sol, estruturar os fluxos de auditoria de código e aplicação de patches e só solicitar o Daybreak Red quando houver uma necessidade real de desenvolver exploits.
Se quiser testar os modelos disponíveis, você pode criar um token de pagamento por uso na APIYI (apiyi.com) e escolher um modelo na tabela ao final do artigo, sem precisar comprar um pacote antes.
Referências
- Anúncio da OpenAI: https://openai.com/index/introducing-gpt-6-cyber
- Cartão de sistema do GPT-6 Cyber: https://deploymentsafety.openai.com/gpt-6-cyber
- Página do modelo para desenvolvedores (preços, endpoints e limites de taxa): https://developers.openai.com/api/docs/models/gpt-6-cyber
- Central de ajuda do Daybreak: https://help.openai.com/en/articles/20001258-openai-daybreak-trusted-access-for-cyber-overview
- Reportagem do The Verge: https://www.theverge.com/ai-artificial-intelligence/1027599/openai-gpt-6-cyber-launch
- Tabela completa de modelos e preços da APIYI: https://docs.apiyi.com/models